
Kafka系列(三)、生产者分区策略、ISR、ACK、幂等性、事务机制

Kafka【八】如何保证消息发送的可靠性、重复性、有序性 幂等性生产者:防止消息重复发送,适用于单个消息级别的去重。事务支持:确保操作的原子性和一致性,适用于需要跨分区或系统的一致性操作。因此,幂等性生产者并不是必须与事务隔离使用才能保证消息的唯一性。相反,幂等性生产者本身就是为了解决消息重复发送问题而设计的。事务支持则是为了实现更高级别的数据一致性和操作的原子性。两者可以独立使用,也可以结合使用以满足不同的需求。 阅读详情

目录

分区策略

消息压缩

ISR机制

ACK机制

故障处理

一致性语义


Kafka系列:

kafka 2.4.1单机版部署及使用

kafka监控系统kafka eagle安装使用

滴滴开源的kafka-manager编译及部署使用

kafka管理监控系统 CMAK(yahoo的kafka-manager)部署及使用

Kafka系列(一)、2.6.0版本kafka集群搭建

Kafka系列(二)、架构原理及存储机制


分区策略

kafka的topic通过分区(partition)提升可扩展性和并发度,生产者将数据写入topic时选择分区有下面三种策略:

  1. 指定分区:写到指定的分区;
  2. 没指定分区:将key进行hash后再与该topic的分区数量进行取余得到分区号,可以保证同样的key的消息会进入同一个分区内;
  3. 没指定分区又没有key值:先随机生成一个整数(之后每次在这个整数上递增1),将这个整数和topic的分区数量进行取余得到分区号(Round-Robin算法),是kafka默认的分区分配策略,能保证负载均衡不会出现倾斜的情况。

消息压缩

在前一篇文章中我们提到 消息压缩可以提升kafka的性能,生产者在发送消息的时候将消息按照指定的压缩算法(gzip,snappy,lz4,zstandard)进行压缩,达到降低网络IO、优化broker磁盘空间的目的,但这样也会有更多的CPU消耗,因此是个需要权衡的功能。

在存储的消息格式中除了K-V的消息体之外还有其他描述性字段如attributes,它保存了消息的编码,压缩算法等信息。消费者通过该值记录的压缩算法进行解压,得到消息体。

各压缩算法的性能对比请参考:Kafka 2.1.0压缩算法性能测试

ISR机制

在前面介绍了每个topic的分区可以设置若干个副本(Leader、Follower),其中Follower实时同步Leader的数据,为了保证生产者发送的数据,能可靠的发送到指定的 topic,topic 的每个分区收到生产者发送的数据后,都需要向生产者发送应答 ack(acknowledgement),如果生产者收到 ack,就会进行下一轮的发送,否则重新发送数据。在Kafka中必须要所有Follower都完成同步时才会发送ack,这样的好处是当重新选举Leader时,只需要有n+1个副本即可容忍n台节点故障,但缺点也很明显就是延迟很高,因为必须等待所有follower都完成同步才行。

但这样又会带来新的问题,如果其中有一个follower由于网络延迟或者某种原因,迟迟不能完成数据同步,Leader就会一直阻塞等待直到该follower完成同步,这非常的影响性能,于是Kafka引入了一个新的机制:ISR(In-Sync Replica)。

ISR(In-Sync Replica):和Leader保持同步的follower集合,Leader不需要等待所有Follower都完成同步,只要在ISR中的Follower完成数据同步就可以发送ack 给生产者。如果ISR集合里的follower 的延迟时间超过配置的参数(replica.lag.time.max.ms)就会从ISR 内剔除,只需要保证副本能够发送到这些ISR集合里的follower即可。一旦Leader发生故障,就会从ISR集合里选举一个Follower作为新的Leader。

在版本0.90以前还有一个参数,根据follower和leader之间相差的数据量来控制是否在ISR集合内,大于配置的阈值则踢出ISR集合。

ACK机制

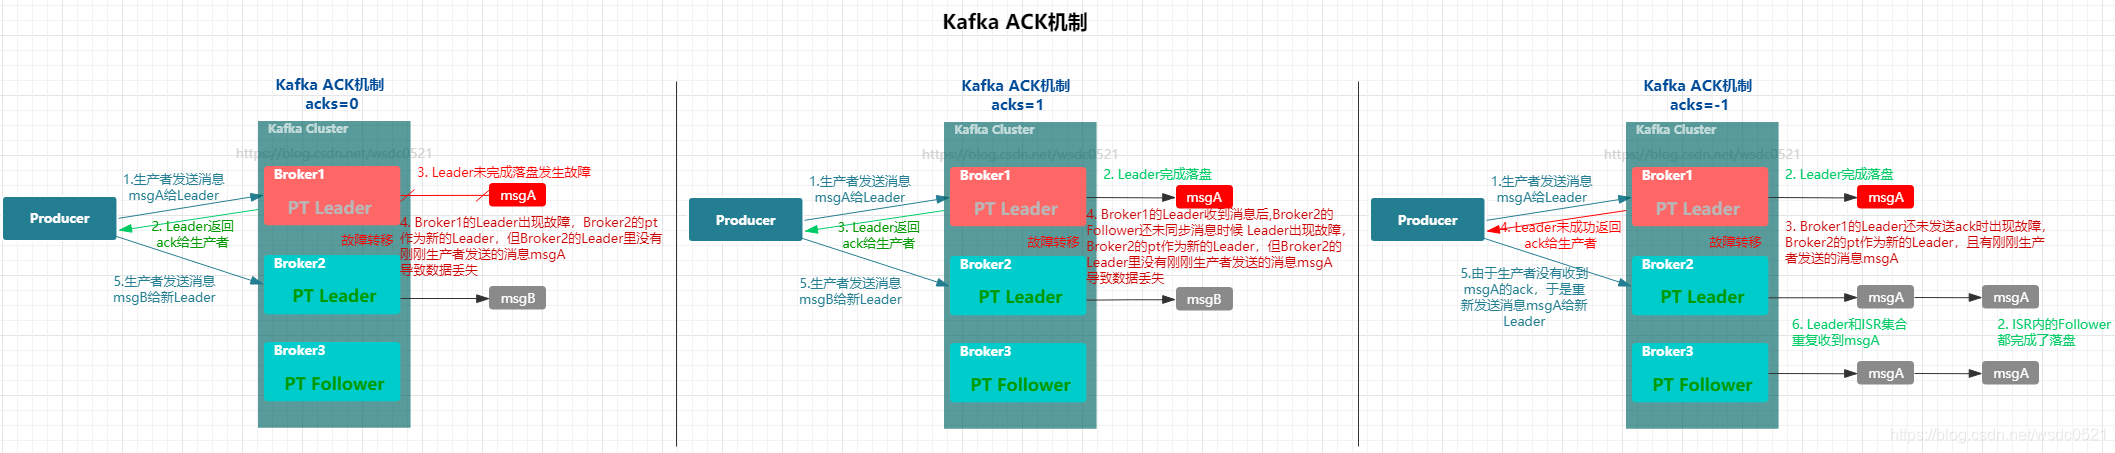
对于某些不太重要的数据,我们能容忍少量数据的丢失,不需要等待ISR内的Follower都完成同步再发送ack,这样的话可以牺牲可靠性来换来数据吞吐量的提升。通过对可靠性和写入延迟的权衡,我们可以选择下面三种可靠性级别:

  • acks = 0 :生产者只负责发消息,不管Leader 和Follower 是否完成落盘就会发送ack 。这样能够最大降低延迟,但当Leader还未落盘时发生故障就会造成数据丢失;
  • acks = 1 :Leader将数据落盘后,不管Follower 是否落盘就会发送ack 。这样可以保证Leader节点内有一份数据,但当Follower还未同步时Leader发生故障就会造成数据丢失;
  • acks = -1(all) :生产者等待Leader 和ISR 集合内的所有Follower 都完成同步才会发送ack 。但当Follower 同步完之后,broker发送ack之前,Leader发生故障时,此时会重新从ISR内选举一个新的Leader,此时由于生产者没收到ack,于是生产者会重新发消息给新的Leader,此时就会造成数据重复;

(点击图片放大) 
 

故障处理
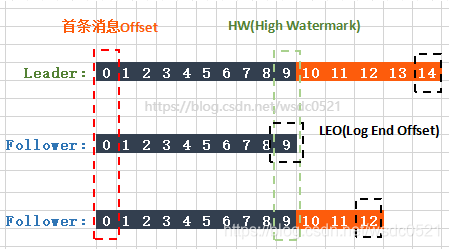
  • LEO(Log End Offset):每个副本内最大的offset;
  • HW(High Watermake):消费者能见到的最大的offset,为ISR集合内最小的LEO;

如上图Leader写15条,ISR内两个follower分别写了10条和13条,那当前分区数据的HW为9,LEO分别为14,9,12。
为了保证消费的一致性,避免出现当消费者消费到offset13时发生故障,然后从新leader消费时没有offset为13的数据,因此对于消费者来说只能看到并消费HW之前的数据,在这种机制下,当消费者消费到offset9时Leader出现故障,此时无论是ISR内的哪个follower作为新的Leader都能保证消费端的一致性。

故障处理:

  • Follower:follower 发生故障后会被临时踢出 ISR集合,当该 follower 恢复后,它会先读取上次记录的HW,并将本地log 文件内高于该HW 的部分截取掉,然后从 HW 的offset开始向 Leader 进行重新同步,保证自己的数据和当前的Leader数据一致。当该 follower 的LEO 大于等于(重新超过)该 分区的当前HW,就可以重新加入 ISR 了。
  • Leader:Leader 发生故障之后,控制器会从ISR 集合内选举一个新的Leader,然后为了保证多个副本之间的数据一致性,其余的Follower 会先将各自的 log 文件内高于HW 的部分截取掉,然后从HW 的offset开始向 Leader 进行重新同步,保证自己的数据和当前新的Leader的数据一致。

可以看出,HW,LEO是为了保证消费者端的消费一致性,避免出现由于Leader更换导致的消费offset不一致或数据不一致的情况。

而上面的ACK机制是为了保证生产者端的数据一致性,当选择acks=all时可以保证数据一定不会丢。

一致性语义

在分布式消息传递一致性语义上有下面三种:

  • At Least Once:消息不会丢,但可能会重复;
  • At Most Once:消息会丢,但不会重复;
  • Exactly Once:消息不会丢,也不会重复;

在kafka0.11版本之前是无法在kafka内实现exactly once 精确一次性保证的语义的,在0.11之后的版本,我们可以结合新特性 幂等性以及acks=-1 来实现kafka生产者的exactly once。

  • acks=-1:在上面ack机制里已经介绍过,他能实现at least once语义,保证数据不会丢,但可能会有重复数据;
  • 幂等性:0.11版本之后新增的特性,针对生产者,指生产者无论向broker 发送多少次重复数据,broker 只会持久化一条;

在0.11版本之前要实现exactly once语义只能通过外部系统如hbase的rowkey实现基于主键的去重。

幂等性解读: 

在生产者配置文件 producer.properties 设置参数 enable.idompotence = true 即可启用幂等性。

Kafka的幂等性其实就是将原来需要在下游进行的去重操作放在了数据上游。开启幂等性的生产者在初始化时会被分配一个PID(producer ID),该生产者发往同一个分区(Partition)的消息会附带一个序列号(Sequence Number),Broker 端会对<PID, Partition, SeqNumber>作为该消息的主键进行缓存,当有相同主键的消息提交时,Broker 只会持久化一条。但是生产者重启时PID 就会发生变化,同时不同的 分区(Partition)也具有不同的编号,所以生产者幂等性无法保证跨分区和跨会话的 Exactly Once。

事务:kafka在0.11 版本引入了事务支持。事务可以保证 Kafka 在 Exactly Once 语义的基础上,生产和消费可以跨分区和会话,要么全部成功,要么全部失败。

生产者事务:

Kafka引入了一个新的组件Transaction Coordinator,它管理了一个全局唯一的事务ID(Transaction ID),并将生产者的PID和事务ID进行绑定,当生产者重启时虽然PID会变,但仍然可以和Transaction Coordinator交互,通过事务ID可以找回原来的PID,这样就保证了重启后的生产者也能保证Exactly Once 了。

同时,Transaction Coordinator 将事务信息写入 Kafka 的一个内部 Topic,即使整个kafka服务重启,由于事务状态已持久化到topic,进行中的事务状态也可以得到恢复,然后继续进行。


希望本文对你有帮助,请点个赞鼓励一下作者吧~ 谢谢! 


kafka生产者的副本同步策略以及数据一致性、丢失消息、消息重复等问题的一些看法 生产者ISR 1. ISR的由来 2.什么是ISR? ISR全称In-Sync-Replica-Set,意思是与Leader保持同步的的follower集合,当一个Partition写一条数据时,就需要Followers来同步此数据, ... 阅读详情

相关推荐

Frida实战:如何用HashMap.put拦截法快速定位安卓App加密参数(附完整脚本)

本文详细介绍了如何使用Frida拦截HashMap.put方法快速定位安卓App加密参数,提供完整脚本和实战案例。通过动态分析技术,相比传统静态分析大幅提升效率,适用于电商、社交、金融等场景的加密参数定位。

jump7的博客 261

kafka-04数据同步原理ISR、ACK、LEO、HW

111

m0_45987292的博客 1535

如何把Excel的数据导入python?

Python数据分析——excl导入数据的简单方法(xlrd) 本文的初衷是发现网上很多Excel导入Python都没有结合具体Excel文档进行讲解,所以这篇文档将会呈现一个简单快速的Excel+Python的入门方法。 开发环境 Prerequisites: 在开始用Python导入Excel之前,要配置好自己的开发环境,最好有IDE(terminal也可)+安装相应的数据分析包。 IDE :pycharm,vscode,etc 数据分析包:matplotlib,xlrd,numpy,etc 导入数

qq_40783513的博客 7万+

第十章 kafka专题之ACK/ISR/HW机制

kafka专题之ACK/ISR/HW机制

qq_27924553的博客 1659

ARM Cortex平台NEON指令集优化实战指南

本文为ARM Cortex平台开发者提供了一份全面的NEON指令集优化实战指南。文章从NEON的SIMD架构原理讲起,详细介绍了开发环境搭建、NEON内联函数与自动向量化两种核心编程方法、关键数据类型与指令,并通过图像饱和运算、矩阵乘法等实战案例,深入解析了性能调优技巧与常见避坑指南,旨在帮助开发者充分释放ARM处理器的并行计算潜力。

weixin_29162439的博客 260

《Python全栈系列教程》专栏介绍及文章汇总

《Python全栈系列教程》专栏介绍及文章汇总

孤寒者的博客 71万+

kafka--基础知识点--5.1--ACK机制

P15 15_尚硅谷_Kafka高级_生产者ACk机制

Chasing__Dreams的博客 958

YOLOv8改进系列:RepVGG重参数化结构——训练多分支,推理单路,极致提速

本文将详细介绍如何将RepVGG的重参数化思想融入到YOLOv8的骨干网络中,实现一种训练时多分支、推理时单路的改进版YOLOv8。我们将提供完整的代码实现、详细的原理讲解,并在COCO数据集和自定义数据集上进行充分的实验验证。

YOLO 200

kafka四 kafka producer的ack机制和kafka集群

一、前几节讲了简单的数据发送接收,忘了说一个点,就是producer发送数据的时候怎么保证数据成功发送到kafka服务器上。 org.apache.kafka.clients.producer.Producer的send()方法有三个重载,其中一个如下: producer.send(new ProducerRecord&lt;String, Object&gt;(TOPIC, data), ...

hezhihuahzh的博客 1万+

YOLOv8结合GhostNet实现轻量化目标检测:模型设计与性能评测

GhostNet系列的核心是**“幽灵特征图(Ghost Feature Map)”** 概念:通过简单的线性变换(如深度卷积)生成“幽灵特征”,这些特征与原始特征融合后,能以极低的计算成本带来丰富的语义信息。为了突出GhostNet系列的必要性,设计消融实验:分别测试“仅主卷积”“仅幽灵卷积”“GhostNet(主卷积+幽灵卷积)”三种方案的性能,用数据证明“幽灵特征”的不可替代性。简单来说,引入GhostNet系列的YOLOv8,既能体现你的技术深度,又能让毕设的“落地性”大幅提升。

m0_71589036的博客 116

Ubuntu零基础入门到精通【1.1讲】:什么是 Ubuntu?一文带你彻底搞懂!

🏆 本文收录于 《滚雪球学 Ubuntu》 专栏。 本专栏面向有一定计算机基础,但尚未系统学习 Linux / Ubuntu 的读者,采用“滚雪球式学习法”:先装好、再会用、再理解、再优化、再实战,带你从第一次进入 Ubuntu 桌面 / 终端开始,逐步掌握 Ubuntu 的日常使用、命令操作、软件安装、系统配置、开发环境搭建与服务器部署能力。

**My Coding Family** 5757

Kafka的ACK含义

ACK有三种 0 意味着producer不等待broker同步完成的确认,继续发送下一条(批)信息 提供了最低的延迟。但是最弱的持久性,当服务器发生故障时,就很可能发生数据丢失。例如leader已经死亡,producer不知情,还会继续发送消息broker接收不到数据就会数据丢失 1 意味着producer要等待leader成功收到数据并得到确认,才发送下一条message。此选项提供...

雪落南城的博客 1万+

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

(3)Kafka生产者分区策略、ISR、ACK、一致性语义

语义生产者行为消费者行为优点缺点适用场景至少一次等待ACK,会重试先处理,后提交Offset数据不丢失可能重复消费可处理重复数据的业务至多一次不等待ACK,不重试先提交Offset,后处理吞吐量高,无重复可能丢失数据日志、metrics收集精确一次启用幂等性和事务配置为读取已提交事务最强一致性性能开销最大金融、交易等核心业务Kafka官网https://kafka.apache.org/documentation/#gettingStarted。

wzk153的博客 931

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

kafka分区、生产经验、数据去重、幂等性分析介绍

​ 开发人员可以根业务需求使数据2前往不同的分区,需要自定义分区器来实现。​ 1. 实现接口Partitioner​ 2.实现3个方法:partition,close,configure​ 4.编写partition方法,返回分区号​ 5.在客户端将此类配置进去。

qq_45875024的博客 1794

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Kafka 消息可靠性投递——从生产者到消费者的全链路保障

Kafka 的全链路可靠性需要三个层面的协同配置。acks=all+ 幂等性 + 重试策略 + 本地死信兜底。消费者层:手动位移提交 + 业务幂等 + 异常分类处理。运维层:Broker+ 端到端监控 + 告警。理想情况下通过事务实现"精确一次"语义,但对于大多数业务场景,提前设计好幂等消费逻辑,配合"至少一次"投递策略,是投入产出比最高的方案。

alex_goden的博客 1万+

[消息队列 Kafka] Kafka 架构组件及其特性(二)Producer原理

这边整理下Kafka三大主要组件Producer原理。

harryptter的专栏 2106

Kafka 生产者 、 Kafka 消费者与 kafka事务

文章目录Kafka 生产者 、 Kafka 消费者与 kafka事务3.2、Kafka 生产者3.2.1 分区策略3.2.1.1)分区的原因3.2.1.2)分区的原则【*】3.2.2 数据可靠性保证(生产者推送的数据)【*】3.2.2.1、副本数据同步策略3.2.2.2、ISR3.2.2.3、ack 应答机制(数据丢失和数据重复)3.2.2.4、故障处理细节(数据一致性)3.2.3 Exactly Once 语义3.3、Kafka 消费者3.3.1 Kafka消费方式3.3.2 消费者组里的分区分配策略3.

wang_luwei的博客 1397

大数据之kafka生产者数据可靠性保障

介绍了kafka生产者数据一致性保障的原理,供大家参考。

柳小葱的博客 1765

五、Kafka 生产者 、 Kafka 消费者与 kafka事务

1.1、分区的原因 1.方便在集群中扩展,提高负载能力,每个 Partition 可以通过调整以适应它所在的机器,而一个 topic又可以有多个 Partition 组成,因此整个集群就可以适应任意大小的数据了; 2.可以提高并发读写,因为可以以 Partition 为单位读写了。(联想到ConcurrentHashMap在高并发环境下读写效率比HashTable的高效) 1.2、分区的原则【*】 我们需要将 producer 发送的数据封装成一个 ProducerRecord 对象。 1.指明 part

qq_37200262的博客 1770

Kafka 生产者

kafka生产者原理 异步发送 分区 提高吞吐量 数据的可靠性 ack级别设置 数据重复问题 生产者事务 数据的有序和乱序

m0_56017821的博客 2882

kafka生产者相关

kafka生产者相关:在 Kafka 中,生产者的分区策略可以通过配置参数 来指定。当生产者发送消息到主题时,分区策略决定了消息被分配到哪个分区中。Kafka 提供了以下几种默认的分区策略:除了默认的分区策略之外,Kafka 还允许用户自定义分区策略。用户可以实现 接口,并通过配置参数 指定自定义的分区策略。自定义的分区策略可以根据业务需求来选择分区的方式,比如根据消息的某个字段来选择分区,或者根据一些特定的规则来选择分区。自定义分区策略可以提高消息的分布均衡性,从而提高整体的性能和可扩展性。Kafk

专注Java(全栈)应用开发,求知若渴,虚心若愚,talk is cheap, show me the code. 1162

Kafka生产者详解(下):数据去重(幂等性)与数据有序

Kafka数据可靠性机制详解:通过acks参数控制不同级别的可靠性,0(不等待应答,效率高但可能丢失)、1(Leader落盘应答,中等可靠性)和-1(ISR全部同步应答,高可靠性但效率低)。幂等性和事务机制解决了数据重复问题,实现ExactlyOnce语义。事务流程包括PID申请、消息发送、事务提交等步骤,确保关键数据不丢不重。此外,通过max.in.flight.requests.per.connection参数配置可实现单分区有序性。Kafka在1.x版本后结合幂等性可保证局部有序,但整体分区间仍为无序

Muyu1uz的博客 1085

kafka生产者api和数据操作

kafka生产者api和数据操作

zhaojiew的学习笔记 3万+

(2)Kafka中生产者工作机制详细介绍

1.生产者分区机制 (1)分区原因 提高可扩展性:集群可通过设置Topic的Partition数量,以适应合适大小的数据。 提高并发:以Partition为单位读写。 (2)数据分区原则 ①直接指明partition值 ②不执行partition,而通过key-value,进行哈希取余得到partition ③轮询算法:只有value时,随机生成一个整数值,与Topic可用的partition数量取余。 2.生产者可靠性保证 (1)可靠...

大表哥的博客 1390

【Kafka从入门到放弃系列 四】Kafka架构深入——生产者策略

分区策略 分区的原因 分区的原则 数据可靠性保证 副本同步策略 ISR选举策略 ACK应答机制 HW&LEO故障处理机制 Exactly Once语义

MaoLin Tian's Blog 1280
上一篇: Kafka系列(二)、架构原理及存储机制
下一篇: Kafka系列(四)、消费者策略、Rebalance机制、Offset存储机制
王义凯_Rick
王义凯_Rick 领域专家: 大数据技术领域 领域专家: 大数据技术领域
博客等级 码龄14年 858粉丝 162原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

王义凯_Rick

遇见即是缘,路过就给个评论吧~

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值