端到端智能驾驶训练瓶颈解析:连续帧数据真值的关键价值与行业实践

51c自动驾驶~合集57 多目标多头蒸馏模块:我们看到轨迹模仿学习之后的轨迹还过了其他的MLP,这就是其他头,它的目标也是不一样的,第一个是跟碰撞相关的,第二个是跟行驶区域相关的,第三个是跟舒适度相关的,也就是说不同的评判指标都有一个teacher,之前的模仿学习就是人类的teacher,那么这些teacher是怎么来的呢?本文作者提出的新的范式,就是规划模块是多模的输出,同时,目标也是多样性的,即不仅是GT的轨迹也同时引入了更多的正样本,由不同的专家给出的。还是那句话,小米汽车的成功,是小米价值观,小米模式,和小米方法论的成功。 阅读详情

一、引 言

随着感知、决策和控制各模块的性能逐步逼近上限,端到端学习(End-to-End Learning)在智能驾驶领域受到越来越多关注。端到端模型通过深度神经网络将原始传感器输入直接映射为驾驶控制信号,减少中间模块误差传播的影响,有望简化系统架构、提升整体协同效率。

然而,现实中端到端方案的实际落地远未达到预期,训练稳定性差、泛化能力弱、对极端场景响应迟钝等问题频现。本文将从训练数据角度出发,聚焦一个关键变量:高质量连续帧数据真值,探讨它如何成为突破端到端训练瓶颈的核心资源。
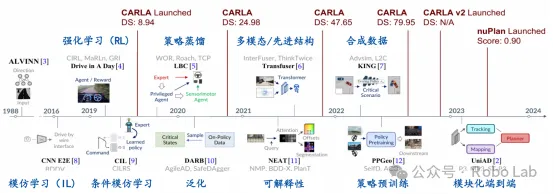
端到端发展历程

二、端到端智能驾驶训练的基本流程

端到端智能驾驶模型的核心思想是打通传感器输入与车辆控制之间的映射关系,其训练流程通常包括以下关键步骤:

  1. 数据采集与预处理:采集车辆在真实或仿真环境中行驶时的多模态数据,包括RGB图像、LiDAR点云、IMU信号、CAN控制数据、高精地图等,并对其进行时间同步、数据清洗与格式标准化。

  2. 模型设计与训练:主流端到端模型多基于深度卷积神经网络、Transformer、BEV(Bird’s Eye View)表示等结构,分为感知-规控融合网络和轨迹回归网络两类,训练目标为最小化预测控制信号(或目标轨迹)与人类驾驶员实际操作之间的误差。

  3. 评估与验证:通过回放或闭环仿真方式对模型进行评估,主要考察其在不同交通场景下的鲁棒性、平滑性、安全性和策略合理性。

相较于传统模块化系统,端到端模型理论上更具整体协同性,但对数据质量,尤其是语义一致、时间连续的训练样本提出了更高要求。
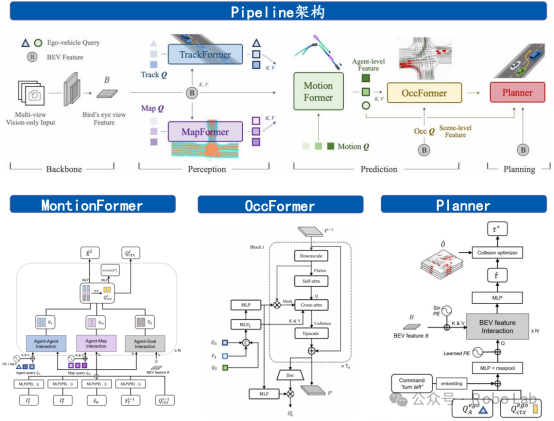
OpenDriveLab发布UniAD架构设计概览

OpenDriveLab发布UniAD架构设计概览

三、训练瓶颈解析:为什么端到端模型难以落地?

3.1 场景稀疏与长尾分布问题

端到端模型依赖大量驾驶数据学习控制策略,但现实道路中的关键决策场景(如非保护左转、临时施工、突发加塞等)极为稀缺,属于典型的长尾分布。模型在训练阶段难以充分暴露于这些罕见场景,导致测试或部署时响应失效。

即便具备上万小时的驾驶数据,如果缺乏对这些“高风险高复杂度场景”的密集采集和标注,模型学习出的控制策略往往偏向于“温和保守”,难以在突变交通情境下做出有效响应。此外,传统采集方式主要依赖自然驾驶过程,未必能高效覆盖所有corner case场景,进一步放大了模型在长尾问题上的性能劣势。

更重要的是,这些场景常常具有复杂的语义关系和多重意图变化,如施工场地同时伴随道路收窄、交警指挥、路面反光干扰等,单帧信息难以覆盖其语义全貌。

3.2 缺乏时序建模能力

许多端到端方法采用静态输入(如单帧图像或短时间窗口),忽视了驾驶行为本质上是一个强时序相关的连续决策过程。缺乏时序特征建模,导致模型在需要提前预判的场景中响应迟缓,表现为“控制漂移”、“跟车失稳”等问题。

比如在高速并线场景中,驾驶员通常会通过观察前后车速和打灯行为提前规划动作,而非根据当前帧立即判断是否变道。若训练数据无法提供连续帧的状态变化信息,模型将缺乏对“策略演化路径”的学习,容易陷入只适应静态决策的“盲控制”。

此外,诸如紧急刹车、躲避障碍、连续交互让行等行为,本质上是一个策略序列,而不是某一帧的孤立响应,必须依靠跨时间建模与行为记忆。

3.3 控制真值的模糊性与歧义性

相比分类或检测任务中相对明确的标签,驾驶控制信号具有明显的多解性。比如在同一场景中,驾驶员可以选择轻微减速也可以选择变道,均为合理行为。这样的监督信号本身就存在歧义,容易造成模型学习方向不确定,训练过程震荡。

此外,不同驾驶员在相同条件下的行为也存在差异,个体风格、安全容忍度、驾驶经验都会导致控制策略的不同,模型学习到的控制行为易出现不稳定、多样性过高的现象,从而影响模型收敛效果与泛化性能。

控制数据还存在“非一致性采集”问题,例如由于采集时GPS漂移或CAN延迟,标签信号本身存在偏移或波动,进一步加剧了训练过程中的误差传播。

3.4 数据离散性,缺乏连续监督

当前常用的数据集如nuScenes、Argoverse、Waymo Motion仅提供稀疏帧标注或短时轨迹片段,缺乏高频连续的数据段。这种数据形态难以支撑模型学习跨时序的策略演化逻辑,也难以实现真正意义上的“行为模仿”。

例如,车辆在进入环岛前的减速、注视、寻找切入点,再到环岛内决策、出环时加速等,均需多帧状态连续呈现才能完整表达策略过程。离散帧仅能呈现动作结果,缺乏状态演化的上下文,导致模型无法推理“为何做出某动作”。

某些驾驶行为(如超车)还涉及视觉注意力迁移、信号意图变化、交互对抗博弈等内容,只有连续帧才能揭示背后的语义轨迹。

3.5 时序标签不一致、误差累积

在模块化系统中,每一层都可以进行误差校正。但在端到端体系中,一旦输入数据存在时间对齐误差或标签跳变,误差会在模型中逐层放大并最终导致策略输出严重偏移,尤其是在复杂交通互动场景中更为明显。

此外,如果连续帧间的目标ID、轨迹或意图标注不一致,会导致模型误认为是两个完全不同的事件,进一步削弱其对跨帧语义的建模能力。缺乏稳健的多帧时间标注机制,也直接限制了Transformer等长时序建模结构在端到端训练中的表现。

目前很多数据平台在生成标注时仍以帧为单位,缺少跨帧实体一致性检查与插值重建能力,导致同一目标在两帧中出现“跳帧”、“漂移”甚至“消失”,这在视觉跟踪、意图建模上都是严重阻碍。

综上所述,当前端到端模型虽具备技术吸引力,但在训练稳定性、数据需求、行为一致性建模等方面仍存在明显瓶颈,而这些问题的根源往往可以追溯到“连续帧真值”的缺失。

四、连续帧数据真值的价值与作用

在端到端智能驾驶模型的训练中,数据不仅仅是“素材”,更是“监督信号”的根基。尤其是具有时序连续性与真实语义真值(ground truth)的高质量数据序列,不仅弥补了端到端训练中的诸多结构性缺陷,更逐步成为系统走向实用化的“第一性资源”。本文将从以下四个维度系统论述其核心价值。

4.1 驱动策略演化建模的基础

智能驾驶并非图像分类等静态任务,它要求模型不仅识别当前状态,更要基于过去预测未来、基于变化规划行为。因此,“策略的演化轨迹”是理解驾驶行为的关键。而这种策略路径,天然需要通过高时间分辨率的连续帧数据来呈现。

以左转避让为例,驾驶员通常会经历“驶入交叉口 → 观察对向车 → 判断速度差 → 减速等待/直接穿越”一系列决策阶段。若数据仅提供转弯瞬间的单帧控制信号,模型将无法理解为何此时选择“等待”或“转向”,更难学习行为背后的演化逻辑。

而连续帧数据,配合高质量的控制与意图真值,可以让模型感知到“从观察到动作”的全过程,从而建立起策略因果链条。这是传统离散采样数据无法提供的训练线索。

更进一步,借助连续帧,模型可以构建跨帧表示,如轨迹微分、速度变化率、注意力转移趋势等,极大丰富输入特征空间,为策略预测提供更具表现力的状态描述。

4.2 提升模型稳定性与泛化能力

端到端模型最大挑战之一是其对数据波动的敏感性,即“单帧预测误差”会导致整段控制逻辑偏移。而连续帧数据在训练中天然具备“冗余约束”效应:

· 时序一致性:连续帧之间状态平滑,控制信号应逐渐过渡。训练过程中,模型在拟合轨迹时需同时满足空间误差最小与时间连贯性,等于引入一种“隐式正则化”,能有效抑制过拟合与过激预测。

· 行为约束带宽:在复杂场景下,连续帧记录了同一行为的多个表现阶段,构成“多视图监督”。这使得模型即使某一帧预测存在偏差,也可通过邻近帧反馈纠偏,从而在整体上增强鲁棒性。

· 稀缺场景的语义外推:对于长尾决策如“前车紧急掉头”、“交警指挥变道”,连续帧能揭示该事件前后的上下文状态,有助于模型从相似但非等同场景中迁移策略,从而提升泛化能力。

以实际工程经验为例,当端到端模型引入连续帧训练机制后,其轨迹偏差率在城市环路中的变化范围下降约20%-30%,尤其在多车交互、突然减速等非结构化场景中表现更平稳。

4.3 支撑行为意图与交互建模

连续帧不仅仅记录空间状态变化,更提供了行为演进与意图显现的窗口。在车路交互频繁的城市交通中,仅通过单帧很难判断其他交通体的“未来走势”。而连续帧轨迹+语义标签的组合,可构建明确的行为意图监督信号,提升模型对交互场景的感知与预测能力。

例如,在“交汇让行”情景中:

· 行人连续帧的移动方向、速度变化可推断其“是否过街”的意图;

· 对向车是否减速、变道可预示其“是否避让”;

· 自车历史控制轨迹也能影响未来行为预测,如刹车力度持续变化说明“正在让行”。

这些隐性意图信息,依赖高质量连续帧数据才能准确提取与标注。借助多帧的速度、加速度、加加速度(jerk)等物理量可进一步辅助模型判断“是想停还是正加速”,从而做出更合逻辑的决策。

一些先进的端到端架构甚至将行为意图作为中间显式表示(例如 Waymo 的 Multi-Agent Prediction 网络结构),通过多目标轨迹回归对交互进行建模,背后均依赖连续帧的轨迹与ID一致性标签作为监督。

4.4 满足长时序神经网络的训练需求

Transformer等长序列神经网络结构近年来被广泛引入端到端驾驶学习,尝试解决传统CNN架构对时序建模能力的不足。但这类模型天然需要大规模“序列样本”支持。

如以每秒20帧计算,一个10秒行为片段即包含200帧图像+CAN数据+标注,且要求目标ID一致、动作连续、时间对齐,若缺乏高质量连续帧样本,将极大制约这类结构的性能发挥。

此外,部分模型使用滑窗机制对历史状态进行聚合,需要标注数据能保持稳定的“因果链式输入”,即“前10帧决定当前动作”,此时一旦中间帧存在遮挡、跳帧、标注丢失等问题,整个训练段将失效。

在实际项目中,使用具备4D连续真值(空间3D+时间连续)支持的数据集,可将Transformer模型的收敛速度提升40%以上,训练稳定性显著增强。而无此类数据的情况下一些长序列结构甚至无法稳定训练。

4.5 促进闭环部署与仿真评估

高质量连续帧数据不仅用于模型训练,也为后续的模型验证与部署提供坚实支撑。在闭环部署前,通常需在仿真平台中对端到端策略进行大规模行为回放与场景重演验证,而只有具备时间连续性的真实行为数据,才能有效驱动仿真系统:

· 可基于真实轨迹构造多车交通情景,复现稀缺互动行为;

· 可模拟模型替代人类驾驶员进行同一路径重演,对比预测轨迹与真实轨迹之间的偏差,评估模型行为一致性;

· 可通过插值、剪辑等方式构建场景变体,对模型策略稳定性进行压测。

此外,在实际部署过程中,若发现模型在某类场景下存在“重复性误判”,可通过连续帧回放精确定位策略崩溃点,为后续模型重训、数据补充提供针对性样本。

因此,具备高语义、长时序、一致性标签的连续帧数据,不仅用于前端训练,更是端到端系统实现闭环开发的基础资源。

五、行业代表性实践与案例分析

在端到端智能驾驶系统的探索过程中,头部科技公司和造车新势力已逐步认识到连续帧数据与高质量真值标签在模型训练中的核心价值。无论是Waymo、Cruise等国际自动驾驶先锋,还是理想、小鹏、华为、亮道智能等中国智能驾驶主力军,均在其技术路线或平台架构中,强调连续行为数据的采集、标注与利用。

5.1 Waymo、Cruise 等国际领先企业的应用实践

Waymo:利用多帧轨迹监督训练长时策略模型

Waymo在其端到端建模中高度重视“驾驶者行为模式”的重建,其Motion数据子集中就明确提供连续时间片段,涵盖目标ID、速度、加速度、轨迹点等详细标签。这使得模型不仅能预测当前位置的控制指令,还能在更长时间窗口内回归未来数秒的目标行为。Waymo同时还在内部实验中提出“多策略采样+交互式回放”的数据构建方法,以增强端到端模型对复杂交通情境中“多种合理解”的学习能力。

在这里插入图片描述

Cruise:闭环回放与重演强化策略一致性

Cruise在训练其城市端到端决策系统时,强调用连续数据复现真实驾驶状态变化。其独特的回放+仿真结合训练流程中,模型需在“给定过去行为”的前提下预测未来动作路径。这种设计促使模型从“即时控制”转向“连续意图生成”。Cruise还建立专门的轨迹一致性度量指标,评估模型预测结果与人类驾驶策略在时间维度上的拟合度,进一步验证了连续数据对策略一致性的重要支撑作用。

在这里插入图片描述

5.2 理想、小鹏、华为、亮道智能:国内代表性路径实践

理想汽车:基于自然驾驶行为段构建时序学习样本

理想汽车在L2+系统中已部署多套轻量化端到端模型,其数据策略以“行为单元”为核心单位。通过对自然驾驶轨迹进行聚类分析与行为识别,提取如“变道插队”“进出匝道”等行为序列,构成完整的时序样本用于训练。同时,理想还基于自研的多模态数据管理平台,实现视频、点云、轨迹、控制数据的全链路同步,为端到端策略训练构建了坚实的数据基础。

VLM模型在驾驶过程中,自动标注视频帧和传感 器信号以生成轨迹和其他标签。此外,对视频帧应用自动描述生成,以生成行为和推理的描述
VLM模型在驾驶过程中,自动标注视频帧和传感 器信号以生成轨迹和其他标签。此外,对视频帧应用自动描述生成,以生成行为和推理的描述。
在这里插入图片描述
在这里插入图片描述

理想汽车推出ReconDreamer世界模型

在这里插入图片描述

理想汽车双系统架构

在这里插入图片描述

系统1(端到端)&系统2(VLM)架构

小鹏汽车:BEV+Transformer结构融合连续帧输入

小鹏在端到端感知-规控一体化方向的研究中,积极引入BEV表示与时序Transformer结构。其训练样本由10-20秒连续帧构成,包含目标跟踪ID、语义地图、路径偏差等多层次真值标注,极大提升了模型在多车交互和密集城市道路场景中的稳定性。小鹏内部评估数据显示,在引入连续帧轨迹监督后,其轨迹预测偏差下降约27%,同时在“追尾危险”场景中提前干预率提升显著。

在这里插入图片描述

在这里插入图片描述

小鹏XNGP模块化端到端架构

主流的端到端架构vs小鹏汽车的端到端架构

华为智能汽车:构建端到端训练的全流程时序平台

华为通过其MDC平台,将数据闭环能力从静态采集升级为“行为段级别”的连续信息提取。其数据平台支持CAN、感知、定位、地图等多模态信号的毫秒级时间对齐,并通过规则引擎自动识别关键决策事件,输出结构化连续标签序列。同时,华为在训练端采用“时间窗滚动预测”机制,使端到端模型能够自适应地感知过去状态变化并动态调整策略,显著提升城市通勤中的跟车舒适性与安全性。

在这里插入图片描述

在这里插入图片描述

华为智能驾驶ADS版本演进

在这里插入图片描述

算法从ADS 2.0升级至ADS 3.0

ADS 3.0采用两段式端到端架构

在这里插入图片描述

亮道智能:提供工业级4D连续帧数据标注解决方案

亮道智能作为领先的自动驾驶数据服务平台,率先在国内构建了可规模化生产“4D真值数据”的工业流程体系。其服务能力主要体现在以下几个方面:

· 跨模态多帧融合标注能力:支持RGB、LiDAR、Radar、IMU等多源数据的时间同步、空间对齐和一致性校验,确保每一帧标注在上下文语义上可闭合。

· 时序一致性与目标ID跟踪机制:引入多帧插值、轨迹重建与目标追踪算法,实现关键目标在整个时间段内的ID连续性与行为一致性,满足Transformer类模型的训练要求。

亮道智能感知算法训练数据闭环

六、结语:从“数据可用”走向“语义连续”

端到端智能驾驶模型的落地之路,归根结底是一条对“行为理解”不断精进的路径,而非仅靠模型结构堆叠所能解决。正如前文所述,当模型从感知、规划、控制一体化地去学习驾驶策略时,其对数据的要求不再是“量”与“广度”优先,而是更深层次的“连续性”、“一致性”与“语义完整性”。

在这一背景下,连续帧数据的价值不止于简单的时间序列堆叠,更在于其承载了场景演化的语境逻辑。只有当数据能够真实呈现驾驶行为从观测、判断到执行的全过程,模型才有可能真正建立起对人类策略意图的理解能力。

产业实践也正朝着这一方向加速前进:从Waymo的轨迹重演,到小鹏、理想对自然行为段的高保真采样,再到亮道智能的4D语义标注能力,行业上下游正逐步形成以“语义行为”为核心的训练数据生态体系。这不仅让端到端模型更加稳健与可信,也为未来构建“有责任边界”的自动驾驶系统提供基础支撑。

因此,与其说“端到端”的挑战在模型端,不如说它是一场对数据体系结构的再定义。当我们真正实现从“帧标签”到“行为真值”的跃迁,端到端智能驾驶的商业化与规模化落地,才可能从构想走向现实。

Tesla 2021年发布基于BEV+Transformer的感知算法架构

Tesla 2022年引入Occupancy占用网络

FSD神经网络汇总

智驾数据闭环全流程介绍 借助大语言模型的能力,毫末实现了在开集场景中Zero-Shot的快速精准的自动标注。随着BEV感知技术的出现,图像特征开始从2D的透视图转换到了3D空间,输出车体世界坐标系下的3D静态或者动态的结果,而BEV需要的真值数据并且动态物体还需要考虑时序信息,由此4D标注技术成为了未来BEV+Transformer架构发展不可或缺的一部分。自动驾驶场景本身就是无界限的场景,之前用NeRF的方法建模时,都是假设场景是稳定的,对于动态场景的捕捉力度不足,在有多个动目标、光线变化的场景里,NeRF合成的图质量很差。 阅读详情

相关推荐

自动驾驶系统中的数据闭环:挑战与前景

数据闭环对于自动驾驶系统的持续进化至关重要,它通过收集corner case数据提高模型泛化能力并驱动算法迭代。然而,落地过程中面临合规性、数据确权、系统资源占用、数据处理难度、软件系统复杂度和模型训练难度等挑战。尽管存在问题,但随着技术发展,预期这些问题将被解决,从而推动自动驾驶系统向更高阶发展。

数据与算法架构提升之路专栏 2809

深度学习中端到端(end-to-end)简要理解

端到端 end-to-end

ElysiaAILab 1万+

标贝科技:自动驾驶中的数据标注类别分享

在自动驾驶、机器人导航、视频监控等领域,对动态场景中的障碍物、行人、车辆等进行标注时,考虑时间维度可以提供更加准确和完整的信息。车道线标注主要用于道路地标线的标注,其数据可用于训练和评估车道线检测、车道线跟踪、车道保持等算法,以帮助自动驾驶系统准确识别和跟踪车道线,实现车辆在道路上的稳定行驶和导航。5、图像分割:图像分割可对图片中复杂不规则类目进行标注,这些分类可能是“行人,车辆,建筑物,天空,植被等等,此外,除了区域划分,语音分割还需标注不同对象的对应属性,帮助车辆识别道路上的可行驶区域。

biaobei的博客 3003

计算机视觉的探索:从卷积神经网络到端到端训练

1.背景介绍 计算机视觉(Computer Vision)是人工智能(Artificial Intelligence)领域中的一个重要分支,其主要研究如何让计算机理解和处理人类世界中的视觉信息。随着大数据、深度学习等技术的发展,计算机视觉技术得到了巨大的推动。在这篇文章中,我们将探讨从卷积神经网络(Convolutional Neural Networks, CNNs)到端到端训练(End-to...

AI天才研究院 1491

端到端学习在机器学习领域中是一种训练模型的方法,它可以从原始输入直接学习到最终的输出,而无需手动设计特征或进行中间步骤

它的出现大大简化了模型的构建过程,提高了模型的性能和效率端到端学习在机器学习中是一种训练模型的方法,它能够直接从原始输入学习到最终的输出结果,而无需手动设计特征或进行中间步骤的处理。模型的输入层是一个展平的图像数组,隐藏层包含 128 个神经元,并使用 ReLU 激活函数,输出层包含 10 个神经元,并使用 softmax 激活函数。模型的输入层是一个展平的图像数组,隐藏层包含 128 个神经元,并使用 ReLU 激活函数,输出层包含 10 个神经元,并使用 softmax 激活函数。

BugCrusher的博客 999

基于大数据的端到端训练框架

模型从原始输入到最终输出的全链路由单一框架优化,中间无人工干预。传统图像识别:手动提取SIFT特征 → 用SVM分类;端到端图像识别:CNN直接输入像素值 → 输出类别概率(特征提取与分类由模型自动完成)。在大数据场景下,端到端训练的边界进一步扩展——不仅是模型层面的端到端,更是“数据处理→特征工程→模型训练→部署”的全流程端到端。数据层的核心目标是将多源数据转化为模型可直接使用的特征数据湖(Data Lake)

AI架构全栈开发实战笔记 831

什么是端到端训练

传统的图像识别问题往往通过分治法将其分解为预处理,特征提取和选择,分类器设计等若干步骤。分治法的动机是将图像识别的母问题分解为简单、可控且清晰的若干小的子问题。不过分步解决子问题时,尽管可以在子问题上得到最优解,但子问题上的最优解并不意味着就能得到全局问题的最后解。使用多步骤、多模型解决一个复杂任务的时候,一个明显的弊端是各个模块训练目标不一致,某个模块的目标函数可能与系统的宏观目标有偏差,这样训...

贱小杜的博客 1万+

辅助驾驶功能开发-测试篇(2)-真值系统介绍

快速构建有效感知真值,快速完成感知性能评估,快速分析感知性能缺陷。主要应用场景包括:1. 感知算法开发验证: 在算法开发周期中,评测结果可以作为测试报告的一部分,体现算法性能的提升。2. 遴选供应商: 在供应商选择过程中,可以将各供应商的评测结果作为对比的一个维度,分析各供应商的优势。

2301_78837294的博客 6698

端到端训练:颠覆性的AI模型范式

端到端训练是深度学习的革命性范式,通过构建单一可微分模型,直接将原始输入映射到最终输出。其核心突破在于四大要求:1.全局可微分性 - 确保梯度顺畅回流2.统一优化目标 - 单一损失函数3.指导全局优化3.协调特征学习 - 自动演化最优内部表示4.稳定训练动力学 - 管理梯度流保证收敛

kingnight233的博客 1446

Fluent基于低氧舱气体交换仿真(氮气与空气混合)

一、背景概述 模拟低氧舱充氮气和排除混合气体的过程,假设注入95%的氮气,舱内原有气体为空气,压力为标准大气压,温度为300K。观察气体注入过程中,舱内平均氮气和氧气浓度的变化。 二、Fluent设置 Setup 1、General type选择压力基 绝对速度 瞬态 重力勾选 2、Model 能量方程开启 组分运输开启,设置方法如下: 选择后OK,view就会变成Edit,点击Edit。然后再次点击Edit。 将组分中的非氮气氧气和空气的气体移除,右边选项需要将空气放在最后一位。 3、Materi

qq_35535616的博客 1万+

Endnote 导入参考文献的时候,格式错误太多了。et.al错误,国标GBT7714在endnote中的详细配置教程,适用于本科,硕士论文文献插入的模板

EndNote插入文献常遇到以下错误主要如下: 等、et al不分; 英文作者全名大写; 期刊名字使用了缩写(图片里没有体现;卷号、期号缺失时出现乱码,多了半个括号;页码范围略去了相同部分;没有悬挂缩进,本文全部解决,全网最细

sakura的博客 3万+

车企如何利用数据闭环服务智驾开发与测试

智能驾驶技术飞速发展,数据成为驱动自动驾驶技术进步的关键要素。如何构建高效的数据闭环以优化智驾系统的开发和测试,已成为各大车企关注的重点。

vincent_321的博客 2031

C#通过Aforge调用电脑摄像头(附代码)

C#标准库本身不带有能调用电脑摄像头的库,如果利用windows自身的API来实现的话,着实有些麻烦。Aforge这个第三方库能很好的实现调用、处理的功能。 PS:文末给大家分享了完整的项目源码,各位最好先下载下来,对照着来看 1、先看一下效果 2、Aforge介绍 AForge.NET是一个专门为开发者和研究者基于C#框架设计的,这个框架提供了不同的类库和关于类库的资源,还有很多应用程序例子,包括计算机视觉与人工智能,图像处理,神经网络,遗传算法,机器学习,机器人等领域。 3、我使用的开发环境 操作系统

weixin_44996090的博客 1万+

end to end(端到端训练)

端到端训练简单的理解就是不要预处理和特征提取,直接把原始数据扔进去得到最终结果,就是给模型更多自我调整的能力。

weixin_51015047的博客 658

SpringBoot项目整合Knife4j接口文档

写满接口信息的文档,每条接口包括:请求参数,响应参数,接口地址,接口名称,请求类型,请求格式,备注。

诨号无敌鸭的博客 1017

Spirent TestCenter 3.90吞吐测试全流程详解(附RFC 2544配置避坑指南)

本文详细解析了使用Spirent TestCenter 3.90进行网络吞吐测试的全流程,并提供了符合RFC 2544标准的配置指南与避坑要点。内容涵盖测试环境搭建、核心概念澄清、STC软件配置步骤、结果深度解读以及自动化脚本入门,旨在帮助网络测试工程师精准评估设备性能,规避常见配置陷阱。

weixin_42602368的博客 370

End-to-end_training

而端到端训练将整个任务视为一个统一的整体,通过神经网络自动学习最优的特征表示和中间步骤。例如,在图像分类中,传统的机器学习方法需要手动提取边缘、角点等特征,而端到端的深度学习模型(如卷积神经网络)可以直接从原始图像学习分类。“End-to-end training”(端到端训练)是一种深度学习方法,指的是模型从原始输入直接学习到期望输出,而无需手动设计中间特征提取或分步骤优化。RNN(循环神经网络)在端到端训练中的应用主要体现在处理序列数据的场景,例如语音识别、自然语言处理等任务。

2401_83026894的博客 798

【毕设保姆级指南】基于YOLOv8的DAGM 2007工业缺陷检测系统从搭建到落地

本教程基于YOLOv8算法实现DAGM 2007工业缺陷检测系统,包含数据处理、模型训练和可视化界面开发全流程。首先对DAGM数据集进行格式转换和划分,然后通过YOLOv8训练工业缺陷检测模型,最终构建PyQt5交互界面实现缺陷可视化检测。该系统可用于智能制造中的产品质量控制,帮助快速定位工业产品缺陷,提升检测效率和准确性,为工业质检提供高效解决方案。

LXY_LOVE36的博客 182

端到端训练是什么

端到端训练就是一条龙地把原始输入直接训练到最终输出,全流程由神经网络自动“学会”每一步怎么做,人只需要提供数据、设计合适的正反例和评价标准。这是深度学习发展后,越来越多任务追求的目标。

ttest11的博客 945

Boot过程相关镜像详解:IVT、DCD、App Boot镜像到底是什么?

S32系列芯片中常说的IVT镜像、DCD镜像等跟Boot过程相关的镜像到底是什么,镜像结构长啥样?各镜像作用是什么?主分区和备份区的概念?答案统统在这里!!

车载系统攻城狮 4251

Android Audio其他——数字音频接口(附)

数字音频接口 DAI,即 Digital Audio Interfaces,顾名思义,DAI 表示在板级或板间传输数字音频信号的方式。相比于模拟接口,数字音频接口抗干扰能力更强,硬件设计简单,DAI 在音频电路设计中得到越来越广泛的应用。

小旭的专栏 1027

什么是端到端?端到端学习

端到端学习是一种通过训练一个单一的模型来直接映射输入到输出的方法,避免了传统方法中的手工特征提取和中间步骤。这种方法通过自动化特征学习和减少复杂性,通常能够在各种任务中取得更高的性能。端到端学习已经在语音识别、图像分类、机器翻译等领域取得了显著的成果,并广泛应用于实际应用中。

爱学习_萌萌哒 9277

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

一文详解自动驾驶数据闭环 | 大数据管理!

编辑|无人驾驶俱乐部点击下方卡片,关注“自动驾驶之心”公众号ADAS巨卷干货,即可获取点击进入→自动驾驶之心【全栈算法】技术交流群数据闭环涉及较多领域,本期主题则是五大数据闭环之一的——大数据管理部分。不同等级阶段的车辆,需要采集的数据量也呈现几何级增长。以目前常见的L3阶段为例,随着4K超高清摄像头、128线激光雷达等传感器引入,每天8小时数据采集系统记录的数据量高达30TB。这么说吧,英伟...

CV_Autobot的博客 3039

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

一文带你全面了解,自动驾驶数据闭环之——大数据管理

推荐|焉知智能汽车作者 |高工(汽车主机厂ADAS研发人员)来源|无人驾驶俱乐部知圈|进“计算平台群”请加微yanzhi-6,备注计算数据闭环涉及较多领域,后续逐一研究梳理,本期主题则是五大数据闭环之一的——大数据管理部分。前面说道不同等级阶段的车辆,需要采集的数据量也呈现几何级增长。以目前常见的L3阶段为例,随着4K超高清摄像头、128线激光雷达等传感器引入,每天8小时数据采集系统...

weixin_55366265的博客 1602

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

深度学习中的一些概念

它在早期的目标检测方法中非常流行,但现代的深度学习方法,如Faster R-CNN、YOLO(You Only Look Once)和SSD(Single Shot MultiBox Detector),已经取得了更高的性能和速度,减少了对手工设计特征的依赖,使目标检测更加精确和高效。此外,端到端训练的性能通常受到神经网络架构的选择和超参数的设置的影响。总之,端到端训练是深度学习领域的一种强大方法,它强调了自动化和端到端优化,可以在许多应用中提供出色的性能,但也需要仔细的数据准备和模型设计。

maniac_ran的博客 716

一文了解“端到端”自动驾驶模型

对于华为、小鹏等国内玩家而言,大家普遍尚处于感知“端到端”、决策规划模型化阶段。参考特斯拉在2021和2022年年底的AI Day上分别公布了BEV和Occupancy Network的技术架构,“端到端”是深度学习中的概念,英文为“End-to-End(E2E)”,指的是一个AI模型,只要输入原始数据就可以输出最终结果。应用到自动驾驶领域,意味着只需要一个模型,就能把摄像头、毫米波雷达、激光雷达等传感器收集到的感知信息,转换成车辆方向盘的转动角度、加速踏板的踩踏深度以及制动的力度等具体操作指令,让汽车实现

qq_22751305的博客 1万+
上一篇: 机器人行业正被汽车内卷逻辑吞噬
下一篇: 割草机器人革命:为何高线束激光雷达是唯一的未来?
robo_lab
博客等级 码龄6年 43粉丝 10原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值