基于改进K-means的网络数据聚类算法matlab仿真

【图像分割】基于matlab GUI迭代阙值选择+最大类间差+区域生长图像分割【含Matlab源码 816期】 迭代阙值选择+最大类间差+区域生长图像分割 完整代码,直接运行,适合小白!可提供运行操作视频! 阅读详情

目录

1.程序功能描述

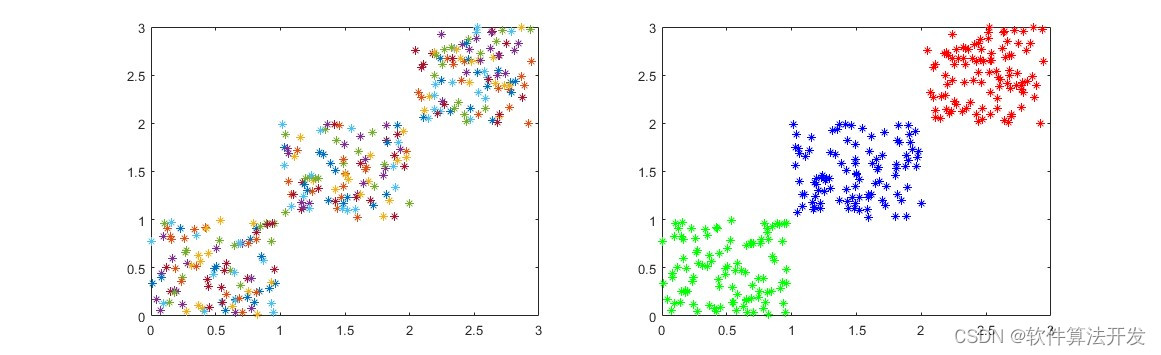
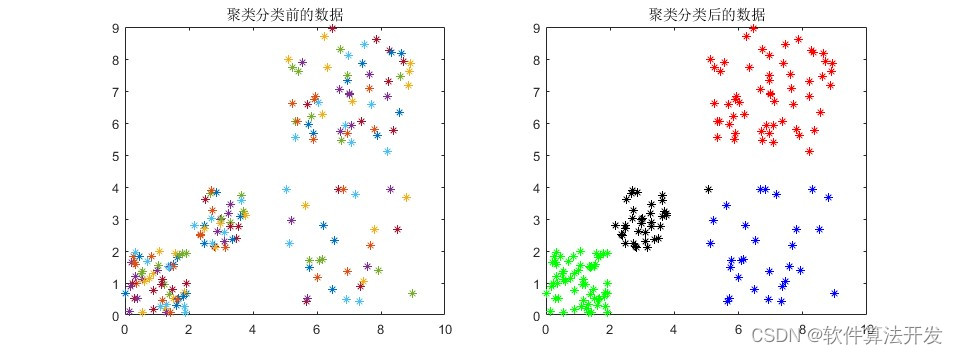
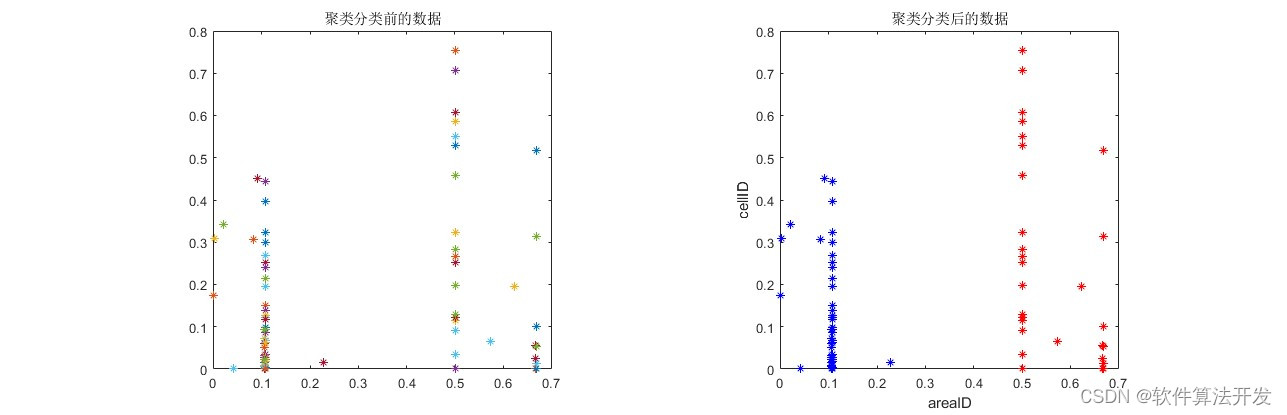
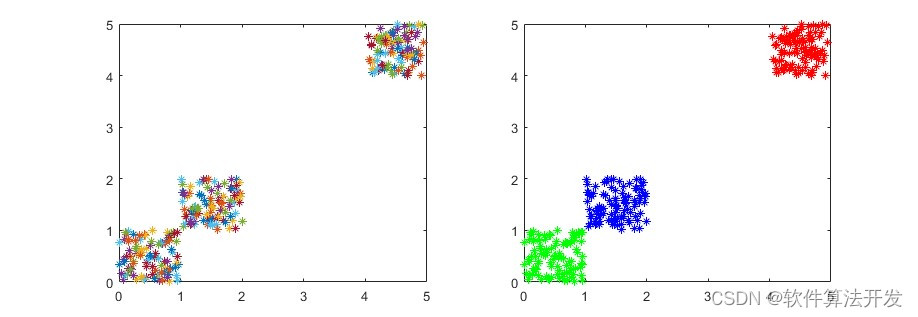
2.测试软件版本以及运行结果展示

3.核心程序

4.本算法原理

5.完整程序


1.程序功能描述

        K-means属于聚类分析中一种基本的划分方法,常采用误差平方和准则函数作为聚类准则。主要优点是算法简单、快速而且能有效地处理大数据集。研究和分析了聚类算法中的经典K-均值聚类算法,总结出其优点和不足。重点分析了K-均值聚类算法对初始值的依赖性,并用实验验证了随机选取初始值对聚类结果的影响性。根据传统的K-means算法存在的缺陷,提出了改进后的K-means算法,主要解决了孤点对聚类中心影响的问题以及K值的确认问题。

2.测试软件版本以及运行结果展示

MATLAB2022a版本运行
3.核心程序

........................................................
for  Cluster_Num = 2 : K_start
     Cluster_Num
     flags       = 0;
     Step        = 4000;
     disp('K值分类');
     %随机化定义聚类中心点
     Center      = Data_NoGD(:,1:Cluster_Num);
     %进行初始的迭代
     [KindData,KindNum] = func_Kmeans_Cluster(Center,Data_NoGD);
     NewCenter          = func_NewCenter(KindData,KindNum,row);
     %进行K值分类
     while (sum(sum(NewCenter ~= Center))) & Step
           Center             = NewCenter;
           [KindData,KindNum] = func_Kmeans_Cluster(Center,Data_NoGD);
           NewCenter          = func_NewCenter(KindData,KindNum,row);
           Step               = Step-1;
     end
     %计算距离代价
     disp('计算距离代价');
     %计算L
     disp('计算L');
     xl = NewCenter(1,:);
     yl = NewCenter(2,:);
     for j = 1 : Cluster_Num
         L(j) = sqrt((Xavg - xl(j))^2 + (Yavg - yl(j))^2);
     end


     Lsum(Cluster_Num - 1) = sum(L)*Cluster_Num;
     disp('计算D');
     %计算D
     for j = 1:Cluster_Num
         KindData_tmpx = KindData(1,:,j);
         KindData_tmpy = KindData(2,:,j);
         %去掉其中的0数值
         KindData_tmp = [KindData_tmpx;KindData_tmpy];
         if isempty(KindData_tmp) == 1
             D(i,j) = inf;
         else
             %开始统计
             for i = 1:length(KindData_tmp)
                 D(i,j) =  sqrt((KindData_tmp(1,i) - xl(j))^2 + (KindData_tmp(2,i) - yl(j))^2);
             end
         end
         clear KindData_tmp KindData_tmpx KindData_tmpy
     end
     

     Dsum(Cluster_Num - 1) = sum(sum(D))/Cluster_Num;
     %计算F(K)
     disp('计算F');
     F(Cluster_Num - 1) = Lsum(Cluster_Num - 1) + Dsum(Cluster_Num - 1);
     F
     
     
     if isfinite(F(Cluster_Num - 1)) == 0
        break;
     else

     end     
     
     
     pause(1)
     clear tmp Center KindData KindNum NewCenter Step xl yl L D 
     
end

[V,IND] = min(F);
Kopt = IND+1;
fprintf('最佳聚类值K = ');
fprintf('%d',Kopt);
fprintf('\n\n');

%使用最新的K值进行聚类分析
Cluster_Num = Kopt;
[row,col]   = size(Data_NoGD);
Step        = 1000;
%定义三个聚类中心点
Center      = Data_NoGD(:,1:Cluster_Num);
%进行初始的迭代
[KindData,KindNum] = func_Kmeans_Cluster(Center,Data_NoGD);
NewCenter          = func_NewCenter(KindData,KindNum,row);
%进行据雷锋唔系
while (sum(sum(NewCenter ~= Center))) & Step
    Center             = NewCenter;
    [KindData,KindNum] = func_Kmeans_Cluster(Center,Data_NoGD);
    NewCenter          = func_NewCenter(KindData,KindNum,row);
    Step               = Step-1;
end

func_fig(Data_NoGD,Cluster_Num,KindData);  
12_005m

4.本算法原理

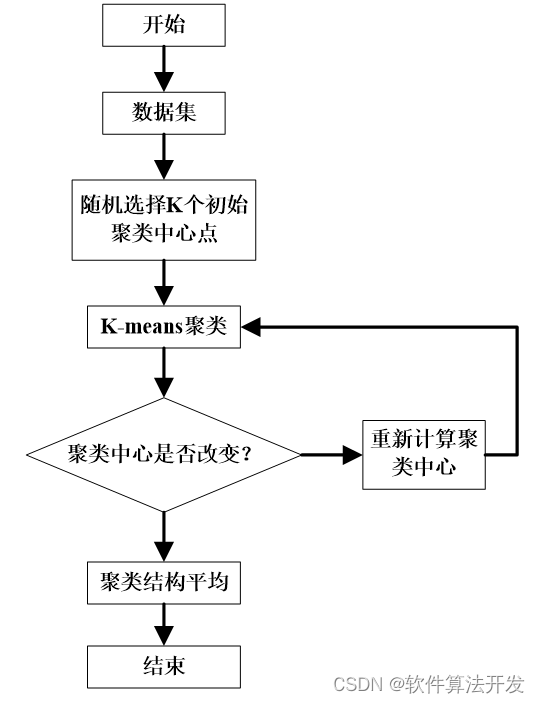
       K-means聚类算法基本思想,首先算法随机选取k个点作为初始聚类中心,然后计算各个数据对象到各聚类中心的距离,把数据对象归到离它最近的那个聚类中心所在的类;对调整后的新类计算新的聚类中心,如果相邻两次的聚类中心没有任何变化,说明数据对象调整结束,聚类准则Jc已经收敛。K-means聚类算法的一个特点是在每次迭代中都要考察每个样本的分类是否正确,若不正确,就要调整。在全部数据调整完后,再修改聚类中心,进入下一次迭代。如果在一次迭代算法中,所有的数据对象被正确分类,则不会有调整,聚类中心也不会有任何变化,这标志着Jc已经收敛,至此算法结束。本文重点对K-均值聚类算法进行了研究分析,并在K-均值聚类算法的基础上提出了改进。

       K-means聚类算法是硬聚类算法,是典型的基于原型的目标函数聚类分析算法点到原型——簇中心的某种距离和作为优化的目标函数,采用函数求极值的方法得到迭代运算的调整规则。K-means聚类算法以欧氏距离作为相异性测度它是求对应某一初始聚类中心向量最优分类,使得评价指标E值最小。
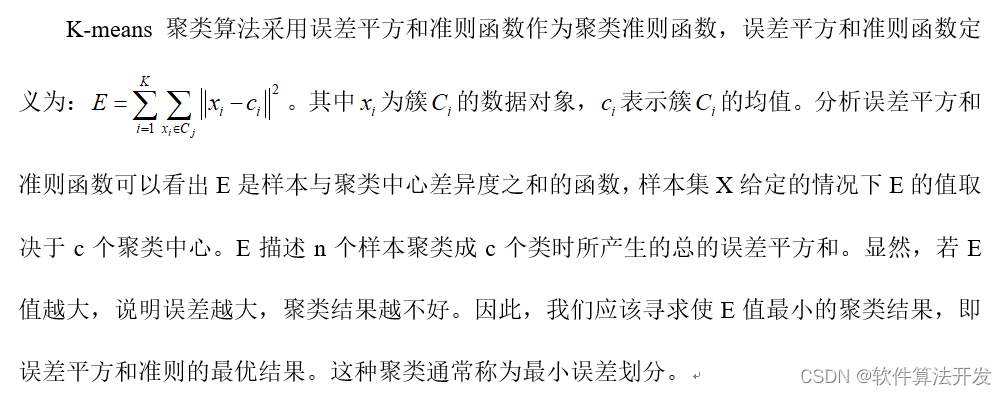
       误差平方和准则函数适用于各类样本比较集中而且样本数目悬殊不大的样本分布。当不同类型的样本数目相差较大时,采用误差平方和准则。很可能把样本数目多的类分开,以便达到总的误差平方和最小。

整个算法的基本流程如下图所示:
5.完整程序

VVV

一种改进的K-means算法 这是一个基于matlab语言的K-means算法的改进程序,代码完整易懂,里面包含有实际的数据集,能有利于对K-means算法感兴趣的研究学者或者开发人员 立即下载

相关推荐

模式识别 改进的K-Means++算法 实现模式分类

基于Matlab实现: 模式识别 改进的K-Means++算法 实现模式分类

【机器学习】K-Means算法及多种优化改进算法,聚类模型评估,附带案例代码

一、聚类分析 聚类分析是根据在数据中发现的描述对象(数据)及其关系的信息,将数据划分成有意义或有用的组(簇)。其目标是: 组内的对象相互之间是相似的(相关的),而不同组中的对象是不同的(不相关的); 组内的相似性(同质性)越大,组间差别越大,聚类就越好。 聚类可以看作是一种分类,它用簇标号创建对象的标记。然而,只能从数据中导出这些标记,它与分类(例如分类决策树等)不同,分类是监督分类,即使用...

Daycym的博客 2万+

Zephyr RTOS详解

Zephyr 是一个开源的实时操作系统(RTOS),专为资源受限的嵌入式设备设计,支持多种架构(如 ARM Cortex-M、RISC-V、x86 等)。

weixin_43484713的博客 4112

kmeans改进 matlab,基于距离函数的改进k―means 算法

摘要:聚类算法在自然科学和和社会科学中都有很普遍的应用,而K-means算法是聚类算法中经典的划分方法之一。但如果数据集内相邻的簇之间离散度相差较大,或者是属性分布区间相差较大,则算法的聚类效果十分有限。本文基于离散度的思想,采用新的加权距离函数代替了传统算法的欧氏距离,在一定程度上优化了k-means算法的聚类结果。关键词:聚类;k-means算法;离散度中图分类号:TP18 文献标识码:A 文...

weixin_26805597的博客 1050

GD32F103实战:用ADC+DMA实现高精度多通道电压采集与OLED实时显示(附完整工程)

本文详细介绍了如何利用GD32F103的ADC+DMA技术实现高精度多通道电压采集,并通过OLED实时显示数据。文章包含硬件架构设计、ADC配置技巧、DMA传输优化及显示系统实现方案,提供完整工程代码和调试指南,适用于工业传感器和环境监测设备开发。

weixin_42567497的博客 403

无法联网的情况下,dbeaver离线安装数据库驱动-clickhouse

无法联网的情况下,dbeaver离线安装数据库驱动-clickhouse

u012831187的博客 1万+

基于K-means聚类算法的无线传感器网络分簇路由协议

一、算法设计 在无线传感器网络中使用时,k-means将按以下步骤实现: (1)选择kkk个质心; (2)根据欧几里德距离,根据到质心的距离将节点分组到不同的组中; (3)通过获取分配给该质心簇的所有数据点的平均值,再次选择每个簇中的新质心; (4)如果新质心与过去的位置不同,则重复步骤(2)和(3),直到满足停止标准(也就是说,距离的总和被最小化,或者达到一些最大迭代次数); (5)结束聚类。 步骤(2)中,用来分组的标签labelilabel_ilabeli​通过以下公式计算:labeli=argmin

心升明月的博客 5656

vivado2025安装教程:手把手带你完成环境配置

详细讲解vivado2025的安装步骤与环境配置技巧,帮助开发者快速搭建FPGA开发平台。涵盖常见问题解决方案,确保vivado2025稳定运行,提升开发效率。

weixin_42588672的博客 3044

【聚类分析 】鲸鱼算法WOA-K-means++聚类优化算法Matlab实现

聚类分析作为一种无监督学习方法,在数据挖掘、模式识别等领域有着广泛的应用。其目标在于将数据样本划分成若干个不同的簇,使得簇内样本具有较高的相似度,而簇间样本的相似度较低。K-means算法作为一种经典的聚类算法,因其简单高效而备受关注。然而,K-means算法的性能严重依赖于初始聚类中心的选取,容易陷入局部最优解。为了克服这一缺点,K-means++算法被提出,它通过一种概率化的方式选择初始聚类中心,有效地提高了聚类结果的质量。然而,K-means++算法仍然存在收敛速度慢以及对参数K敏感的问题。

Matlab245的博客 897

基于libVLC的视频播放器之四:直接使用libVLC

一.效果 播放本地文件 播放网络url:rtsp://3.84.6.190/vod/mp4:BigBuckBunny_115k.mov 二.实现 既然有VLC-Qt,为什么还要直接调用libVLC呢,因为直接调用会加深对整个播放流程的理解,方便后面修改VLC-Qt源码。 注意事项: 1.编译报错:error C2065: “libvlc_media_read_cb”: 未声明的标识符。修改如下: 2.libvlc_new(0, nullptr)返回null 将plugins

草上爬的博客 5051

RK3568下GPIO模拟串口

在嵌入式开发中,硬件 UART 资源可能被其他外设占用。此时,通过 GPIO 模拟 UART(软串口)成为一种灵活的解决方案。本文基于 RK3568 平台,结合 Linux 内核模块,实现高精度软串口通信,并深入分析关键技术细节。可以看到已经接收到数据了,可以自己创建自定义的设备文件到/dev下,也可以按照串口设备的标准创建一个设备,后面有时间我写一篇和标准串口设备结合的gpio模拟串口文章。RK3568 GPIO 模拟串口(软串口)实现详解。将编译好的驱动放到板子上运行。再写个Makefile。

文石_2009的博客 366

【图像聚类】基于matlab GUI K-means算法图像聚类【含Matlab源码 1787期】

K-means算法图像聚类 完整代码,直接运行,适合小白!可提供运行操作视频!

订阅付费专栏Matlab(奶茶价版),可赠送奶茶价版付费专栏指定代码1份; 4313

基于RK3588与昇腾310B的异构K8s集群部署与NPU统一调度实战

本文介绍了基于RK3588与昇腾310B的异构K8s集群部署方案,通过HAMi+Volcano实现NPU统一调度。方案包含硬件配置、操作系统准备(银河麒麟/欧拉)、容器运行时部署及K8s集群搭建等关键步骤,支持多厂商NPU设备的统一抽象和精细化切分,为边缘AI计算提供高效资源管理能力。

huanghm88的专栏 281

【图像分割】基于聚类的乳腺肿瘤分割算法:k-means、模糊 c-means 和优化 k-means附matlab代码

乳腺癌是全球女性最常见的恶性肿瘤之一,早期诊断对提高患者生存率至关重要。医学图像分析,特别是乳腺超声或 mammography 图像的分割,在辅助诊断中扮演着关键角色。准确分割出肿瘤区域能够帮助医生更有效地评估肿瘤大小、位置和形态,从而制定更精准的治疗方案。本文将探讨基于聚类的图像分割方法在乳腺肿瘤分割中的应用,重点比较k-means算法、模糊c-means算法以及优化后的k-means算法,并提供相应的Matlab代码示例。一、基于聚类的图像分割方法概述。

Matlab_jiqi的博客 1029

DeepSeek如何构建可扩展的 AI 驱动交易系统,基于 MetaTrader 5 与 Python 利用先进的数据处理、机器学习和容器化部署来优化算法交易。

MT5 Python API 架构设计分为三层:通信层:利用异步消息传递(例如 ZeroMQ 或标准套接字编程)支持每秒数万个数据请求。转换层: C++ 动态库有效地将 MT5 命令转换为 Python 对象(反之亦然),从而优化速度和内存使用率。接口层:提供Pythonic API,封装了所有终端功能,包括:1)实时价格订阅(滴答或秒级更新)2)历史数据检索(从M1到更高的时间范围)3)订单流监控(交易详情和市场深度)4)策略执行引擎(用于算法交易)

iCloudEnd的博客 1387

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

【图像分割】基于matlab k-means、模糊c-means 和优化k-means聚类的乳腺肿瘤分割【含Matlab源码 8986期】

k-means、模糊c-means 和优化k-means聚类的乳腺肿瘤分割 完整代码,包运行;可提供运行操作视频!适合小白!

Matlab912100926的博客 930

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

【图像分割】k-means、模糊c-means 和优化k-means聚类的乳腺肿瘤分割【含Matlab源码 8986期】

k-means、模糊c-means 和优化k-means聚类的乳腺肿瘤分割 完整代码,包运行;可提供运行操作视频!适合小白!

订阅付费专栏Matlab(奶茶价版),可赠送奶茶价版付费专栏指定代码1份; 670

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

m基于K-means聚类算法和神经网络的模糊控制器设计matlab仿真

聚类就是按照某个特定标准把一个数据集分割成不同的类或簇,使得同一个簇内的数据对象的相似性尽可能大,同时不在同一个簇中的数据对象的差异性也尽可能地大。根据层次分解的顺序是自底向上的还是自上向下的,层次聚类算法分为凝聚的层次聚类算法和分裂的层次聚类算法。在模糊神经网络设计中,模糊规则的建立是系统设计的瓶颈问题,所以有关神经网络与模糊系统相结合的研究大多集中在模糊神经网络的建模,模糊神经网络结构和算法的研究是国内外学者研究的热点,新模糊神经网络模型和学习算法不断涌现。输入:包含n个对象的数据和簇的数目k;

fpga/matlab/simulink算法仿真工程 1052

【深度学习】基于 K-means 聚类算法的图像区域分割附Matlab代码

图像分割是计算机视觉领域一项至关重要的任务,其目标是将图像划分为具有语义或视觉意义的互不重叠的区域。图像分割技术广泛应用于医学图像分析、自动驾驶、遥感图像解译等多个领域。近年来,深度学习技术在图像分割领域取得了显著进展,但传统的聚类算法,如K-means,由于其实现简单、计算效率高,在某些场景下仍然具有一定的应用价值。本文将深入探讨基于K-means聚类算法的图像区域分割方法,分析其原理、优势、局限性以及可能的改进方向。K-means聚类算法原理。

matlab_daizuo的博客 1350
上一篇: 通过MATLAB分别对比二进制编码遗传优化算法和实数编码遗传优化算法
下一篇: 基于粒子群优化的图像融合算法matlab仿真
软件算法开发
博客等级 码龄3年 2138粉丝 246原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

软件算法开发

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值