一次性讲清楚大模型王者 Qwen3 系列的 17 个模型,大模型入门到精通,收藏这篇就足够了!

【Ai教程】Ollma安装 | 0代码本地运行Qwen大模型,保姆级教程来了! 我们平时使用的ChatGPT、kimi、豆包等Ai对话工具,其服务器都是部署在各家公司的机房里,如果我们有一些隐私数据发到对话中,很难保证信息是否安全等问题,如何在保证数据安全的情况下,又可以使用大预言模型,Ollma(哦拉玛)可以告诉你答案! 阅读详情
AI摘要

本文详细介绍了Qwen3系列模型的发展历程及17个模型的特点,涵盖不同阶段的性能对比和适用场景。同时提供本地部署方法、学习路径以及丰富的学习资源,帮助用户从入门到精通大模型。

Qwen3 模型发展历程

第一阶段

2025年4月29日,阿里推出了 Qwen3 模型,包含8个模型,覆盖各种 GPU 要求。

    1. 两个 MoE 模型:Qwen3-235B-A22B 和 Qwen3-30B-A3B
    1. 六个 Dense 模型:Qwen3-32B、Qwen3-14B、Qwen3-8B、Qwen3-4B、Qwen3-1.7B 和 Qwen3-0.6B

其中 Qwen3-235B-A22B 是最优模型,各项评分超过 DeepSeek-R1、Qwen32B 和 OpenAI-o1,与 Gemini-2.5-Pro 的比较中,各有优势,官方比较指标如下:
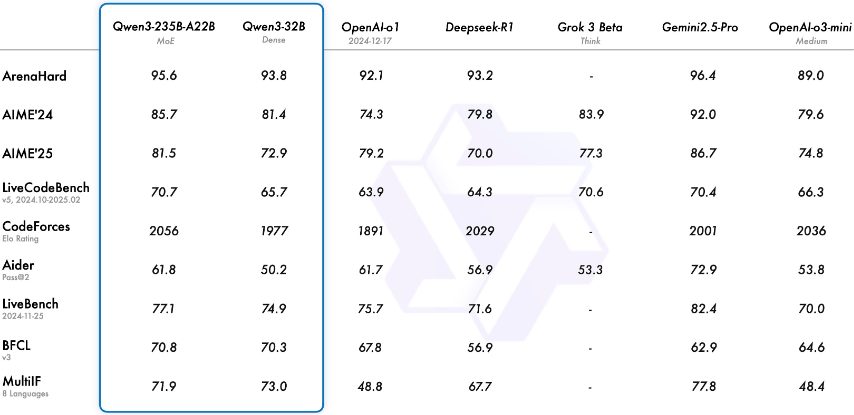
Qwen3-30B-A3B 相较于上一代的 Qwen32B,也更胜一筹。
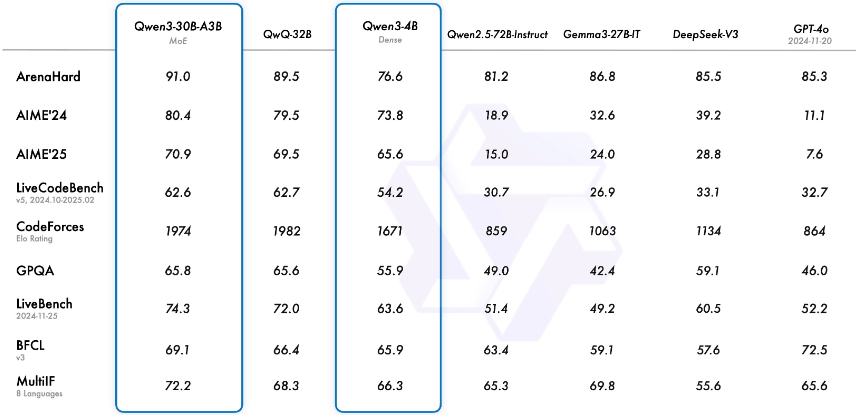
综合官方的比较,发现 Qwen3 的8个模型的从优到劣分别是:Qwen3-235B-A22B > Qwen3-32B > Qwen3-30B-A3B > …,本地24G显存可以部署 Qwen3-32B 和 Qwen3-30B-A3B 的量化版。

第二阶段

2025年7月21日到8月8日,阿里推出了 Qwen3 的升级模型,核心包含6个模型。

    1. Qwen3-235B-A22B-Instruct-2507 和 Qwen3-235B-A22B-Thinking-2507,是针对上一代旗舰模型 Qwen3-235B-A22B 的升级,前者是非思考模式,后者是思考模式模型。是新的旗舰模型。
    1. Qwen3-30B-A3B-Instruct-2507 和 Qwen3-30B-A3B-Thinking-2507,是针对 Qwen3-30B-A3B 的升级,前者是非思考模式,后者是思考模式模型。
    1. Qwen3-4B-Instruct-2507 和 Qwen3-4B-Thinking-2507,是针对 Qwen3-4B 的升级,前者是非思考模式,后者是思考模式模型。

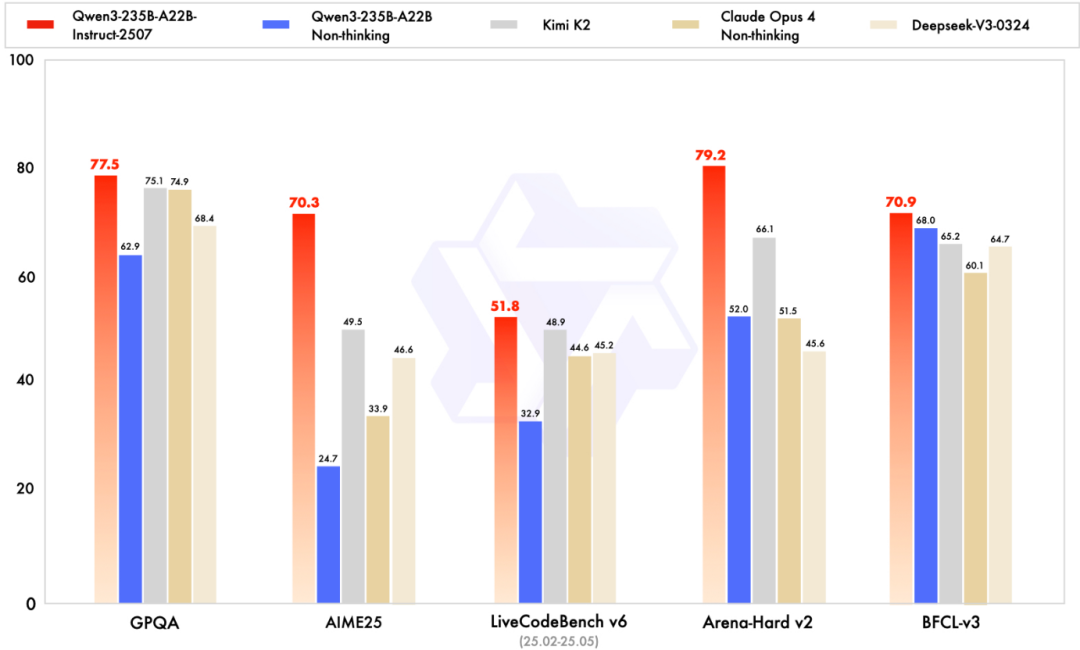
其中 Qwen3-235B-A22B-Instruct-2507 与其他开闭源模型的性能对比如下,可以说是遥遥领先。
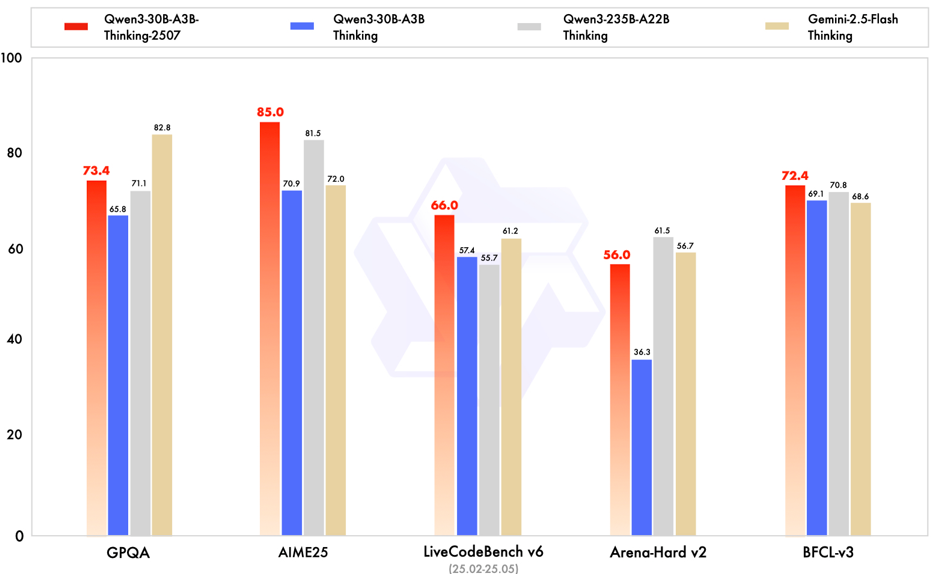
Qwen3-30B-A3B-Thinking-2507 的性能评测图如下,在大部分场景超过了上一代的 Qwen3-235B-A22B 模型的思考模式。
Qwen3-30B-A3B-Instruct-2507 的性能评测图如下,全面大幅度超过了上一代的 Qwen3-235B-A22B 模型非思考模式。
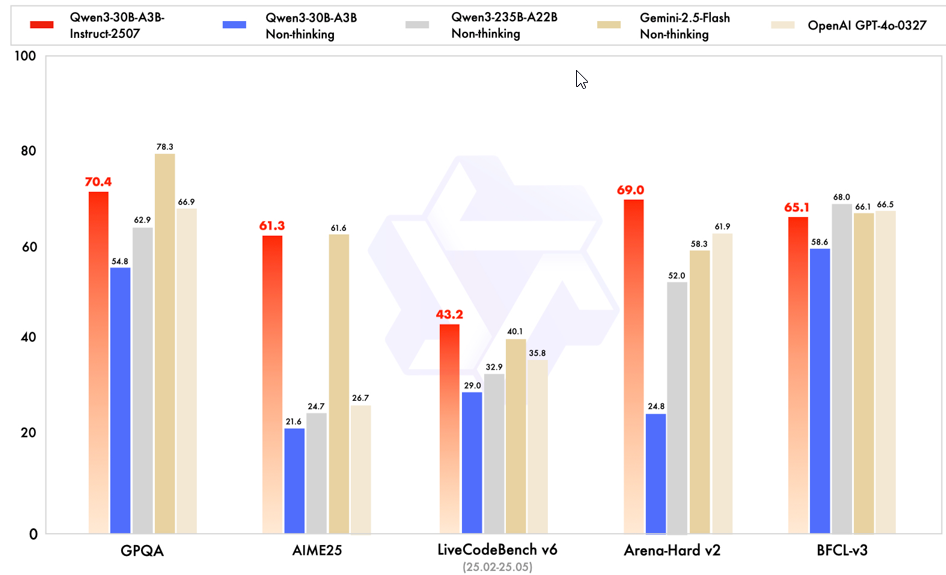
本地24G显存最高可以部署 Qwen3-30B-A3B-Instruct-2507 和 Qwen3-30B-A3B-Thinking-2507 的量化版本。

除了以上的通用模型之外,Qwen3 还提供了两个垂类编码模型 Qwen3-Coder-480B-A35B-Instruct 和 Qwen3-Coder-30B-A3B-Instruct

第三阶段

2025年9月5日,阿里推出了当前系列的最强模型 Qwen3-Max-Preview,估计很快就会推出 Qwen3-Max 正式版,该模型具有1万亿参数,是同系列 Qwen3-235B-A22B 参数的四倍。官方测评如下,超过了 Qwen3-235B-A22B-Instruct-2507/Kimi K2/Claude Opus4/Deepseek-V3.1

该模型当前可以在 https://chat.qwen.ai/ 免费使用。

综上所述,如果是远程使用模型,则可以选择 Qwen3-Max-Preview;如果是本地使用模型,24G 显存可以选择 Qwen3-30B-A3B-Instruct-2507 和 Qwen3-30B-A3B-Thinking-2507 的量化版本。

本地使用

通过 ollama 进行安装,确保先安装过 ollama,若无,先参考 https://www.aileading.cn/docs/llm/ollama.html 安装 ollama。

在 ollama 官网 https://ollama.com/library/qwen3 选择一个适合自己显存的模型进行下载。下载的过程中,如果发现突然变慢,可以 ctrl+c 终止下载流程,之后继续使用如下命令进行下载(会接着之前的进度)

复制命令,在 cmd 中执行,即可下载并运行模型

ollama run qwen3:30b-a3b-thinking-2507-q4_K_M

如果模型没有下载过,则会先下载模型,再运行。简单测试:

>>> 0.8和0.11谁大
0.8 比 0.11 大。

### 解释:
- 0.8 可以写成 0.80(小数点后补零,便于比较)。
- 比较小数部分:0.80 的十分位是 8,0.11 的十分位是 1。
- 8 > 1,因此 0.80 > 0.11。
- 用分数验证:0.8 = 80/100,0.11 = 11/100,80/100 > 11/100。

所以,**0.8 > 0.11**。
(简单来说:0.8 是 8 个十分之一,0.11 是 11 个百分之一,相当于 1.1 个十分之一,所以 0.8 更大。)

目前在终端中就可以使用 Qwen3 模型了,但是终端的界面不太友好,接下来通过 PageAssist 图形化界面进行使用,关于 PageAssist 的安装和使用见 https://www.aileading.cn/docs/llm/page-assist.html。也可以使用 OpenWebUI 图形界面使用,关于 OpenWebUI 的安装和使用见 https://www.aileading.cn/docs/llm/open-web-ui.html

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

本地/服务器部署Dify傻瓜式教程 ​之前在AI大模型生态最态势及相关技术-25.5.27-优快云博客中提到了搭建AI Agent新贵平台 Dify,在从意识里懂一下Dify-优快云博客进一步对Dify进行了介绍。 今天以简单易懂的方式讲解一下怎么在本地/服务器上部署Dify(下二、3),添加不同模型供应商的大模型,以及实践过程中遇到的问题。 阅读详情

相关推荐

开源模型应用落地-工具使用篇-Ollama(六)

Ollama集成QWen1.5系列模型,全网唯一,绝非搬运。

以微薄之力,予他人些许温暖. 2万+

从零开始之Dify部署篇

Dify传送门。本系列文章从零开始探索Dify的功能及搭建过程。本文的搭建流程是基于Docker Compose进行部署。

u013563715的博客 7万+

【SABRE 3D, SABRE 3DxT,LAM设备】2025年9月13日-安全配置-准备工作

请遵循本规程将SABRE 3D/3DxT/3D Scimitar系统设置为安全配置,以便能够在电镀单元、APT模块、XMM(或SRD)模块、工厂接口(FI)外壳或中央通道内部及周边区域执行作业p104-p117。在生产过程中暂停调度程序存在一定风险:若待维护模块未离线且在其他模块完成处理前重启调度程序,可能对生产晶圆造成影响。维护人员需特别注意电镀模块内的晶圆状态,并尽可能快速地恢复调度程序。确认待维护模块内无晶圆滞留暂停调度程序并将相应模块设置为离线状态打开模块检修门并关闭安全盖板(槽位)

weixin_46735260的博客 1368

一文带你入门 MCP(模型上下文协议)

Model Context Protocol (MCP) 是一个开放协议,它使 LLM 应用与外部数据源和工具之间的无缝集成成为可能。无论你是构建 AI 驱动的 IDE、改善 chat 交互,还是构建自定义的 AI 工作流,MCP 提供了一种标准化的方式,将 LLM 与它们所需的上下文连接起来。目前,MCP 已经积累了足够的临界规模和动能,因此它被视为 2023-2025 年“代理开放标准”之争的潜在赢家。

kuokay的博客 3万+

使用 Python 获取实时港股行情数据

在本教程中,你将学习如何通过 Infoway API 获取港股实时行情数据,具体以腾讯控股(0700.HK)和汇丰控股(0005.HK)为例,使用 Python 进行数据请求和解析。

kk_stoper的博客 1517

激光雷达测距方式全解析:ToF、三角测距和FMCW到底怎么选?

本文深度解析激光雷达三种主流测距方式(ToF、三角测距和FMCW)的技术原理、环境适应性和成本模型,提供场景化选型决策指南。通过对比各技术在精度、抗干扰能力和维护成本等方面的表现,帮助工程师在自动驾驶、工业检测和消费电子等领域做出最优选择。

qqq44的博客 719

大模型王者Qwen3系列全解析:17个模型详解与应用指南

本文全面解析阿里大模型Qwen3系列17个模型的发展历程、性能对比与应用场景。从初始8个模型到最新Qwen3-Max-Preview,详细介绍了各模型特点及适用场景。同时提供了本地部署指南,包括Ollama安装和图形界面使用方法,帮助开发者根据显存条件选择合适模型进行开发应用。

大模型训练 4147

深入解析STM32F103R6的USB OTG_FS双重角色设备(DRD)设计与应用

本文深入解析了STM32F103R6的USB OTG_FS双重角色设备(DRD)设计与应用。详细阐述了其作为USB主机和设备双重角色的硬件设计要点,包括VBUS电源管理与ID引脚配置,并提供了设备模式(如虚拟串口CDC)与主机模式(如读取U盘文件)的软件实现实战指南,帮助开发者充分发挥该芯片的OTG潜力。

weixin_29195615的博客 265

AI大模型王者Qwen3全解析:从零基础入门到精通,17个模型一次性讲透!

文章详细介绍阿里Qwen3系列大模型的发展历程,涵盖三个阶段共17个模型,包括通用模型和垂类编码模型。内容包含各模型性能对比、适用场景分析,以及通过ollama和图形界面PageAssist/OpenWebUI进行本地部署的具体步骤,帮助读者根据显存需求选择合适模型,实现从远程使用到本地部署的全方位指导。

2401_85375298的博客 1643

python -- 海洋气象科研论文中常用绘图配色汇总

当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。可以通过自定义选取不同颜色的rgb,通过自定义的方式构建colormap。

weixin_68789096的博客 972

SPMI协议学习总结

SPMI(System Power Management Interface)是由MIPI(Mobile Industry Processor Interface)联盟定义的一种硬件接口标准,它主要用于移动设备中,连接SoC(System on Chip)处理器系统的集成电源控制器与一个或多个电源管理IC(PMIC),以实现精确的电源管理

歌颂苦难的行为是无耻的; 1082

大模型王者Qwen3全解析:17个模型详解+本地部署指南!大模型部署

文章详细介绍了阿里Qwen3大模型系列的发展历程,分为三个阶段共17个模型,包括通用模型和垂类编码模型。其中Qwen3-Max-Preview是当前最强模型,具有1万亿参数。文章还提供了本地部署指南,24G显存用户可通过ollama部署Qwen3-30B-A3B-Instruct/Thinking-2507的量化版本,并使用PageAssist或OpenWebUI等图形化界面进行交互。

Trb701012的博客 1566

SIWAVE+ADS提取PCB走线寄生参数

本文将介绍一种很适合PCB走线提取寄生电感等参数的方法,即是通过SIWAVE将PCB走线的S参数提取出来,再通过ADS将S参数转换成电感、电容值。

sinat_15150363的博客 1765

Qwen3真香!不愧为目前最强开源模型!(附本地部署教程)大模型入门到精通,收藏这篇就足够了!

开源大模型新的王者,继Claude 3.7 Sonnet、Gemini 2.5家族后全球唯三的混合推理模型,也是国内首款“混合推理模型”,正式发布。

DEVELOPERAA的博客 1395

Unity引擎开发:复杂动作系统_动作捕捉数据的应用与整合

通过以上步骤,我们可以在Unity中有效地应用和整合动作捕捉数据,以实现更加真实和流畅的动画效果。从导入文件格式的选择,到预处理和优化,再到实时应用和调试验证,每一步都至关重要。希望本文能帮助你在Unity项目中更好地利用动作捕捉数据,提升动画质量和性能。

chenlz2007的博客 958

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

“小模型”大能力:Qwen3-30B-A3B-Instruct,大模型入门到精通,看这篇就足够了

我们就结合 Qwen3 的技术报告,深度剖析 Qwen3-30B-A3B 这款模型,看看它是如何通过精巧的设计,实现“小激活参数,大模型能力”的。

Y525698136的博客 2965

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

国产大模型新王者?Qwen3全面升级,引爆开源竞速!

阿里通义千问近日宣布更新旗舰版Qwen3模型,专注"快思考"的Instruct模型,追求的是在指令遵循、文本理解和知识问答等任务上实现更快、更准,实现更极致的性能表现。

weixin_50197960的博客 1923

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

一键部署DeepSeek-R1等1700+顶级AI大模型,这个神器太强了,大模型入门到精通,收藏这篇就足够了!

一键部署DeepSeek-R1等1700+顶级AI大模型,这个神器太强了,大模型入门到精通,收藏这篇就足够了!

DEVELOPERAA的博客 757

【收藏必学】40亿参数屠榜王者!Qwen3-VL-4B:多模态大模型入门到实践

Qwen3-VL-4B是阿里通义千问团队推出的40亿参数轻量级多模态大模型,在多个国际评测榜单中超越700B+竞品登顶。其采用Interleaved-MRoPE架构和DeepStack视觉融合技术,支持32语种OCR和256K上下文,可部署于消费级设备。该模型已开源,适用于智能客服、教育辅助、工业巡检等多场景,为开发者提供强大且易于集成的多模态解决方案。

datian1234的博客 728

多模态大模型王者Qwen3-VL本地部署完全指南:从零开始上手教程

本文详细介绍了多模态大模型Qwen3-VL的本地部署与使用方法,包括模型选择、安装配置、运行参数设置等。重点推荐24G显存下部署Qwen3-VL-8B-Thinking模型,并详细阐述了其视觉编码增强、空间感知、长上下文理解等核心功能。文章提供了完整的安装步骤和运行指南,帮助读者快速上手这一先进的多模态大模型。

2401_84494441的博客 4055

世界开源模型排行榜,(非常详细)零基础入门到精通,收藏这篇就够了

现在大模型竞技场可谓龙争虎斗。之前阿里云的通义千问发布全球性能最强开源模型Qwen2-72B,就第一时间给大家介绍过。想不到时隔半月,全球著名开源平台huggingface的联合创始人兼首席执行官Clem在社交平台宣布,来自中国的Qwen2-72B指令微调版本,成为全球开源模型排行榜第一名。

Javachichi的博客 1283

史上最强”MCP大模型“?一文解析开源大模型当之无愧的王——Qwen3

本篇分享结合实践案例和官方报告,向大家分享Qwen3模型种类丰富,性能强劲,MCP支持性能优异,模式转换等核心亮点,分析Qwen3如何推动人工智能大模型从“参数竞赛”迈向“效率革命”!

weixin_42782643的博客 2379

开源嵌入新王落地!Qwen3-Embedding 本地部署指南 + Dify 召回测试实录

前两天,通义千问推出的 Qwen3-Embedding 系列模型(包括8B、4B和0.6B三个版本)在权威评测中表现惊艳,尤其在多语言任务和长上下文处理能力上全面超越主流竞品,成为开源嵌入模型的新王者。 多尺寸全能选手,全面碾压BGE-M3!

Gaga246的博客 3486

世界开源模型排行榜,零基础入门到精通,收藏这篇就够了

现在大模型竞技场可谓龙争虎斗。之前阿里云的通义千问发布全球性能最强开源模型Qwen2-72B,就第一时间给大家介绍过。想不到时隔半月,全球著名开源平台huggingface的联合创始人兼首席执行官Clem在社交平台宣布,来自中国的Qwen2-72B指令微调版本,成为全球开源模型排行榜第一名。

Python_0011的博客 1144

通义千问 Qwen2,登顶国内第一大模型!

大家好,我是煎鱼。7 月 9 日起,OpenAI 将正式终止对部分地区(包含中国)提供 API 服务,引起业内一片哗然,纷纷开始自检,找新的国内可用的国产化替代方案。此时我有一个朋友的 Boss,结合各家大模型的表现和价格(性价比),推荐了阿里云的通义千问。尤其是提起最近新出的开源大模型 Qwen2 系列。非常强!今天特意了解了下,做一个快速的介绍分享。通义千问 Qwen22024 年 6 月 7...

EDDYCJY的博客 4014

2025年国产AI模型深度测评:文心大模型4.5、DeepSeek、Qwen3能力大比拼,谁才是国内AI大模型王者?

通过这次全面的对比测试,我发现每个模型都有自己的特色和优势。DeepSeek在数学推理和代码生成方面表现突出,Qwen3在多模态能力和企业服务方面有着不错的表现。而文心一言在这次测试中给我留下了深刻印象,特别是在语言理解的细致度、逻辑推理的严谨性,以及专业领域知识的全面性方面都表现得相当出色。无论是情感分析的准确性,还是医学、法律等专业领域问答的深度和实用性,都展现出了不错的水准。当然,AI技术发展日新月异,每个模型都在不断迭代优化。

jennycisp的博客 3742
上一篇: 地表最强SGLang部署本地Qwen3-32B大模型--实战教程,大模型入门到精通,收藏这篇就足够了!
下一篇: DeepSeek-V3.1发布,Agent实力如何?大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
