地表最强SGLang部署本地Qwen3-32B大模型--实战教程,大模型入门到精通,收藏这篇就足够了!

【Ai教程】Ollma安装 | 0代码本地运行Qwen大模型,保姆级教程来了! 我们平时使用的ChatGPT、kimi、豆包等Ai对话工具,其服务器都是部署在各家公司的机房里,如果我们有一些隐私数据发到对话中,很难保证信息是否安全等问题,如何在保证数据安全的情况下,又可以使用大预言模型,Ollma(哦拉玛)可以告诉你答案! 阅读详情
AI摘要

本文详细介绍了如何在本地部署Qwen3-32B大模型,包括下载模型、拉取镜像、启动服务及多种使用方式。重点讲解了Docker配置、参数设置和推理优化方法,适合初学者到进阶者参考。

前言

在企业中部署大模型,相信各位都有 ”数据不出库“ 的需求。
想用大模型的能力,又要保证数据安全。
有 且只有一条出路:本地部署大模型。

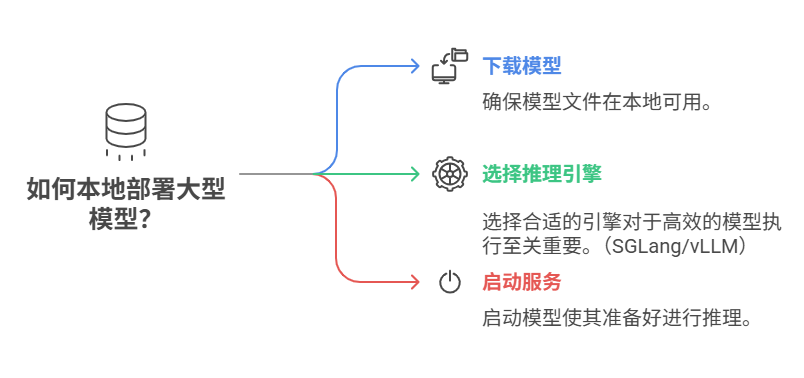
本地部署大模型,只需三步:下载模型–选推理引擎–启动服务
硬件要求

  • • 显存:至少需 2*24GB(如 RTX 3090/4090)以支持 32B 模型的运行
  • • 内存:建议 32GB 以上,若使用混合推理(GPU+CPU)则需更高内存
  • • 存储:模型文件约 20GB,需预留 30GB 以上的硬盘空间

一、下载模型

[ModelScope / Huggingface] 两个方式,任君二选一

1.1 ModelScope

安装包

pip install -U modelscope

代码下载

from modelscope import snapshot_download
model_dir = snapshot_download('Qwen/Qwen3-32B',cache_dir='/NV/llm_models/Qwen/Qwen3-32B')

1.2 Huggingface

安装包

pip install -U huggingface_hub

添加环境变量,就不存在“需要科学”的问题

export HF_ENDPOINT=https://hf-mirror.com

代码下载

# 代码下载
from huggingface_hub import hf_hub_download
hf_hub_download(repo_id="Qwen/Qwen3-32B",local_dir='/NV/llm_models/Qwen/Qwen3-32B')

或命令行下载

huggingface-cli download Qwen/Qwen3-32B --local-dir /NV/models_hf/Qwen/QwQ-32B/

二、拉镜像

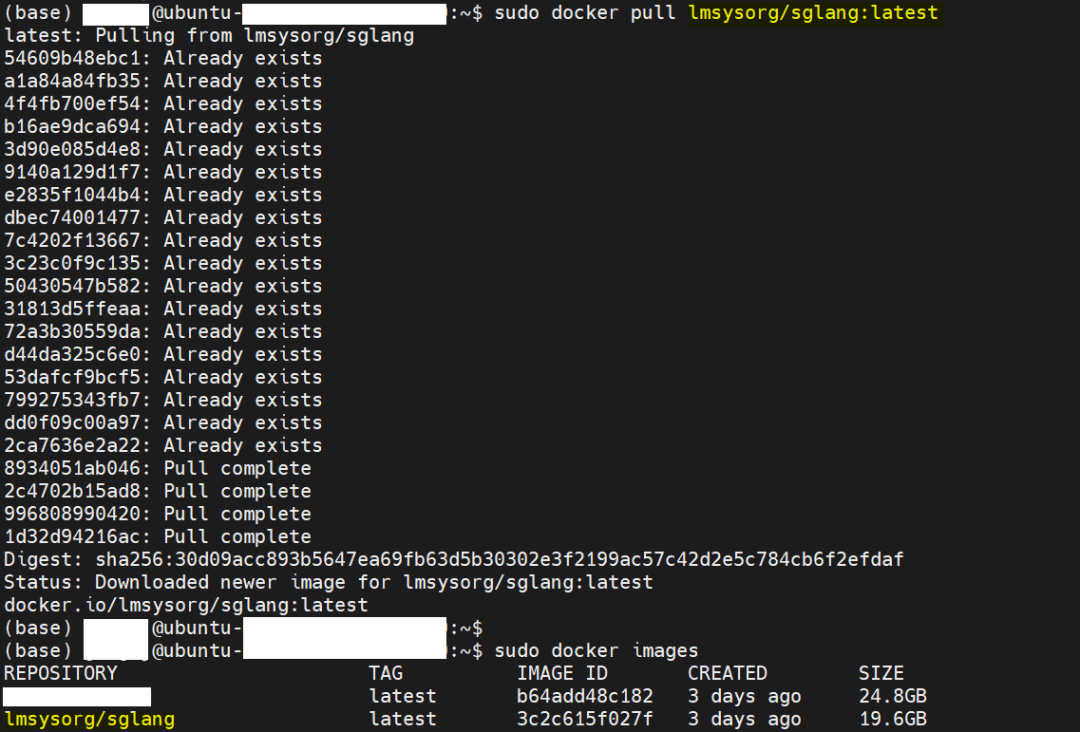
Docker-Hub官网 搜 SGLang,找到合适的镜像
默认为

docker pull lmsysorg/sglang:latest
三、启动模型

SGLang官方文档查看参数

Docker 启动命令如下:

docker run -d --gpus all \
           --shm-size 32g \
           -p 8001:8001 \
           -v /NV/models_hf/Qwen/Qwen3-32B:/model \
           --ipc=host \
           lmsysorg/sglang:latest \
    python3 -m sglang.launch_server \
           --model /model \
           --tp 4 \
           --trust-remote-code \
           --port 8001

基本参数

  • • 启用显卡
  • • 启用全部显卡:--gpus all
  • • 启用指定几张卡: --gpus '"device=0,1,2,3"'
  • • 后台运行: -d
  • • 初次运行:验证是否正常启动了服务,先不使用-d

附加参数

  • • 允许外部访问:--host 0.0.0.0
  • • 指定模型名称:–served-model-name Qwen3-32B
  • • 开启最大上下文长度32768:--json-model-override-args '{"rope_scaling":{"rope_type":"yarn","factor":4.0,"original_max_position_embeddings":32768}}' --context-length 131072

四、使用Qwen3的三种方式🌐

4.1 Python调用本地Qwen3

import openai
client =openai.client(base_url="http://localhost:8001/v1",api_key="EMPTY" )

# Chat completion
response=client.chat.completions.create(
    model="default",
    messages=[
        {"role": "system","content": "You are a helpful AI assistant"},
        {"role":"user","content":"简要介绍RAG是什么?"},
    ],
    temperature=0,
    max_tokens=64,
)
print(response)

4.2 HTTP 接口请求本地Qwen3

curl --location --request POST 'http://127.0.0.1:8001/v1/chat/completions' \
--header 'Content-Type: application/json' \
--data-raw '{
    "model": "Qwen/Qwen3-32B",
    "messages": [
      {"role": "user", "content": "请用一句话介绍你自己"}
    ],
    "temperature": 0.7,
    "max_tokens": 512
  }'

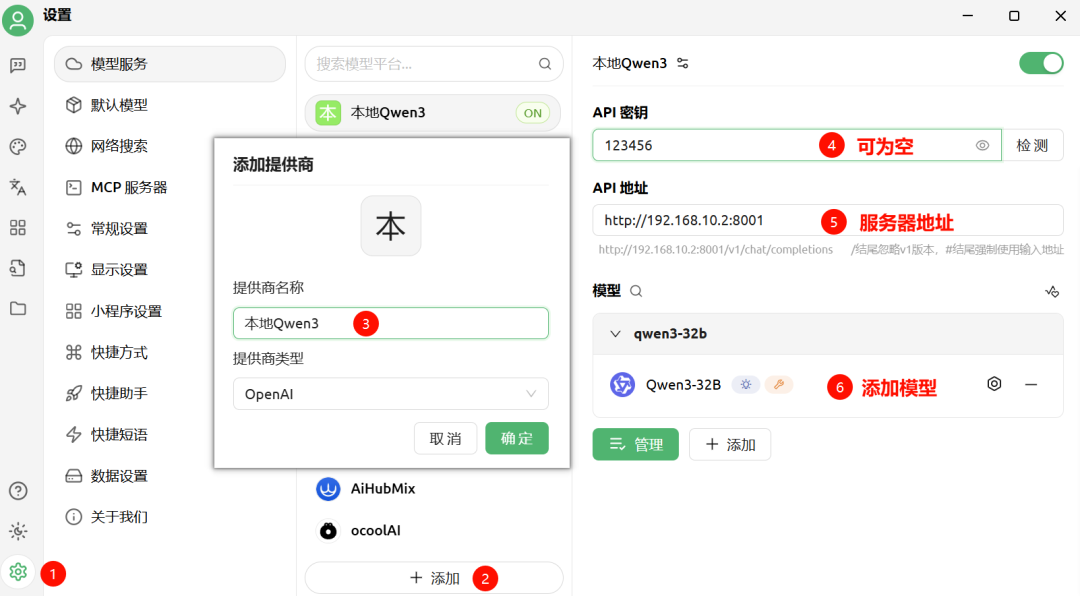
4.3 客户端使用本地Qwen3

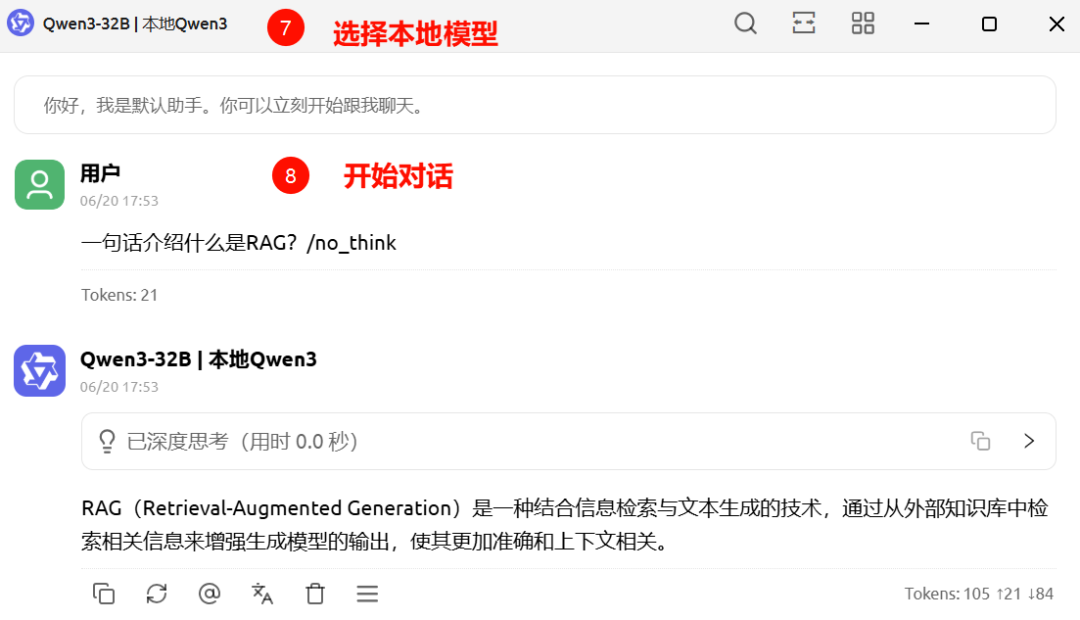
以CherryStudio为例
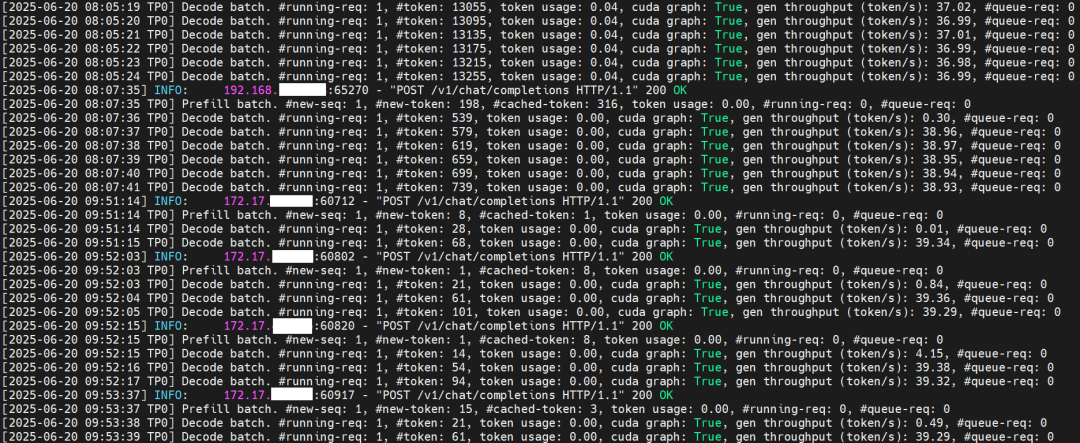
4.4 查看推理速度

找到你的容器id

sudo docker ps   # 如0d5faf88f505

查看容器的日志

sudo docker logs 0d5faf88f505  # 如需实时查看,加个-f
以下是 逐行解析 启动命令的含义和作用,按需查看。


🐳 docker run 是什么?

这是启动一个 Docker 容器的命令。你可以把它理解为“运行一个已经打包好的应用环境”。


🔧 参数详解

✅ --gpus all

  • • 启用所有 GPU(NVIDIA 显卡),让容器可以访问你的 CUDA 设备。
  • • 需要安装好 nvidia-docker2。

✅ --shm-size 32g

  • • 设置共享内存大小为 32GB。
  • • 某些模型推理需要较大的共享内存空间,特别是大规模模型(如 DeepSeek-V3)。
  • • 默认共享内存较小(64MB),不足以支持大模型推理。

✅ -p 8001:8001

  • • 将宿主机(也就是你当前系统的)端口 8001 映射到容器内部的 8001 端口。
  • • 用于通过浏览器或 API 访问服务:http://localhost:8001

✅ /NV/models_hf/Qwen/Qwen3-32B:/model

  • • 将宿主机上的 HuggingFace 缓存目录挂载到容器中的 /model。
  • • 目的是:
  • • 共享模型缓存,避免重复下载
  • • 加快下次加载模型的速度

示例路径说明:

  • • 宿主机路径:/NV/models_hf/Qwen/Qwen3-32B → 当前用户的HuggingFace 缓存目录
  • • 容器路径:/model → 容器中 root 用户的缓存路径

✅ --ipc=host

  • • 使用宿主机的 IPC(进程间通信)命名空间。
  • • 大模型推理时可能涉及多进程通信,使用这个参数可以避免 IPC 资源限制问题。

🖼️ lmsysorg/sglang:latest
这是你要运行的镜像名称和标签:

  • • lmsysorg/sglang: SGLang 的官方镜像
  • • latest: 最新版本的 tag

🚀 python3 -m sglang.launch_server

这部分是容器启动后执行的命令,用来启动 SGLang 服务。

参数解释

--model /model

  • • 加载 HuggingFace 上的模型 /model
  • • 如果本地没有这个模型,SGLang 会自动从 HF 下载并缓存到之前挂载的目录中

--tp 4

  • • tp = Tensor Parallelism(张量并行)
  • • 表示使用 4 个 GPU 并行推理(适用于多卡服务器)
  • • 如果你只有 2 张卡,请设置为 --tp 2

--trust-remote-code

  • • 允许加载远程代码(某些模型依赖自定义代码实现)
  • • 如不加此参数,可能会报错:This repository requires custom code

--port 8001

  • • 指定服务监听的端口号(与前面的 -p 对应)

📦 小结:整个命令的作用

功能说明
使用 GPU支持深度学习加速
共享内存 32G支持大规模模型推理
挂载模型缓存避免重复下载模型
映射端口通过 REST API 访问模型服务
启动 SGLang 服务加载 Qwen3-32B 模型并提供推理接口

实践出真知,与君共勉。

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

本地/服务器部署Dify傻瓜式教程 ​之前在AI大模型生态最态势及相关技术-25.5.27-优快云博客中提到了搭建AI Agent新贵平台 Dify,在从意识里懂一下Dify-优快云博客进一步对Dify进行了介绍。 今天以简单易懂的方式讲解一下怎么在本地/服务器上部署Dify(下二、3),添加不同模型供应商的大模型,以及实践过程中遇到的问题。 阅读详情

相关推荐

开源模型应用落地-工具使用篇-Ollama(六)

Ollama集成QWen1.5系列模型,全网唯一,绝非搬运。

以微薄之力,予他人些许温暖. 2万+

从零开始之Dify部署篇

Dify传送门。本系列文章从零开始探索Dify的功能及搭建过程。本文的搭建流程是基于Docker Compose进行部署。

u013563715的博客 7万+

光模块数字诊断监控(DDM)功能

DDM(Digital Diagnostic Monitoring)数字诊断监控,由行业组织SFF Committee制定,遵循SFF-8472多源协议定义的标准参数而工作,规范了光模块和网络设备的软硬件所需遵循的标准数值或范围,确保了网络设备供应商和光模块供应商之间所提供产品的互操作性不同。:通过监测激光器的偏置电流来预测激光器的劣化,从而确保在故障发生之前将业务切换到备用链路上或替换有可能故障的光模块,因此起到了预测光模块寿命的作用。光模块DDM信息可以通过SNMP读取光模块的接收光功率和发射光功率。.

光模块的博客 2300

一文带你入门 MCP(模型上下文协议)

Model Context Protocol (MCP) 是一个开放协议,它使 LLM 应用与外部数据源和工具之间的无缝集成成为可能。无论你是构建 AI 驱动的 IDE、改善 chat 交互,还是构建自定义的 AI 工作流,MCP 提供了一种标准化的方式,将 LLM 与它们所需的上下文连接起来。目前,MCP 已经积累了足够的临界规模和动能,因此它被视为 2023-2025 年“代理开放标准”之争的潜在赢家。

kuokay的博客 3万+

浙江大学Fast-Lab从0制作自主空中机器人公开课教程补充及部分注意事项(适用于ubuntu系统和ROS零基础)

浙江大学Fast-Lab从0制作自主空中机器人公开课纯萌新补充(适用于从没接触过ubuntu系统),记录了一些自己不会的地方以及踩过的坑

qq_39986834的博客 2984

STM32F103C8T6+I2C+DMA读取陀螺仪模块JY901S(硬件I2C

说明:1.本实验代码适用移植一切stm32f1系列;2.本实验使用的是外设资源硬件I2C2;3.本实验运用的是DMA单次模式,如果需要DMA的循环模式,请移步我的另一篇文章;4.本文章不提供陀螺仪校准教学,并是在没有校准陀螺仪情况下读取数据;5.本文章是作者的学习记录及心得,如有不足,欢迎指正。 总结:亲测stm32f103c8t6最小系统板通过片上外设资源I2C配合DMA读去陀螺仪模块jy901s偏航角有效。

anquanyuanqqadsy的博客 6172

地表最强SGLang部署本地Qwen3-32B大模型--实战教程

摘要:本文提供Qwen3-32B大模型本地部署实战教程,满足企业数据安全需求。 内容包括:硬件要求(至少2*24GB显存); 通过ModelScope或Huggingface下载模型; 使用Docker拉取SGLang镜像并启动服务; 三种调用方式(Python、HTTP接口和客户端)。 重点解析了Docker启动参数,强调共享内存和GPU配置的重要性。 部署后可通过8001端口访问服务,实现安全高效的本地大模型应用。

sinat_29950703的博客 2719

基于PSINS的INS/NHC/ODO组合导航仿真全解析

组合导航通过多传感器融合克服单一导航系统的局限,是车辆自主定位的关键技术。其中惯性导航(INS)依靠陀螺仪与加速度计积分推算运动状态,但误差随时间累积;GNSS提供绝对位置,却在城市峡谷中易受多径效应和遮挡影响导致定位漂移。卡尔曼滤波作为信息融合核心,将不同量测按统计特性加权,实现优势互补。基于PSINS开源工具箱搭建的SINS/GNSS/ODO/NHC组合导航仿真,能够在GNSS失锁条件下利用非完整约束和里程计抑制惯性误差发散,广泛应用于无人驾驶、物流车辆自主定位等场景。本文围绕PSINS仿真环境,详细拆

weixin_29044713的博客 253

一键解锁地表最强代码模型!Qwen3-Coder 从部署到实战全指南,大模型入门到精通,收藏这篇就足够了!

阿里通义千问团队重磅推出Qwen3-Coder-480B-A35B模型,以开源形式震撼整个开发者社区。

2301_81940605的博客 1814

Vmware 17保姆级教程:从零部署华为enspPro模拟器(附镜像下载+配置优化)

本文提供了一份详尽的Vmware 17部署华为eNSP Pro模拟器的保姆级教程。内容涵盖从镜像下载、虚拟机导入、网络配置到深度性能调优的全过程,并针对常见启动失败、设备卡顿等故障提供了实用的排查方案,旨在帮助网络工程师和华为认证备考者快速搭建稳定高效的实验环境。

arduino9maker的博客 636

告别激活烦恼:Lattice Diamond 3.13 永久免费License申请与配置全攻略(Windows 64位)

本文详细介绍了Lattice Diamond 3.13永久免费License的申请与配置全流程,特别针对Windows 64位系统用户。从官网导航的隐藏路径到Host ID的获取方式,再到License文件的高级处理技巧和环境变量的深度配置,提供了全面的安装教程和疑难问题解决方案,帮助开发者彻底告别激活烦恼。

weixin_28736335的博客 425

SGLang部署Qwen3与Qwen2.5-VL-32B实战

基于SGLang推理引擎高效部署Qwen3-32B和Qwen2.5-VL-32B大模型,利用RadixAttention实现高吞吐、低延迟,支持多轮对话、结构化输出与多模态处理,显著优于vLLM。

weixin_28235889的博客 602

STM32F103循迹小车PID调参实战:手把手教你整定舵机PD与电机PI参数

本文详细介绍了基于STM32F103的循迹小车PID调参实战,重点讲解舵机PD控制与电机PI参数的整定技巧。通过硬件选型、基础测试、四步调参法和分段控制策略,帮助开发者解决小车蛇形走位等问题,提升循迹性能。文章还分享了高级调试技巧和典型问题排查方法,适用于智能车竞赛和机器人开发。

weixin_42524226的博客 361

SGLang RBG调度器部署Qwen3-235B生产实践

大模型推理服务中,KV Cache管理与请求级调度是保障低延迟、高稳定性的核心基础。传统continuous batching在长尾输入下显存浪费严重,而基于请求生命周期的RBG(Request-Based GPU scheduling)调度器通过动态slot分配、反压控制和优先级路由,显著提升显存利用率与P95延迟可控性;结合Qwen3-235B特有的MoE稀疏激活、超长上下文数值不稳及中文分词敏感等挑战,需定制tokenizer预处理、RoPE缩放与安全context窗口。本文聚焦真实政务、法律、医疗场

weixin_30859423的博客 399

Qt C++ 电子海图与作战叠加(Overlay)系统

lab_pos->setText(QString("坐标: X%1 Y%2").arg(p.x(),0,'f',0).arg(p.y(),0,'f',0));lab_distance->setText(QString("距离: %1 海里").arg(dist,0,'f',1));lab_bearing->setText(QString("方位: %1°").arg(bear,0,'f',1));// 绘制S-57海图基底。scene->addText("封锁线").setPos(450,180);

寒寒豆豆软件公司的博客 496

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

新手必看!Qwen3-Embedding-0.6B保姆级部署教程

本文介绍了如何在星图GPU平台上自动化部署Qwen3-Embedding-0.6B镜像,快速构建文本嵌入服务。该镜像专精于生成高质量语义向量,典型应用于RAG知识库检索、智能客服意图匹配及跨语言内容搜索等场景,显著提升语义理解与信息召回效率。

weixin_36288992的博客 933

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

极致算力释放:在昇腾 NPU (CANN 8.2) 上极速部署 SGLang + Qwen2.5 实战指南

在大模型推理技术的竞逐中,SGLang 凭借其革命性的 RadixAttention 技术和高效的算子调度机制,正在成为高性能推理的新标杆。特别是在多轮对话和 Agent 智能体场景下,它对 KV Cache(键值缓存)的极致复用能力,使其在吞吐量表现上甚至超越了老牌强者 vLLM。本文将聚焦于国产算力底座——昇腾(Ascend)NPU,基于 GitCode Notebook 最新的Ubuntu +CANN预装镜像,为开发者带来一份“0-Day”级别的极速部署指南。

Zero_VPN的博客 3万+

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

SGLang发布mini版本:30万行代码压缩至5000行,性能无损!小白也能读懂的大模型推理框架!

SGLang团队发布mini-SGLang,将30万行代码压缩至5000行,保留重叠调度、FlashAttention-3等核心优化技术。该版本专为学习大模型推理原理设计,开发者可在周末内读完代码,性能与完整版相近。mini-SGLang支持在线/离线服务、流式传输和重叠调度,主要定位教学实验,不建议生产环境使用。

Android23333的博客 1177

Qwen3-Embedding-4B快速入门:Python调用代码实例详解

本文介绍了如何在星图GPU平台上自动化部署Qwen3-Embedding-4B镜像,快速构建高性能文本嵌入服务。该镜像专精于多语言语义向量化,典型应用于RAG知识库问答、跨语言搜索及代码语义匹配等场景,显著提升检索相关性与AI应用响应精度。

weixin_42587866的博客 1121

小白也能懂!Qwen3-Embedding-4B保姆级教程:从安装到实战应用

本文介绍了如何在星图GPU平台上自动化部署Qwen3-Embedding-4B镜像,快速构建文本语义理解能力。通过开箱即用的OpenAI兼容接口,用户可轻松实现文本向量化与语义相似度计算,典型应用于智能搜索、文档聚类和客服意图识别等场景。

weixin_36235398的博客 264

Qwen3-32B模型性能基准测试:不同硬件配置下的吞吐量对比

你是否曾在部署Qwen3-32B这样的大模型时遇到过这些问题:消费级GPU显存不足导致推理失败?云端GPU成本过高难以承受?相同模型在不同硬件上的性能差异巨大却缺乏参考数据?本文将通过系统性的基准测试,为你揭示Qwen3-32B在各类硬件配置下的真实吞吐量表现,助你找到性价比最优的部署方案。 读完本文你将获得: - 8种常见硬件配置的Qwen3-32B吞吐量实测数据 - 不同量化精度对性能与质量...

gitblog_00538的博客 1678

Clawdbot代理直连Qwen3-32B:快速部署与使用指南

本文介绍了如何在星图GPU平台上自动化部署Clawdbot 整合 Qwen3:32B 代理直连 Web 网关配置Chat平台镜像,快速构建企业级私有大模型对话服务。该镜像通过协议转换与端口代理,使Clawdbot前端可直接调用Qwen3-32B进行多轮技术问答、代码生成等典型任务,显著提升AI应用落地效率。

weixin_31459297的博客 417

2026年AI向量服务趋势:Qwen3开源模型部署入门必看

本文介绍了如何在星图GPU平台上自动化部署Qwen3-Embedding-4B镜像,快速构建高性能中文语义向量服务。该镜像专为检索与RAG优化,支持长文本理解与跨语言嵌入,典型应用于智能搜索、知识库语义召回等场景,显著提升语义匹配精度与响应速度。

weixin_36288992的博客 408

Qwen3:阿里云最强开源大语言模型全面解析

Qwen3是阿里云通义千问团队开发的最新大语言模型系列,代表了当前开源大语言模型技术的巅峰水平。该系列在Qwen2.5和QwQ基础上进行全面升级,提供从0.6B到235B-A22B的丰富模型规模选择,包括密集模型和混合专家(MoE)模型。其最具创新性的特性是独特的双模式推理架构,支持思考模式和非思考模式的智能切换,以及256K tokens超长上下文处理能力,可扩展到1百万tokens。模型支持1...

gitblog_00078的博客 1508
上一篇: 大模型训练与微调实战手册(以 Qwen 为例),大模型入门到精通,收藏这篇就足够了!
下一篇: 一次性讲清楚大模型王者 Qwen3 系列的 17 个模型,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值