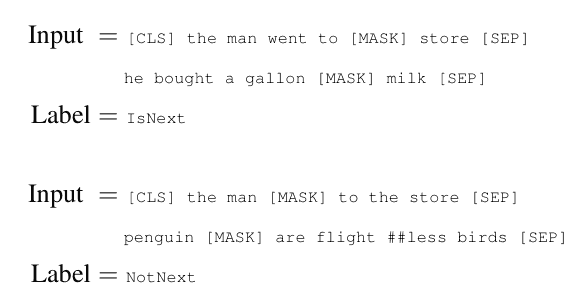小白程序员必看:轻松入门BERT大模型,附代码示例与收藏指南!

阿里最强小钢炮上线!Qwen3.6-35B-A3B+OpenClaw本地部署全记录 阿里发布高效轻量级开源模型Qwen3.6-35B-A3B,本文详细介绍了基于Ollama的本地部署方案,包括与OpenClaw与飞书机器人的集成方案 阅读详情

BERT作为深度学习与自然语言处理领域的里程碑,通过双向Transformer结构实现强大的文本表示。文章深入解析BERT的核心思想、网络架构、预训练任务及微调范式,并提供了PyTorch代码示例,帮助读者理解BERT内部机制。掌握BERT,开启大模型学习之旅,收藏本文,持续更新内容等你探索!

1.BERT 的核心思想

BERT 的全称是 Bidirectional Encoder Representations from Transformers,顾名思义,它基于 Transformer 的 Encoder 结构,利用 双向上下文信息 来学习文本表示。
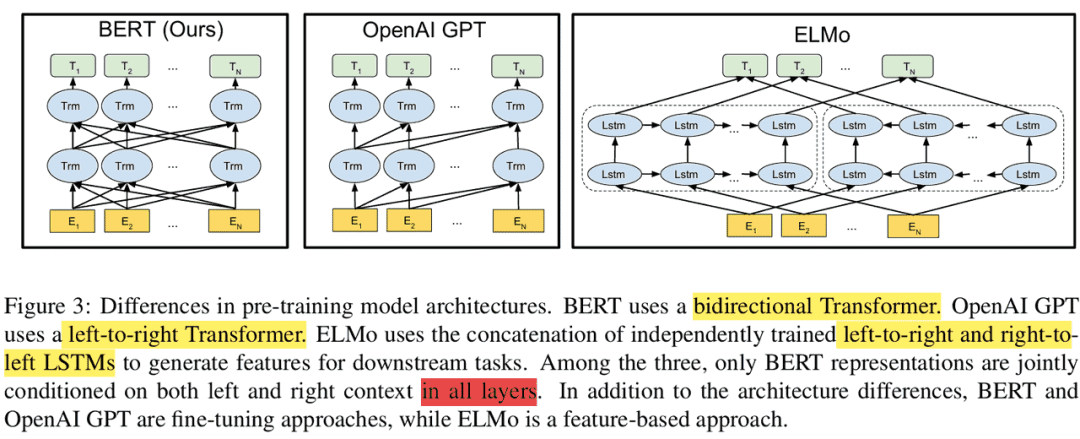
传统语言模型往往是单向的:

而 BERT 通过 Masked Language Model (MLM) 的设计,实现了同时建模左右语境,从而获得了更强大的表示能力。

BERT 不是生成模型,而是深度的双向语言理解模型。它通过预训练,学习到了丰富的语言表示,能够理解上下文的语义信息。

2.BERT 的网络架构
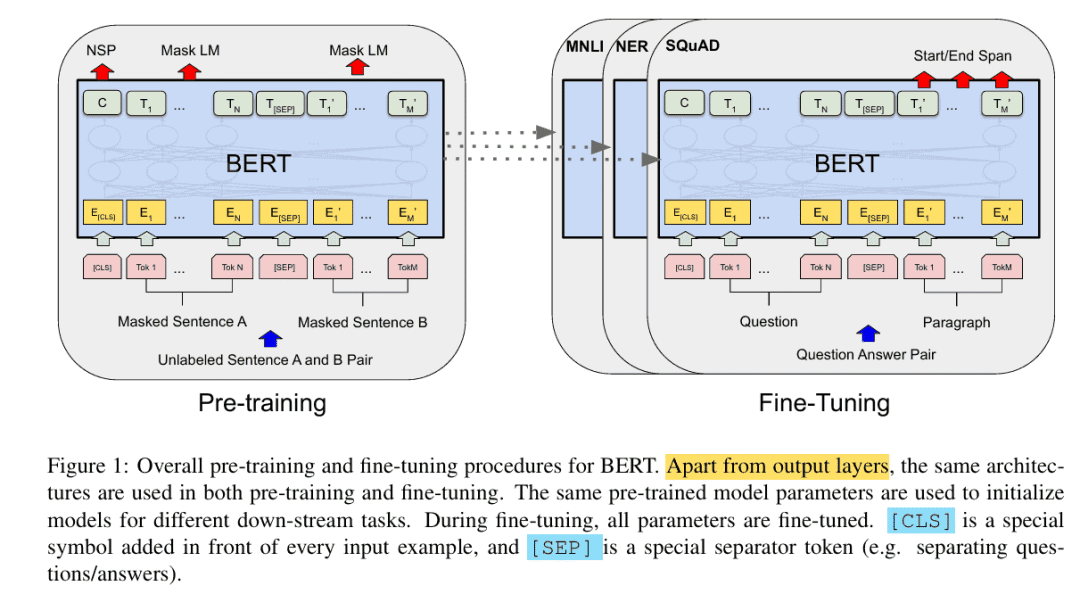
BERT 完全基于 Transformer Encoder 堆叠,其主要组成部分包括:

1. 输入表示
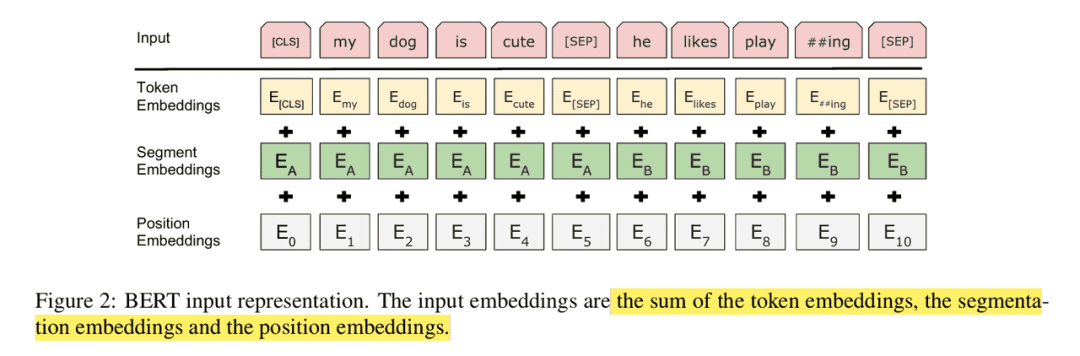
  • 由三部分向量相加得到:
  • Token Embedding:词向量。
  • Segment Embedding:区分句子 A 和句子 B。
  • Position Embedding:位置编码。
  • 输入序列通常以 [CLS] 开头,用于分类任务,以 [SEP] 分隔句子。

2. 多层 Transformer Encoder

  • 每层包括 Multi-Head Self-Attention 和 前馈神经网络(Feed-Forward Network)。
  • Self-Attention 能够捕捉任意位置之间的依赖关系。

3. 输出表示

  • [CLS] 的输出向量通常用来做分类任务。
  • 其他 token 的向量可用于序列标注、问答、翻译等下游任务。

3.预训练任务

BERT 的关键创新在于其 预训练目标,主要包括两类:

  1. Masked Language Model (MLM)

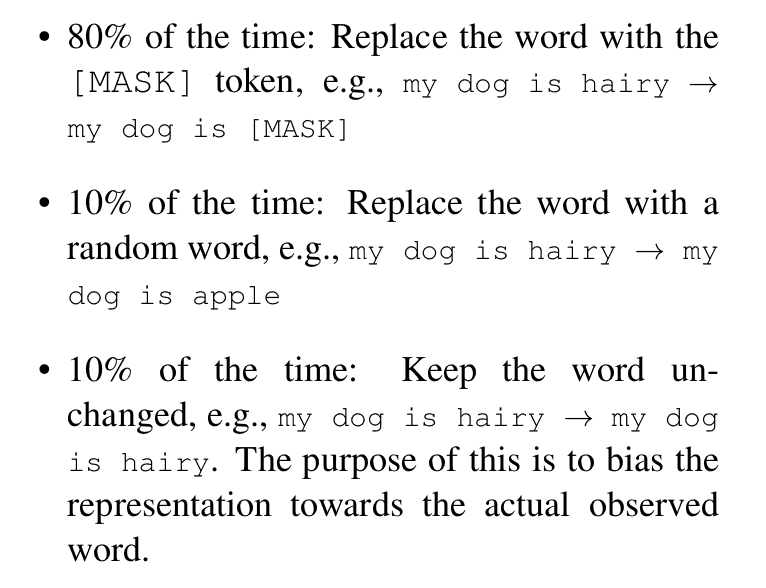
  • 随机掩盖 15% 的词,让模型根据上下文预测它们。
  • 不同于传统 LM 单向预测,MLM 可以利用完整的双向上下文。
  1. Next Sentence Prediction (NSP)
  • 输入句子对 (A, B),判断 B 是否是 A 的下一句。

  • 旨在增强句子级别的关系建模能力,对问答和自然语言推理任务尤为有帮助。

    4.微调范式

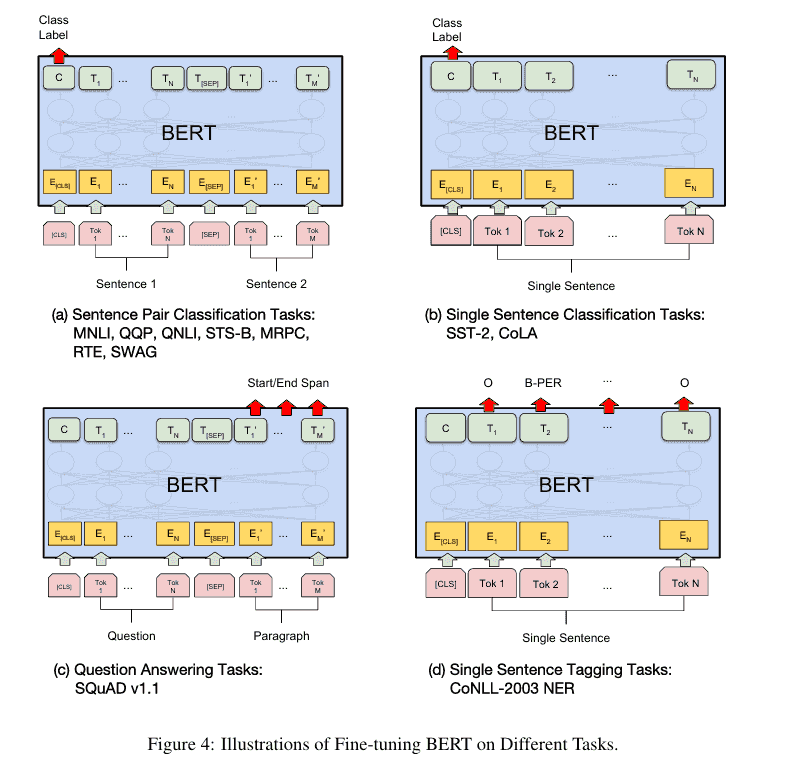
BERT 的最大贡献之一,是提出了 “预训练 + 微调” 的范式:

这种模式极大降低了下游任务的标注需求,也让学术界和工业界快速享受到预训练模型的红利。

5.代码示例

下面我们用 PyTorch 从零搭建核心模块,帮助更好的理解 BERT 的内部机制。

import torch
import torch.nn as nn
import math
# ----------------------
# 1. Multi-Head Self Attention
# ----------------------
classMultiHeadSelfAttention(nn.Module):
def__init__(self, hidden_dim, num_heads):
super().__init__()
assert hidden_dim % num_heads == 0, "hidden_dim 必须能被 num_heads 整除"
self.num_heads = num_heads
self.head_dim = hidden_dim // num_heads
self.query = nn.Linear(hidden_dim, hidden_dim)
self.key   = nn.Linear(hidden_dim, hidden_dim)
self.value = nn.Linear(hidden_dim, hidden_dim)
self.out   = nn.Linear(hidden_dim, hidden_dim)
defforward(self, x, mask=None):
B, L, D = x.size()  # batch_size, seq_len, hidden_dim
# 线性映射
Q = self.query(x).view(B, L, self.num_heads, self.head_dim).transpose(1, 2)  # [B, heads, L, head_dim]
K = self.key(x).view(B, L, self.num_heads, self.head_dim).transpose(1, 2)
V = self.value(x).view(B, L, self.num_heads, self.head_dim).transpose(1, 2)
# Scaled Dot-Product Attention
scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.head_dim)  # [B, heads, L, L]
if mask isnotNone:
scores = scores.masked_fill(mask == 0, -1e9)
attn = torch.softmax(scores, dim=-1)
out = torch.matmul(attn, V)  # [B, heads, L, head_dim]
out = out.transpose(1, 2).contiguous().view(B, L, D)  # [B, L, hidden_dim]
returnself.out(out)
# ----------------------
# 2. Transformer Encoder Block
# ----------------------
classTransformerBlock(nn.Module):
def__init__(self, hidden_dim, num_heads, ff_dim, dropout=0.1):
super().__init__()
self.attn = MultiHeadSelfAttention(hidden_dim, num_heads)
self.norm1 = nn.LayerNorm(hidden_dim)
self.norm2 = nn.LayerNorm(hidden_dim)
self.ff = nn.Sequential(
nn.Linear(hidden_dim, ff_dim),
nn.ReLU(),
nn.Linear(ff_dim, hidden_dim)
)
self.dropout = nn.Dropout(dropout)
defforward(self, x, mask=None):
# Self-Attention + 残差
attn_out = self.attn(x, mask)
x = self.norm1(x + self.dropout(attn_out))
# Feed Forward + 残差
ff_out = self.ff(x)
x = self.norm2(x + self.dropout(ff_out))
return x
# ----------------------
# 3. BERT Embeddings
# ----------------------
classBERTEmbedding(nn.Module):
def__init__(self, vocab_size, hidden_dim, max_len=512, dropout=0.1):
super().__init__()
self.token_emb = nn.Embedding(vocab_size, hidden_dim)
self.pos_emb   = nn.Embedding(max_len, hidden_dim)
self.seg_emb   = nn.Embedding(2, hidden_dim)  # segment A / B
self.norm = nn.LayerNorm(hidden_dim)
self.dropout = nn.Dropout(dropout)
defforward(self, input_ids, segment_ids):
B, L = input_ids.size()
pos_ids = torch.arange(L, device=input_ids.device).unsqueeze(0).expand(B, L)
x = self.token_emb(input_ids) + self.pos_emb(pos_ids) + self.seg_emb(segment_ids)
returnself.dropout(self.norm(x))
# ----------------------
# 4. BERT Model
# ----------------------
classBERT(nn.Module):
def__init__(self, vocab_size, hidden_dim=768, num_heads=12, ff_dim=3072, num_layers=12, max_len=512):
super().__init__()
self.embedding = BERTEmbedding(vocab_size, hidden_dim, max_len)
self.layers = nn.ModuleList([
TransformerBlock(hidden_dim, num_heads, ff_dim) for _ inrange(num_layers)
])
self.cls_head = nn.Linear(hidden_dim, vocab_size)  # 用于 MLM
defforward(self, input_ids, segment_ids, mask=None):
x = self.embedding(input_ids, segment_ids)
for layer inself.layers:
x = layer(x, mask)
logits = self.cls_head(x)  # MLM 任务输出
return logits
# 模拟输入
vocab_size = 30522# 与 BERT 一致
model = BERT(vocab_size)
input_ids = torch.randint(0, vocab_size, (2, 10))  # batch_size=2, seq_len=10
segment_ids = torch.zeros_like(input_ids)  # 全部属于句子 A
logits = model(input_ids, segment_ids)
print(logits.shape)  # [2, 10, vocab_size]

输出的 logits 可用于 Masked Language Model (MLM) 任务,即预测被 [MASK] 掩盖的词。

BERT 的提出,最大的三大贡献可以总结成下面三个部分:

  1. 双向 Transformer 表示学习 —— 捕捉更全面的上下文信息。
  2. 预训练 + 微调范式 —— 让通用语言模型成为 NLP 的基础设施。
  3. 广泛适用性 —— 覆盖了几乎所有 NLP 任务。

最后

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?

答案只有一个:人工智能(尤其是大模型方向)

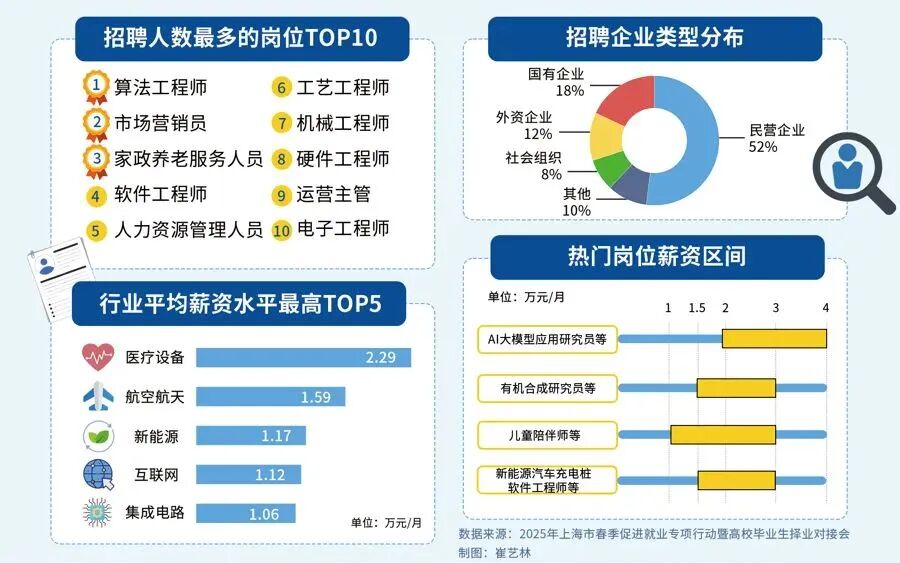
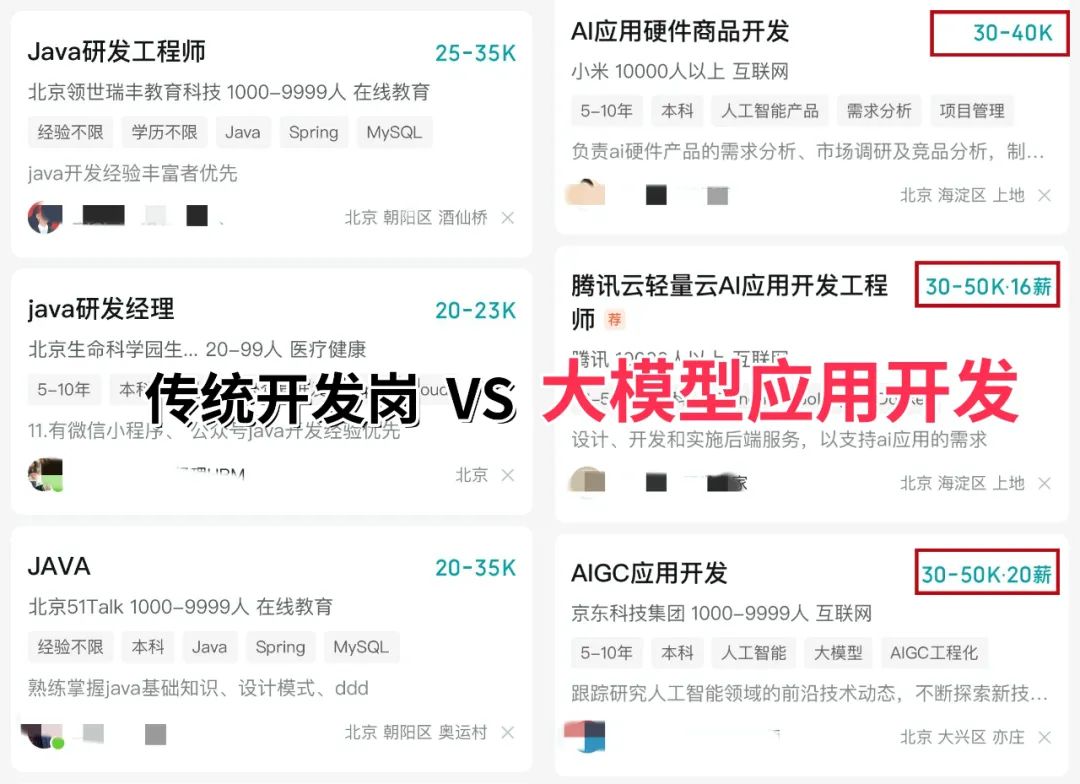
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
图片
图片
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。

如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!

下面是我整理的大模型学习资源,希望能帮到你。

图片

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

最后

1、大模型学习路线

img

2、从0到进阶大模型学习视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。

在这里插入图片描述

3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)

在这里插入图片描述

4、 AI大模型最新行业报告

2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

5、面试试题/经验

img

【大厂 AI 岗位面经分享(107 道)】

img

【AI 大模型面试真题(102 道)】

img

【LLMs 面试真题(97 道)】

img

6、大模型项目实战&配套源码

img

适用人群

在这里插入图片描述

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型

  • 带你了解全球大模型

  • 使用国产大模型服务

  • 搭建 OpenAI 代理

  • 热身:基于阿里云 PAI 部署 Stable Diffusion

  • 在本地计算机运行大模型

  • 大模型的私有化部署

  • 基于 vLLM 部署大模型

  • 案例:如何优雅地在阿里云私有部署开源大模型

  • 部署一套开源 LLM 项目

  • 内容安全

  • 互联网信息服务算法备案

  • …

    👇👇扫码免费领取全部内容👇👇

    在这里插入图片描述

3、这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

一文搞懂 Agent Skills:从“会聊天”到“会干活”,Agent Skills 到底改变了什么? Agent Skills 通常可以直译为“智能体技能”,是一种给智能体“加技能包/工作流插件”的标准化方式。从本质上看,它的作用类似于给 Agent 安装“技能包”或“工作流插件”——把完成某一类任务所需的知识步骤和工具使用方式整体封装起来,供 Agent 在合适的时机自动调用和执行,而不再依赖人类反复编写提示词来引导。如果将 Agent 理解为一个能够自主完成任务的“数字员工”,那么 Skills 就是它所掌握的具体“工种”或“手艺”。 阅读详情

相关推荐

深度对比 OpenClaw 与 Harness:个人助理 vs 企业级 AI 工程范式

维度OpenClawHarness(架构层面)架构形态具体产品/框架抽象范式/方法论核心组件执行层 + 评估层 + 控制层通信方式WebSocket 总线,本地回环优先依赖具体实现,无统一标准扩展方式插件机制(Skills)+ Channels七大模块各自独立选型架构思想致敬 Unix 哲学,三层解耦工业级分层管控维度OpenClawHarnessGitHub 星标34 万+(历史第一)分散到多个项目大厂支持多家云厂商一键部署。

lukabruce的博客 1163

金三银四跳槽季必藏!2026 字节校招薪资大揭秘,AI 岗成应届生薪资天花板

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

大模型研究中心 996

【GNSS数据处理】赫尔默特(helmert)方差分量估计解析及代码实现

一、背景 helmert方差分量估计是方差-协方差分量估计的一个特例,在近现代测量平差中,我们处理的数据有明显的变化,数据序列中包括粗差,数据类型不再单一等问题。当我们遇到数据类型两类及以上时,可以考虑使用赫尔默特方差分量估计,应用的前提条件是不同类别的数据需要相互独立,这样我们的权阵就是对角阵。 二、引入 我们先用王者荣耀这款游戏引入一下,王者可是撩妹利器,哈哈,就像你有两部手机(安卓和苹果),带妹的时候大概率会用苹果,因为游戏体验方面苹果要优于安卓,带妹的时候不掉帧,不卡顿,不闪退,要操作有操作,有皮肤

ANKP的博客 1万+

一文看懂Agent Skills带来的AI变革!

Skills 通过指令和代码为 Claude 提供新功能,虽然这使它们功能强大,但也意味着恶意 Skill 可以指导 Claude 以与 Skill 声称的目的不匹配的方式调用工具或执行代码。Skills 是可重用的、基于文件系统的资源,为 Claude 提供特定领域的专业知识:工作流、上下文和最佳实践,将通用代理转变为专家。Claude 在具有文件系统访问权限的虚拟机中运行,允许 Skills 作为包含指令、可执行代码和参考资料的目录存在,组织方式就像你为新团队成员创建的入职指南。

JavaEdge全是干货的技术号 4202

计算文本相似度的常用算法

NLP、数据挖掘领域中,文本分析是一个很重要的领域,这有助于我们去让计算机理解语言的作用和使用。文本分析是数据挖掘的重要手段,利用文本分析,我们将很快的读取到一本书、一篇文章、一段话中的关键词和核心思想,而文本相似度就是我们用来剔除无用信息或者重复信息的重要手段,让计算机去找文本中的不同。 在生活中,信息检索、数据挖掘、机器翻译、文档复制检测等领域都应用到“文本相似度”。文本不仅仅是文字,文本相似度的应用更广,除了文字的匹配,还可以是图片、音频等,因为它们的实质都是在计算机中都是以二进制的方式存在的。相.

氧小氢的博客 2万+

SecureCRT串口连接保姆级教程:从驱动安装到波特率设置(附常见问题解决)

本文提供SecureCRT串口连接的保姆级教程,涵盖从USB转串口驱动安装、端口识别到波特率等核心参数设置的完整流程。针对连接失败、乱码、键盘输入无响应等高频问题,给出了深度排查与解决方案,帮助网络与嵌入式开发新手快速掌握串口调试技能。

weixin_29281941的博客 433

小白程序员必收藏!超全面大模型学习路线,从入门到实战,轻松提升竞争力

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

AI大模型的博客 681

StarCCM+ 导入STL几何模型进行仿真

通过 Import Surface Mesh 的方法导入 STL 文件进行仿真

薛定谔的alpha狗 6129

【大模型小白必看】如何系统的入门大模型?大模型入门到精通,从浅入深,收藏这篇就够了!

大模型的应用场景包括Prompt工程、AIAgent、私有知识库等,开发人员可以从套壳应用逐步深入至微调和训练。学习路径建议:1)掌握Python和向量数据库基础;2)实战LangChain框架开发;3)本地部署开源模型如ChatGLM2-6B;4)进阶学习机器学习、深度学习和NLP知识;5)深入研究模型调优和部署技术。当前大模型生态蕴含丰富机会,掌握相关技能可显著提升开发效率和工作竞争力。

m0_63171455的博客 1379

最新Python爬虫实战(入门爬虫篇)——案例1:某瓣网站Top250图片数据采集(附上完整爬虫代码)

本次案例通过Python爬虫技术实现了某瓣Top250电影封面的批量下载。代码采用模块化设计,函数实现cookies的自动解析,简化了配置流程,涵盖请求、解析、存储的完整流程。学习重点包括:抓包工具定位数据源、正则表达式匹配图片链接、模拟请求头绕过反爬机制、以及自动化文件管理。需要注意控制请求频率并遵守网站使用规范,适用于入门爬虫实践。

努力让自己发光,对的人才能迎着光而来 16万+

PCL 法向量夹角剔除错误匹配点对【2026最新版】

实现了一种简单的基于对应点法线角度的对应关系去除方法。博客长期更新,本文最新更新时间为:2026年5月24日。

点云侠的博客 41万+

小白程序员必看:收藏这份大模型学习指南,轻松入门AI技术!

本文详细介绍了大语言模型(LLM)的三种核心架构:自编码模型(如BERT)、自回归模型(如GPT)和序列到序列模型(如T5),并解释了它们的技术原理、应用场景和代表模型。文章以通俗易懂的方式解析了ChatGPT的原理,融合了自回归模型和人类反馈的机制。此外,还提供了学习大模型的方法和建议,适合初学者入门及深入学习。

2401_85375186的博客 1168

接入 AI 之后,为什么测试和排障还是没有真正变快?

如果你们准备做平台型 AI,不要先从聊天入口开始想。先把真实数据采上来;再把链路、版本、快照、报告这些核心对象建稳;再把历史沉淀、反馈、检索能力补齐;最后再让 AI 围绕这些对象去工作。这样做出来的 AI,才更容易从“看起来聪明”走向“真正省时间”。

专注 AI 精准测试平台实战落地,分享从代码 Diff 到回归决策的完整工程闭环。主张“先建数据链路,再上 AI 智能”,让测试从“靠经验”走向“基于风险”。 527

收藏!26年必火的AI大模型应用开发,小白&程序员入门指南

说白了就是:先搞懂“怎么用”,再探究“为什么能用”,最后钻研“怎么用得更好”。接下来,就按“小白→进阶→大神”的梯度,给大家拆解具体学习方向。

m0_48891301的博客 816

Qt代码-军用仿真系统基础框架

ui->mapClickLabel->setText(QString("地图点击:(%.1f, %.1f)米").arg(worldPos.x()).arg(worldPos.y()));emit simulationEvent(QString("添加实体: %1 (ID: %2)").arg(attr.name).arg(entity.id()));// 像素坐标→世界坐标(米)

寒寒豆豆软件公司的博客 168

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

小白程序员必看:轻松掌握BERT大模型,收藏学习这份超全指南

本文详细介绍了BERT大模型的核心概念、算法原理及最佳实践。从预训练模型的基本思想到Transformer的自注意力机制,再到BERT的双向编码器,文章深入浅出地讲解了BERT的工作原理。此外,还提供了使用BERT进行文本分类的代码实例和详细解释,帮助读者更好地理解和应用BERT。文章还探讨了BERT的实际应用场景,推荐了相关工具和资源,并展望了未来发展趋势与挑战。通过本文,读者能够系统地学习BERT大模型,为自然语言处理任务打下坚实基础。

2301_82275412的博客 433

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

收藏!小白程序员必看:轻松掌握RAG核心模型Embedding与Rerank

本文详细介绍了RAG系统中核心的Embedding和Rerank模型。Embedding模型负责将文本向量化以进行相似度检索,而Rerank模型则在检索基础上进一步精确排序,提升相关性。文章从功能目标、应用阶段和技术实现三个维度对比了两种模型,并辅以实例说明,适合初学者和程序员学习大模型基础知识。Embedding和Rerank模型是RAG系统中的核心模型。在RAG系统中,有两个非常重要的模型一个是Embedding模型,另一个则是Rerank模型;这两个模型在RAG中扮演着重要角色。

2301_76168381的博客 1151

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Android AI大模型入门教程:小白程序员收藏必备,轻松玩转大模型

本文将带领开发者入门Android AI大模型,涵盖大模型基础概念、类型、训练与推理过程,并推荐适合Android的轻量级模型。教程详细讲解在Android项目中集成大模型的环境搭建、模型转换、加载初始化及推理过程,并介绍图像分类、文本分类和目标检测等实际应用案例。此外,还分析了开发中可能遇到的问题及解决方案,帮助开发者更好地应对挑战。

aolan123的博客 1006

小白程序员必看!收藏这份AI大模型学习路线,轻松解锁高薪技能!

本文详细介绍学习AI大模型的正确顺序,从基础知识打底(数学、编程)到机器学习、深度学习,再到自然语言处理和大模型核心(Transformer+预训练),最后介绍大模型应用实战和持续进阶方向。文章强调AI大模型的重要性及学习大模型对职业发展的帮助,并提供超全最新的AI大模型应用开发学习清单和资料,助力读者快速入门并抓住AI时代风口。阶段 1:基础知识打底(数学 + 编程)✅ 数学三件套:线性代数、概率统计、微积分✅ 编程基础:Python+ NumPy+ Matplotlib阶段 2:机器学习入门。

ytt0523_com的博客 717

小白程序员必看:收藏这份RAG入门指南,轻松玩转大模型AI技术

近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验。

2601_95390420的博客 538

程序员小白必看!2026全新大模型保姆级学习指南,从入门到实战,建议收藏!✨

近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验。

Zs272的博客 638

收藏级|大模型从入门到实战完整路线(小白/程序员必看)

学习大模型,从来不是“看懂论文、记住知识点”就够了,更重要的是“亲手造出能跑的模型、能落地的应用”。无论是小白还是程序员,只要遵循这条路线,循序渐进、坚持实践,12个月后,你一定能摆脱“AI门外汉”的标签,成为能独立开发大模型应用的技术人。对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)

大模型教程的博客 1014

收藏!小白程序员轻松入门大模型:RAG与微调行业选型指南

本文深入探讨了AI大模型落地时RAG与微调的技术选型难题,强调不同行业(医疗、金融、电商)的适配性差异。文章详细解析了RAG(实时检索)和微调(专业知识学习)的原理及工具选型,如Milvus、Pinecone、Weaviate等向量库,以及LoRA、QLoRA等微调技术。通过3步决策法、3档预算方案和工具性能测试,为不同场景提供具体实施方案。最后展望了AI工具链平民化趋势,并分享了实操部署与成本控制技巧,帮助读者精准把握大模型落地关键点。

datian1234的博客 1025

收藏!学习AI大模型:为何值得入局?小白&程序员必看

我当初决定深耕AI大模型领域时,其实带着不少转行的迷茫——此前完全是AI圈的门外汉,对各类技术术语一知半解。万幸的是,一位深耕行业多年的亲戚给了我关键指点,帮我避开了很多新手易踩的坑,也让我清晰认清了学习AI大模型的核心价值。他当时分享的几点原因,至今仍适合想入局的小白和程序员参考。

weixin_72959097的博客 509

必收藏!2026大火的AI大模型应用开发,小白&程序员入门指南(附完整进阶路线)

最近AI大模型应用开发的热度直接拉满,懂行的人都知道,2026年这绝对是风口赛道!去BOSS直聘上翻一翻就知道,相关岗位量暴增,薪资待遇也直接碾压不少传统赛道。真心建议所有理工科的朋友,尤其是还在死磕前后端、感觉行业红利渐退的程序员,赶紧把目光转向这里,别错过这波逆袭机会!后台每天都有不少同学私信我,问AI大模型应用开发到底该从哪学、要学什么。为了帮大家少走弯路,我专门采访了深耕大模型领域5年的行业大佬,整理了这份超详细的入门+进阶指南,不管你是纯小白还是有编程基础的程序员,都能直接套用,一定要收藏好,避免

weixin_72959097的博客 511
上一篇: CrewAI vs AutoGen vs LangGraph vs MetaGPT vs OpenAI Agents SDK:收藏!新手程序员必看的大模型智能体框架选型指南
下一篇: 收藏!Java程序员转行大模型开发:从入门到实践,小白也能轻松上手
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值