2026收藏级指南:2025年初DeepSeek引爆格局,程序员必学大模型破局职业危机

Transformer是什么?看完这篇你就醍醐灌顶 前言 由谷歌团队提出的预训练语言模型BERT近年来正在各大自然语言处理任务中屠榜(话说学者们也挺有意思的,模型名都强行凑个芝麻街的人物名,哈哈哈)。 BERT算法的最重要的部分便是Transformer的概念,它本质上是Transformer的编码器部分。 而Transformer是什么呢?transformer是永远的神,自从transformer使用了抛弃rnncnn的纯attention机制之后,各种基于transformer结构的预训练模型都如雨后春笋般雄起,而transformer中最重要就是使用 阅读详情

站在2026年回望,2025年刚拉开序幕时,DeepSeek便如一颗重磅AI炸弹,在IT从业者的职业赛道上炸开了全新格局,也让大模型技术彻底从“前沿概念”走进了行业刚需的核心视野。

阿里云核心业务全面接入 Agent 体系, 字节跳动 30% 的后端岗位要求具备大模型开发能力

腾讯、京东、百度等大厂也纷纷敞开怀抱,招聘岗位 80% 都和 AI 相关。

img

大模型就像一把重构行业的密钥,正在重新绘制技术开发的底层蓝图。曾经占据主流的CRUD传统开发模式,在AI原生应用的快速迭代下,正逐渐被挤压到行业边缘,技术迭代的速度远超多数程序员的预期。

这绝非简单的技术更新迭代,对广大程序员而言,更像是一场迫在眉睫的职业生存危机——稍有松懈就可能被行业淘汰。

  • 业务端加速转型,领导明确要求用RAG技术优化企业知识库检索效率,自己却对RAG的核心逻辑、实现步骤一无所知,只能束手无策;
  • 想抓住风口转型AI团队管理,可面对大模型微调需求,连数据标注标准、数据集规模配置、微调参数调试等基础问题都毫无概念;
  • 立志转行热门的大模型应用开发工程师,投递简历时才发现,多数岗位都要求具备实际项目落地经验,而自己却连基础的大模型调用、API集成实操都未接触过;
  • 甚至有不少资深开发者发现,曾经赖以生存的热门开发框架、大数据工具,如今已不再是叩开理想工作大门的万能钥匙,AI能力正成为简历的核心加分项。

当下技术圈虽受降薪、裁员的寒流影响,但AI相关技术岗位却逆势突围,宛如春日里蓬勃生长的新芽,不仅招聘需求疯狂激增,薪资水平更是实现150%的逆势上涨。为了抢夺优质大模型人才,大厂纷纷开出70-100万的年薪套餐,部分头部企业还附带股权、技术培训等额外福利,足以见得行业对大模型人才的迫切需求。

在这里插入图片描述

行业趋势已十分明确:不出1年,“具备AI大模型项目开发经验”大概率会成为技术岗简历投递的基础门槛,而非加分项。对程序员而言,现在入局学习大模型技术,正是抢占职业先机的黄金窗口期。

AI大模型工程师的现状与趋势

从当前行业现状来看,大模型技术的落地场景正持续拓宽,已从互联网行业渗透到金融、医疗、自动驾驶、工业制造、个性化推荐等多个领域。未来3-5年,大模型将成为各行业数字化转型的核心支撑,从智能客服的精准应答的医疗影像的辅助诊断,从自动驾驶的场景决策到电商平台的个性化推送,都离不开大模型技术的赋能。

对程序员尤其是小白开发者而言,选择大模型方向不仅意味着掌握前沿核心技术,更能收获广阔的职业发展空间。相较于传统开发岗位,大模型领域的技术迭代虽快,但入门路径清晰——从基础的模型调用、Prompt工程入手,再逐步深入RAG、模型微调、AI原生应用开发,循序渐进就能积累实操经验。而且目前行业正处于人才缺口期,小白提前布局学习,更容易在求职中脱颖而出,避开传统开发岗位的激烈内卷。

小白/程序员如何系统学习大模型LLM?

作为在一线互联网企业深耕十余年的技术老兵,我经常收到小白和程序员朋友的提问:“零基础怎么入门大模型?”“自学没有方向怎么办?”“实战项目怎么找?”等问题。难以高效入门。

这里为了帮助大家少走弯路,我整理了一套全网最全最细的大模型零基础教程。涵盖入门思维导图、经典书籍手册、实战视频教程、项目源码等核心内容。免费分享给需要的朋友!

图片

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

1、我们为什么要学大模型?

很多开发者会问:大模型值得花时间学吗?答案是肯定的——学大模型不是跟风追热点,而是抓住数字经济时代的核心机遇,其背后是明确的行业需求和实打实的个人优势:

第一,行业刚需驱动,并非突发热潮。大模型是AI规模化落地的核心引擎,互联网产品迭代、传统行业转型、新兴领域创新均离不开它,掌握大模型就是拿到高需求赛道入场券。

第二,人才缺口巨大,职业机会稀缺。2023年我国大模型人才缺口超百万,2025年预计达400万,具备相关能力的开发者岗位多、薪资高,是职场核心竞争力。

第三,技术赋能增效,提升个人价值。大模型可大幅提升开发效率,还能拓展职业边界,让开发者从“写代码”升级为“AI解决方案设计者”,对接更高价值业务。

对于开发者而言,现在入门大模型,不仅能搭上行业发展的快车,还能为自己的职业发展增添核心竞争力——无论是互联网大厂的AI相关岗位,还是传统行业的AI转型需求,都在争抢具备大模型技术能力的人才。

在这里插入图片描述

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

2、大模型入门到实战全套学习大礼包分享

最后再跟大家说几句:只要你是真心想系统学习AI大模型技术,这份我耗时许久精心整理的学习资料,愿意无偿分享给每一位志同道合的朋友。

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

部分资料展示

2.1、 AI大模型学习路线图,厘清要学哪些

对于刚接触AI大模型的小白来说,最头疼的问题莫过于“不知道从哪学起”,没有清晰的方向很容易陷入“东学一点、西补一块”的低效困境,甚至中途放弃。

为了解决这个痛点,我把完整的学习路径拆解成了L1到L4四个循序渐进的阶段,从最基础的入门认知,到核心理论夯实,再到实战项目演练,最后到进阶优化与落地,每一步都明确了学习目标、核心知识点和配套实操任务,带你一步步从“零基础”成长为“能落地”的大模型学习者。后续还会陆续拆解每个阶段的具体学习内容,大家可以先收藏起来,跟着路线逐步推进。

img

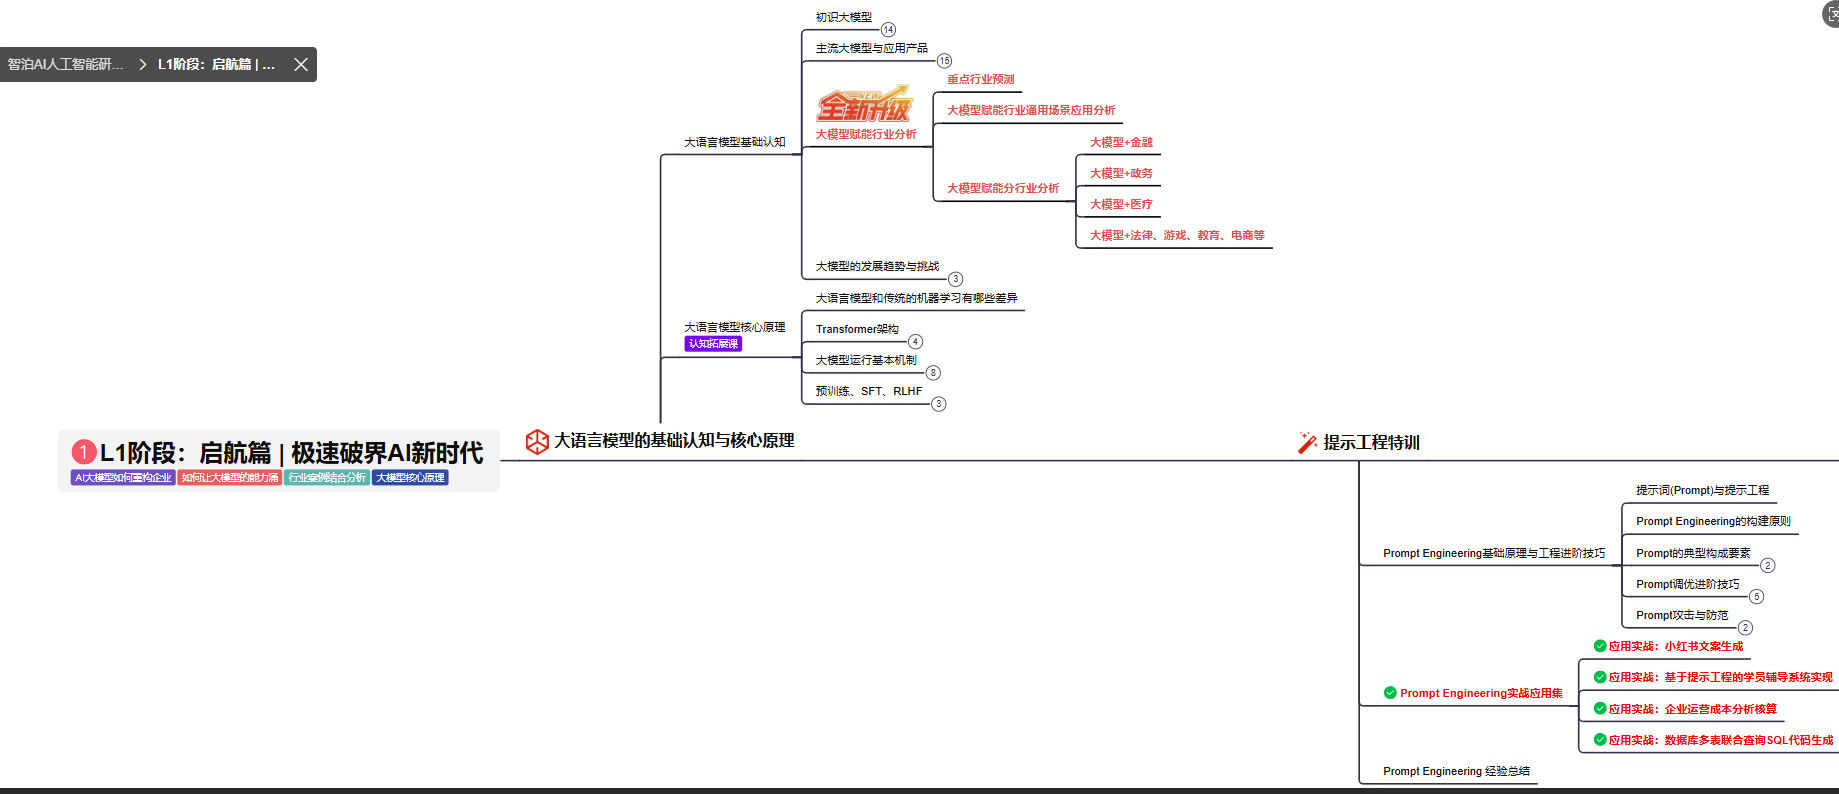
L1级别:大模型核心原理与Prompt

在这里插入图片描述

L1阶段: 将全面介绍大语言模型的基本概念、发展历程、核心原理及行业应用。从A11.0到A12.0的变迁,深入解析大模型与通用人工智能的关系。同时,详解OpenAl模型、国产大模型等,并探讨大模型的未来趋势与挑战。此外,还涵盖Pvthon基础、提示工程等内容。
目标与收益:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为AI应用开发打下坚实基础。

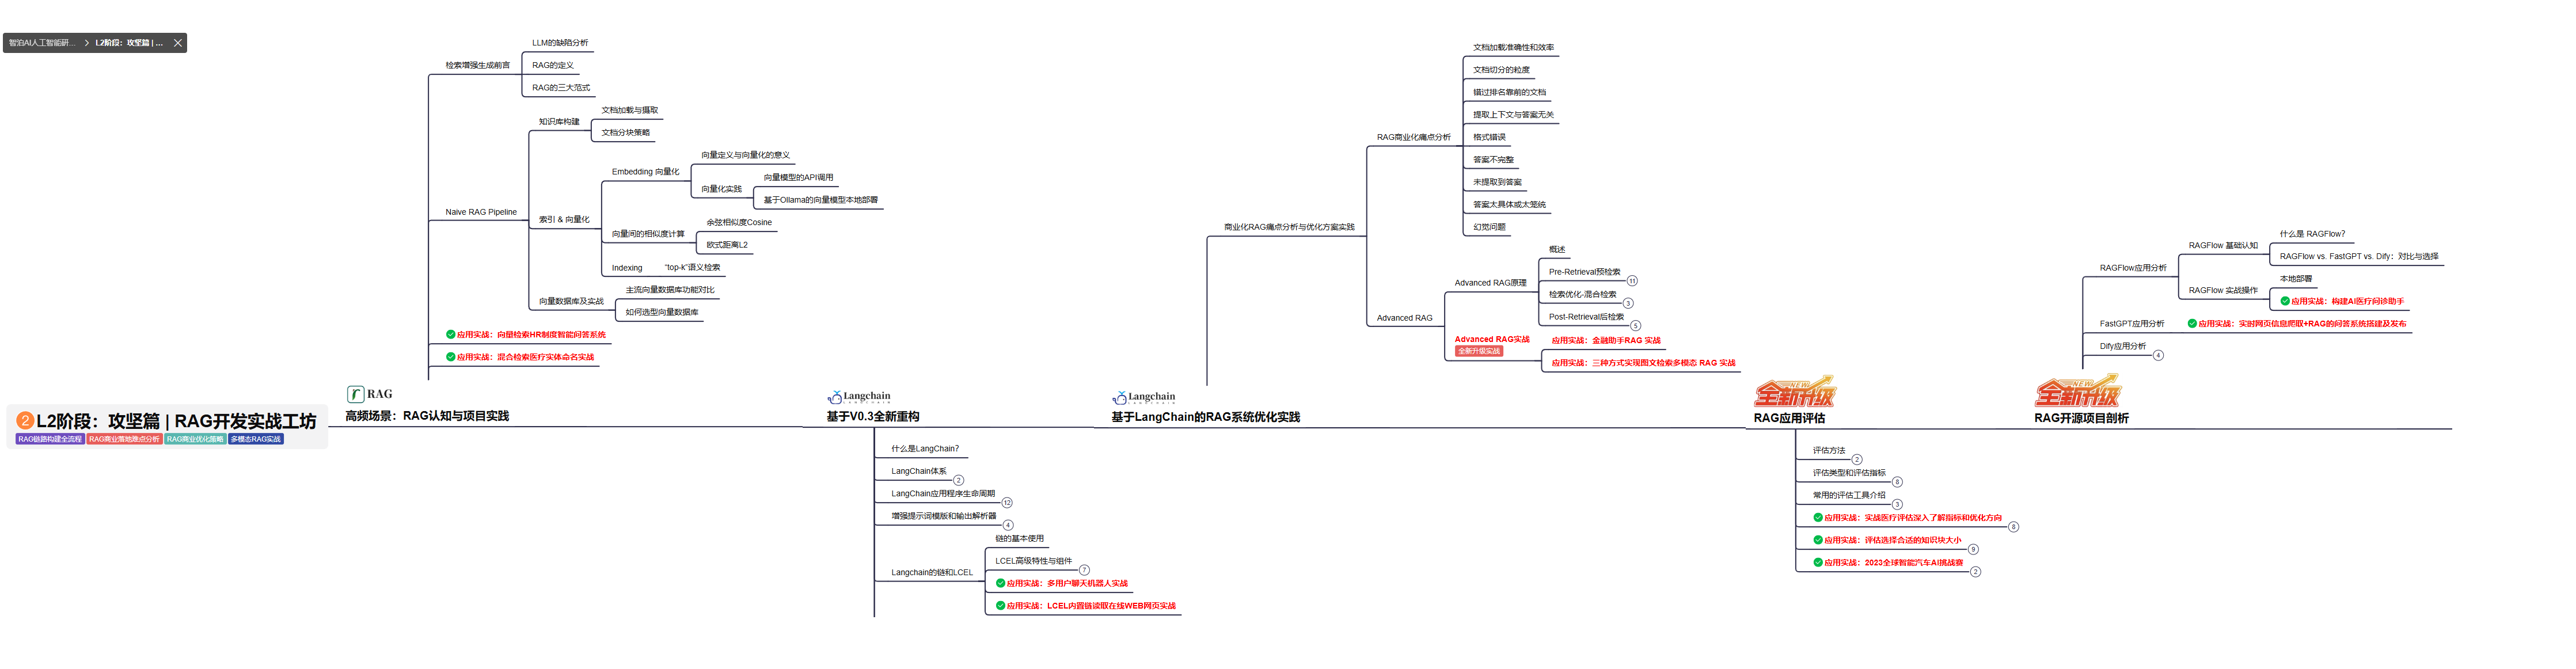
L2级别:RAG应用开发工程
请添加图片描述

L2阶段: 将深入讲解AI大模型RAG应用开发工程,涵盖Naive RAGPipeline构建、AdvancedRAG前治技术解读、商业化分析与优化方案,以及项目评估与热门项目精讲。通过实战项目,提升RAG应用开发能力。

目标与收益: 掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。

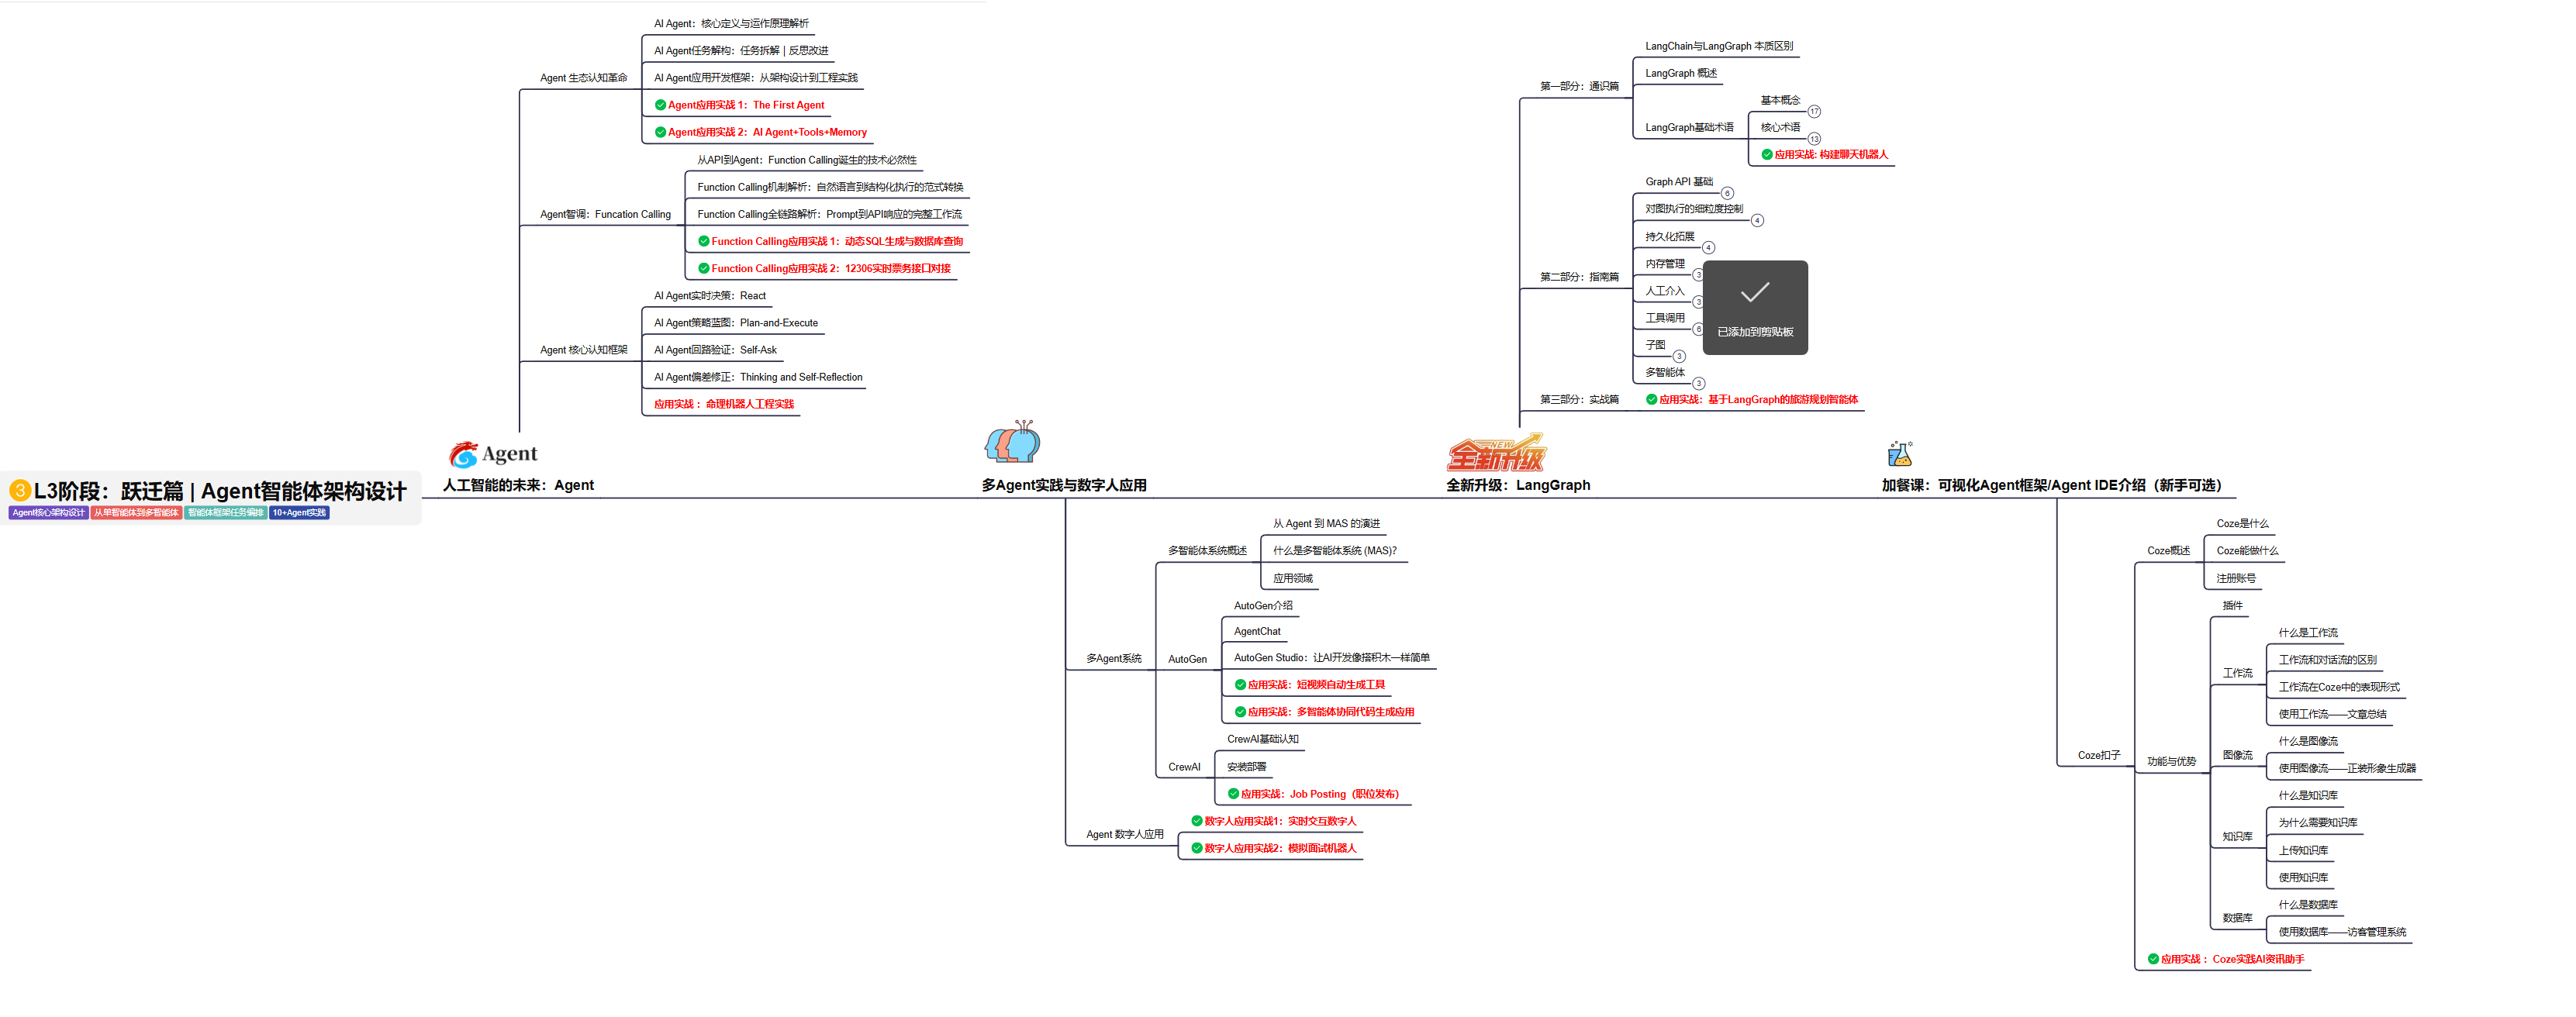
L3级别:Agent应用架构进阶实践
请添加图片描述

L3阶段: 将 深入探索大模型Agent技术的进阶实践,从Langchain框架的核心组件到Agents的关键技术分析,再到funcation calling与Agent认知框架的深入探讨。同时,通过多个实战项目,如企业知识库、命理Agent机器人、多智能体协同代码生成应用等,以及可视化开发框架与IDE的介绍,全面展示大模型Agent技术的应用与构建。

目标与收益:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。

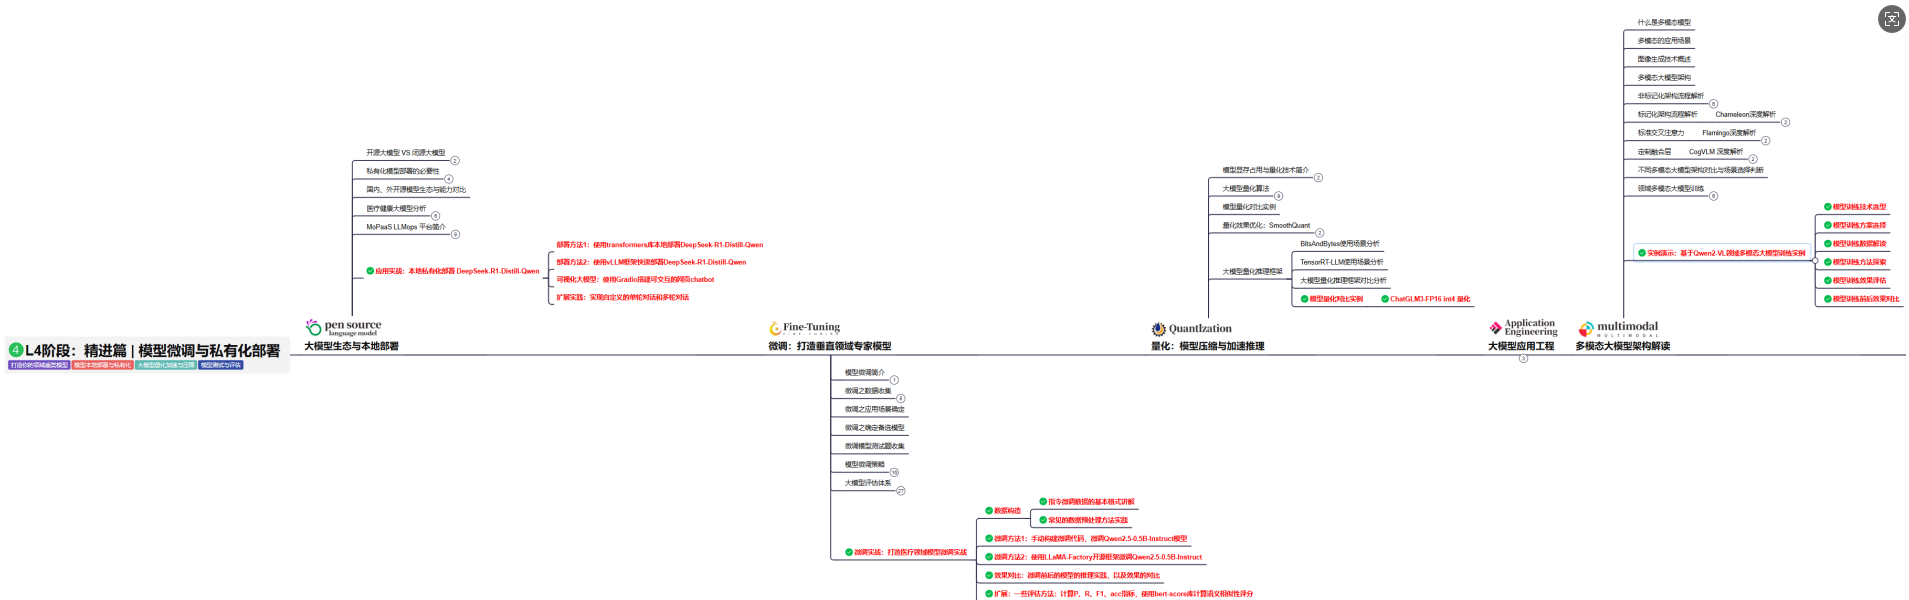
L4级别:模型微调与私有化大模型
在这里插入图片描述

L4级别: 将聚焦大模型微调技术与私有化部署,涵盖开源模型评估、微调方法、PEFT主流技术、LORA及其扩展、模型量化技术、大模型应用引警以及多模态模型。通过chatGlM与Lama3的实战案例,深化理论与实践结合。

目标与收益:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。

2.2、 全套AI大模型应用开发视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。

在这里插入图片描述

2.3、 大模型学习书籍&文档

收录《从零做大模型》《动手做AI Agent》等经典著作,搭配阿里云、腾讯云官方技术白皮书,帮你夯实理论基础。

在这里插入图片描述

2.4、 AI大模型最新行业报告

2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

2.5、大模型大厂面试真题

整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。

img

【大厂 AI 岗位面经分享(107 道)】

img

【AI 大模型面试真题(102 道)】

img

【LLMs 面试真题(97 道)】

img

2.6、大模型项目实战&配套源码

学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

img

适用人群

在这里插入图片描述

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型

  • 带你了解全球大模型

  • 使用国产大模型服务

  • 搭建 OpenAI 代理

  • 热身:基于阿里云 PAI 部署 Stable Diffusion

  • 在本地计算机运行大模型

  • 大模型的私有化部署

  • 基于 vLLM 部署大模型

  • 案例:如何优雅地在阿里云私有部署开源大模型

  • 部署一套开源 LLM 项目

  • 内容安全

  • 互联网信息服务算法备案

  • …

    👇👇扫码免费领取全部内容👇👇

    在这里插入图片描述

3、这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

transformer中QKV的通俗理解(剩女与备胎的故事) 用vit的时候读了一下transformer的思想,前几天面试结束之后发现对QKV又有点忘记了, 写一篇文章来记录一下 参考链接: 哔哩哔哩:在线激情讲解transformer&Attention注意力机制(上)在线激情讲解transformer&Attention注意力机制(上)_哔哩哔哩_bilibiliAttention is all you need介绍 更具体的介绍可以去阅读论文在Attention is all you need这篇文章中提出了著名的Transformer模型Transforme 阅读详情

相关推荐

LightRAG:简单快速的检索增强生成框架快速上手

你是环境科学专家,提供详细且结构化的回答,并包含示例。---对话历史---{history}---知识库------响应规则---目标格式和长度:{response_type}""" response_custom = rag . query("可再生能源的主要优势是什么?

sinat_33203678的博客 1934

变形金刚——Transformer入门刨析详解

Transformer详解

m0_67505927的博客 10万+

HyperMesh实战:5种复杂载荷场景下的field映射技巧(附TCL脚本)

本文详细介绍了HyperMesh在5种复杂载荷场景下的field映射技巧,包括轴承载荷的圆柱坐标系映射、粉末压力中的切向力处理、实验数据到有限元模型的场映射、多工况载荷的组合映射以及局部细化网格的边界条件传递。通过实战案例和TCL脚本,帮助工程师高效解决有限元分析中的载荷映射难题,提升工作效率。

fanta的博客 294

Transformer详解

近期Transformer MLP系列模型的出现,增加了CV领域的多样性。但是Transformer这一不同领域的模型对学习者来说需要一个细致的学习过程.下面就是本菜鸟总结学习路线。

qq_52302919的博客 7万+

RACECAR底层平台安装:Jetson Nano+ROS Melodic全栈部署指南

移动机器人开发中,底层平台安装是将硬件转化为可编程移动平台的关键起点。其核心在于嵌入式系统、ROS中间件与传感器驱动的深度协同——需兼顾内核模块加载、GPIO/PWM精确控制、I2C设备初始化及ROS工作空间构建等多层技术耦合。尤其在竞速级小车如RACECAR场景下,Jetson Nano的硬件加速能力、MPU6050 IMU固件加载、TB6612FNG电机驱动配置等细节,直接决定运动控制精度与实时性。本文聚焦Ubuntu 18.04 + ROS Melodic + JetPack 4.4.1技术栈,覆盖从

weixin_32025789的博客 256

CRMEB小程序订阅消息实战指南:PHP配置与疑难排查

本文提供CRMEB小程序订阅消息的完整实战指南,重点解析PHP环境下的配置流程与常见错误解决方法。文章从订阅消息的核心规则讲起,详细拆解了从微信后台获取模板到CRMEB后台完成字段映射的关键步骤,并提供了从用户授权、缓存清除到服务器日志检查的逐层排查方案,帮助开发者高效打通消息通道,避免常见配置陷阱。

weixin_29022115的博客 320

【超详细】【原理篇&实战篇】一文读懂Transformer

Transformer是一种用于自然语言处理(NLP)和其他序列到序列(sequence-to-sequence)任务的深度学习模型架构,它在2017年由Vaswani等人首次提出。Transformer架构引入了自注意力机制(self-attention mechanism),这是一个关键的创新,使其在处理序列数据时表现出色。

艰难困苦,玉汝于成。 68万+

Android 蓝牙——概述(一)

Profiles (蓝牙应用规范),它从应用场景的角度为蓝牙技术的使用制定了不同的规范。这也是和大众日常生活接触最多的一部分。蓝牙支持很多Profiles:MAP:(MessageAccessProfile),短信访问协议,允许设备间的信息交换,短信。使用场景:智能车载中同步短信等信息。HFP:(Hands-free Profile),电话免提协议,让蓝牙设备(如蓝牙耳机/车机)可以控制电话,如接听、挂断、拒接等。

小旭的专栏 3492

Transformer的Q、K、V和Mutil-Head Self-Attention(超详细解读)

举个例子我们在某宝上搜索东西,输入的搜索关键词就是Q,商品对应的描述就是K,Q与K匹配成功后搜索出来的商品就是V。Q、K、V经过Linear然后经过h个Self-Attention,得到h个输出,其中h指的是注意力的头数。更多的头数意味着更强大的模型能力,比如LLM大模型Baichuan-13B中的head数目是40,而Baichuan-7B中的head数目是32。是三个可训练的参数矩阵,输入矩阵X分别与三个矩阵参数进行相乘,相当于进行一次线性变换,得到了Q、K、V。,那Q、K、V是怎么来的呢?

weixin_45303602的博客 4万+

FastAPI 极简教程(偏实战,一篇搞定)

本文是一篇FastAPI实战教程,通过最少的概念讲解快速掌握FastAPI的核心功能。文章首先介绍FastAPI是基于Starlette和Pydantic的高性能Python API框架,具有自动生成文档、类型驱动校验、异步支持和依赖注入等优势。教程从安装环境开始,演示了如何创建最小项目并编写第一个"Hello World"接口。接着详细讲解了路由参数处理(Path/Query/Body)、Pydantic数据模型校验、响应模型控制、状态码设置等核心功能。在高级功能方面,重点介绍了错误处

AI天才研究院 814

AgentScope实战训练营- Java从零开始快速构建Agent完整教程

本文基于阿里巴巴开源的 AgentScope Java 框架,从零开始手把手带你构建 AI 智能体应用。内容涵盖环境搭建、基础对话、工具调用、结构化输出、多Agent流水线、Hook可观测性、会话持久化、MCP协议、RAG知识库集成、多模态工具、技能系统、Spring Boot Web部署等21个核心模块,附带完整可运行代码示例,帮助Java开发者快速掌握Agent开发全流程。

program哲学 863

神经网络算法 - 一文搞懂 Transformer(总体架构 & 三种注意力层)

本文将从三个方面,带您一文搞懂**输入嵌入:将输入的文本转换为向量,便于模型处理。位置编码:给输入向量添加位置信息,因为Transformer并行处理数据而不依赖顺序。多头注意力:让模型同时关注输入序列的不同部分,捕获复杂的依赖关系。残差连接与层归一化:通过添加跨层连接和标准化输出,帮助模型更好地训练,防止梯度问题。带掩码的多头注意力:在生成文本时,确保模型只依赖已知的信息,而不是未来的内容。前馈网络:对输入进行非线性变换,提取更高级别的特征。

xxue345678的博客 3万+

第16课:动手实战中文句法依存分析

句法分析是自然语言处理(NLP)中的关键技术之一,其基本任务是确定句子的句法结构或者句子中词汇之间的依存关系。主要包括两方面的内容:一是确定语言的语法体系,即对语言中合法句子的语法结构给予形式化的定义;另一方面是句法分析技术,即根据给定的语法体系,自动推导出句子的句法结构,分析句子所包含的句法单位和这些句法单位之间的关系。 句法分析被用在很多场景中,比如搜索引擎用户日志分析和关键词识别,比如信息抽...

春华秋实 2437

你真的看懂Transformer了吗?小白学习笔记为你答疑解惑

Transformer是一种基于注意力机制的序列到序列模型,它在机器翻译任务中表现出色并逐渐成为自然语言处理领域的主流模型。Transformer模型的核心思想是使用自注意力机制(self-attention)来捕捉输入序列中各个位置的上下文关联。自注意力机制允许模型在编码和解码过程中对不同位置的信息进行加权,使得模型能够更好地理解上下文,并将重要的信息加权汇聚起来。通过多层的自注意力机制和前馈神经网络,Transformer模型能够学习到输入序列的表示,并生成与任务相关的输出。

xuleoo的博客 9438

【Unity实战篇 】| 游戏中实现镂空遮罩效果【矩形、圆形镂空遮罩】

本文来写一下怎样在Unity中完成一个 镂空遮罩 的效果。 镂空遮罩 比较常用的有两种:矩形镂空遮罩、圆形镂空遮罩。 镂空遮罩 在游戏中常被当做新手引导必备的内容,可以给玩家更多不一样的体验。 下面就一起来看一下怎样做出这种效果吧!

努力前行,总会成为自己心中的那道光 1万+

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

LightRAG – 香港大学推出的开源检索增强生成系统

LightRAG是由香港大学研究团队推出的一种检索增强生成(Retrieval-Augmented Generation, RAG)系统,基于整合图结构索引和双层检索机制,提升大型语言模型在信息检索中的准确性和效率。系统能捕捉实体间的复杂依赖关系,全面理解信息,处理具体和抽象查询,确保用户获得既相关又丰富的响应。LightRAG具备快速适应新数据的能力,在动态环境中保持高效和准确,基于增量更新算法及时整合新数据,无需重建整个知识库。

u010291330的博客 4003

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

LightRAG开源了!轻巧、强大,GraphRAG的进化版

现有的RAG系统老是搞不清复杂关系,答案经常被切碎,缺乏上下文,难以真正理解问题。而LightRAG就是来解决这些问题的,它把图结构引入文本索引和检索,采用,从低到高全面覆盖信息。更酷的是,它还能更新数据,保持实时高效的响应,而且它已经开源了哦!并且你现在可以通过简单的API调用来实现多种检索模式,包括本地、全局和混合检索。

2401_84208172的博客 8497

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Transformer 模型详解

本内容主要介绍 Transformer 模型的具体实现。

步入人工智能 37万+

AI大模型系列之七:Transformer架构讲解

Transformer模型设计之初,用于解决机器翻译问题,是完全基于注意力机制构建的编码器-解码器架构,编码器和解码器均由若干个具有相同结构的层叠加而成,每一层的参数不同。编码器主要负责将输入序列转化为一个定长的向量表示,解码器则将这个向量解码为输出序列。Transformer总体架构可分为四个部分:输入部分、编码器、解码器、输出部分。

Peter_Changyb的博客 1万+

大模型入门到精通之GraphRAG、LightRAG、AgenticRAG,如何选择?

如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

2401_85375186的博客 1847

Transformer 大模型架构深度解析(4)详解 Transformer 架构

例如:句子 The animal didn’t cross the street because it was tired,其中 it 和 animal 的关联必然最大,其权重也最大,it 的语音单元必然包含 animal 的信息,如此的 Decoder 就知道了代词 it 指代的是名称 animal 而不是其他词,翻译为 “动物”。由于深度神经网络中每一层的输入都是上一层的输出,因此多层传递下,对网络中较高的层,之前的所有神经层的参数变化会导致其输入的分布发生较大的改变。

烟云的计算 6591

深入理解上下文工程(Context Engineering):从入门到精通

想象这样一个场景:你正在用ChatGPT帮助分析一份50页的市场调研报告。开始时,AI的回答精准到位,但随着对话深入,你发现它开始"健忘"——忘记了报告中的关键数据,甚至开始给出与前面矛盾的建议。这不是AI模型本身的问题,而是遇到了上下文管理的挑战。

2401_85373691的博客 1835

【深度学习】深刻理解“变形金刚”——Transformer

Transformer 是一种用于处理序列数据的深度学习模型架构,最初由 Vaswani 等人在 2017 年的论文《Attention is All You Need》中提出。它彻底改变了自然语言处理(NLP)领域,成为许多高级任务(如机器翻译、文本生成、问答系统等)的基础架构。Transformer 的核心思想是,而不依赖于传统的 RNN 或 CNN,在机器翻译上效果特别好,横扫NLP领域。

weixin_62403234的博客 3912

【Transformer系列】深入浅出理解Transformer网络模型(综合篇)

【Transformer系列】深入浅出理解Transformer网络模型(综合篇)

IT菜鸟 1万+

一文搞懂GraphRAG、LightRAG、AgenticRAG,看这一篇就够了!

一文搞懂GraphRAG、LightRAG、AgenticRAG,看这一篇就够了!

xxue345678的博客 1万+
上一篇: 收藏!行业大模型发展全景解析:从技术迭代到垂直落地,程序员必看指南
下一篇: AI会取代程序员吗?(Java转大模型必藏指南)
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值