


本文深度拆解LangChain开源框架,这是一款专为大语言模型(LLM)应用开发设计的工具集,能让开发者以“搭积木”的方式快速构建AI应用。文中不仅涵盖Model I/O、Chains、Memory、Tools、Agent、Retrieval等核心组件的实操方法与环境搭建步骤,还补充了组件选型技巧、避坑要点,助力新手快速入门。尽管LangChain存在部分争议,但凭借其标准化的模块拆解能力,仍是现阶段大模型开发入门的优选工具,能帮助开发者吃透AI应用的底层逻辑。

1、LangChain框架核心认知
1.1 什么是LangChain?
LangChain由哈佛大学开发者Harrison Chase(哈里森·蔡斯)于2022年10月发起研发,比ChatGPT(2022年11月30日问世)还要早一个月,是一款开源的LLM应用开发框架。其核心目标是降低AI应用构建门槛,通过模块化组合,让开发者无需深耕底层逻辑,就能快速搭建智能体(Agent)、问答系统(QA)、对话机器人、知识库等复杂功能。
LangChain在Github上的热度持续攀升,已成为大模型开发领域的主流工具之一:

结合AI大模型整体架构,LangChain的定位清晰可见,是连接LLM与实际应用的核心桥梁:


1.2 为什么优先选LangChain?
LangChain的核心价值的在于提供了一套“高可用、可扩展、低耦合”的模块化工具集,能帮开发者跳过底层复杂逻辑,聚焦业务场景落地。它不仅学习成本低、开发难度小,还支持组件单独调用,经过迭代已从单一开源包,成长为覆盖开发、调试、部署全流程的完整生态。
以下通过对比直接调用大模型API与使用LangChain开发的差异,更直观体现其优势:
| 对比维度 | 直接调用大模型API | 使用LangChain开发 |
|---|---|---|
| 开发模式 | 调用简单,但复杂功能需大量自定义代码,逻辑冗余 | 模块化组装,预制组件与链式流程,复杂逻辑结构化 |
| 多模型支持 | 需为OpenAI、Anthropic等不同厂商API单独编写适配代码 | 统一接口封装,可灵活切换、组合多厂商模型,无需改核心逻辑 |
| 外部数据集成 | 需自行实现数据加载、处理、向量化、检索全流程 | 内置RAG能力,一键对接PDF、数据库、API等外部数据源 |
| 上下文管理 | 手动维护对话历史,易超出Token限制,上下文断裂 | 内置Memory组件,支持短期/长期记忆管理,保持对话连贯性 |
| 复杂任务自动化 | 多步骤推理、工具调用逻辑复杂,开发成本高 | 通过Agent实现自主决策,自动调用计算器、搜索引擎等工具完成任务 |
| 生产部署与调试 | 缺乏标准化工具,监控、调试全靠自定义,落地困难 | 配套LangSmith平台,提供调试、监控、链路追踪等全流程能力 |
1.3 LangChain V0.3架构设计(宏观视角)
LangChain框架由多个功能包组成,整体分为架构、组件、部署三个层次,各模块各司其职又可协同工作:

核心组成部分解析:
- LangChain核心包:封装核心API,支撑应用认知架构,细分为三个子包:
- langchain:包含Chains、Agents、Retrieval策略等核心业务组件;
- langchain-community:第三方集成模块,覆盖Model I/O、Retrieval、Tool等外部对接能力;
- langchain-Core:提供基础抽象与LangChain表达式语言(LCEL),是组件协同的核心。
- LangGraph:基于有向图+条件边构建多智能体应用,支持条件分支、循环、并行等复杂控制流,还能实现状态持久化、断点续跑、人机协作等高级功能,是当前多智能体开发的热门模块。
- LangSmith:大模型应用全生命周期管理工具,集成调试、沙盒测试、提示词管理、注释、性能监控六大功能,与LangChain无缝衔接,助力从原型快速落地生产。
- LangServe:基于FastAPI构建,可将LangChain开发的Chain、Agent快速封装为REST API服务,极大简化AI应用服务化、规模化部署流程。
注:目前LangChain生态中,LangGraph与LangSmith是最受开发者关注的两大模块,覆盖复杂场景开发与生产运维核心需求。
1.4 LangChain六大核心组件
LangChain的灵活性源于其六大核心组件,开发者可通过灵活组合这些组件,搭建满足不同场景的LLM应用:

- Model I/O(模型交互接口):标准化LLM交互流程,封装提示词模板调用、模型推理、输出解析三大环节,实现输入标准化、输出结构化,解耦应用与底层模型。
- Chains(链):串联多个组件形成自动化工作流,比如“提示词模板→LLM→输出解析器”的简单链,或多子链组合的复杂流程,实现步骤化任务处理。
- Memory(记忆):存储对话历史与上下文信息,为多轮对话提供支持,让应用具备“有状态”交互能力。
- Agents(智能体):LLM的“决策大脑”,能根据用户需求自主判断是否调用工具、调用哪种工具,实现复杂任务的自动化拆解与执行。
- Retrieval(检索):RAG架构的核心模块,负责从海量文档、数据源中检索与问题相关的信息,为LLM提供外部知识支撑,解决模型知识冻结问题。
- Callbacks(回调机制):监控LLM应用运行全流程,支持日志记录、性能分析、流式输出等功能,保障应用可观测性,便于优化迭代。
2、LangChain环境准备与快速上手
2.1 环境安装(Python版)
LangChain基于Python开发,需先确保本地安装Python 3.8及以上版本,再通过以下两种方式安装LangChain:
# 方式一:pip安装(推荐,适配大多数场景)
pip install langchain

# 方式二:conda安装(适合conda环境管理的用户)
conda install langchain -c conda-forge
补充:若需使用LangSmith、LangGraph等扩展功能,需单独安装对应包,如pip install langsmith langgraph。
2.2 快速demo:调用ChatOpenAI模型
from langchain_openai import ChatOpenAI

# 初始化ChatOpenAI模型
chat_model = ChatOpenAI(
    model_name="gpt-3.5-turbo",  # 模型名称,可根据需求切换
    base_url="https://api.openai.com/v1",  # 模型交互地址,国内用户可配置代理地址
    api_key="your-api-key",  # 个人API密钥,需从OpenAI平台申请
    temperature=0.7  # 随机性参数,0-1之间,值越高生成内容越灵活
)

注:API密钥需从对应模型厂商平台申请,国内用户可选用通义千问、文心一言等国产模型,只需替换对应模型类(如ChatTongyi、ChatErnie),调用逻辑一致。
3、核心组件实操:Model I/O
3.1 Model I/O核心作用
Model I/O是应用与LLM的“沟通桥梁”,类比JDBC与数据库的关系,核心是解耦应用逻辑与底层模型实现。其工作流程分为三步:输入格式化(Format)→模型调用(Predict)→输出解析(Parse),对应Prompt Template、Model、Output Parser三个子组件。

3.2 LangChain支持的三大模型类型
- LLMs(大语言模型):非对话型模型,处理纯字符串输入输出,适用于一次性文本生成、翻译、总结等任务,是基础文本处理组件。
from langchain_openai import OpenAI `` ``# 初始化LLM模型 ``llm_model = OpenAI(api_key="your-api-key") ``# 调用模型 ``response = llm_model.invoke("什么是LangChain框架?") ``print(response) - Chat Models(对话模型):专为多轮对话优化,输入输出为结构化消息对象(含角色、内容),能更好地维护对话上下文,是对话机器人的核心。
from langchain_openai import ChatOpenAI ``from langchain.schema import HumanMessage `` ``# 初始化对话模型 ``chat_model = ChatOpenAI( `` model_name="gpt-3.5-turbo", `` api_key="your-api-key", `` temperature=0.7 ``) ``# 调用模型(输入为HumanMessage对象) ``response = chat_model.invoke(HumanMessage(content="用一句话概括反洗钱?")) ``print(response.content)
- Embedding Model(嵌入模型):将文本、图片等非结构化数据转换为高维向量,核心特点是“语义相近,向量相近”,是RAG、语义检索的基础。
from langchain_community.embeddings import OllamaEmbeddings `` ``# 初始化本地部署的嵌入模型(以Ollama为例) ``embeddings_model = OllamaEmbeddings( `` model="nomic-embed-text", `` base_url="http://127.0.0.1:11434", # 本地服务地址 ``) ``# 文本向量化 ``vector = embeddings_model.embed_query("hello world") ``print(f"嵌入向量长度: {len(vector)}") ``print(f"前20个向量值: {vector[:20]}")
3.3 消息对象(Message)详解
对话模型中,消息是交互的基本单位,每条消息包含角色、内容及元数据(Token数、ID等),LangChain提供统一格式,支持跨模型兼容,核心消息类型有4种:
- SystemMessage:定义模型行为准则,设定角色、规则、环境信息,若模型不支持则自动合并到HumanMessage中。
- HumanMessage:用户输入内容,包括提问、指令等,是模型的核心输入源。
- AIMessage:模型输出结果,含文本内容与元数据(如工具调用信息、Token消耗)。
- ToolMessage/FunctionMessage:传递外部工具执行结果,供Agent决策使用,是工具与模型的衔接载体。
实操示例:多消息类型组合调用
from langchain_openai import ChatOpenAI
from langchain.schema import SystemMessage, HumanMessage

chat_model = ChatOpenAI(api_key="your-api-key")
# 组合系统消息与用户消息
messages = [
    SystemMessage(content="你是反洗钱领域专家,名为RiskHelper,回答简洁专业"),
    HumanMessage(content="什么是反洗钱?")
]
# 调用模型,返回AIMessage对象
response = chat_model.invoke(messages)
print(type(response))  # 输出:<class 'langchain.schema.messages.AIMessage'>
print(response.content)

3.4 Prompt Template(提示词模板)
固定提示词灵活性差,Prompt Template通过占位符变量动态生成提示词,支持多场景复用,还能有效约束模型输出,减少幻觉。好的提示词可解决60%以上的幻觉问题,是LLM应用优化的核心手段。
LangChain提供4类常用模板,覆盖不同场景:
- PromptTemplate:基础文本模板,生成无角色区分的纯字符串,适用于LLM模型。
from langchain.prompts import PromptTemplate `` ``# 定义模板({domain}为占位符) ``prompt_template = PromptTemplate( `` template="如何成为{domain}领域的专家?给出3个核心步骤", `` input_variables=["domain"] # 声明变量 ``) ``# 填充变量生成提示词 ``prompt = prompt_template.invoke({"domain": "反洗钱"}) ``# 调用模型 ``response = chat_model.invoke(prompt) ``print(response.content) - ChatPromptTemplate:生成结构化对话消息列表,含角色区分,适用于Chat Models,支持两种创建方式。
from langchain.prompts import ChatPromptTemplate `` ``# 方式一:构造函数创建 ``chat_prompt1 = ChatPromptTemplate([ `` ("system", "你是{domain}专家,名字叫{name}"), `` ("human", "帮我解答:{question}") ``]) ``# 方式二:from_messages方法创建(更简洁) ``chat_prompt2 = ChatPromptTemplate.from_messages([ `` ("system", "你是{domain}专家,名字叫{name}"), `` ("human", "帮我解答:{question}") ``]) ``# 填充变量调用 ``prompt = chat_prompt2.format(domain="反洗钱", name="RiskHelper", question="反洗钱的核心原则?") ``response = chat_model.invoke(prompt) ``print(response.content) - 特定角色消息模板:如SystemMessagePromptTemplate、HumanMessagePromptTemplate,可组合为ChatPromptTemplate,精准控制单条消息角色。
from langchain.prompts import ChatPromptTemplate ``from langchain.prompts.chat import SystemMessagePromptTemplate, HumanMessagePromptTemplate `` ``# 定义角色模板 ``system_template = SystemMessagePromptTemplate.from_template("你是{domain}专家,名字叫{name}") ``human_template = HumanMessagePromptTemplate.from_template("帮我解答:{question}") ``# 组合为ChatPromptTemplate ``chat_prompt = ChatPromptTemplate.from_messages([system_template, human_template]) ``# 填充变量调用 ``prompt = chat_prompt.format(domain="反洗钱", name="RiskHelper", question="反洗钱的核心原则?") ``response = chat_model.invoke(prompt) - FewShotPromptTemplate(样本模板):通过少量示例引导模型输出格式,适用于需要固定输出风格的场景。
from langchain.prompts import FewShotPromptTemplate, PromptTemplate `` ``# 1. 定义示例数据 ``examples = [ `` {"question": "什么是Spring Boot?", "answer": "基于Spring的Java开源框架,简化应用创建与部署"}, `` {"question": "什么是依赖注入?", "answer": "外部容器为对象提供依赖,解耦对象与依赖创建"}, `` {"question": "什么是RESTful API?", "answer": "遵循REST架构的Web接口,用HTTP方法操作资源"} ``] ``# 2. 定义示例模板 ``example_prompt = PromptTemplate( `` input_variables=["question", "answer"], `` template="问题: {question}\n答案: {answer}" ``) ``# 3. 创建FewShot模板 ``few_shot_prompt = FewShotPromptTemplate( `` examples=examples, # 示例数据 `` example_prompt=example_prompt, # 示例格式 `` suffix="问题: {question}", # 用户问题后缀 `` input_variables=["question"] # 变量 ``) ``# 生成提示词并调用 ``prompt = few_shot_prompt.format(question="什么是LangChain?") ``response = chat_model.invoke(prompt) ``print(response.content)
3.5 Output Parsers(输出解析器)
LLM默认返回字符串,输出解析器可将结果转换为JSON、列表、日期等结构化数据,便于应用后续处理。LangChain提供多种内置解析器,以下以常用的JsonOutputParser为例实操:
from langchain.output_parsers import JsonOutputParser
from langchain.prompts import PromptTemplate
from pydantic import BaseModel, Field

# 定义JSON格式(通过Pydantic约束字段)
class AntiMoneyLaundering(BaseModel):
    definition: str = Field(description="反洗钱定义,简洁明了")
    principle: list = Field(description="反洗钱核心原则,最多3条")

# 初始化JSON解析器
json_parser = JsonOutputParser(pydantic_object=AntiMoneyLaundering)

# 定义提示词模板(加入格式要求)
prompt_template = PromptTemplate(
    template="用一句话描述{name},并列出其核心原则。格式要求:{format_instructions}",
    input_variables=["name"],
    partial_variables={"format_instructions": json_parser.get_format_instructions()}
)

# 生成提示词并调用
prompt = prompt_template.invoke({"name": "反洗钱"})
response = chat_model.invoke(prompt)
# 解析为JSON格式
result = json_parser.parse(response.content)
print(type(result))  # 输出:<class '__main__.AntiMoneyLaundering'>
print(result.dict())  # 转换为字典

3.6 模型调用的3种方式(含异步)
LangChain通过Runnable接口统一组件调用方式,支持同步、异步、流式调用,适配不同场景需求:
- invoke:同步调用,单条输入,等待模型完全处理后返回结果,适用于简单任务。
- stream:流式调用,逐字符返回结果,提升用户交互体验,类比日常使用的AI聊天工具。
from langchain_openai import ChatOpenAI ``from langchain.prompts import ChatPromptTemplate `` ``chat_model = ChatOpenAI( `` api_key="your-api-key", `` streaming=True # 开启流式输出 ``) ``chat_prompt = ChatPromptTemplate.from_messages([ `` ("system", "你是反洗钱专家"), `` ("human", "详细讲解反洗钱的核心流程") ``]) ``prompt = chat_prompt.format(question="反洗钱核心流程?") ``# 流式输出 ``for chunk in chat_model.stream(prompt): `` print(chunk.content, end="", flush=True) - batch:批量调用,一次性发送多条输入,提升处理效率。
from langchain.schema import HumanMessage `` ``# 准备多条消息 ``messages_list = [ `` [HumanMessage(content="什么是风控?")], `` [HumanMessage(content="什么是反洗钱?")], `` [HumanMessage(content="什么是EDD?")] ``] ``# 批量调用 ``responses = chat_model.batch(messages_list) ``for res in responses: `` print(res.content)
补充异步调用方法:astream(异步流式)、ainvoke(异步单条)、abatch(异步批量),适用于异步编程场景,需配合async/await语法使用。
4、核心组件实操:Chains(链)
4.1 Chains核心价值
Chains将多个组件(提示词模板、模型、解析器、工具等)串联为自动化工作流,前一个组件输出作为后一个组件输入,实现“流水线式”任务处理。既支持“提示词模板→模型→解析器”的简单链,也支持多子链组合的复杂流程(如先总结文本→再翻译→最后生成报告)。

4.2 常用Chain组件实操(含弃用说明)
- LLMChain(已弃用):基础链,封装提示词模板与LLM,适用于简单单步任务。在LangChain 0.1.17版本标记为过时,1.0后移除,不推荐使用。
from langchain.chains import LLMChain # 过时警告 ``from langchain.prompts import ChatPromptTemplate `` ``chat_prompt = ChatPromptTemplate.from_messages([ `` ("system", "你是{domain}专家,名字叫{name}"), `` ("human", "{question}") ``]) ``# 构建LLMChain ``chain = LLMChain(llm=chat_model, prompt=chat_prompt) ``# 调用链 ``response = chain.invoke({"domain": "反洗钱", "name": "RiskHelper", "question": "反洗钱核心原则?"}) ``print(response)
- SequentialChain(已弃用):顺序链,串联多个子链,适用于分步任务,同样已过时,1.0后移除。
- LCEL(推荐):LangChain表达式语言,通过管道符
|组合组件,简洁灵活,支持动态调整流程,是1.0后推荐的链式构建方式。from langchain.prompts import ChatPromptTemplate ``from langchain.output_parsers import JsonOutputParser `` ``# 定义组件 ``json_parser = JsonOutputParser() ``chat_prompt = ChatPromptTemplate.from_messages([ `` ("system", "你是反洗钱专家,按格式输出JSON:{format_instructions}"), `` ("human", "描述{name}的定义和核心原则") ``]) ``# 用管道符组合链:提示词模板→模型→解析器 ``chain = chat_prompt | chat_model | json_parser `` ``# 调用链(传入变量) ``response = chain.invoke({ `` "name": "反洗钱", `` "format_instructions": json_parser.get_format_instructions() ``}) ``print(response)
补充其他实用Chain:
- LLMMathChain:数学计算链,将问题转换为Python表达式执行,解决LLM计算能力弱的问题;
- RouterChain:路由链,根据输入内容自动选择适配的子链处理,适用于多场景统一入口;
- StuffDocumentsChain:文档填充链,将多文档内容合并为提示词输入模型,适用于小批量文档处理。
5、核心组件实操:Memory(记忆)
5.1 Memory核心作用
LLM本身不具备上下文记忆能力,多轮对话的连贯性完全依赖Memory组件。Memory负责存储对话历史与上下文信息,每次调用模型时,将历史记录与当前问题合并为提示词,让模型“记住”之前的交互内容,实现有状态对话。
5.2 Memory工作原理

- 用户输入当前问题;
- Memory组件读取历史对话记录;
- 拼接“历史对话+当前问题”生成完整提示词;
- 发送提示词给模型,获取响应;
- 将当前对话(问题+响应)存入Memory,供下一轮调用。
5.3 常用Memory组件实操
LangChain提供多种Memory组件,适配不同对话场景,核心差异在于存储范围、Token消耗与连贯性平衡:
- ChatMessageHistory:基础记忆类,直接操作消息对象,轻量无依赖,但数据不持久化(程序重启丢失),是其他Memory的底层依赖。
from langchain.memory import ChatMessageHistory ``from langchain.schema import HumanMessage, AIMessage `` ``# 初始化记忆 ``history = ChatMessageHistory() ``# 添加对话记录 ``history.add_user_message("你好,我是RiskHelper") ``history.add_ai_message("你好!我是反洗钱领域助手,有什么可以帮你?") ``history.add_user_message("我是谁?") # 依赖历史记录回答 ``# 调用模型 ``response = chat_model.invoke(history.messages) ``print(response.content) # 输出:你是RiskHelper呀! - ConversationBufferMemory:完整存储所有对话历史,连贯性最强,但Token消耗随对话增长递增,适用于短对话场景。
from langchain.chains import LLMChain ``from langchain.prompts import PromptTemplate ``from langchain.memory import ConversationBufferMemory `` ``# 定义提示词模板({history}为记忆占位符) ``prompt_template = PromptTemplate.from_template( `` "历史对话:{history}\n当前问题:{input}" ``) ``# 初始化记忆 ``memory = ConversationBufferMemory(memory_key="history") ``# 构建链(集成记忆) ``chain = LLMChain(llm=chat_model, prompt=prompt_template, memory=memory) ``# 第一次调用 ``response1 = chain.invoke({"input": "用一句话描述LangChain?"}) ``print("第一次响应:", response1["text"]) ``# 第二次调用(依赖历史) ``response2 = chain.invoke({"input": "如何快速上手它?"}) ``print("第二次响应:", response2["text"])
- ConversationBufferWindowMemory:仅保留最近K轮对话,平衡连贯性与Token消耗,适用于中长篇对话。
from langchain.memory import ConversationBufferWindowMemory `` ``# 初始化记忆,保留最近10轮对话 ``memory = ConversationBufferWindowMemory(memory_key="history", k=10) ``chain = LLMChain(llm=chat_model, prompt=prompt_template, memory=memory) - ConversationSummaryMemory:生成对话摘要替代原始记录,减少Token消耗,支持长期对话,核心是用LLM提炼对话精髓。
from langchain.memory import ConversationSummaryMemory ``from langchain.memory.chat_message_histories import ChatMessageHistory `` ``# 初始化对话历史 ``history = ChatMessageHistory() ``history.add_user_message("什么是反洗钱?") ``history.add_ai_message("反洗钱是预防和打击洗钱犯罪的措施,核心是识别可疑交易。") ``history.add_user_message("反洗钱的核心原则有哪些?") ``# 基于对话历史生成摘要记忆 ``memory = ConversationSummaryMemory.from_messages(llm=chat_model, chat_memory=history) ``# 读取记忆(输出摘要) ``print(memory.load_memory_variables({}))
- ConversationSummaryBufferMemory:混合记忆,近期对话保留原始内容,早期对话生成摘要,兼顾连贯性与低消耗,是最实用的记忆组件之一。
from langchain.memory import ConversationSummaryBufferMemory `` ``memory = ConversationSummaryBufferMemory( `` llm=chat_model, `` max_token_limit=100, # 触发摘要的Token阈值 `` return_messages=True ``) ``# 保存对话上下文 ``memory.save_context({"input": "你好,我是RiskHelper"}, {"output": "你好!我是反洗钱助手。"}) ``memory.save_context({"input": "什么是反洗钱?"}, {"output": "反洗钱是预防洗钱犯罪的措施。"}) ``memory.save_context({"input": "什么是风控?"}, {"output": "风控是风险控制的简称。"}) ``# 读取记忆 ``print(memory.load_memory_variables({}))
避坑提示:部分模型(如DeepSeek)不支持get_num_tokens_from_messages方法,会导致记忆组件报错,需自定义子类实现该方法:
from langchain_openai import ChatOpenAI
from typing import List
from langchain.schema import BaseMessage

class DeepSeekChatOpenAI(ChatOpenAI):
    def get_num_tokens_from_messages(self, messages: List[BaseMessage]) -> int:
        # 自定义Token计算逻辑,可根据模型文档调整
        total_tokens = sum(len(msg.content) // 2 for msg in messages)
        return total_tokens

# 用自定义类初始化模型
chat_model = DeepSeekChatOpenAI(
    model_name="deepseek-chat",
    base_url="your-base-url",
    api_key="your-api-key"
)
6、核心组件实操:Tools(工具)
6.1 Tools核心价值
Tools是LLM与外部世界交互的“桥梁”,本质是可调用的函数封装,能扩展LLM的能力边界——让模型具备搜索、计算、数据库查询、文件操作等实际行动能力,解决LLM“只会思考不会动手”的问题。


6.2 Tool核心要素与使用流程
一个完整的Tool需包含5个要素:工具名称(唯一标识)、工具描述(引导Agent调用)、参数定义(输入约束)、返回类型、执行逻辑。使用流程分为4步:

- 工具创建:通过装饰器或类封装函数;
- 工具绑定:将工具注册到Agent,告知可用工具列表;
- 工具调用:Agent根据需求决策调用工具,构造参数;
- 结果处理:工具执行后返回结果,供Agent生成最终回答。
6.3 自定义Tool实操(两种方式)
- @tool装饰器(推荐,简洁高效)
from langchain.tools import tool `` ``# 用装饰器定义工具 ``@tool( `` name="multiply", # 工具名称 `` description="用于计算两个整数的乘积,输入为两个整数a和b", # 工具描述 `` return_direct=True # 结果直接返回给用户,不经过Agent二次处理 ``) ``def multiply(a: int, b: int) -> int: `` """计算两个整数的乘积""" `` return a * b `` ``# 调用工具 ``result = multiply.invoke({"a": 2, "b": 3}) ``print(result) # 输出:6 - StructuredTool.from_function(灵活配置)
from langchain.tools import StructuredTool `` ``# 定义工具函数 ``def multiply(a: int, b: int) -> int: `` """计算两个整数的乘积""" `` return a * b `` ``# 用StructuredTool封装 ``multiply_tool = StructuredTool.from_function( `` func=multiply, `` name="multiply", `` description="用于计算两个整数的乘积,输入为两个整数a和b" ``) `` ``# 调用工具 ``result = multiply_tool.invoke({"a": 4, "b": 5}) ``print(result) # 输出:20
6.4 Tool与Agent、大模型结合使用
Tool通常与Agent配合使用,由Agent决策是否调用工具,以下以“股票价格查询”为例实操:
from langchain_openai import ChatOpenAI
from langchain.tools import Tool
from langchain.agents import create_structured_chat_agent, AgentExecutor
from langchain import hub
from langchain.tools.convert import convert_to_openai_tool

# 1. 定义工具函数(模拟股票价格查询)
def get_stock_price(company_name: str) -> str:
    """查询指定公司当日股票收盘价,输入为公司名称(如腾讯、阿里)"""
    # 实际场景中可对接股票API,此处模拟返回
    mock_data = {"腾讯": "380.5港元", "阿里": "85.2美元"}
    return f"{company_name}当日收盘价:{mock_data.get(company_name, '暂无数据')}"

# 2. 封装为LangChain Tool
stock_tool = Tool(
    name="getStockPrice",
    func=get_stock_price,
    description="用于查询公司当日股票收盘价,输入为公司名称(如腾讯、阿里)"
)
tools = [stock_tool]

# 3. 转换为OpenAI工具格式(适配Agent)
openai_tools = [convert_to_openai_tool(tool) for tool in tools]

# 4. 加载预定义提示词模板
prompt = hub.pull("hwchase17/structured-chat-agent")

# 5. 创建Agent与执行器
agent = create_structured_chat_agent(chat_model, tools, prompt)
agent_executor = AgentExecutor(
    agent=agent,
    tools=tools,
    verbose=True,  # 开启日志,查看Agent思考过程
    handle_parsing_errors=True  # 处理解析错误
)

# 6. 执行查询
response = agent_executor.invoke({"input": "查询腾讯当日股票收盘价"})
print(response["output"])

避坑提示:Agent未调用工具的常见原因:①工具描述模糊,Agent无法匹配需求;②问题过于简单,Agent认为无需调用工具;③模型对工具调用支持度低(如部分国产模型)。可通过优化工具描述、调整提示词、更换模型解决。
6.5 Tools与MCP Server对比
MCP(Model Communication Protocol)Server是独立的工具服务,将通用工具封装为服务,供多个Agent共享调用,与LangChain内置Tools的差异如下:
| 对比维度 | LangChain内置Tools | MCP Server |
|---|---|---|
| 部署位置 | 与Agent同进程,紧耦合 | 独立进程/服务器,松耦合 |
| 复用性 | 仅当前Agent可用 | 多Agent、多应用共享 |
| 更新维护 | 修改需重新编译Agent | 独立更新,不影响Agent |
| 性能 | 本地调用,无网络开销 | 需网络/IPC通信,有延迟 |
| 适用场景 | 简单、专用工具,快速迭代 | 通用、复杂工具,规模化部署 |
7、核心组件实操:Agent(智能体)
7.1 Agent核心定位
Agent是LangChain的“决策核心”,通过协调LLM、Tools、Memory等组件,实现复杂任务的自主拆解与执行。2025年被称为“Agent元年”,标志着AI从“对话式思考”迈向“自主式行动”。

一个成熟的Agent需具备6大能力:LLM推理能力、Memory上下文管理、Tools调用能力、任务规划能力、行动执行能力、多Agent协作能力。
7.2 Agent两大运行模式
- **Function Calling(函数调用模式)**预先定义函数列表及描述,将函数信息与用户问题一同发送给LLM,由LLM决策是否调用函数、调用哪个函数及参数,LLM仅负责规划,不执行函数,实际执行由Agent完成。适用于实时数据查询、计算、API调用等场景。核心类型:
- AgentType.OPENAI_FUNCTIONS:基础函数调用Agent,适配OpenAI系列模型,性能稳定;
- AgentType.OPENAIMULTI_FUNCTIONS:多函数调用Agent,支持复杂依赖关系、并行调用,适用于多步骤任务。
- **ReAct模式(思考-行动-观察循环)**通过“Thought(思考)→Action(行动)→Observation(观察)”的循环流程处理任务,每一步都由LLM推理下一步动作,透明可解释,适用于需要清晰推理过程的场景。
 核心类型:
- AgentType.ZERO_SHOT_REACT_DESCRIPTION:零样本ReAct,依赖工具描述推理,无需示例;
- AgentType.STRUCTURED_CHAT_ZERO_SHOT_REACT_DESCRIPTION:结构化ReAct,支持复杂参数传递;
- AgentType.CONVERSATIONAL_REACT_DESCRIPTION:对话式ReAct,集成Memory,支持多轮对话。
7.3 ReAct Agent实操(结合搜索工具)
from langchain_openai import ChatOpenAI
from langchain.agents import create_react_agent, AgentExecutor
from langchain import hub
from langchain_community.tools.tavily_search import TavilySearchResults

# 1. 初始化搜索工具(需申请Tavily API Key)
search_tool = TavilySearchResults(
    max_results=3,
    description="用于搜索最新网页信息、历史数据、新闻,输入为明确的搜索关键词"
)
tools = [search_tool]

# 2. 加载ReAct提示词模板
prompt = hub.pull("hwchase17/react")

# 3. 初始化Agent
agent = create_react_agent(
    llm=chat_model,
    tools=tools,
    prompt=prompt
)

# 4. 初始化执行器
agent_executor = AgentExecutor(
    agent=agent,
    tools=tools,
    verbose=True,
    handle_parsing_errors=True
)

# 5. 执行任务(需要历史数据,Agent会自动调用搜索工具)
response = agent_executor.invoke({"input": "2021年2月5日腾讯股票收盘价是多少?"})
print(response["output"])
小白/程序员如何系统学习大模型LLM?
作为在一线互联网企业深耕十余年的技术老兵,我经常收到小白和程序员朋友的提问:“零基础怎么入门大模型?”“自学没有方向怎么办?”“实战项目怎么找?”等问题。难以高效入门。
这里为了帮助大家少走弯路,我整理了一套全网最全最细的大模型零基础教程。涵盖入门思维导图、经典书籍手册、实战视频教程、项目源码等核心内容。免费分享给需要的朋友!

👇👇扫码免费领取全部内容👇👇
1、我们为什么要学大模型?
很多开发者会问:大模型值得花时间学吗?答案是肯定的——学大模型不是跟风追热点,而是抓住数字经济时代的核心机遇,其背后是明确的行业需求和实打实的个人优势:
第一,行业刚需驱动,并非突发热潮。大模型是AI规模化落地的核心引擎,互联网产品迭代、传统行业转型、新兴领域创新均离不开它,掌握大模型就是拿到高需求赛道入场券。
第二,人才缺口巨大,职业机会稀缺。2023年我国大模型人才缺口超百万,2025年预计达400万,具备相关能力的开发者岗位多、薪资高,是职场核心竞争力。
第三,技术赋能增效,提升个人价值。大模型可大幅提升开发效率,还能拓展职业边界,让开发者从“写代码”升级为“AI解决方案设计者”,对接更高价值业务。
对于开发者而言,现在入门大模型,不仅能搭上行业发展的快车,还能为自己的职业发展增添核心竞争力——无论是互联网大厂的AI相关岗位,还是传统行业的AI转型需求,都在争抢具备大模型技术能力的人才。


人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
2、大模型入门到实战全套学习大礼包分享
最后再跟大家说几句:只要你是真心想系统学习AI大模型技术,这份我耗时许久精心整理的学习资料,愿意无偿分享给每一位志同道合的朋友。
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
部分资料展示
2.1、 AI大模型学习路线图,厘清要学哪些
对于刚接触AI大模型的小白来说,最头疼的问题莫过于“不知道从哪学起”,没有清晰的方向很容易陷入“东学一点、西补一块”的低效困境,甚至中途放弃。
为了解决这个痛点,我把完整的学习路径拆解成了L1到L4四个循序渐进的阶段,从最基础的入门认知,到核心理论夯实,再到实战项目演练,最后到进阶优化与落地,每一步都明确了学习目标、核心知识点和配套实操任务,带你一步步从“零基础”成长为“能落地”的大模型学习者。后续还会陆续拆解每个阶段的具体学习内容,大家可以先收藏起来,跟着路线逐步推进。

L1级别:大模型核心原理与Prompt
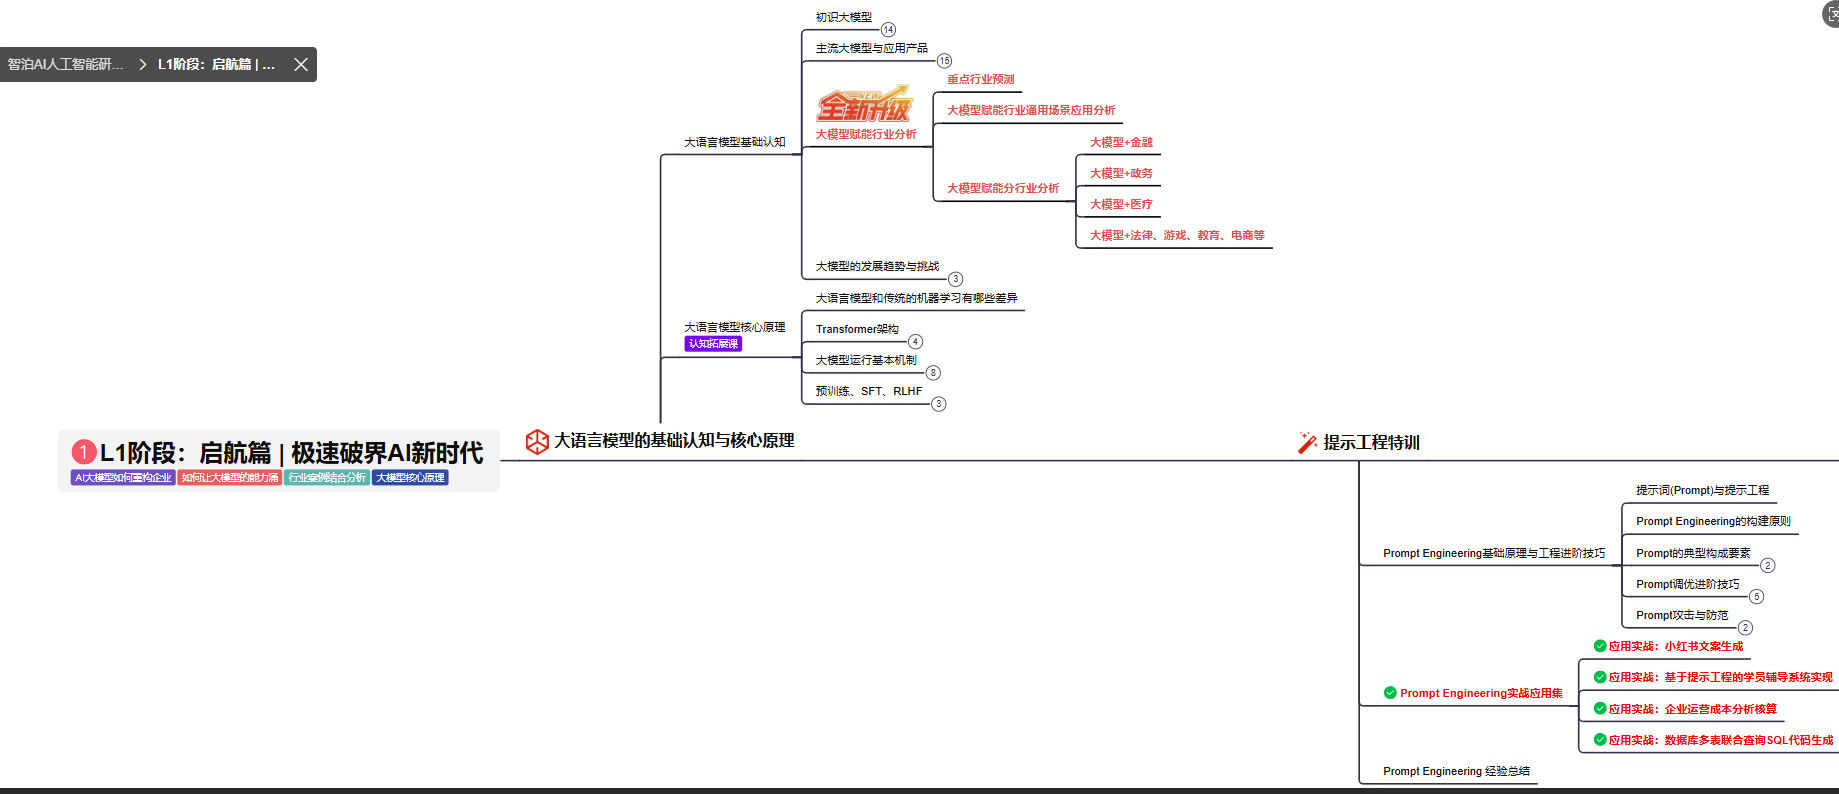
L1阶段: 将全面介绍大语言模型的基本概念、发展历程、核心原理及行业应用。从A11.0到A12.0的变迁,深入解析大模型与通用人工智能的关系。同时,详解OpenAl模型、国产大模型等,并探讨大模型的未来趋势与挑战。此外,还涵盖Pvthon基础、提示工程等内容。
目标与收益:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为AI应用开发打下坚实基础。
L2级别:RAG应用开发工程
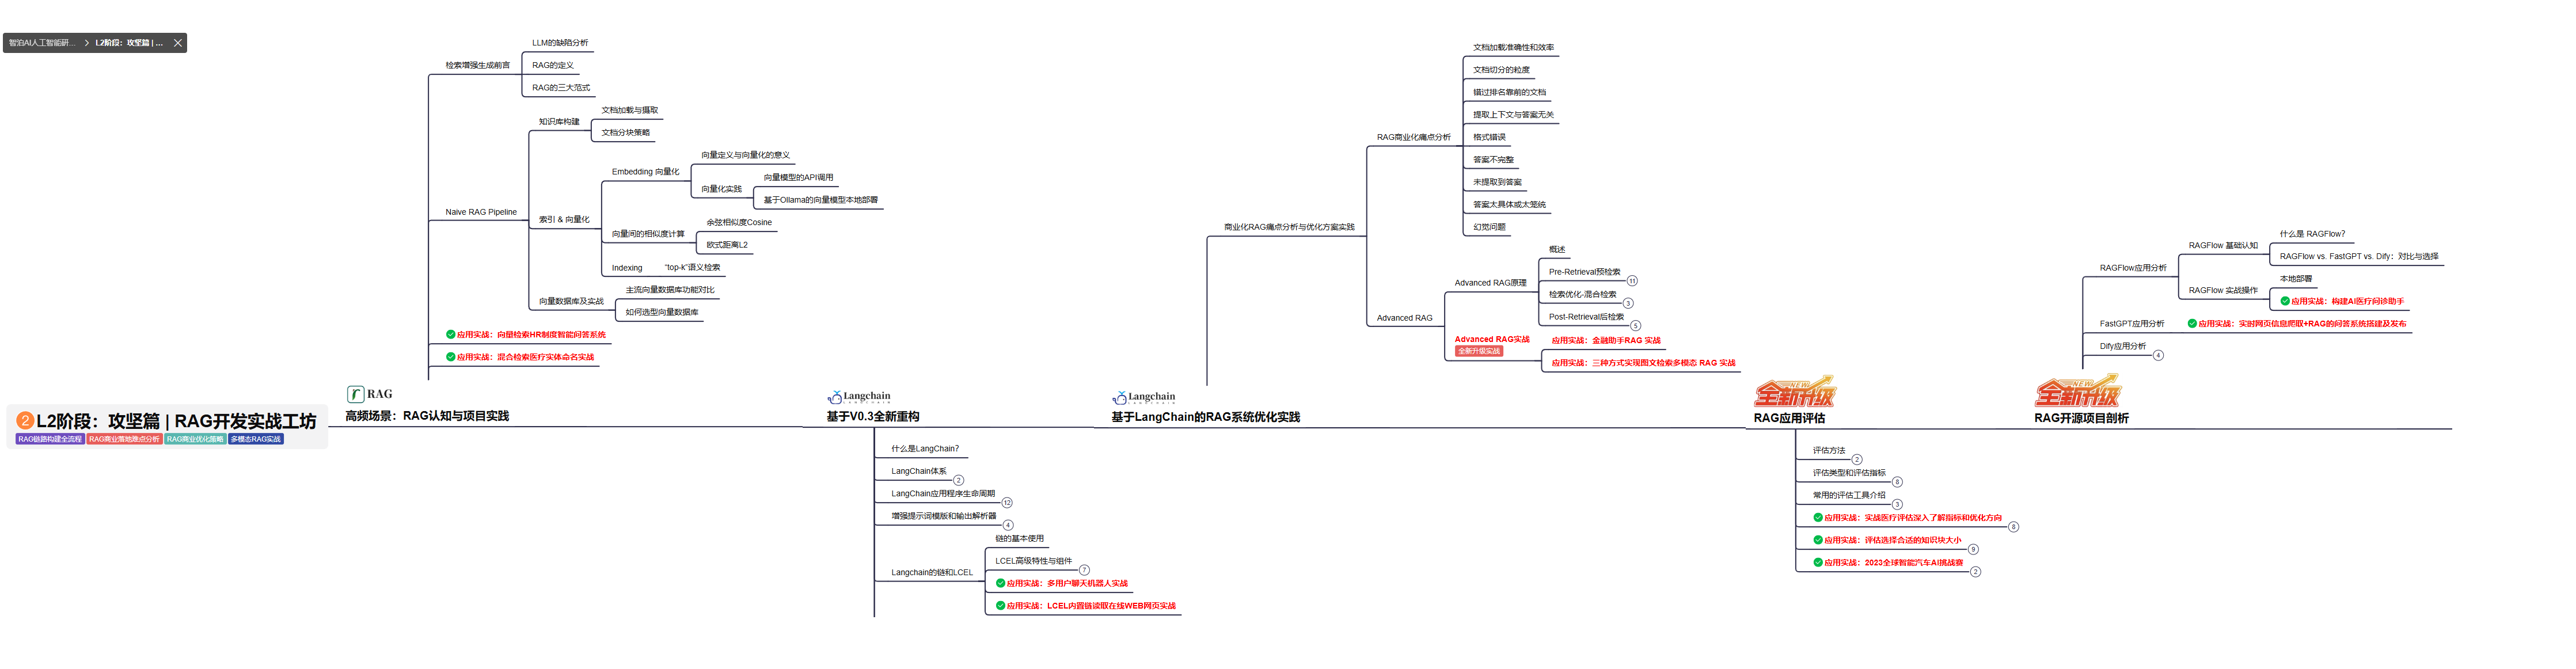
L2阶段: 将深入讲解AI大模型RAG应用开发工程,涵盖Naive RAGPipeline构建、AdvancedRAG前治技术解读、商业化分析与优化方案,以及项目评估与热门项目精讲。通过实战项目,提升RAG应用开发能力。
目标与收益: 掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。
L3级别:Agent应用架构进阶实践
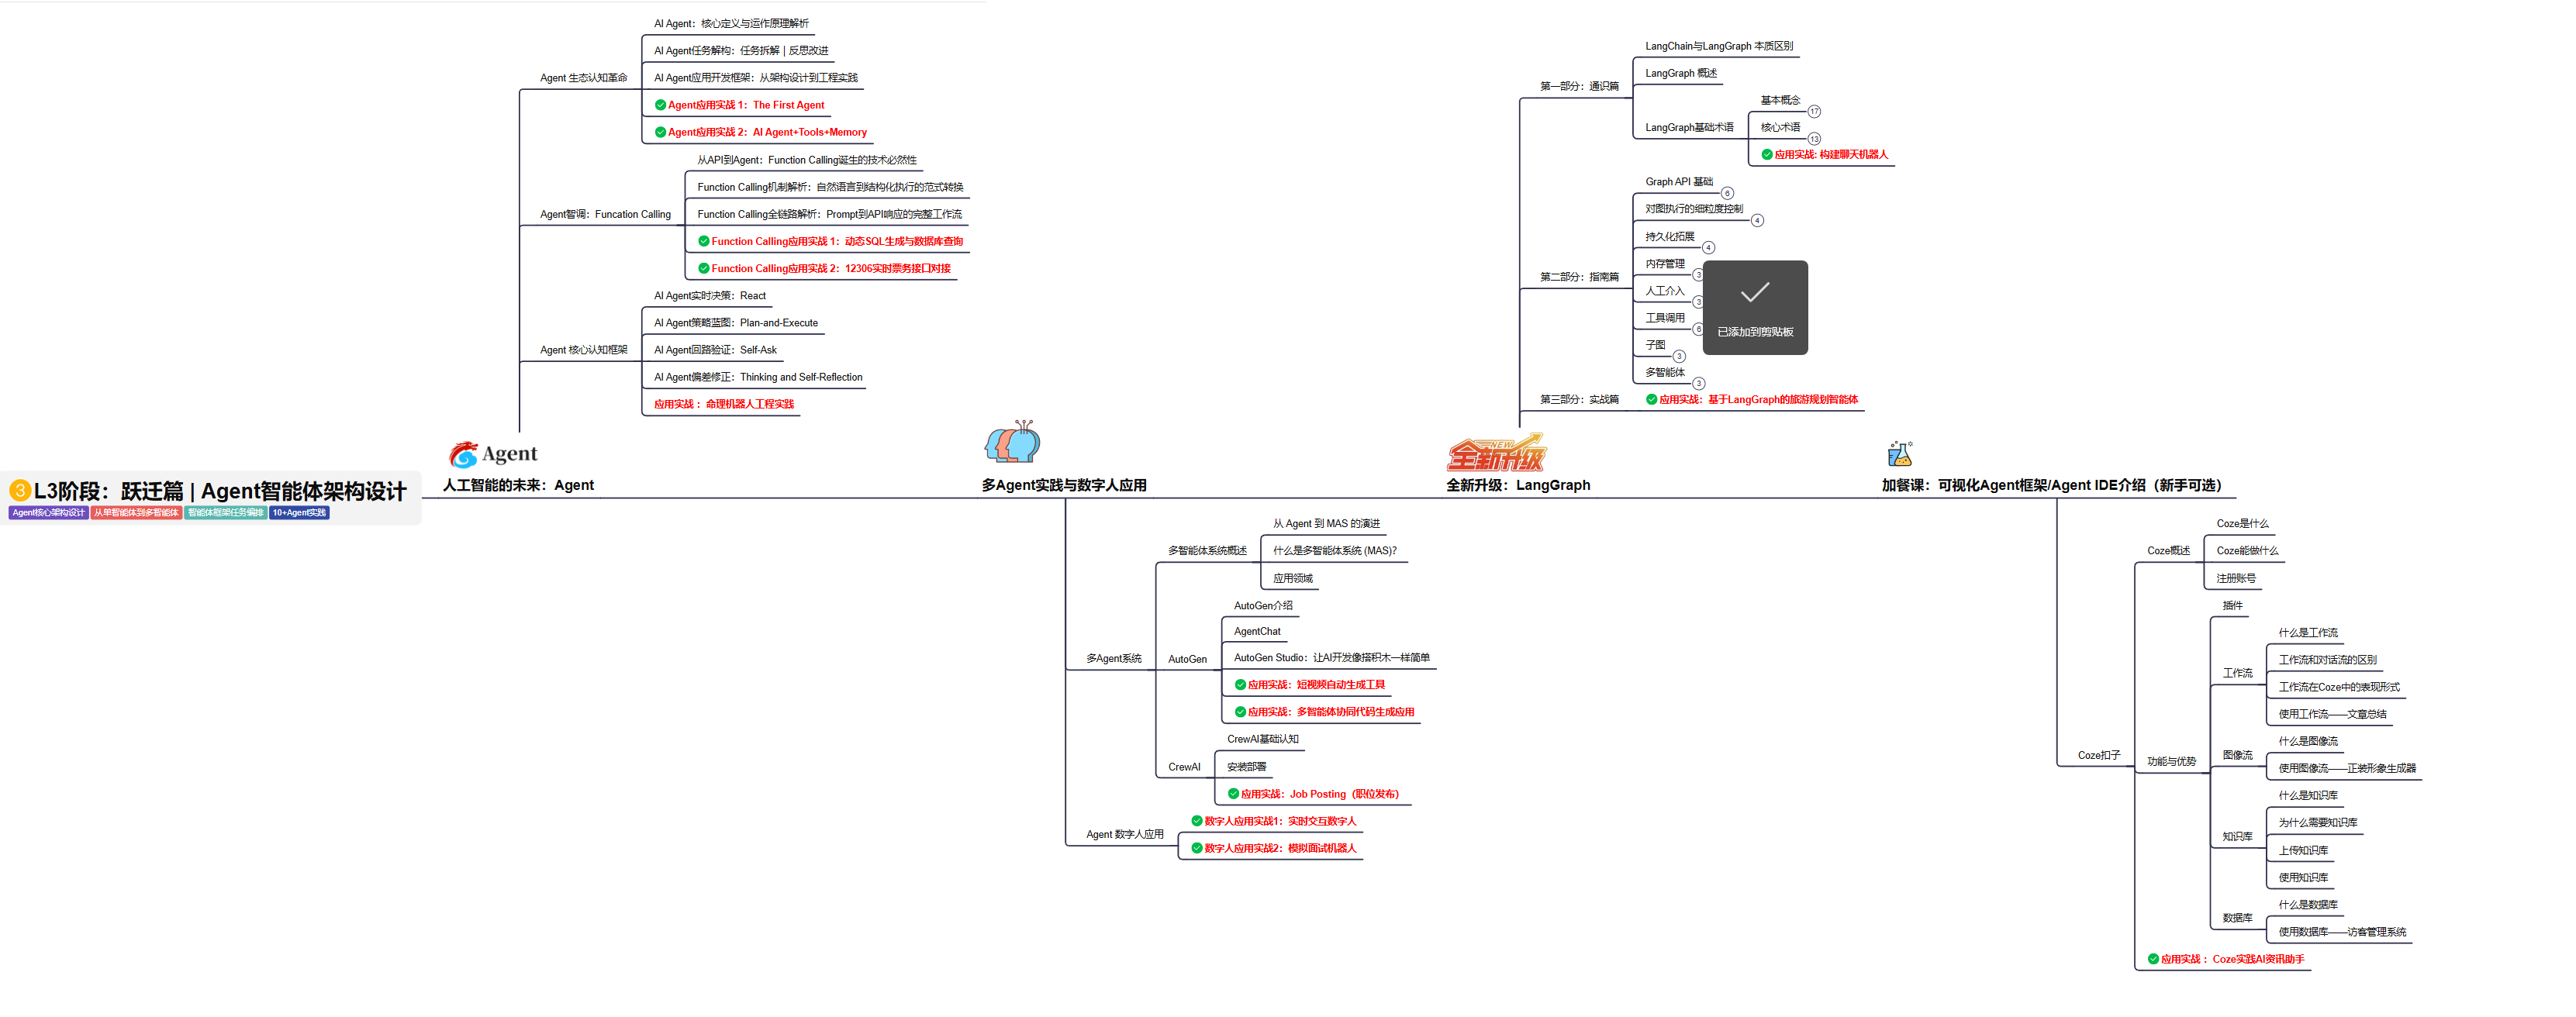
L3阶段: 将 深入探索大模型Agent技术的进阶实践,从Langchain框架的核心组件到Agents的关键技术分析,再到funcation calling与Agent认知框架的深入探讨。同时,通过多个实战项目,如企业知识库、命理Agent机器人、多智能体协同代码生成应用等,以及可视化开发框架与IDE的介绍,全面展示大模型Agent技术的应用与构建。
目标与收益:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
L4级别:模型微调与私有化大模型
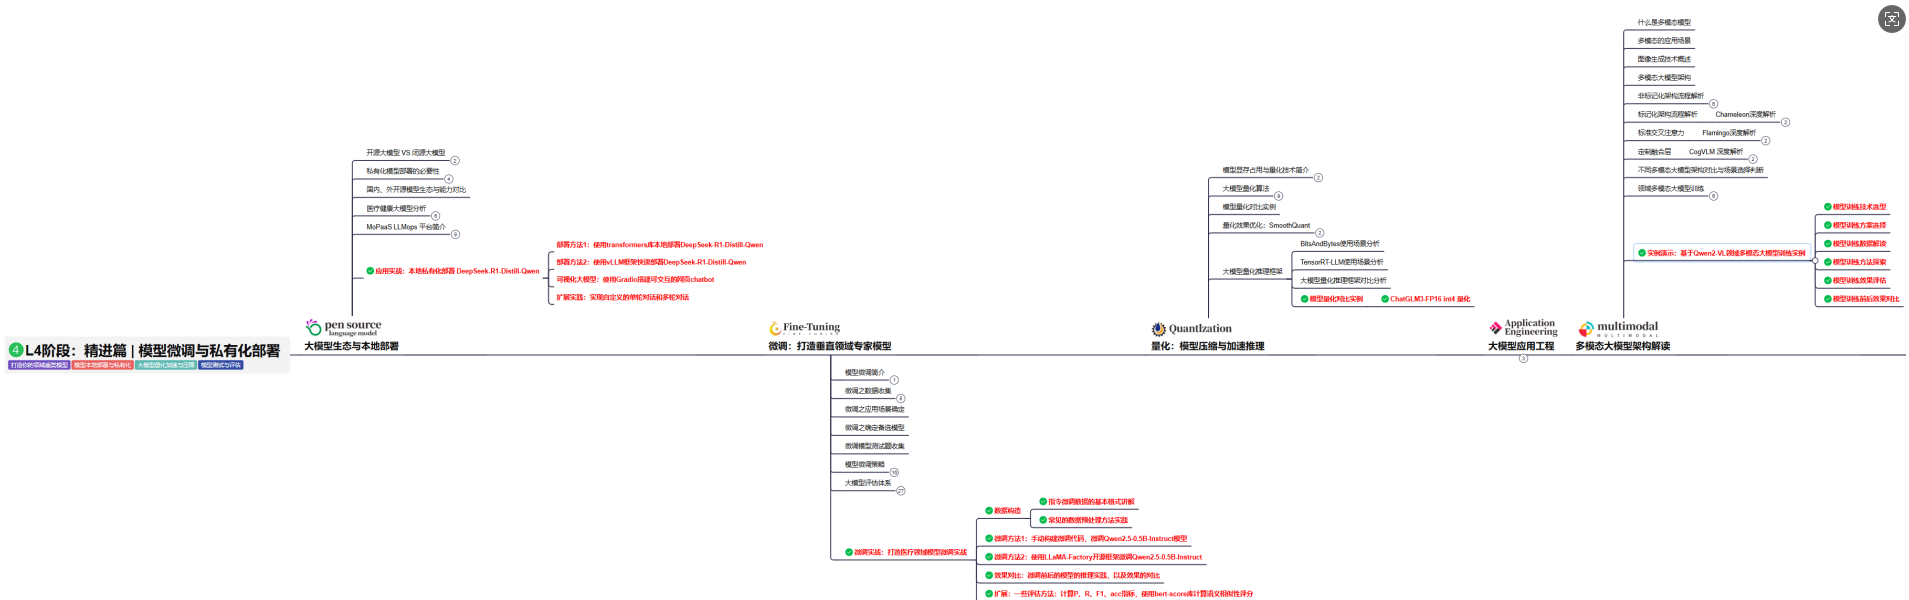
L4级别: 将聚焦大模型微调技术与私有化部署,涵盖开源模型评估、微调方法、PEFT主流技术、LORA及其扩展、模型量化技术、大模型应用引警以及多模态模型。通过chatGlM与Lama3的实战案例,深化理论与实践结合。
目标与收益:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。
2.2、 全套AI大模型应用开发视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。

2.3、 大模型学习书籍&文档
收录《从零做大模型》《动手做AI Agent》等经典著作,搭配阿里云、腾讯云官方技术白皮书,帮你夯实理论基础。

2.4、 AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

2.5、大模型大厂面试真题
整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。

【大厂 AI 岗位面经分享(107 道)】

【AI 大模型面试真题(102 道)】

【LLMs 面试真题(97 道)】

2.6、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

适用人群

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇
3、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


