复旦女硕大模型复试,被LongLoRA微调问懵了…

LoRA、QLoRA、LoRA+、LongRA、DoRA、MaLoRA、GaLore Lora:https://blog.youkuaiyun.com/GarryWang1248/article/details/135036298 阅读详情

近日训练营的一位复旦大学的女硕士告诉我,上周去参加某厂大模型岗复试,面试官问了 LongLoRA 微调。最终咱们这位复旦女硕士还是被这小小的问题给难住痛失 offer。那么这 LongLoRA 微调到底是啥呢?今天就来给大家好好讲讲。

01

面试官心理分析

首先面试官问这个问题呢,其实主要是想考你 3 点内容。

第一, 你知不知道 LongLoRA 微调,有没有看过相关的 paper。如果你听都没有听过,那显然这道题就不用继续了。

第二, LongLoRA 微调主要解决的是什么样的问题,为什么要提出这种微调策略,是基于什么样的背景。

第三, 它是怎么解决的问题,展开详细讲讲。

好,那接下来我们就沿着面试官的心理预期,来回答一下这道题目。

02

面试题解析

首先说下背景,LongLoRA 是港中文和 MIT 在 23 年发表的一篇 paper,主要是为了解决长上下文的注意力机制计算量很大的问题。

我们知道,现在大模型的上下文是越做越长,像 OpenAI GPT4-Turbo 支持到了 128K,Kimi 甚至支持到了 200K 的长度。

长文本影响最大的就是 self-attention ,因为它的显存占用和计算量是随着长度平方变化的。

所以这里我们就答出了第一个得分点,LongLoRA 解决了一个什么样的问题,基于什么样的背景和动机。

其实面试跟大家平时考试答题一样,也有得分点,不是说你答的越多就越好,重要的是答到点子上。

面试时间就那么一两个小时,你长篇大论一堆,面试官是没有那么多耐心听的,反而给面试减分。

好,我们接着来看。

那 LongLoRA 怎么解决的这个问题呢?

在回答这类问题的时候,建议大家先整体概括,再展开表述,同时尽量结合画图,这样思路更加清晰。

比如这里,先整体概括一下,LongLoRA 的原则是,虽然在推理过程中需要密集的全局注意力,但通过稀疏的局部注意力可以有效且高效地微调模型。

具体来说呢,LongLoRA 在微调期间延长了上下文长度,同时使用 Lora 方法保持了高性能和低复杂性,它提出了 shifted sparse attention 的微调方案,我们简称为 S2-Attention。

在训练阶段使用 S2-Attention,推理时用全局注意力。

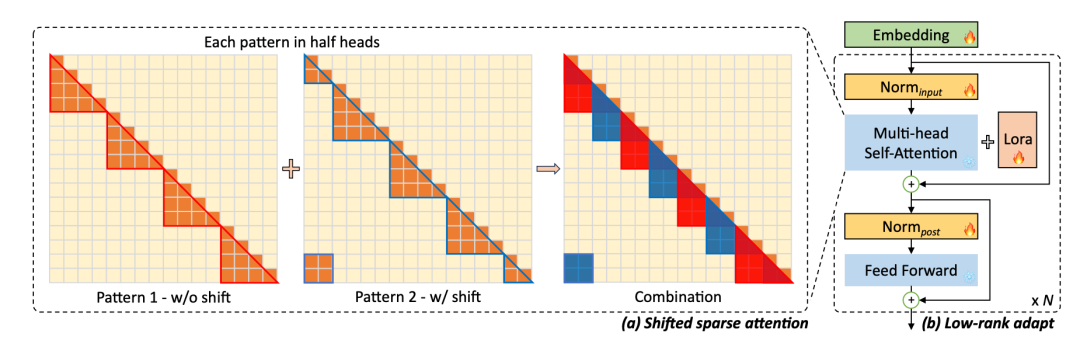
我们看下面这张图,S2-Attention 在微调阶段,使用的是局部注意力,而不是全局注意力。

也就是将输入文档分解为几个不同的组,并在每个组中分别应用注意力机制,大家注意看图中的 Pattern1。
img

那这种方式有什么好处呢?

好处就是它能够在资源占用不多的情况下拓展长度。

那缺点呢?

由于不同组之间缺乏信息交换,随着长度增大,会导致部分信息的丢失。因此 S2-Attention 又引入了组大小一半的移位操作,确保相邻组之间顺利的信息交换。

我们看图中的 Pattern 2,那这个改进有助于模型在文本开头和结尾之间顺利交换信息,提高了模型的稳定性。

img

说的大白话一点,就是对每个 token 而言,真正跟它有一定关联程度的,绝大部分都在相近的区域内,不需要看太远,但为了保持前后注意力的连贯性,所以加上了移位操作。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

LongLoRA:低成本扩展大模型上下文窗口的微调技术详解 在自然语言处理领域,Transformer架构因其强大的序列建模能力成为大语言模型(LLM)的基石,但其自注意力机制的计算复杂度随序列长度呈平方级增长,成为处理长文本的核心瓶颈。为了突破这一限制,参数高效微调(PEFT)技术应运而生,它通过仅更新模型极少量参数来适配新任务,大幅降低了计算和存储成本。基于此,LongLoRA(Long Low-Rank Adaptation)创新性地结合了移位短注意力(Shifted Short Attention)和可学习位置嵌入(Learnable Positional 阅读详情

相关推荐

大语言模型之十六-基于LongLoRA的长文本上下文微调Llama-2

增加LLM上下文长度可以提升大语言模型在一些任务上的表现,这包括多轮长对话、长文本摘要、视觉-语言Transformer模型的高分辨4k模型的理解力以及代码生成、图像以及音频生成等。对长上下文场景,在解码阶段,缓存先前token的Key和Value(KV)需要巨大的内存开销,其次主流的LLM模型在推理的时候上下文长度都小于等于训练时的上下文长度。

shichaog的专栏 3392

从LongLoRA到LongQLoRA(含源码剖析):超长上下文大模型的高效微调方法

本文一开始是《七月论文审稿GPT第2版:从Meta Nougat、GPT4审稿到Mistral、LongLora Llama》中4.3节的内容,但一方面考虑到LongLora的实用性,二方面为了把LongLora和LongQLora更好的写清楚,故把这部分的内容抽取出来独立成本文。

结构之法 算法之道 1万+

LongLoRA 介绍

然而,传统的 LLM 在处理长上下文时会遇到计算量过大的问题。这是因为 LLM 在计算注意力时,需要考虑所有上下文中的 token,这导致计算量随着上下文长度的增加而呈平方级增长。为了解决这个问题,本文提出了 LongLoRA,一种使用局部注意力来微调长上下文 LLM 的方法。LongLoRA 的主要思想是,在计算注意力时,只考虑上下文中的局部区域,而不是整个上下文。具体来说,LongLoRA 在 LongQA 数据集上的准确率为 82.3%,而其他方法的准确率均低于 80%。

步子哥的博客 906

LONGLORA: EFFICIENT FINE-TUNING OF LONGCONTEXT LARGE LANGUAGE MODELS翻译

大型语言模型 (LLM) 通常使用预定义的上下文大小进行训练,例如 LLaMA 为 2048 个token,LLaMA2 为 4096 个token。然而,预定义的大小限制了LLM在许多应用中的应用,例如总结长文档或回答长问题。为了解决这个限制,最近的一些工作对LLM进行了训练或微调以适应更长的上下文。然而,使用长序列从头开始训练 LLM 会带来计算挑战,并且对现有预训练的 LLM 进行微调也相当昂贵。

nopSled 1059

dify工作流的原理

摘要: Dify 工作流是一个基于有向无环图(DAG)的智能任务编排系统,支持多节点(如LLM调用、API工具、条件分支等)的可视化拖拽与流程编排。其核心原理包括执行引擎(解析DAG并管理节点依赖)、上下文变量传递(类Jinja模板的变量引用机制)和状态持久化(存储执行日志与中间结果)。工作流通过事件驱动执行,支持异步任务调度,并与RAG知识库、LLM服务等模块深度集成,最终可发布为API或对话应用。技术栈基于Python(FastAPI+Celery)和PostgreSQL,实现低代码化的AI应用开发。

nbspzs的专栏 2187

(详细教程)opencv+pycharm+笔记本摄像头 做一个人脸识别

文章目录 前言 一、pandas是什么? 二、使用步骤 1.引入库 2.读入数据 总结 一、安装opencv-python 这里推荐使用pycharm直接安装opencv-python 打开文件——设置——python解释器——点击+号 搜索opencv-python,点击安装包,等待片刻即可安装好 检查是否安装好,新建一个项目输入以下代码,若无报错则安装好 import cv2 二、准备分类器 咱们使用opencv官方提供的分类器,包括面部识别,侧...

qq_52852432的博客 1万+

什么是 LongLoRA

LongLoRA 是一种针对 LoRA 的改进方法,旨在通过参数高效微调(PEFT)使大语言模型能够处理长上下文(long-context)任务,同时保持低计算和内存成本。LongLoRA 结合了 LoRA 的低秩更新机制和针对长序列优化的训练策略(如 Shift Short Attention),以适配预训练模型到需要处理长输入(如长文档、长对话)的任务。LongLoRA 由 Chen 等人在 2023 年提出,特别适合需要扩展上下文窗口的场景。

彬彬侠的博客 1052

道路缺陷检测实战指南:基于YOLOv11的深度学习系统从搭建到落地

道路缺陷检测项目的每一步,都是“理论→实践→反思→优化”的成长循环。当你看到自己开发的系统能精准识别出道路上的每一处裂缝、每一个坑洼时,那种“技术解决真实问题”的成就感,会让你明白深度学习不止是论文里的公式,更是改变行业的工具。如果过程中遇到模型不收敛、界面功能异常等问题,不妨把问题拆解成“数据是否标注准确?”“模型参数是否合理?”“界面逻辑是否有漏洞?”等小问题逐一排查。记住,每解决一个问题,你就离“能独立落地AI项目的工程师”更近一步。

LXY_LOVE36的博客 171

【大模型上下文长度扩展】LongLoRA:长序列大模型微调新方式

LoRA通过低秩更新减少了模型微调的计算成本,而S2-Attn通过改进的注意力机制有效处理长序列,这两种技术的结合使得在资源受限的情况下也能实现对长上下文的支持。此外,当前的研究主要集中在模型架构和训练方法的改进上,较少考虑到数据侧的优化,如通过更智能的数据预处理和选择机制来减轻长上下文处理的负担。结合使用LoRA和S2-Attn的优势在于,它们共同提供了一种高效且有效的方式来扩展大型语言模型的上下文处理能力。这种方法不仅提高了模型处理长文本的能力,还保持了计算上的可行性,提供了更多的灵活性和效率。

Debroon 5310

Jetson Nano之CSI摄像头操作方法

jetson端csi摄像头的应用方法

ZONGXP的博客 1万+

如何调用 DBMS_DISKGROUP 对 ASM 文件进行随机读取

该篇博客介绍了如何通过 Java 调用 DBMS_DISKGROUP 读写 Oracle ASM 共享存储文件,并提供了 Java Demo。并测试出 DBMS_DISKGROUP 存在性能瓶颈。

我要出家当道士 1179

探索未来无线通信:LongLoRA —— 长距离、低功耗的新星

探索未来无线通信:LongLoRA —— 长距离、低功耗的新星 是一个创新的开源项目,由DVLab团队研发,旨在实现超长距离、极低功耗的无线通信解决方案。项目的核心目标是增强LoRa(Long Range)技术的性能,以满足物联网(IoT)设备在偏远地区或者需要长时间工作的应用场景的需求。 技术分析 LongLoRA 基于LoRa调制解调技术,但对其进行了深入优化。LoRa本身是一种扩频调制技术,...

gitblog_00084的博客 587

[Unity3D]水族馆游戏教程四

文章目录0.接上篇1.速度控制器2.修改FishAI3.修改后的效果4.总结 0.接上篇 上一篇,实现了鱼AI的随机游动、自动转向,并且学习了如何分析调试过程中遇到的报错。 本篇将继续优化鱼AI。 1.速度控制器 上一篇虽然实现了鱼的随机游动,但是可以看到,鱼在转向的时候,会显得很突然。因此先要解决这个问题。 我们的思路是,让鱼在刚转向的时候,速度由慢到快,等到游动到快要到达目标点的时候,速度减慢...

延澈左的专栏 1039

【全面解析】LoRA、QLoRA、LoRA+、LongRA、DoRA、MaLoRA、GaLore:七大方案深度解读,不容错过!

原始的线性权重矩阵。:下投影矩阵,其中是低秩分解的秩。:上投影矩阵。:权重更新矩阵。:缩放因子。

2401_84204207的博客 2376

【Windows Server 2019】组策略的配置与管理——理论基础

博文介绍了组策略的定义,作用和分类。组策略包括计算机配置和用户配置;组策略又分为为基于本地的组策略和基于AD(活动目录)的域组策略。并说明了不同组策略发生冲突时默认的规则。

VMware, Windows, Linux, Cisco, Container, Kubernetes, Kali 1万+

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

写给大模型新人的经验,刷到少走三年弯路!

有搞大模型训练集群,GPU 集群,CPU/GPU 混部集群,池子里要管理几百上千张卡,还要负责他们的利用率,机器的健康状况,有没有挂的,中小公司这块基本都是开发和运维一体的,一个工作干两个工种的活。集数据 IO,模型训练,预测,上线,监控于一体,这种就是跟着业务团队走,做适配,造很多高效的轮子,方面业务团队使用,减少他们额外重复开发的时间。拿数据来说,先说通用的大模型训练,数据的来源,从哪里采,数据的质量怎么把控,如何过滤有毒信息,语言的筛选与比例,数据的去重,以及数据的规范化处理,评测集的构建。

2401_85328934的博客 1518

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

低成本微调长文本LLM

在有限的设备资源上微调长文本的LLM显得很重要了。中文Llama2-7b支持的最大长度为4k,Qwen1.5-7b支持的最大长度为32k,Qwen1.5-14b支持的最大长度为32k,Qwen-14b支持的最大长度为8k,Baichuan2-13b支持的最大长度为4k。在原有的预训练模型上微调比支持的最大长度的长的文本面临两个问题:如何修改旋转位置编码支持更长的文本,一个是有限的资源上LLM微调长文本。在采用LoRA的方式微调LLM,梯度更新的参数为每一层的线性层相应的lora参数,例如表达式中的。

weixin_42223207的博客 1611

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

LongLoRA 开源项目教程

LongLoRA 开源项目教程 项目介绍 LongLoRA 是一个用于扩展大型语言模型(LLM)上下文长度的开源项目。该项目通过结合改进的 LoRA(Low-Rank Adaptation)技术和 S^2-Attn 方法,能够在保留原始模型架构的同时,有效地将模型的上下文长度从 4k 扩展到 100k 或更高。LongLoRA 兼容大多数现有的技术,如 Flash-Attention2,并且支持在...

gitblog_00652的博客 634

ICLR 2024 | LONGLORA : 长上下文大语言模型的高效微调

通常,使用长上下文大小训练LLMs非常耗时,传统的训练方式需要大量的训练时间和GPU资源。本文介绍了一种名为LongLoRA的有效微调方法,通过两种方式来提高效率:一是采用稀疏局部注意力进行fine-tuning,二是重新审视参数高效的fine-tuning方法。可以扩展预训练大型语言模型(LLMs)的上下文大小,并且计算成本有限。本文从两个方面加快了LLMs的上下文扩展。一方面,虽然推理过程中需要密集全局注意力,但可以通过稀疏局部注意力有效地、高效地微调模型(S2-Attn)。

weixin_59191169的博客 1719

万字长文梳理 LLM 中的长文本问题

深度学习自然语言处理 分享作者:紫气东来(知乎)编辑:马景锐链接:https://zhuanlan.zhihu.com/p/640641794近期,随着大模型技术的发展,长文本问题逐渐成为热门且关键的问题,不妨简单梳理一下近期出现的典型的长文本模型:10 月上旬,Moonshot AI 的 Kimi Chat 问世,这是首个支持 20 万汉字输入的智能助手产品;10 月下旬,百川智能发布 Baic...

zenRRan的博客 3912

大模型微调:3-高效微调原理详解LongLoRA+VeRA+S-LoRA

本文深入解析了三种前沿的大模型高效微调技术:LongLoRA、VeRA和S-LoRA。LongLoRA通过稀疏局部注意力机制和LoRA结合,显著降低了长文本微调的计算成本;VeRA采用基于向量的随机矩阵适应,进一步提升了参数效率;S-LoRA则实现了多LoRA适配器的并发服务架构。文章从技术背景、核心原理、数学建模到实战案例,系统性地介绍了这些方法在解决大模型微调面临的资源消耗、内存限制和计算效率等关键挑战上的创新突破,为AI从业者提供了全面的技术指南。

1412

LongLoRA解决长上下文微调难题:ms-swift最新进展

LongLoRA通过低秩微调和位置编码扩展,显著提升大模型处理长文本的能力。结合ms-swift框架与Ulysses、Ring-Attention等并行技术,单卡即可实现64K以上上下文微调,显存占用低,训练稳定,已在合同问答等场景验证实效,大幅降低长上下文应用门槛。

weixin_35728286的博客 421

LongLoRA:低成本扩展大模型上下文窗口,实现超长文本理解

自注意力机制是Transformer架构的核心,其计算复杂度随序列长度呈平方级增长,这成为大语言模型处理长文本的主要瓶颈。为了突破这一限制,参数高效微调技术应运而生,它允许在仅更新少量参数的情况下使模型适应新任务,极大降低了计算和存储成本。其中,低秩适配(LoRA)通过引入可训练的低秩矩阵来近似权重更新,是一种广泛应用的PEFT方法。结合创新的训练时注意力机制,如移位稀疏注意力,可以高效地模拟长距离依赖学习,从而将模型上下文窗口从几千token扩展至数万甚至十万级别。这种技术组合为代码库分析、长文档摘要、复

weixin_30621959的博客 396

复旦女硕复试,被LongLoRA微调问懵了…

近日训练营的一位复旦大学的女硕士告诉我,上周去参加某厂大模型岗复试,面试官问了 LongLoRA 微调。最终咱们这位复旦女硕士还是被这小小的问题给难住痛失 offer。那么这 LongLoRA 微调到底是啥呢?今天就来给大家好好讲讲。01首先面试官问这个问题呢,其实主要是想考你 3 点内容。第一,你知不知道 LongLoRA 微调,有没有看过相关的 paper。如果你听都没有听过,那显然这道题就不用继续了。

2401_85375186的博客 574

阿里一面:Transformer从头问到脚。。。

阿里一面深度解析:Transformer模型的全面探索

dsxaigc的博客 1069
上一篇: 【论文】FunAudioLLM:一个旨在增强人类与大型语言模型(LLMs)之间自然语音交互的模型家族
下一篇: 大模型速通LLM神书来了《从头开始构建大型语言模型》,尚未发布,GitHub标星22k!!
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值