【论文】FunAudioLLM:一个旨在增强人类与大型语言模型(LLMs)之间自然语音交互的模型家族

FunAudioLLM:阿里通义实验室的开源语音大模型项目 - SenseVoice与CosyVoice模型介绍 深入了解FunAudioLLM,阿里巴巴通义实验室开源的先进语音技术项目。SenseVoice和CosyVoice两大模型,以其高精度多语言语音识别、情感辨识和自然语音生成能力,引领语音交互的新时代。本文详细解析了技术原理、社区开发资源,为语音技术爱好者和专业人士提供了指南 阅读详情

研究背景

1.研究问题:这篇文章要解决的问题是如何增强人类与大型语言模型(LLMs)之间的自然语音交互。具体来说,研究集中在语音识别、情感识别和音频事件检测(多语言)以及语音生成(多语言、零样本学习、跨语言语音克隆和指令跟随能力)两个方面。

2.研究难点:该问题的研究难点包括:实现低延迟的多语言语音识别;在多语言环境中进行高精度的语音识别;生成自然且具有情感表达的多语言语音;以及在零样本情况下进行语音克隆和指令跟随。

3.相关工作:该问题的研究相关工作包括GPT-4o、Gemini-1.5等高性能语言模型的发展,以及高精度语音识别、情感识别和语音生成技术的进步。

研究方法

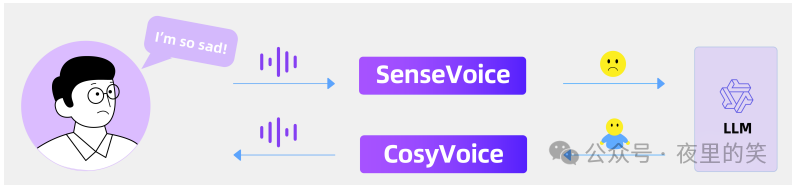
这篇论文提出了FunAudioLLM框架,用于解决人类与LLMs之间的自然语音交互问题。具体来说,

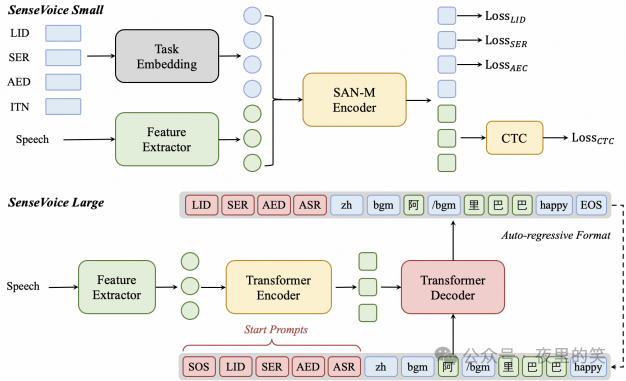
1.SenseVoice模型:SenseVoice模型用于语音理解,支持多语言语音识别、情感识别和音频事件检测。SenseVoice-Small是一个非自回归的编码器模型,适用于快速语音理解,支持五种语言(中文、英语、粤语、日语和韩语),推理延迟小于80ms,速度比Whisper-small快5倍以上,比Whisper-large快15倍以上。SenseVoice-Large是一个自回归的编码器-解码器模型,支持超过50种语言的语音识别,特别在中文和粤语上表现优异。
img

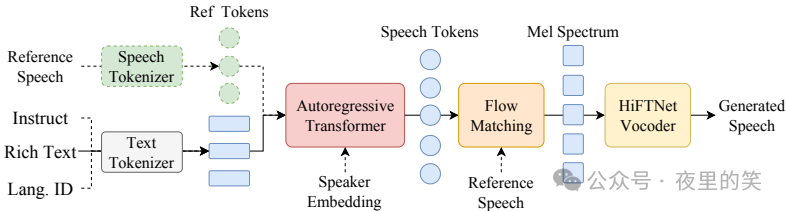
2.CosyVoice模型:CosyVoice模型用于语音生成,支持多语言语音生成,具有零样本学习、跨语言语音克隆、情感共振语音生成和指令微调等功能。CosyVoice-base-300M模型专注于准确表示说话人身份、零样本学习和跨语言语音克隆。CosyVoice-instruct-300M模型通过指令文本生成情感丰富的语音,并允许对说话人身份、说话风格等进行细致调整。CosyVoice-sft-300M模型在七个多语言说话人上进行微调,准备立即部署。
img

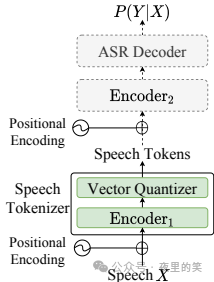
3.语义语音分词器:为了提高系统性能和减少对高质量数据的需求,论文提出了一种监督语义语音分词器S3S3。该分词器基于预训练的SenseVoice-Large模型,在编码器的初始六层之后引入一个向量量化器,增强了时间信息。
img

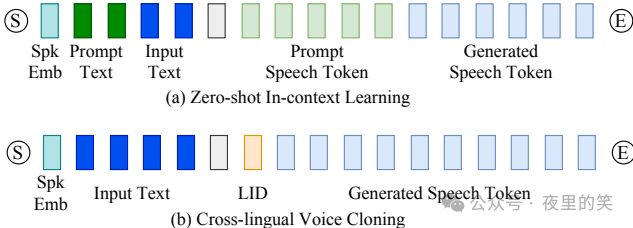
4.零样本上下文学习和指令微调:CosyVoice模型展示了零样本上下文学习能力,允许通过简短的参考语音样本复制任意声音。此外,CosyVoice-instruct模型通过指令文本进一步增强了可控性,支持说话人身份、说话风格和细粒度副语言特征的控制。
img

实验设计

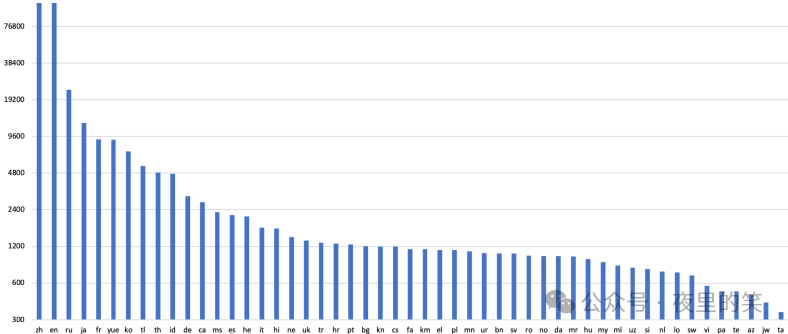
1.数据集:SenseVoice模型的训练数据集包括约300,000小时的音频数据,覆盖五种语言(中文、粤语、英语、日语和韩语)。为了进一步提升SenseVoice-Large的多语言能力,额外整合了100,000小时的多语言数据。CosyVoice模型的训练数据集包括多种语言,使用内部工具进行语音检测、信噪比估计、说话人分离和分离。
img

2.评估指标:多语言语音识别使用字符错误率(CER)和词错误率(WER)进行评估。情感识别使用未加权平均准确率(UA)、加权平均准确率(WA)、宏平均F1分数(F1)和加权平均F1(WF1)进行评估。音频事件检测使用F1分数进行评估。

3.实验设置:在A800机器上进行推理效率评估,解码批处理大小为1。对于编码器-解码器模型,使用束搜索解码,束大小为5。

结果与分析

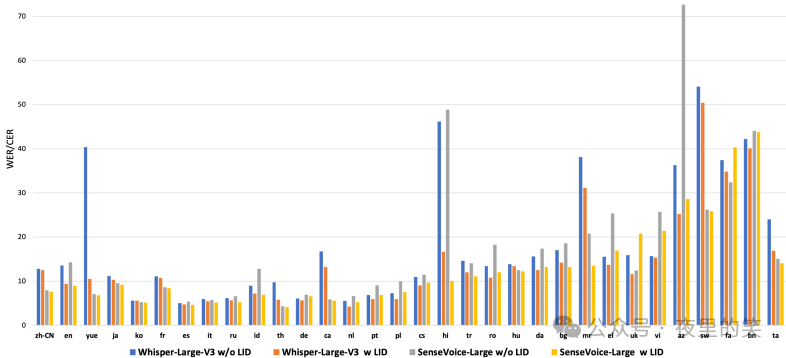
1.多语言语音识别:SenseVoice-S和SenseVoice-L在大多数测试集上显著优于Whisper模型,特别是在粤语、加泰罗尼亚语和马哈拉施特拉语上表现优异。SenseVoice-S的推理延迟比Whisper-small快5倍以上,比Whisper-large快15倍以上。
img

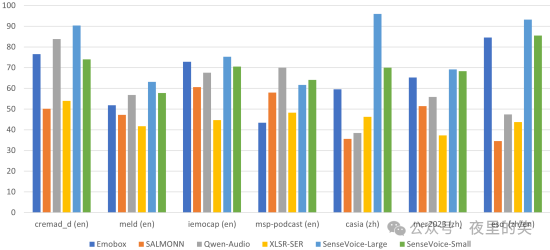
2.情感识别:SenseVoice-Large在所有测试集和所有指标上表现最佳,SenseVoice-Small在大多数数据集上也优于其他基线模型。
img

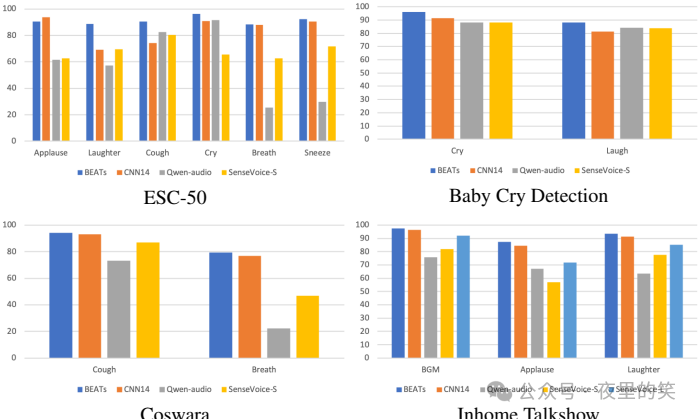
3.音频事件检测:SenseVoice模型在音频事件分类或检测方面表现良好,尽管BEATS和PANNs可能在某些任务上具有更高的F1分数。
img

4.语义信息保留:S3分词器在中文和英语测试集上展示了强大的识别性能,在Common Voice zh-CN集上,S3分词器比Whisper-Large V3模型的错误率降低了4.14%。

5.生成质量:CosyVoice在英语和中文生成质量评估中表现出色,内容一致性和说话人相似性均达到人类水平。通过ASR重排序,CosyVoice的WER显著降低。
img

6.情感控制:CosyVoice-instruct在情感控制方面表现优异,情感指令输入下的情感识别准确率显著提高。

总体结论

这篇论文提出的FunAudioLLM框架通过SenseVoice和CosyVoice两个创新模型,显著提升了人类与LLMs之间的自然语音交互能力。SenseVoice模型在多语言语音识别和情感识别方面表现优异,而CosyVoice模型在多语言语音生成和控制方面具有显著优势。FunAudioLLM框架的应用包括语音翻译、情感语音聊天、互动播客和富有表现力的有声书叙述,推动了语音交互技术的前沿。

论文评价

优点与创新

1.SenseVoice模型:

a.多语言语音识别:SenseVoice-Small支持五种语言的低延迟自动语音识别(ASR),而SenseVoice-Large支持超过50种语言的高精度ASR。

b.情感识别和音频事件检测:SenseVoice不仅支持语音识别,还提供先进的情感识别和音频事件检测功能。

c.非自回归架构:SenseVoice-Small采用非自回归端到端架构,推理延迟极低,比Whisper-small快5倍以上,比Whisper-large快15倍以上。

2.CosyVoice模型:

a.多语言语音生成:CosyVoice支持五种语言的语音生成,能够生成自然听起来的语音。

b.零样本上下文学习:CosyVoice能够在没有训练的情况下进行语音克隆,仅需3秒的提示语音。

c.跨语言语音克隆:CosyVoice可以跨语言复制语音,生成具有不同音色、情感和风格的语音。

d.指令微调:通过指令文本控制说话人身份、说话风格和其他细粒度的副语言特征。

3.开源模型:

a.SenseVoice和CosyVoice的相关模型已在Modelscope和Huggingface上开源,并发布了相应的训练、推理和微调代码。

4.丰富的应用场景:

a.FunAudioLLM通过与LLMs的集成,提供了语音翻译、情感语音聊天、互动播客和富有表现力的有声书叙述等多种应用演示。

不足与反思

1.SenseVoice的局限性:

a.对于资源较少的语言,ASR性能通常较低。

b.SenseVoice不是为流式转录设计的,未来工作可能会专注于开发基于SenseVoice的可流式语音理解模型。

2.CosyVoice的局限性:

a.支持的语言数量有限,虽然可以根据显式指令表达情感和说话风格,但不能根据文本的语义内容推断适当的情感或风格。

b.在唱歌方面表现不佳,需要在保持原始音色的同时实现富有表现力的情感变化。

c.两个创新模型与LLMs的训练不是端到端的,这种管道方法可能会引入错误传播,影响整体性能。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

阿里通义音频生成大模型 FunAudioLLM 开源 近年来,人工智能(AI)技术的进步极大地改变了人类与机器的互动方式,特别是在语音处理领域。阿里巴巴通义实验室最近开源了一个名为FunAudioLLM的语音大模型项目,旨在促进人类与大型语言模型(LLMs)之间的自然语音交互。FunAudioLLM包含两个核心模型:SenseVoice和CosyVoice,分别负责语音理解和语音生成。 阅读详情

相关推荐

人工智能的语音革命:SenseVoice模型的突破与应用

SenseVoice是一个专注于高精度多语言语音识别、情感辨识和音频事件检测的开源模型。它不仅支持超过50种语言的语音识别,而且在情感识别和音频事件检测方面也展现出卓越的性能。多语言识别能力:通过超过40万小时的数据训练,SenseVoice在多语言识别上超越了现有的Whisper模型。情感识别:在测试数据上,SenseVoice的情感识别效果达到了业界领先水平。音频事件检测:能够检测音乐、掌声、笑声、哭声等多种人机交互事件。高效推理。

步子哥的博客 2784

声临其境!体验阿里云开源音频基座大模型——FunAudioLLM

阿里通义实验室开源了全新的音频基座大模型FunAudioLLM,包含SenseVoice与CosyVoice两大核心模型。SenseVoice专精于多语言语音识别、情感辨识与声音事件检测,支持50余种语言,中文及粤语识别准确率提升50%以上。CosyVoice则擅长语音合成,只需3-10秒原始音频即可克隆音色,并支持跨语言合成。FunAudioLLM的应用场景广泛,包括语音到语音翻译、情感语音对话、互动播客及有声读物等。CosyVoice的在线体验显示,其生成的语音自然流畅,支持定制化及高级情绪控制,超越竞

qq_44373268的博客 5400

ATM火控电容改造实战:提升速凌无刷电机动力与系统稳定性

在嵌入式系统与电机驱动领域,电源完整性是保障电路稳定运行的核心基础。其核心原理在于通过合理的电容网络设计,为负载提供瞬时大电流并滤除高频噪声,从而维持电压稳定。这项技术的核心价值在于能显著提升系统的动态响应能力与可靠性,避免因电压跌落导致微控制器复位或功率器件过应力。典型的应用场景包括无人机电调、机器人关节驱动以及各类需要快速响应的伺服系统。本文聚焦于水弹发射器ATM火控系统的硬件迭代,通过详解电容的选型、布局与焊接流程,特别是针对速凌五代无刷电机的高启动电流特性,系统性地阐述了如何通过强化电源储能与芯片去

weixin_33868027的博客 556

阿里开源语音理解和语音生成大模型FunAudioLLM

阿里开源大模型FunAudioLLM,一个创新的框架,旨在促进人类与大型语言模型(LLMs)之间的自然语音交互。FunAudioLLM的核心是两个开创性的模型:用于语音理解的SenseVoice和用于语音生成的CosyVoice。

声纹感知 洞察芯声 7229

PT静态时序分析实战:从基础命令到高级报告解析

本文详细介绍了PT(PrimeTime)静态时序分析(STA)的实战技巧,从基础命令如pt_shell和report_timing的使用,到高级报告解析与问题排查。通过丰富的实例和脚本示例,帮助工程师快速掌握时序分析的核心技能,提升芯片设计验证效率。

weixin_29289821的博客 954

双轴按键摇杆模块原理与嵌入式驱动实战

双轴按键摇杆是一种融合模拟量(X/Y轴)与数字量(Z轴按键)的复合型人机交互传感器,其本质基于电位器分压原理与机械开关通断特性。通过ADC采集连续电压信号并结合数字IO检测按键状态,可实现高鲁棒性的二维运动感知与触发控制。该方案技术门槛低、成本可控、兼容性强,广泛应用于智能小车、DIY游戏手柄、工业HMI及教育开发板等嵌入式场景。文中深入解析电位器线性度、KEY引脚开漏特性、ADC参考电压稳定性及软件消抖状态机等关键工程要素,为基于Arduino、STM32或ESP32平台的快速集成提供可复用的技术路径。

weixin_30995917的博客 82

阿里开源的音频模型_原理与实操

方法:引入两个创新模型:SenseVoice 处理多语言语音识别、情感识别和音频事件检测;CosyVoice 促进多语言语音生成,具有对多种语言、音色、说话风格和说话人身份的控制。结论:SenseVoice-Small 为 中文、英文、粤语、日文、韩文 5 种语言提供极低延迟的 ASR,性能比 Whisper-small 快 5 倍以上;

谢彦的技术博客 4531

Win11下DCMTK的Visual Studio 2022配置教程

最近有个新需求,需要完成读取和解析DICOM数据相关的SDK

qq_45797625的博客 3261

FunAudioLLM:人与法学硕士自然交互的语音理解与生成基础模型

FunAudioLLM:人与LLM自然交互的语音理解与生成基础模型 [论文] [代码] [Modelscope:SenseVoiceCosyVoice] [HuggingFace:SenseVoiceCosyVoice] 统一演讲团队 阿里巴巴集团 摘要:本报告介绍了FunAudioLLM,这是一个旨在增强人与大型语言模型(LLM)之间自然语音交互的框架。其核心是两个创新模型:用于高精度多语言语音识别、情感识别和音频事件检测的SenseVoice ;以及用于多语言、音色和情感

具身机器人和通用AI 1446

从零开始搭建企业级安全扫描平台:基于Docker的Greenbone和ClamAV部署指南

本文提供了一份基于Docker容器技术,从零开始搭建企业级安全扫描平台的实战指南。详细介绍了如何部署和集成漏洞扫描工具Greenbone与病毒扫描工具ClamAV,涵盖架构设计、Docker环境优化、容器化部署步骤以及平台集成与监控方案,帮助企业构建自动化、可扩展的安全防御核心组件。

delta的博客 756

世界职业院校技能大赛—人工智能赛道项目逐字稿参考十二

世界职业院校技能大赛—人工智能赛道项目逐字稿参考十二

我是网络安全兼技能大赛工程师,专注网络安全技术学习与技能大赛实战!持续分享最新的技术文章,帮你少走弯路,一起在技术赛道上进步~ 144

FunAudioLLM:用于人机自然交互的语音理解和生成基础模型

FunAudioLLM: Voice Understanding and Generation Foundation Models for Natural Interaction Between Humans and LLMs FunAudioLLM:用于人机自然交互的语音理解和生成基础模型

Together_CZ的博客 2385

【连接器专题】 EIA-364 系列标准的完整列表

EIA-364 系列标准在电子工业中具有重要的地位,为电子连接器和互连系统的测试和验证提供了统一的、可操作的流程和方法,有助于提高电子产品的质量和可靠性,促进了电子工业的发展

一点硬件 2660

基于规范编解码器将LLM用作图像生成器

大模型(LLM)是一种人工智能模型,旨在理解和生成人类语言。它们在大量的文本数据上进行训练,可以执行广泛的任务,包括文本总结、翻译、情感分析等等。LLM的特点是规模庞大,包含数十亿的参数,帮助它们学习语言数据中的复杂模式。这些模型通常基于深度学习架构,如转化器,这有助于它们在各种NLP任务上取得令人印象深刻的表现。

AI_Conf的博客 2098

手把手教您 Claude 桌面端无需账号订阅,免费接入国产自定义大模型(Claude Desktop 绕过订阅限制,接入任意自定义 AI 模型)

无需官方账号,也能畅玩Claude桌面端!本文详解Claude Desktop如何跳过登入接入自定义大模型,轻松解锁Cowork、Code等强大功能🚀

XiaoqiangClub的博客 5412

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

阿里SenseVoice -语音识别模型本地部署

SenseVoice是一款多功能语音基础模型,支持语音识别(ASR)、语言识别(LID)、情感识别(SER)和事件检测(AED)。提供大小两个版本:Small版轻量高效,推理速度比Whisper快7-17倍;Large版支持更多语言且识别更精准。推荐使用RTX2080Ti及以上显卡部署,实测RTX4060Ti16G运行良好。该模型在智能客服、医疗转录、教育司法等领域有广泛应用,支持中英日韩及粤语识别,具有识别速度快、多语言支持等优势。安装部署简单,通过Python虚拟环境即可完成。

Mercurian_T的博客 3957

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

SenseVoice模型可视化论文:网络结构与特征流向研究

SenseVoice作为一款多语言语音理解模型(Multilingual Voice Understanding Model),在语音识别领域展现出卓越性能。本文通过可视化技术深入剖析其网络架构与特征流向,揭示模型从音频输入到文本输出的完整处理流程。我们将重点解析Sinusoidal Position Encoder(正弦位置编码器)、MultiHeadedAttentionSANM(基于SANM...

gitblog_01095的博客 832

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

云平台部署 FunAudioLLM 语音天花板

项目入口:https://open.virtaicloud.com/web/project/detail/470526582805655552。CosyVoice在线体验:https://www.modelscope.cn/studios/iic/CosyVoice-300M。SenseVoice在线体验:https://www.modelscope.cn/studios/iic/SenseVoice。,即刻将项目一键克隆到工作空间,不需要自己动手收集下载数据集、模型等。,根据项目主页介绍进行部署。

m0_49711991的博客 1587

IntelliJ IDEA 集成 Google Java Format 插件完整指南:终极代码格式化解决方案 [特殊字符]

Google Java Format 是一款由 Google 开发的 Java 代码格式化工具,能够自动将 Java 源代码格式化为符合 Google Java 代码风格规范的统一格式。本文将为您提供在 IntelliJ IDEA 中安装和配置 Google Java Format 插件的完整教程,让您的代码始终保持专业和一致。 ## 🔧 插件安装步骤详解 ### 从插件市场安装 首先打开

gitblog_00764的博客 879

[1302]FunAudioLLM – 阿里通义团队推出的开源语音大模型

模型结构如下图所示:经过超过40万小时的数据训练,支持50多种语言,其识别性能超越了Whisper模型。具备出色的情感识别能力,在测试数据上超越了当前最佳模型。提供声音事件检测能力,支持检测各种常见的人机交互事件,如背景音乐、掌声、笑声、哭泣、咳嗽和打喷嚏。SenseVoice-Small模型采用非自回归的端到端框架,具有极低的推理延迟。处理10秒音频仅需70毫秒,比Whisper-Large快15倍。提供便捷的微调脚本和策略,使用户能够根据业务场景轻松解决长尾样本问题。

周小董 3777

阿里云开源音频基座大模型 FunAudioLLM=SenseVoice+CosyVoice

阿里通义实验室开源音频基座大模型FunAudioLLM,包含SenseVoice和CosyVoice两大模型。SenseVoice支持50+种语言识别,中文准确率提升50%,兼具情感辨识和环境音检测;CosyVoice可实现3-10秒音色克隆,支持中英日粤韩五语种合成和情感语音控制。该模型在语音翻译、情感对话、互动播客和有声读物等场景表现优异,其在线体验显示生成语音自然流畅,超越ChatTTS等竞品。目前用户可通过魔搭社区体验多语言音频生成功能。

何哥的博客 2065

SenseVoice模型蒸馏实践:从Large到Small的知识迁移策略

在语音识别(Automatic Speech Recognition, ASR)领域,模型性能与部署效率的矛盾日益突出。工业级语音模型如SenseVoice Large虽能实现98.5%的语音识别准确率,但参数量常突破10亿,在边缘设备(如嵌入式系统、移动端)上面临三大痛点:推理延迟超过500ms、内存占用超过2GB、功耗成本增加300%。为解决这一矛盾,模型蒸馏(Model Distillati...

gitblog_00027的博客 963

SenseVoice模型蒸馏论文:知识迁移方法与实验结果分析

针对SenseVoice模型在边缘设备部署中的效率瓶颈,本文提出一种基于多任务知识蒸馏(Knowledge Distillation, KD)的模型压缩方案。通过解析SenseVoice-Small的轻量级架构设计,构建了融合CTC损失(Connectionist Temporal Classification Loss)与情感识别损失的蒸馏框架,实现了教师模型92%的语音识别性能,同时将参数量压...

gitblog_00763的博客 1047

FunAudioLLM:探索音频基座大模型在AI应用中的新境界

最近我看了一下通义语音团队最新开源的音频基座大模型FunAudioLLM。这个大模型可不得了,它包含了SenseVoice和CosyVoice两大模型,一个负责多语言音频理解,另一个则专注于多语言音频生成。今天,我就来给大家详细说说这两个模型究竟怎么样,以及我在评测活动中的一些体验。

Y525698136的博客 1925

如何利用FunAudioLLM搭建语音对话系统

如果子模块克隆失败可以进入FunAudioLLM-APP目录运行以下命令。创建download,py文件,用于下载模型。运行download,py,下载文件。

Hui01080的博客 1544

阿里通义音频生成大模型 FunAudioLLM 开源!

人类对自身的研究和模仿由来已久,在我国2000多年前的《列子·汤问》里就描述了有能工巧匠制作出会说话会舞动的类人机器人的故事。声音包含丰富的个体特征及情感情绪信息,对话作为人类最常使用亲切自然的交互模式,是连接人与智能世界至关重要的环节。近日,阿里通义实验室发布并开源了语音大模型项目,旨在深化人类与大型语言模型(LLMs)之间的自然语音交互体验。这一框架的核心是两个创新模型:SenseVoice和CosyVoice。

stephen147的博客 4409
上一篇: 大模型算法岗和大模型开发岗有什么区别?
下一篇: 复旦女硕大模型复试,被LongLoRA微调问懵了…
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值