这篇文章提供了大语言模型(LLM)的全面学习指南,涵盖从数学基础、神经网络到LLM架构、微调技术、评估方法等核心内容,以及向量存储、RAG、推理优化等工程实践。文章整理了大量学习资源和系统性学习路线,适合初学者到进阶者全面掌握大模型技术,实现职业发展和项目应用。
LLM Fundamentals 基础
1. 机器学习的数学基础
在掌握机器学习之前,理解支撑这些算法的基本数学概念非常重要。

- 线性代数:这是理解许多算法(特别是深度学习算法)的关键。主要概念包括向量、矩阵、行列式、特征值和特征向量、向量空间以及线性变换。
- 微积分:许多机器学习算法涉及到连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分以及梯度的概念也很重要。
- 概率论与统计学:这些知识对于理解模型如何从数据中学习并进行预测至关重要。主要概念包括概率理论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。
有的时候临时抱佛脚也是可以的
📚 其他资源:
- 3Blue1Brown - 线性代数的本质:一系列视频,提供了这些概念的几何直观解释。
- StatQuest with Josh Starmer - 统计学基础:为许多统计概念提供简单明了的解释。
- Ms Aerin 的 AP 统计学直观理解:一系列 Medium 文章,提供每种概率分布的直观理解。
- Immersive Linear Algebra:线性代数的另一种视觉解释。
- 可汗学院 - 线性代数:适合初学者,以非常直观的方式解释概念。
- 可汗学院 - 微积分:一个互动课程,涵盖了微积分的所有基础知识。
- 可汗学院 - 概率与统计:以易于理解的格式提供材料。
2. 机器学习的 Python
Python 是一种强大且灵活的编程语言,因其可读性、一致性和强大的数据科学库生态系统而特别适合机器学习。

- Python 基础:掌握 Python 编程需要理解基本语法、数据类型、错误处理和面向对象编程。
- 数据科学库:包括熟悉 NumPy 用于数值计算,Pandas 用于数据操作和分析,以及 Matplotlib 和 Seaborn 用于数据可视化。
- 数据预处理:这包括特征缩放和标准化、处理缺失数据、异常值检测、分类数据编码,以及将数据划分为训练集、验证集和测试集。
- 机器学习库:熟练使用 Scikit-learn 是至关重要的,这个库提供了广泛的有监督和无监督学习算法。理解如何实现线性回归、逻辑回归、决策树、随机森林、K 最近邻(K-NN)和 K-means 聚类等算法也很重要。主成分分析(PCA)和 t-SNE 等降维技术对可视化高维数据也非常有帮助。
📚 其他资源:
- Real Python: 提供全面的资源,包括适合初学者和高级用户的 Python 文章和教程。
- freeCodeCamp - 学习 Python: 长视频,全面介绍 Python 的所有核心概念。
- Python 数据科学手册: 免费数字书籍,非常适合学习 pandas、NumPy、Matplotlib 和 Seaborn。
- freeCodeCamp - 面向所有人的机器学习: 针对初学者的机器学习算法实用入门。
- Udacity - 机器学习入门: 免费课程,涵盖主成分分析 (PCA) 和其他几个机器学习概念。
👉[优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)]()👈

3. 神经网络
神经网络是许多机器学习模型的基础,特别是在深度学习领域。要有效利用神经网络,需要全面理解其设计和机制。

- 基础知识:包括理解神经网络的结构,如层、权重、偏置以及激活函数(如 sigmoid、tanh、ReLU 等)。
- 训练和优化:熟悉反向传播算法以及不同类型的损失函数,如均方误差(MSE)和交叉熵。理解各种优化算法,如梯度下降、随机梯度下降、RMSprop 和 Adam。
- 过拟合:了解过拟合的概念(即模型在训练数据上表现良好但在未见过的数据上表现较差),各种正则化技术(如 dropout、L1/L2 正则化、提前停止、数据增强)以防止过拟合。
- 实现多层感知机(MLP):构建一个多层感知机,也称为全连接网络。
📚 其他资源:
- 3Blue1Brown - 神经网络是什么?: 该视频直观地解释了神经网络及其内部工作原理。
- freeCodeCamp - 深度学习速成课程: 该视频高效地介绍了深度学习中的所有重要概念。
- Fast.ai - 实用深度学习: 面向具有编程经验的人的免费课程,旨在学习深度学习。
- Patrick Loeber - PyTorch 教程: 适合初学者的系列视频,学习 PyTorch。
4. 自然语言处理(NLP)
自然语言处理(NLP)是人工智能的一个迷人领域,它弥合了人类语言与机器理解之间的差距。从简单的文本处理到理解语言细微差别,NLP 在翻译、情感分析、聊天机器人等许多应用中扮演了关键角色。

- 文本预处理:学习各种文本预处理步骤,如分词(将文本拆分为单词或句子)、词干提取(将单词还原为其根形)、词形还原(类似于词干提取,但考虑上下文)、停用词去除等。
- 特征提取技术:熟悉将文本数据转换为机器学习算法可以理解的格式的方法。关键方法包括词袋模型(BoW)、词频-逆文档频率(TF-IDF)和 n-grams。
- 词嵌入:词嵌入是一种词语表示方法,它允许具有相似含义的词具有相似的表示。关键方法包括 Word2Vec、GloVe 和 FastText。
- 递归神经网络(RNNs):理解 RNNs 的工作原理,这是一种设计用于处理序列数据的神经网络。探索 LSTM 和 GRU,这两种 RNN 变体能够学习长期依赖关系。
📚 参考资料:
- RealPython - 使用 spaCy 进行 Python 中的自然语言处理: 关于 spaCy 库在 Python 中进行自然语言处理任务的详尽指南。
- Kaggle - 自然语言处理指南: 一些笔记本和资源,提供 Python 中自然语言处理的动手解释。
- Jay Alammar - Word2Vec 插图: 一个很好的参考,帮助理解著名的 Word2Vec 架构。
- Jake Tae - 从零开始的 PyTorch RNN 实现: 在 PyTorch 中对 RNN、LSTM 和 GRU 模型的实用而简单的实现。
- colah’s blog - 理解 LSTM 网络: 关于 LSTM 网络的更理论化的文章。
LLM Scientist 科学家
1. 大型语言模型(LLM)架构
虽然对 Transformer 架构的深入理解不是必须的,但了解其输入(tokens)和输出(logits)是非常重要的。原始的注意力机制是另一个关键组件,因为后续版本中引入了改进的版本。

- 高层次视角:重新审视编码器-解码器 Transformer 架构,特别是仅解码器的 GPT 架构,这在现代大型语言模型中广泛使用。
- 分词:理解如何将原始文本数据转换为模型可以理解的格式,这涉及将文本拆分为 tokens(通常是单词或子词)。
- 注意力机制:掌握注意力机制的理论,包括自注意力和缩放点积注意力,这使得模型在生成输出时能够关注输入的不同部分。
- 文本生成:了解模型生成输出序列的不同方式。常见的策略包括贪婪解码、束搜索(beam search)、top-k 采样和核采样(nucleus sampling)。
📚 参考资料:
- 插图化的 Transformer by Jay Alammar: 对 Transformer 模型的视觉和直观解释。
- 插图化的 GPT-2 by Jay Alammar: 比前一篇文章更为重要,专注于 GPT 架构,与 Llama 的架构非常相似。
- Transformer 的视觉介绍 by 3Blue1Brown: 简单易懂的 Transformer 视觉介绍。
- LLM 可视化 by Brendan Bycroft: 对 LLM 内部发生的事情的惊人 3D 可视化。
- nanoGPT by Andrej Karpathy: 一段长达 2 小时的 YouTube 视频,讲解如何从零实现 GPT(适合程序员)。
- 注意力?注意力! by Lilian Weng: 以更正式的方式介绍注意力机制的必要性。
- LLM 中的解码策略: 提供代码和不同解码策略的视觉介绍,用于生成文本。
2. 构建指令数据集
虽然从维基百科和其他网站获取原始数据很容易,但在自然环境中收集指令和答案的配对却很困难。正如在传统机器学习中一样,数据集的质量将直接影响模型的质量,因此它可能是微调过程中最重要的组成部分。

- Alpaca-类似数据集:使用 OpenAI API(GPT)从零生成合成数据。您可以指定种子和系统提示,以创建多样化的数据集。
- 高级技术:学习如何使用 Evol-Instruct 改进现有数据集,如何生成高质量的合成数据,如在 Orca 和 phi-1 论文中所述。
- 数据过滤:传统技术包括正则表达式(regex)、删除近似重复项、关注具有较高 token 数量的答案等。
- 提示模板:没有真正标准的指令和答案格式,因此了解不同的聊天模板(如 ChatML、Alpaca 等)是重要的。
📚 参考资料:
- 为指令微调准备数据集 by Thomas Capelle: 探讨 Alpaca 和 Alpaca-GPT4 数据集以及如何格式化它们。
- 生成临床指令数据集 by Solano Todeschini: 教程,讲解如何使用 GPT-4 创建合成指令数据集。
- 使用 GPT 3.5 进行新闻分类 by Kshitiz Sahay: 利用 GPT 3.5 创建指令数据集,以微调 Llama 2 进行新闻分类。
- 微调 LLM 的数据集创建: 含有一些过滤数据集并上传结果的技术的笔记本。
- 对话模板 by Matthew Carrigan: Hugging Face 关于提示模板的页面。
3. 预训练模型
预训练是一个非常漫长且昂贵的过程。了解预训练过程中发生的事情是有益的,但不需要实际操作经验。

- 数据管道:预训练需要巨大的数据集(例如,Llama 2 在 2 万亿 tokens 上进行了训练),这些数据需要经过过滤、分词,并与预定义的词汇表进行整理。
- 因果语言建模:了解因果语言建模与掩码语言建模的区别,以及在这种情况下使用的损失函数。为了高效的预训练,深入了解 Megatron-LM 或 gpt-neox。
- 规模定律:规模定律 描述了模型性能如何随着模型大小、数据集大小和训练所用计算量的变化而变化。
- 高性能计算:此处不涉及,但如果您计划从头开始创建自己的大型语言模型,了解 HPC(硬件、分布式工作负载等)是基础知识。
📚 参考资料:
- LLMDataHub by Junhao Zhao: 精选的数据集列表,用于预训练、微调和RLHF。
- 从零开始训练因果语言模型 by Hugging Face: 使用 transformers 库从头开始预训练一个 GPT-2 模型。
- TinyLlama by Zhang et al.: 查看这个项目以深入了解 Llama 模型从零开始训练的过程。
- 因果语言建模 by Hugging Face: 解释因果语言建模与掩码语言建模之间的区别,并介绍如何快速微调 DistilGPT-2 模型。
- Chinchilla 的深远影响 by nostalgebraist: 讨论扩展规律及其对 LLM 的一般意义。
- BLOOM by BigScience: 描述 BLOOM 模型构建过程的 Notion 页面,包含大量关于工程部分及遇到的问题的有用信息。
- OPT-175 日志 by Meta: 研究日志记录了哪些方面出现了问题和哪些方面做得对。如果你计划预训练一个非常大的语言模型(在这种情况下为175B参数),这份日志非常有用。
- LLM 360: 一个针对开源 LLM 的框架,提供训练和数据准备代码、数据、指标和模型。
4. 监督微调
预训练模型仅在下一个 token 预测任务上进行训练,这使得它们在处理指令时并不是特别有用。监督微调(SFT)可以调整它们以响应指令。此外,它还允许您在任何数据上(如私有数据或未见过的数据)对模型进行微调,并在不需要支付如 OpenAI API 的费用的情况下使用它。

- 全面微调:全面微调指的是训练模型中的所有参数。这是一种效率较低的技术,但能够产生略好的结果。
- LoRA:一种基于低秩适配器的参数高效技术(PEFT)。它不是训练所有参数,而是仅训练这些适配器。
- QLoRA:另一种基于 LoRA 的 PEFT 技术,它将模型的权重量化为 4 位,并引入分页优化器以管理内存峰值。结合 Unsloth 使用,可以在免费的 Colab 笔记本上高效运行。
- Axolotl:一个用户友好且功能强大的微调工具,被许多最先进的开源模型使用。
- DeepSpeed:针对多 GPU 和多节点设置的高效预训练和微调工具(在 Axolotl 中实现)。
📚 参考资料:
- 新手 LLM 训练指南 by Alpin: 介绍微调 LLM 时需要考虑的主要概念和参数。
- LoRA 深度解析 by Sebastian Raschka: 关于 LoRA 的实际见解及如何选择最佳参数。
- 微调你的 Llama 2 模型: 如何使用 Hugging Face 库微调 Llama 2 模型的实用教程。
- 填充大型语言模型 by Benjamin Marie: 为因果 LLM 填充训练示例的最佳实践。
- LLM 微调入门指南: 如何使用 Axolotl 微调 CodeLlama 模型的教程。
5. 偏好对齐
在监督微调之后,强化学习从人类反馈(RLHF)是用于将大型语言模型(LLM)的回答与人类期望对齐的步骤。其核心思想是通过从人类(或人工)反馈中学习偏好,以减少偏见、审查模型或使其更有用。这比 SFT 更复杂,通常被视为可选步骤。

- 偏好数据集:这些数据集通常包含若干个带有某种排序的答案,因此比指令数据集更难生成。
- 近端策略优化(PPO):该算法利用一个奖励模型来预测给定文本是否被人类高度评价。然后,使用这个预测来优化 SFT 模型,并根据 KL 散度施加惩罚。
- 直接偏好优化(DPO):DPO 通过将问题重新表述为分类问题来简化过程。它使用参考模型而不是奖励模型(无需训练),并且只需要一个超参数,使其更加稳定和高效。
📚 参考资料:
- Distilabel by Argilla: 出色的工具,用于创建自己的数据集。特别设计用于偏好数据集,但也可以进行监督微调(SFT)。
- 使用 RLHF 训练 LLMs 的介绍 by Ayush Thakur: 解释了为什么 RLHF 有助于减少偏见并提高 LLM 的性能。
- RLHF 说明 by Hugging Face: 介绍 RLHF,包括奖励模型训练和通过强化学习进行微调。
- LLMs 偏好微调 by Hugging Face: 比较 DPO、IPO 和 KTO 算法以执行偏好对齐。
- LLM 训练:RLHF 及其替代方案 by Sebastian Rashcka: RLHF 过程及其替代方案(如 RLAIF)的概述。
- 使用 DPO 微调 Mistral-7b: 微调 Mistral-7b 模型的教程,并重现 NeuralHermes-2.5。
6. 评估
评估大型语言模型(LLM)是管道中一个被低估的部分,这一过程既耗时又具有一定的可靠性。您的下游任务应决定您需要评估的内容,但始终记住 Goodhart 定律:“当一个度量成为目标时,它不再是一个好的度量。”

- 传统指标:像困惑度(Perplexity)和 BLEU 分数这样的指标现在不如以前流行,因为它们在大多数情况下存在缺陷。尽管如此,理解这些指标以及它们的适用场景仍然很重要。
- 通用基准:基于 语言模型评估工具包(Language Model Evaluation Harness),Open LLM Leaderboard 是通用 LLM(如 ChatGPT)的主要基准。还有其他流行的基准,如 BigBench、MT-Bench 等。
- 任务特定基准:诸如摘要生成、翻译和问答等任务具有专门的基准、指标,甚至子领域(如医学、金融等),例如用于生物医学问答的 PubMedQA。
- 人工评估:最可靠的评估是用户的接受率或人类的比较。除了聊天记录之外,记录用户反馈(例如使用 LangSmith)有助于识别潜在的改进领域。
📚 参考资料:
- 固定长度模型的困惑度 by Hugging Face: 提供困惑度的概述,并提供使用 transformers 库实现困惑度的代码示例。
- BLEU 得分的风险 by Rachael Tatman: 介绍了 BLEU 得分及其许多问题,并提供了相关示例。
- 对 LLM 评估的调查 by Chang et al.: 关于评估内容、评估地点和评估方法的全面论文。
- 聊天机器人竞技场排行榜 by lmsys: 基于人类比较的通用 LLMs 的 Elo 评分排行榜。
7. 量化
量化是将模型的权重(和激活值)转换为更低精度的过程。例如,将使用 16 位存储的权重转换为 4 位表示。这个技术在减少大型语言模型(LLM)的计算和内存成本方面变得越来越重要。

- 基础技术:学习不同的精度级别(如 FP32、FP16、INT8 等)以及如何使用 absmax 和零点技术进行简单的量化。
- GGUF 和 llama.cpp:最初设计用于在 CPU 上运行,llama.cpp 和 GGUF 格式已成为在消费级硬件上运行 LLM 的最受欢迎的工具。
- GPTQ 和 EXL2:GPTQ 和更具体的 EXL2 格式提供了极快的速度,但只能在 GPU 上运行。模型的量化过程也需要较长时间。
- AWQ:这种新格式比 GPTQ 更准确(困惑度更低),但使用了更多的 VRAM,且不一定更快。
📚 参考资料:
- 量化介绍: 量化的概述,包括 absmax 和零点量化,以及 LLM.int8() 的代码示例。
- 使用 llama.cpp 量化 Llama 模型: 教程介绍如何使用 llama.cpp 和 GGUF 格式来量化 Llama 2 模型。
- 使用 GPTQ 进行 4-bit LLM 量化: 教程介绍如何使用 GPTQ 算法和 AutoGPTQ 对 LLM 进行 4-bit 量化。
- ExLlamaV2:最快的 LLM 运行库: 指南介绍如何使用 EXL2 格式量化 Mistral 模型,并用 ExLlamaV2 库运行它。
- 理解激活感知权重量化 by FriendliAI: 关于 AWQ 技术及其优势的概述。
8. 新趋势
一些新的发展趋势。

- 位置嵌入:了解大型语言模型(LLM)如何编码位置,特别是像 RoPE 这样的相对位置编码方案。实现 YaRN(将注意力矩阵乘以温度因子)或 ALiBi(基于 token 距离的注意力惩罚)来扩展上下文长度。
- 模型合并:合并训练好的模型已成为创建高性能模型的一种流行方法,无需进行微调。流行的 mergekit 库实现了最受欢迎的合并方法,如 SLERP、DARE 和 TIES。
- 专家混合:由于其优异的性能,Mixtral 使 MoE 架构重新流行。与此同时,OSS 社区中出现了一种 frankenMoE 类型,通过合并模型如 Phixtral 提供了更便宜且性能良好的选择。
- 多模态模型:这些模型(如 CLIP、Stable Diffusion 或 LLaVA)可以处理多种类型的输入(文本、图像、音频等),并使用统一的嵌入空间,这解锁了如文本到图像等强大的应用。
📚 参考资料:
- 扩展 RoPE by EleutherAI: 总结了不同位置编码技术的文章。
- 理解 YaRN by Rajat Chawla: YaRN 的介绍。
- 使用 mergekit 合并 LLMs: 关于使用 mergekit 进行模型合并的教程。
- 专家混合模型解释 by Hugging Face: 关于专家混合模型(MoEs)的详尽指南及其工作原理。
- 大型多模态模型 by Chip Huyen: 多模态系统的概述以及该领域的近期历史。
LLM Engineer 工程师
1. 运行大型语言模型(LLMs)
由于硬件要求高,运行大型语言模型可能会很困难。根据您的使用案例,您可能希望通过 API(如 GPT-4)来简单地使用模型,或在本地运行它。在任何情况下,提示和指导技术可以改善和约束您的应用输出。

- LLM API:API 是部署 LLM 的一种方便方式。这个领域分为私人 LLM(如 OpenAI、Google、Anthropic、Cohere 等)和开源 LLM(如 OpenRouter、Hugging Face、Together AI 等)。
- 开源 LLM:可以在 Hugging Face Hub 上找到 LLM。您可以直接在 Hugging Face Spaces 中运行其中一些,或通过像 LM Studio 这样的应用程序本地下载并运行,或通过 CLI 使用 llama.cpp 或 Ollama。
- 提示工程:常见的技术包括零样本提示、少样本提示、思维链和 ReAct。这些技术在更大的模型中效果更好,但也可以调整用于较小的模型。
- 结构化输出:许多任务需要结构化输出,如严格的模板或 JSON 格式。可以使用像 LMQL、Outlines、Guidance 等库来指导生成并遵循给定的结构。
📚 参考资料:
- 使用 LM Studio 本地运行 LLM by Nisha Arya: 关于如何使用 LM Studio 的简短指南。
- 提示工程指南 by DAIR.AI: 提供详细的提示技巧列表和示例。
- Outlines - 快速入门: 由 Outlines 启用的指导生成技术列表。
- LMQL - 概述: LMQL 语言的介绍。
2. 构建向量存储
创建向量存储是构建检索增强生成(RAG)管道的第一步。文档被加载、拆分,并且相关的块被用来生成向量表示(嵌入),这些向量会被存储以便在推理过程中使用。

- 文档导入:文档加载器是处理多种格式的便利工具,包括 PDF、JSON、HTML、Markdown 等。它们还可以直接从一些数据库和 API(如 GitHub、Reddit、Google Drive 等)中检索数据。
- 拆分文档:文本拆分器将文档分解为较小且语义上有意义的块。与其在 n 个字符后拆分文本,不如按标题拆分或递归拆分,并附加一些额外的元数据。
- 嵌入模型:嵌入模型将文本转换为向量表示。这允许对语言进行更深层次和更细致的理解,这是执行语义搜索所必需的。
- 向量数据库:向量数据库(如 Chroma、Pinecone、Milvus、FAISS、Annoy 等)专门用于存储嵌入向量。它们可以根据向量相似性高效地检索与查询“最相似”的数据。
📚 参考资料:
- LangChain - 文本分割器: LangChain 中实现的不同文本分割器列表。
- Sentence Transformers 库: 受欢迎的嵌入模型库。
- MTEB 排行榜: 嵌入模型的排行榜。
- 五大顶级向量数据库 by Moez Ali: 对最佳和最受欢迎的向量数据库进行比较。
3. 检索增强生成(RAG)
通过 RAG,大型语言模型(LLM)从数据库中检索上下文文档,以提高答案的准确性。RAG 是增强模型知识的一种流行方法,无需进行微调。

- 协调器:协调器(如 LangChain、LlamaIndex、FastRAG 等)是将 LLM 连接到工具、数据库、记忆等的流行框架,并增强其能力。Zlai也是属于这里。
- 检索器:用户指令通常没有针对检索进行优化。可以应用不同的技术(例如,多查询检索器、HyDE 等)来重新措辞/扩展它们,并提高性能。
- 记忆:为了记住先前的指令和回答,LLM 和像 ChatGPT 这样的聊天机器人将这些历史信息添加到上下文窗口中。可以通过总结(例如,使用较小的 LLM)、向量存储 + RAG 等方法来改进这个缓冲区。
- 评估:我们需要评估文档检索(上下文精确度和召回率)和生成阶段(答案的准确性和相关性)。可以使用 Ragas 和 DeepEval 等工具简化评估过程。
📚 参考资料:
- Llamaindex - 高级概念: 在构建 RAG 流水线时需要了解的主要概念。
- Pinecone - 检索增强: 检索增强过程的概述。
- LangChain - 基于 RAG 的问答: 构建典型 RAG 流水线的逐步教程。
- LangChain - 记忆类型: 不同记忆类型及其相关用法的列表。
- RAG 流水线 - 评估指标: 评估 RAG 流水线的主要指标概述。
4. 高级 RAG
现实应用可能需要复杂的管道,包括 SQL 或图数据库,以及自动选择相关工具和 API。这些高级技术可以改进基础解决方案并提供额外功能。

- 查询构造:存储在传统数据库中的结构化数据需要特定的查询语言,如 SQL、Cypher、元数据等。我们可以直接将用户指令转换为查询,以通过查询构造访问数据。
- 代理和工具:代理通过自动选择最相关的工具来增强 LLM。这些工具可以像使用 Google 或 Wikipedia 这样简单,也可以像 Python 解释器或 Jira 这样复杂。
- 后处理:最后一步处理输入的数据,这些数据被送入 LLM。通过重新排序、RAG-fusion 和分类等方法,增强检索文档的相关性和多样性。
- 编程 LLM:像 DSPy 这样的框架允许您基于自动评估以编程方式优化提示和权重。
📚 参考资料:
- LangChain - 查询构造: 介绍不同类型查询构造的博客文章。
- LangChain - SQL: 关于如何使用 LLM 与 SQL 数据库交互的教程,包括文本到 SQL 的转换和可选的 SQL 代理。
- Pinecone - LLM 代理: 介绍不同类型的代理和工具。
- LLM 驱动的自主代理 by Lilian Weng: 关于 LLM 代理的理论文章。
- LangChain - OpenAI 的 RAG: 概述 OpenAI 采用的 RAG 策略,包括后处理。
- DSPy 的 8 个步骤: 一般用途的 DSPy 指南,介绍模块、签名和优化器。
5. 推理优化
文本生成是一个成本高昂的过程,需要昂贵的硬件。除了量化之外,还有各种技术被提出,以最大化吞吐量并降低推理成本。

- 闪电注意力(Flash Attention):优化注意力机制,将其复杂度从平方级别降低到线性级别,从而加快训练和推理速度。
- 键值缓存(Key-value cache):了解键值缓存以及 多查询注意力(Multi-Query Attention,MQA) 和 分组查询注意力(Grouped-Query Attention,GQA) 中引入的改进。
- 推测解码(Speculative decoding):使用一个小模型生成草稿,然后由更大的模型进行审查,以加速文本生成。
📚 参考资料:
- GPU 推理 by Hugging Face: 解释如何优化 GPU 上的推理。
- LLM 推理 by Databricks: 生产环境中优化 LLM 推理的最佳实践。
- 优化 LLM 的速度和内存 by Hugging Face: 介绍三种主要的优化技术:量化、Flash Attention 和架构创新。
- 辅助生成 by Hugging Face: Hugging Face 的版本的推测解码,介绍了其工作原理以及实现代码。
6. 部署 LLM
在大规模部署 LLM 是一项工程壮举,可能需要多个 GPU 集群。在其他场景下,演示和本地应用可以用更低的复杂度实现。

- 本地部署:隐私是开源 LLM 相较于私有 LLM 的一个重要优势。本地 LLM 服务器(如 LM Studio、Ollama、oobabooga、kobold.cpp 等)利用这一优势为本地应用提供支持。
- 演示部署:像 Gradio 和 Streamlit 这样的框架有助于原型设计和分享演示。你也可以轻松地在线托管这些应用,例如使用 Hugging Face Spaces。
- 服务器部署:大规模部署 LLM 需要云服务(参见 SkyPilot)或本地基础设施,通常利用优化的文本生成框架,如 TGI、vLLM 等。
- 边缘部署:在受限环境中,像 MLC LLM 和 mnn-llm 这样的高性能框架可以将 LLM 部署在网页浏览器、Android 和 iOS 上。
📚 参考资料:
- Streamlit - 构建基本的 LLM 应用: 教程,讲解如何使用 Streamlit 创建一个基本的类似 ChatGPT 的应用。
- HF LLM 推理容器: 使用 Hugging Face 的推理容器在 Amazon SageMaker 上部署 LLM。
- Philschmid 博客 by Philipp Schmid: 关于使用 Amazon SageMaker 部署 LLM 的高质量文章集合。
- 优化延迟 by Hamel Husain: 比较 TGI、vLLM、CTranslate2 和 mlc 在吞吐量和延迟方面的表现。
7. 安全性 LLM
除了传统的软件安全问题外,LLM 由于其训练和提示方式,还存在独特的弱点。

- 提示攻击:与提示工程相关的不同技术,包括提示注入(附加指令以劫持模型的回答)、数据/提示泄露(检索其原始数据/提示)和越狱(构造提示以绕过安全功能)。
- 后门:攻击向量可以针对训练数据本身,例如通过毒化训练数据(例如,添加虚假信息)或创建后门(秘密触发器,以在推理过程中改变模型的行为)。
- 防御措施:保护 LLM 应用的最佳方法是针对这些漏洞进行测试(例如,使用红队和检查工具如 garak),并在生产环境中监控它们(使用像 langfuse 这样的框架)。
在大模型时代,我们如何有效的去学习大模型?
零基础如何高效学习大模型?
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

【大模型全套视频教程】
教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。
从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。
同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
深耕 AI 领域技术专家带你快速入门大模型
跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

【精选AI大模型权威PDF书籍/教程】
精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
【AI 大模型面试题 】
除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。
【大厂 AI 岗位面经分享(92份)】
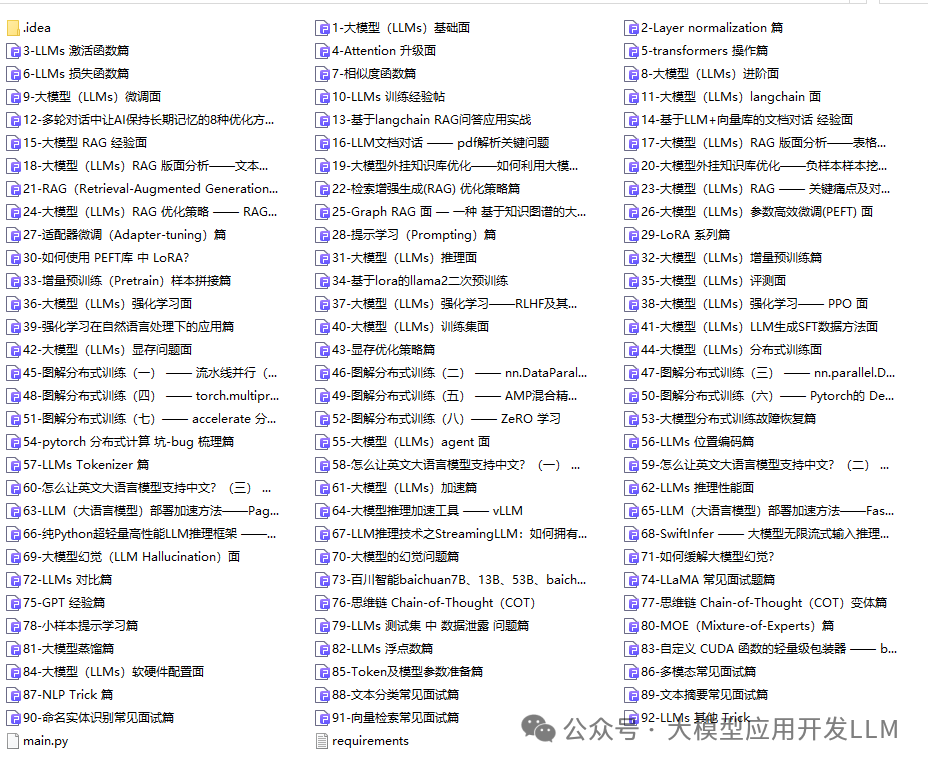
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
【640套 AI 大模型行业研究报告】
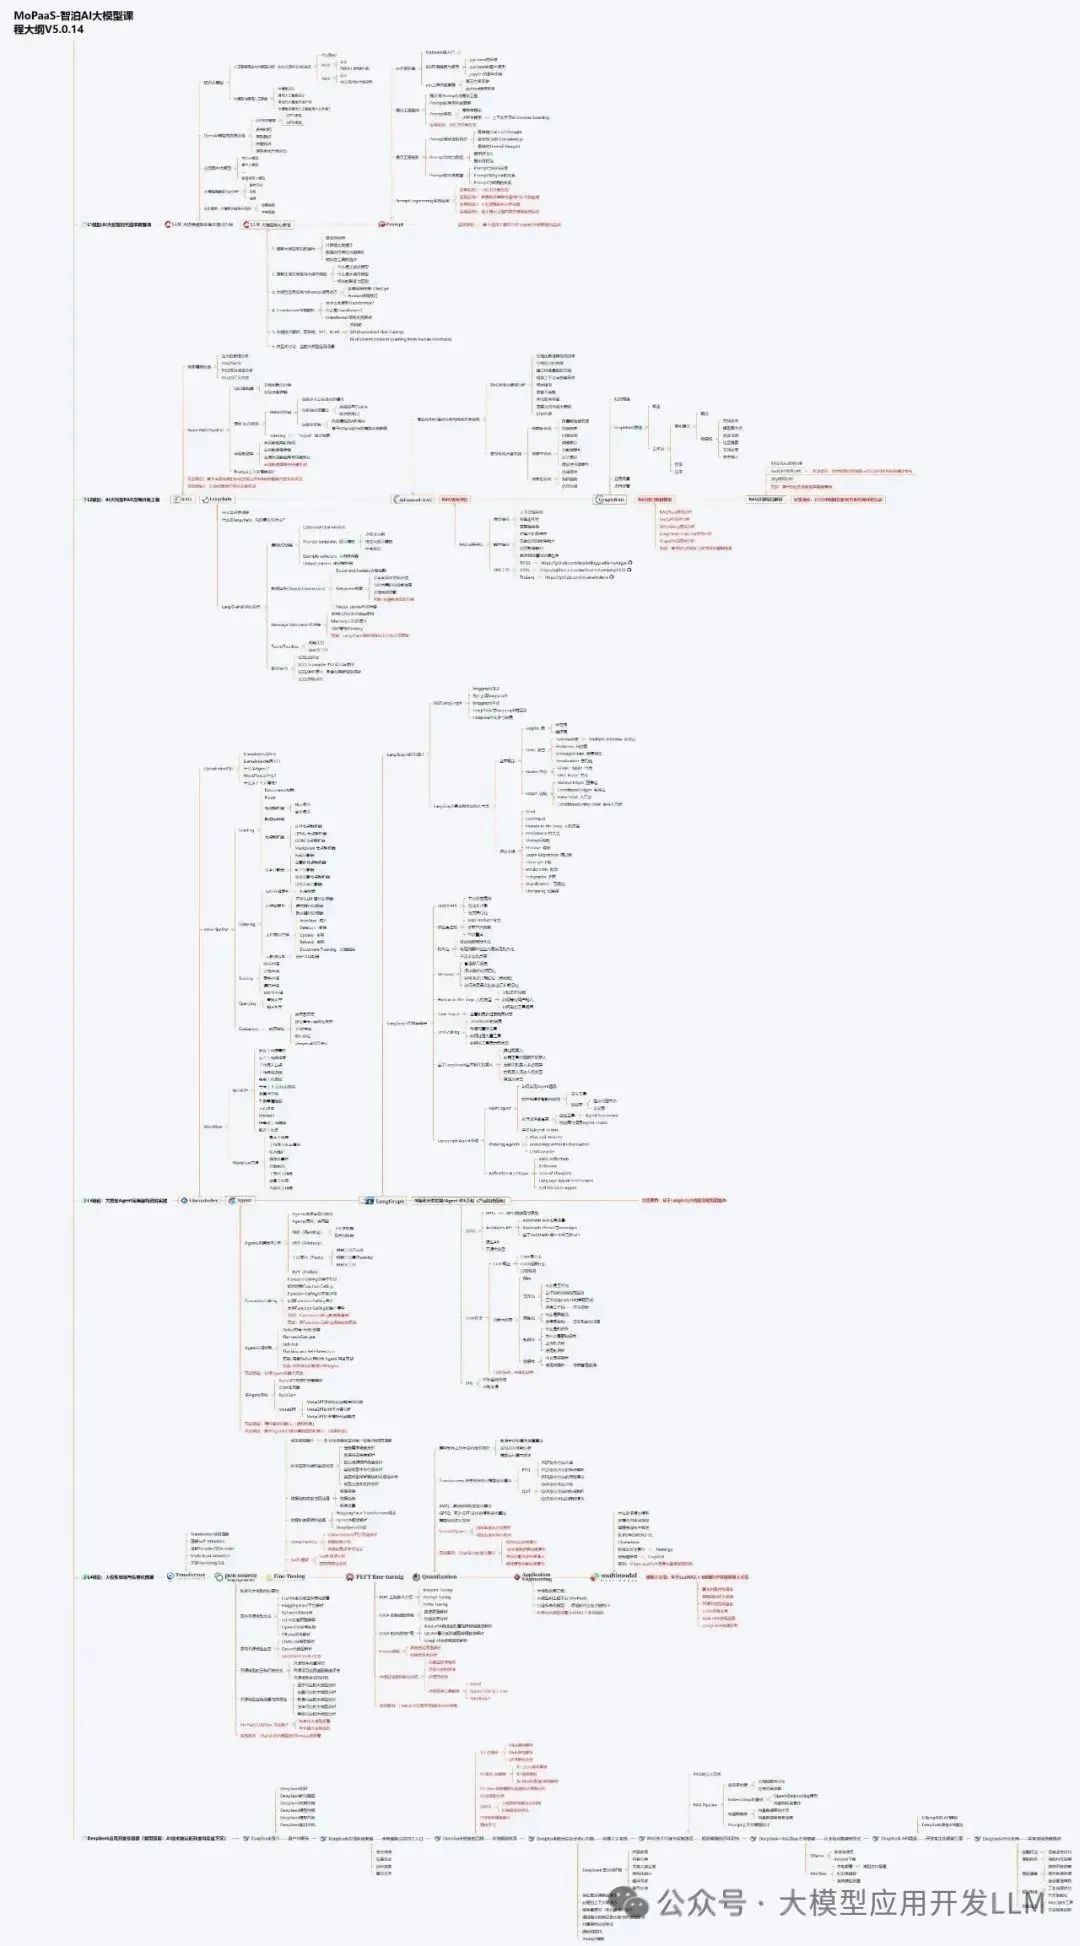
【AI大模型完整版学习路线图(2025版)】
明确学习方向,2025年 AI 要学什么,这一张图就够了!
👇👇点击下方卡片链接免费领取全部内容👇👇
抓住AI浪潮,重塑职业未来!
科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。
行业趋势洞察:
- 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
- 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
- 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。
与其观望,不如行动!
面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
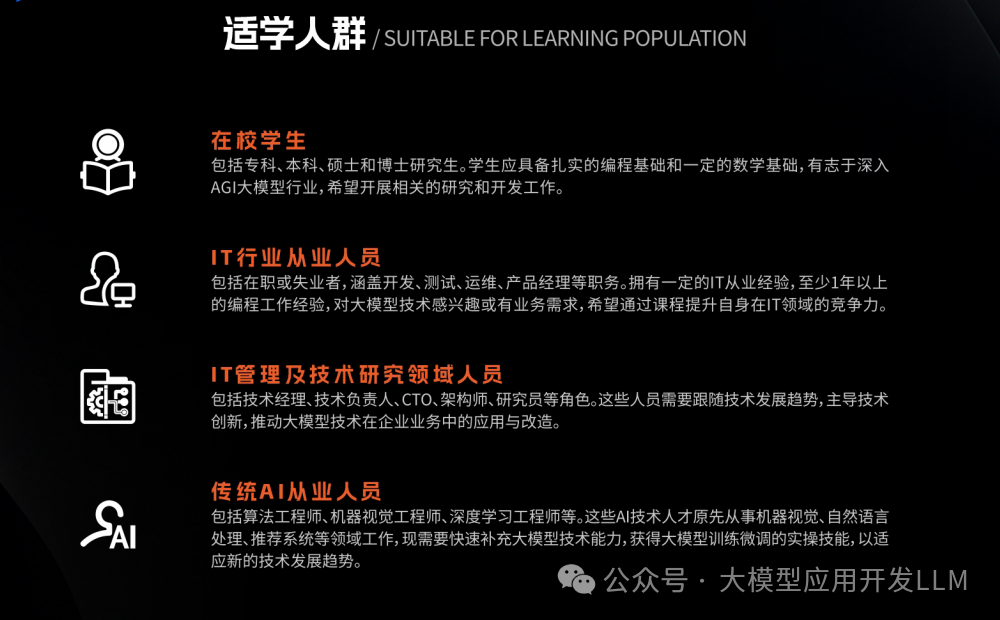
01 为什么分享这份学习资料?
当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。
因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!
我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。
*02 这份资料的价值在哪里?*
专业背书,系统构建:
-
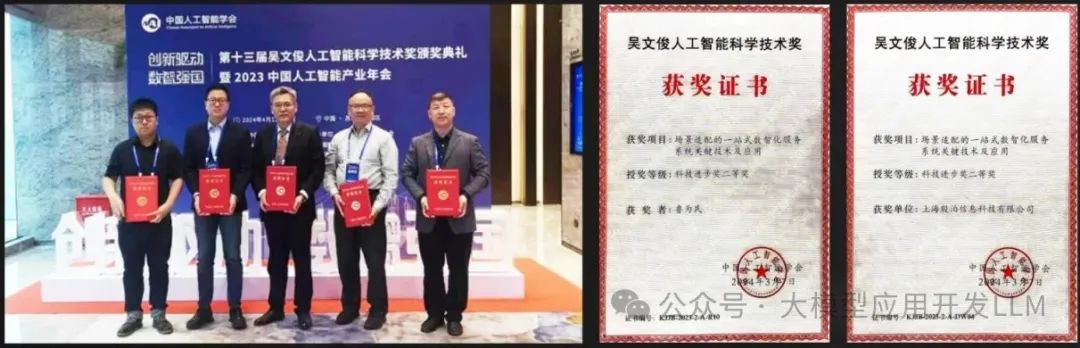
本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:
-
- 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
- 拥有多项中美发明专利。
- 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
-
目前,我有幸与鲁博士共同进行人工智能相关研究。
内容实用,循序渐进:
-
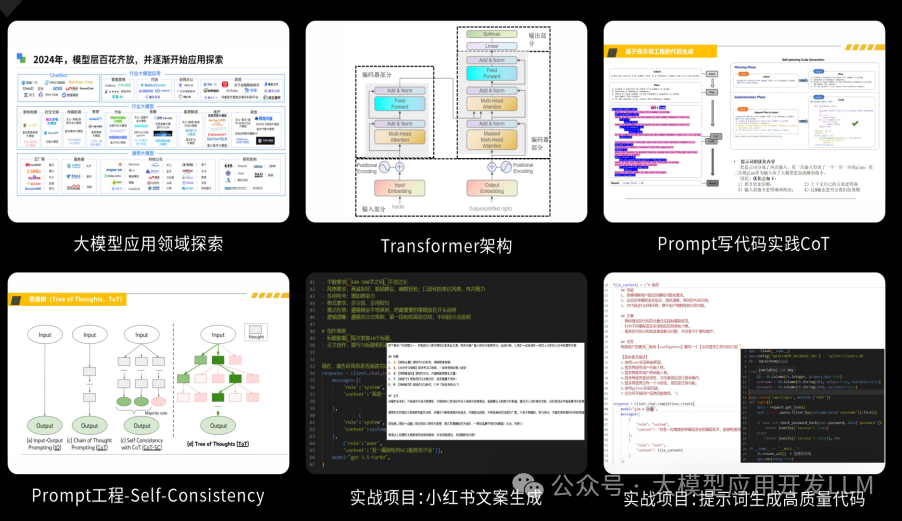
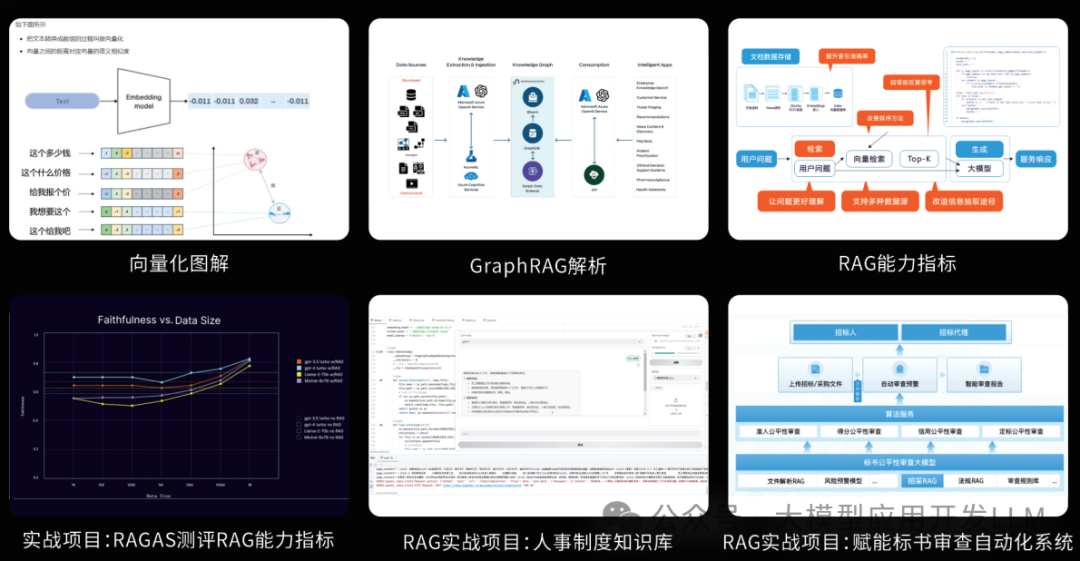
资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。
-
包含丰富的视频教程与实战项目案例,强调动手实践能力。
-
无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
抓住机遇,开启你的AI学习之旅!
 5735


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言