大模型算法工程师经典面试题————如何根据模型参数量估计大模型微调和推理所需显存?

大模型技术关于硬件和操作系统的要求 与Windows或MacOS相比,Linux在大模型推理和微调方面提供了更完善的功能支持,并且是工业场景中最常使用的操作系统。:适用于入门级或中级的大模型应用,推荐的显卡型号为NVIDIA RTX 3090和2080ti,具体选择取决于所需的显存和预算。:对于大模型的工业级实践,尤其是全量微调,建议使用高端的NVIDIA A100 80G显卡,并且至少需要4张卡以满足高性能需求。我们还提供了具体的GPU硬件要求和成本估算,包括不同量化级别下的推理和高效微调时的GPU显存占用,以及相应的显卡配置和成本。 阅读详情

面试题

如何根据模型参数量估计大模型微调和推理所需显存?

标准答案

为什么需要根据需要模型参数量估计需要的显存?

估计模型参数量对于确定所需的显存是非常重要的,原因如下:

  1. 模型存储: 每个模型参数(权重和偏置项)都需要一定的存储空间。在训练过程中,这些参数会被更新,并且需要在显存中保存最新的值以便后续计算使用。
  2. 激活值存储: 在前向传播过程中,每一层的输出(激活值)也需要被暂时存储起来,以便在反向传播时用于计算梯度。这意味着除了模型参数外,还需要额外的空间来存储每一步的中间结果。
  3. 梯度存储: 在反向传播阶段,每个参数都会有一个对应的梯度,这些梯度也需要存储在显存中,直到它们被用来更新参数为止。
  4. 批处理大小: 训练时使用的批处理大小也会影响显存需求。较大的批处理可以提高训练效率,但会占用更多的显存,因为需要同时处理更多的样本数据。
  5. 优化器状态: 一些优化算法(如Adam或RMSprop)会在每个参数上维护额外的状态(如移动平均值等),这些状态同样需要存储空间。
  6. 其他开销: 除了上述主要因素之外,还有一些其他的开销,比如模型架构元数据、临时变量以及其他运行时需要的数据结构。

因此,准确估计模型参数量可以帮助我们合理配置硬件资源,确保训练过程顺利进行而不会因显存不足而导致训练失败或效率低下。特别是在使用高性能GPU进行大规模训练时,合理分配显存尤为重要。

如何计算大模型微调所需显存

要计算大型模型微调所需的显存,我们需要考虑训练过程中涉及的各种组成部分及其占用的显存。以下是根据给定内容总结的关键点:

显存组成部分
  1. 模型权重:

    • 每个浮点数(float32)占用4字节的空间。
  2. 优化器:

    • AdamW:对于每个参数,需要额外存储两种状态(动量和二阶矩),每个状态占用8字节,这说明优化器所占用的显存是全精度(float32)模型权重的2倍。
    • bitsandbytes优化的AdamW:每个参数需要额外存储的状态占用2字节,即全精度模型权重的一半。
    • SGD:优化器状态占用的显存与全精度模型权重相同。
  3. 梯度:

    • 全精度(float32)模型权重所占用显存与梯度所占用显存相同。
  4. 计算图内部变量(通常称为前向激活或中间激活):

    • 这些变量在PyTorch、TensorFlow等框架中用于执行前向和后向传播,需要存储图中的节点数据,这部分显存需求在运行时才能确定。
显存需求计算
  1. 模型权重:每个参数占用4字节。

  2. 优化器状态:

    • 对于AdamW,每个参数需要额外存储两个状态(动量和二阶矩),每个状态占用8字节,总计额外占用16字节。
    • 对于bitsandbytes优化的AdamW,每个参数需要额外存储的状态占用2字节。
    • 对于SGD,优化器状态占用与模型权重相同的显存。
  3. 梯度:占用与模型权重相同的显存。

  4. 计算图内部变量:这部分显存需求取决于具体的前向传播过程,通常在运行时才能确定,可以通过比较不同批次的显存使用差异来大致估算。

示例计算
  • 假设一个7B参数的全精度模型,每个参数占用4字节,则模型权重占用 (7 \times 10^9 \times 4) 字节 = 28GB。
  • 使用AdamW优化器时,优化器状态占用 (7 \times 10^9 \times 16) 字节 = 112GB。
  • 梯度占用与模型权重相同的显存,即28GB。
  • 因此,总显存需求大约为 (28 + 112 + 28) GB = 168GB。
  • 但是,考虑到实际情况中的显存需求通常是模型权重的3-4倍,那么对于7B参数的模型,显存需求大约为 (28 \times 3) GB 到 (28 \times 4) GB,即78GB到104GB。
优化思路

为了减少显存需求,可以采取以下几种策略:

  • 量化:使用更少的位数表示权重和梯度,例如使用8位或更低精度的表示。
  • 模型切分:将模型分割成多个部分,分别在不同的设备上进行计算。
  • 混合精度计算:使用混合精度训练,例如FP16或BF16,以减少显存占用。
  • Memory Offload:将部分数据卸载到主内存或其他存储设备,减少显存占用。

主流的计算加速框架如DeepSpeed、Megatron等已经实施了上述的一些技术来降低显存需求。

如何计算大模型推理显存

所仅考虑推理阶段,计算所需的显存是比较简单些:

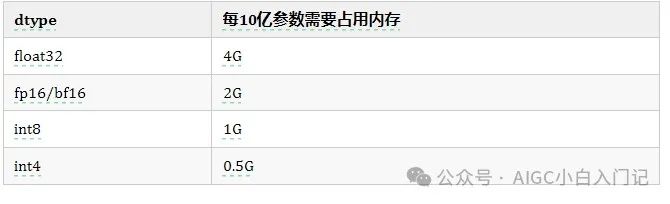
一般情况下,大多数模型的参数类型为 float32,每个参数需要占用4字节的空间。

因此我们可以这样计算:每10亿个参数大约占用4GB的显存(实际计算结果应为 GB,但为了简便起见,可以近似为4GB)。

eg:以 LLaMA 模型为例,其参数量为 7,000,559,616,所以以全精度加载LLaMA 模型参数所需的显存容量为:

这个数值有些挑战性,因为专为游戏设计的 GeForce 系列显卡最高也只有 24GB 显存,这意味着这类显卡无法运行此模型。因此,至少需要使用 Tesla 系列或其他更高规格的显卡才能满足运行此类大模型的需求。
图片

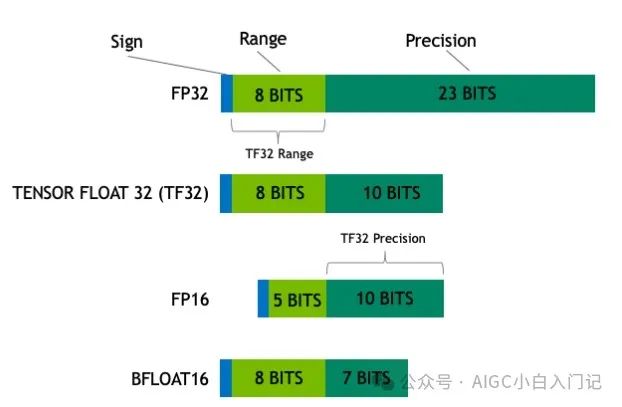
我们可以通过使用半精度(FP16 或 BF16)来加载模型,这样每个参数只需占用2字节的空间,所需显存容量就能减少一半,降至13.04GB。

使用半精度是一个很好的选择,虽然显存需求减少了一半,但由于精度降低,模型性能可能会略有下降,但通常仍在可接受的范围内。

  • 提问:如何在一张8GB显存的3070显卡部署LLaMA 模型?

如果想在一张8GB显存的3070显卡部署LLaMA 模型,可以通过采用 int8 精度进一步减少显存需求,降至6.5GB,但模型效果会进一步下降。

  • 提问:那如果我的电脑显卡特别 low!!! 只有一张 显存为4GB 的 GTX 960 显卡呢?

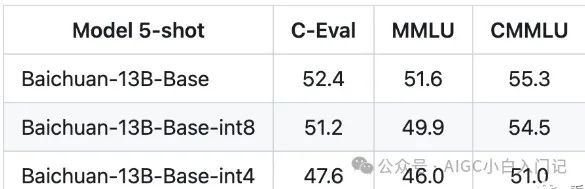
不怕,你只需要使用 int4 精度来运行,显存需求再次减半,降至3.26GB。当年我花费了上千元购买这块显卡,虽然现在只能勉强运行70亿参数级别的大模型进行推理,但也算是跟上了潮流。

目前 int4 是最低的精度级别,如果继续降低精度,模型的效果就难以保证了。

以下是百川给出的不同精度量化结果的对比:
图片

注:上述计算只考虑了将模型加载到显存中的情况,实际上在模型运算时还需要为一些临时变量分配空间,比如在进行 beam search 时。因此,在真正进行推理时,请记得预留一些缓冲空间,否则很容易导致显存溢出(OOM)。

  • 提问:我的电脑内存很大,但是就是没有显存可以用怎么办?

如果显存仍然不足,可以采用 Memory Offload 技术,将部分显存内容转移到主内存中,但这会显著降低推理的速度。
图片
​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

数据仓库实践:从ITR流程讲指标体系建设 从 ITR 流程或者其他客服反馈流程的考核过程可见,实际工作中不可能只通过单个指标评价一个业务过程,需要从多个维度梳理业务,并把多个高度相关的指标组织起来,以避免只考虑其中某个指标从而摧毁整个业务过程的结果,指标体系=指标+体系。 阅读详情

相关推荐

极验第四代滑块验证码破解(三):滑块轨迹构造

极验第四代滑块验证码破解(三):滑块轨迹构造声明 声明 原创文章,请勿转载! 本文内容仅限于安全研究,不公开具体源码。维护网络安全,人人有责。 本文关联文章超链接:

帯泪的鱼的博客 8624

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3937

【BLE系列-第六篇】GATT解析:属性、特征、描述符的逻辑关系

本文系统介绍了BLE协议中的ATT和GATT机制。ATT以"属性"为基本数据单元,包含UUID、Handle、权限和Value四个要素。GATT则在ATT基础上构建了服务、特征和描述符的层次结构:服务(UUID:0x2800/0x2801)通过声明属性标识,特征声明(UUID:0x2803)指向特征值(UUID:0x2Axx或自定义),描述符(UUID:0x2900~0x290F)提供附加信息。GATT复用ATT发现机制,通过定义特定UUID语义实现服务发现和特征管理。这种设计使BLE设

qq_43399763的博客 1930

大模型训练微调和推理阶段的显存对比分析

AI大模型名称中的b代表十亿级参数量,如7b表示70亿参数。大模型生命周期包含训练、微调和推理三阶段,各阶段显存需求不同:训练阶段显存需求最高(如7b模型需约200GB),需多块高端GPU;微调分全量(需120GB)和高效(20GB)两种;推理阶段显存需求最低(7b模型仅需7GB),可通过量化优化。参数量级直接决定了硬件配置需求,理解这些参数有助于合理规划和购置计算存储资源等。

hhue2007的专栏 932

hMailServer安装配置

hMailServer安装配置 使用宝塔面板上的宝塔邮件服务器2.1版本,进行安装hMailServer。 宝塔在安装hMailServer是有做了一些配置,如果是手工安装需要注意一下配置点: 1、\hMailServer\Bin 目录下增加mysql连接文件libmysql.dll,要去下载32位的。 libmysql.dll下载 链接:https://pan.baidu.com/s/1YGJXzjowlJ9n_MiqB4xiqw 提取码:wz90 2、 需要提前安装mysql,并创建hM.

王者的博客 5868

Qt Creator菜单栏消失的终极修复指南:从快捷键冲突到设置恢复

本文详细解析了Qt Creator菜单栏消失的常见原因及修复方法,包括快捷键冲突排查、配置文件重置和界面模式切换等解决方案。特别针对Qt开发者遇到的菜单栏显示问题,提供了从简单快捷键操作到深度配置修改的全方位指南,帮助用户快速恢复Qt Creator的正常使用。

weixin_27240351的博客 338

【大模型实战篇】大模型显存资源计算以及GPU如何选择

大模型、GPU、大模型显存资源计算、LLM、模型资源估算、计算公式、大模型资源因素、显存计算器、数值精度、GPU选型、大模型部署

源泉的小广场 8724

Python异步协程爬虫优化:解决aiohttp中ServerDisconnectedError的高效策略

本文深入探讨了在Python异步协程爬虫中使用aiohttp时,如何高效解决常见的ServerDisconnectedError问题。核心策略包括全局复用ClientSession、精细配置TCPConnector连接池、实施请求重试与速率限制,从而构建稳定、高效的异步爬虫架构,有效避免服务器断开连接错误。

pz890123的博客 862

2025大模型算法工程师经典面试题————如何根据模型参数量估计大模型微调和推理所需显存?

如何根据模型参数量估计大模型微调和推理所需显存?因此,准确估计模型参数量可以帮助我们合理配置硬件资源,确保训练过程顺利进行而不会因显存不足而导致训练失败或效率低下。特别是在使用高性能GPU进行大规模训练时,合理分配显存尤为重要。要计算大型模型微调所需的显存,我们需要考虑训练过程中涉及的各种组成部分及其占用的显存。:每个参数占用4字节。:占用与模型权重相同的显存。:这部分显存需求取决于具体的前向传播过程,通常在运行时才能确定,可以通过比较不同批次的显存使用差异来大致估算。

2401_85328934的博客 1372

【回眸】Tessy 单元测试软件使用指南(三)怎么打桩和指针赋值和测试

本文介绍了当使用Tessy对软件进行单元测试时如何打桩和指针相关测试的注意事项及操作要点,希望能给正在摸索Tessy的网友一点点启发。

啤酒鸭的物联网开发记录博客 1万+

【ArcGIS Pro微课1000例】0047:深度学习--棕榈树提取全流程

对汤加科洛瓦伊种植园每棵棕榈树的健康状况进行清查和评估,这需要花费大量的时间和劳动力。为简化此过程,将在 ArcGIS Pro 中使用深度学习模型来识别树木,然后根据植被绿度的测量值计算其健康状况。第一步是找到显示汤加科洛瓦伊的影像,该影像具有足够精细的空间和光谱分辨率来识别树木。获得此影像后,将创建训练样本并将其转换为可供深度学习模型使用的格式。为了让模型识别出它的查找任务,需要定义棕榈树的影像,以便识别相似的像素和树木大小。

智慧空间实验室 2208

Mythos模型如何实现软件安全能力的范式跃迁

大语言模型在软件安全领域的应用,正从辅助分析工具迈向自主攻防闭环系统。其核心在于模型是否具备对程序语义、系统行为与攻击链路的深度建模能力,而非简单匹配已知漏洞模式。关键技术突破包括长上下文下的符号推理、基于环境反馈的强化学习(RLEF)训练范式,以及超长链式思维(100M token级推理)带来的战术级决策能力。这类能力使模型可完成从静态代码审计、动态利用构造到跨系统横向移动的全链路任务,显著提升漏洞发现效率与准确性。Claude Mythos正是这一演进路径的标志性成果,它在SWE-bench Pro和C

SAN_YUN的专栏 265

vue3+element-plus - 最新详细实现将表格Table组件 “所见所得导出“ 为excel(xls/xlsx)电子表格文件,表格中的图片图像、图标等媒体资源完美导出显示(详细示例代码)

vue3,nuxt3,element plus,表格组件,Table,el-table,导出,下载,excel,电子工作簿,xls,xlsx,将表格导出成xls,如何把表格原封不动的导出成excel,保留图片,带图片,图标,如何导出包括含有图片的Excel表格,图片和表格数据导出excel,把表格导出成excel格式,表格内的图片一起导出,vue3导出图片和数据到Excel,可导出图片,导出图像到Excel,网页上的图片怎么能导出到xls表格中,显示图片url链接,图片太多导出失败,图片会超出单元格,图片不

✅ 精选推荐文章 4767

大模型到底需要消耗多少GPU显存?公式和工具全都有

如何计算大模型到底需要多少显存,是常常被问起的问题。现从实用角度介绍一个简单公式和一个工具方便大家工作中使用。1)估算公式(该公式来自于Sam Stoelinga简化[1])注意:该公式只是为了简化计算的估计,并未包含kvcache所需显存以及context大小的影响。下面以运行16位精度的 Llama 70B 模型所需的 GPU 内存为例套用公式:该模型有 700 亿参数。由此可见,模型所需的 GPU 内存相当大。

m0_59164304的博客 7503

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

大模型显存计算指南 - 推理与训练显存计算详解

推理阶段主要考虑参数量、注意力缓存和激活值训练阶段需额外考虑梯度、优化器状态和前向计算缓存合理使用显存优化技术可以突破硬件限制希望这篇文章能帮助你更好地理解和规划大模型的显存使用!

携梦问道的博客 4963

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

(最全)PyTorch神经网络打印存储所有权重+状态+激活值(运行时中间值)+量化权重和激活

假设已经有模型model和pt文件了,在当前目录下新建weights文件夹,运行最后三行代码,就可以得到模型的权重(文本形式和二进制形式)很多时候嵌入式或者新硬件需要纯净的权重模型和激活值(运行时中间值),本文提供一种最简洁的方法。作为一个整体,目前没办法拆开来看其内部的中间值。和以下等价(不需要recursive了)对于二进制形式的文件,可以通过。查看其对应的浮点数值。

qq_44345567的博客 1584

如何根据模型参数推算出部署所需要多大的GPU

激活值内存取决于模型结构、批次大小(Batch Size)和序列长度(Sequence Length)。要根据模型参数推算所需的GPU显存,需综合考虑参数存储、中间激活值、推理缓存及框架开销。:24GB显存(如RTX 4090/A10G)或通过量化降低需求。预留20%~30%显存应对框架预分配、临时缓冲区等开销。

小马过河R的博客 2640

简明大模型微调/推理显存资源计算

asd8705的专栏 412

大模型本地部署硬件资源学习(包含模型微调所需资源)

本博客将全面探讨构建系统的需求分析框架到深入解析华为昇腾算力的支持能力,再到提供详尽的显卡信息对比和大模型微调所需的显存资源指南。特别针对Qwen系列与DeepSeek蒸馏模型,将详细介绍其微调显存需求、优化策略及硬件选型建议。

weixin_44733966的博客 6617

AI大模型训练相关参数如何估算?有这一篇就够了

随着大模型时代的到来,模型参数量、训练数据量、计算量等各方面急剧增长。参数规模方面,在过去的几年里,语言模型的参数规模从数亿增长到数千亿,甚至达到万亿级别。例如OpenAI的GPT-3拥有175B参数,而GPT MoE参数规模到达了1.8T;数据量方面,训练一个大模型通常需要达到T级别tokens;另外,由于参数规模和数据量庞大,随之带来的是巨大的计算量。

python1234567_的博客 5603

梯度累积与显存占用:深入解析

在深度学习模型的训练过程中,梯度累积(Gradient Accumulation)是一种常用的技术,特别是在显存有限的情况下,能够有效增加批次大小,同时不超出显存限制。然而,对于梯度累积对显存的影响,很多开发者仍有疑问:梯度累积会不会增加显存的占用?尤其当累积步数增大时,显存占用是否会急剧增加?

weixin_41496173的博客 2461

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 304

把 KV Cache 压到 FP4:BitDecoding-FP4 的算法-系统协同设计复盘

长上下文推理卡在KV Cache的显存与带宽上,而现有FP4方案要么精度崩、要么速度废。这篇文章复盘BitDecoding-FP4如何用三个算法补丁加一个系统重构,在B300上把服务吞吐提升2.4–3.0倍,精度几乎不掉。

helloagent的博客 310

【算法拾光】链表 哈希表|K个一组翻转链表 + 两数之和

K个一组翻转链表需分段反转,借助哑节点与前驱指针维护连接,避免断链;两数之和利用哈希表实现O(1)查找,空间换时间,高效定位目标组合。前者考察链表指针操作,后者聚焦映射关系构建,均为面试高频题。

wuqingyigexiaoba的博客 329
上一篇: 普通人转行“提示工程师”毫无意义
下一篇: 使用大模型提效程序员工作
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


