AI 实战篇:从零训练你的大模型 ——MiniMind 全流程实战

minimind - 从零开始训练小型语言模型 大语言模型(LLM)领域,如 GPT、LLaMA、GLM 等,虽然它们效果惊艳, 但动辄10 Bilion庞大的模型参数个人设备显存远不够训练,甚至推理困难。 几乎所有人都不会只满足于用Lora等方案fine-tuing大模型学会一些新的指令, 这约等于在教牛顿玩21世纪的智能手机,然而,这远远脱离了学习物理本身的奥妙。 此外,卖课付费订阅的营销号漏洞百出的一知半解讲解AI的教程遍地, 让理解LLM的优质内容雪上加霜,严重阻碍了学习者。 阅读详情

最近在GitHub上挖到一个宝藏项目——MiniMind,一个能让大家从零开始,用极低成本和极短时间玩转大模型全流程的开源项目。从预训练(Pretrain)到监督微调(SFT),从LoRA轻量化训练到DPO偏好优化,甚至模型蒸馏和多模态拓展,全部代码原生PyTorch实现,不依赖复杂第三方抽象接口。

作为一名AI从业者,亲测后发现它不仅是一个可落地的项目,更是入门大模型训练的绝佳教程。今天就带大家手把手体验这个“大道至简”的实战过程。
为什么MiniMind值得上手?

01

接触过大模型的同学都知道,训练一个模型往往意味着“高门槛”:动辄千万级参数、数万元服务器成本、数周的训练周期,还得依赖一堆复杂框架。但MiniMind彻底打破了这个印象:
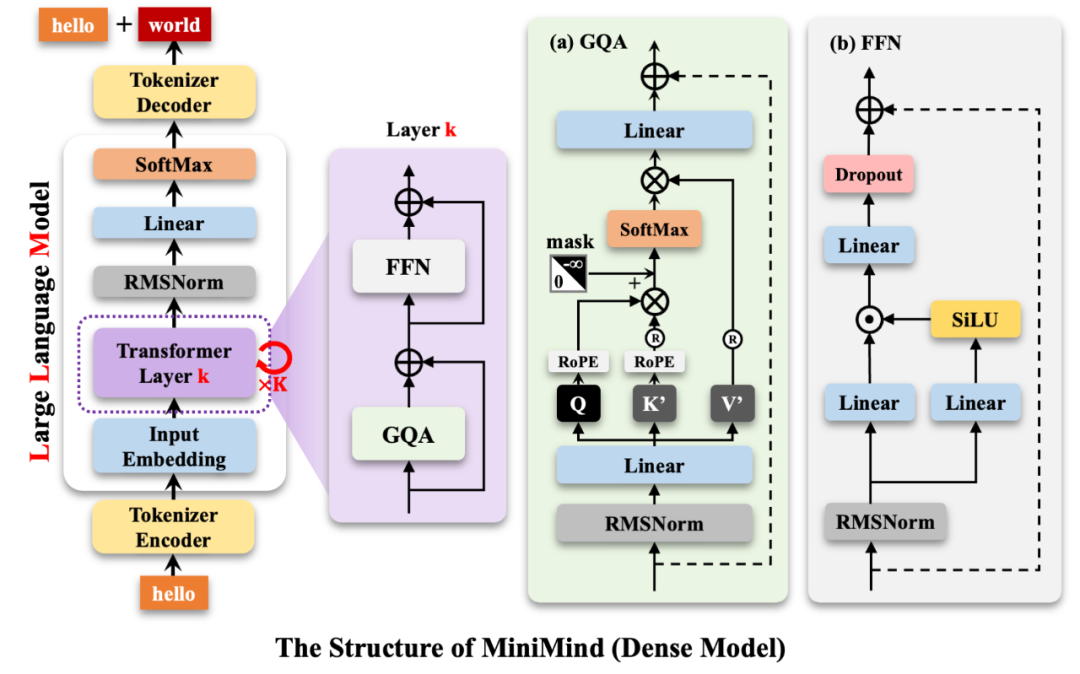
  • 极致轻量化:最小的MiniMind2-small仅25.8M参数,是GPT-3的1/7000,普通个人GPU(比如NVIDIA 3090)就能轻松跑起来。

    (本地实测)训练完成的 DPO 模型(out/dpo_512.pth)仅 2910 万参数,内存占用 55.52MB。从结构上看,它由 8 层网络组成,核心参数集中在 MLP 模块(59.4%),没有冗余设计

    PyTorch Model Analysis: out/dpo_512.pth==================================================File Size: 58237621 bytes (55.54 MB)File Type: PyTorch ModelObject Type: dictTotal Parameters:29,106,688Model Size in Memory: 55.52 MBModel Architecture Summary:----------------------------Number of Layers:8Vocab Size: 6400Hidden Size: 512Output Vocab Size: 6400Attention Heads:1Head Dimension: 512Component Breakdown:  Tokenizer Embeddings:3,276,800 parameters (11.3%)    - model.embed_tokens.weight  Attention Blocks:5,242,880 parameters (18.0%)  MLP Blocks:17,301,504 parameters (59.4%)  Layer Norms:8,192 parameters (0.0%)  Final Normalization: 512 parameters (0.0%)    - model.norm.weight  Output Projection: 3,276,800 parameters (11.3%)    - lm_head.weight
    
  • 低成本快迭代:单卡3090训练2小时、服务器成本仅3元,就能从0训出一个能对话的基础模型;8卡4090甚至能压缩到10分钟内,成本几乎不变。

  • 全流程开源:从Tokenizer训练、数据清洗,到Pretrain、SFT、LoRA、DPO/PPO强化学习,再到模型蒸馏,每一步都有完整代码,且完全基于PyTorch原生实现,小白也能看懂底层逻辑。

  • 扩展性强:不仅支持文本模型,还拓展了视觉多模态(MiniMind-V),兼容transformers、vllm、llama.cpp等主流工具,训练好的模型能直接集成到ChatUI里用。

实战前的准备:3分钟搭好环境

02

MiniMind的门槛低到离谱,不需要复杂的集群配置,个人电脑或云服务器(3090以上显卡)就能搞定。

  1. 环境依赖

核心依赖只有PyTorch,其他库(如transformers、datasets)按需安装,项目仓库里提供了requirements.txt,一行命令即可搞定:

pip install -r requirements.txt
  1. 数据集准备

不用自己爬数据!项目开源了所有训练阶段的高质量数据集(预训练、SFT、DPO等),直接从ModelScope或HuggingFace下载,放到./dataset/目录即可。推荐先下这三个核心文件:

  • pretrain\_hq.jsonl:高质量预训练数据(1.6GB)

  • sft\_*mini\_*512.jsonl:精简版SFT指令数据(1.2GB)

  • dpo.jsonl:偏好优化数据(55MB)

从零训练三步走:从“空白模型”到“能聊天”

03

第一步:预训练(Pretrain)——让模型“认识世界”

预训练是让模型学习语言规律的基础,MiniMind的预训练过程简化到极致:

  1. 下载并处理预训练数据(pretrain\_hq.jsonl),项目提供了自动清洗脚本,会过滤低质文本、统一格式。

  2. 运行预训练脚本,指定模型参数(以25.8M的small模型为例):

    python train_pretrain.py
    

单卡3090上,2个epoch约1.5小时就能跑完,模型会初步具备语言生成能力。

第二步:监督微调(SFT)——教模型“懂指令”

预训练后的模型像个“识字但不懂任务”的孩子,SFT要教它理解人类指令(比如“推荐杭州美食”“解释大语言模型”):

  1. 用./dataset/sft\_*mini\_*512.jsonl作为微调数据,包含日常对话、知识问答等场景。

  2. 运行SFT脚本:

    python train_sft.py
    

这一步更快,约30分钟就能完成,模型已经能回应简单指令了。

第三步:DPO优化——让模型“说人话”

直接微调的模型可能回答生硬,DPO(直接偏好优化)通过“好/坏回答对比”,让模型输出更符合人类偏好的内容:

  1. 使用dpo.jsonl数据集,里面包含“问题+好回答+坏回答”的三元组。

  2. 运行DPO脚本:

    python train_dpo.py
    

20分钟左右完成,此时模型的对话流畅度会明显提升。

效果实测:3元成本的模型能做到什么?

04

训练完成后,用项目提供的eval\_llm.py启动一个简单chat终端,就能直接和模型聊天了。实测效果超出预期:

  • 基础对话:能清晰介绍自己(“我是MiniMind,一个轻量级AI助手”)。

  • 知识问答:能解释“大语言模型”的基本概念,推荐杭州特色美食(虽然偶尔会混入其他地方的菜,但逻辑在线)。

  • 多语言能力:支持简单英文对话,虽然不够流利,但作为25.8M的小模型已属难得。

(附一段实测对话)

MiniMind模型参数: 25.83 M(illion)[0] 自动测试[1] 手动输入1👶: 请介绍一下北京的美食🤖️: 北京是中华人民共和国首都,拥有丰富的美食文化。以下是一些著名的美食:1. **烤鸭**:北京烤鸭是北京最具代表性的美食之一,以其独特的皮脆肉嫩、皮脆肉嫩、鸭肉鲜嫩、鸭血粉腌制而闻名。2. **豆汁**:豆汁是北京最具代表性的美食之一,以其浓郁的豆汁和鲜美的鸭肉汁而闻名。3. **火锅**:火锅是北京最有名的中国菜之一,以其火锅底料、肉质鲜嫩、配料多样而闻名。4. **葱油饼**:葱油饼是北京传统美食,通常由饼皮、葱花、肉馅、豆皮等配料组成,口感麻辣鲜香,是北京的代表美食之一。5. **豆浆**:豆浆是北京著名的特色小吃,由豆浆、牛奶、蛋黄、糖等原料制成,口感丰富,可以搭配米饭食用。

一点建议:为什么MiniMind是最好的入门教材?

05

如果你是大模型初学者,MiniMind的价值远不止“能训模型”:

  • 代码极简:所有核心算法(如Transformer结构、LoRA权重分解、DPO损失函数)都用PyTorch原生代码实现,没有隐藏的第三方接口,能直接看到“模型怎么算出来的”。

  • 文档详细:从数据清洗到训练参数调优,每个步骤都有注释和说明,甚至包含“为什么这么做”的思路解析。

  • 可扩展性强:想尝试MoE(混合专家模型)?想做医疗领域微调?项目里有现成的代码和数据集(如lora\_medical.jsonl),改改参数就能跑。

结语:用“极简”打破大模型的“神秘感”

06

MiniMind最打动我的是它践行的“大道至简”理念——大模型不是只有大厂能玩的奢侈品,普通人也能完整体验从0到1的训练流程。如果你也想亲手摸透大模型的底层逻辑,不妨从这个项目开始:不需要高深的理论,不需要昂贵的设备,跟着步骤一步步跑,你会发现“训练大模型”原来这么简单。


想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

如何理解反步法设计控制器? 假设以二阶系统为例,被控对象的系统状态方程为: 基于反步控制的具体方法如下: 1.1步骤一 定义期望状态为xd,状态误差e1,为: e1=x1-xd; 则e1的导数为: 1.2步骤二 定义虚拟控制量为: e2定义为: 1.3步骤三 定义Lyapunov能量函数为: 1.4步骤四 定义总Lyapunov能量函数为: 因此设计的控制律为: 设计c>0,则: 满足Lyapunov的稳定性判定条件... 阅读详情

相关推荐

[Spawn service failed. Exiting] ROS2运行turtlebot3_gazebo例程卡住_报错

[Spawn service failed. Exiting] ROS2运行turtlebot3_gazebo例程卡住_报错

Feizhai2的博客 4862

MiniMind用极低的成本训练属于自己的大模型

在2小时,训练出属于自己的28M大模型。特性说明:1、在家用电脑中即可进行大模型的训练。2、训练时间可在一天之内,让你获得低成本训练出的大模型。3、适用于性能不高的电脑本地运行及训练迭代。

任聪聪的博客 4095

[特殊字符] 智能补货(AI-driven Replenishment)完整实施方案

补货量=预测需求+安全库存−当前库存补货量 = 预测需求 + 安全库存 - 当前库存补货量=预测需求+安全库存−当前库存。:基于 LSTM/Transformer 预测未来 30/60/90 天的销量。

nbsaas-boot基于Request-Response的企业级快速开发框架 967

【万字解析—小白也能上手的大模型实践:2 小时从零训练 26M 超轻量 MiniMind,详解部署全流程与实战避坑指南】

MiniMind是一个开源的大模型训练项目,旨在降低大模型学习门槛,让普通人仅用2小时和低成本服务器就能训练出超轻量语言模型(25.8M参数)。项目特点包括:全流程开源代码、兼容主流推理引擎、可作为LLM入门教程。核心流程涵盖了分词器训练、预训练、监督微调(SFT)、LoRA微调、DPO强化学习等完整生命周期。部署环境要求16核CPU、48GB内存、24GB显存的GPU。通过该项目,用户可以深入理解Transformer结构、分词器原理等核心技术,避免"只会调用API"的表层学习。

2301_80224467的博客 2840

基于carsim与Simulink联合仿真的车辆换道轨迹规划与轨迹跟踪模型

PID_反步控制_滑膜控制三种四旋翼无人机轨迹跟踪控制算法仿真 附带对应的说明文档,提供建模过程与仿真结果文献(英文)➕PPT 描述:采用的同一种参考轨迹,都是三维仿真 三种控制方法: [1]PID控制、[2]反步控制、[3]滑膜控制(三个仿真模型) 每个仿真均应用了同一种轨迹路径,直接运行即可出三维图,可以实现四旋翼无人机轨迹的跟踪

2501_90804007的博客 1084

3D识别建模 — 基于ReconstructMe和EAGLE EYES SCANNER的实现

3D实体识别建模,作为3D打印反向工程的一个重要环节,今天就让我们利用ReconstructMe和EAGLE EYES SCANNER来了解一下。 第一步、软件和硬件准备就绪 ReconstructMe下载并安装 http://reconstructme.net/?wpdmdl=160 EAGLE EYES SCANNER直接将相应USB插入电脑接口即OK,之后在    中点击搜索“设备管理...

qq_40013290的博客 881

人人都能训练大模型!MiniMind:3 小时打造你的微型 GPT

MiniMind 是近期 GitHub 上最受瞩目的 AI 开源项目之一,它用 3 小时训练时间 + 2G 显存需求 的极致性价比,将大语言模型(LLM)的训练门槛砸到了地平线!这个由开发者 Jingyao Gong 打造的项目,正在 GitHub 以每天 400+ 星的速度疯狂生长,目前已斩获 12.2k+ Stars。

瓦罗兰特顶级C位的博客 1854

Win11右键菜单显示更多选项设置默认展开方法

在Windows 11操作系统中,用户可能会发现右键点击桌面空白处时,弹出的菜单中仅显示“显示更多选项”,而并非直接展示所有可用的选项。这对于希望快速访问特定功能的用户来说,无疑增加了一些不便。为了优化这一体验,本文将介绍两种简单的方法,帮助用户设置Win11右键菜单,使其默认展开包含的所有选项。通过上述两种方法,用户可以轻松地将Win11右键菜单设置为默认展开所有选项,从而提高工作效率和便捷性。希望这篇文章对你有所帮助!

nntxthml的博客 1万+

MiniMind:已开源!只要3小时就能训练一个26M的大模型,教程非常清晰我感觉我又行了!

MiniMind 是一个轻量级的大语言模型项目,让用户可以在个人设备上快速训练和运行GPT模型。该项目可以使用极小的数据和计算资源,在3小时内训练出一个26M的模型,使大模型技术使用更加简单。MiniMind 支持单机单卡和多卡训练,兼容多个流行的框架,并提供完整的代码和文档支持,帮助初学者和研究者快速上手并进行定制和扩展。MiniMind现在总共有5个模型,最小的是26M,已经有不错的对话能力了。

m0_59235945的博客 7069

Tecplot进阶:巧用公式与多Frame对比,实现CFD多工况数据差异的可视化分析

本文详细介绍了如何利用Tecplot进行CFD多工况数据差异的可视化分析,通过公式计算和多Frame对比,实现变量差值自动计算、多视图同步展示和差异量化统计。文章还提供了数据准备、基础操作、实战技巧和常见问题解决方案,帮助工程师高效完成CFD后处理工作。

weixin_29227425的博客 528

Sigrity SystemSI仿真分析教程文件路径

为了方便读者能够快速上手和学会Sigrity SystemSI 的功能,将Sigrity SystemSI仿真分析教程专栏所有文章对应的实例文件上传至以下路径。

weixin_54787054的博客 710

自己训练大模型?MiniMind 全流程解析 (一) 预训练

MiniMind是一个开源的大语言模型训练框架,提供从预训练到推理的全流程解决方案。本文解析其预训练流程的核心技术:1)采用余弦退火学习率调度平衡收敛与精度;2)混合精度训练结合float16前向计算与float32梯度管理加速训练;3)梯度累积技术突破显存限制;4)基于NCCL的分布式训练实现多GPU并行。框架通过模块化设计(参数解析、数据加载、训练循环等)支持高效训练,并确保实验可复现性(随机种子管理)。项目完全开源,代码详见GitHub仓库。

翊歌 1999

AIGC算法工程师面试八股文深度解析与进阶指南:揭秘Diffusion Models核心原理与实战技巧

总结来说,Cosine Noise Scheduler 的核心优势在于它能够更巧妙地平衡信号和噪声的比例,在扩散过程的早期阶段更长时间地保留原始图像的细节信息,从而为去噪模型提供一个更友好的学习环境,最终带来更优异的生成质量。🚀

FJN110的博客 346

【GitHub上大模型开源项目】MiniMind项目,用极简代码轻松训练大模型,附详细实战教程!

MiniMind是一个轻量级大模型开源项目,让普通人也能以极低成本(单卡3090训练2小时,成本仅3元)完成大模型全流程训练。项目从预训练到DPO优化,全部基于PyTorch原生实现,不依赖复杂框架。最小模型仅25.8M参数,适合个人GPU运行。对于大模型初学者,MiniMind提供了完整的代码实现和详细文档,是入门大模型训练的绝佳选择。

2301_80239908的博客 1324

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

自己训练大模型?MiniMind 全流程解析 (三) DPO训练

MiniMind DPO训练教程解析了一种无需奖励模型的强化学习方法。DPO通过直接优化人类偏好数据,简化了传统RLHF流程。文章详细介绍了DPO的核心算法、数据格式要求和完整训练实现,包括模型初始化、损失函数计算和训练循环。DPO采用对比"好/差回答"的概率比来学习人类价值观,其损失函数基于参考模型与训练模型的概率差异。训练过程需要同时维护可更新的训练模型和冻结的参考模型,通过批次数据处理和反向传播优化模型参数。该教程为开发者提供了完整的DPO训练技术实现方案。

翊歌 2010

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

MiniMind - 从0训练语言模型

一、关于 MiniMind 📌 项目包含 二、📌 Environment 三、📌 Quick Start Test 四、📌 Quick Start Train 0、克隆项目代码 1、环境安装 2、如果你需要自己训练 3、测试模型推理效果 五、📌 Data sources 1、分词器🤖 2、Pretrain数据 📙 3、SFT数据 📕 4、DPO数据 📘 5、更多数据集 6、数据集下载地址 六、模型📌 七、 Experiment 📌 训练完成的模型权重 八、Eval📌 1、RLHF篇

AI工程化、开源分享、文档翻译、代码笔记 9006

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

MiniMind:低成本、高效能,平民级大模型训练神器

MiniMind的核心目标是为广大开发者提供一种低成本、高效能的训练方式,通过优化算法和架构,使得即使在普通的计算机环境下,也能进行大模型训练。

DEVELOPERAA的博客 1487

【MiniMind】从零开始训练大模型:开源LLM实践指南

🔗GitHub 地址MiniMind 项目提供了从数据处理到训练、微调的完整流程,核心亮点包括:✔轻量级模型:基础版本参数量仅 25.8M,适合个人开发者。✔全流程开源:包含数据预处理、预训练、监督微调(SFT)、LoRA 微调、DPO(直接偏好优化)等完整代码。✔原生 PyTorch 实现:方便二次开发,深入理解 LLM 训练原理。✔支持多模态扩展:官方还推出了视觉语言模型 MiniMind-V!📢实际测试:使用 NVIDIA RTX 3090 训练 25.8M 规模模型,成本低至。

weixin_72708850的博客 1942

从零实践:个人电脑上26M小参数GPT的预训练、微调与推理全流程解析——MiniMind实战指南

本文详细解析了如何在个人电脑上从零开始实践一个26M参数GPT模型的完整流程。通过MiniMind项目,开发者可以亲手完成GPT预训练、监督微调(SFT)等核心步骤,深入理解Transformer架构与模型训练原理。项目还涵盖了知识蒸馏、RLHF/DPO和LoRA等进阶优化技术,是学习大模型技术的绝佳实践沙盒。

agile9scrum的博客 1079

2小时从零训练你的专属视觉语言模型:MiniMind-V终极指南

想要亲手打造一个能看懂图片、理解对话的AI助手吗?现在,你只需要2小时和3块钱成本,就能从零训练出一个65M参数的视觉语言模型!MiniMind-V这个开源项目让你轻松入门多模态AI世界,打造专属于你的个性化视觉语言模型。无论你是想构建医疗影像分析系统、电商商品描述生成器,还是教育内容问答助手,MiniMind-V都能为你提供完整的解决方案。 ## 🚀 为什么选择MiniMind-V? Mi

gitblog_01064的博客 943

3元2小时从0训练AI模型:MiniMind中英文对照实战指南

你是否曾因大语言模型(LLM)动辄数十亿的参数量望而却步?是否渴望亲手构建一个属于自己的AI模型,却被复杂的技术门槛和高昂的算力成本吓退?MiniMind项目将彻底改变这一现状——这个仅26M参数(GPT-3的1/7000)的超轻量级模型,让你用3元算力成本和2小时,就能从0到1完成训练。本文提供中英双语对照指南,带您快速掌握MiniMind的核心技术与实践方法。 ## 项目核心特性 Mini...

gitblog_00207的博客 1038

3小时从零训练64M参数大模型:MiniMind完全实战指南

你是否曾对大语言模型的复杂架构望而却步?是否觉得动辄数百亿参数的训练成本高不可攀?MiniMind项目为你提供了一个全新的解决方案——仅需3小时和不到3元成本,就能从零开始训练一个64M参数的轻量级语言模型。作为一款开源的大语言模型教学项目,MiniMind不仅展示了如何构建高效的小型模型,更提供了从预训练到强化学习的完整训练链路。 通过本指南,你将获得: - **完整的模型训练流程**:从数据

gitblog_00130的博客 384
上一篇: 谷歌解密生产级 AI Agents:从原型到落地的全栈技术指南
下一篇: LLaMA Factory 安装与配置指南:在 Ubuntu 上快速搭建大模型微调平台
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
