一文说清大模型微调的6种方法!零基础入门到精通,看这篇就够了!赶紧收藏!

Pytorch—模型微调(fine-tune) 对于不同的层可以设置不同的学习率,一般情况下建议,对于使用的原始数据做初始化的层设置的学习率要小于(一般可设置小于10倍)初始化的学习率,这样保证对于已经初始化的数据不会扭曲的过快,而使用初始化学习率的新层可以快速的收敛。 阅读详情

大模型预训练是一种在自然语言处理、计算机视觉等领域广泛应用的技术,以下是详细介绍:

1. 基本概念

**预训练模型:**是在大规模数据上进行无监督或自监督学习训练得到的模型。例如在自然语言处理中,像 BERT(Bidirectional Encoder Representations from Transformers)、GPT(Generative Pretrained Transformer)系列等都是典型的预训练模型。这些模型通过学习大量文本数据中的语言模式、语义信息和语法结构等知识,形成了对语言的深度理解能力。

**预训练过程:**在预训练阶段,模型会接触海量的数据。例如,GPT - 3 在预训练时使用了大量来自互联网的文本,包括新闻文章、博客、小说等多种来源,数据量达到了数千亿个单词。模型利用这些数据,通过设计好的训练目标(如语言模型的下一个单词预测任务),不断调整自身的参数,以学习数据中的特征和模式。

2. 预训练的目标

无监督学习目标

**【1】自回归任务:**在语言模型中,自回归任务的目标是根据文本序列的前面部分预测下一个单词或字符。例如,给定句子 “我喜欢吃苹果,因为它很___”,模型要预测出 “甜” 这个词。GPT 系列模型在预训练时就主要基于自回归任务,它通过不断预测下一个单词,学习文本的生成模式。

**【2】自监督任务:**以 BERT 为例,它采用了自监督学习中的掩码语言模型(Masked Language Model,MLM)和下一句预测(Next Sentence Prediction,NSP)任务。在 MLM 任务中,会随机掩盖输入文本中的一些单词,模型需要根据上下文来预测这些被掩盖的单词。对于 NSP 任务,模型需要判断给定的两个句子是否是相邻的句子,从而学习句子之间的语义关系。

监督学习目标(部分预训练采用)

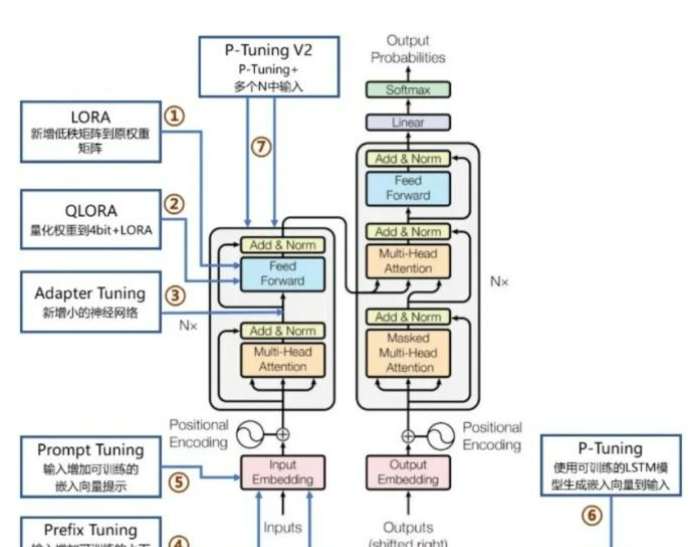
除了无监督和自监督任务外,也有一些预训练模型在训练初期或部分训练过程中采用监督学习目标。例如,在图像分类预训练中,如果已经有了一部分带有标签的图像数据(如 ImageNet 数据集,其中图像都有对应的类别标签),模型可以先基于这些有标签的数据进行监督学习,学习图像的特征和类别之间的映射关系。
img

3. 预训练的优势

**【1】学习通用特征:**大模型预训练能够使模型从海量数据中学习到通用的特征和模式。在自然语言处理中,这意味着模型可以掌握语言的基本语法、语义关系、常见的表达方式等。对于不同的下游任务,如文本分类、情感分析、机器翻译等,这些通用特征都可以作为基础,帮助模型更快更好地适应任务。

**【2】提升性能和效率:**当在特定的下游任务上对预训练模型进行微调(Fine - tuning)或直接应用(如在某些任务中直接使用预训练语言模型的特征表示)时,由于模型已经具备了丰富的先验知识,往往可以用较少的数据和较短的训练时间获得较好的性能。例如,在文本分类任务中,使用预训练的 BERT 模型进行微调,相比从零开始训练一个模型,不仅可以在准确率上有显著提升,而且训练时间也会大大缩短。

4. 预训练数据的重要性

**【1】数据规模:**数据的规模对于预训练模型的性能至关重要。一般来说,数据量越大,模型能够学习到的特征和模式就越丰富。例如,随着 GPT 系列模型的发展,从 GPT - 1 到 GPT - 3,数据量不断增加,模型的能力也在不断提升,能够处理的任务类型和复杂度也在不断扩大。

**【2】数据多样性:**除了规模,数据的多样性也很关键。多样化的数据包括不同的主题、文体、语言风格、数据来源等。在自然语言处理中,如果预训练数据只包含新闻文章,那么模型对于小说、学术论文等其他文体的理解能力就会受限。因此,像百科全书、博客、社交媒体文本、文学作品等多种来源的数据都被纳入预训练数据中,以提高模型对各种语言环境的适应能力。

5. 预训练的挑战

**【1】计算资源需求:**预训练大模型需要大量的计算资源,包括高性能的 GPU 集群、大量的内存和存储设备。例如,训练 GPT - 3 需要数千个 GPU 同时运行数周甚至数月,这不仅需要高昂的硬件成本,还需要高效的计算集群管理和调度能力。

**【2】数据质量和偏差问题:**数据质量会直接影响预训练模型的质量。如果数据中存在错误信息、噪声或恶意数据,可能会导致模型学习到错误的知识。此外,数据的偏差也会给模型带来问题。例如,如果预训练数据中大部分内容来自某一特定地区或文化背景,那么模型在处理其他地区或文化背景相关内容时可能会出现偏差或误解。

**【3】模型过拟合和泛化问题:**尽管预训练模型接触的数据量很大,但仍然可能存在过拟合的风险。当模型过于复杂且数据存在一定局限性时,模型可能会过度拟合预训练数据中的某些特征,而在面对新的数据或任务时无法很好地泛化。这就需要在预训练和后续的微调或应用过程中,通过优化模型结构、调整训练策略等方式来解决。

大模型微调的方法主要有以下几种:

一、全量微调(Full Fine-tuning)

【1】原理:在预训练的大型模型基础上,对模型的所有层和参数进行调整,使其适应特定任务。在这个过程中,模型会根据特定任务的数据重新学习和更新所有的权重参数,以达到更好地完成该任务的目的。

【2】优点:因为对模型的所有参数进行了调整,所以可以充分利用预训练模型的通用特征,能够较好地适应特定任务,在一些情况下可以获得较高的性能表现。例如,在图像分类任务中,如果有足够的计算资源和数据,全量微调可以使模型对特定类别的识别准确率大幅提高。

【3】缺点:计算成本较高,需要大量的计算资源和时间来训练模型,尤其是对于非常大的模型。而且,如果特定任务的数据量较少,可能会导致过拟合的问题。

二、基于适配器(Adapter)的微调

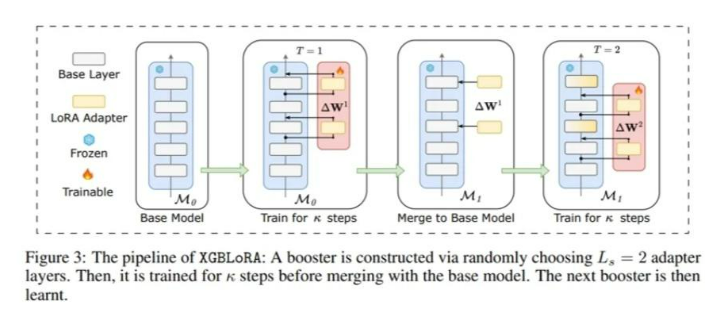
【1】原理:在预训练模型的每一层(或某些层)中添加适配器模块,微调时冻结预训练模型主体,由适配器模块学习特定下游任务的知识。每个适配器模块由两个前馈子层组成,第一个前馈子层将模型的输出作为输入,将原始输入维度投影到一个较小的维度,第二个前馈子层再将其还原到原始输入维度作为输出。

【2】优点:只需要训练少量的特定于任务的参数,大大降低了训练的计算成本和存储需求。同时,由于预训练模型的主体被冻结,保留了预训练模型的大部分知识,能够快速适应新的任务。

【3】缺点:增加了模型的复杂性,可能会在一定程度上影响模型的推理速度。而且,如果适配器模块的设计不合理,可能无法充分发挥预训练模型的性能。
img

三、基于低秩适应(LoRA)的微调

【1】原理:冻结预训练模型的矩阵参数,并引入额外的低秩矩阵来替代模型权重的变化。在下游任务时只更新这些低秩矩阵的参数,而保持预训练模型的大部分参数不变。通过这种方式,模型可以在不改变原始模型结构的情况下,快速适应新的任务。

【2】优点:显著减少了需要训练的参数数量,降低了计算资源的需求,同时能够保持较高的性能。与全量微调相比,训练速度更快,更适合在计算资源有限的情况下进行模型微调。

【3】缺点:低秩假设可能并不完全适用于所有的任务和模型,在某些情况下可能无法达到与全量微调相当的性能。

四、基于提示学习(Prompt Tuning)的微调

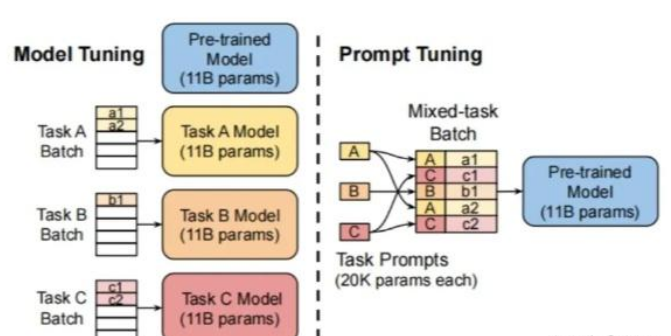
【1】原理:通过在输入文本中添加提示信息,引导模型更好地理解任务,并根据提示信息进行预测。提示信息可以是一些特定的文本片段、关键词或者问题模板等,其目的是将下游任务转化为与预训练模型的预训练任务相似的形式,以便模型能够更好地利用预训练的知识。

【2】优点:不需要对模型的结构进行修改,只需要在输入层进行操作,因此非常简单方便。同时,提示学习可以灵活地应用于各种不同的任务,具有较强的通用性。

【3】缺点:提示的设计需要一定的经验和技巧,不同的提示可能会对模型的性能产生较大的影响。而且,如果提示信息与模型的预训练知识不匹配,可能会导致性能下降。
img

五、基于模型蒸馏(Model Distillation)的微调

【1】原理:训练一个小的学生模型来模拟大的老师模型。首先使用大量的数据训练一个大型的预训练模型(老师模型),然后使用老师模型的输出作为监督信号,来训练一个较小的学生模型。在训练过程中,学生模型学习老师模型的行为和预测结果,从而在保持较高性能的同时,降低模型的复杂度和计算成本。

【2】优点:可以大大降低模型的计算成本和存储需求,同时能够保持较高的性能。对于一些资源受限的场景,如移动设备或嵌入式系统,模型蒸馏是一种非常有效的方法。

【3】缺点:训练过程相对复杂,需要先训练一个大型的老师模型,然后再训练学生模型。而且,如果老师模型的性能不够好,或者学生模型的结构设计不合理,可能会导致性能下降。

六、基于动态预测加速的微调

【1】原理:利用一些技巧减少在预测时花费的时间,例如动态地选择模型的部分层进行计算,或者根据输入数据的特点自适应地调整模型的计算策略等1。

【2】优点:可以在不影响模型性能的前提下,提高模型的预测速度,对于一些对实时性要求较高的应用场景非常重要。

【3】缺点:需要对模型的结构和计算流程进行深入的理解和优化,实现起来相对复杂,而且可能需要根据不同的模型和任务进行定制化的开发。

如何学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

read-normal-img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

【大模型】模型微调(非常详细)从入门到精通,看这一篇就够了 本文结合示例简单讨论如何使用LoRA微调 (FT) 预训练的 LLM。LoRA原理将在接下来的文章里详细讨论。 阅读详情

相关推荐

大模型微调的几种常见方法

在文章《深入理解大语言模型微调技术》中,我们详细了解大语言模型微调的概念和训练过程,本篇给大家介绍大模型微调常见的7种训练方法。

产品老A,8年互联网大厂AIPM,专注探索新型人机交互 1万+

【大模型微调】一文掌握7种大模型微调的方法

本篇文章深入分析了大型模型微调的基本理念和多样化技术,细致介绍了LoRA、适配器调整(Adapter Tuning)、前缀调整(Prefix Tuning)等多个微调方法。详细讨论了每一种策略的基本原则、主要优点以及适宜应用场景,使得读者可以依据特定的应用要求和计算资源限制,挑选最适合的微调方案。大型语言模型(LLM)的训练过程通常分为两大阶段:阶段一:预训练阶段在这个阶段,大型模型会在大规模的无标签数据集上接受训练,目标是使模型掌握语言的统计特征和基础知识。

python123456_的博客 5万+

RK3576+IMX415 MIPI摄像头零拷贝显示系统

MIPI CSI-2是嵌入式视觉系统中主流的高速图像传感器接口标准,其核心价值在于低延迟、高带宽与硬件级DMA直通能力。基于V4L2子系统与DRM/KMS驱动栈,可构建从传感器RAW数据到帧缓冲区的零拷贝通路,显著降低CPU负载并提升实时性。该技术广泛应用于工业检测、边缘AI推理前数据接入及多路同步采集等场景。本文以Rockchip RK3576 SoC和索尼IMX415传感器为典型组合,详解MIPI物理层适配、内核驱动集成、GStreamer零拷贝管道搭建及systemd服务化部署,覆盖从硬件信号完整性到

weixin_36047538的博客 217

一文讲解:模型微调(fine-tune)

对于图片来说,我们CNN的前几层学习到的都是低级的特征,比如,点、线、面,这些低级的特征对于任何图片来说都是可以抽象出来的,所以我们将他作为通用数据,只微调这些低级特征组合起来的高级特征即可,例如,这些点、线、面,组成的是园还是椭圆,还是正方形,这些代表的含义是我们需要后面训练出来的。此时,模型的最后一层大小并不是预想的,因此需要获取输入到最后一层全连接层之前的维度大小,然后根据数据集的类别数来指定最后输出的out_features数目,以此代替原来的全连接层。数据多,数据类似程度高:这是最理想的情况。

Python栈 4655

GB28181安防平台未授权访问漏洞:原理、复现与修复指南

未授权访问漏洞是Web安全中常见的访问控制缺陷,其本质在于应用在提供对敏感功能或数据的访问前,未能对请求者的身份和权限进行充分验证。从技术原理上看,这类漏洞常源于拦截器配置错误、安全注解遗漏或自定义校验逻辑缺陷,导致本应受保护的API接口被意外暴露。在工程实践中,此类漏洞危害巨大,攻击者无需登录即可直接访问系统核心接口,可能引发敏感信息泄露、权限提升甚至系统接管。尤其在安防监控、物联网管理平台等场景中,一旦涉及用户管理接口(如`/api/user/**`),风险会急剧放大。本文以GB28181视频监控管理平

weixin_30271335的博客 438

Xilinx FPGA MultiBoot实战:7Series与UltraScale的SPI Fallback配置详解

本文深入解析了Xilinx FPGA的MultiBoot(多启动)与Fallback(回退)功能,针对7系列与UltraScale/UltraScale+系列,提供了从约束文件编写、看门狗集成到镜像烧录的完整实战配置指南。文章重点对比了两个系列在SPI Fallback配置上的关键差异与注意事项,旨在帮助工程师构建高可靠、永不宕机的FPGA系统。

weixin_29197051的博客 547

模型微调(fine-tune)

模型微调(fine-tune)

爱敲代码的狼仔 6277

(二)目标检测之 HOG+SVM 算法

文章目录一、概述二、方法概述三、积分图四、AdaBoost五、级联检测六、结果七、复现八、总结参考资料 一、概述   梯度直方图HOG(Histogram of Oriented Gradients)是法国人Dalal在2005年CVPR会议上提出的特征提取算法,并将其与 SVM 配合,用于行人检测。论文地址:Histograms of oriented gradients for human detection HOG有个优点,提取的边缘和梯度特征能很好的抓住局部形状的特点,且因是对图像做了Gamma

天青如水的博客 1万+

一文彻底搞懂大模型微调

大模型微调(Fine-tuning)是指基于预训练的大型语言模型(如GPT、BERT等),通过特定领域或任务的数据进行二次训练,使模型适应具体应用场景的技术过程。与从零开始训练相比,微调能够以较低成本实现模型的领域适配,是AI大模型落地应用的核心技术路径。

2501_91381485的博客 5226

【以太网硬件六】1000base-T物理层编码究竟是怎么编的?

详述1000base-T物理层4D-PAM5的编码过程

highman110的博客 5324

【x265编码器】章节1——x265的lookahead模块分析

目录一、模块功能二、lookahead模块分析1.调用流程2.代码分析Lookahead::addPicture()Lookahead::checkLookaheadQueue()Lookahead::getDecidedPicture()Lookahead::findJob()Lookahead::slicetypeDecide()PreLookaheadGroup::processTasksLookaheadTLD::lowresIntraEstimate()Lookahead::slicetypeAn

vcvdv123的博客 4万+

【2024最新】深入了解 大语言模型(LLM)微调方法(总结)

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。即更新模型所有权重的过程,被称为全微调。需要注意的是,与预训练一样,全微调需要足够的内存和计算预算来存储和处理训练过程中的所有梯度、优化器和其他更新组件。其中,大模型微调技术在此过程中起到了非常关键的作用,它提升了模型的生成效率和适应性,使其能够在多样化的应用场景中发挥更大的价值。

m0_48891301的博客 3860

基于 Qt C++ 的金融行情交易终端

由于完整的商业级源码非常庞大,我将为你提供一个 **结构完整、可直接编译运行的基础框架**,并详细说明各模块的实现思路和扩展方向。double波动 = quote.lastPrice * (rand()%200 - 100) / 10000.0;// 订单缓存(orderId -> Order)

寒寒豆豆软件公司的博客 191

大模型微调方法综述

保存时只需要为每个任务保存重参数的结果即可。

lovely_yoshino的博客 2万+

Vibe Writing 手把手教程:Obsidian + Claudian + Skill

本文介绍了Vibe Writing的实操教程,主要使用Obsidian+Claudian+Skill组合。教程包含工具安装配置(Obsidian、Claudian插件)、核心工作流(选题-调研-写作-发布)和效果对比。重点展示了Claude Code生成的文本更具"人味"和场景感,优于其他AI工具。作者强调工具只是辅助,内容灵魂仍需个人思考积累。附有公众号排版和全网发布工具推荐,以及自动配图生成方案。

299

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

模型微调微调:了解如何将

作者:禅与计算机程序设计艺术 模型微调微调:了解如何将机器学习模型优化到更高的性能 作为一名人工智能专家,模型微调微调是一个非常重要的技术,它可以帮助我们构建更高效的机器学习模型,从而提高我们的预测准确性和数据处理速度。在本文中,我们将深入探讨模型微调微调的

AI天才研究院 7866

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

总结!大模型微调(Tuning)的常见方法

作者:爱吃牛油果的璐璐,北京大学 电子与通信工程硕士,推荐广告从业者编辑:青稞AI前言微调是指调整大型语言模型(LLM)的参数以适应特定任务的过程。这是通过在与任务相关的数据集上训练模型来完成的。所需的微调量取决于任务的复杂性和数据集的大小。在深度学习中,微调是一种重要的技术,用于改进预训练模型的性能。除了微调ChatGPT之外,还有许多其他预训练模型可以进行微调。快来!NLP论文投稿、LLM交流...

zenRRan的博客 3855

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

【AI大模型】一文搞懂模型微调Fine-tuning,适合零基础小白收藏!!

本文将从微调的本质、微调的原理、微调的应用三个方面,带您一文搞懂模型微调 Fine-tuning 。

bugyinyin的博客 1274

一文详解:8种常见的大模型微调方法,看这篇就够了!

P-Tuning v2是P-Tuning的进一步改进版,在P-Tuning中,连续提示被插入到输入序列的嵌入层中,除了语言模型的输入层,其他层的提示嵌入都来自于上一层。这种方法的优势在于不需要调整模型的所有权重,而是通过在输入中添加前缀来调整模型的行为,从而节省大量的计算资源,同时使得单一模型能够适应多种不同的任务。与传统的微调范式不同,前缀调整提出了一种新的策略,即在预训练的语言模型(LM)输入序列前添加可训练、任务特定的前缀,从而实现针对不同任务的微调。

javatiange的博客 2780

什么是大模型微调?如何对大模型进行微调?大模型入门到精通,收藏这篇就够了

从GPT-3到ChatGPT,再到GPT-4和GitHub Copilot,微调在这些过程中发挥了重要作用。什么是微调?微调能解决哪些问题?LoRA又是什么?如何进行微调?本文将解答上述问题,并通过代码示例展示如何使用LoRA进行微调。微调的技术门槛不高,对于规模不超过100亿参数的模型,所需的硬件成本也不高(100亿参数的模型并非玩具,许多实际应用中会使用这种规模的模型)。即使是非专业的算法人员,也可以尝试微调自己的模型。除了ChatGPT和GitHub Copilot,微调还可以应用于许多其他领域。

Python单行客的博客 1823

关于大模型微调,你想知道的都在这里了

感性理解:大模型微调指的是“喂”给模型更多信息,对模型的特定功能进行 “调教”,即通过输入特定领域的数据集,让其学习这个领域的知识,从而让 大模型能够更好的完成特定领域的NLP任务,例如情感分析、命名实体识别、文本分类、对话聊天等;微调并不是大模型领域独有的概念,而是伴随着深度学习技术发展,自然诞生的一个技术分支,旨在能够有针对性的调整深度学习模型的参数(或者模型结构),从而能够使得其更佳高效的执行某些特定任务,而不用重复训练模型;

yulingzheng的博客 1万+

大模型~合集2

更奇怪的是,Battle 发现,如果为模型提供正向的 prompt,比如「这会很有趣」或「你和 ChatGPT 一样聪明」,有时候模型的性能也会提升。该工具可以自动改进简单的输入 prompt,比如「骑马的男孩」,从而得到更好的图像。这里也一样,自动生成的 prompt 的表现优于人类专家给出的 prompt(用作起点),至少根据 PickScore 指标是这样的。「你就坐在那里,试图找到单词的某种神奇组合,从而让你的模型在你的任务上得到最佳的可能表现。」Henley 说,「难的是将其产品化。 whao

whaosoft143ai的博客 888

模型微调(fine-tuning)

微调,就是基于预训练模型进行微调,比如用大型数据集Imagenet训练好的resnet,再在自己的数据集上训练一部分靠近输出的层,使之更加适用于自己的问题。预训练模型的数据集与自己的数据集相似,但自己的数据集太少计算资源不够是否微调以及微调的方法要根据自己的数据集大小、数据集与预训练模型数据集的相似程度来选择。数据量少,相似度高修改最后几层;数据量少,相似度低保留预训练模型的前几层,训练后面的层;数据量大,相似度高这是最理想的情况。使用预训练的权重初始化模型,重新训练整个模型;...

年少的勇气已经用完,剩下的就是三思而后行 3007

大模型入门指南 - Fine-tuning:小白也能看懂的“模型微调”全解析

你是否感到疑惑:为什么AI能够与你探讨哲学、创作科幻故事,然而在处理财报中隐藏于正常数据下的债务危机,或是剖析法律条款中错综复杂的侵权陷阱时,却无法给出完全精准的答案,如同一位知识面广泛却并非专精的优等生?实际上,这就好比一位全能型学霸,尽管学识渊博,但在面对特定学科的难题时仍需查漏补缺,而模型微调(Fine-tuning)正是让AI实现精准“查漏补缺”的关键技术。

youmaob的博客 1681

大模型微调是什么?有什么用?

大模型微调是指在已经训练好的大规模预训练模型的基础上,针对特定的任务或数据集,对模型的参数进行少量的调整和优化。Qwen2是通义千问团队最近开源的大语言模型, 以Qwen2作为基座大模型,通过指令微调的方式做高精度的命名实体识别(NER),入门学习LLM微调、建立对大模型微调的认知。命名实体识别(Named Entity Recognition,简称 NER)是自然语言处理中的一项重要任务。其主要目的是从文本中识别出具有特定意义的实体,这些实体可以包括人名、地名、组织机构名、时间、日期、货币金额等。

h1453586413的博客 3290

大家都在说的AI大模型微调到底是什么?最易懂的AI知识科普!为你解决对“微调”所有的疑问

chatgpt说:模型微调(Model Fine-tuning)是指在已经训练好的模型基础上,针对特定任务或数据集进行调整,以获得更好的性能。通常情况下,模型微调是在预训练模型的基础上完成的,它可以提高模型在新任务或新数据集上的表现。举个例子,如下图,一个与训练出来的什么都会的小羊驼(大语言模型),又通过FineTuning微调,学习了到专业的知识和背景(领域知识),于是它变成了一个领域专家(行业大语言模型)微调,翻译自Fine tuning,简称FT,也被很多人称为“精调”。

python1234_的博客 2796
上一篇: 深入浅出大模型:预训练、监督微调、强化学习、RLHF
下一篇: 今年读过最绝的一本大模型书,读完你就是 LLM 大师!
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值