大模型瓶颈之——大模型长文本处理问题以及解决方案

主流大模型上下文窗口限制与多轮对话机制解析 建议将复杂任务分配给高性价比模型(如DeepSeek处理长文本,GPT-4处理逻辑推理),通过混合调用策略平衡成本与效果。多轮对话的Token消耗遵循。 阅读详情
AI摘要

博客介绍了大模型长文本处理问题,如上下文限制、长距离依赖等,给出分块处理、稀疏注意力机制等解决方案。还分享了全套AGI大模型学习大纲与路线,以及640套AI大模型报告合集,上传至优快云可免费领取,助于掌握大模型应用开发技能。

“大模型长文本处理,是大模型性能评价标准之一”

正如大家所知道的那样,大模型上下文窗口是有限制的,而上下文窗口大小是大模型的评价标准之一,越强大的大模型越有着更长的上下文窗口。

而传说谷歌推出的Gemini 1.5 Pro模型将上下文长度刷新到了100万token,创下了最长上下文窗口的记录。

那么大模型窗口上下文长度有哪些难点和问题,以及都是怎么解决的?

01

—

大模型长文本处理问题

在现有的大模型体系中,上下文窗口是一个很重要的评判标准,越长的上下文窗口意味着越强的性能;但同时,当上下文长度超过一定界限之后,大模型的性能会呈现断崖式下降。

当上下文长度达到一定限度之后,不论是大模型的输出质量,还是响应速度都会受到极大的影响。

其实上下文窗口问题说到底就是大模型的长文本处理问题,在大模型处理长文本问题时,面临着多个技术难点和问题。

上下文限制

问题

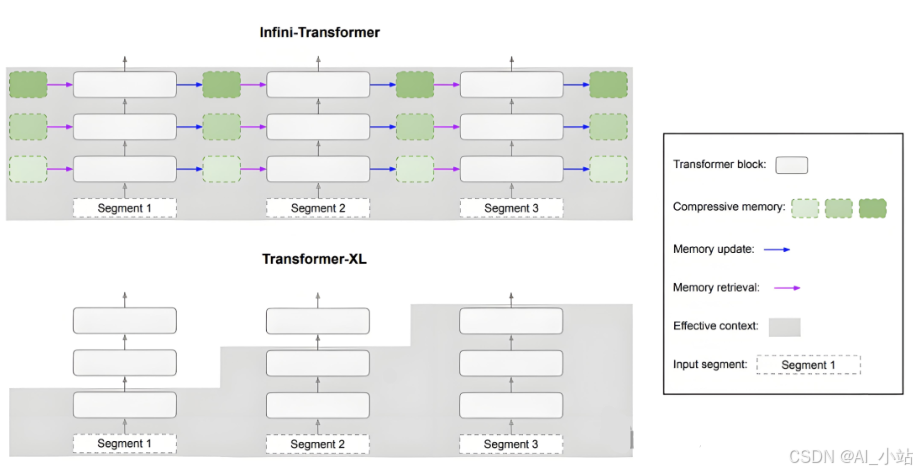
上下文窗口大小:大模型通常拥有一个固定的上下文窗口大小,这限制了模型能够同时处理的文本长度;当文本超出限制时,模型可能无法保持上下文的一致性和连贯性。
在这里插入图片描述

解决方案

分块处理:将长文本分成多个块进行处理,每个块大小在上下文窗口内;然后将处理结果合并或通过某种方法连接。

滑动窗口机制:使用滑动窗口技术逐步处理文本,将当前窗口中的内容与前一个窗口的内容进行结合,以保持上下文。

改进的上下文机制:引入像Transformer-XL和Reformer这样的模型,这些模型通过引入相对位置编码和记忆机制来扩展上下文长度。

长距离依赖

问题

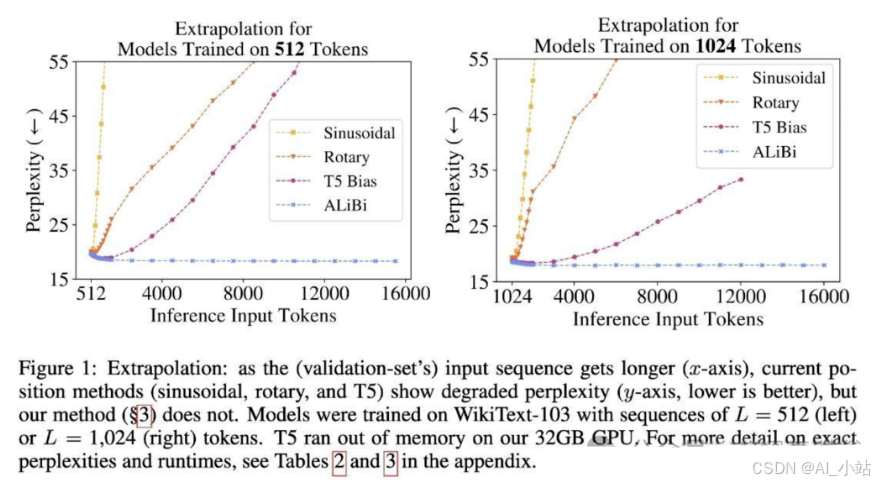
长距离依赖:在长文本中,重要信息可能在文本的开始部分或中间部分,而当前的自注意力机制可能难以有效捕捉这些长距离的依赖关系。

解决方案

稀疏注意力机制:采用稀疏注意力机制(如Longformer, Big Bird),这些机制通过减少计算复杂度来处理长文本,并能有效捕捉长距离的依赖关系。

分层注意力机制:引入分层注意力机制(如Linformer),通过减少计算复杂度和调整注意力层的结构来提高对长文本的处理能力。
在这里插入图片描述

计算与内存开销

问题

计算复杂度:长文本会显著增加计算和内存开销,特别是在训练阶段,计算复杂度和内存需求是平方级别的。

内存消耗:处理长文本时,需要大量的内存来存储模型参数和中间计算结果。

解决方案

模型压缩:通过模型剪枝,量化和知识蒸馏等技术来减少模型的计算和内存需求。

分布式计算:利用分布式计算资源(如GPU集群,TPU)来处理长文本和大模型训练,提高计算效率和内存处理能力。

生成质量

问题

生成连贯性:在生成长文本时,保持文本的连贯性和一致性是一个挑战,特别是在长段落或章节中。

信息重复:长文本生成过程中可能会出现信息重复或冗余的问题。

解决方案

后处理和校正:使用文本生成的后处理技术来检测和修正重复信息,提高文本的连贯性。

生成策略优化:调整生成策略,如使用束搜索,温度控制和顶级采样等技术,来优化生成质量。

上下文更新和记忆

问题

上下文更新:在处理长文本时,如何有效地更新和维持上下文信息,特别是对长篇文章的多轮生成。

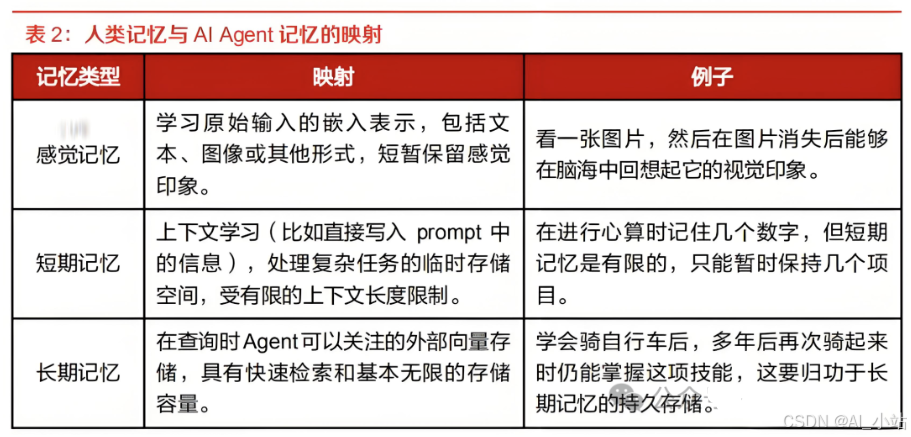
记忆机制:传统的Transformer模型没有内置记忆机制,导致在处理超长文本时,记忆能力有限。
在这里插入图片描述

解决方案

记忆增强机制:使用增强的记忆网络(如Transformer-XL)来保持长距离的信息,这些模型引入了持久的记忆机制,用于处理长期依赖。

交互式生成:在生成过程中逐步引入新的上下文信息,并结合之前的生成结果,进行连续的内容生成和更新。

任务适应性

问题

任务特定性:不同任务(如文章生成,对话生成,摘要等)对长文本的处理需求不同,模型需要适应这些特定任务的要求。

解决方案

任务特定微调:在特定任务的数据集上进行微调,以优化模型在特定任务上的表现。

适配模块:引入适配模块(如领域特定的提示或模板),帮助模型更好地适应不同类型的长文本生成任务。

数据质量和多样性

问题

数据质量:长文本的生成依赖于训练数据的质量,如果数据质量较差,生成的长文本可能不够准确或有偏差。

数据多样性:训练数据的多样性影响模型的生成能力,如果数据中缺乏多样性,模型可能在处理某些类型的长文本时表现不佳。

解决方案

数据增强:通过数据增强技术扩充训练数据的多样性,提高模型的生成能力。

数据清洗:对训练数据进行清洗和预处理,以提高数据质量,从而改善生成结果的准确性和可靠性。

如何学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

大模型处理长上下文方法一览 2023年中开始,各大LLM厂商开始关注到长上下文的问题。2023年5月,Claude把长度支持到100k tokens;6、7月的时候,ChatGPT3.5也已经支持16k,而ChatGLM2-B最大长度已经可以到32k。(插一句,ChatGLM系列做得一直很不错,从基础模型、长窗口、工具调用、Agent都一直保持在比较前沿的水平,个人最近用ChatGLM3、ChatGLM4体验还是很不错的)差不多同时间还有LM-SYS的LongChat,MosaicLM的MPT也支持16k以及更长的上下文。 阅读详情

相关推荐

突破LLM的token限制:多块上下文保留的实用系统(含code)

大语言模型(LLMs)取得了令人瞩目的进展,已广泛应用于文本生成、翻译、问答等诸多场景。然而,LLMs存在的一些局限性,如有限的上下文窗口(令牌限制)和缺乏长期记忆,限制了其在处理复杂任务时的表现。本文将深入探讨一种实用的解决方案,旨在克服这些限制,提升LLMs的性能。

llm_way的博客 1319

大模型长文本处理问题以及解决方案

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

m0_56255097的博客 5804

避坑指南:用Ollama本地大模型做批量翻译时遇到的5个典型问题(Python版)

本文分享了使用Ollama本地大模型进行批量翻译时常见的5个问题及解决方案,包括长文本分割、特殊符号处理、流式输出中断等。通过Python代码示例和优化策略,帮助开发者提升翻译质量和效率,特别适合处理技术文档等复杂内容。

weixin_30576827的博客 418

为什么大语言模型都有上下文限制?

然而,计算量只是第一道门槛,紧接着迎来的是内存瓶颈。按常见的 16 位浮点精度估算,1 个 token 约占用 1 KB,若支持 10 万 token 的上下文,仅存储输入就要吃掉近 100 GB 显存。更长的上下文意味着更高的延迟与成本——在按 token 计费的商业模式里,用户每多输入 1 000 tokens,就要为算力和显存多付一次钱;在与大语言模型交互时,许多用户都会遇到这样的困惑:当对话或文档输入过长时,模型会出现 “失忆” 现象,要么忽略早期信息,要么生成逻辑混乱的内容。

2501_92849183的博客 1526

AgentWrite大模型长文本生成技术

AgentWrite的本质是将创作转化为可管理的生产过程:规划→分段生成→质量管控。其价值不仅在于突破技术瓶颈。

技术引领业务创新 1191

AI大模型算力瓶颈解析:从Kimi事件看长文本处理优化方案

AI大模型算力需求是当前人工智能技术落地的核心挑战。从技术原理看,大模型推理需要大量GPU显存支持,特别是长文本处理场景下,显存占用和计算复杂度呈指数级增长。在工程实践中,合理的算力规划直接影响服务稳定性和成本控制。通过动态资源调度、模型优化等架构方案,可以有效提升资源利用率。以Kimi智能助手的长文本处理为例,200万字上下文需要40GB+显存容量,这凸显了AI服务在面临用户爆发式增长时的算力供给难题。本文基于实际案例分析,为开发者提供从算力需求评估到弹性架构设计的完整解决方案,帮助应对类似的技术挑战。

weixin_29092579的博客 233

大模型核心问题全解析:从激活函数到训练实战

Causal LM 仅依赖前文,专注生成任务,工程实现简单;Prefix LM 可利用前缀双向上下文,兼顾理解与生成能力,灵活性更强,但模型结构与训练复杂度更高。

ppbk_的博客 1029

大模型提示工程:硬件加速如何应对长文本处理挑战

我们每天都会遇到长文本:写论文时需要总结几十篇文献、做法律分析时要读几百页合同、甚至想让AI帮你梳理一本小说的情节。但大模型(比如GPT-3、Llama 2)处理长文本时,总会“掉链子”——要么直接截断前面的内容,要么回答得前言不搭后语,要么处理时间长得让人崩溃。长文本到底给大模型带来了哪些挑战?提示工程(比如“怎么给模型发指令”)能解决哪些问题?硬件加速(比如GPU、TPU)能给模型“补哪些短板”?两者结合如何让大模型“读懂厚书”?用“超级大脑读厚书”的故事,引出长文本挑战的本质;

大数据洞察的博客 802

为什么你的大模型越跑越慢?(性能退化根源深度剖析)

掌握大模型应用性能调优关键方法,解决推理延迟高、响应变慢难题。涵盖负载优化、缓存策略与计算资源分配,适用于生成式AI服务、企业级模型部署场景。深度剖析性能退化根源,提升系统稳定性与吞吐量,值得收藏。

IterLoom的博客 992

CCS TMSC6748 报错Error connecting to the target: (Error -600 @ 0x0)

CCS TMSC6748 报错Error connecting to the target:(Error -600@ 0x0)

AS_the_deer1717的博客 6636

2025ICPC南昌邀请赛题解

2025ICPC南昌邀请赛由XDU和WHU联合出题的ICPC南昌邀请赛,榜单显示8题金、6题银、5题铜。

weixin_50089904的博客 1958

Qwen3-4B避坑指南:vLLM部署常见问题解决方案

本文介绍了基于星图GPU平台自动化部署Qwen3-4B-Instruct-2507镜像的实践方法,重点解决vLLM部署中的显存优化、服务连接与长文本处理等常见问题。该镜像适用于本地化AI应用开发,如智能对话系统构建,支持高并发低延迟推理,助力开发者高效实现模型微调与服务上线。

weixin_36235398的博客 492

储能变流器(Power Control System——PCS)设计原理

储能变流器(Power Control System——PCS)可控制蓄电池的充电和放电过程,进行交直流的变换,在无电网情况下可以直接为交流负荷供电。PCS 由 DC/AC 双向变流器、控制单元等构成。PCS 控制器通过通讯接收后台控制指令,根据功率指令的符号及大小控制变流器对电池进行充电或放电,实现对电网有功功率及无功功率的调节。 PCS 控制器通过 CAN 接口与 BMS 通讯,获取电池组状态信息,可实现对电池的保护性充放电,确保电池运行安全。   储能变流器(PCS)可控制蓄电池的充电和放电过程,进

Zhouengineer的博客 5万+

字节跳动AHN-GDN模型:突破大模型长文本处理瓶颈的终极解决方案

🚀 字节跳动最新发布的AHN-GDN(Artificial Hippocampus Networks with GatedDeltaNet)模型,为大语言模型的长文本处理能力带来了革命性突破!这个基于Qwen2.5-3B-Instruct的创新架构,成功解决了传统Transformer在处理超长序列时面临的计算瓶颈问题。 ## 🔍 什么是AHN-GDN模型? AHN-GDN是一种人工海马体

gitblog_00983的博客 982

实验四 基于IDEA+SpringBoot+Maven+Thymeleaf的系统实现实验目的

通过这次实验,我学习了如何成功进行IDEA+SpringBoot+maven的系统实现,搭建好IDEA+SpringBoot+maven的系统环境,成功地安装并配置了maven的运行环境,学会了创建springboot的三种方式,并且能将之前的实验结合起来运用。pom.xml中引入thymeleaf依赖,在classpath:/templates/下新建HTML页面(可采用实验一创建的页面),新建controller进行测试,访问页面后返回success成功数据。同时掌握和thymeleaf的基本语法。

m0_73502929的博客 1379

Orbbec-Gemini-335 深度相机 Python SDK 编译与配置全记录(Windows 环境)

本篇博客将围绕 Windows 系统下 Orbbec SDK 的 Python 配置与编译过程进行详细说明,主要使用的是官方提供的 pyorbbecsdk Python wrapper 项目以及 Orbbec SDK V2 Python Wrapper 配置指南,并记录了安装与配置过程中遇到的若干问题及解决办法。

Junseer的博客 1965

效率跃升!分片处理技术实现大模型长文本处理速度倍增

申请人:百度在线网络技术(北京)有限公司 | 申请号:CN202411640368.4 | 申请日:2024.11.15 | 发明创造名称:基于大模型的文本处理方法、装置、电子设备和存储介质。通过分片处理与动态资源优化,该技术为长文本处理任务提供了高性价比的解决方案,开发者可通过开源代码快速验证,企业用户可基于商业SDK构建定制化流水线。支持Apache 2.0/MIT开源协议,允许企业免费集成至私有化部署系统,商业应用需遵循API调用次数授权规则。,解决大模型处理超长文本时的响应延迟与超时报错问题。

mobingyu的博客 1009

TC8:SOMEIPSRV_SD_MESSAGE_07-09

TTL为服务实例的生命周期。在此生命周期之后,不提供服务实例。

jasonj333 908

Selective Context:上下文压缩神器,突破 LLM 长文本处理瓶颈

Selective Context 完成压缩的核心技术在于自信息测量。在信息论中,自信息衡量与一个事件相关的惊讶或不确定性水平;罕见事件传递更多信息,因此具有更高的自信息,而常见事件传递较少信息,自信息较低。在语言建模中,自信息可以用来评估词汇单元(如单词、短语或句子)的信息量。自信息较低的词汇单元信息量较少,更可能从上下文中推断出来,因此在 LLM 推理过程中,这些输入部分可以被视为冗余。

ck_reboot的博客 2253

innovus:ccopt_design流程

我正在「拾陆楼」和朋友们讨论有趣的话题,你⼀起来吧?spec文件可以只创建一次,无需多次创建。2)virtual balance阶段。3)Full Balancing阶段。4)Clock Routing阶段。1)clustering阶段。

m0_61544122的博客 2477

HSM 网络安全 信息安全

HSM HSM信息安全功能 汽车电子网络安全中HSM 的应用场景 选择适合汽车电子网络安全的 HSM 符合汽车安全标准和法规要求的HSM HSM 在汽车电子网络安全中的可靠性和安全性 评估汽车电子网络的安全性 汽车 HSM(Hardware Security Module)模块开发 汽车 HSM(Hardware Security Module)模块测试

天赐好车的博客 1238

大模型长文本处理瓶颈怎么破?TaoToken统一通道下的分块与检索方案

长文本处理卡在显存与首字延迟?本文给出TaoToken统一通道下分块、检索、流式调用的可复制配置,含800-1000 token分块函数、混合召回重排与压测脚本,并附401、local proxy failed等报错排查表。一个Key切换模型,官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 即可落地大模型长文本处理解决方案。

weixin_35754676的博客 5

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

大模型处理长文本有哪些技术难点?

当大语言模型遇上长文本处理,一场关于“理解力”的技术较量正在上演。GPT-4o的上下文窗口达到12.8万个token,Kimi更是突破200万token,但窗口越大,算力消耗就越高,响应延迟越明显。更棘手的是,即便模型能“吞下”海量文本,也未必能真正“消化”——上下文衰减、信息过载、文本解析错误等连锁问题,正让企业的AI应用陷入“看得多却答不准”的尴尬境地。TextIn xParse作为专业文本解析引擎,正是瞄准这些技术瓶颈,为大模型提供高质量的“可理解”数据输入。

TextIn智能文档云平台的官方博客 469

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

突破长文本瓶颈:PaddleNLP 8192 Token高效处理方案

你是否还在为法律文档、学术论文等超长文本处理而烦恼?当文档长度超过模型默认Token限制时,强行截断会丢失关键信息,多次分段处理又导致上下文断裂。现在,PaddleNLP通过创新的FlashMask技术和优化的模型配置,让8192 Token超长文本处理变得简单高效。本文将带你了解PaddleNLP长文本处理的核心技术、实现方法及应用案例,读完你将能够: - 掌握8192 Token文本的端到端处...

gitblog_00623的博客 710

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

上一篇: 大模型干货必看:大语言模型(LLM)如何更好地继续预训练(Continue PreTraining)
下一篇: 新手教程,使用Langchain-Chatchat构建自己的专属GPT
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值