Sample Packing:长序列 LLM 训练的 Attention 问题及优化

大模型训练之加速篇 -attention优化【线性化performer/VQ->分块计算MQA/GQA->计算(flash atten/slim/dec)->缓存MLA/pagedAtt】 加速 阅读详情

一、背景

之前看过部分 Megatron-LM 的源码,也详细分析过对应的 Dataset 和 DataLoader,想当然的认为在 LLM 预训练时会使用 Document Level 的 Mask,也就是常说的 Sample Packing 技术。最近我们在做长序列训练相关工作时发现并非如此,并且出现了一些很奇怪的性能问题,因此重新看了相关工作,并进行了部分实验。

Sample Packing 中有很多可以讨论的技术点,比如 Attention 的实现和优化,Sample 的组合及负载均衡问题(有点类似调度问题)以及不同方案对效果的影响等。我们这里只是先简单介绍一下相关问题和实验,后续会进一步探索更多工作,比如 Document Level 的 Mask 到底对预训练效果影响有多大,对 Attention 进行优化还能带来多少提升,如何设计一个比较好的 Packing 策略等?

二、Dataset + Dataloader

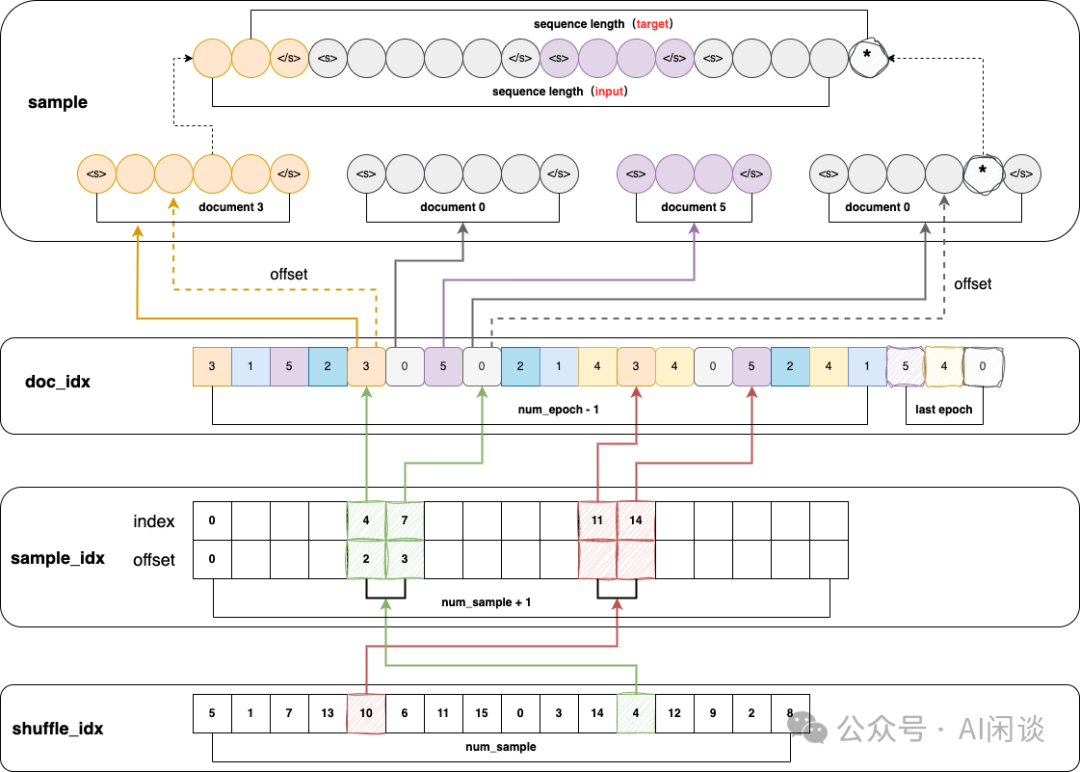
简单说来,预训练通常包含很多不同的数据集,每个数据集又包含许多 Document。为了提升训练效率,在实际训练的时候一个 Sample(Sequence)里面可能会包含多个不同的 Document(Sample Packing)。比如 8K 的预训练 Sequence Length,则一个 Sample 可以包含 8 个 1K 的 Document。

如下图所示,简单展示了 Megatron-LM 中如何 Packing 多个 Document,实际上就是一个多级的索引。需要说明的是,这里其实会引入很多随机读操作,会极大影响读的性能。不过一般 LLM 计算代价都很高,这里也往往不会导致瓶颈。
三、Attention Mask

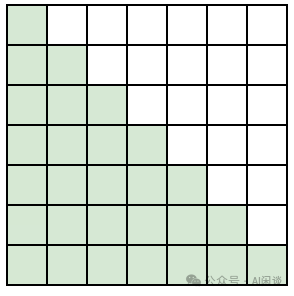
对于单个 Document 而言,Decoder Only 的 GPT 模型具有 Causal 特性,也就是每个 Token 不能看到之后的 Token,因此在实际训练中需要添加 Attention Mask。如下图所示,这种情况下 Attention Mask 是一个标准的下三角矩阵(Causal Mask),也就是绿色部分为 1,其他部分为 0:
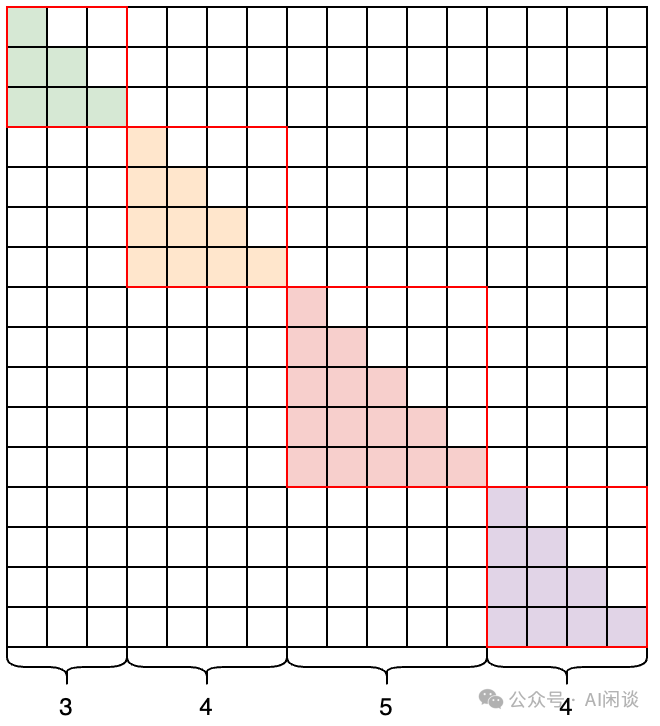
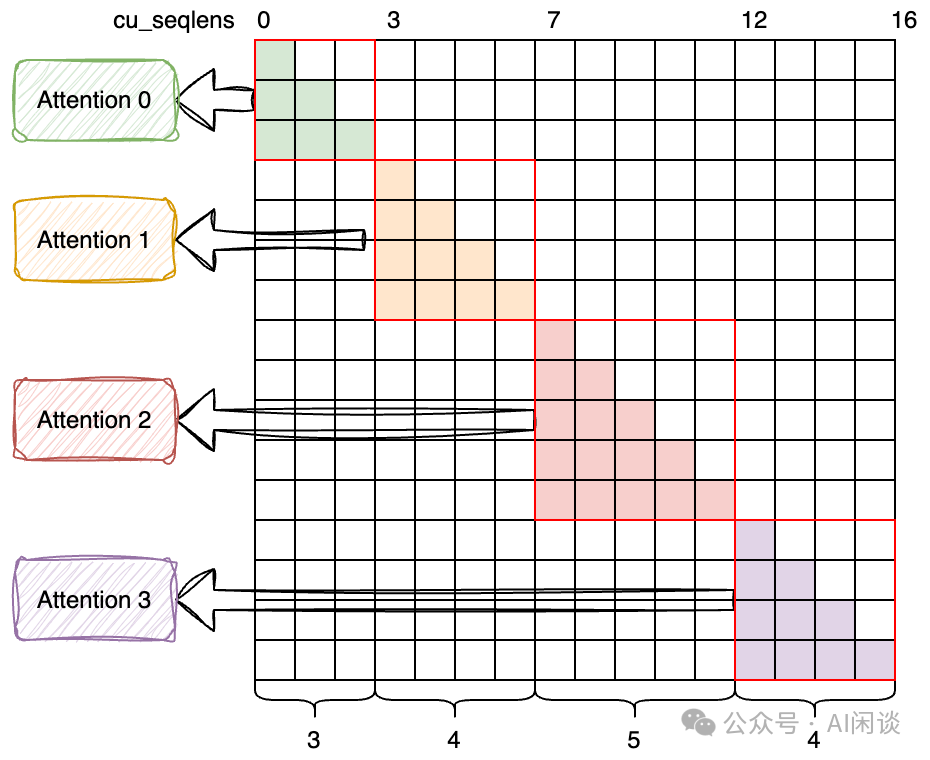
如果一个 Sample 里包含多个样本,则 Attention Mask 矩阵需要变成如下图所示的块对角矩阵形式(Block Diagonal Mask)。比如 Sequence Length 为 16,4 个 Document 的长度分别为 3,4,5,4,则对应 Attention Mask 矩阵如下图所示,对角线上的 4 个矩阵(红框)都是标准的下三角矩阵。按照这种方式可以保证和 4 个 Document 单独作为 Sample 训练是等价的:
四、Reset Attention Mask

4.1 是否需要

那么在实际使用中是否需要严格按照 Block Diagonal Mask 的方式使用呢?答案是否定的,比如 Megatron-LM 可以通过 reset_attention_mask 来控制是使用 Block Diagonal Mask 还是标准的 Causal Mask,默认值为 False。很多模型在预训练时也会采用默认配置,即使用 Causal Mask。

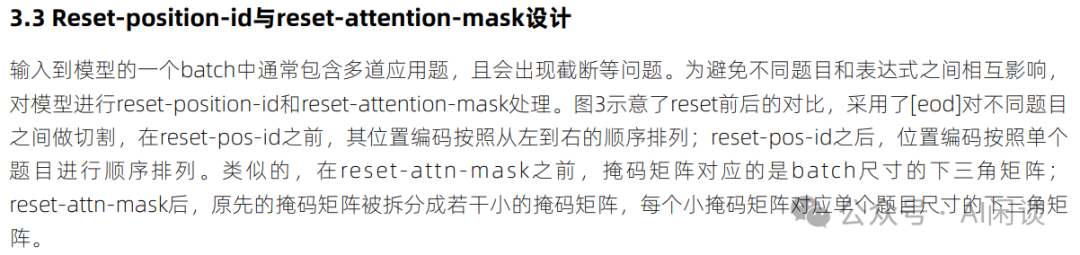
在浪潮的 Yuan-1.0 报告(“源1.0”大模型技术白皮书)中有提到,为了避免不同 Document 之间的相互干扰而将 reset_attention_mask 设置为 True,也就是 Block Diagonal Mask:
在 Meta 的 LLaMA 3.1 技术报告([2407.21783] The Llama 3 Herd of Models)中也提到,在 LLaMA 3.1 模型的预训练中会打开这个配置。不过作者也做了说明,对于 8K Sequence Length 的预训练而言,对模型最终的效果影响不大,对长序列的 Continuous PreTraining 影响比较大:

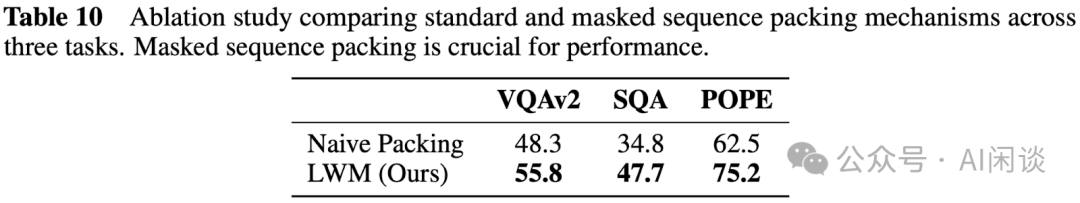
在 [2402.08268] World Model on Million-Length Video And Language With Blockwise RingAttention 中作者提出了“世界模型”,为了提升超长序列的训练效率,作者采用了 Sample Packing 的策略,并且做了相关消融实验。如下图 Table 10 所示,采用 Naive Packing(不对 Attention Mask 特殊处理)相比使用了 Block Diagonal Mask 的 LWM 的性能会差很多:
PS:当然,目前还没有更多有关预训练中是否 reset_attention_mask 的消融实验,我们后续会进行相关测试。此外,如果采用绝对位置编码,Position-id 也需要相应的调整,在 Megatron-LM 中对应 reset_position_id 选项。

4.2 性能问题

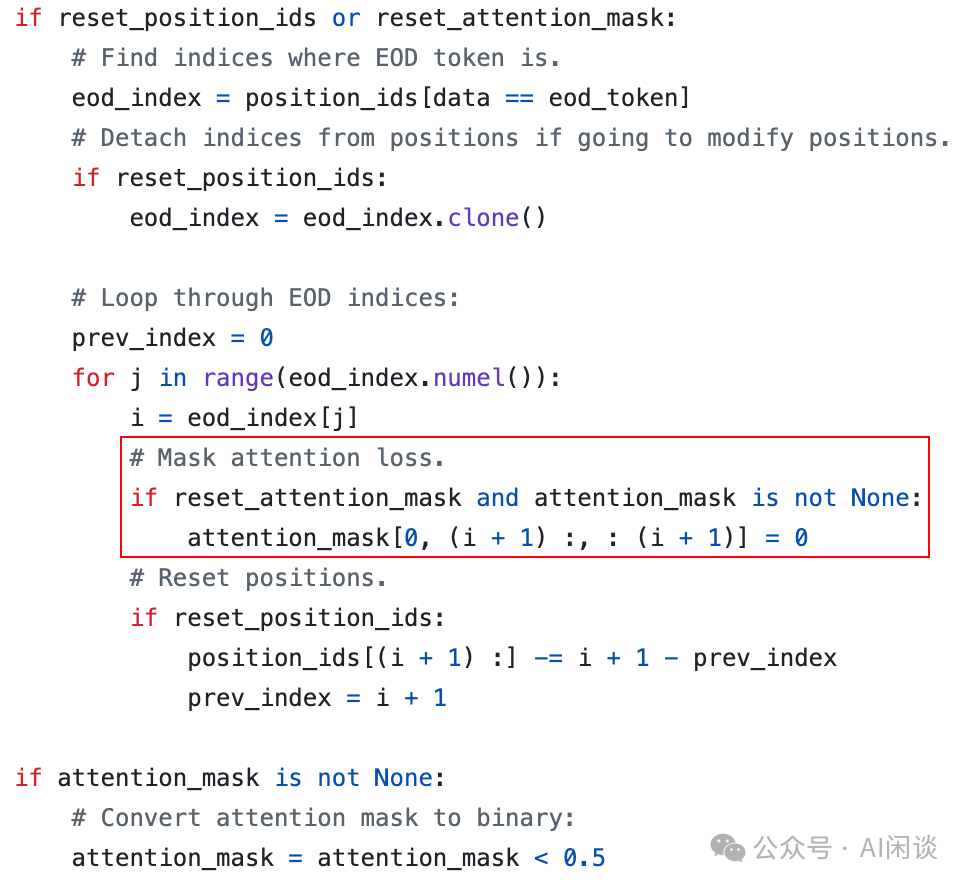
如下图为 Megatron-LM/megatron/core/datasets/gpt_dataset.py 中 reset_attention_mask 的实现方式,首先会将 attention_mask 初始化为标准的 Causal Mask 形式,然后从第二个 Document 开始,将之前的 mask 置为 0:
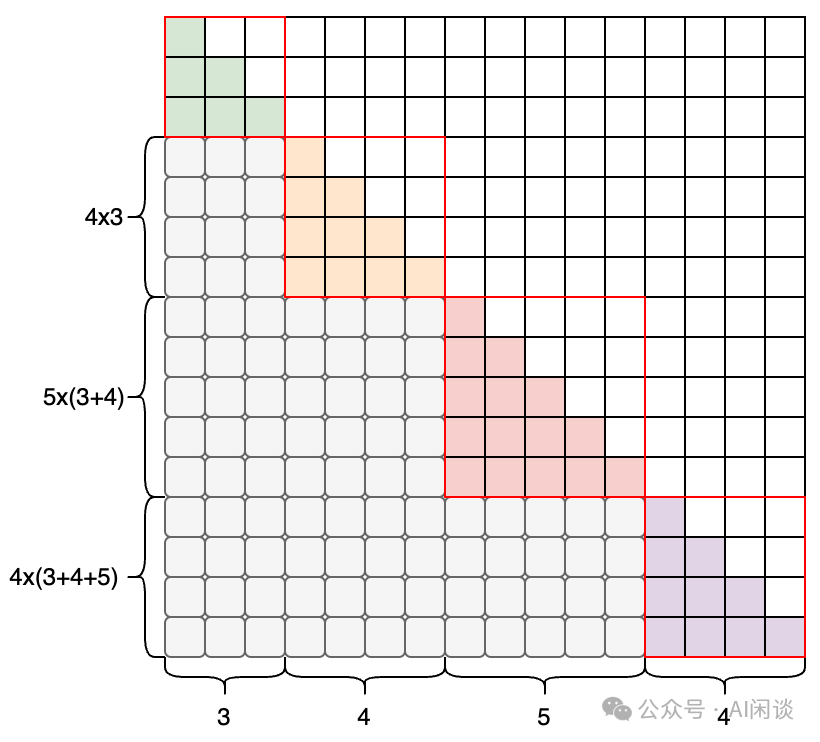
具体来说如下图所示,初始是一个标准的 Causal Mask 矩阵,然后会将 4x3、5x(3+4) 和 4x(3+4+5) 的区域依次置为 0,之后会变成 Block Diagonal Mask:
实际上我们已经知道这里是标准的 Block Diagonal Mask,可以使用 torch.block_diag() 快速创建。实测当序列比较长时(比如 32K),两种方式速度可能会差几十倍,导致 reset_attention_mask 可能成为训练瓶颈:
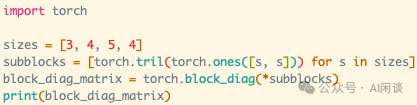
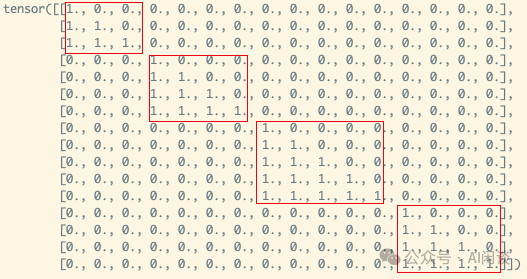
除此之外,当序列非常长时,Attention Mask 也会占据很大的存储空间,为了计算效率,往往会使用整型而不是 Bool 类型。假设以 int8 存储,32K 序列长度对应的 Mask 大小为 32K * 32K = 1GB,128K 时更是高达 16GB。为了避免显存浪费,其实不必将其拼成大的 Block Diagonal Mask,而保留几个小的 Causal Mask 即可。

五、Attention 优化

5.1 FlashAttention

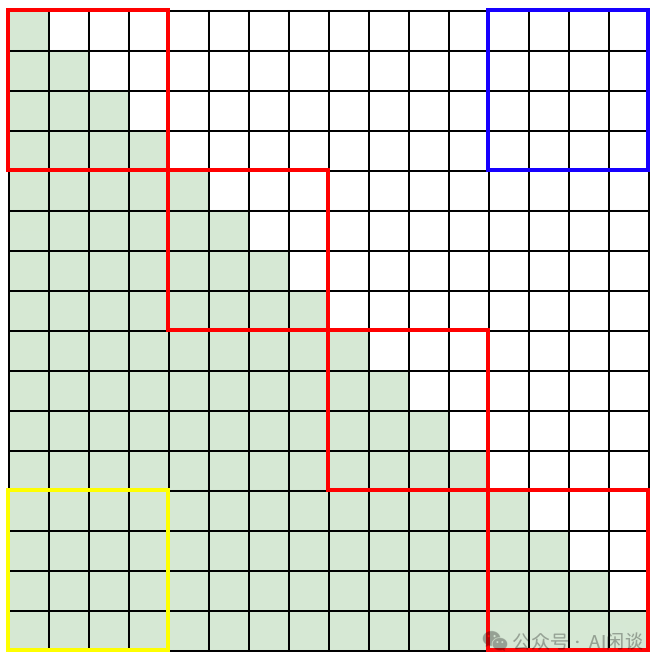
当前 LLM 预训练基本都会使用 FlashAttention,其对 Casual Mask 的方式进行了优化,如下图所示,假设 16x16 的 Attention Mask,在计算时按照 4x4 分块,则可以将其分为 3 种情况:

  • 有些块对应的 Mask 都是 0(红框右上部分,比如蓝框),无需再计算。

  • 有些块中部分 Mask 为 0,部分 Mask 为 1(红框),需要相应特殊处理。

  • 有些块对应的 Mask 都是 1(红框左下部分,比如黄框),全部计算即可。

对于上述 Block Diagonal Mask,依然可以使用 Causal Mask 的方式计算,不过会导致大量的无效计算。幸运的是,FlashAttention V2 支持可变序列长度(Varlen)的 Batching Attention 计算,可以避免 Padding 导致的无效计算。因此也就可以借用这种机制来对 Block Diagonal Mask 进行解构,重新分解为多个 Causal Mask 分别计算,可以避免很多无效计算。如下图所示,可以将其看成 4 个独立的 Attention 计算,具体可以参考 FlashAttention Github 上的相关讨论:How to implement example packing with flash_attn v2? · Issue #654 · Dao-AILab/flash-attention · GitHub 和 Will attention_mask be extended to 3D? (concatenate short samples for efficient training) · Issue #432 · Dao-AILab/flash-attention · GitHub。
在 GLM-4([2406.12793] ChatGLM: A Family of Large Language Models from GLM-130B to GLM-4 All Tools)中也应用了 Sample Packing 方案,并且同样使用了 Block Diagonal Mask 机制来区分不同的 Document。并且作者也是基于 FlashAttention 的 Varlen 功能来实现。

5.2 Pytorch FlashAttention

Pytorch 的 scaled_dot_product_attention 提供了高效的 Attention 实现,也集成了 FlashAttention2 的实现,然而其不支持上述的可变序列长度的功能,导致针对 Block Diagonal Mask 场景时会存在大量的重复计算。

此外,我们在之前的文章中也多次提到,当序列比较短时,Attention 部分计算的占比并不是特别大,因此其中的冗余计算可能对整体训练速度影响不大;但当序列比较长时,Attention 部分计算的占比会越来越大,冗余计算可能会对训练速度有比较大的影响,也就需要对其进行优化。

5.3 FlexAttention

Pytorch 在 2.5.0 版本引入了 FlexAttention(FlexAttention: The Flexibility of PyTorch with the Performance of FlashAttention),可以很容易支持各种 Attention Mask 变种,比如标准 Causal Mask、Sliding Window + Causal、Prefix Mask 以及 Document Mask(Block Diagonal Mask)等,相比 FlashAttention 也更加的灵活。

我们基于 FlexAttention 进行了相关测试,以验证使用 Block Diagonal Mask 的性能优势。首先以两个 16K Document 拼接为一个 32K Sample 为例,Attention Mask 大概是如下图所示方式,对应的稀疏度为 74.80%(整个 Mask 中 0 的占比):
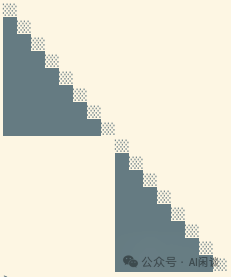
如下图所示我们在 H100 GPU 上进行的 Attention 相关性能测试。可以看出, Pytorch 的 Causal + FlashAttention2 方式确实可以达到非常高的 TFLOPS,明显高于 FlexAttention。然而,因为 FlexAttention 中避免了很多无效计算,实际的 Forward 和 Backward 时间反而更短:

当然,也并不意外着 FlexAttention 总是更优的,还和 Sample 中 Document 长度有关。如下图所示为相应测试结果,32K 表示 Sample 中只有一个 Document,2K + 30K 表示 Sample 中有 2 个 Document,一个长度 2K,一个长度 30K。从下图基本上可以得出这样一个结论:当 Sample 中最长的 Document 的长度 <= Sequence Length/2 时,使用 FlexAttention 可能会带来更大的收益:
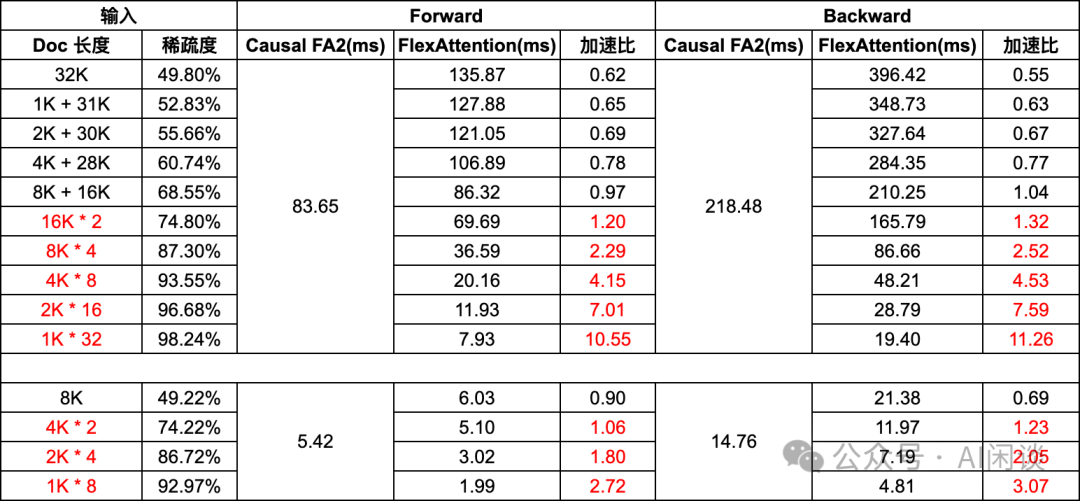
那么为什么“最长的 Document 的长度 <= Sequence Length/2”时会有收益呢?其实可以简单从稀疏度的角度考虑:假设 a1 + a2 + a3 + … + an = S,并且 0 < a1 <= a2 <= a3 <= … <= an <= S/2,那么可以用数学归纳法得出 (a1)^2 + (a2)^2 + (a3)^2 + … + (an)^2 <= S^2/2。也就是说,最长的 Document 的长度 <= Sequence Length/2 时,稀疏度会 >= 75%(还要考虑 Causal 特性),相应的 FlashAttention 中至少有一半的冗余计算。

因此,我们也需要充分考虑在长文本训练过程中短文本的占比,极端情况下训练数据全部是超长文本,每个 Sample 中都只有一个 Document,Block Diagonal Mask 会退化为 Causal Mask。不过有些时候为了避免模型出现灾难性遗忘,也会混合一些短文本数据,或者高质量的预训练数据,不可避免的会出现冗余计算的问题。

5.3 Sequence Parallel

针对长序列场景通常会采用 RingAttention 和 USP 等,然而不管是 RingAttention 还是其 LoadBalance 版本(如下图 Figure 3 所示)等都没有太多讨论 Sample Packing 的情况。对于 Block Diagonal Mask 场景,其相应的优化,LoadBalance 策略也可能需要对应调整:
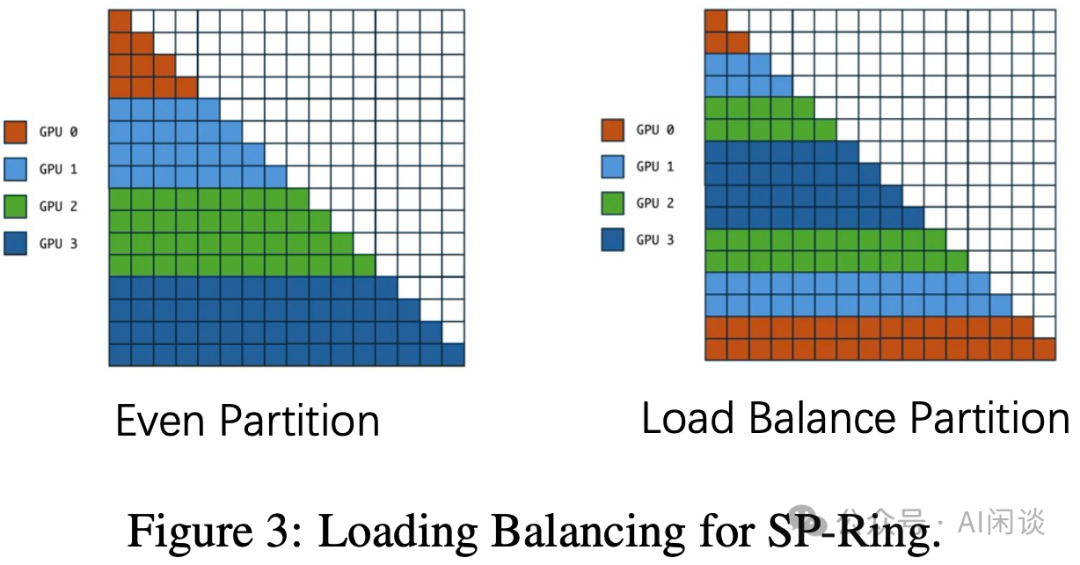
在 [2402.08268] World Model on Million-Length Video And Language With Blockwise RingAttention 中作者(也是 RingAttention 的作者)声称针对 Block Diagonal Mask 场景对 RingAttention 进行相关优化,但并没有对比优化前后训练速度的提升。

PS:整体来说,在各种序列并行技术中更好的兼容 Block Diagonal Mask 场景又会有更多的挑战,我们留作后续介绍。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

深度学习之Encoder-Only原理与实战 【代码】深度学习之Encoder-Only原理与实战。 阅读详情

相关推荐

告别CANoe?手把手教你用Python+PCAN搭建汽车诊断脚本(附完整代码)

本文详细介绍了如何利用Python和PCAN硬件搭建高性价比的汽车诊断自动化方案,替代昂贵的CANoe工具。通过开源库python-can和udsoncan实现UDS诊断协议,涵盖硬件选择、环境配置、核心功能实现及性能优化,附完整代码示例,助力开发者快速构建诊断脚本。

weixin_42551227的博客 373

Transformer模型变长序列优化:解析PyTorch上的FlashAttention2与xFormers

随着AI模型在复杂度和应用范围上的持续扩展,性能优化变得越来越重要。本文着重探讨了注意力层的优化策略,并提供了一系列实用的工具和技术来提升Transformer模型的性能。数据处理优化:- 提出了动态填充和无填充策略- 优化了序列连接和位置编码的处理方式计算效率提升:- 利用FlashAttention2实现高效的注意力计算- 通过编译优化提升执行效率框架集成:- 展示了如何在HuggingFace生态系统中实现这些优化- 提供了具体的代码修改指南。

deephub 6936

【时间序列预测算法】——Holt-Winters算法介绍及代码实现

背景 一阶二阶三阶指数平滑方法拟合效果均较好,通过结合数据自然属性,数据自身、趋势变化、季节性,提出了这三个角度的衡量量,可以说,理解起来更自然、更亲切。 公式 一阶: sts_tst​是t时刻对xtx_txt​的估计值,这里只有一个参数α,是数据本身的平滑属性的体现。 二阶: 引入了时间趋势变量btb_tbt​,优化了一下一阶的公式。同时还可以预测t+m时刻的值: 三阶: 又引入了季节性周期描述变量ctc_tct​,优化了一下二阶的公式。同时还可以预测t+m时刻的值: NOTE:ct

BlackValley的博客 1万+

多模态模型如何处理任意分辨率输入——Tiling与Packing技术详解(part2)

接上文http://myhz0606.com/article/vllm_any_resolution,补充一些公式推导。

weixin_40779727的博客 618

SwinIR实战:从环境搭建到模型训练的全流程解析

本文提供了SwinIR超分辨率模型从零开始的全流程实战指南。详细解析了基于PyTorch和Anaconda的环境搭建、数据准备与配置文件修改、训练启动与常见错误排查(如张量尺寸不匹配),以及模型评估方法,帮助读者高效部署并训练SwinIR模型。

weixin_28224217的博客 319

统信UOS系统网络服务异常排查:WIFI图标消失与网络设置缺失的解决方案

本文详细解析了统信UOS系统WIFI图标消失与网络设置缺失的常见问题,提供了从基础修复到进阶排查的完整解决方案。重点分析了NetworkManager服务异常的根本原因,包括系统更新中断、权限配置错误等,并给出实用的命令行操作指南和预防措施,帮助用户快速恢复网络功能。

weixin_29234239的博客 619

模型并行分布式训练 Megatron (3) ---模型并行实现

因为对于第二行来说,其输入Y其实本质是 XA1,XA2并行的,所以为了降低通信量,我们可以把数据通信延后或者干脆取消通信,就是把第一行最后的 all_gather 和第二行最初的 split 省略掉,这其实就是数学上的传递性和结合律(局部和之和为全局和)。NVIDIA Megatron 是一个基于 PyTorch 的分布式训练框架,用来训练超大Transformer语言模型,其通过综合应用了数据并行,Tensor并行和Pipeline并行来复现 GPT3,值得我们深入分析其背后机理。

luoganttcc的博客 1453

【FPGA教程案例59】深度学习案例6——基于FPGA的CNN卷积神经网络之整体实现

在课程,我们对的基本原理有了初步认识。在上一个课程,我们完成了CNN的Relu激活层、pool池化层、卷积层以及图像输入层的实现,如下图所示:在本课程中,我们将上述四个模块结合起来,构建一个简单的CNN卷积神经网络。...

FPGA/MATLAB学习教程/源码/项目合作开发 2637

LLM长序列训练实战:如何用FlashAttention优化Sample Packing性能(附避坑指南)

本文深入探讨了在LLM长序列训练中,如何利用FlashAttention优化Sample Packing性能。通过分析传统打包方法的性能瓶颈,详细介绍了FlashAttention V2的可变长度批处理功能如何高效实现块对角掩码,从而消除计算冗余,显著提升训练效率。文章还提供了从数据加载到训练循环的全链路实战优化方案与关键避坑指南。

qqq44的博客 956

从 SAP Gateway 旧 add-ons 卸载到 SAP S/4HANA 转换的清理路线

摘要: SAP Gateway系统的维护难点往往源于历史遗留组件的堆积,而非OData服务本身的复杂性。早期系统为支持多种服务类型而安装的各类add-ons(如IW_SCS、IW_CNT、GW_CORE等),随着系统升级和团队更替逐渐成为技术负债。自SAP NetWeaver 7.40起,核心功能已整合至SAP_GWFND组件,使架构显著简化。在向S/4HANA迁移时,需重点清理已废弃的add-ons(如IW_SCS、IW_GIL等),但必须谨慎验证其关联服务是否仍被调用。组件清理需结合系统日志和调用链分析

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 424

纯方位观测下的三维定位,IV-PLKF(Inverse Velocity-Weighted Pseudo-Linear Kalman Filter)

在现代定位系统中,纯方位观测因其无需测距设备的优势,在无线通信、无人机导航和室内定位等领域备受关注。本文深入探讨基于算法的三维定位方法,并提供完整的MATLAB仿真例程。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 672

StreamingLLM:让LLM拥有无限长生成能力

在流式场景(如多轮对话或实时处理无限长输入)中,传统方法(如滑动窗口或重新计算 KV)要么效率低下,要么丢失上下文。StreamingLLM 提出了一种创新方法,旨在让 LLM 在不改变上下文窗口大小的情况下,高效处理无限长输入。

陈锐的技术笔记 1237

基于YOLOv11的农作物病虫害检测系统设计与实现

我们使用公开的IP102病虫害数据集作为基础,该数据集包含102种病虫害类别,覆盖水稻、小麦、玉米等多种主要农作物。图像数量:75,222张类别数:102图像分辨率:从640×480到4000×3000不等标注格式:PASCAL VOC格式此外,我们还收集了部分田间实际拍摄的图像以增强模型泛化能力。

YOLO 595

Moxin-LLM预训练代码逐行精讲:ColossalAI Booster如何驱动7B大模型训练

Moxin-LLM 是一套完全开源、可复现的大语言模型(LLM)家族,官方公开了数据集、训练脚本与模型权重。本文以 [train/](https://link.gitcode.com/i/dc6adbc50b8742f7e3efb448fe9c6332) 目录下的**预训练代码**为主线,逐段精讲 ColossalAI Booster 是如何把一台或一个节点集群的 GPU 拧成一股绳,驱动 **7

gitblog_01186的博客 824

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

OpenRLHF实践之Qwen2.5-0.5B微调

OpenRLHF 是一个基于 Ray、DeepSpeed 和 HF Transformers 构建的高性能 RLHF 框架:​本实验的基础设备是AutoDL租用的服务器。

qq_46325481的博客 5929

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

LLM(14):模型的长序列问题

如果你不熟悉 RNNs,不用担心——不需要详细了解 RNN 的工作原理就能跟随此处的讨论,这里的重点放在编码器-解码器的一般概念上。编码器在每一步更新其隐藏状态(隐藏层中的内部值),试图将整个输入句子的意思传给最后一个隐藏状态中,如图 3.4 所示。虽然我们不需要了解这些编码器-解码器结构的 RNN 的内部工作原理,但这里的关键思想是,编码器部分将整个输入文本处理成一个隐藏状态(记忆单元)。编码器-解码器 RNN 的一个重大局限性在于,在解码阶段,RNN 无法直接访问编码器中较早的隐藏状态。

计算机科学、人工智能、数据分析和大数据方向的研发和教学。 549

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

英伟达:针对长序列的LLM高效推理注意力

处理长序列时,由于自注意力机制的二次复杂度导致的计算和内存资源需求过高。论文提出了Star Attention算法,通过分块局部注意力和全局查询编码的两阶段机制,显著提高了长序列处理的效率和速度。

大模型任我行的博客 766

从零开始理解FlashAttention:算法细节图解

介绍了 FlashAttention 技术,它通过优化 GPU 内存层次结构和融合内核,实现了快速且节省内存的精确注意力计算。文章分为两部分:第一部分介绍了注意力机制的基础知识以及 GPU 优化方法;第二部分深入讲解了 FlashAttention 的核心算法,包括如何分解 SoftMax 操作以支持分块计算,以及如何在前向和反向传播中高效处理中间结果。FlashAttention 实现了 7.6 倍的速度提升和 O(N) 的内存复杂度,同时保持了精确的注意力分数,极大地推动了大规模模型训练的效率和可行性

AI人工智能的学习之路 2283

打破GPU显存墙:FlashAttention-2算法在LLM训练中的极致优化实践

LLM训练面临显存占用的三大挑战:注意力矩阵膨胀、中间激活存储和硬件带宽限制。2023年提出的FlashAttention-2算法通过内存访问优化、分块计算、重计算和核融合等技术,显著降低显存占用并提升训练速度。该算法在A100和H100硬件上实测显示,显存占用降低52.8%,训练速度提升2.9倍。未来,混合精度分块、硬件协同设计和分布式扩展将是LLM训练优化的关键方向。随着硬件技术的进步,百万

像风一样自由 2074

LLMの推理过程

将 logits 传递给 logits_processor 和 logits_warper,在这两个方法中进行一些预处理过程,例如添加惩罚项或对概率分布进行修改,使得生成的结果更符合期望,具体调用了(这里用到了temperature参数,作用是调节模型生成的随机性,temperature通常被用于控制softmax函数的形状,从而影响生成序列的多样性,当temperature值接近0时,模型趋向于输出最可能的单个结果,也就是模型的输出趋向于确定性。该策略用于限制模型在每个生成步骤中所考虑的可能输出的范围。

whaosoft143ai的博客 2553

【大模型LLM面试合集】大语言模型基础_LLM为什么Decoder only架构

LLM 是 “Large Language Model” 的简写,目前一般指百亿参数以上的语言模型, 主要面向文本生成任务。跟小尺度模型(10亿或以内量级)的“百花齐放”不同,目前LLM的一个现状是Decoder-only架构的研究居多,像OpenAI一直坚持Decoder-only的GPT系列就不说了,即便是Google这样的并非全部押注在Decoder-only的公司,也确实投入了不少的精力去研究Decoder-only的模型,如PaLM就是其中之一。

高丽大学人工智能硕士在读|专注大模型、RAG、OCR与AI工程实践 1472

FlashAttention-v3

摘要:本文介绍了FlashAttention-3的创新优化,针对Hopper架构GPU特性进行深度适配。通过生产者-消费者异步机制,实现线程束专用化和乒乓调度,使TMA数据搬运与TensorCore计算重叠执行。采用2/3-Stage流水线设计提升计算并行度,权衡寄存器压力与块大小。特别优化了FP8低精度计算,通过寄存器所有权转换、数据布局适配及块量化/非相干处理技术,在保持精度的同时显著提升吞吐量。相比v2版本,v3充分利用硬件异步特性和低精度优势,实现了更高性能的注意力计算方案,为类似架构的算子优化提供

Bubu的博客 479

【LLM】GLM长文本训练(数据、流程、infra)

GLM融合packing和sorted batching的优点,提出sorted packing训练方法:根据计算量来构建同一批次内的 Pack,确保同一批次中各个 Pack 数据的计算量相近,从而减少了气泡时间。此外,我们还引入了梯度累积技术,以避免排序带来的偏差 长短文本混合 SFT 的高效训练方法主要有两种:Packing 和 Sorted Batching。Sorted Batching 可能会引入某些先验知识,即同一批次内的数据长度趋于一致,这有可能导致不良的训练效果。相比之下,Packing 策

发现问题,并解决问题,批判性思维 2962

DeepSpeed Ulysses: 训练极长序列Transformer模型的系统优化

微软DeepSpeed组官方中文博客(翻译自官方英文博客:DeepSpeed Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models)。转载自微软DeepSpeed组官方知乎账号:zhihu.com/people/deepspeed。从生成性AI到科研模型,长序列...

开源社KAIYUANSHE的博客 1901

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 196
上一篇: 10分钟搞清楚为什么Transformer中使用LayerNorm而不是BatchNorm
下一篇: 如何精准计算:大型语言模型(LLM)部署到底需要多少GPU内存?
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值