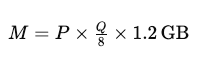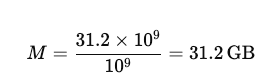如何精准计算:大型语言模型(LLM)部署到底需要多少GPU内存?

【LLM】vLLM部署与int8量化 介绍了vLLM原理并讲解如何支持peft,对不同的decoding methods进行了说明,同时详述了int8量化的过程。 阅读详情

在几乎所有关于大型语言模型(LLM)的访谈中,总有一个问题反复出现:“部署 LLM 需要多少 GPU 内存?”

这个问题并非偶然,它是衡量您对这些强大模型在实际生产环境中部署和扩展能力理解程度的关键指标。

当您在处理像 GPT、LLaMA 或其他任何 LLM 时,准确估算所需的 GPU 内存至关重要。不论您面对的是7B参数的模型还是更大规模的模型,合理配置硬件资源以确保模型高效运行是不可忽视的环节。接下来,我们将深入解析相关计算,帮助您准确估算部署这些模型时所需的 GPU 内存。
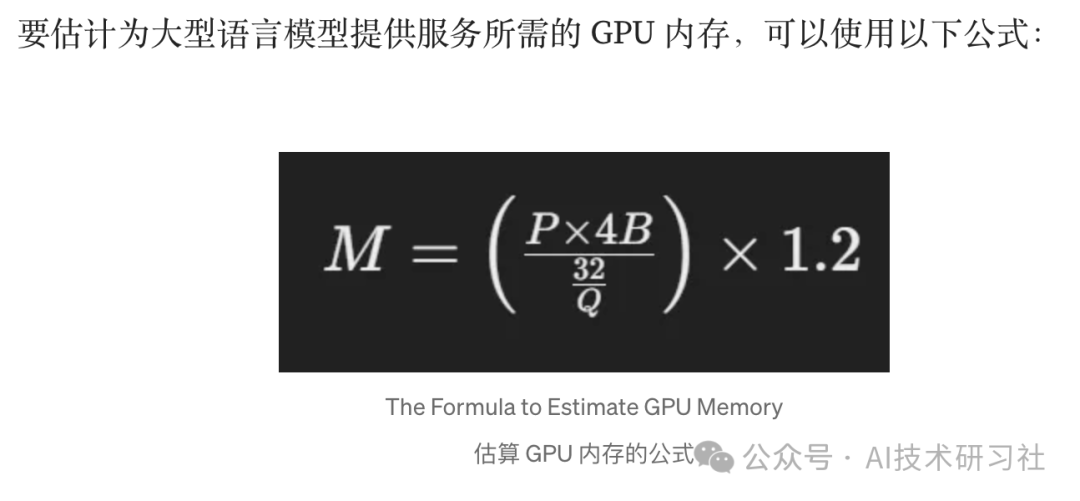
img

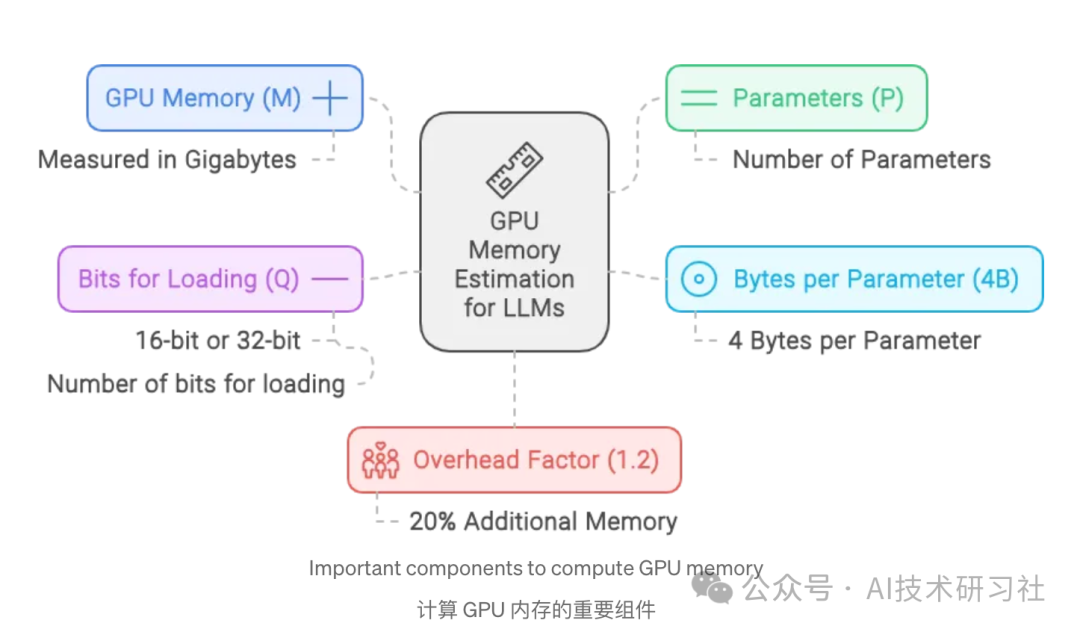
M 是 GPU 内存,以 GB 为单位。

P 是模型中的参数数。

4B 表示每个参数使用的 4 个字节(每个参数在内存中的占用)。

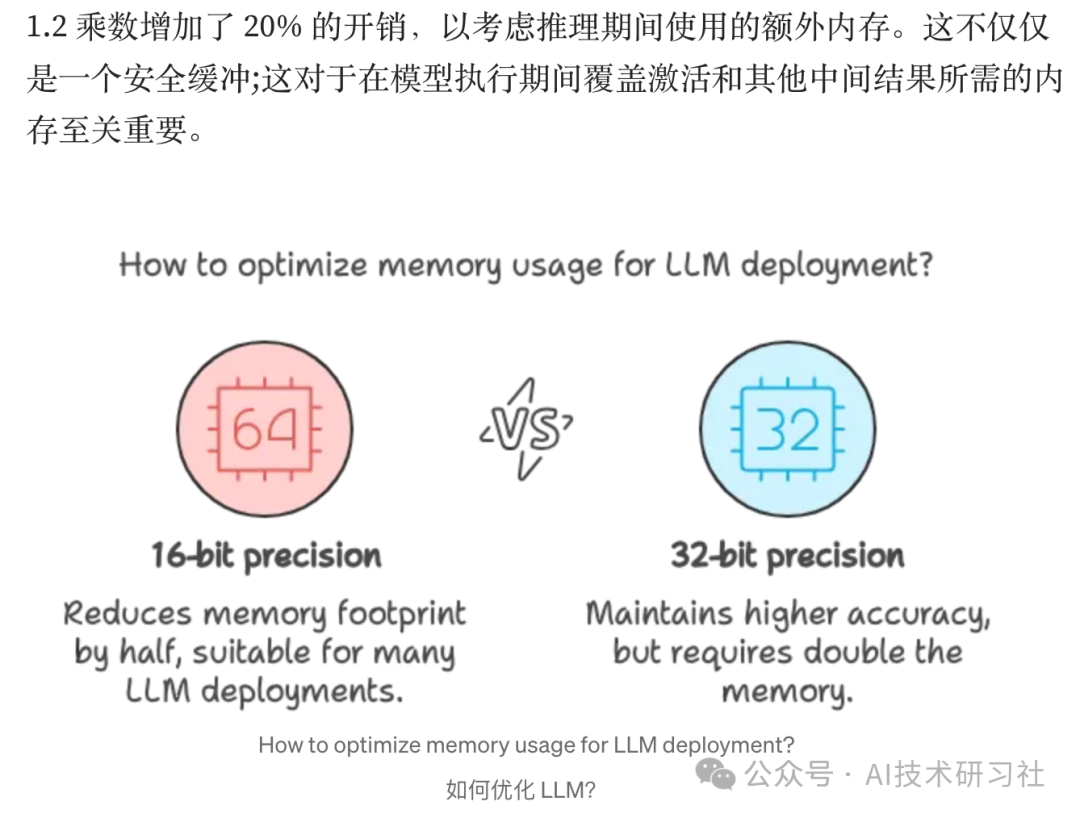
Q 是加载模型的位数(例如,16 位或 32 位)。

1.2 代表 20% 的额外开销,用于考虑额外的存储需求,例如缓存、元数据等。
img

因此,公式可以表达为:

img

这个公式用于估算在部署大语言模型(LLM)时所需的 GPU 内存大小,确保模型可以顺利运行并考虑到一定的余量。
img

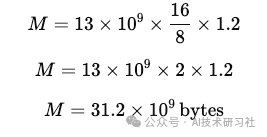
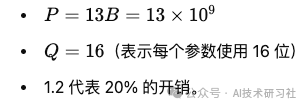
假设我们有一个模型,参数数量PPP 为 13B(130亿参数),使用 16 位(即 2 字节)来加载模型,想要估算部署这个模型所需的 GPU 内存MMM。

我们可以将这些值代入公式:

M=P×Q8×1.2

其中:
img

计算步骤如下:

img

换算成 GB:

img

因此,部署这个 13B 参数、16 位精度的大模型大约需要 31.2 GB 的 GPU 内存。

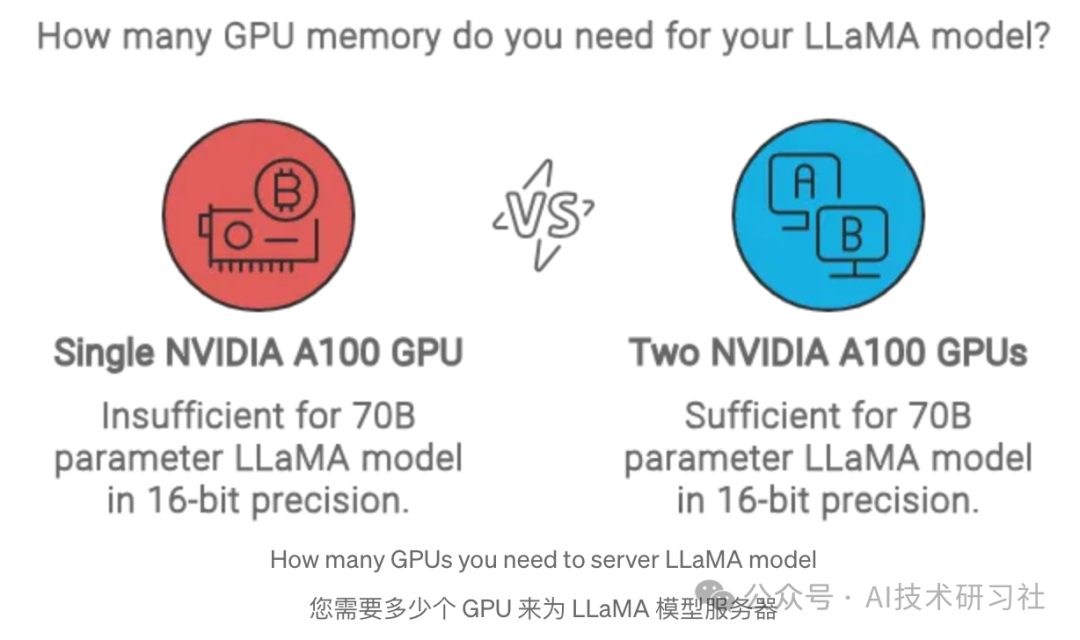
理解和应用这个公式不仅仅是理论上的;它具有现实世界的影响。例如,具有 80 GB 内存的单个 NVIDIA A100 GPU 不足以为该模型提供服务。您至少需要两个 A100 GPU,每个 GPU 为 80 GB,才能有效地处理内存负载。
img

通过掌握这一计算,您不仅能自信应对面试中的关键问题,更能在实际部署中避免硬件资源的高昂浪费。下次评估 LLM 部署时,您将精准了解如何有效预估所需的 GPU 内存,确保系统高效运行,轻松应对挑战。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

llm.txt:优化大型语言模型理解网站内容的关键文件 在AI技术快速发展的今天,大型语言模型(LLM)如ChatGPT已成为获取信息的重要渠道。然而,传统网站结构对AI并不友好,导致信息检索效率低下。llm.txt作为一种专为LLM优化的网站导航文件,通过结构化Markdown格式,明确指示网站核心内容和资源优先级。其技术原理在于绕过HTML噪音,直接提供纯净内容,显著提升AI理解准确率。这一技术特别适用于技术文档、API参考等场景,能有效解决上下文窗口有限的问题。通过合理设计llm.txt文件,开发者可以让AI快速定位关键信息,如代码示例、理论说明等,实现从 阅读详情

相关推荐

大模型训练资源评估

卡间通信延长对训练时长的影响未有明确测算公式,根据现有实例推测:H800相对于H100也仅有卡间通信速率的下降(约50%),其在执行训练任务时,H800消耗比H100多10%-30%的时间。激活值所消耗的额外显存随batchsize的大小而增加,在batchsize较大时,此部分额外显存消耗远远大于模型参数的消耗,采用激活重计算技术可将中间激活显存从O(n)减少到O(√n)。从官方给出的技术规格上来看,在模型训练中最关注的显存与算力参数完全一致,80GB版本GPU显存带宽一致。

andy20160103的博客 6428

2025年全球主流大模型本地部署及高效使用硬件配置指南,从入门到精通,硬件配置+部署全解析!

文章详细介绍了截至2025年8月全球主流大模型(GPT、Claude、Gemini、LLaMA、ChatGLM等)在不同规模和场景下的硬件需求配置。按模型参数量分类(超小、小型、中型、大型、超大型),分析了各模型在推理、微调等场景下的GPU显存、CPU、内存和存储需求,为个人用户和企业级应用提供了精准配置建议,帮助读者根据需求选择合适硬件。在人工智能飞速发展的当下,大模型应用日益广泛。无论是个人开发者打造专属聊天机器人,还是企业构建智能客服、专业领域助手,了解大模型运行的硬件需求配置至关重要。

bagell的博客 5826

本地AI助手部署指南:DeepSeek Harness与Ollama集成实践

AI Agent作为当前人工智能领域的热门技术,通过模拟人类决策过程,能够自主规划、调用工具并执行复杂任务。其核心原理在于将大语言模型的推理能力与外部工具API相结合,形成可闭环的工作流。这种技术架构的价值在于显著提升了AI系统的实用性和自动化水平,使其从单纯的对话工具转变为能够解决实际问题的智能助手。在应用场景上,AI Agent广泛应用于代码生成、数据分析、自动化办公等领域。本文聚焦于如何通过DeepSeek Harness平台与Ollama本地模型的集成,实现隐私安全、离线可用的AI助手部署方案,特别

dengjuanshou7445的博客 474

部署大型语言模型 (LLM) 服务需要多少 GPU 显存?

了解为 LLM 服务的 GPU 显存需求不仅仅是一个面试问题,更是现实世界的必需。下次部署模型或在面试中回答这个问题时,希望大家可以有精确的数学计算来支持您的答案。一般来说,FP16 中的 7B 参数模型需要约16.8GB 的 VRAM。利用量化、分流到CPU或多 GPU并行设置来优化显存占用。根据模型大小选择 GPU:16GB VRAM 用于小型模型,24GB 以上用于大型模型。对这些数字了解得越多,就越有信心在生产中优化和部署 LLM!

Z4400840的博客 1811

振动能量采集技术:从原理到实战,破解物联网供电难题

能量采集技术旨在捕获环境中的废弃能量(如机械振动、热能、光能)并将其转化为电能,其核心原理在于通过压电、电磁、静电或摩擦电等物理效应实现能量形式的转换。这项技术的核心价值在于为物联网(IoT)中难以布线或更换电池的分布式传感器节点、植入式医疗设备等提供近乎永续的电力解决方案,从而解决物联网部署的“最后一米供电”瓶颈。其应用场景广泛覆盖工业预测性维护、结构健康监测、可穿戴设备及消费电子等领域。本文聚焦于振动能量采集这一细分方向,深入剖析了压电式、电磁式、电容式及摩擦纳米发电机(TENG)等主流技术路线的实战考

weixin_42660494的博客 567

python自动交易 缠论_缠论自动交易系统实现了

一、缘起:缠中说禅的伟大,我想你只要上网搜索一下就知道了,他的才气不用我说,我只想说说他的《教你炒股票》系列文章,108篇文章,将他的股票操盘秘籍全部公开给广大的股友了,更有缠友将其理论写成公式,在网上也是广为流传,深受广大缠友们的喜爱。我也是缠中说禅的忠实崇拜者之一,从2008年开始每天都使用缠论来看盘,特别想将缠论写成交易系统,让计算加来帮助我们自动交易,从而减轻我们盯盘的辛劳,可是苦于没有好...

weixin_39970689的博客 4637

只需三步,手把手带你在本地部署运行大模型

在当前的技术环境下,大型语言模型(LLMs)已经成为人工智能领域的一个重要里程碑。

AAI666666的博客 1万+

【软件介绍】GWAS meta分析软件:METAL

Meta-analysis是对多个GWAS分析结果进行综合评价。METAL是GWAS meta分析最常用的工具之一,本文简单介绍METAL软件基本用法。

hucy_Bioinfo 1万+

揭秘万亿参数大型语言模型的 AI 推理部署

AI 正在改变每个行业,解决人类面临的重大科学挑战,例如精准药物发现和自动驾驶汽车的开发,以及为了解决商业问题,自动创建电子商务产品描述和从法律合同中提取见解。如今,每家企业都在探索大型语言模型 (LLM) 创造竞争优势的潜力。NVIDIA Cloud 合作伙伴正在介入,支持企业的 AI 之旅。例如,NexGen Cloud 为其客户提供了通过其按需云平台 Hyperstack 运行概念验证 (PoC) 的机会,然后再承诺签订大规模超级云合同。

专注于人工智能领域的小何尚 964

TI AWR1642实战指南:CCS调试mmWave Demo Visualizer全流程解析

本文详细解析了TI AWR1642开发板的CCS调试流程,重点介绍了mmWave Demo Visualizer的使用方法。从环境准备、版本确认到bin文件烧录、CCS工程配置,再到调试启动与结果验证,提供了全流程的实战指南,帮助开发者快速掌握AWR1642的调试技巧,避免常见错误。

weixin_30790841的博客 111

智能气象站:ESP32驱动的心知天气数据可视化实践

本文详细介绍了基于ESP32微控制器和心知天气API构建智能气象站的完整实践。通过Arduino开发环境,实现天气数据的获取、JSON解析与OLED屏可视化展示,涵盖硬件连接、API配置、低功耗优化及部署问题排查,为物联网开发者提供实用指南。

jump7的博客 210

LLM部署优化:GPU内存需求计算与量化技术详解

通过应用特定的计算公式,可以准确估算部署LLMs所需的GPU VRAM,从而选择最合适的硬件配置。同时,量化技术作为一种有效的内存优化手段,能够在不同精度下显著降低VRAM需求,实现高效部署。两者结合,不仅优化了资源利用和成本控制,还提升了部署的灵活性和可扩展性,为大规模语言模型的实际应用提供了坚实的技术支持。

XianxinMao的博客 1614

使用MATLAB求解二维顶盖驱动流问题的详细代码和说明

本文介绍了使用MATLAB求解二维顶盖驱动流问题的涡量-流函数方法。代码采用129×129网格,雷诺数Re=1000,通过迭代求解Navier-Stokes方程,包含流函数方程和涡量输运方程的离散求解。程序实现了边界条件处理、收敛性检查,并提供丰富后处理功能:流线图、涡量分布图、中心线速度曲线、矢量图和三维涡量可视化。计算结果可与Ghia等(1982)的经典数据进行验证。该代码完整展示了CFD问题的数值求解流程,包括参数设置、主循环计算和多种结果呈现方式,适用于流体力学教学和科研验证。

AI的内部世界的博客 225

部署大模型需要多少GPU显存?一文教你精准计算

这不仅关系到硬件成本,更直接影响服务的并发能力和响应速度。今天,我们就以Llama 70B模型为例,手把手教你计算推理所需的GPU显存。

python1234567_的博客 1180

MICCAI‘23 | TSegFormer:基于几何引导Transformer的口内扫描3D牙齿分割

光学口内扫描仪(IOS)在数字牙科中广泛应用于提供牙冠和牙龈的详细3D信息。准确的3D牙齿分割对于各种牙科应用至关重要,但现有方法在复杂边界处容易出错,并且在不同患者之间表现不佳。本文提出了TSegFormer,它通过多任务3D Transformer架构捕捉IOS点云中不同牙齿和牙龈之间的局部和全局依赖关系。此外,作者设计了一种基于新颖点曲率的几何引导损失,以端到端方式优化边界,避免了耗时的后处理,从而实现临床适用的分割。

小白学视觉 291

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

面试题:部署一个LLM大概需要多少显存?

部署大型语言模型需要大量的 GPU 内存资源。所需的内存量取决于模型的大小和复杂性、用于存储参数的数据类型以及应用的优化(如量化)。通过了解影响 GPU 内存需求的因素,开发人员可以做出明智的决策,以实现 LLMs 的最佳性能和效率。

2401_85373691的博客 1172

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

科研级GPU选型指南:针对LLM推理的深度解析与精准匹配策略

这些模型的背后,离不开强大的计算能力支撑,而GPU作为核心硬件之一,扮演着至关重要的角色。NVIDIA作为GPU领域的领航者,推出了多款适用于不同场景的GPU产品,旨在满足从个人到大规模科研项目的LLM推理需求。然而,面对琳琅满目的GPU型号,如何精准选型,以确保性能、成本与扩展性的最佳平衡,成为了一个亟待解决的问题。在LLM推理的战场上,GPU的性能表现直接关乎任务的成败。针对不同规模的LLM推理需求,我们可以从NVIDIA的GPU产品线中挑选出最适合的型号。

finehoo_andy的博客 1479

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

一文读懂大型语言模型LLM

在当今的技术世界中,人工智能正以前所未有的速度发展和演变。这一领域的快速发展得益于先进的机器学习算法、海量数据的可用性以及计算能力的显著提升。特别是,在自然语言处理(NLP)领域,AI的进步已经让计算机不仅能理解人类语言的基本结构,还能在更深层次上把握其语义和情感。这种能力的核心在于大型语言模型(大语言模型),如GPT和Gemini,它们通过分析和处理大量文本数据,能夠生成流畅、准确且具有上下文关联性的语言输出。这些模型的强大之处在于它们的多功能性和适应性,能够被应用于从简单的文本生成到复杂的对话系统和文本

2401_85325519的博客 981

一文带你搞清:自然语言处理(NLP)与大型语言模型(LLM)的核心差异解析

一文带你搞清:自然语言处理(NLP)与大型语言模型(LLM)的核心差异解析

大模型教程的博客 4884

异构计算环境下的LLM部署:whichllm对多GPU与混合架构的智能支持指南

在当今AI快速发展的时代,本地部署大型语言模型已成为开发者和研究者的重要需求。然而,面对复杂的异构计算环境——从NVIDIA、AMD、Intel到Apple Silicon的混合硬件架构,找到最适合您硬件配置的LLM模型往往令人头疼。这就是whichllm工具的用武之地:一个基于真实基准测试的智能推荐系统,帮助您在多GPU与混合架构环境下找到最佳运行的本地LLM模型。🚀 ## 🔍 为什么异构

gitblog_01022的博客 282

LLM精准记忆长序列:法律和隐私问题的探讨

大模型(LLM)是一种人工智能模型,旨在理解和生成人类语言。它们在大量的文本数据上进行训练,可以执行广泛的任务,包括文本总结、翻译、情感分析等等。LLM的特点是规模庞大,包含数十亿的参数,帮助它们学习语言数据中的复杂模式。这些模型通常基于深度学习架构,如转化器,这有助于它们在各种NLP任务上取得令人印象深刻的表现。

AI_Conf的博客 1038

【LLM部署指南】显存要多少?7B/14B/32B/72B 模型显存占用分析与通用计算公式

【LLM部署指南】显存要多少?7B/14B/32B/72B 模型显存占用分析与通用计算公式

core815的专栏 1万+
上一篇: Sample Packing:长序列 LLM 训练的 Attention 问题及优化
下一篇: 30岁决心转行,AI太香了
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值