


介绍
生成式模型是目前人工智能领域最令人着迷的方向之一,尤其是那些基于用户提示生成文本的文本生成模型。一个著名的例子是 OpenAI 的 ChatGPT,它是一个 助手模型,可以回答用户在多个主题上的问题。
在这篇文章中,我们将介绍大型语言模型(LLM)、它的工作原理,以及如何从零开始训练它。我会尽量把文章中的每个主题都讲清楚,希望大部分读者都能理解并有所收获 😁。
如果你打算运行所有代码示例,请确保你已经先导入了所需的库。
import torch
import torch.nn as nn
import torch.nn.functional as F
什么是大型语言模型(LLM)?
你可能认为LLM就是一些可以生成类似人类语言文本的模型,对吧?嗯,没错,基本上就是这样。本质上,LLM 是一种基于 Transformer 的模型,通过海量的文本数据集训练而成。它学会了理解单词和文本的含义,从而能够生成类似人类语言的文本。实际上,LLM 的功能类似于一个文本补全模型,它会基于概率预测序列中的下一个标记(token)。给定一个包含 N 个标记的序列,下一个标记可能是什么呢?

标记化(Tokenization)
在将文本数据输入模型之前,需要对其进行预处理。众所周知,计算机只能理解数字,而不能像人类一样直接理解文本。因此,我们需要将文本转换为数值表示。
分词器(Tokenizer) 是一种算法,它将原始文本拆分为一系列单词,也被称为 标记(tokens)。每个单词会被映射到模型的词汇表中,而词汇表存储了模型“认识”的所有单词。
对于词汇表中的每个标记,都会分配一个整数表示。这样,每个单词都会被转换为一个整数。

文本标记化过程(作者提供的图片)。
在构建分词器时没有固定的规则。文本标记化有多种方法。我们可以按字符级别标记化,将每个字符单独标记化;也可以按单词级别标记化,将文本拆分为有意义的字符序列。请注意,标记化的方法会影响模型训练时的表现。这是因为标记化的方式决定了模型如何理解文本。如果使用不良的标记化方法,模型对文本的理解也会变差。
如果你不想在这一步花费太多时间,可以使用现成的库来完成这项任务。目前最著名的两个库是 OpenAI 的 TikToken 和 Google 的 SentencePiece。你可以在它们的 GitHub 仓库中查看更多细节。
以下是一个简单的字符级标记化分词器的代码实现:
class Tokenizer:
    @staticmethod
    def create_vocab(dataset):
        """
        从数据集创建词汇表。

        参数:
            dataset (str): 用于创建字符词汇表的文本数据集。

        返回:
            Dict[str, int]: 字符词汇表。
        """
        vocab = {
            token: index
            for index, token in enumerate(sorted(list(set(dataset))))
        }
        vocab["<unk>"] = len(vocab)
        return vocab

    def __init__(self, vocab):
        """
        初始化分词器。

        参数:
            vocab (Dict[str, int]): 词汇表。
        """
        self.vocab_encode = {str(k): int(v) for k, v in vocab.items()}
        self.vocab_decode = {v: k for k, v in self.vocab_encode.items()}

    def encode(self, text):
        """
        对字符级文本进行编码。

        参数:
            text (str): 要编码的输入文本。

        返回:
            List[int]: 包含标记索引的列表。
        """
        return [self.vocab_encode.get(char, self.vocab_encode["<unk>"]) for char in text]

    def decode(self, indices):
        """
        解码标记索引列表。

        参数:
            indices (List[int]): 标记索引的列表。

        返回:
            str: 解码后的文本。
        """
        return "".join([self.vocab_decode.get(idx, "<unk>") for idx in indices])
嵌入(Embedding)
虽然我们已经将文本中的单词和字符转换成了数值表示,但这些数值还不能直接输入到神经网络中。尽管计算机能够“读取”和“理解”文本,但单一的数值不足以捕捉它们的真实含义。让我们来分析以下几个单词:
Woman(女人)、Fruit(水果)、Vehicle(交通工具)、Car(汽车)、Animal(动物)
这些单词之间存在差异,但如果尝试用空间可视化它们的关系或相似性,我们可能会看到如下分布:

基于单词关系和相似性的分布(作者提供的图片)。
虽然这些单词大多数是完全不同的,但 Car(汽车)和 Vehicle(交通工具)却非常相似,因为汽车本质上是一种交通工具。这就是它们在空间中相互靠近的原因。而其他单词则分布在整个空间,因为它们之间没有任何相似性。
然而,这种理解是人类的认知方式。现在,试着向计算机解释这个概念。计算机只看到每个单词的一个数值表示,很难理解它们之间的关系。因此,我们需要一种能够更有效捕捉单词含义的替代表示方式,而这就是嵌入层的作用。
嵌入(Embedding)是标记的向量表示,由可学习的参数构成,这些参数在训练过程中会不断调整,以改进单词的表示。那么,如何将一个数字转换为一个向量呢?可以将嵌入层想象成一个查找表(lookup table),其中有行和列。行对应于模型的词汇表大小,列则表示每个标记的向量大小。
例如,在数据集中,“person”(人)这个单词经过标记化后变成了数字“153”。这个数字会作为查找表的行索引。当找到与该索引对应的行时,就能提取到存储在那里的向量。

嵌入层查找表的简单示意图(作者提供的图片)。
这里,我们有一个嵌入层,共 N 行,每行对应一个标记的向量表示。向量的大小可以由我们自行决定。更大的向量可以学习并捕捉数据集中更多的细节,但计算开销更大。相对较小的向量计算成本更低,但对于词汇量大的复杂数据集来说,可能在训练中表现较差。此外,模型可能无法捕捉到数据的重要细节。嵌入层的“最佳”大小因数据集而异。
嵌入层的一个有趣之处在于,它能够根据输入神经网络的文本学习如何在连续的向量空间中表示单词的意义。之后,我们的模型便可以理解文本中单词的含义。回到之前关于单词相似性的例子,如果我们尝试比较两个训练后的向量,可以使用距离度量来计算它们的相似度!通常使用**余弦距离(cosine distance)**来解决这个问题。
Transformers

Transformer 架构图
正如之前提到的,LLM 是一个基于 Transformer 的模型。这种架构最初是为了解决语言翻译问题而设计的。它由一个 Encoder 和 Decoder 模块组成,使用了一种名为 Scaled Dot-Product Attention 的注意力机制,用来计算上下文中词元之间的关系。
Encoder 和 Decoder 模块的工作方式完全不同。简而言之,Encoder 模块会在分析每个单词时考虑整个文本上下文。而 Decoder 模块在 t 位置会屏蔽所有未来的单词,仅使用当前可用的前置单词来分析当前词元。整个 Transformer 的核心模块是注意力机制,叫做 Multi-Head Attention,这也是整个 LLM 架构的关键部分。接下来我们会构建它,但在此之前,让我们先准备数据,并让其可以输入模型。
以这句话为例:“Hi! My name is Matheus.”。首先,我们需要将文本转换为数值表示。为此,我们需要将文本拆分成一个单词列表,如下所示:
“Hi”,“!”,“My”,“name”,“is”,“Mat”,“he”,“us”,“.”“Hi”, “!”, “My”, “name”, “is”, “Mat”, “he”, “us”, “.”
你可能会想:“为什么要这样拆分文本?” 这里我使用了 TikTokenizer 网站中的 cl100k_base 分词器。然后,我们需要将这些字符串转换为数字。cl100k_base 分词器给了我以下的词元:
13347,0,3092,836,374,7011,383,355,1313347, 0, 3092, 836, 374, 7011, 383, 355, 13
每个词元都会作为嵌入层的索引。假设嵌入的向量表示只有 5 个参数。那么,对于每个数字,我们将其替换为一个长度为 5 的向量。
[0.54881350.715189370.602763380.544883180.4236548[0.5488135 0.71518937 0.60276338 0.54488318 0.4236548
0.645894110.437587210.8917730.963662760.383441520.64589411 0.43758721 0.891773 0.96366276 0.38344152
0.791725040.528894920.568044560.925596640.071036060.79172504 0.52889492 0.56804456 0.92559664 0.07103606
0.08712930.02021840.832619850.778156750.870012150.0871293 0.0202184 0.83261985 0.77815675 0.87001215
0.978618340.799158560.461479360.780529180.118274430.97861834 0.79915856 0.46147936 0.78052918 0.11827443
0.639921020.143353290.944668920.521848320.414661940.63992102 0.14335329 0.94466892 0.52184832 0.41466194
0.264555610.774233690.456150330.568433950.01878980.26455561 0.77423369 0.45615033 0.56843395 0.0187898
0.61763550.612095720.6169340.943748080.68182030.6176355 0.61209572 0.616934 0.94374808 0.6818203
0.35950790.437031950.69763120.060225470.666766720.3595079 0.43703195 0.6976312 0.06022547 0.66676672]
我们得到了一个大小为 (9,5) 的向量,其中 9 表示上面列表中的每个词元,而 5 是嵌入向量的大小。这将是注意力机制的输入数据。
注意力机制

注意力机制图示
注意力机制指的是 Scaled Dot-Product Attention。如图所示,我们有三个输入数据,分别是 Query、Key 和 Value。在文本生成任务中,它们来源于同一个数据源。接下来我们会实际操作它们。
每个 Q、K 和 V 都是通过嵌入文本的线性变换生成的。先忽略第二个叫做 Multi-Head Attention 的模块,专注于第一个模块。我们会将嵌入后的文本输入 Query、Key 和 Value 的线性层。在这个例子中,每个层都会接收一个大小为 (9,5) 的向量,并生成一个同样大小的新向量。所以现在我们有了三个新的数据表示。
第一步操作是对 Query 和 Key 进行矩阵乘法。你可能会问:“什么是 Query 和 Key?” 简单来说,Query 是你要寻找的信息,而 Key 是你存放这些信息的地方。想象你在图书馆找一本书:这就是我们的 Query。而书可能存放在书架上:在这个场景中,这就是我们的 Key。
这里,我们试图找到上下文中所有词元之间的关系。

上下文中词元之间的关系
Query 和 Key 都是 (9,5) 的向量。在矩阵乘法中,我们将一个矩阵的列乘以另一个矩阵的行。所以我们需要确保 Query 的列数与 Key 的行数一致。为此,我们需要先对 Key 矩阵转置,然后再与 Query 相乘。
Q = (9,5)
K = (9,5)
QK = Q * K.t = (9,9)

通过 Query 和 Key 生成的注意力矩阵。
注意力的缩放
在计算词元之间的关系后,我们将结果输入到一个 Softmax 函数中,使每行的值归一化为 0 到 1,且每行的总和为 1。但在此之前,我们需要将其除以 sqrt(emb_dim)(嵌入维度的平方根),以避免极端值传递给 Softmax,从而导致 one-hot 向量的问题。这听起来合理吗?来看一个例子。
假设我们有一个大小为 (1,25) 的张量,值如下:
0.95008842 -0.15135721 -0.10321885 0.4105985 0.14404357 1.45427351 0.76103773 0.12167502 0.44386323 0.33367433 1.49407907 -0.20515826 0.3130677 -0.85409574 -2.55298982 0.6536186 0.8644362 -0.74216502 2.26975462]]
这个张量是一个正态分布,这意味着其方差接近 1,均值接近 0(实际上,我们需要增加数值数量才能更准确地观察均值和方差)。假设这个张量是 *Q * K.t* 的结果。应用 Softmax 后,得到的结果为:
0.03957302 0.01315369 0.01380237 0.02307288 0.01767414 0.06551851 0.03275635 0.01728319 0.0238533 0.02136456 0.06817911 0.0124647 0.02092881 0.00651406 0.00119133 0.02942009 0.03632461 0.00728556 0.14808906]]
最高值 (2.26975462) 在 Softmax 转换后变为 0.14808906,而最低值 (-2.55298982) 变为 0.00119133。将这些值相加的结果正好是 1。现在,将这些值乘以 10,并假设 *Q * K.t* 的乘积返回了这个放大后的张量,再次应用 Softmax 看看结果。
[0.0022186 0.00016123 0.00044072 0.01128264 0.00324955 0.00000171
0.00039646 0.00002168 0.00002284 0.00017889 0.00009862 0.00208436
0.00028859 0.00009358 0.00018383 0.00013984 0.00220362 0.00001933
0.00013059 0.00000404 0.00000003 0.00023188 0.00036785 0.00000735
0.9781891 ]]
极端值(最高值和最低值)在 Softmax 后差异会更大。最高值 (22.69754622) 在 Softmax 转换后变为 0.9781891,而最低值 (-25.5298982) 变为 0.00000003。这说明我们应用 Softmax 的目标是让分布更加平滑,但由于值被放大了 10 倍,导致高值更高,低值更低。类似的情况可能会发生在大小为 (9,9) 的注意力矩阵中,因此我们将结果除以 sqrt(emb_dim) 以解决这个问题。
下一步:实现代码,用 PyTorch 写一个自定义的 Attention Module。
注意力掩码
回到上面展示文本 “Hi! My name is Matheus.” 的注意力矩阵的图片,我们可以看到,我们对所有的标记(tokens)计算了注意力。这是Transformers的注意力机制中一个有趣的点,因为实际上我们是在尝试预测序列中的每一个标记,而不仅仅是最后一个。所以即使上下文少于预期,我们的大型语言模型(LLM)仍然可以高度自信地预测序列的下一个标记。
但是,在LLM的训练阶段,我们希望根据一段标记序列作为上下文来预测下一个标记。为此,我们需要只考虑前一个标记来预测下一个,对吗?然而这里出现了一个问题,因为我们并没有这么做,而是在注意力机制的最终阶段仅仅考虑了整个文本。换句话说,整个注意力矩阵被用于通过 attention * V 计算数据的新表示形式。为了解决这个问题,我们需要隐藏所有样本的后续标记。我们通过使用三角掩码并将其应用到注意力矩阵上来实现这一点。

注意力掩码(图片由作者提供)。
让我们在 Pytorch 中实现这个 注意力机制,并实际运行一下!如果你愿意,可以在 Google Colab 上运行这段代码。
torch.random.manual_seed(seed=1234)

text = "Hi! My name is Matheus."
tokens = [13347, 0, 3092, 836, 374, 7011, 383, 355, 13]

vocab_size = max(tokens) + 1
emb_dim = 5
context = len(tokens)

embedding = nn.Embedding(num_embeddings=vocab_size, embedding_dim=emb_dim)
query = nn.Linear(in_features=emb_dim, out_features=emb_dim, bias=False)
key = nn.Linear(in_features=emb_dim, out_features=emb_dim, bias=False)
value = nn.Linear(in_features=emb_dim, out_features=emb_dim, bias=False)

ones = torch.ones(size=[context, context], dtype=torch.float)
mask = torch.tril(input=ones)

t_tokens = torch.tensor(data=tokens).unsqueeze(dim=0)
x = embedding(t_tokens)

B, T, C = x.size()
Q = query(x)
K = key(x)
V = value(x)

QK = Q @ K.transpose(-2, -1) * C**-0.5
attention = QK.masked_fill(mask[:T,:T] == 0, float("-inf"))
attention = F.softmax(input=attention, dim=-1)

out = attention @ V

print(out.size())
位置编码
我们都知道,句子中单词的顺序非常重要。这是因为,在某些情况下,文本的最终意义可能会因为单词的排列方式而发生变化,尤其是某些单词的意义会依赖于它们在文本中的分布。
理论上,如果我们改变标记序列的顺序,那么这些标记的表示形式可能也会有所不同,对吧?但如果你先打印变量 x,然后取消注释第11行代码以反转整个标记序列,再次打印变量 x,你会发现,即使标记的顺序发生了改变,其意义仍然是一样的。换句话说,如果我们改变标记的顺序,其向量表示形式必须不同。
位置编码通过为每个位置编码一个固定值来尝试解决这一问题。这可以通过一个嵌入层(embedding layer)实现,该层会学习如何对文本的每个位置进行编码。这个编码会与文本的嵌入表示相加,然后作为输入提供给模型。
torch.random.manual_seed(seed=1234)

text = "Hi! My name is Matheus."
tokens = [13347, 0, 3092, 836, 374, 7011, 383, 355, 13]

vocab_size = max(tokens) + 1
emb_dim = 5
context = len(tokens)

pe = nn.Embedding(num_embeddings=context, embedding_dim=emb_dim)
embedding = nn.Embedding(num_embeddings=vocab_size, embedding_dim=emb_dim)
query = nn.Linear(in_features=emb_dim, out_features=emb_dim, bias=False)
key = nn.Linear(in_features=emb_dim, out_features=emb_dim, bias=False)
value = nn.Linear(in_features=emb_dim, out_features=emb_dim, bias=False)

ones = torch.ones(size=[context, context], dtype=torch.float)
mask = torch.tril(input=ones)

indices = torch.arange(context, dtype=torch.long)

t_tokens = torch.tensor(data=tokens).unsqueeze(dim=0)
x = embedding(t_tokens)
x = pe(indices) + x

B, T, C = x.size()
Q = query(x)
K = key(x)
V = value(x)

QK = Q @ K.transpose(-2, -1) * C**-0.5
attention = QK.masked_fill(mask[:T,:T] == 0, float("-inf"))
attention = F.softmax(input=attention, dim=-1)

out = attention @ V

print(out.size())
如果你尝试运行这段代码并再次打印变量 x,你会发现,当我们改变标记的顺序时,其意义也随之改变。
以下是结合嵌入层和注意力模块的最终代码:
class Embedding(nn.Module):
    def __init__(self, vocab_size, embedding_dim):
        """
        初始化带位置编码的嵌入层。

        参数:
            vocab_size (int): 词汇表大小。
            embedding_dim (int): 词嵌入的维度。
        """
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embedding_dim)
        self.pe = nn.Embedding(vocab_size, embedding_dim)

    def forward(self, x):
        """
        嵌入层的前向传播。

        参数:
            x (torch.Tensor): 输入张量,形状为 (batch_size, seq_len)。

        返回:
            torch.Tensor: 输出张量,形状为 (batch_size, seq_len, embedding_dim)。
        """
        word_emb = self.embedding(x)
        word_pe = self.pe(x)
        return word_emb + word_pe

class AttentionBlock(nn.Module):
    def __init__(self, embedding_dim, context_size):
        """
        初始化注意力模块。

        参数:
            embedding_dim (int): 词嵌入的维度。
            context_size (int): 上下文窗口大小。
        """
        super().__init__()
        self.query = nn.Linear(embedding_dim, embedding_dim, bias=False)
        self.key = nn.Linear(embedding_dim, embedding_dim, bias=False)
        self.value = nn.Linear(embedding_dim, embedding_dim, bias=False)

        ones = torch.ones(size=[context_size, context_size], dtype=torch.float)
        self.register_buffer(name="mask", tensor=torch.tril(input=ones))

    def forward(self, x):
        """
        注意力模块的前向传播。

        参数:
            x (torch.Tensor): 输入张量,形状为 (batch_size, seq_len, embedding_dim)。

        返回:
            torch.Tensor: 新的嵌入表示,形状为 (batch_size, seq_len, embedding_dim)。
        """
        B, T, C = x.size()

        query = self.query(x)
        key = self.key(x)
        value = self.value(x)

        qk = query @ key.transpose(-2, -1) * C**-0.5
        attention = qk.masked_fill(self.mask[:T,:T] == 0, float("-inf"))
        attention = F.softmax(input=attention, dim=-1)

        out = attention @ value
        return out
多头注意力机制
与执行单一的注意力块不同,我们可以并行执行多个注意力块,然后将它们的结果连接起来。实际上,每个 Head (注意力块)都有独立的可学习参数,它们会同时尝试找到关于数据的不同相关信息。需要注意的是,每个 Head 会计算输入到注意力块的嵌入的一个部分,并且 Head 的数量必须可以被嵌入大小整除。
class MultiAttentionBlock(nn.Module):

    def __init__(self, embedding_dim, num_heads, context_size):
        """
        Initialize the MultiAttentionBlock layer.

        Args:
            embedding_dim (int): Dimensionality of the word embeddings.
            num_heads (int): Number of attention heads.
            context_size (int): Size of the context window.
        """
        super().__init__()

        # Checking number of heads
        head_dim = embedding_dim // num_heads
        assert head_dim * num_heads == embedding_dim, "Embedding dimension must be divisible by number of heads"

        self.attention = nn.ModuleList(modules=[AttentionBlock(embedding_dim, head_dim, context_size) for _ in range(num_heads)])
        self.linear = nn.Linear(in_features=embedding_dim, out_features=embedding_dim)

    def forward(self, x):
        """
        Forward pass of the MultiAttentionBlock layer.

        Args:
            x (torch.Tensor): Input tensor of shape (batch_size, seq_len, embedding_dim).

        Returns:
            torch.Tensor: New embedding representation of shape (batch_size, seq_len, embedding_dim).
        """
        out = torch.cat(tensors=[attention(x) for attention in self.attention], dim=-1)
        x = self.linear(x)
        return x
为防止诸如梯度消失的问题,我们通常在多头注意力块之后应用跳跃连接。然后,我们会应用批量归一化,并引入全连接神经元,以帮助模型在将信息传递到下一个注意力块之前处理从上一块提取的有用信息。上图的 Transformer 图解展示了该工作流的运行方式。
class FeedForward(nn.Module):

    def __init__(self, embedding_dim, ff_dim):
        """
        Initialize the feed forward layer.

        Args:
            emb_dim (int) : The dimension of the embedding.
            ff_dim (int) : The dimension of the feed forward layer.
            dropout_rate (float) : The dropout rate. (default: 0.2)
        """
        super().__init__()
        self.linear_1 = nn.Linear(embedding_dim, ff_dim)
        self.relu = nn.ReLU()
        self.linear_2 = nn.Linear(ff_dim, embedding_dim)


    def forward(self, x):
        """
        Forward pass of the feed forward layer.

        Args:
            x (torch.Tensor) : The input tensor.

        Returns:
            torch.Tensor : The output tensor.
        """
        x = self.linear_1(x)
        x = self.relu(x)
        x = self.linear_2(x)
        return x

class DecoderLayer(nn.Module):

    def __init__(self, embedding_dim, head_dim, context_size, ff_dim):
        """
        Initialize the decoder layer.

        Args:
            embedding_dim (int): Dimensionality of the word embeddings.
            head_dim (int): Dimensionality of each head.
            context_size (int): Size of the context window.
            ff_dim (int): Dimensionality of the feed-forward layer.
        """
        super().__init__()
        self.attention = MultiAttentionBlock(embedding_dim, head_dim, context_size)
        self.feed_forward = FeedForward(embedding_dim, ff_dim)
        self.norm_1 = nn.LayerNorm(normalized_shape=embedding_dim)
        self.norm_2 = nn.LayerNorm(normalized_shape=embedding_dim)

    def forward(self, x):
        """
        Forward pass of the decoder layer.

        Args:
            x (torch.Tensor) : The input tensor.

        Returns:
            torch.Tensor : The output tensor.
        """
        x_norm = self.norm_1(x)
        attention = self.attention(x_norm)
        attention = attention + x

        attention_norm = self.norm_2(attention)
        ff = self.feed_forward(attention_norm)
        ff = ff + attention

        return ff
数据集
使用的数据集是 Medium 文章,来自 Kaggle 的一个公共数据集。它包含了大约 19 万篇 Medium 文章,每篇文章都包含标题及与之相关的正文内容。总体来说,我并不期待模型能够生成与世界上每一个主题相关的文本。所用数据集的内容局限于某些特定主题。

数据集中文章的主题分布(图片由作者提供)。
我排除了包含非 UTF-8 字符的文章,以及基于长度条件筛选掉了一些文章,从而减少了训练样本的数量。
从零开始训练 LLM
首先,我决定从零开始训练,训练整个神经网络,包括其用于词表示的嵌入层。我的分词算法基于一个简单的正则表达式规则,按模式规则对文本进行拆分。这个正则表达式函数将字符序列与标点符号和数字分开。
接下来,我的方法是限定标题和正文的边界,明确告诉模型标题和正文分别从哪里开始和结束。随后,我为每篇文章添加了填充(padding)标记,以标准化输入模型的数据长度。
在数据预处理中,我将所有的新标记存储到一个词汇表字典中,并创建一个索引以指向新标记。我将词汇表的大小限制在 50K~80K 个标记以内,以控制嵌入层训练所需的参数数量。
为了避免模型 过拟合,我使用了一些正则化方法,例如使用 10% 的 Dropout 层以及权重衰减(Weight Decay)参数为 0.0001。训练过程运行在 RTX 4090(24GB 显存)上,持续了 15 小时。我使用 交叉熵损失(Cross-Entropy Loss)预测每个位置上的标记,并使用 准确率(Accuracy)评估生成的文本质量。

从零开始训练的 LLM 的损失曲线图
在推理过程中,模型能够很好地完成短文本的生成,但在长文本生成时,它开始重复之前预测的句子,进入无限循环。
GPT-2 预训练嵌入 + 解码器
我尝试了使用 OpenAI 的 GPT-2 的预训练嵌入层(Embedding Layer),其中包含预计算的词表示。这将训练时间缩短到仅一个小时,同时降低了训练其他部分所需的资源要求。
为此,我使用 Transformer 库加载了 GPT-2 的分词器和嵌入层。然而,我遇到了一个限制,即 GPT-2 的分词器仅包含 *<|endoftext|>* 特殊标记,这个标记仅用于标记文本的结束位置。理想情况下,我希望能够明确指定文章的起始位置,并通过填充来标准化文章长度。
鉴于此限制,我的 GPT-2 方法只是简单地将标题和正文拼接在一起,然后使用 *<|endoftext|>* 标记对文本进行填充。尽管这种方法没有明确区分文本的起始和结束,但令人惊讶的是,它取得了不错的效果。我还测试了其他分词器和嵌入模型,例如 BERT、T5 和 RoBERTa,但 GPT-2 在性能和训练时间上表现最佳。

使用 GPT-2 预训练嵌入层的 LLM 的损失曲线图(图片由作者提供)。
模型的最终结果及其文本生成性能可以在我的 GitHub 仓库 中找到。
最终总结
在本次探索中,我们深入了解了 LLM 的工作原理,并演示了从零开始构建 LLM 的过程。我的个人项目作为一个实践示例,展示了在有限硬件和专注数据集下所能实现的结果。尽管在这些限制下无法实现最佳性能,但该项目提供了宝贵的见解和改进。
该项目突出了硬件性能和数据集规模对 LLM 性能的影响。这是一次宝贵的学习经历,使我能够探索 LLM 开发中的权衡取舍。
总之,这次探索提供了 LLM 的实践入门,并展示了其开发过程中的一些注意事项。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
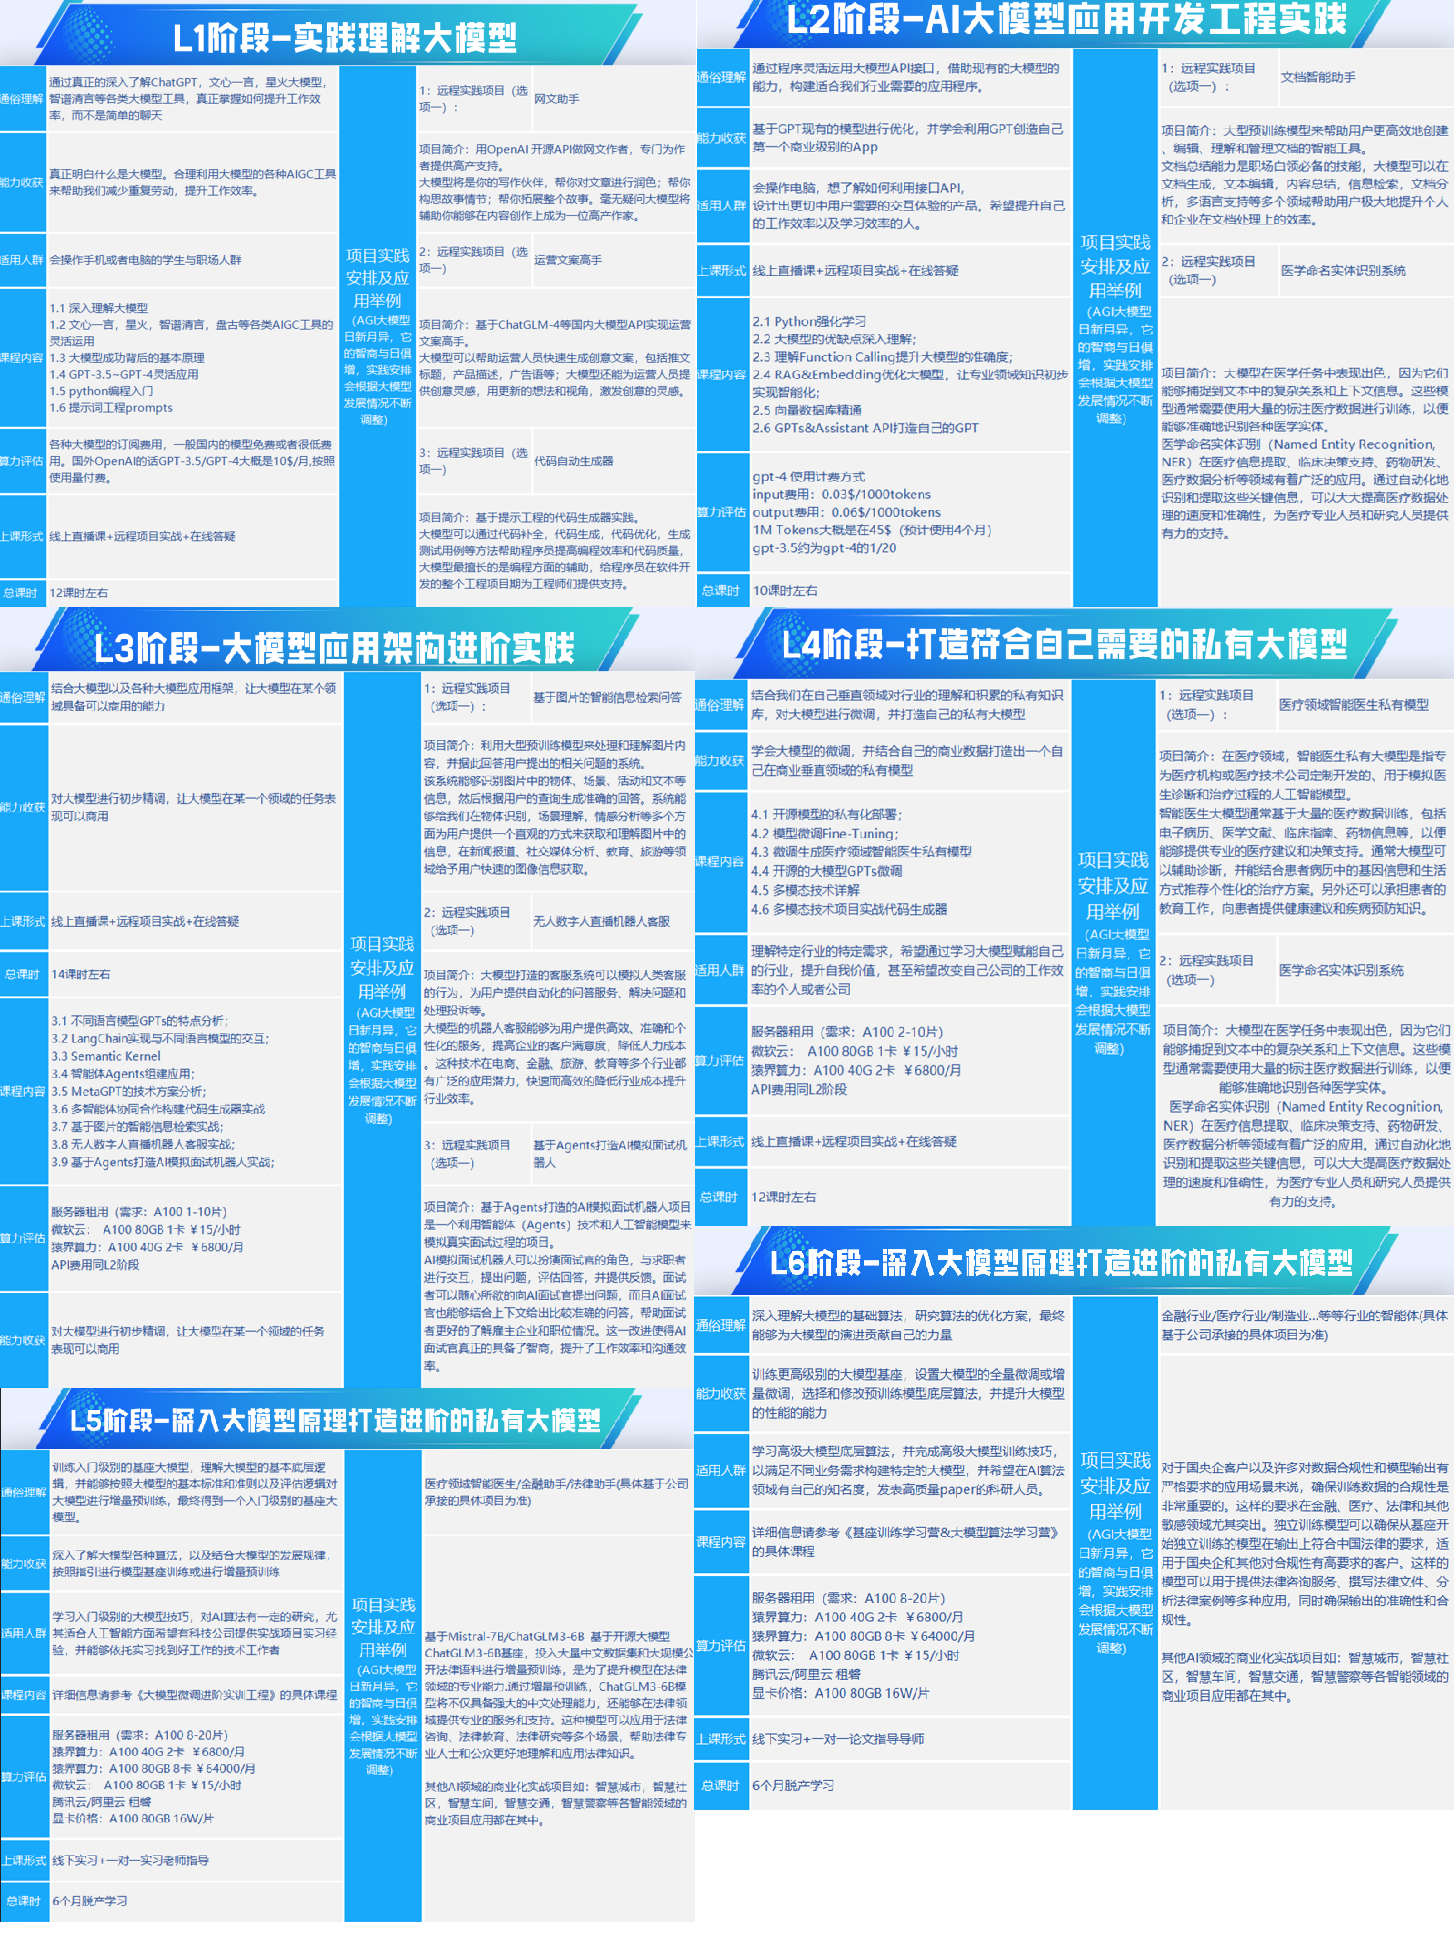
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
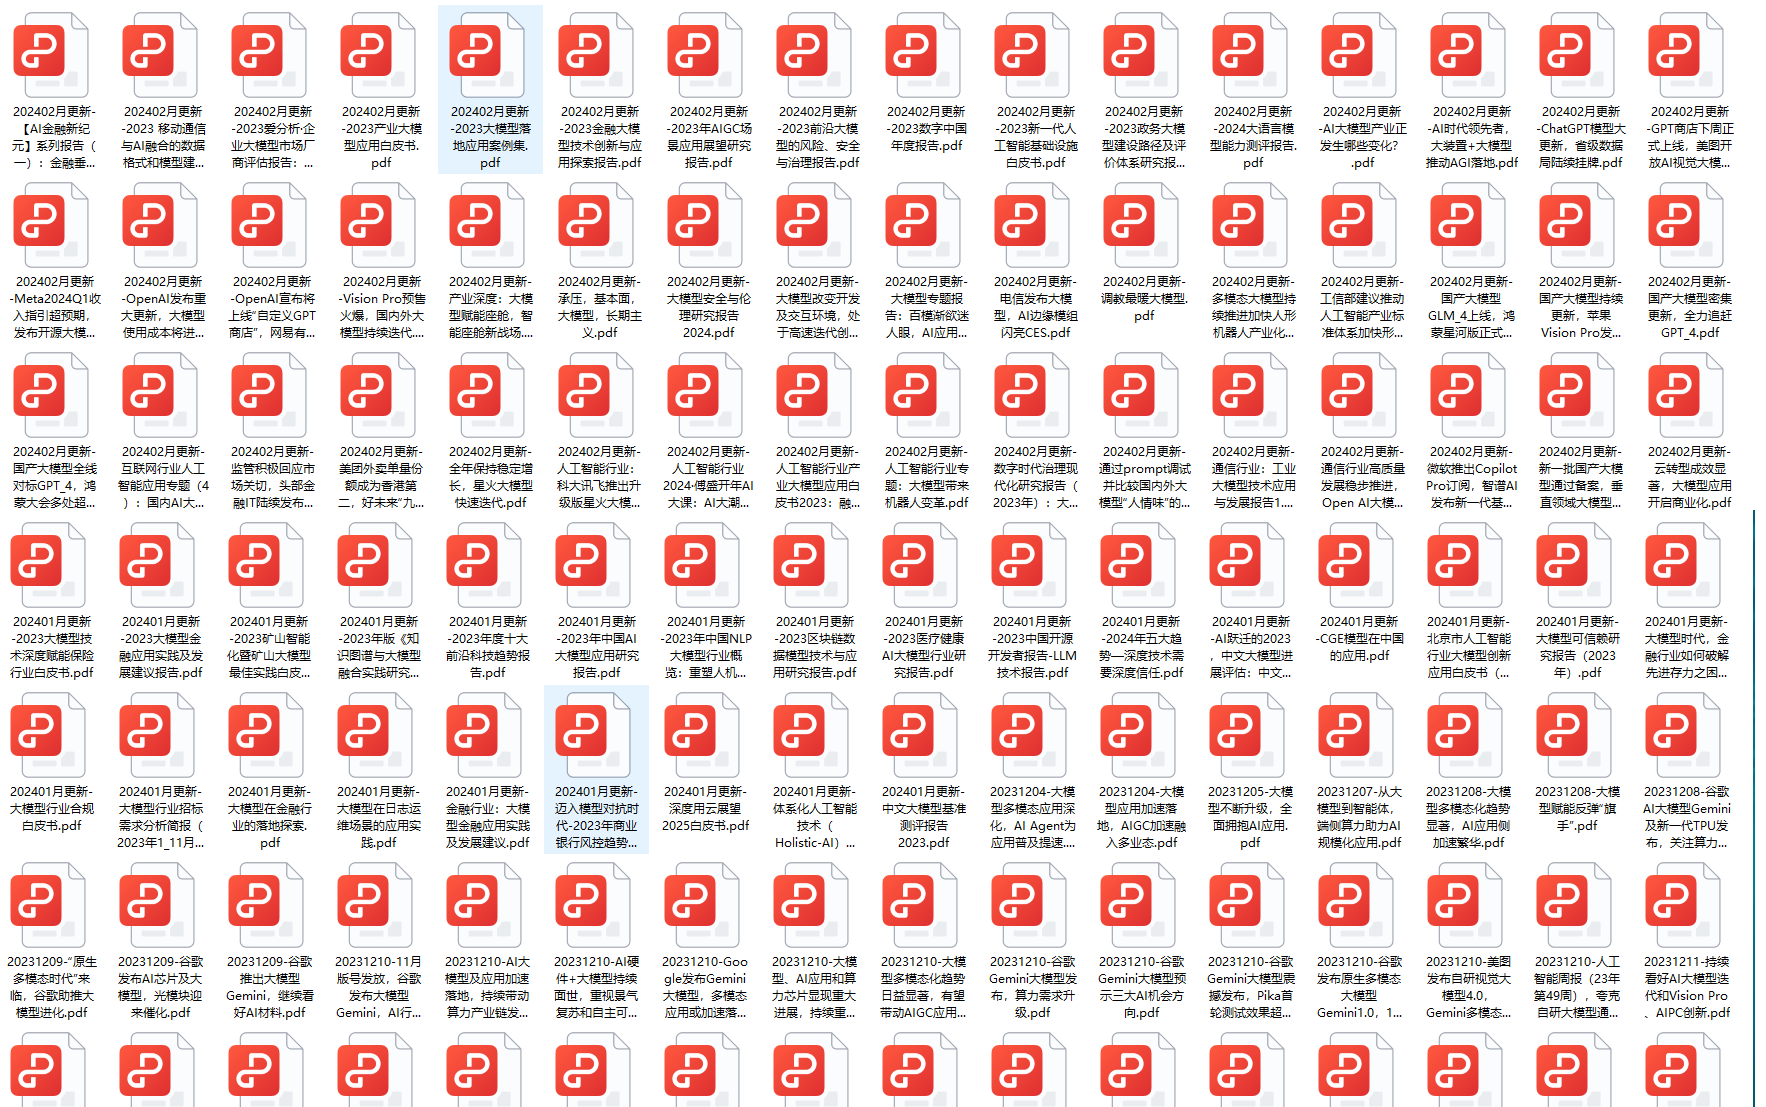
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
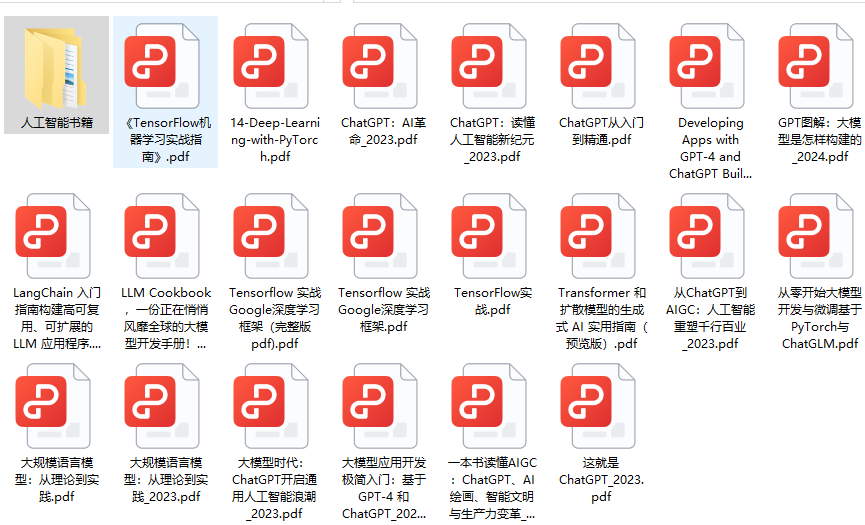
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 2708


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


