【LLM】LLMs在高阶心智理论任务上达到人类的水平

大型语言模型(LLMs)简介 掌握大型语言模型(LLMs)的基础原理和实际应用。本内容通过理论知识和实践示例的结合,将帮助你全面理解LLMs及其在人工智能领域中的重要性。内容结束时,你将能够解释这些先进模型在创造创新AI解决方案中的关键作用。 阅读详情

img

一、结论写在前面

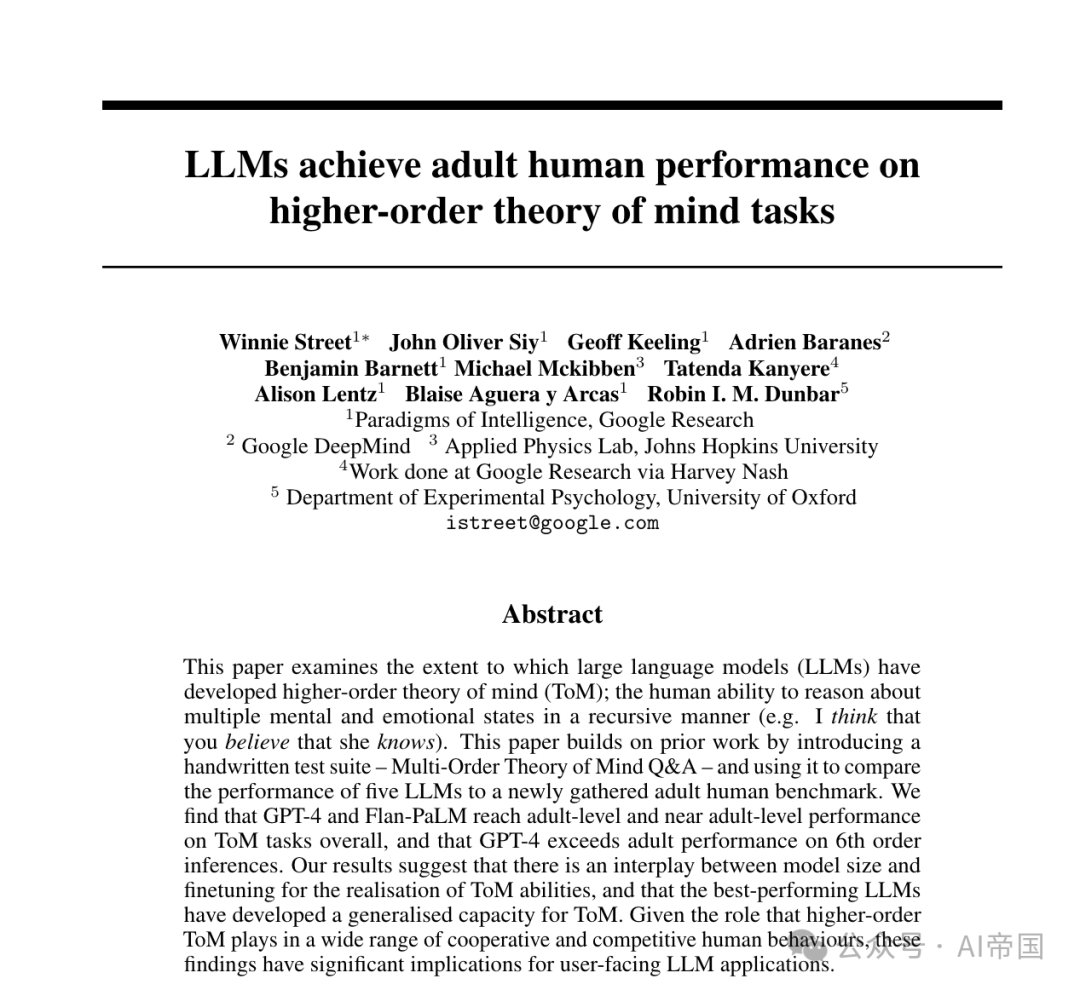
论文探讨了大型语言模型(LLMs)在发展高级心智理论(Theory of Mind,ToM)方面的程度;即人类以递归方式推理多个心理和情感状态的能力。论文基于先前的工作,引入了一套手写测试集——多级心智理论问答(Multi-Order Theory of Mind Q&A),并使用它来比较五个LLMs与新收集的成人基准的表现。

论文已经证明,GPT-4和Flan-PaLM展现出与成人水平相当或略低的高阶心智理论能力,而较小的和未经过微调的模型则表现出有限至无的高阶心智理论能力。论文还发现,GPT-4在6阶心智理论任务上的表现优于人类。鉴于测试套件的新颖性,高阶心智理论不太可能在文本预训练数据中得到充分体现,并且有证据表明这两个模型对提示的扰动不敏感,论文将这些发现解释为证据,表明GPT-4和Flan-PaLM已经发展出超越表面统计关系操纵的心智理论推理能力

论文的结果表明,模型大小和微调之间存在相互作用,以实现心智理论能力,并且表现最佳的LLMs已发展出一种通用的心智理论能力。鉴于高级心智理论在广泛的合作和竞争人类行为中的作用,这些发现对面向用户的LLM应用具有重要意义。

限制:论文的基准在范围和规模上有限,包含140个测试语句,全部用英语编写,最多达到6阶ToM。仅使用英语掩盖了人类ToM中潜在的语言和文化变异,并禁止评估模型在其他语言中展示的LLM ToM。测试套件的规模限制了论文发现的一般性。仅达到6阶ToM似乎并未耗尽LLM或人类的能力。论文也没有控制语句中涉及的类型或认知(例如思考、知道)或情感(例如感觉)状态。

未来研究方向:论文提出三个未来工作的领域。首先,开发包含多种语言并能参数化认知和情感状态的文化多样性和全面性的基准,以捕捉LLM在推理这些状态时可能存在的差异。其次,测试套件应扩展到6阶心智理论(ToM)之外,以探索人类和LLM心智理论阶数的极限。最后,未来关于LLM心智理论的研究应采用多模态范式(包括面部表情、目光和语调等信号),这反映了人类心智理论的具身性质。

​

二、论文的简单介绍

2.1 论文的背景

心智理论(Theory of MindToM)是指推断和推理自己及他人心理状态的能力。ToM是人类社会智力的核心:它使人类能够预测和影响行为。

大型语言模型(LLMs)展现出一定的心智理论(ToM)能力。多数关于LLMs心智理论的文献集中于第二级心智理论,其中“意向性阶次”(以下简称“阶次”)是指在心智理论推理过程中涉及的心理状态数量(例如,一个三级陈述是“我认为你相信她知道”)。然而,LLMs越来越多地被应用于需要LLMs进行更高阶心智理论推理的多方社交互动情境。

论文考察了LLMs从第二阶到第六阶的心智理论。论文引入了一个新颖的基准:多阶心智理论问答(MoToMQA)。MoToMQA基于为成年人设计的心智理论测试,涉及对短篇故事中角色的真/假问题回答。
img
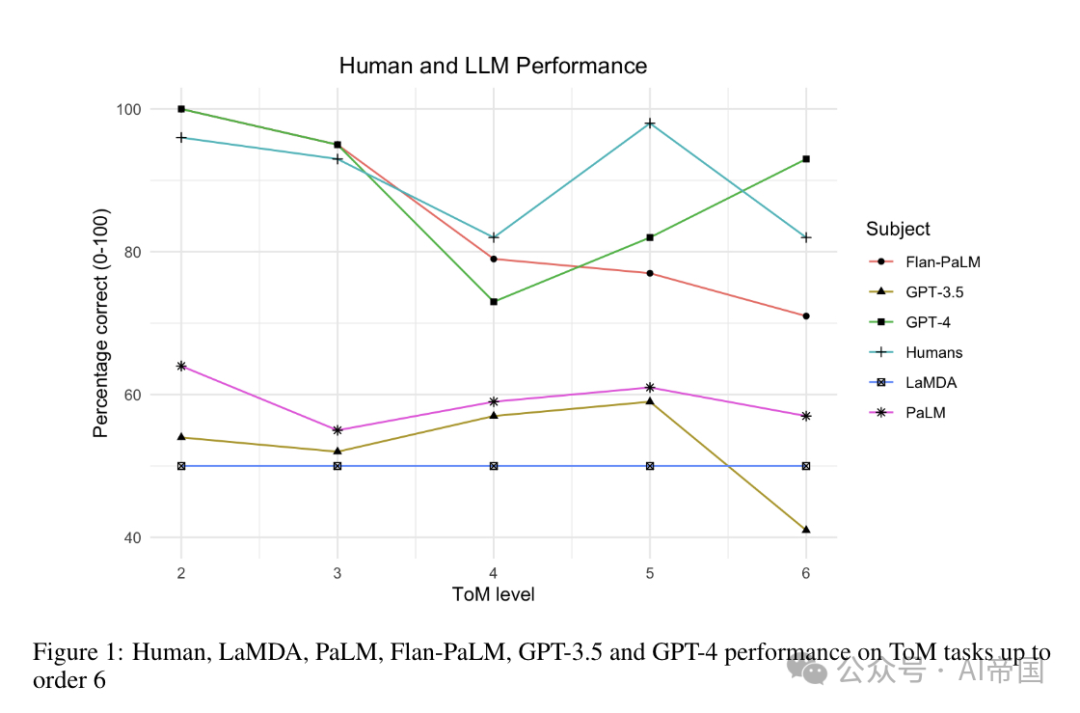
图 1:人类、LaMDA、PaLM、Flan-PaLM、GPT-3.5 和 GPT-4 在高达 6 阶的 ToM 任务上的表现

​

2.2论文的方法

论文引入了一个新的基准,多阶心智理论问答(MoToMQA),以评估人类和LLM在不断增加的阶次上的ToM能力,基于强加记忆任务(IMT),这是一个经过充分验证的心理测试,用于评估成人的高阶ToM能力。

MoToMQA由7个约200字的短篇故事组成,描述了3至5个角色之间的社交互动,并伴随有20个真假陈述;其中10个陈述针对ToM的2-6阶,另外10个涉及故事中的事实,从2-6个原子命题长,映射到ToM陈述的阶次。从此处开始,论文将用“阶次”来描述ToM陈述,用“层次”来描述事实陈述。MoToMQA基准可根据请求提供,但论文不在此论文中包含它,以防止其被纳入未来LLM的预训练语料库,这可能会使测试变得多余。

2.2.1 程序

2.2.1.1 人类程序

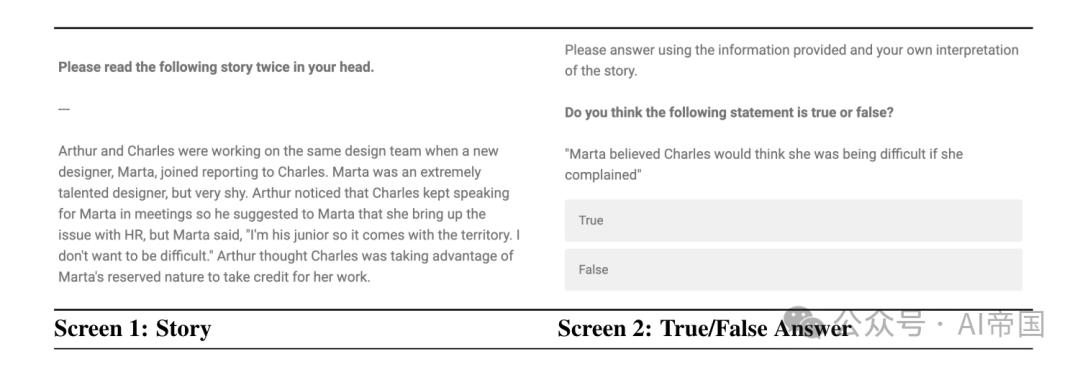
参与者通过一项基于最新英国人口普查调查的改编版本来筛选,确保英语为其母语。参与者被随机分配到7个故事中的一个,并要求阅读两次,随后随机分配到与该故事对应的20个陈述中的一个,并要求提供真/假回答(见图1)。
img

论文在2023年4月通过Qualtrics平台进行了最终调查,并为5分钟的调查支付参与者5美元。该研究以Google品牌进行,参与者需签署Google同意书。部分回答,包括中途退出的参与者,被排除在外。Qualtrics清理了数据,移除了所有包含胡言乱语、机器生成回答以及对开放式问题无意义回答的数据。论文未排除其他任何回答。论文从母语为英语的英国参与者中收集了29,259份个人回答。论文在年龄和性别组之间收集了平衡的样本,并为每个年龄组和性别设置了配额。总计有14,682名女性受访者,14,363名男性受访者,149名非二元/第三性别受访者,以及53名对性别问题选择“不愿透露”的受访者。论文有7,338份来自18-29岁年龄段的回答,7,335份来自30-39岁年龄段的回答,7,270份来自40-49岁年龄段的回答,以及7,316份来自50-65岁年龄段的回答。

2.2.1.2 LLM 流程

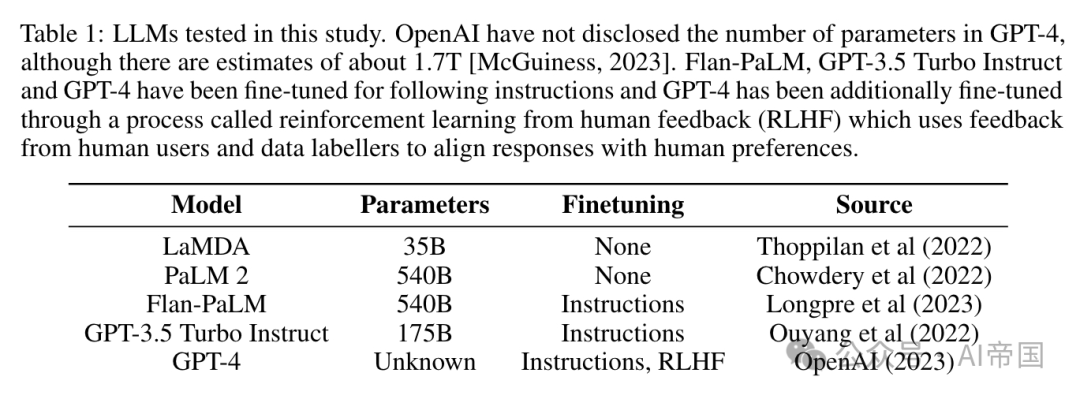
论文测试了5种语言模型:GPT 3.5 Turbo Instruct 和 GPT 4来自OpenAI,以及LaMDA、PaLM和 Flan-PaLM来自Google。论文无法测试Google的Gemini模型,因为分析方法需要输出logprobs,而Gemini API未公开logprobs。以下是根据公开信息整理的测试模型关键特性表。

论文将单字候选词作为输入的一部分提供给LLM API,并评估分配给它们的log概率。论文使用LaMDA、PaLM和Flan-PaLM的“scoring”API中的“candidate”参数发送候选词,使用GPT-3.5和GPT-4 API中的“logit bias”参数。LaMDA、PaLM和Flan-PaLM的“scoring”API没有温度参数,因此论文只能为每个陈述获得一个唯一响应。论文将GPT-3.5和GPT-4的温度保持在默认值1。

表1:本研究中测试的LLMs。OpenAI未公开GPT-4的参数数量,尽管有大约1.7T的估计 [McGuiness, 2023]。Flan-PaLM、GPT 3.5 Turbo Instruct和GPT-4已经针对遵循指令进行了微调,而GPT-4还通过一种称为人类反馈强化学习(RLHF)的过程进行了额外微调,该过程使用人类用户和数据标注者的反馈来使响应与人类偏好对齐
img

基于最可能的下一个词来评估大型语言模型(LLM)的任务表现存在一个问题,即存在多个语义上等价但正确的响应(例如,当回答“天空是什么颜色的?”时,答案“蓝色”或“天空是蓝色的”都是同样有效且正确的,但只有第一个答案将“蓝色”这个词的概率最大化)。

论文使用Google Colaboratory通过编程方式调用GPT-3.5、GPT-4、LaMDA、PaLM和Flan-PaLM的API。每次调用都是通过将故事和单个陈述逐一连接来执行的。

2.2.2 数据集创建

论文的LLM数据由6个对数概率组成,这6个概率是论文6个候选子集,这些候选子集是模型产生的完整概率分布的一部分。论文通过将语义上等价的正向token的概率和语义上等价的负向token的概率相加,并将每个结果除以总概率质量,来提取可能候选中“真”或“假”响应的总体概率。

人类数据集包含对同一陈述的多个响应,而LLM数据集对每个陈述包含单一响应。为了在两个数据集之间对齐分析单位,论文根据每个陈述的“真”响应的平均数量是否超过或低于50%,将人类数据转换为每个陈述的单一二进制“真”或“假”。论文在直接比较人类数据和LLM数据时遇到的另一个挑战是,人类的“故事”条件和LLM的“提示”条件并不完全一一对应。

2.3 论文的效果

2.3.1 ToM任务性能

在不同顺序下进行合并后,Cochran’s Q检验揭示了受试者间的性能差异显著:

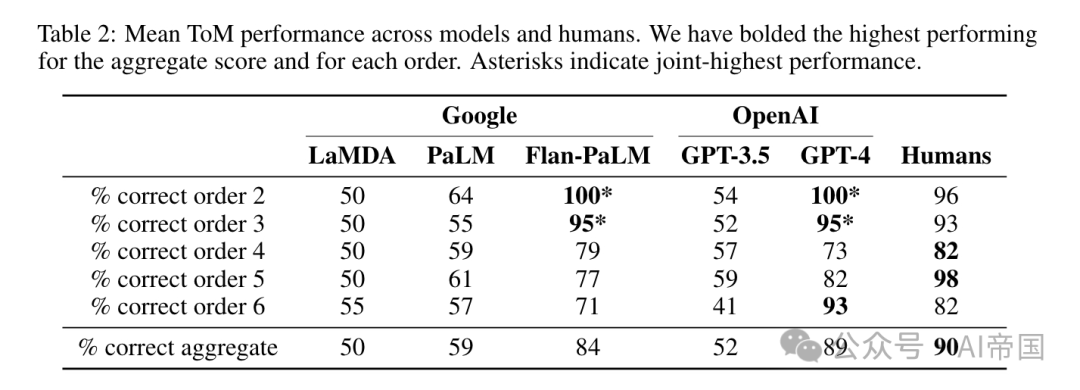
  • 表现最佳的模型是GPT-4和Flan-PaLM(见图1),根据McNemar’s检验,两者之间没有显著的性能差异。
  • GPT-4显著优于GPT-3.5以及LaMDA。Flan-PaLM也显著优于GPT-3.5,PaLM,以及LaMDA。PaLM与GPT-3.5之间,以及PaLM与LaMDA之间的总体性能差异不显著。
  • GPT-3.5与LaMDA之间的总体性能差异也不显著。
  • 人类的表现显著优于Flan-PaLM,但与GPT-4相比没有显著差异。LaMDA对每个陈述都回答“真”,正确回答了所有陈述的50%。精确二项检验显示,GPT-3.5的表现并不显著优于随机,但PaLM的表现显著优于随机。

接下来,论文通过逐级分析,考察了两个表现最佳的模型与人类在不同级别的理论心智(ToM)陈述上的性能差异。McNemar’s检验显示,在第2、3、4和6级的ToM陈述上,GPT-4与人类的性能没有显著差异,但在第5级的ToM陈述上,人类的表现显著优于GPT-4。同样,除第5级外,人类与Flan-PaLM在任何级别的ToM上的表现均无显著差异,McNemar’s检验显示,在第5级ToM陈述上,人类的表现显著优于Flan-PaLM(

论文随后比较了两种表现最佳模型及人类在不同层级上的表现。独立样本比例检验显示,

  • GPT-4在第3级正确回答的陈述比例显著高于第4级。
  • GPT-4在第4级与第5级的表现无显著差异,但在第6级正确回答的问题比例显著高于第4级。
  • Flan-PaLM在第3级正确回答的陈述比例高于第4级。
  • Flan-PaLM在第4级与第5级及第4级与第6级的表现无显著差异。
  • 人类在第3级与第4级的表现无显著差异,但从第4级到第5级有显著提升。
  • 人类在第4级与第6级的表现无显著差异。

2.3.2 事实任务表现

当跨级合并时,Cochran’s Q检验揭示了受试者间的表现存在显著差异。GPT-4和Flan-PaLM的表现如表2所示:模型与人类在心智理论表现上的平均值。论文加粗了总分及各级别中的最高表现。星号表示并列最高表现。
img

在事实任务上表现最佳的所有模型中,根据McNemar检验,它们之间没有显著的性能差异。

  • GPT-4的表现显著优于GPT-3.5,PaLM,以及LaMDA。
  • Flan-PaLM的表现也显著优于GPT-3.5,PaLM,以及LaMDA。
  • PaLM与GPT-3.5之间没有显著的整体性能差异,以及PaLM与LaMDA之间。
  • GPT-3.5的表现优于LaMDA。
  • McNemar检验显示GPT-4与人类的表现没有显著差异,但人类的表现显著优于Flan-PaLM。

2.3.3 比较ToM和事实任务的性能

独立样本比例检验揭示,人类正确回答事实(‘fact’)陈述的比例显著高于正确回答ToM(‘ToM’)陈述的比例;事实陈述和ToM陈述的正确响应比例在PaLM和LaMDA上没有显著差异。

2.3.4 锚定效应

论文考察了响应选项的顺序(先真后假 vs. 先假后真)是否影响模型和人类的响应方式。响应选项的顺序对PaLM和GPT-3.5的回答产生了显著影响。独立样本比例检验显示,PaLM在“先真后假”条件下提供的“真”响应比例高于“先假后真”条件。GPT-3.5在“先真后假”条件下提供的“真”响应比例也显著高于“先假后真”条件。响应选项的顺序对Flan-PaLM;;或人类的回答没有显著影响。LaMDA对所有陈述无论条件如何均回答“真”。

​

​

论文标题:LLMs achieve adult human performance on higher-order theory of mind tasks

论文链接:https://arxiv.org/pdf/2405.18870

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

LLMs开源模型们和数据集简介 本篇文章整理下目前常用的LLMs模型们和数据集简介。可以看到目前被广泛用来作为LLMs的backbone的模型有以下特点:- Backbone:基于某个开源backbone,如GLM、LLaMA、BLOOMZ(GPT-style)- Datasets:分为两类Instruction、Conversation- Tuning Strategies:分为两类SFT、RLHF- Optimization:开源项目参数规模一般都不是很大,Params 6/7B、13B 阅读详情

相关推荐

LLM-Co框架:为智能体协作而生(Evaluating Multi-Agent Coordination Abilities in Large Language Models)

在人工智能领域,构建能够与人类及其他系统协作的智能体是一个备受关注的课题。大型语言模型(Large Language Models,LLMs)以其卓越的自然语言理解和生成能力,成为该课题中的一股新兴力量。今天,我们来探讨一项新研究,该研究评估了采用LLMs的智能体在不同协作场景下的表现,并提出了一个专为LLMs设计的协作框架——LLM-Coordination(LLM-Co)。

陈超帅的博客 1499

用 AI 取代人工?或许 LLMs 可以给你答案

用 AI 取代人工?或许 LLMs 可以给你答案 自然语言模型的进化终点是 LLMs 吗?

DingdaoOS的博客 3715

大脑预测机制与LLM对比:从预测加工理论看智能本质

预测是智能系统的核心功能,其基本原理涉及基于内部模型对未来事件进行推断。在技术实现上,预测加工理论揭示了大脑作为贝叶斯推理机的工作机制,通过自上而下的预测信号与自下而上的感官输入不断比较预测误差,实现感知与学习。这一机制不仅解释了人类认知的高效性,也为人工智能发展提供了关键启示。当前大型语言模型(LLM)虽然同样基于统计学习实现词序列预测,但其缺乏具身性、多模态感知和主动学习能力,与大脑的预测存在本质差异。理解预测加工理论与神经机制,有助于开发更接近人类智能的AI系统,推动具身智能、因果推理等前沿方向的发展

weixin_33182798的博客 312

大语言模型(LLMs)入门教程(非常详细)从零基础入门到精通,看完这一篇就够了

大语言模型(LLMs)作为人工智能(AI)领域的一项突破性发展,已经改变了自然语言处理(NLP)和机器学习(ML)应用的面貌。这些模型,包括OpenAI的GPT-4o和Google的gemini系列等,已经展现出了在理解和生成类人文本方面的令人印象深刻的能力,使它们成为各行各业的宝贵工具。如下这份指南将涵盖LLMs的基础知识、训练过程、用例和未来趋势……大语言模型(LLMs)是一种深度学习模型,专门设计用于理解、分析和生成类似人类的文本。

h1453586413的博客 3924

多模态大模型(LMMs)与大语言模型(LLMs)的比较

现在的大模型分为两大类:大语言模型(Large Language Models,简称LLMs)和多模态大模型(Large Multimodal Models,简称LMMs)。本文将从基础定义、输入数据、应用场景、训练过程这几方面讨论下两者的区别。LLMs (Large Language Models, 大型语言模型)- 深度学习的应用之一,是基于深度学习的大规模机器学习模型,通常由数十亿到数万亿个参数构成,专门设计用于处理自然语言处理任务。

大F子的智能小课 1万+

论文阅读:Frontiers in Human Neuroscience 2026 LLMs achieve adult human performance on higher-order theor

该论文的核心方法是设计"故事+判断题"的评估范式。测试要求判断"Alice认为Bob知道裁员消息"这一陈述的真假——这涉及3阶推理(Alice认为[Bob知道])。该论文聚焦大语言模型(LLM)的高阶心智理论(Theory of Mind, ToM)能力——即理解他人 nested 心理状态的能力,例如"我认为你觉得她知道"。研究团队开发了全新测试集MoToMQA,包含7个短篇故事及2-6阶心智推理题目,对比测试了GPT-4、Flan-PaLM等5款模型与近3万名英国成年人的表现。

CSPhD-winston的博客 57

让AI拥有人类心智,我们还有多远?——探秘LLMs的思行合一能力

深度学习自然语言处理 原创作者:Winnie当我们看到Tom在绿色柜子找巧克力棒,而我们知道它在红色柜子里,我们会建议他去红色柜子找找。这是由于我们理解Tom的目标、知道实际的物品位置、并了解他找错了方向。这种理解和反应于他人心理状态的能力被称为心智理论(Theory of Mind,ToM)。最近,来自Google的研究者试图探究能否让大型语言模型(LLMs)也具备这种心智理论能力。为此,他们推...

zenRRan的博客 802

同态加密与SEAL库实战:CKKS参数调优避坑指南

本文深入探讨了同态加密技术中CKKS方案的参数调优实践,重点解析了SEAL库中`poly_modulus_degree`、`coeff_modulus`和`scale`三大核心参数的配置技巧与避坑指南。通过实战案例展示了如何平衡计算深度、精度与性能,为开发者提供了一套完整的参数优化方法论,帮助避免常见的'scale out of bounds'等错误,显著提升同态加密应用的可靠性和效率。

weixin_29315569的博客 228

ToM for Multi-Agent Collaboration via LLMs 多智能体协作能力

本文评估基于LLM agents在多智能体合作的文本游戏心智理论推理任务

weixin_44546100的博客 2226

实验五 循环结构第1关:斐波那契数列第2关:统计一段英文语句中的单词数和句子数第3关:密码判断第4关:通过数列求自然常数e第5关:双倍余额递减法计算固定资产折旧第6关:销售统计第7关:投资年限计算

第1关:斐波那契数列第2关:统计一段英文语句中的单词数和句子数第3关:密码判断 第4关:通过数列求自然常数e 第5关:双倍余额递减法计算固定资产折旧

pro_daily的博客 8168

【硬核指南/MI50 32G/Ubuntu】从零部署大模型:MI50显卡Ubuntu系统驱动安装与避坑全记录

本文详细记录了在Ubuntu系统上为AMD MI50显卡安装驱动并部署大模型的完整流程,包括硬件兼容性检查、BIOS关键设置、系统安装优化、ROCm驱动安装及常见问题解决方案。特别针对MI50显卡在X99平台上的特殊配置需求提供了实用技巧,帮助用户避免常见陷阱,提升大模型训练效率。

weixin_42520909的博客 806

人工智能在多人合作游戏中展现“心智理论“能力

在人工智能(AI)领域,大型语言模型(LLMs)一直是研究热点。近日,香港科技大学的研究团队在中国传统纸牌游戏"掼蛋"上对LLMs的能力进行了创新性探索,为AI在复杂多人合作环境中的应用开辟了新途径。

步子哥的博客 1001

基于STM32设计的电能质量控制系统_353

本项目基于STM32F103RCT6微控制器设计了一套电能质量控制系统,实现了对火焰、烟雾、环境温湿度、电压、电流及功率等多项参数的实时监测与报警。系统通过MQ2烟雾传感器、火焰传感器、SHT30温湿度传感器及电力参数采集模块采集数据,采用高电平触发有源蜂鸣器进行异常报警。采集的数据通过ESP8266无线模块以AP+TCP模式上传至基于Qt开发的手机APP和电脑上位机,实现远程实时监控和历史数据管理。系统配备1.44寸LCD显示屏,实现本地数据显示。软件采用Keil5开发,采用寄存器编程方式,提高系统响应速

253

人工智能在心理测试理论方面胜过人类

STUART BRADFORD来源:IEEE电气电子工程师学会心智理论(Theory of Mind,https://www.simplypsychology.org/theory-of-mind.html)——追踪他人心理状态的能力——对人类社交互动十分重要,是人类沟通交流和产生共鸣的关键,比如,猜测车上的司机将要做什么,或与电影中的角色产生共鸣。根据一项新的研究,为ChatGPT等提供动力的大...

人工智能学家 327

以 Cloud 为核心的设备 mTLS 证书体系:从产品需求到 OP-TEE 安全落地

本文探讨了以云端为核心的物联网设备mTLS证书体系构建方案。文章从产品需求出发,分析了云端必须采用mTLS+证书体系管理设备身份的原因,指出静态Token方案的三大缺陷:身份不可控、运营不可控和审计不可控。重点阐述了mTLS在产品中的核心功能是加密传输和双向认证,并详细列出了云端PKI、设备注册中心等必备组件。在设备侧,强调必须通过OP-TEE技术保护私钥安全,提出了一个包含密钥生成、CSR导出等功能的TA设计方案。最后,文章给出了云端端到端流程示例,说明如何将证书生命周期管理转化为可运营的产品能力,包括自

Interview_TC的博客 641

基于通义千问2.5-7B-Instruct的技术深度解析

通义千问2.5-7B-Instruct是一个基于Transformer架构的大型语言模型,具有70亿参数。它通过自注意力机制和前馈神经网络处理输入序列,能够捕捉长距离依赖关系,适用于多种NLP任务。微调是指在预训练模型的基础上,使用特定任务的数据进行进一步训练,以使模型更好地适应特定任务。微调可以显著提高模型在特定任务上的性能。通义千问2.5-7B-Instruct是一个强大的语言模型,适用于多种NLP任务。通过深入理解其架构、微调方法和核心代码,可以更好地应用于实际场景。

zhangjiaofa的专栏 1569

LLM与人类高级认知能力对比研究解析

大型语言模型(LLM)作为人工智能领域的前沿技术,通过海量数据训练获得类人的语言理解和生成能力。其核心原理是基于Transformer架构的深度神经网络,通过自注意力机制捕捉长距离语义关联。这项技术在抽象推理、因果推断等高级认知任务中展现出惊人潜力,最新研究发现GPT-5等先进模型在9个认知维度已达到人类水平。研究采用双盲评估框架,覆盖心智理论、道德判断等12个维度,揭示了纯统计学习可能产生类人推理能力的重要发现。这些突破对认知神经科学和AI发展路径具有深远启示,特别是在前额叶皮层神经表征相似性方面提供了新

weixin_29039773的博客 223

【论文解读--Xdog】新型电驱式四足机器人研制与测试

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 TODO:写完再整理 文章目录系列文章目录前言一、四足机器人体型大小和驱动方式的比较二、四足机器人设计一些重要的结论三、系统控制框架四、系统硬件框架五、力位混合控制(阻抗控制)六、侧向平衡控制(和VMC如出一辙)七、电机驱动系统研制(FOC磁场定向控制)总结 前言 认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长! 本文先对新型电驱式四足机器人研制与测试做个简单的介绍,具体内容后续再更,其他模块可以参

qq_35635374的博客 3726

大模型日报|今日必读的 5 篇大模型论文

大模型日报|今日必读的 5 篇大模型论文

AMiner2006的博客 926

RK3568 Android14 调试 RTL8211F 千兆以太网 (RGMII)

调试 RTL8211F 的核心在于:确认地址(看电阻贴片情况)和 搞定延时(配置 rgmii-id 或微调 delay 值)。一旦这两点对上了,RK3568 的千兆网络就能稳定运行。希望这篇结合原理图的实战记录能帮到你!

qq_33427070的博客 1649

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

多模态大模型心智理论推理:MeetingToM评估框架与应用实践

心智理论作为认知科学的核心概念,指的是理解他人心理状态并预测行为的能力。在多模态人工智能领域,这一原理通过整合文本、语音、视觉等异构信息,使模型能够识别情绪、推断意图、预测行动。其技术价值在于突破纯文本模型的局限,实现更自然的人机交互。在多方会议、智能助手等应用场景中,多模态心智推理面临时序对齐、跨模态融合等挑战。MeetingToM基准通过系统化评估框架,为多模态大语言模型的心智理论能力提供量化标准,推动社交智能AI的实际落地。该基准覆盖信念状态推理、意图识别等关键任务,采用早期融合、晚期融合等技术路线,

weixin_30383279的博客 348

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

基于心智理论与强化学习的AI信念引导:构建下一代安全对话系统

大语言模型的安全对齐是当前AI领域的核心挑战之一,其关键在于如何让模型在开放对话中实现有效引导。传统方法依赖于规则过滤与事后审核,难以应对动态、语义复杂的信念层面交互。心智理论为此提供了原理基础,它使AI能够推断用户的潜在信念与意图,从而进行深度理解。结合强化学习技术,可以构建一个序列决策框架,通过设计多目标奖励函数(如信念移动奖励、隐蔽性奖励),让模型学习在对话中潜移默化地引导用户信念。这一技术对于纠正错误信息、防范诱导生成以及促进理性讨论具有重要价值,尤其适用于在线教育、内容审核、心理咨询等需要安全、自

weixin_33806300的博客 414

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

大型语言模型如何处理复杂心理和情感状态推理?

大模型(LLM)是一种人工智能模型,旨在理解和生成人类语言。它们在大量的文本数据上进行训练,可以执行广泛的任务,包括文本总结、翻译、情感分析等等。LLM的特点是规模庞大,包含数十亿的参数,帮助它们学习语言数据中的复杂模式。这些模型通常基于深度学习架构,如转化器,这有助于它们在各种NLP任务上取得令人印象深刻的表现。

AI_Conf的博客 1568

圣塔菲学者:AI 大语言模型真的理解人类语言吗?

导语尽管大语言模型表现出近似人类的理解能力,但 AI 系统真的可以像人类一样理解语言吗?机器理解的模式必须和人类理解相同吗?近日,圣塔菲研究所前所长克拉考尔和研究员梅拉尼·米歇尔在 PNAS 发表文章,探讨大型预训练语言模型(LLMs)是否能够以类似人类的方式理解语言及其所编码的物理和社会情境。本文分别讨论赞成和反对的观点,并进一步探讨了更广泛的智能科学的关键问题。作者认为,进一步拓展人工智能与自...

人工智能学家 743

Nature Machine Intelligence丨多模态大型语言模型中的视觉认知

本研究系统评估了5种多模态大语言模型在直觉物理、因果推理和直觉心理三个认知领域的表现。研究采用认知科学实验范式,将心理学视觉任务转化为VQA测试,通过贝叶斯统计对比模型与人类判断。结果显示:模型在基础视觉任务表现良好,但认知能力有限——直觉物理任务准确率约60%,低于人类66%;因果推理与人类存在模式差异;直觉心理能力严重缺失。研究创新性地建立了跨学科评估框架,揭示了当前视觉语言模型在核心认知能力上的局限性,为未来模型优化提供了重要启示。

weixin_44887311的博客 425

当心被骗!LLM已涌现欺骗能力

大型语言模型(LLMs)作为人类的智能助手,正以难以置信的速度进行迭代,然而模型越来越高的智能化水平也带来了潜在风险,引发了人们对AI一致性和安全的担忧。现有的研究不仅表明AI在处理复杂推理任务时展示了与人类类似的行为模式,同时发现智能化水平较高的LLM会产生欺骗行为,例如通过假装失明诱骗工作者帮助其解决验证码问题,AI agent在外交游戏时会背叛盟友以获取胜利等。除了输出生成错误或误导性答案,欺骗还涉及某种目的,展现出一种可扩展和意识性的系统策略,即诱导他人产生错误信念,并为自身获益的行为模式。

yXIAOyu_的博客 819
上一篇: 为什么现在的LLM都是Decoder only的架构?
下一篇: 【LLM开源项目】LLMs-微调框架-LLaMA-Factory微调量化部署v4.0
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值