subway 智能视频监控分析智能体

AI使用指南:6个超实用的Prompt提示词模板 最近越来越多人开始接触AI,但其实想要让AI更懂你,关键是掌握对的提示词模板!今天就给大家分享6种超实用的Prompt提示词模板,不管你是小白还是老手都能用 阅读详情

​

详细拆解 "智能视频监控与分析智能体" 的具体实现过程。这将是一个从数据到部署的完整技术流水线。


目录

目录

 一、 系统架构总览

 二、 分场景具体实现过程

 三、 技术实现流水线

 四、 核心代码模块示例

 五、 挑战与解决方案


 智能视频监控分析智能体实现方案

 一、 系统架构总览

该系统采用经典的 "端-边-云" 协同架构,以实现效率与性能的最佳平衡。
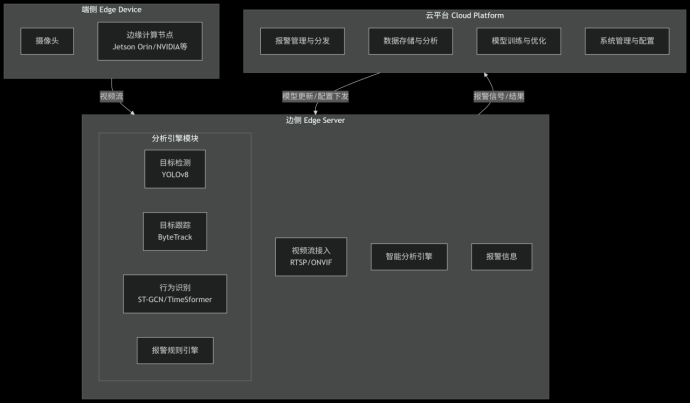
​编辑```mermaid
flowchart TD
subgraph A[端侧 Edge Device]
    A1[摄像头]
    A2[边缘计算节点<br>Jetson Orin/NVIDIA等]
end

subgraph B[边侧 Edge Server]
    B1[视频流接入<br>RTSP/ONVIF]
    B2[智能分析引擎]
    subgraph B2_Sub[分析引擎模块]
        B2_1[目标检测<br>YOLOv8]
        B2_2[目标跟踪<br>ByteTrack]
        B2_3[行为识别<br>ST-GCN/TimeSformer]
        B2_4[报警规则引擎]
    end
    B3[报警信息]
end

subgraph C[云平台 Cloud Platform]
    C1[报警管理与分发]
    C2[数据存储与分析]
    C3[模型训练与优化]
    C4[系统管理与配置]
end

A -- 视频流 --> B
B -- 报警信号/结果 --> C
C -- 模型更新/配置下发 --> B
```

---

 二、 分场景具体实现过程

 场景一:轨行区人员/异物入侵检测

1. 技术选型:
- 核心模型:YOLOv8s (精度与速度的平衡)
- 跟踪算法:ByteTrack (高性能多目标跟踪)
- 推理框架:TensorRT (NVIDIA GPU加速)

2. 实现步骤:

步骤 1: 定义ROI (Region of Interest)
- 在视频帧中精确划定轨行区多边形区域,排除其他区域的干扰。
- 使用OpenCV的`cv2.pointPolygonTest()`函数判断检测到的目标中心点是否在ROI内。

```python
 伪代码:ROI区域入侵判断
import cv2
import numpy as np

 1. 定义轨行区ROI多边形顶点(归一化坐标或像素坐标)
roi_points = np.array([[x1, y1], [x2, y2], [x3, y3], [x4, y4]], np.int32)

 2. 对每个检测到的目标
for detection in detections:
    x_center, y_center = detection['center']
    
     3. 判断目标中心点是否在ROI多边形内
    is_inside = cv2.pointPolygonTest(roi_points, (x_center, y_center), False) >= 0
    
    if is_inside:
         4. 触发入侵报警
        trigger_intrusion_alert(detection)
```

步骤 2: 模型推理与跟踪
- 使用YOLOv8进行实时目标检测,获取人员、车辆、异物等目标的坐标和置信度。
- 使用ByteTrack为每个目标分配唯一ID,实现跨帧跟踪,避免重复报警。

步骤 3: 报警过滤逻辑
- 防误报机制:目标必须在ROI内持续存在N帧(如5帧,约0.2秒)才触发报警,避免因检测抖动误报。
- 报警信息:包含目标截图、目标类型、位置、时间、跟踪ID等信息。

---

 场景二:站台乘客异常行为识别

这是一个更复杂的时序行为识别问题。

1. 技术选型:
- 姿态估计:YOLOv8-Pose (检测人体17个关键点)
- 行为识别:基于规则 + 时序卷积网络 (ST-GCN)

2. 实现步骤:

步骤 1: 关键点检测
- 使用YOLOv8-Pose模型获取乘客的骨骼关键点坐标(鼻子、肩膀、手肘、膝盖等)。

步骤 2: 定义异常行为规则
- 摔倒检测:计算人体的高宽比和肩膀线与地面的角度。
    - `if (身高/宽度 > 阈值) and (肩膀角度 < 阈值): then 判定为摔倒`
- 跨越黄线:判断脚部关键点与预设黄线区域的位置关系。
- 奔跑:计算连续帧之间人体关键点的位移速度。

```python
 伪代码:基于姿态关键点的摔倒检测
def detect_fall(keypoints):
    """
    根据人体关键点判断是否摔倒
    keypoints: 包含17个关键点坐标的数组
    """
     1. 获取肩膀、臀部、脚踝等关键点
    left_shoulder = keypoints[5]
    right_shoulder = keypoints[6]
    mid_hip = (keypoints[11] + keypoints[12]) / 2
    
     2. 计算肩膀连线的角度(与水平线的夹角)
    shoulder_vector = right_shoulder - left_shoulder
    angle = np.degrees(np.arctan2(shoulder_vector[1], shoulder_vector[0]))
    if angle < 0:
        angle += 180
    
     3. 计算人体的高宽比
    height = np.linalg.norm(mid_hip - (left_shoulder + right_shoulder)/2)
    width = np.linalg.norm(right_shoulder - left_shoulder)
    ratio = height / width if width > 0 else 0
    
     4. 应用阈值规则
    if angle > 45 and angle < 135 and ratio < 1.5:
        return True   疑似摔倒
    else:
        return False
```

步骤 3: 高级行为识别(可选)
- 对于更复杂的行为(如打架、争执),使用ST-GCN(时空图卷积网络)。
- 将连续多帧的人体关键点构造成图结构,同时学习空间(关节间)和时间(帧间)的特征。

---

 场景三:设备状态监控

1. 技术选型:
- 异常检测:Unsupervised Anomaly Detection (如SPADE, PatchCore)
- 分类模型:ResNet / EfficientNet (用于破损、漏水等具体缺陷分类)

2. 实现步骤:

步骤 1: 数据收集与预处理
- 收集正常状态的设备图像(如正常的闸机、扶梯、墙面)。
- 收集各种缺陷的图像(如屏幕破损、漏水痕迹、烟雾)。

步骤 2: 模型训练
- 方案A(有监督):如果缺陷数据充足,训练一个EfficientNet分类模型,识别各种缺陷类型。
- 方案B(无监督):如果缺陷样本稀少,采用异常检测思路。模型只学习“正常”是什么样子,任何偏离“正常”的模式都会被标记为异常。

步骤 3: 实时监控与报警
- 定时截取设备图像送入模型。
- 输出异常分数和异常区域的热力图,便于运维人员定位问题。

```python
 伪代码:基于无监督异常的漏水检测
def detect_water_leak(image):
    """
    使用无监督异常检测模型检测图像中的异常区域
    """
     1. 图像预处理
    processed_image = preprocess(image)
    
     2. 模型推理(异常检测模型,如PaDim/PatchCore)
    anomaly_score, anomaly_map = anomaly_model.predict(processed_image)
    
     3. 后处理
    if anomaly_score > threshold:
         找到异常区域轮廓
        contours = find_contours(anomaly_map)
         判断异常区域形状和位置是否符合漏水特征
        if is_leak_pattern(contours):
            return True, anomaly_map
    return False, None
```

---

 三、 技术实现流水线

​编辑

```mermaid
graph LR
A[原始视频流] --> B[数据采集与标注]
B --> C[模型选择与训练]
C --> D[模型优化与部署]
D --> E[实时分析与推理]
E --> F[业务逻辑与报警]
F --> G[报警分发与呈现]

subgraph B
    B1[使用LabelImg标注目标]
    B2[使用CVAT标注行为]
end

subgraph C
    C1[YOLOv8目标检测模型]
    C2[ST-GCN行为识别模型]
    C3[Anomaly异常检测模型]
end

subgraph D
    D1[TensorRT模型转换]
    D2[TensorRT模型量化]
    D3[模型量化INT8]
end

subgraph E
    E1[OpenCV/TensorRT推理]
    E2[DeepStream优化]
end

subgraph F
    F1[报警规则引擎]
    F2[防误报逻辑]
end

subgraph G
    G1[消息队列Kafka]
    G2[平台界面展示]
    G3[短信/邮件通知]
end
```

 四、 核心代码模块示例

主分析循环 (main_loop.py):

```python
import cv2
from yolov8 import YOLOv8Detector
from byte_tracker import ByteTracker
from behavior_analyzer import BehaviorAnalyzer

 初始化模型和跟踪器
detector = YOLOv8Detector(model_path="weights/yolov8s.pt")
tracker = ByteTracker()
behavior_analyzer = BehaviorAnalyzer()

cap = cv2.VideoCapture("rtsp://camera_stream_url")
fps = cap.get(cv2.CAP_PROP_FPS)
frame_count = 0

while True:
    ret, frame = cap.read()
    if not ret:
        break
        
     1. 目标检测
    detections = detector.detect(frame)
    
     2. 目标跟踪
    tracks = tracker.update(detections)
    
     3. 应用特定场景分析
     场景1: 入侵检测
    for track in tracks:
        if is_in_roi(track.center, roi_points):  检查是否在ROI内
            trigger_alert("Intrusion", track.id, frame)
            
     场景2: 行为识别 (每5帧分析一次行为)
    if frame_count % 5 == 0:
        keypoints = detector.detect_pose(frame)  姿态估计
        behavior = behavior_analyzer.analyze(keypoints)  行为分析
        if behavior == "fall_down":
            trigger_alert("FallDown", None, frame)
    
    frame_count += 1

cap.release()
```

 五、 挑战与解决方案

| 挑战 | 解决方案 |
| :--- | :--- |
| 光照变化、天气影响 | 使用数据增强训练模型、采用红外热成像摄像头作为补充 |
| 实时性要求高 | 模型量化(TensorRT INT8)、硬件加速(NVIDIA Jetson) |
| 误报率控制 | 多帧验证、多算法融合、设置合理的报警阈值 |
| 系统稳定性 | 设计看门狗机制,进程崩溃后自动重启 |

这个实现方案平衡了技术先进性和工程落地性,可以根据具体地铁线的需求和预算进行裁剪和扩展。建议从入侵检测这个单一场景开始试点,成功后再逐步扩展其他功能。

​

用友u8服务器优化,用友U8erp软件运行的性能优化方案图文教程 今天一定要给大家分享一下用友U8erp软件运行的性能优化方案图文教程,以下方案来自用友软件官方维护工程师反馈在在处理客户问题的时候,有一类问题较为挠头,就是诸如用友U8服务器效率低下的问题。比如用友U8运行慢,卡住等,我们暂先不提用友U8软件代码、脚本层面本身的性能提升问题,我们只是基于现有用友U8软件版本,在客户现有环境下排查用友U8软件运行的性能瓶颈,并采取一定的技术手段进行性能调校。本文将推... 阅读详情

相关推荐

GNSS接收机性能测试指标详解:TTFF、位置精度、灵敏度等关键参数如何评估

本文详细解析了GNSS接收机性能测试的关键指标,包括首次定位时间(TTFF)、位置精度、灵敏度等,帮助工程师系统评估接收机性能。通过多频段协同定位和载波相位测试等技术,提升定位精度至亚米级。同时,介绍了灵敏度测试的极限挑战和授时精度的专业测试方案,为GNSS接收机的性能优化提供实用指导。

cuda7parallel的博客 973

终极视频行为分析系统:5分钟上手智能监控解决方案

想要快速实现智能视频监控却不懂音视频开发?xcms视频行为分析系统为你提供一站式解决方案。这个基于C++开发的强大工具让普通用户也能轻松部署人脸检测、周界入侵、烟火识别等高级功能,无需编写复杂代码即可完成专业级视频分析任务。 ## 🎯 为什么选择xcms系统? 传统视频监控系统往往需要专业团队开发,而xcms打破了这一技术壁垒。系统集成了完整的视频处理流程,从视频输入到行为分析再到结果输出,

gitblog_01099的博客 1096

线阵相机标定必看:如何用Halcon实现亚毫米级精度测量(以HC050标定板为例)

本文以HC050标定板为例,详细阐述了如何利用Halcon实现线阵相机的高精度标定,以达到亚毫米级测量。文章深入剖析了线阵相机标定的核心原理、面临的独特挑战,并提供了从硬件搭建、图像采集到Halcon软件实操的完整路径,重点解析了运动参数设置、精度验证及常见问题排错,为精密测量应用提供系统解决方案。

weixin_29213655的博客 314

UML面向对象-分析、建模与设计(第三版·微课视频·题库版)顺序图画图

该顺序图展示了客户端(Client)通过事务对象(Transaction)与ODBC代理(ODBCProxy)的交互过程。客户端创建事务,设置操作参数并提交,事务调用代理完成数据设置,最后销毁事务。整个流程体现了对象间协作与生命周期管理,清晰展现了系统内部调用顺序与状态变化。

一亩高粱 35

AntV G6边动画实战:手把手教你实现数据流向箭头与虚线流动效果

本文详细解析了如何使用AntV G6实现数据流向箭头与虚线流动效果,通过自定义边动画提升数据可视化的动态表现力。从基础环境搭建到核心概念讲解,再到虚线流动动画和箭头路径动画的具体实现与参数调控,帮助开发者掌握G6边动画的高级技巧,适用于网络流量监控、数据传递等场景。

weixin_28487433的博客 268

父子Agent架构:解决AI系统上下文污染的技术方案

在AI系统设计中,上下文管理是核心挑战之一。传统单Agent架构在处理复杂任务时,常面临上下文无限膨胀导致的信息淹没和性能下降问题。父子Agent架构通过职责分离和上下文隔离机制,采用分而治之的思想,将大任务拆解为多个子任务由专门子Agent处理。该架构中父Agent负责任务规划和结果汇总,子Agent执行具体任务后立即销毁中间状态,通过精炼摘要进行通信。这种设计不仅能有效控制上下文长度,还能提升系统稳定性和执行效率,特别适用于编程辅助、自动化测试等需要多步骤处理的场景。父子Agent架构体现了计算机科学中

weixin_42531710的博客 353

AI 视频进入智能体时代:一条短片,如何从灵感走到成片?

AI 视频创作正在从单点生成走向完整流程。本文结合 Adobe Firefly 的新动向,梳理从确定目标、准备授权素材、设计画面到配音字幕和发布前复核的五步方法,并介绍 Aivo容剪如何辅助团队衔接创作环节。

AIVOClaw的博客 148

LSCM最小二乘保角参数化

LSCM最小二乘保角参数化 最小二乘思想 已知一组点的数据(x,y) x x1x_1x1​ x2x_2x2​ x3x_3x3​ … xnx_nxn​ y y1y_1y1​ y2y_2y2​ y3y_3y3​ … yny_nyn​ 可以近似为线性关系 y=ax+by=ax+by=ax+b ,目标为确定常数 aaa , bbb ; 解法:找到 aaa , bbb ,使得所有 yiy_iyi​ 与 axi+bax_i+baxi​+b 偏差的平方和 Q=∑i=1n(yi−axi−b)2 Q=\s

weixin_49732532的博客 4256

AI动画视频生成器免费在线怎么用?新手完整操作教程

AI动画视频生成器让零基础用户也能快速制作动画内容,本文拆解在线创作全流程:剧本构思、角色场景设定、提示词撰写、分镜生成、后期剪辑导出。对比免费版与付费版本的差异,讲解免费工具常见限制,分享素材导入、提升画面一致性的实操技巧,解答角色跑脸、提示词难写等高频问题,同时介绍适合短剧团队的规模化创作方案,帮助个人创作者和团队按需挑选AI动画工具。

2601_96477822的博客 556

浅析图像处理中的名词:Gamma 校正(Gamma变换、Gamma调整)

浅析图像处理中的名词:Gamma 校正(Gamma变换、Gamma调整)

qq_51908382的博客 1万+

用Python的fengwo模块复刻通达信筹码峰(COST/WINNER),选股效率提升10倍

本文介绍了如何使用Python的fengwo模块高效复刻通达信的筹码峰(COST/WINNER)计算,显著提升选股效率。通过C++内核与多线程优化,fengwo模块将传统Python实现的数小时计算压缩至分钟级,解决了量化交易中的性能瓶颈问题。文章详细解析了筹码峰计算原理、fengwo模块的技术架构及实战应用,助力量化开发者构建高效选股系统。

weixin_29062823的博客 441

视频解说交付前,用 Python 检查字幕时轴与证据镜头是否对齐

用普通 SRT 和 Python 标准库复现两类字幕错误:时轴重叠,以及结论比证据画面提前出现。附可运行示例、修正结果和人工审片边界。

linan96的博客 150

yolov26改进 | Neck/颈部创新篇 | 独创HFPN利用分层特征融合块HFFB模块融合多层次特征改进yolov26(全网独家创新)

本文提出了一种创新的分层特征融合模块HFFB(Hierarchical Feature Fusion Block)来改进YOLOv26的neck部分,构建了名为HFPN的新型特征金字塔网络。该模块通过三分支结构融合局部特征(CNN提取)、全局特征(Swin Transformer提取)和中间特征,并包含空间注意力(SA)、通道注意力(CA)和残差反向MLP(IRMLP)等组件来优化特征融合效果。实验表明,该方法能针对不同尺度目标(大/中/小)进行自适应检测,可根据具体数据集需求选择不同配置。文章详细提供了核

Snu77的博客 486

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 246

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

打字就能剪视频的AI工具

AI 会替代剪辑师吗?这个问题和“AI 会替代程序员吗”一样,问错了方向。会用 AI 工具的人,正在替代不会用的人。一个剪辑师用传统方式花三天做的宣传片,另一个人用 UniCut 一天做完,质量差不多,市场会选谁,答案很明显。工具的进化从来不是把专业的人淘汰掉,而是把专业的门槛拆掉。浏览器已经打开了,剩下的就是你愿不愿意试一下。体验地址:https://unicut.h5ds.com/开源仓库:https://github.com/mtsee/unicut。

d676015863的博客 167

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

本地化部署会议视频软件如何替换旧平台?账号迁移、历史数据与用户培训怎么安排?

账号先映射:身份与权限验证通过,再开放使用。资料分级处理:能查、能读、权限正确,比“全部搬完”更重要。切换可恢复:入口、增量数据和业务通知都要纳入回退方案。培训按岗位落地:让用户完成真实任务,而不是只听功能介绍。这套方法适合政企、集团及医疗等具有长期资料留存、多终端接入和业务集成需求的组织。小规模替换可以简化批次与流程,但不应省略权限验证、备份恢复和关键会议演练。

hz56789的博客 293

AI 礼盒开箱视频怎么做?让商品亮相更有仪式感

AI商品视频通过精细设计开箱动作与场景节奏,将礼盒从静态包装转化为沉浸式送礼体验。从暖光布景、情感化构图到手部停顿、商品细节特写,每一帧都传递“精致”与“珍视”。以珠宝礼盒为例,俯拍视角下,红色对开门展开如舞台揭幕,银色项链在深蓝夜空衬底中缓缓呈现,掌心承托、缓慢转动,强化视觉记忆。结尾平铺构图,礼盒与商品共存,情绪由期待落至静谧珍藏。全程无文字,靠画面叙事,实现仪式感与品牌调性的深度融合。

yunhhhhh的博客 132

RN鸿蒙空间音频实战

示例仓库:https://atomgit.com/m0_37170006/react-native-ohos-spatial-audio 社区导引:框架源码与版本发布见 https://atomgit.com/CPF-RN/ohos_react_native/tree/0.84-main CPF-RN 鸿蒙社区:https://atomgit.com/CPF-rn。

buhuisuanfa的博客 2万+

通过 AIGC 生成视频何时才能告别“抽卡”!

如果视频的主体内容已经符合要求,只存在错误字幕或局部画面瑕疵时,重新生成不仅增加成本,还可能改变原本满意的部分。针对这类问题,WAND-EraseVibe+ 提供了视频擦除与画面重建能力。根据腾讯云披露的技术方案,该工具采用基于隐空间 Transformer 的生成式修复架构,先将视频画面编码为隐空间特征,在特征层推断并重建需要修复的区域,再解码为视频画面。白模前置、垂直场景调优和局部修复分别作用于不同环节,目的都是减少为了获得可用内容而付出的重复生成成本。

Enweitech Software Works 168

网页视频资源识别与本地化管理:从 HTTP 流媒体技术到完整的视频工作流

现代网页视频技术已经从简单的文件传输发展到分段传输、自适应码率和浏览器端媒体处理。这使视频播放体验不断改善,也让资源识别和本地管理变得更加复杂。对于技术人员而言,理解 HTTP、HLS、MPEG-DASH 和 MSE 的基本工作机制,有助于更准确地分析网页视频的传输过程。对于视频创作者和研究人员而言,建立从内容发现、资源识别到本地整理的完整工作流,可能比单纯寻找一个下载工具更有长期价值。

m0_68263549的博客 455

Android 音频 Player 体系

Android 音频框架中,"Player"是统一抽象的音频播放实例,涵盖 AudioTrack、MediaPlayer 等。每个 Player 由唯一 piid 标识,通过 PlayerBase 注册至 PlaybackActivityMonitor,状态机管理其生命周期(idle→started→stopped→released)。关键事件如 portId 绑定、静音(位掩码标识主静音、音量为0等)、设备切换等均通过 PLAYER_UPDATE_* 通知系统。静音原因以掩码形式记录,日志中“source

aningxiaoxixi的博客 168

[黎阳之光] 边海防无人机巡检实战教程:航线规划、目标发现与视频孪生联动一次讲透

本文给出的是简化版模型与参考框架,面向真实项目的完整落地,还需结合具体海域、设备与业务规则做针对性设计。它的角色不是替代固定感知,而是做“机动确认层”——雷达和固定视频负责发现,无人机负责在 10 分钟内飞到目标上空,把“有个点”变成“看清是什么”。数据流的关键指标:无人机视频接入孪生平台延迟不超过 800ms,位置上报频率 1Hz,吊舱角度反馈 10Hz。位置或角度一滞后,图上无人机的视野锥就会和实际画面错位,指挥员按图指挥就会指错地方。这样既不断档,又不烧钱。

m0_75019831的博客 321

15. 调用ComfyUI生成视频!

在“导演大师”中,我们不仅支持导出分镜导演包并一键导入运行,还为用户提供了极高的自定义自由度。许多创作者希望结合自己精心调试的 MiniMax H3 工作流来生成视频,这当然是完全支持的。通常有两种操作方式:一种是手动复制,将分镜的资产与提示词手动粘贴至本地工作流中;另一种则是更为高效的自动化方案——直接在“导演大师”中调用 ComfyUI 工作流,实现一键生成。本文将重点介绍后者的配置与使用全流程,帮助你打通从分镜脚本到视频直出的自动化链路。

2601_95544990的博客 291

面向强噪声工业场景的 KL‑2510 音频 DSP 模组设计与多场景落地分析

KL-2510是一款22×16mm邮票孔SMT封装音频模组,集成ADC/DAC、AI-ENC降噪(45–90dB)与AEC回声消除(100dB),支持USB免驱及模拟/PDM麦克风输入,具备4档硬件拾音增益,适配医疗、矿山、安防等复杂噪声场景。通过五类真实案例验证其在病房对讲、井下报警、门铃对讲等应用中的稳定性与易用性。重点提示:需接入AEC_IN参考信号、输出加分压电路、外设勿接3V3电源,避免烧毁。适用于空间紧凑、无算法团队的嵌入式项目,显著降低音频开发门槛。

R190_6589的博客 419

翻译配音后音画对不上?用 ffmpeg + Python 把新音轨对齐到原视频时间轴

做视频出海、课程本地化的同学迟早会撞上这个坑:原片是中文 3 分钟口播,你换成英文 AI 配音后,要么配音在 2 分 10 秒就播完了、后面画面在放"默片",要么配音拖到 4 分钟、视频早黑屏了——也就是**音画不同步(A/V desync)**。 根因很简单:不同语言的"信息密度"不一样。同一段意思,英文往往比中文多 30%~50% 的音节,中文又比英文短。你把原音轨换成翻译后的配音,新音轨长度和原视频时间轴天然对不上。本文把"怎么测量偏差、怎么用 ffmpeg 把新音轨拉伸/压缩到刚好贴合原视频、...

weixin_60261120的博客 353

视频已经变模糊了,为什么还是会卡?

视频播放中画质忽清忽糊、画面转圈,根源在于下载速率与缓冲消耗不匹配。即使测速快,也未必能持续支撑高画质播放。自适应码率切换需综合考虑缓冲余量、持续吞吐与切换成本,盲目升档易导致卡顿。测试时应固定片源、模拟真实网络变化,记录缓冲、切换与停顿细节,结合下载、缓冲与轨道变化时间线分析问题,才能优化体验。稳定中等画质往往比频繁跳变更可接受。

NetworkSimulator的博客 268

海外直播APP开发需要关注什么?视频美颜SDK的多端适配问题

随着海外直播市场不断发展,直播APP对视频美颜功能的要求也越来越高。由于Android与iOS在摄像头调用、图像处理和设备性能方面存在差异,视频美颜SDK的多端适配成为开发过程中不可忽视的技术环节。本文从海外直播APP开发需求出发,分析美颜SDK的兼容性、实时处理性能、平台差异及设备测试等问题,为直播平台的技术选型与开发规划提供参考。

q1031691172的博客 158
上一篇: 智能体在地铁的落地场景
下一篇: AI+金融行业 和赋能应用的技术
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

交通上的硅基思维

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值