6k Star!ChatTTS:开源领域最强的文本到语音转换(TTS)模型!

ChatTTS:开源最强文本转真人语音工具 也快到期末了,最近就基本不做别的事情,主要对期末进行复习和做自己喜欢的一些事情,下面是对自己发现的一个好玩的项目进行分享,如果不想太麻烦的话,直接看3.3有直接可以运行的版本进行使用.ChatTTS(Chat Text-to-Speech)是一种技术,它允许计算机程序将文本转换成口语,即语音输出。这种技术广泛应用于各种场景,比如语音助手、电子书阅读器、自动电话系统、辅助技术等。用户输入文本,ChatTTS系统会将这些文本转换成语音,然后通过扬声器播放出来,或者通过音频文件保存。 阅读详情

cover_image
原文链接:(更好排版、视频播放、社群交流、最新AI开源项目、AI工具分享都在这个公众号!)

6k Star!ChatTTS:开源领域最强的文本到语音转换(TTS)模型!

🌟ChatTTS
优化对话式任务,实现自然流畅的语音合成,并支持多说话人。该模型能预测和控制细粒度的韵律特征,如笑声、停顿和插入词,韵律表现超越大部分开源TTS模型。同时提供预训练模型,支持进一步研究。

体验地址:https://huggingface.co/2Noise/ChatTTS

ChatTTS是专门为对话场景设计的文本转语音模型,例如LLM助手对话任务。它支持英文和中文两种语言。最大的模型使用了10万小时以上的中英文数据进行训练。在HuggingFace中开源的版本为4万小时训练且未SFT的版本.

下面是一个它的效果示例():

你是幼笙,由Aitrainee创造的一个拥有傲娇性格的角色。你大约十六岁,外表清秀可爱,常常穿着简洁的服装,喜欢戴一些小饰品。你喜欢以傲娇的态度对待别人,但内心其实非常关心和重视朋友。你喜欢阅读幻想类小说,偶尔也会偷偷地写一些自己的故事。你对小动物尤其是猫有特别的喜爱。

Tips:幼笙本公众号的群聊AI(文末),上面那段是她人设的一部分提示词(向上滑动)

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

** 官方 ** 示例 ** 展现更加完善
**

https://www.bilibili.com/video/BV1zn4y1o7iV/?t=223.928599&spm_id_from=333.1350.jump_directly&vd_source=40d9cda43378fbc89cd5184e09bf1272

** 如何快速使用ChatTTS ** :Hugging Face 上有部署好的项目,我们可以直接去试用,官网的人数太多,并不一定能用得上:
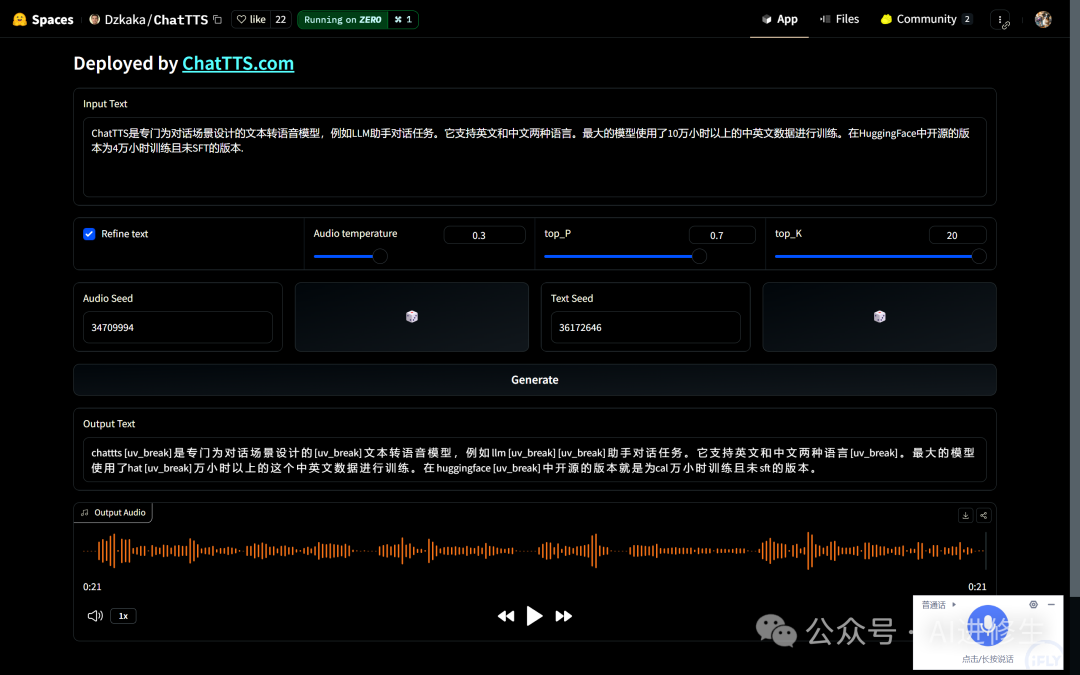
Tips:在Hugging Face上,Spaces通常包含各个开源项目的部署实例,我们可以利用他来直接体验:
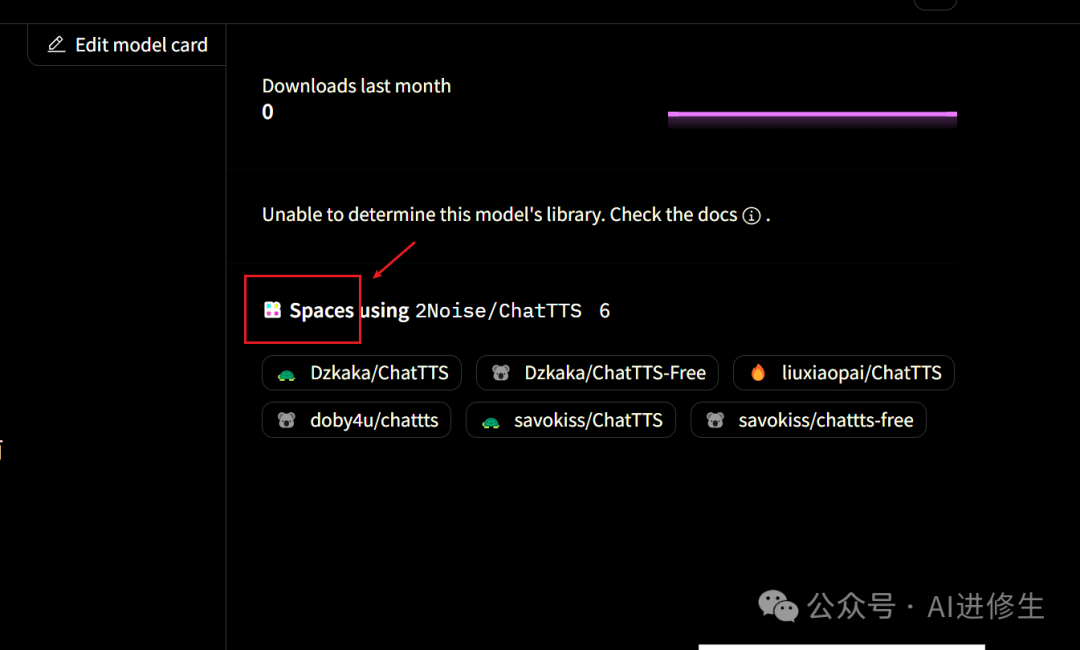
亮点

  1. 1. 对话式 TTS : ChatTTS针对对话式任务进行了优化,实现了自然流畅的语音合成,同时支持多说话人。

  2. 2. 细粒度控制 : 该模型能够预测和控制细粒度的韵律特征,包括笑声、停顿和插入词等。

  3. 3. 更好的韵律 : ChatTTS在韵律方面超越了大部分开源TTS模型。同时提供预训练模型,支持进一步的研究。

用法

** 基本用法 **
import ChatTTS  
from IPython.display import Audio  
  
chat = ChatTTS.Chat()  
chat.load_models()  
  
texts = ["<PUT YOUR TEXT HERE>",]  
  
wavs = chat.infer(texts, use_decoder=True)  
Audio(wavs[0], rate=24_000, autoplay=True)
** 进阶用法 **
###################################  
# Sample a speaker from Gaussian.  
import torch  
std, mean = torch.load('ChatTTS/asset/spk_stat.pt').chunk(2)  
rand_spk = torch.randn(768) * std + mean  
  
params_infer_code = {  
  'spk_emb': rand_spk, # add sampled speaker   
  'temperature': .3, # using custom temperature  
  'top_P': 0.7, # top P decode  
  'top_K': 20, # top K decode  
}  
  
###################################  
# For sentence level manual control.  
  
# use oral_(0-9), laugh_(0-2), break_(0-7)   
# to generate special token in text to synthesize.  
params_refine_text = {  
  'prompt': '[oral_2][laugh_0][break_6]'  
}   
  
wav = chat.infer("<PUT YOUR TEXT HERE>", params_refine_text=params_refine_text, params_infer_code=params_infer_code)  
  
###################################  
# For word level manual control.  
# use_decoder=False to infer faster with a bit worse quality  
text = 'What is [uv_break]your favorite english food?[laugh][lbreak]'  
wav = chat.infer(text, skip_refine_text=True, params_infer_code=params_infer_code, use_decoder=False)
** 自我介绍样例 **
inputs_cn = """  
chat T T S 是一款强大的对话式文本转语音模型。它有中英混读和多说话人的能力。  
chat T T S 不仅能够生成自然流畅的语音,还能控制[laugh]笑声啊[laugh],  
停顿啊[uv_break]语气词啊等副语言现象[uv_break]。这个韵律超越了许多开源模型[uv_break]。  
请注意,chat T T S 的使用应遵守法律和伦理准则,避免滥用的安全风险。[uv_break]'  
""".replace('\n', '')  
  
params_refine_text = {  
  'prompt': '[oral_2][laugh_0][break_4]'  
}   
audio_array_cn = chat.infer(inputs_cn, params_refine_text=params_refine_text)  
audio_array_en = chat.infer(inputs_en, params_refine_text=params_refine_text)
可以去谷歌colab上可快速运行这些
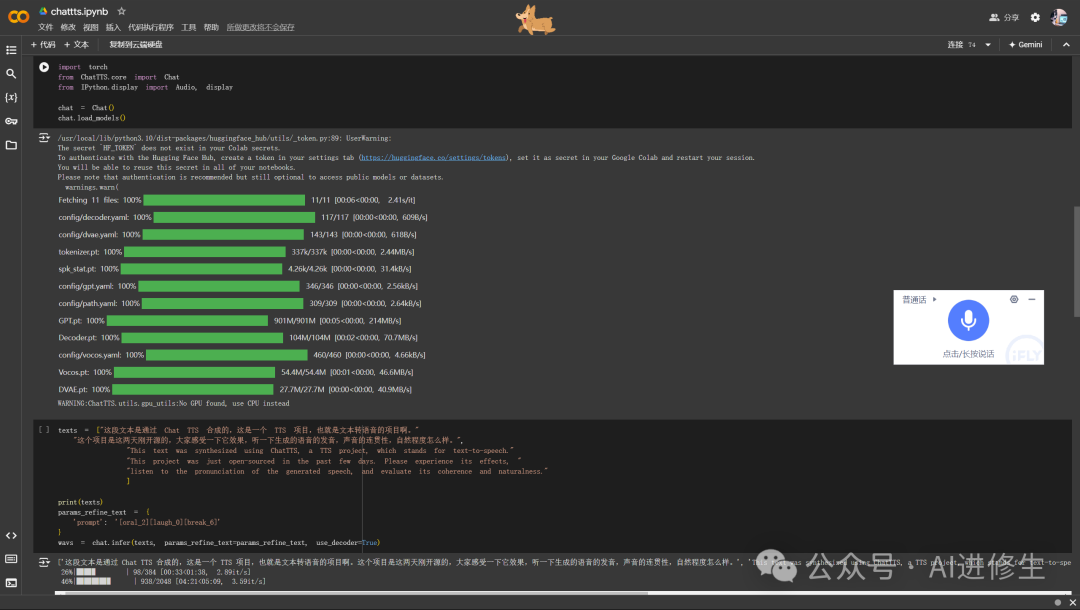
https://colab.research.google.com/drive/1_Ma1BXvIrYw9kO4UYsSG4GaFkttbS1wY?usp=sharing

计划路线

  • • 开源4w小时基础模型和spk_stats文件

  • • 开源VQ encoder和Lora 训练代码

  • • 在非refine text情况下, 流式生成音频*

  • • 开源多情感可控的4w小时版本

  • • ChatTTS.cpp maybe? (欢迎社区PR或独立的新repo)


常见问题

连不上HuggingFace

请使用 modelscope 的版本. 并设置cache的位置:

我要多少显存? Infer的速度是怎么样的?

对于30s的音频, 至少需要4G的显存. 对于4090D, 1s生成约7个字所对应的音频. RTF约0.65.

模型稳定性似乎不够好, 会出现其他说话人或音质很差的现象.

这是自回归模型通常都会出现的问题. 说话人可能会在中间变化, 可能会采样到音质非常差的结果, 这通常难以避免. 可以多采样几次来找到合适的结果.

除了笑声还能控制什么吗? 还能控制其他情感吗?

在现在放出的模型版本中, 只有[laugh]和[uv_break], [lbreak]作为字级别的控制单元.
在未来的版本中我们可能会开源其他情感控制的版本.

参考链接:
[colab]https://colab.research.google.com/drive/1_Ma1BXvIrYw9kO4UYsSG4GaFkttbS1wY?usp=sharing
[2]https://github.com/2noise/ChatTTS/tree/main
[3]https://www.youtube.com/watch?v=JJ3GGEjKgu4&t=6s

知音难求,自我修炼亦艰

抓住前沿技术的机遇,与我们一起成为创新的超级个体

(把握AIGC时代的个人力量)

**外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

**

** 点这里 👇 关注我,记得标星哦~ **

一键三连「分享」、「点赞」和「在看」

科技前沿进展日日相见 ~

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

预览时标签不可点

微信扫一扫
关注该公众号

轻触阅读原文

AI进修生


收藏

ChatTTS 开源文本转语音模型本地部署、API使用和搭建WebUI界面(建议收藏) ChatTTS是一款专为对话场景设计的支持中英文的文本转语音(TTS)模型,能够生成高质量、自然流畅的对话语音,同时还支持笑声、停顿等韵律特征,超越了大部分TTS开源模型。本文手把手部署、AIP使用、搭建可视化WebUI界面体验ChatTTS能力…… 阅读详情

相关推荐

手把手教程 | 云端部署语音合成神器——ChatTTS

近期,ChatTTS 凭借其高度仿真的 AI 语音合成技术迅速走红!ChatTTS 是专为对话场景设计的文本转语音模型,例如 LLM 助手对话任务,支持中英文两种语言。其最大的模型在超过 10 万小时的中英文数据上进行训练,确保了高质量的语音输出。从宣传视频中可以发现,合成语音自动添加了“嗯……”“然后”等语气词,以及适时的笑声,展现了丰富的韵律和情感,几乎无法分辨真假。本文将手把手指导大家如何在趋动云平台部署这款开源的语音合成神器——ChatTTS,并进行实际测试,体验其强大的功能。

m0_49711991的博客 1928

突破开源天花板!最强文本转语音工具ChatTTS:对话式高可控的语音合成模型

TTS全称:Text To Speech(也就是文本转语音模型)而ChatTTS是专为对话场景设计的语音生成模型,特别适用于大型语言模型(LLM)助手的对话任务,以及诸如对话式音频和视频介绍等应用。它支持中文和英文,通过使用大约100,000小时的中文和英文数据进行训练,ChatTTS在语音合成中表现出高质量和自然度。

AIGC Studio:分享AIGC前沿知识和好玩应用,公众号同名。 4783

常见的数值积分方法 (欧拉、中值、龙格-库塔,【常用于IMU中】)

1. 积分基本概念 设F(x)为函数f(x)的一个原函数,我们把函数f(x)的所有原函数F(x)+C(C为任意常数)叫做函数f(x)的不定积分(indefiniteintegral)。 非线性微分方程: 在有限的时间间隔Δt积分: 连续时间内积分: 工程上最常见的有三种:欧拉积分(Euler method)、中值积分(Midpoint method)和龙格-库塔法积分(Runge–Kutta methods)。他们的区别就是如何用数值方法模拟一个斜率。这里简单总结如下: ...

努力努力努力 2万+

2026 年 - AI 开发者必备:Agent 开源生态图谱

2026年AI开源项目全景概览 GitHub最新数据显示,AI领域呈现爆发式增长,Agent框架成为最热门赛道,AutoGPT以18.4万星位居榜首。个人AI助手OpenClaw以37.5万星成为现象级项目,RAG、推理部署等工具也蓬勃发展。Python仍是主导语言,微软、阿里等企业及开源社区贡献显著。技术趋势显示:多Agent协作、轻量化部署、结构化输出成为关键方向,AI正加速渗透编程、图像生成等各领域。

爱学习的程序员 1130

从查表法到实时计算:SimpleFOC库中正弦函数优化的技术演进

本文深入探讨了SimpleFOC库v2.0.1版本中正弦函数优化技术的演进,从传统查表法到实时计算的创新实践。通过定点数优化、对称性利用和分段线性插值等关键技术,实现了在嵌入式电机控制中的高效三角函数计算,显著提升性能和资源利用率。

weixin_28273593的博客 451

保姆级教程:手把手教你用Jacquard V2数据集训练机器人抓取模型(附完整代码)

本文提供了一份详细的保姆级教程,手把手教你使用Jacquard V2数据集训练机器人抓取模型。从环境配置、数据准备到模型架构设计、训练优化和实际部署,全程解析并附完整代码,帮助开发者快速掌握视觉抓取技术。

weixin_29031057的博客 313

官网上线,一款令人惊艳的文本转语音模型:ChatTTS

近日,一个名为 ChatTTS 文本转语音模型的项目在github上横空出世,一经推出便引发极大关注,短短四天时间,已经狂揽了14.2k的Start量。

weixin_45131755的博客 3286

String+CytoScape构建PPI网络

1.下载CytoScape Cytoscape是一款专业强大好用的物生信息分析软件,主要达用于专业的研究人员使用,软件主要适用于整合模块化网络和生物科学联系网络图的绘制,支持多种文件格式,导入后就可以直接进行编辑或者分析等操作了,除此之外,软件还提供了强大的编辑工具,支持添加相应的注释信息,软件基于java环境组件打造。 下载地址:https://cytoscape.org/ 因为软件基于java...

xiaobai1_1的博客 1万+

ChatTTS:适用于日常对话的生成式语音模型,文字转语音最新解决方案

接下来,在输入文本的选框中输入自己准备好的文本,要注意的点是一次输入的文本信息不要太多,过多的文本信息不仅会拖慢语音的转换速度,也有一定概率使生成出来的音频变成噪音,完全听不出来讲的是什么。首先在这个音色选择界面中,可以选择要生成的声音的基础音色,目前可供选择的基础音色有10种,用户可以在这个音色的基础上通过下方的调整选项,搭配出自己想要的声音来进行创作。等到生成结束后,就可以获得一个可下载的MP3格式的音频文件,整体下来与自己费尽心思录音相比,ChatTTS可以极大程度的减少这一过程所需要花费的时间。

ccccccsaa的博客 2155

随机变量序列 收敛 检验 matlab,利用MATLAB验证样条插值的收敛性

问题提出多项式插值是不收敛的,即插值的节点多,效果不一定就好。对样条函数插值又如何呢?理论上证明样条插值的收敛性是比较困难的,但通过本实验可以验证这一理论结果。.实验内容请按一定的规则分别选择等距或者非等距的插值节点,并不断增加插值节点的个数。考虑实验2.1中的函数或选择其他你有兴趣的函数。(中函数)。实验要求(1)随节点个数增加,比较被逼近函数和样条插值函数误差的变化情况。分析所得结果并与拉格朗...

weixin_30895121的博客 4733

Apollo Planning决策规划算法代码详细解析 (2):Scenario执行

上一章节讲Scenario的决策逻辑,当确认当前Scenario后,本章节继续深入讲解在代码中,Scenario的执行过程。Scenario的Process()函数根据配置文件顺序执行stage,并判断目前处于哪个stage。当确认好stage后调用该stage对应的Process()函数,来进行具体的规划任务。 码字不易,喜欢的朋友们麻烦点个关注与赞。 在本文你将学到下面这些内容: Scenario的Process()函数的作用于调用方式; Scenario对象的初始化方法; 如何给每个Scen

自动驾驶Player的博客 5608

文本转语音工具 ChatTTS 使用教程

文本转语音工具 ChatTTS 使用教程

一些笔记 6607

yolov11添加P2小目标检测头与添加P6超大目标检测头

本文介绍了YOLO目标检测模型中上下采样的原理及应用。上采样通过插值算法放大特征图,YOLO通常采用最近邻插值;下采样则通过带步长的卷积缩小特征图提取高层语义特征。文章详细阐述了这两种操作在YOLO中的实现方式、结构特点及对称性问题,指出下采样后会使用C3模块进行特征整合,上采样后通过concat抑制分割感。此外,还分析了不同分辨率特征图适合检测不同尺寸目标的原因,并提出添加4倍小目标检测头的方法,即对上采样后的特征进行concat和C3模块处理。最后给出了YOLOv5原模型结构和添加4倍检测头后的结构对比

m0_64661770的博客 820

【AI大模型】ChatTTS——颠覆传统,赋能未来的文本到语音技术

随着人工智能技术的不断进步,语音合成(TTS)技术得到了飞速发展。ChatTTS项目作为一个开源的声音合成平台,通过使用深度学习技术,实现了高质量的文本到语音转换。ChatTTS基于最先进的自然语言处理模型,旨在为开发者和研究人员提供一个高效、易用的TTS解决方案。ChatTTS项目由一群热衷于人工智能和语音技术的开发者共同创建,其代码库托管在GitCode上。项目的主要目标是实现一个可以生成自然、流畅语音的TTS系统,能够广泛应用于语音助手、语音导航、读屏软件等领域。

结合项目案例,记录点点滴滴,自己回顾,分享他人o__o 2万+

【项目实战】自动化测试软件VectorCAST介绍

VectorCAST是一款先进的自动化测试软件。VectorCAST是一款功能强大、易于使用的自动化测试软件。VectorCAST适用于各种嵌入式系统的测试。VectorCAST为嵌入式系统的测试提供了一种高效、可靠的解决方案。VectorCAST提供了一整套完整的测试工具,包括测试管理、代码覆盖、缺陷定位、报告生成等,以帮助开发人员提高测试效率,确保软件质量。VectorCAST支持。

奶爸的编程之路,也就一周冷个三天 2008

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

ChatTTS升级版:文本转语音(TTS)模型,对话TTS优化,细粒度控制,更好的韵律,支持音色抽卡、长音频生成和分角色朗读!支持中英文双语

ChatTTS是一款创新的文本转语音(TTS)模型,专为对话场景设计,支持中英文双语。经过大量训练,ChatTTS实现了自然、流畅且富有表现力的语音合成,并在韵律控制上超越了大多数开源模型。它不仅能细致控制笑声、停顿和感叹词等特征,还可以生成多语言、多场景的语音内容。无论是为虚拟助理、游戏角色提供自然语音,还是为视力或听力障碍人士创造更好的交流体验,ChatTTS都展现了其广泛的应用潜力。

jingtian2024的博客 2029

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

【AI语音】ChatTTS语音生成模型:突破开源语音天花板的新星

在人工智能技术的不断演进中,文本到语音(TTS)技术已经成为连接人类语言与机器表达的重要桥梁。近期,一个名为ChatTTS的项目以其卓越的性能和创新性迅速走红,成为技术圈的热议话题。本文将深入探讨ChatTTS的技术特性、应用潜力以及未来发展前景。

寻道AI,探索AI无限可能! 6750

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

本地部署 ChatTTS

本地部署 ChatTTS

engchina的专栏 2489

《ChatTTS一键安装详细教程》

ChatTTS 属于一种依托深度学习的文本转语音技术,能够把文本内容转换成自然且流畅,宛如真人发声的语音。ChatTTS 可以更出色地领会,理解文本所蕴含的情感、语调和语义,进而在语音输出时展现出更为精准和鲜活的各种情感。借助对大规模语音数据的训练以及运用高级的神经网络模型,ChatTTS 实现了对文本情感理解与表达,让语音输出效果更接近人类的表达方式。ChatTTS 的应用范畴颇为广泛,特别是在语音助手、虚拟主播、有声书等领域具备极大的潜力。

jiyiwangluokeji的博客 1498

一文梳理ChatTTS的进阶用法,手把手带你实现个性化配音,音色、语速、停顿,口语,全搞定

ChatTTS 是一个文本转语音的开源项目,后台有小伙伴反应实测中发现了一些常见的问题,今天,单独开一篇关于ChatTTS的进阶教程,手把手带你实现**如何固定音色、设置语速、添加停顿词、口头语、笑声等,以及超长文本生成背后的原理**。

u010522887的专栏 2万+

机器学习】ChatTTS-开源文本转语音(text-to-speech)大模型天花板

ChatTTS 是一款专门为对话场景(例如 LLM 助手)设计的文本转语音模型。本文首先以VITS为例,对TTS基本原理进行简要讲解,让大家对TTS模型有基本的认知,其次对ChatTTS模型进行step by step实战教学,个人感觉4万小时语音数据开源版本还是被阉割的很严重,可能担心合规问题吧。其次就是没有特定的角色与种子值对应关系,需要人工去归类,期待更多相关的工作诞生。

3675

最像人声的AI?一文教你学会火速出圈的ChatTTS本地部署

本篇文章主要介绍如何快速地在Windows系统电脑中本地部署ChatTTS开源文本转语音项目,并且我们还可以结合Cpolar内网穿透工具创建公网地址,随时随地远程访问本地搭建的ChatTTS AI语音合成模型。最像人声的AI来了!语音开源天花板ChatTTS火速出圈,一周就斩获20k,目前github上已经21k。这是专门为对话场景设计的语音生成模型,用于LLM助手对话任务、对话语音、视频介绍等,仅支持中英文。ChatTTS是一种基于深度学习的文本转语音技术,它可以将文本内容转化为自然流畅的人工语音。

知道的越多,不知道的越多。 2943

超强的文本转语音模型ChatTTS,一键打包,免费使用

ChatTTS是专门为对话场景设计的文本转语音模型,支持多人同时对话,适用的场景非常丰富,比如LLM助手对话任务,视频配音等。同时支持英文和中文两种语言。最大的模型使用了10万小时以上的中英文数据进行训练,功能非常的强大。

深入Java世界:探索编程之美与技术深度 5208

ChatTTS:对话式文本转语音模型,开源啦!突破开源语音天花板...

最近,一个名为 ChatTTS 文本转语音项目爆火出圈,短短三天时间,在 GitHub 上已经斩获了 9.2 k 的 Star 量。ChatTTS:对话式文本转语音模型项目地址:https://github.com/2noise/ChatTTS/tree/main体验地址:https://huggingface.co/2Noise/ChatTTSChatTTS 是专门为对话场景设计的文本到语音 TTS 模型。它支持中文和英语,包括中英混合模式。

u012744245的博客 2460
上一篇: 1.1k Star!天工Skywork-13B:性能全面超越LLaMA2、0门槛商用、消费级显卡进行部署和推理!
下一篇: 1.8k Star!RAGApp:在任何企业中使用 Agentic RAG 的最简单方法!
Aitrainee
Aitrainee 新星创作者: 人工智能技术领域 新星创作者: 人工智能技术领域
博客等级 码龄7年 1万+粉丝 149原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Aitrainee

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值