


本文全面介绍了大模型应用的基础知识,包括Transformer架构、Attention机制、Scaling Law等基本原理,以及API接口、上下文管理等实践要点。文章深入探讨了提示词工程的核心要素和技巧,强调了结构化输出和防注入的重要性。此外,还详细解析了检索增强生成(RAG)的流程和优化方法,以及Agent智能体的应用架构和设计模式。最后,文章介绍了大模型微调原理,帮助读者理解模型参数、损失函数等核心概念。整体而言,本文为AI应用开发和大模型工程提供了系统性的知识框架和实践指导。
一、大模型应用基础
核心目标:建立对大模型的工程认知,了解边界和使用成本
1、基本原理(懂原理就行,不用会推导)
- Transformer 架构、Attention 机制、位置编码:理解 Attention 是 O(n²) 复杂度,是长上下文又慢又贵的原因,位置编码决定了模型的外推能力,是超长上下文效果会明显退化的原因
- Scaling Law:解释了"大力出奇迹"的由来,对应用开发者是背景知识,知道是什么就可以
2、API 接口(需要动手实践)
-
消息格式:System、User、Assistant 三种角色的分工
-
多轮对话:本质是无状态的,每次请求都要把完整历史带上
-
流式输出协议:SSE
-
影响输出随机性的采样参数:Temperature、Top_p
-
稳定的提示词前缀可以被缓存复用,省 token、降延迟的有效手段
3、上下文 Context
-
常见模型的窗口大小、超窗口后的截断策略
-
Lost in the middle:塞在上下文中间的信息容易被模型忽略
-
长上下文对延迟和成本的实际影响
4、局限性
- 依赖训练数据、有知识截止时间、会幻觉、看不到私域知识、更新知识困难、训练成本高
5、通用模型 vs 推理模型
-
推理模型:把"思考过程"内化了,用更高的延迟和 token 换更强的推理、规划能力
-
模型选择:简单抽取、改写、分类用通用模型,复杂推理、多步规划上推理模型
6、多模态模型
- 了解图文、音视频输入的基本能力边界
二、提示词工程
核心目标:稳定且可控地完成任务
1、设计要素
- 任务目标、上下文、角色、受众、样例、输出格式
2、构建技巧
- 思维链、Few-shot、自我验证、格式化输出,用推理模型时,手动写 CoT 的收益大幅下降甚至有害,模型自己会拆解步骤,硬塞一套思考流程反而是限制它,CoT 主要是给通用模型用的
3、System Prompt 设计
- 角色、约束、输出规范这类稳定的东西放 system prompt,动态输入放 user prompt中
4、结构化输出
可靠的 JSON,用 Function Calling、JSON mode、约束解码
5、Meta Prompting
用大模型来优化提示词:基于参考答案做自动化评测,把"调 prompt"变成能迭代的工程
6、提示词结构化
用结构化模板写复杂指令,可维护、可复用、稳定性更高
7、防注入
- 关键词过滤、安全护栏、指令边界设计、该拒答时拒答,用户输入永远当不可信数据处理
补充:真正落地时,关键提示词往往需要和领域、业务专家一起打磨,他们知道什么是对的输出,你知道怎么让模型稳定产出,需要配合
三、检索增强生成(RAG)
核心目标:给模型接上私域知识和实时信息,降低幻觉,企业里最容易落地的场景
1、完整流程
建立索引:文档解析、文本切片、向量化、索引存储
检索生成:知识检索、答案生成、引用溯源
2、向量检索原理
Embedding 的文本向量化机制、相似度计算(余弦相似度、点积)
3、向量数据库选型
-
FAISS(轻量、适合原型和中小规模)
-
Milvus(生产级)
-
Elasticsearch(已有 ES 技术栈、要做混合检索时直接使用)
4、混合检索
向量检索(语义)+ BM25(关键词)融合,纯向量对专有名词、编号、代码这类需要精确匹配的东西经常召不回,需要补充 BM25
5、常见优化方法
-
知识治理、Query 改写、多路召回(HyDE 假设文档、多角度改写)、切片策略优化、引入 Rerank 重排、元数据过滤
-
Contextual Retrieval:切片前先给每个 chunk 补一段所属上下文再做向量化,能显著降低"切碎后丢失语境导致召不回"的问题
-
Agentic RAG:把检索做成 Agent 能反复调用的工具,让模型自己决定检索几次、检索什么、要不要换个 query 再来一次,这是 RAG 和 Agent 的交汇点,也是当前把复杂问答做扎实的主流方向
6、自动化评测
- Ragas、TruLens 等框架,核心指标:忠实度、答案相关性、上下文召回率,召回和生成分开看,先确认召回到了正确的内容,再评估生成质量
7、多模态 RAG
图文混合知识库下,图像、表格的索引与检索方法
8、GraphRAG
基于知识图谱做实体关联增强检索,适合多跳、复杂关系推理的场景
四、Agent 智能体应用
核心目标:从调一次大模型,进化到"让模型自己规划、调工具、把任务干完"
1、基础架构
规划、感知、执行、记忆(短期记忆、长期记忆)四个组件怎么协作
2、工具调用
-
Function Calling 的工作原理
-
工具设计原则:描述写清楚、粒度切合适、错误信息要可读(模型靠错误信息自我纠正)
-
MCP 协议、A2A 协议、Skills 各自解决什么问题
3、工作流 vs 自主规划
能用固定工作流解决的,不要上自主 Agent,因为自主性越高,越难调试、越贵、越不可控,理解什么时候用编排好的工作流、什么时候让大模型自己规划
4、常见设计模式
- 单 Agent:ReAct 循环、Plan-and-Execute
- 多 Agent:串行、并行、主从、分层
5、原型构建能力
任务分解、角色划分的思路,能基于成熟框架搭出业务 Agent 原型
6、上下文工程(Context Engineering)
Agent 出问题,大部分原因是上下文没管好,每一步往窗口里塞什么:历史怎么压缩、记忆怎么取回、工具返回结果怎么裁剪、无关信息怎么剔除
7、记忆系统
短期记忆(当前对话)、长期记忆(持久化存储 + 按需检索),别把所有东西都堆进上下文,该外置的外置、用到再取
8、工程可靠性设计
任务中断恢复、幂等性设计、循环检测、超时与降级处理,Agent 本质上还是个分布式服务,该有的容错一样不能少
9、评测与迭代
任务完成率、工具调用准确率等指标,Agent 评测比单轮问答难,因为完成任务的路径不唯一,要区分轨迹评测(过程对不对)和结果评测(最终对不对),两者都要看
五、大模型应用工程实践
核心目标:把 Agent 原型变成高并发、安全、可上线的线上服务
1、主流 Agent 开发框架
LangChain、LangGraph、Spring AI 的架构和组件,按场景和团队技术栈选型
2、可观测性
LangSmith、LangFuse 等平台:能追踪每一步的输入输出、token 消耗、延迟
3、内容安全与合规
安全护栏,敏感问题拒答或转人工,防止违法违规、歧视偏见、隐私泄露、幻觉信息输出,硬约束,这是上线的前提
4、监控与治理
审计日志、用户问答记录、异常告警
理解数据飞轮,根据线上真实数据怎么优化prompt、知识库和评测集
5、成本与性能优化
QPS 限流与多级队列、语义缓存、Prompt 压缩、Prompt 缓存(稳定前缀复用)、Context 截断、降级策略
6、应用安全
身份鉴权、网络隔离、密钥管理、最小权限原则
六、大模型微调原理
核心目标:对 Agent 开发工程师,这部分不需要自己动手训,理解原理、能判断"要不要微调"就够了
1、训练原理:预训练和微调的区别
2、机器学习、深度学习、神经网络之间的层次关系
3、核心概念:模型参数(权重)、损失函数、知识蒸馏
4、梯度下降算法:训练超参的作用(batch size、learning rate、eval steps、epoch)
5、全参微调 vs 高效微调:Prompt Tuning、LoRA / QLoRA 的适用场景和资源消耗差异
6、模型对齐:RLHF(人类反馈强化学习)与 DPO(直接偏好优化)的基本思想
7、常用评测指标:分类任务(Accuracy / F1)、文本生成(BLEU / ROUGE)、推理能力基准(HumanEval / MMLU)
01
什么是AI大模型应用开发工程师?
如果说AI大模型是蕴藏着巨大能量的“后台超级能力”,那么AI大模型应用开发工程师就是将这种能量转化为实用工具的执行者。
AI大模型应用开发工程师是基于AI大模型,设计开发落地业务的应用工程师。
这个职业的核心价值,在于打破技术与用户之间的壁垒,把普通人难以理解的算法逻辑、模型参数,转化为人人都能轻松操作的产品形态。
无论是日常写作时用到的AI文案生成器、修图软件里的智能美化功能,还是办公场景中的自动记账工具、会议记录用的语音转文字APP,这些看似简单的应用背后,都是应用开发工程师在默默搭建技术与需求之间的桥梁。
他们不追求创造全新的大模型,而是专注于让已有的大模型“听懂”业务需求,“学会”解决具体问题,最终形成可落地、可使用的产品。
优快云粉丝独家福利
给大家整理了一份AI大模型全套学习资料,这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
02
AI大模型应用开发工程师的核心职责
需求分析与拆解是工作的起点,也是确保开发不偏离方向的关键。
应用开发工程师需要直接对接业务方,深入理解其核心诉求——不仅要明确“要做什么”,更要厘清“为什么要做”以及“做到什么程度算合格”。
在此基础上,他们会将模糊的业务需求拆解为具体的技术任务,明确每个环节的执行标准,并评估技术实现的可行性,同时定义清晰的核心指标,为后续开发、测试提供依据。
这一步就像建筑前的图纸设计,若出现偏差,后续所有工作都可能白费。
技术选型与适配是衔接需求与开发的核心环节。
工程师需要根据业务场景的特点,选择合适的基础大模型、开发框架和工具——不同的业务对模型的响应速度、精度、成本要求不同,选型的合理性直接影响最终产品的表现。
同时,他们还要对行业相关数据进行预处理,通过提示词工程优化模型输出,或在必要时进行轻量化微调,让基础模型更好地适配具体业务。
此外,设计合理的上下文管理规则确保模型理解连贯需求,建立敏感信息过滤机制保障数据安全,也是这一环节的重要内容。
应用开发与对接则是将方案转化为产品的实操阶段。
工程师会利用选定的开发框架构建应用的核心功能,同时联动各类外部系统——比如将AI模型与企业现有的客户管理系统、数据存储系统打通,确保数据流转顺畅。
在这一过程中,他们还需要配合设计团队打磨前端交互界面,让技术功能以简洁易懂的方式呈现给用户,实现从技术方案到产品形态的转化。
测试与优化是保障产品质量的关键步骤。
工程师会开展全面的功能测试,找出并修复开发过程中出现的漏洞,同时针对模型的响应速度、稳定性等性能指标进行优化。
安全合规性也是测试的重点,需要确保应用符合数据保护、隐私安全等相关规定。
此外,他们还会收集用户反馈,通过调整模型参数、优化提示词等方式持续提升产品体验,让应用更贴合用户实际使用需求。
部署运维与迭代则贯穿产品的整个生命周期。
工程师会通过云服务器或私有服务器将应用部署上线,并实时监控运行状态,及时处理突发故障,确保应用稳定运行。
随着业务需求的变化,他们还需要对应用功能进行迭代更新,同时编写完善的开发文档和使用手册,为后续的维护和交接提供支持。
03
薪资情况与职业价值
市场对这一职业的高度认可,直接体现在薪资待遇上。
据猎聘最新在招岗位数据显示,AI大模型应用开发工程师的月薪最高可达60k。
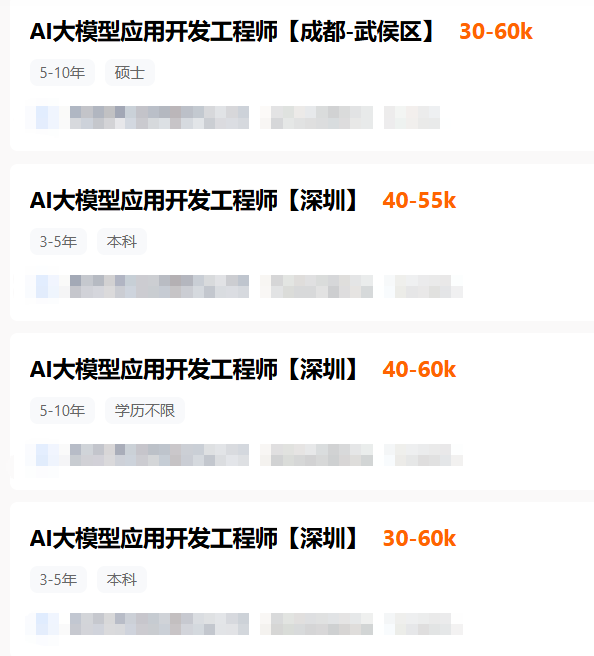
在AI技术加速落地的当下,这种“技术+业务”的复合型能力尤为稀缺,让该职业成为当下极具吸引力的就业选择。
AI大模型应用开发工程师是AI技术落地的关键桥梁。
他们用专业能力将抽象的技术转化为具体的产品,让大模型的价值真正渗透到各行各业。
随着AI场景化应用的不断深化,这一职业的重要性将更加凸显,也必将吸引更多人才投身其中,推动AI技术更好地服务于社会发展。
优快云粉丝独家福利
给大家整理了一份AI大模型全套学习资料,这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
 6092


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


