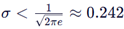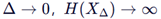理解:信息量,熵,微分熵

熵,信息熵,香农熵,微分熵,交叉熵,相对熵 https://blog.youkuaiyun.com/landstream/article/details/82383503 https://blog.youkuaiyun.com/pipisorry/article/details/51695283 https://www.zhihu.com/question/41252833 https://cloud.tencent.com/developer/article/1... 阅读详情

理解:信息量,熵,微分熵

摘要:

信息量 := (事件发生)不确定的量 := 惊讶程度 := (发生)概率倒数的对数 ,即:

I(x) = −log p(x)

说明:

1. 构造中,对数化是为了变乘除为加减,加负号是为了让信息量成为概率的减函数,且信息量取值非负。

2. 对数底,机器学习取e,单位纳特;通信领域取2,单位比特。

(信息)熵 := (整个样本空间下)随机变量整体不确定的量 := 随机变量取所有可能值包含的信息量 := 信息量的数学期望,即:

离散随机变量  (离散)熵H(X) = E[I(X)] = −∑P(x)logP(x); 其中P(x)为概率质量函数或叫分布律

连续随机变量  *微分熵*h(X) = E[I(X)] = -∫ f(x) log f(x) dx;其中f(x)为概率密度函数;

微分熵不是连续版的熵,而是熵在连续极限下的形式推广,使用需谨慎。

理解 信息论里的 信息量 熵

Qwen3-Max

当然!信息论中的信息量(自信息)和熵是理解“不确定性”与“信息”的基石。下面用直觉、公式和例子帮你清晰掌握。


一、信息量(自信息,Self-Information)

🔍 直觉:

越不可能发生的事件,发生时带来的信息量越大。

  • 明天太阳升起?→ 几乎必然 → 信息量 ≈ 0
  • 明天陨石撞地球?→ 极罕见 → 信息量极大

📐 数学定义:

I(x) = −logP(x)

对一个事件 ,其发生概率为 ,则它的信息量为:

  • 单位:比特(bit,以2为底)、纳特(nat,以e为底)等;
  • 概率越小 →  越大;
  • 若 (必然事件)→ (无新信息)。

✅ 信息量衡量的是单个事件的“惊讶程度”。


二、熵(Entropy)

🔍 直觉:

熵是“平均信息量”,即随机变量整体的不确定性。

  • 抛一枚公平硬币:结果难预测 → 熵高(1 bit);
  • 抛一枚两面都是正面的硬币:结果确定 → 熵为 0。

📐 数学定义(离散):

H(X) = E[I(X)] = −∑P(x)logP(x)

对随机变量 ,其概率分布为 ,则熵为:

  • 是信息量  的期望值;
  • 衡量:描述  所需的最小平均编码长度(香农信源编码定理)。

🌰 例子:

  • 公平硬币: bit
  • 偏置硬币(90%正面): bit(更可预测,熵更低)

三、关键关系总结

概念

对象

含义

公式

信息量 

单个事件 

该事件发生带来的“惊讶度”

熵 

随机变量 

整体不确定性的平均信息量

✅ 熵 = 信息量的期望
✅ 熵越高,系统越“混乱”,越难预测


四、为什么重要?

  • 数据压缩极限:
    无损压缩的平均码长 ≥ 熵(香农第一定理);
  • 机器学习:
    决策树用熵(或基尼不纯度)选择最优分割;
  • 通信:
    信道容量与熵密切相关;
  • 物理学:
    热力学熵与信息熵在统计意义上相通。

一句话总结:

信息量告诉你“一件事有多意外”,熵告诉你“一个系统平均有多不可预测”。
它们共同构成了信息论的起点——用数学度量“信息”本身。


附:连续随机变量的熵

连续随机变量的熵通常指的是微分熵(Differential Entropy),它是信息论中衡量连续随机变量不确定性或信息量的工具。微分熵的定义为:

H(X) = -∫ f(x) log f(x) dx

其中,f(x) 是随机变量 X 的概率密度函数(PDF)。微分熵与离散熵类似,但用于描述连续分布的随机变量。

微分熵的性质

微分熵的值并不总是无穷大,但在某些情况下可能趋于无穷大或为负值。以下是一些关键点:

  1. 熵值可能为负:微分熵的值可以为负,特别是当概率密度函数 f(x) 的值大于 1 时(例如在较小范围内分布很集中的变量)。这与离散熵始终为非负数不同。
  2. 熵值可能趋于无穷大:当概率密度函数的分布范围无限扩展(例如正态分布的标准差 σ 趋于无穷大)时,微分熵可能趋于无穷大。这是因为分布越宽广,不确定性越大,熵值也越高。
  3. 单位的影响:微分熵的单位与概率密度函数的定义有关,通常以“比特”或“纳特”为单位。与离散熵不同,微分熵没有严格的单位定义。

特定分布的微分熵

以下是一些常见分布的微分熵公式:

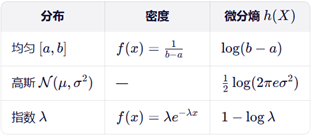
  • 正态分布:H(X) = 1/2 log(2πeσ²)。当 σ 趋于无穷大时,熵值趋于无穷大。
  • 均匀分布:H(X) = log(b - a)。区间 [a, b] 越大,熵值越高。
  • 指数分布:H(X) = 1 - log(λ)。参数 λ 越小,熵值越大。

结论

连续随机变量的熵是否为无穷大取决于其概率密度函数的分布特性。如果分布范围无限扩展(如正态分布的标准差无限大),熵值可能趋于无穷大。但在实际应用中,微分熵通常用于衡量有限范围内的随机变量不确定性,因此其值并不总是无穷大。

信息论 微分熵

Qwen3-Max

微分熵(Differential Entropy)是信息论中连续随机变量的“熵”推广,但它与离散熵有本质区别——它不是信息量的直接度量,也不能表示编码所需的最小比特数。理解它需要明确其定义、性质与局限。


一、定义

设连续随机变量 的概率密度函数为 ,则其微分熵定义为:

  • 单位:比特(若以2为底)或纳特(若以  为底);
  • 形式上类似离散熵,但将求和换成积分,概率质量换成概率密度 。

二、关键性质 vs 离散熵

性质

离散熵 H(X)

微分熵 h(X)

非负性

H(X)≥0

❌ 可为负值(如窄高斯分布)

信息意义

表示最优无损编码平均长度

❌ 不能直接解释为编码长度

坐标不变性

与符号标签无关

❌ 依赖变量单位(如米 vs 厘米结果不同)

最大熵分布

均匀分布

在固定方差下,高斯分布最大

📌 核心区别:
离散熵衡量“不确定性”,而微分熵衡量的是概率密度的“集中程度”,缺乏绝对信息意义。


三、为什么微分熵可以为负?

考虑一个非常集中的分布,例如:

  • X∼N(0,σ2),其微分熵为:

  • 当 时,h(X) < 0。

解释:
密度f(x)可大于1(如尖峰分布),此时 logf(x) > 0,导致−f(x)logf(x) 积分为负。
但这不违反信息论,因为微分熵本身不是“信息量”。


四、微分熵的真正用途

尽管不能直接度量信息,但在以下场景仍有重要价值:

1. 相对比较有意义

  • 虽然  绝对值无意义,但差值有意义;
  • 例如:互信息 I(X;Y) = h(X) + h(Y) − h(X,Y) 仍非负且有信息意义;
  • KL 散度  也有效。

2. 最大熵原理

  • 在给定约束下(如均值、方差),使微分熵最大的分布最“无偏”;
  • 例:固定方差 → 高斯分布;固定均值(正实数)→ 指数分布。

3. 连续信道容量

  • 香农公式 的推导依赖微分熵。

五、与离散熵的关系(极限视角)

若将连续变量X用精度Δ 量化为离散变量 XΔ,则:
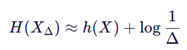
  • 当 ,(因无限精度需无限比特);
  • 微分熵 = 离散熵减去量化精度带来的发散项。

✅ 这说明:微分熵是“去除无限精度冗余后的相对熵”。


六、常见分布的微分熵

七、一句话总结

微分熵不是“连续版的熵”,而是离散熵在连续极限下的形式推广。

它本身无绝对信息意义,但其差值(如互信息、KL散度)有。
使用时切记:不要将其解释为“平均信息量”或“编码长度”。

它是连接连续概率模型与信息论的桥梁,但必须谨慎解读。

脑电EEG常用的特征   最近学习有关脑电的一些基础知识,基于深度学习对脑电信号进行分类时,首先需要对脑电信号进行预处理(滤波等),这时一般不能将其作为数据进行学习,更常见的是提取脑电信号的特征,然后再用深度学习发掘特征与不同情绪的关联。脑电信号常见的特征有: 时域中: 平均值、标准差、一阶差分、归一化一阶差分、能量、功率、高阶过零分析。不稳定指数等 时频域: 功率谱密度、高阶谱、微分熵等 空间域: DASM、RASM、不对称系数、DCAU、多维度有向信息等 下面对上面所述的一些进行解析 1、微分熵DE: 式子中的 ZZZ 符 阅读详情

相关推荐

信息论的基本概念比较:自信息、香浓熵、微分熵、相对熵、交叉熵

信息论的基本想法是一个不太可能的事件居然发生了,要比一个非常可能的事件发生,能提供更多的信息。 希望能有一种量化信息的方法,并且具备一些性质,如: • 非常可能发生的事件信息量要比较少,并且极端情况下,确保能够发生的事件 应该没有信息量。 • 较不可能发生的事件具有更高的信息量。 • 独立事件应具有增量的信息。例如,投掷的硬币两次正面朝上传递的信息量, 应该是投掷一次硬币正面朝上的信息...

陆上溪流 6955

【计算机科学与技术】信息论笔记(6):微分熵

本篇是学习信息论的入门笔记,希望能与各位分享进步!这是第六章:微分熵~

招财猫qwq的博客 3646

微分熵_Differential Entropy_matlab

【达摩老生出品,必属精品,亲测校正,质量保证】 资源名:微分熵_Differential Entropy_matlab 资源类型:matlab项目全套源码 源码说明: 全部项目源码都是经过测试校正后百分百成功运行的,如果您下载后不能运行可联系我进行指导或者更换。 适合人群:新手及有一定经验的开发人员

脑电特征中的微分熵(DE)计算

最近参加了一个脑电相关的竞赛,其中有一个赛道是情绪识别,根据脑电数据将情绪进行4分类,查了一些文献,使用了包括时域、频域、空间域的一些特征,最后发现微分熵作为特征的分类效果最好。 相关参考文献整理下载: https://download.youkuaiyun.com/download/zhoudapeng01/12845100 微分熵作为作为香农熵在连续变量上的推广形式其计算比较简单: 参考:http://cg.cs.tsinghua.edu.cn/people/~Yongjin/N112018-00337.p

zhoudapeng01的专栏 1万+

Steam游戏服务器攻防全景解读——如何构建游戏级抗DDoS防御体系?

当检测到TCP/UDP混合攻击时,应触发预设的熔断策略:优先保障游戏大厅服务的UDP 27015端口,临时限制匹配系统的TCP连接数。针对Steam游戏服务器特有的UDP 4380端口,需配置协议合规性检查规则:限制数据包长度不超过128字节,强制校验请求来源IP的真实性。Steam游戏服务器的防护需要平衡安全性与玩家体验,通过协议深度解析、智能流量调度和服务端加固的三维防御体系,可构建游戏行业专属的抗DDoS护城河。答:采用弹性防护方案,基础防护带宽保持50Gbps,遭遇攻击时自动扩展至T级清洗能力。

2501_91486804的博客 1456

YOLOv8改进 - 注意力篇 - 引入CAA注意力机制

YOLOv8改进 - 注意力篇 - 引入CAA注意力机制

浪子L的博客 5224

微分熵(Differential Entropy)与连续分布的随机变量(正态分布、均匀分布、指数分布)

对于一个连续随机变量XXX,其概率密度函数(PDF)为pxp(x)px,那么它的微分熵HXH(X)HXHX−∫−∞∞pxlog⁡pxdxHX−∫−∞∞​pxlogpxdxpxp(x)px是XXX的概率密度函数(PDF),表示在某个点xxx处的概率密度。log⁡\loglog是以自然对数为底(可以使用log⁡2\log_2log2​表示信息量为比特,或使用ln⁡\lnln。

分享各种学习心得和遇到的问题 2406

基于Python+OpenCV中文及符号检测

一、项目背景与意义在图像处理、文档识别、自动翻译等场景中,中文及符号的准确检测是一个重要且复杂的任务。传统的字符检测方法往往对英文等拉丁字母系的识别效果较好,但对中文及特殊符号的识别准确率较低。本项目旨在利用Python编程语言结合OpenCV库,开发一个能够高效、准确地检测图像中中文及符号的系统,为相关领域的研究和应用提供技术支撑。二、技术实现图像预处理:利用OpenCV的图像处理功能,对输入的图像进行灰度化、二值化、滤波去噪等预处理操作,以提高中文及符号检测的准确性[1]。

2301_79809972的博客 1120

微分熵和连续随机变量的信息度量【**】

对于一个连续随机变量XXX,其概率密度函数(pdf)为pxp(x)px。微分熵HXH(X)HXHX−∫pxlog⁡1pxdx−∫pxlog⁡pxdxHX−∫pxlogpx1​dx−∫pxlogpx))dx这个公式看起来与离散随机变量的熵公式类似,只是将离散情况下的求和符号替换为了积分符号,因为我们现在处理的是连续概率密度函数。最后,互信息IX;YI(X;Y)IX;Y。

qq_51011530的博客 1678

Springboot信息泄露以及heapdump的利用

努力是为了不平庸~安全有些时候是枯燥的,这一次,让我们先人一步,趣学渗透!

LiBai'S BLOG 3万+

【Codex Sandbox 与审批机制:小白也能看懂的实用教程】

这篇教程介绍了Codex工具中的沙盒(Sandbox)和审批(Approvals)机制,帮助用户安全高效地使用Codex协作。沙盒限制Codex访问范围,审批机制则控制敏感操作权限。文章详细讲解了五种常见模式:最安全的安全只读浏览、只读非交互、仓库内编辑、Auto预设和不推荐的YOLO模式。还提供了新手使用路径建议、配置示例和实战场景范式,包括如何测试沙盒行为、不同系统下的实现方式以及常见问题解答。最后附上速查清单,帮助用户快速选择合适的权限组合。

zsr154278963的博客 6713

信息论:熵与互信息

熵/信息熵http://这篇文章主要讲:熵, 联合熵(joint entropy),条件熵(conditional entropy),相对熵(relative entropy,KL 距离),互信息(mutual information),交叉熵(cross entropy),困惑度(perplexity)。熵/信息熵在信息论中,熵是接收的每条消息中包含的信息的平均量,又被称为信息熵、信源熵、平均自信息量。这里, 消息代表来自分布或数据流中的事件、样本或特征。

皮皮blog 10万+

Windows本地部署Ollama+qwen本地大语言模型Web交互界面并实现公网访问

本文主要介绍如何在Windows系统快速部署Ollama开源大语言模型运行工具,并安装Open WebUI结合cpolar内网穿透软件,实现在公网环境也能访问你在本地内网搭建的大语言模型运行环境。近些年来随着ChatGPT的兴起,大语言模型 LLM(Large Language Model)也成为了人工智能AI领域的热门话题,很多大厂也都推出了自己的大语言模型,并或多或少的开源了自己的大语言模型,今天就来分享一个最近很火,且对于小白来说比较好上手本地部署的运行本地LLM的工具Ollama。

迪之的博客 1652

信息论与编码篇---微分熵

微分熵是连续概率分布集中程度的度量,单位是比特。与离散熵不同,微分熵可正可负:当分布比1米均匀更集中时为负,更分散时为正。其核心公式为h(X)=-∫f(x)logf(x)dx,其中f(x)是概率密度(可1)。常见分布的微分熵:均匀分布h=log₂(b-a),高斯分布h=½log₂(2πeσ²),指数分布h=log₂(e/λ)。微分熵会随单位变化,不是绝对信息量,但互信息和相对熵是单位不变的真信息量。

在你不想做的时候,正是应该做的时候。 818

无线控制的隐形桥梁:深入解析NRF24L01在电机控制中的数据传输艺术

本文深入解析NRF24L01无线模块在电机控制中的数据传输技术,涵盖通信机制优化、抗干扰策略及实时性保障。通过舵机和无刷电机的实战案例,展示如何构建稳定高效的无线控制系统,为嵌入式开发提供完整解决方案。

j7k8l的博客 333

HFSS与AI融合:智能算法如何重塑天线设计流程

本文探讨了HFSS与AI融合如何通过智能算法革新天线设计流程。在5G/6G通信时代,AI技术如机器学习和遗传算法显著提升了高频电磁场仿真效率,将传统设计周期从数周缩短至数小时,并优化了天线性能。文章详细介绍了AI与HFSS的集成策略、关键技术突破及典型应用案例,展示了智能算法在天线设计中的巨大潜力。

weixin_29035147的博客 781

连续信源微分熵+AEP

目录 一:连续信源 最大熵定理 二:渐进均分性 1:随机变量收敛性 2:大数定律 3:AEP(渐进均分性) 4:典型集 三:数据压缩 一:连续信源 1)连续随机变量的微分熵 由概率密度函数可知:被积函数和区间的积分表示的是发生的概率。 由于:连续随机变量的取值是无限个,不确定性为无限大。确定输出某值的信息量也是无穷大,这里丢掉无穷大那一项...

laugh哥的博客 2279

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

机器学习中的熵、信息量、交叉熵和 KL 散度:从入门到严谨

本文通过四个难度层级系统介绍了机器学习中的熵、信息量、交叉熵和KL散度概念。从直觉层面的猜谜游戏类比出发,逐步深入到严谨数学定义:熵衡量系统不确定程度,信息量反映事件发生的惊讶程度,交叉熵表示用错误分布处理真实分布的平均信息开销,KL散度则量化两个分布间的差异。文章还阐述了这些概念在深度学习中的实际应用,如交叉熵损失函数与最大似然估计的等价关系,为理解机器学习中的信息论基础提供了清晰的渐进式框架。

AI架构师易筋 1125

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

信息论与编码篇---连续随机变量的微分熵

微分熵是连续随机变量的熵度量,与离散信息熵不同,它可以为负数。核心区别在于离散熵计算有限可能性的不确定性,而微分熵衡量概率密度分布的集中程度。微分熵以1米均匀分布为参照点(熵=0),更集中的分布熵为负,更分散的为正。虽然微分熵本身会随坐标变换而改变,但互信息和相对熵这两个衍生概念在连续情况下仍保持物理意义。在机器学习中,微分熵被广泛应用于VAE、强化学习等场景。关键要理解:微分熵不是绝对信息量,而是相对于参照分布的集中程度度量。

在你不想做的时候,正是应该做的时候。 810

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

信息论:互信息、熵、概率分布、对数函数

Y) 衡量的是,了解 X 能告诉你多少关于 Y 的信息,也就是通过学习 X 能解决多少关于 Y 的不确定性。例如,当我们交谈时,我的话语是X,你的理解是Y。高互信息量意味着我的话语真正减少了你的不确定性,我们是在真正地沟通,而不是互相制造噪音。其中,H(Y) 是 Y 本身的熵(不确定性),H(Y|X) 是在已知 X 的情况下 Y 的熵。但就概率而言:1枚硬币有2种可能的结果,2枚硬币有4种结果,n枚硬币有2ⁿ种结果。它是 Y 在 X 所有可能值上的熵的预期,并根据每个 X 的可能性进行加权。

数学、计算机相关的知识 945

机器学习中各种熵的定义及理解

转载:https://www.cnblogs.com/wkang/p/10068475.html 作者:Bo_hemian 机器学习领域有一个十分有魅力的词:熵。然而究竟什么是熵,相信多数人都能说出一二,但又不能清晰的表达出来。 而笔者对熵的理解是:“拒绝学习、拒绝提升的人是没有未来的,也只有努力才能变成自己想成为的人”。 下图是对熵的一个简单描述: 熵可以理解为是一种对无序状态的度...

Lylianko的专栏 1112

10-信息论

信息量 熵

小帆自留地 601

近似熵 样本熵 模糊熵 & 熵 信息熵

无

try_trying_try的博客 2231

熵的可加性:信息论核心原理与应用解析

熵作为信息论中的基本概念,量化了信息的不确定性程度。其可加性原理表明,独立随机变量的联合熵等于各自熵的和,这一性质源于概率论中独立事件的乘法规则。在工程实践中,熵的可加性为数据压缩、特征选择和密码系统设计提供了理论基础,例如在JPEG编码和分布式存储系统中实现高效处理。理解这一原理需要掌握离散与连续变量的数学证明,以及其在机器学习特征工程和量子通信等前沿领域的延伸应用。通过分析熵的可加性与互信息的关系,可以优化实际系统中的信息处理流程,特别是在处理准独立数据时平衡计算效率与精度。

weixin_28221501的博客 16

[AI算法]:信息论相关概念总结以及理解

机器学习基础–信息论相关概念总结以及理解 文章目录机器学习基础--信息论相关概念总结以及理解1. 信息量(熵)2. KL散度3. 交叉熵4. JS散度 摘要: 熵(entropy)、KL 散度(Kullback-Leibler (KL) divergence)和交叉熵(cross-entropy)以及JS散度,在深度学习以及机器学习很多地方都用的到,尤其是对于目标函数和损失函数的定义。在逻辑回归问...

Bin_Dut的博客 2001
上一篇: 理解 :for,while与do while
下一篇: 形参与实参,Python里的
jei_algorithm
博客等级 码龄5年 0粉丝 8原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值