理解:联合熵,条件熵,互信息,协方差

熵、信息量、条件熵、联合熵、互信息简单介绍 近期在看对比学习论文,发现有不少方法使用了互信息这种方式进行约束,故在此整理一下网上关于互信息的相关内容。 阅读详情

理解:联合熵,条件熵,互信息及协方差

摘要:

X的熵H(X)

==> X, Y共同(注意不是同时)的熵,即联合熵H(X, Y)

==>给定X后,Y的(剩余)不确定量,即条件熵 H(Y|X)

==>给定X,而消除的Y的(部分)不确定量 := XY间的互信息量I(X, Y),具有对称性。

H(X, Y) := H(X∪Y)

H(X, Y) = H(X) + H(Y|X) = H(Y) + H(X|Y) ;链式法则

H(Y|X) := H(X, Y) - H(X)

H(X, Y) = H(X) + H(Y) - I(X, Y)

I(X, Y) := H(X) - H(X|Y) = H(Y) - H(Y|X) = I(Y, X)

协方差仅用于线性相关

互信息量用于衡量所有相关

联合熵与条件熵

理解联合熵(Joint Entropy)和条件熵(Conditional Entropy)的关键在于:它们描述的是多个随机变量“不确定性”的不同组合方式。


🌟 一句话直觉

  • 联合熵 (H(X,Y)):

“同时说出 (X) 和 (Y) 的值,平均需要多少比特?”

  • 条件熵 (H(Y|X)):

“已经知道 (X),再告诉你 (Y),平均还需要多少比特?”


一、联合熵 (H(X, Y))

✅ 定义:

🔍 含义:

  • 衡量一对随机变量 ((X, Y)) 整体的不确定性;
  • 是描述整个联合事件所需的最小平均编码长度。

📌 例子:

掷一枚公平硬币((X):正/反),再掷一颗公平骰子((Y):1–6)。

  • (H(X) = 1) bit,(H(Y) \approx 2.58) bits;
  • 因为独立,(H(X,Y) = H(X) + H(Y) \approx 3.58) bits。
    → 要完整描述一次“硬币+骰子”结果,平均需约 3.58 比特。

二、条件熵 (H(Y|X))

✅ 定义:
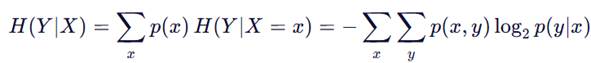
🔍 含义:

  • 在已知 (X) 的前提下,(Y) 的平均剩余不确定性;
  • 可理解为:“给定 (X) 后,预测 (Y) 还有多难?”

📌 例子:

设 (X) = 天气(晴/雨),(Y) = 地面是否湿(是/否)。

  • 若 (X =) “下雨”,则 (Y) 几乎必为“湿” → (H(Y|X=\text{雨}) \approx 0);
  • 若 (X =) “晴天”,则 (Y) 仍有不确定性(可能洒水车)→ (H(Y|X=\text{晴}) > 0);
  • (H(Y|X)) 是这两个条件熵的加权平均。

💡 如果 (Y) 完全由 (X) 决定(如 (Y = X^2)),则 (H(Y|X) = 0)。


三、核心关系:链式法则(Chain Rule)

这是理解三者联系的钥匙:

H(X, Y) = H(X) + H(Y|X)

  • 总不确定性 = (X) 的不确定性 + 知道 (X) 后 (Y) 的剩余不确定性;
  • 对称地:(H(X, Y) = H(Y) + H(X|Y))。

✅ 推论:

  • 若 (X, Y) 独立:(H(Y|X) = H(Y)),所以 (H(X,Y) = H(X) + H(Y));
  • 若 (X, Y) 完全相关(如 (Y = X)):(H(Y|X) = 0),所以 (H(X,Y) = H(X))。

四、信息图**(Venn Diagram)

用维恩图直观展示:

        ___________

       /           \

      /    H(X)     \

     /   _______     \

    |   | I(X;Y)|     |   ← 互信息(共享信息)

    |   |_______|     |

     \      H(Y)      /

      \_____________/

  • (H(X)) = 左圆总面积
  • (H(Y)) = 右圆总面积
  • 重叠部分 = (I(X;Y))(互信息)
  • (H(Y|X)) = 右圆中不重叠的部分
  • (H(X,Y)) = 两圆并集总面积

由此可得:  H(Y|X) = H(Y) - I(X;Y)


五、常见误区澄清

误区

正确理解

“条件熵一定小于边际熵”

✅ 对!因为 (H(Y

“(H(Y

X) = H(X

“联合熵总是大于单个熵”

✅ 是的:

(直观解释,增加元素,总会增加不确定性)


六、为什么重要?—— 应用场景

  • 机器学习特征选择:选使 (H(Y|X_i)) 最小的特征 (X_i)(即最能减少标签不确定性的);
  • 数据压缩:联合熵是无损压缩多变量序列的理论极限;
  • 通信系统:(H(X|Y)) 表示接收端解码后对发送端的剩余不确定性;
  • 因果推断:不对称的条件熵可用于检测方向性(如 (H(Y|X) < H(X|Y)) 暗示 (X \to Y))。

✅ 终极总结

概念

问题

公式

熵 (H(X))

描述 (X) 需多少信息?

(-\sum p(x)\log p(x))

联合熵 (H(X,Y))

描述 ((X,Y)) 需多少信息?

(-\sum p(x,y)\log p(x,y))

**条件熵 (H(Y

X))**

已知 (X),描述 (Y) 还需多少信息?

记住链式法则:总不确定性 = 已知部分 + 未知部分。
这就是信息世界的“守恒律”。

理解互信息

理解互信息(Mutual Information, MI)是掌握信息论核心思想的关键一步。它揭示了两个随机变量之间“共享信息”的本质,是衡量变量相关性、特征选择、通信效率乃至机器学习中表示学习的重要工具。


一、直觉:互信息 = “知道一个变量后,对另一个变量的不确定性减少了多少”

想象你有两个变量:

  • :今天是否下雨(是/否)
  • :地面是否湿(是/否)

如果你不知道 ,那么 有一定不确定性(可能洒水车经过);
但如果你知道 ,那么你几乎可以确定 —— 的信息大幅减少了 的不确定性。

✅ 互信息 就是这种“不确定性减少量”的数学度量。


二、数学定义(三种等价形式)

设 为离散随机变量,联合分布为 ,边缘分布为 。

1. 基于熵的定义(最常用)

I(X, Y) = H(X) - H(X|Y) = H(Y) - H(Y|X)

  • H(X): X的熵(不确定性);
  • H(X|Y):已知 Y后 X的条件熵(剩余不确定性)
  • 所以  I(X,Y) = 因知道 Y而消除的 X 的不确定性。

2. 对称形式

I(X, Y) = H(X) + H(Y) - H(X, Y)

  • H(X, Y) 是联合熵;
  • 互信息 = 各自不确定性的和 − 联合不确定性;
  • 直观:若 X,Y 独立,则 H(X, Y) = H(X) + H(Y),故 I = 0。

3. KL散度形式(最深刻)

I(X, Y) = DKL​(p(x,y)∥p(x)p(y))

  • 即:联合分布  与独立假设下分布  之间的 KL 散度;
  • ✅ 互信息 = “变量间依赖程度”的度量:越大,越不独立。

💡 这个视角揭示了互信息的本质:它衡量的是“变量是否真的独立”。


三、关键性质

性质

说明

非负性

I(X, Y) ≥ 0,当且仅当 X⊥Y(独立)时取等号

对称性

I(X, Y) = I(Y, X)

单位

比特(bit,以2为底)、纳特(nat,以e为底)

与相关系数区别

互信息能捕捉任意非线性依赖(如 ),而皮尔逊相关只测线性

🌰 例子:例子:若 Y=X2,且 X∼N(0,1),则 Corr(X,Y)=0,但 I(X;Y)>0!


四、几何/图示理解:信息图**(Information Diagram)

用维恩图表示熵与互信息的关系:

text

编辑

        ___________

       /           \

      /    H(X)     \

     /   _______     \

    |   | I(X;Y)|     |

    |   |_______|     |

     \      H(Y)      /

      \_____________/

  • 整个圆 = H(X) 或 H(Y);
  • 重叠部分 = I(X, Y);
  • 非重叠部分 = 条件熵 H(X∣Y), H(Y∣X);
  • 联合熵  = 两圆并集

✅ 这张图让你一眼看懂:互信息是两个变量“共享的信息内容”。


五、为什么互信息如此重要?—— 应用场景

1. 特征选择(机器学习)

  • 选择与目标变量X互信息最大的特征 Y;
  • 优势:无需假设线性关系,适用于分类/回归。

2. 通信理论

  • 信道容量 ;
  • 表示:通过优化输入分布,最多能从输出  中获取多少关于输入  的信息。

3. 表示学习 / 自监督学习

  • InfoNCE、对比学习等目标函数隐含最大化互信息;
  • 思想:让不同视角的表示共享尽可能多的信息。

4. 神经科学 / 基因调控

  • 计算神经元放电模式与刺激之间的互信息;
  • 推断基因网络中的调控关系。

六、连续变量的互信息

对连续变量,用微分熵(differential entropy)定义:
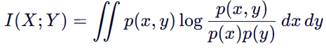
  • 仍满足非负性、对称性;
  • 但微分熵可为负,而互信息始终 ≥ 0(因 KL 散度非负)。

⚠️ 注意:连续互信息需谨慎估计(如用 kNN、核密度估计),不能直接套用离散公式。


七、一句话总结

互信息 量化了“知道 能告诉我们多少关于 的信息”,
它等于联合分布偏离独立假设的程度,
是信息论中衡量“依赖性”的普适标尺——无论线性与否、离散或连续。

当你看到两个变量“有关联”,不妨问一句:
“它们的互信息是多少?”
这比相关系数更能揭示真相。

互信息和协方差的区别

互信息(Mutual Information, MI)和协方差(Covariance)都是用来衡量两个变量之间“关联性”的工具,但它们出发点、适用范围、捕捉的依赖类型和数学本质完全不同。理解它们的区别,是掌握现代数据分析与机器学习的关键。

下面从多个维度进行清晰对比:


一、核心思想对比

指标

核心思想

协方差

衡量两个变量线性共变趋势:当一个变量高于均值时,另一个是否也倾向于高于均值?

互信息

衡量两个变量共享的信息量:知道一个变量的值,能减少多少对另一个变量的不确定性?

✅ 协方差关注“数值如何一起变化”;
✅ 互信息关注“信息如何相互揭示”。


二、数学定义

协方差(Covariance)

  • 若为正: 和  倾向同向偏离均值;
  • 若为负:反向偏离;
  • 若为零:无线性相关(但未必独立!)。

互信息(Mutual Information)
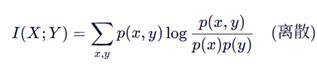
或

  • 衡量联合分布与独立分布的“距离”;
  • (完全独立)。

三、关键区别总结

维度

协方差

互信息

依赖类型

仅捕获线性关系

捕获任意统计依赖(线性、非线性、周期性、分段等)

独立性判断

Cov=0 ⇏ 独立(如 )

 独立(充要条件)

量纲

有单位(如 m·kg),受变量尺度影响

无量纲(单位为 bit/nat),尺度不变

对称性

对称:Cov(X,Y)=Cov(Y,X)

对称:I(X;Y)=I(Y;X)

归一化

需除以标准差得相关系数 

本身有界:

适用变量类型

通常用于连续实值变量

适用于离散、连续、混合变量


四、经典反例:协方差为零,但互信息很大!

考虑:

  • X∼N(0,1)
  • Y=X2

则:

  • Cov(X,Y)=E[X⋅X2]−E[X]E[X2]=E[X3]−0=0(因正态分布奇次矩为0)
  • 但显然:知道 X就完全知道 Y,反之知道 Y可缩小X  的可能范围(±√Y)

→ 协方差 = 0(误判为无关)
→ 互信息 > 0(正确揭示强依赖)

📉 这就是为什么在非线性系统(如神经网络、生物信号、金融时间序列)中,协方差常常失效,而互信息更可靠。


五、可视化对比

关系类型

协方差

互信息

线性正相关

高正值

高

线性负相关

高负值

高

抛物线 

≈0

高

圆形 

≈0

高

完全独立

0

0


六、实际应用中的选择建议

场景

推荐指标

探索线性趋势、构建线性模型(如线性回归)

协方差 / 相关系数

特征选择(尤其非线性问题)

互信息(如 sklearn 的 mutual_info_classif)

时间序列非线性依赖检测

互信息(如延迟嵌入分析)

通信/信息瓶颈/表示学习

必须用互信息

快速初筛大规模变量对

先用相关系数(计算快),再对可疑对用互信息深入

💡 在 Python 中:

python

编辑

from sklearn.feature_selection import mutual_info_regression

mi = mutual_info_regression(X, y)


七、一句话总结

协方差是“线性世界的尺子”,
互信息是“信息宇宙的罗盘”。

  • 如果你只关心“是否同涨同跌”,用协方差;
  • 如果你想知道“它们到底有没有关系——无论什么形式”,用互信息。

在真实世界充满非线性的今天,互信息提供了更普适、更本质的依赖度量,而协方差只是它在线性高斯假设下的一个特例。

信息熵、KL散度、交叉熵、互信息、点互信息 概率论基础知识的介绍 阅读详情

相关推荐

举例说明信息熵、互信息的计算过程

目录一、 计算公式1、信息熵H(X)2、联合熵H(X,Y)3、互信息I(X,Y)4、条件熵H(X|Y)二、举例说明1、信息熵H(X)2、联合熵H(X,Y)3、互信息I(X,Y)4、条件熵H(X|Y)总结 一、 计算公式 在shannon提出信息论到现在已经有70多年的历史。信息论中常用的概念有信息熵、联合熵、条件熵、互信息等概念。 1、信息熵H(X) 定义:一个离散随机变量X的熵H(X)定义为 H...

tangxianyu的博客 4万+

互信息(Mutual Information)

  本文根据以下参考资料进行整理:   1.维基百科:https://zh.wikipedia.org/wiki/%E4%BA%92%E4%BF%A1%E6%81%AF   2.新浪博客:http://blog.sina.com.cn/s/blog_6255d20d0100ex51.html   在概率论和信息论中,两个随机变量的互信息(Mutual Informatio...

weixin_30311605的博客 6807

机器学习100问

《机器学习100问》一共分为三部分,分别是上篇,中篇,下篇。每一篇列出最常见的机器学习基础概念问题。(拟打算在除夕前,出一个《机器学习100答》,针对这三篇列出的问题,一一作出简要的回答。) 注: 如果只列出名词,则问题是:它的定义,推导与应用是什么? 感知机; K近邻法; 朴素贝叶斯; 决策树; 逻辑斯蒂回归; SVM; 常见的核函数; Boosting; E...

cyy2learn的博客 1067

信息论:熵与互信息

熵/信息熵http://这篇文章主要讲:熵, 联合熵(joint entropy),条件熵(conditional entropy),相对熵(relative entropy,KL 距离),互信息(mutual information),交叉熵(cross entropy),困惑度(perplexity)。熵/信息熵在信息论中,熵是接收的每条消息中包含的信息的平均量,又被称为信息熵、信源熵、平均自信息量。这里, 消息代表来自分布或数据流中的事件、样本或特征。

皮皮blog 10万+

机器学习中的概率统计

有人说了,机器学习的算法涉及到大量的数学基础内容,那么我很想好好学习数学,为后面的算法学习做好准备。 果然很有眼光啊,那么这一篇文章我们来仔细讲讲机器学习中所涉及到的数学知识吧。可以这么说:机器学习的数学基础主要萌发于三门课程,高等数学、线性代数和概率统计。其中又以后两者更为居多。 感觉像是没说,我记得大学本科里咱们主要就是学了这三门数学课,考试也通过了,按理来说我们应该已经筑牢了基...

658

互信息量(Mutual Information,MI)计算及应用

互信息量(MI)是信息论中衡量两个随机变量依赖关系的核心指标,能够揭示线性与非线性关联。其数学定义为联合概率分布与边缘分布的比值对数期望,通过熵差量化变量间的信息共享程度。MI具有非负性、对称性等特性,可通过概率统计或数值方法计算,广泛应用于特征选择、NLP、图像处理等领域。尽管功能强大,但需注意尺度依赖、计算复杂度等局限性。与相关系数不同,MI能捕捉非线性关系,为数据分析提供更全面的依赖度量。

Cachel Wood的博客 480

数学基础之概率统计

3-1、为什么使用概率?&amp;nbsp; 概率论是用于表示不确定性陈述的数学框架,即它是对事物不确定性的度量。 在人工智能领域,我们主要以两种方式来使用概率论。首先,概率法则告诉我们AI系统应该如何推理,所以我们设计一些算法来计算或者近似由概率论导出的表达式。其次,我们可以用概率和统计从理论上分析我们提出的AI系统的行为。 计算机科学的许多分支处理的对象都是完全确定的实体,但机器学习却大量使用...

Henry_Zhao的博客 1100

【信息科学与工程学】【通信工程】第十二篇 信息论01

定理名称数学表述意义信源编码定理∀ϵ>0,∃码使 H(X)≤R<H(X)+ϵ无损压缩极限是熵信道编码定理若 R<C,∃码使 Pe​→0;若 R>C,Pe​有正下界信道容量是可靠传输极限率失真定理∀D,∃码使 R>R(D)可达 D;R<R(D)不可达有损压缩极限是率失真函数数据处理不等式X→Y→Z⇒I(X;Y)≥I(X;Z)处理不增加信息Fano不等式$H(X渐近均分性−n1​logp(Xn)→H(X)依概率典型序列等概率。

weixin_49199313的博客 508

第二章 数学/模型基础(数学部分)-2

又称KL散度描述两个概率分布P和Q差异的一种方法,记做D(P||Q)在信息论中,D(P||Q)表示用概率分布Q来拟合真实分布P时,产生的信息表达的损耗,其中P表示信源的真实分布,Q表示P的近似分布,也就是:使用基于Q的分布来编码服从P的分布的样本所需的额外的平均比特数。

组学之心,专注多组学/ 医学AI 领域 1022

STM32 FOC电机控制:手把手教你用CubeMX配置TIM1中心对齐PWM(含代码避坑)

本文详细解析了STM32 FOC电机控制中TIM1中心对齐PWM的配置方法,涵盖CubeMX图形化设置、HAL库代码调用及常见问题排查。特别针对L6230Q驱动芯片的使能逻辑和死区时间配置提供实用指南,帮助开发者高效实现无刷电机的高性能控制。

weixin_27027459的博客 444

Open5GS实战指南:Ubuntu 22.04环境下的5G核心网快速部署

本文提供Open5GS在Ubuntu 22.04环境下部署5G核心网的实战指南,涵盖环境准备、MongoDB配置、核心组件安装、WebUI部署及网络调优等关键步骤。通过详细的安装教程和常见问题解决方案,帮助开发者快速搭建开源5G核心网测试环境。

weixin_29202213的博客 540

17天学习之深度学习task01绪论与数学基础

绪论和深度学习概述 机器学习分类 名称 老师 学习方式 评价标准 有监督学习 有老师 跟着老师学 老师判断 无监督学习 无老师 自学 特定标准评价 强化学习 无老师 自学 自己评价 数学基础 矩阵论 矩阵的基本知识 矩阵 :一个二维数组,常用大写字母表示,比如矩阵A; 张量:0阶张量是标量;1阶张量是矢量;2阶张量是矩阵;3阶及以上叫张量; 矩阵的秩:rank(A) 矩阵的逆:① 是方阵②满秩;则是可逆矩阵; 矩阵的广义逆矩阵:①不是方阵的时候② 是奇异矩阵的时候。若ABA

小泥鳅 581

远程桌面(RDP)共享USB设备全攻略:不止Hyper-V,你的加密狗和CH340串口也能远程用

本文详细介绍了远程桌面(RDP)共享USB设备的完整解决方案,包括加密狗和CH340串口设备的远程使用技巧。通过RemoteFX USB重定向技术,用户可以在远程会话中无缝使用本地USB设备,提升工作效率。文章涵盖企业级配置、典型设备实战案例及高级故障排除方法,是远程工作者的实用指南。

weixin_42522964的博客 334

知识笔记

概念

一亩高粱 750

android 运动目标检测_MindSpore应用案例:AI对篮球运动员目标的检测

MindSpore作为一个端边云协同的开源的全场景AI框架,今年3月份开源以来,受到了业界的广泛关注和应用,欢迎大家参与开源贡献、模型众智合作、行业创新与应用、学术合作等,贡献您在云侧、端侧 (HiMindSpore 应用程序)、边侧以及安全领域的应用案例。MindSpore与您在AI领域共同成长,让AI使能千行百业,释放出强大的生产力。本文讲述的是MindSpore对篮球运动员目标的检测应用,通...

weixin_33603813的博客 835

VS配置RTKLIB(卫星定位开源代码)环境

@RTKlib代码调试教程-Visual Studio 2019 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Markdown编辑器, 可以仔细阅读这篇文章,了解一下Markdown的基本语法知识。 ##RTKLIB-rtklib_2.4.3 提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 @RTKlib代码调试教程-Visual Studio 2019 提示:这里可以添加本文要记录的大概内容: 例如:随着人工智能的不断发展,机器学习这门技

qq_42209977的博客 4486

读书笔记:程序员的数学 概率统计

读书笔记:程序员的数学 概率统计特点内容第一、二章 概率定义 多随机变量第三、四章 离散、连续分布第五章 协方差矩阵与多元正态分布第六、七章 估计与检验 伪随机数第八章 各类应用体会 之前读过程序员的数学、程序员的数学线性代数,这次就把程序员的数学:概率统计也看了。配上普林斯顿微积分读本,算是把高数三件套都过了一遍。虽然说也上过一遍概率论,但又只剩下一些零碎的记忆了。这次看一遍这本概率统计,看看能不能捞回来一点。 特点 跟本科上课的教材相比,它的特点和之前写过的这种数学入门书都非常像,就是干货少讲解多。

qq_42340373的博客 827

Pwntools不只是PWN:用它写个自动化Fuzz脚本,挖掘Linux命令行工具漏洞

本文探讨了如何利用Pwntools构建自动化Fuzz脚本,挖掘Linux命令行工具中的漏洞。通过详细的代码示例和实战案例,展示了Pwntools在Fuzzing中的高效性和灵活性,特别适合快速验证特定场景的安全问题。文章还提供了进阶技巧和避坑指南,帮助安全研究人员快速上手并提升测试效率。

weixin_28718345的博客 221

ML面试1000题系列(31-40)

本文总结ML面试常见的问题集 转载来源:https://blog.youkuaiyun.com/v_july_v/article/details/78121924 31、下列哪个不属于CRF模型对于HMM和MEMM模型的优势(B) A. 特征灵活 B. 速度快 C. 可容纳较多上下文信息 D. 全局最优首先,CRF,HMM(隐马模型),MEMM(最大熵隐马模型)都常用来做序列标...

weixin_30847271的博客 190

华为2024机考真题集合

2.中位数是指把一组数据从小到大排列,最中间的那个数,如果这组数据的个数是奇数,那最中间那个就是中位数,如果这组数据的个数为偶数,那就把中间的两个数之和除以 2,所得的结果就是中位数。在实际考试中会随机抽三道题目进行考察,其中两道100分卷题和一道200分卷题,总共400分。幼儿园组织活动,老师布置了一个任务:每个小朋友去了解与自己同一个小区的小朋友还有几个。3.查找整型数组中元素的众数并组成一个新的数组,求新数组的中位数。1.众数是指一组数据中出现次数量多的那个数,众数可以是多个。

qq_25360769的博客 5093

ABAP Cloud 开发教程的文章目录

本教程涵盖 ABAP 云端 Client 处理、多租户架构、ABAP Cloud开发、动态编程优化、SQL语法改进等技术主题。最新版本1.0.0(更新至2025-12-12),包含197篇文章,重点文章包括《ABAP Client Handling与隔离机制》《ABAP Platform 2021泛型编程》《SAP BTP ABAP多租户应用开发》等,为开发者提供从基础到进阶的实战指南。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1814

从概率估计到“LLM 训练是有损压缩”

本文探讨了如何用信息论方法分析大语言模型(LLM)的内部表征,重点讨论了互信息与熵的估计难题。由于LLM隐藏状态是高维连续向量,传统网格划分方法面临维数灾难;。文章比较了K近邻估计、神经互信息估计和参数化密度估计等方法的优劣,最终引入软熵估计器作为工程折中方案。

画心 527

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

深度学习的数学基础

线性代数 基本变量:标量、向量、矩阵、张量 基本运算:乘法、加法、逆运算;线性变换的几何意义 范数 特征分解:$A=V*diag(\lambda)*V^{-1}$ 奇异值分解:$A=Q*diag(\Sigma)*V$ 伪逆:$A^+=V^T*diag(\Sigma^{-1})*Q^T$ 迹运算:$tr(A)=\sum_{i}^{ }A_{ii}$;$tr(ABC)=tr(B...

dfj77477的博客 253

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

机器学习要点总结

1、哪些机器学习算法不需要做 归一化处理? 归一化处理能够:1)加速梯度下降算法的收敛;2)提高算法精确度(KNN:归一化后,求点对欧几里得距离,可以防止其仅依赖与value较大的特征,而忽略value较小的特征);3)防止特征值较大的特征所占权重 高于 其实际的作用,如linear regression,如果某一feature的值过大,则其权重势必很大,但是此时权重大小与该feature的重要度...

u014765410的博客 211

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

计算机视觉CV入门

计算机视觉,相对比自然语言处理这个领域来说入门门槛会稍微低些,而且图片视频相对于文字来说也更具有趣味性和易于理解。然而,这也会导致CV圈越来越卷,通过知乎相关热门问答便能体会到: 2016年——深度学习的春天是不是要来了? 2017年——人工智能是不是一个泡沫? 2018年——算法岗是否值得进入? 2019年——如何看待算法岗竞争激烈,供不应求? 2020年——如何看待算法岗一片红海,诸神黄昏? 2021年——如何看待算法岗灰飞烟灭?

m0_61899108的博客 1284

AI人工智能所需要的数学基础以及应用场景

神经网络权重矩阵、图像处理、自然语言处理中的词向量表示(如Word2Vec)。统计推断:假设检验、置信区间、最大似然估计(MLE)、最大后验估计(MAP)机器学习模型(如贝叶斯网络、隐马尔可夫模型)、数据分布分析、模型评估。决策树(ID3算法)、模型复杂度控制、生成对抗网络(GAN)。常见分布:高斯分布、伯努利分布、泊松分布、指数族分布。图论:图结构、最短路径算法、树结构(如决策树)梯度下降法及其变体(动量法、自适应学习率)矩阵分解的数值方法(LU分解、QR分解)向量与矩阵运算(加法、乘法、转置)

weixin_43720132的博客 704
下一篇: 理解:交叉熵,KL散度,JS散度,散度
jei_algorithm
博客等级 码龄5年 0粉丝 8原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值