Transformer模型实战篇

Transformer模型探索:Hugging Face库实战篇二——模型与分词器解析 在上一篇文章《开箱即用的 pipelines》中,我们通过 Transformers 库提供的 pipeline 函数展示了 Transformers 库能够完成哪些 NLP 任务,以及这些 pipelines 背后的工作原理。本文将深入介绍 Transformers 库中的两个重要组件:模型(Models类)和分词器(Tokenizers类)。 阅读详情

引入

基于Transformers的NLP解决方案的步骤如下:(以文本分类为例)

  1. 导入相关包,General,可以询问ai需要导什么包
  2. 加载数据集,Data_loader,Datasets
  3. 数据集划分,测试机,验证集,训练集,Datasets
  4. 数据集预处理,处理空的部分,Tokenizer+Datasets
  5. 创建模型,Model
  6. 设置评估函数,可以去hugging face上查看这个相应的评估指标有哪些,Evaluate
  7. 配置训练参数,训练批次,输出大小,日志打印频率,Training Argument
  8. 创建训练器,Trainer+Data Collator
  9. 模型训练,评估,预测,Trainer
  10. 如果只是想要用模型进行预测使用pipeline即可,不用子啊设置评估和训练函数了。Pipeline

显存优化分析

显存占用分析
  • 模型权重

    • 4Bytes*模型参数(因为每一个参数都是32bit的)
  • 优化器状态

    • 8Bytes*模型参数量,对于常用的AdamW优化器而言
  • 梯度

    • 4Bytes*模型参数量
  • 前向激活值

    • 取决于序列长度,隐层额外i都,Batch大小等多个因素
显存优化策略

使用hfl/chinese-macbert-large,330M进行测试

优化策略优化对象显存占用训练时间
Baseline(BS 32 ,MaxLength 128)-15.2G64s
+Gradient Accumulation (BS 1, GA 32)
gradient_accumulation_steps=32 梯度累加​
前向激活值,一次只计算一个批次是数据,为了防止效果变差,我们设置计算32个batch之后才进行参数优化7.4G260s
+Gradient Checkpoints (BS 1, GA 32)
gradient_checkpointing=True梯度检查点​
前向激活值 ,训练的过程中会存储很多没必要存储的信息,对于没有存储的激活值,可有在反向传播计算梯度的时候,让它重新计算即可。7.2G422s
+Adafactor Optiomizer(BS 1,GA32)
optim="adafactor" adafactor优化器 ​
优化器状态,默认的adaw优化器占用较大,可以用占用比较小的优化器5.0G406s
+Freeze Model(BS 1,GA32)前向激活值/梯度,冻结一部分参数,只训练分类器部分,模型效果会变差3.5G178s
+DataLength(BS1,GA32,MaxLength64)
在数据集中的maxlength处进行修改
前向激活值,缩短数据长度3.4G126s

其中对于这个+Freeze Model(BS 1,GA32作用就是冻结这个模型的bert部分,只训练这个模型的全连接层部分。

  • 这是因为:
    预训练模型(bert)已经学了很多中文知识,像「词典+语法」。
    我们的任务只是影评情感二分类,不想让它从头再学中文,只想让它学「如何把已掌握的知识转成情感标签」。
    所以把 bert 的大部分权重「冻住」,只训练后面新加的分类层,既省显存又省时间,还能防止过拟合。

  • 具体操作

    for name, param in model.bert.named_parameters():
        param.requires_grad = False
    model.bert 就是原始 BERT 的所有层
    循环把每一层的权重 param 设置成 requires_grad=False → 不再更新(梯度不计算)
    练时只有没被冻结的层(例如你后面接的 classifier 或 pooler)才会更新。
    

实战演练之命名实体识别

命名实体识别任务介绍

介绍

命名实体识别(Named Entity Recognition,简称NER)是指识别文本中具有特定意义的实体,
主要包括人名、地名、机构名、专有名词等。通常包括两部分:
(1)实体边界识别(从哪里到哪里是一个实体);(2)确定实体类别(人名、地名、机构名或其他)

eg 小明在北京上班

实体类别实体
地点北京
人物小明
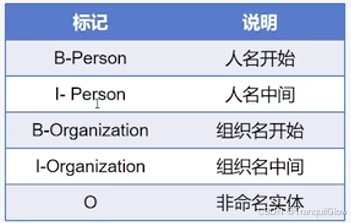
数据标注体系

常见的数据标注有IOB1、IOB2、IOE1、IOE2、IOBES、BILOU​

其中IOB2标注

  • I表示实体内部,,O表示实体外部,B表示实体开始
  • B/I-XXX,XXX表示具体的类别

IOBES标注

  • I或者M表示实体内部,O表示实体外部,B表示实体开始,E表示实体结束,S表示一个词单独形成一个
    命名实体
image

评估指标

Precision,Recall,f1

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

基于Transfromers的解决方案

  • ModelForTokenClassification的源码分析,这个地方看不太懂,先放在这里

评估函数

  • 需要额外安装seqeval

    • pip install seqeval
    • 安装过程中报错Microsoft Visual C++14.0 or greater is required.Getitwith
      "Microsoft C++ Build Tools
    • 进入https://my.visualstudio.com,下载C++buildtools,安装
  • evaluate.load(“seqeval”)

代码实战演练

数据集:peoples_daily_ner

预训练模型:hfl/chinese-macbert-base

代码如下所示:

导入相关包,加载数据集
导包
import evaluate
from datasets import load_dataset
from transformers  import AutoTokenizer,AutoModelForTokenClassification,TrainingArguments,Trainer,DataCollatorForTokenClassification

导入训练集
ner_datasets = load_dataset("peoples_daily_ner",cache_dir="./data" ,trust_remote_code=True)
ner_datasets

查看训练集第0个数据
ner_datasets["train"][0]
查看训练集数据的特征,包括模型是什么类型的数据,以及数据标注体系
ner_datasets["train"].features

获取模型的标注类型
label_list = ner_datasets["train"].features["ner_tags"].feature.names
label_list
数据集预处理

使用模型为:hfl/chinese-macbert-base

由于模型中的tokens是已经划分好了, 直接用tokenizer进行分词的话,它会将每一个划分好的词,当成一个句子
tokenizer = AutoTokenizer.from_pretrained("hfl/chinese-macbert-base")
tokenizer(ner_datasets["train"][0]["tokens"])
我们可以使用is_split_into_words=True 来讲这个不要当成一个句子
tokenizer(ner_datasets["train"][0]["tokens"],is_split_into_words=True)

一个单词可能被 tokenizer 拆成好几块积木(sub-word),我们要保证同一块原单词的每一块积木都贴上同一个标签

返回的字典里多了一组 “word_ids()” 索引,告诉你每块积木属于原列表里的第几个单词。

还有一个问题就是英文中可能会出现分词现象,一个单词被拆分成了多个,所以我们要写代码,进行判断哪些id是属于一个单词的。例如下面这个
res = tokenizer("interesting word")
res就会讲这个interestion划分为id,但是interesting并不是单独一个,而是多个值
res.word_ids(),这个word_ids可以用来判断这些id哪些是一组的。

具体实现如下所示:(这段代码的功能就类似于:给一串已经被切成小积木的乐高贴标签的过程)

假设原始数据如下:

原始 tokens(已分词)ner_tags(标签)
[“我”, “去”, “北京”][O, O, B-LOC]
  • ​O 表示“不是实体”
  • ​B-LOC 表示“地点实体的开头”
# 借助word_ids 实现标签映射
def process_function(examples):
    tokenized_exmaples = tokenizer(examples["tokens"], max_length=128, truncation=True, is_split_into_words=True)
    labels = []
    # 遍历这个标签
    for i, label in enumerate(examples["ner_tags"]):
        # word_ids() 返回 [None, 0, 1, 2, 2, None],0 → 原词列表第 0 个词“我”,2 → 原词列表第 2 个词“北京”(被拆成两块积木,都标 2)
        word_ids = tokenized_exmaples.word_ids(batch_index=i)
        label_ids = []
        for word_id in word_ids:  # 逐块积木
            if word_id is None: # [CLS]、[SEP]、PAD
                label_ids.append(-100)
            else:
                # word_id=0 → 原词0 → label[0]=O
                # word_id=1 → 原词1 → label[1]=O
                # word_id=2 → 原词2 → label[2]=B-LOC
                label_ids.append(label[word_id])
        # 执行上述循环后,label_ids = [-100, O, O, B-LOC, B-LOC, -100],实际代码里 O 和 B-LOC 会被替换成数字 id,如 0 和 1
        labels.append(label_ids)
    tokenized_exmaples["labels"] = labels
    return tokenized_exmaples

tokenized_datasets = ner_datasets.map(process_function, batched=True)
tokenized_datasets
print(tokenized_datasets["train"][0])
创建评估函数
  • predictions:模型猜的 数字标签 id(一排排学号)

  • labels:真正的 数字标签 id(一排排正确答案学号)

  • label_list:把数字翻译成文字标签的小词典
    例:label_list = [“O”, “B-PER”, “I-PER”, “B-LOC”, “I-LOC”]

    • 其中这个[label_list[p] for p, l in zip(prediction, label) if l != -100]​
      1. 取一对 (p, l)​
      2. 如果 l 不是 -100(不是特殊符号)
      3. 就把 p 转成文字标签 label_list[p] 存进列表
# seqeval 是专门给序列标注任务打分的裁判,支持 BIO / IOB2 等格式。
seqeval = evaluate.load("seqeval_metric.py")
seqeval

import numpy as np
def eval_metric(pred):
    predictions, labels = pred
    predictions = np.argmax(predictions, axis=-1) #每个位置取分数最高的索引,得到“预测标签 id”。

    # 将id转换为原始的字符串类型的标签
    true_predictions = [
        [label_list[p] for p, l in zip(prediction, label) if l != -100]
        for prediction, label in zip(predictions, labels) 
    ]

    true_labels = [
        [label_list[l] for p, l in zip(prediction, label) if l != -100]
        for prediction, label in zip(predictions, labels) 
    ]

    result = seqeval.compute(predictions=true_predictions, references=true_labels, mode="strict", scheme="IOB2")

    return {
        "f1": result["overall_f1"]
    }
创建训练器
args = TrainingArguments(
    output_dir="models_for_ner",
    per_device_train_batch_size=64,
    per_device_eval_batch_size=128,
    eval_strategy="epoch",
    save_strategy="epoch",
    metric_for_best_model="f1",
    load_best_model_at_end=True,
    logging_steps=50,
    num_train_epochs=1
)

trainer = Trainer(
    model=model,
    args=args,
    tokenizer=tokenizer,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    compute_metrics=eval_metric,
    data_collator=DataCollatorForTokenClassification(tokenizer=tokenizer)
)
模型训练
trainer.train()
trainer.evaluate(eval_dataset=tokenized_datasets["test"])
模型预测
from transformers import pipeline

# 使用pipeline进行推理,要指定id2label
model.config.id2label = {idx: label for idx, label in enumerate(label_list)}
model.config

# 如果模型是基于GPU训练的,那么推理时要指定device
# 对于NER任务,可以指定aggregation_strategy为simple,得到具体的实体的结果,而不是token的结果
ner_pipe = pipeline("token-classification", model=model, tokenizer=tokenizer, device=0, aggregation_strategy="simple")

res = ner_pipe("小明在北京上班")
res

# 根据start和end取实际的结果
ner_result = {}
x = "小明在北京上班"
for r in res:
    if r["entity_group"] not in ner_result:
        ner_result[r["entity_group"]] = []
    ner_result[r["entity_group"]].append(x[r["start"]: r["end"]])

ner_result

后续

后续博主讲的课还包括机器阅读理解,多项选择,文本相似度,检索机器人,文本摘要,生成对话机器人等实战演练课程。由于我没有做这些实验的需求,后续的实验演练课程笔记就不再做了。

我只通过这个命名实体的识别来了解这个Transformer模型实验的大致流程即可。后续如果有这些方面的实验需要去做,可以通过继续学习相关视频知识

‍

第86步 时间序列建模实战:Transformer回归建模 阅读详情

相关推荐

Transformer实战(4)——从零开始构建Transformer

相较于传统模型,如循环神经网络 (RNN),Transformer 的优势在于能够理解输入和输出序列中元素之间的关系,在大语言模型 (如 ChatGPT 和 DeepSeek) 的发展中起到了关键作用,为了从零开始构建 Transformer,首先探讨自注意力机制,包括查询 (query)、键 (key) 和值 (value) 向量,以及缩放点积注意力 (SDPA)。将层归一化和残差连接集成到多头注意力层中,并与前馈层结合,构建编码器层,堆叠编码器层构建编码器,还将实现 Transformer 中的解码器。

盼小辉丶的博客 3万+

Swin Transformer实战目标检测:训练自己的数据集

Transformer发轫于NLP(自然语言处理),并跨界应用到CV(计算机视觉)领域。 Swin Transformer是基于Transformer的计算机视觉骨干网,在图像分类、目标检测、实例分割、语义分割等多项下游CV应用中取得了SOTA的性能。该项工作也获得了ICCV 2021顶会最佳论文奖。 本课程将手把手地教大家使用labelImg标注和使用Swin Transformer训练自己的数据集。  本课程将介绍Transformer及在CV领域的应用、Swin Transformer的原理。 课程以多目标检测(足球和梅西同时检测)为例进行Swin Transformer实战演示。 课程在Windows和Ubuntu系统上分别做项目演示。包括:安装软件环境、安装Pytorch、安装Swin-Transformer-Object-Detection、标注自己的数据集、准备自己的数据集(自动划分训练集和验证集)、数据集格式转换(Python脚本完成)、修改配置文件、训练自己的数据集、测试训练出的网络模型、性能统计、日志分析。  相关课程: 《Transformer原理与代码精讲(PyTorch)》https://edu.youkuaiyun.com/course/detail/36697《Transformer原理与代码精讲(TensorFlow)》https://edu.youkuaiyun.com/course/detail/36699《ViT(Vision Transformer)原理与代码精讲》https://edu.youkuaiyun.com/course/detail/36719《DETR原理与代码精讲》https://edu.youkuaiyun.com/course/detail/36768《Swin Transformer实战目标检测:训练自己的数据集》https://edu.youkuaiyun.com/course/detail/36585《Swin Transformer实战实例分割:训练自己的数据集》https://edu.youkuaiyun.com/course/detail/36586《Swin Transformer原理与代码精讲》 https://download.youkuaiyun.com/course/detail/37045

【实战篇】【DeepSeek的模型炼丹术:如何把Transformer炖出佛跳墙的滋味?】

就像《食神》里的那碗黯然销魂饭,最简单的食材,最极致的功力。去年在算法峰会上,某大厂秀出千亿参数模型时,DeepSeek的架构师默默掏出手机点了个外卖——后来才知道他们用十分之一的参数量跑出了更优指标。配合自研的梯度裁剪算法,在A100上训练速度提升2.3倍,显存占用减少40%,效果堪比给模型穿了紧身衣——该瘦的地方瘦,该有肌肉的地方保留。这种动态剪枝让模型像壁虎尾巴,没用的部分自动脱落,重要的及时再生。处理长文本时,试试"分段注意力":把文章切成块,每块先自注意再跨块注意,显存占用直降70%

商务合作|问题讨论|交流学习 请联系作者微信,加微信请务必注明来意,博客主页有联系方式 323

Transformer网络原理与实战

Transformer网络是一种基于自注意力机制的神经网络,由Google于2017年提出,并被广泛应用于自然语言处理、语音识别、图像生成等领域。相对于传统的循环神经网络和卷积神经网络,Transformer网络具有更好的并行性和更高的计算效率,在处理长文本时表现更加出色。Transformer网络的核心思想是利用自注意力机制来实现序列建模。该模型的输入和输出都是序列,它可以将源序列和目标序列分别映射到一个连续的向量空间中,并使用自注意力机制来计算输入序列中各个位置之间的依赖关系,从而实现对序列的建模。

Cyrus_May的博客 3305

手把手教你用UM982搭建厘米级RTK定位系统(附避坑指南)

本文详细介绍了如何使用UM982模组搭建厘米级RTK定位系统,涵盖硬件连接、软件配置和深度优化技巧。UM982支持BDS、GPS、GLONASS和Galileo等多系统全频点信号,特别适合精准农业、无人机导航等高精度应用场景。通过实战案例和避坑指南,帮助开发者快速实现厘米级定位精度。

y7z8a的博客 1408

Matlab生成dsp程序——环境搭建(c2000系列[F28335、F2837x]都适用)

一、环境配置 (28377D的操作是一模一样就是硬件设置的时候需要选择28377d进行相应的设置) 1)matlab与ccs联合编译需要安装对应的matlab版本和ccs版本,且只有2016a以上的matlab支持c2000系列。具体对应关系参照: http://software-dl.ti.com/ccs/esd/documents/ccs_matlab.html 2)matlab版本确定之后,还需要安装有关于ccs的相关软件: I、TI Code Composer Studio xxxx(对应

qq_42151264的博客 2万+

【超详细】【原理篇&实战篇】一文读懂Transformer

Transformer是一种用于自然语言处理(NLP)和其他序列到序列(sequence-to-sequence)任务的深度学习模型架构,它在2017年由Vaswani等人首次提出。Transformer架构引入了自注意力机制(self-attention mechanism),这是一个关键的创新,使其在处理序列数据时表现出色。

艰难困苦,玉汝于成。 68万+

网络变压器等效电路及网络变压器中间抽头作用详解

       华强盛电子导读:要详细了解网络变压器周边EMC管控及网络变压器BOB-SMITH电路的连接原理,首先我们对网络变压器的认识及其电路各参数影响都要有个简要的认识,本文,对非理想网络变压器等效电路做一个详细的分析,其中重点讨论一下网络变压器中间抽头的作用其影响                          网络变压器等效电路及                        ...

网络变压器专业资料 6005

大模型-Transformer原理与实战篇

Transformer是一种用于自然语言处理(NLP)和其他席列到序列(sequence-to-sequence)任务的深度学习模型架构,它在2017年由Vaswani等人首次提出。Transformer架构引入了自注意力机制(self-attention mechanism)这是一个关键的创新,使其在处理序列数据时表现出色。

有朋自远方来,不亦乐乎。 1147

Redhawk:什么是timing window?

STA timing file中timing window的作用和计算方式

m0_61544122的博客 1万+

【Unity】【Pico】【VR开发】为何PICO打包后真机运行闪退

由于并没有开版权验证,而且闪退后也并没有弹框说版权问题,所以还是怀疑环境有什么地方不对。设置步骤,项目配置都没问题,Build也成功,Unity版本是符合要求的2022LTS版本,但是一在真机上运行就闪退。

每日出拳老爷子的博客 3175

【大模型实战篇】构建大模型分词器并应用于Transformer库

大模型、分词器、构建分词器、从零构建分词器、tokenizer、BPE、WordPiece、Unigram、实战、Transformer、huggingface、编码器、解码器

源泉的小广场 2132

HTML金色流星雨(完整代码)

HTML实现金色流星雨动态效果的完整代码。

AIGC 992

【多模态模型学习】从零手撕一个Vision Transformer(ViT)模型实战篇

本文介绍了使用自建ViT模型完成图像分类任务的过程。首先在Windows 10系统下搭建了Python 3.10虚拟环境,并安装了PyTorch等必要依赖库。接着下载并预处理了服装图像数据集。重点构建了ViT模型的核心组件:PatchEmbedding模块将图像分块并嵌入向量;MultiHeadSelfAttention实现多头自注意力机制;ResidualAdd提供残差连接;FeedForwardBlock构成前馈网络。这些组件共同组成了Transformer编码器块,最终构建出一个完整的ViT模型架构,

281

22、嵌入式软件随机延迟生成与加密算法防护技术

本文探讨了嵌入式软件中的随机延迟生成方法与块密码软件实现的高阶掩码及洗牌技术。重点介绍了浮动均值延迟生成方法,其在8位AVR平台上的实现效率为Θ(1),显著提升了抗相关功率分析(CPA)攻击的能力,相比传统方法更安全且轻量。同时,分析了高阶掩码与洗牌技术结合的方案,通过理论建模量化其对高级差分功率分析(DPA)攻击的抵抗能力,并以AES为例展示了该方案的应用流程。最后对比了不同防护技术在安全性与开销之间的权衡,为实际应用中选择合适的安全策略提供了依据。未来可进一步优化实现效率并融合多种防护手段以应对复杂安全

fern8的博客 88

python基础:工作会用到的95%的基础python代码都在这了(万字详解!)

本文是一份Python编程语言的快速参考备忘单,涵盖了Python基础语法和常用数据类型。主要内容包括:Python入门指南(打印、变量声明)、内置数据类型(字符串、数值、列表、元组、集合、字典等)、控制结构(判断、循环)、函数定义、文件处理操作以及字符串操作方法(切片、循环遍历等)。这个备忘单特别适合初学者快速查阅Python基础语法,同时也提供了数据类型转换、f-string格式化字符串等实用技巧。通过简洁的代码示例展示了Python的基本语法规则和典型用法。

数据知道的博客 8160

告别晦涩!白话讲透 Transformer 与大型语言模型的核心逻辑

告别晦涩!白话讲透 Transformer 与大型语言模型的核心逻辑

优快云_430422的博客 863

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Transformer入门必读!从文本分词到输出概率的全解析,看这一篇就够了!

Transformer入门必读!从文本分词到输出概率的全解析,看这一篇就够了!

优快云_224022的博客 1875

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

2025大模型发展回顾、国内外大模型进展及未来研判分析报告

2025年,大模型领域迎来了飞速发展,技术革新不断推动着人工智能的边界。从国内到海外,各大科技巨头和初创企业纷纷在大模型赛道上加速布局,降本提效成为主旋律,模型性能和应用场景不断拓展。 大模型的发展离不开Transformer架构的出现。2017年,谷歌团队提出Transformer模型,其自注意力机制克服了传统循环神经网络(RNN)在处理长文本时的局限性,标志着自然语言处理(NLP)领域的分水岭时刻。Transformer架构的核心在于其编码器(Encoder)和解码器(Decoder)模块,以及

ytt0523_com的博客 1286

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

【AI 大模型基础扫盲】Transformer 是什么?一文用大白话讲透

【AI 大模型基础扫盲】Transformer 是什么?一文用大白话讲透

优快云_224022的博客 1270

一网打尽!5大深度学习模型!RNN、CNN、Transformer、BERT、GPT

深度学习,在人工智能领域不断取得了发展成就。其中,RNN、CNN、Transformer、BERT以及GPT五种深度学习模型,凭借其独特的优势,在计算机视觉、自然语言处理等诸多领域实现了重要突破。本文将从四大维度——关键技术、数据处理、应用场景以及经典案例,对这五种模型进行简要介绍。首先,在关键技术方面,这五种模型各具特色,它们通过不同的算法和结构来提取数据中的深层信息,实现了高效的特征学习和模式识别。时间:起始于20世纪90年代关键技术:依托独特的循环结构与记忆单元。

weixin_59191169的博客 963

2025年大模型架构创新研究报告|附30页PDF文件下载

量子位智库权威报告揭示AI架构变革浪潮,2025年6月,中国领先的人工智能研究机构量子位智库(QbitAI Insights)发布了《2025大模型架构创新研究报告》,这份30页的重磅报告由资深分析师王昕祎领衔,系统梳理了当前AI领域最前沿的架构创新趋势。报告指出,自2017年Transformer架构问世以来,AI行业首次面临全面的架构范式革新,这场变革将决定未来5-10年人工智能技术的发展方向。

youmaob的博客 981

【Transformer系列】深入浅出理解ViT(Vision Transformer)模型

【Transformer系列】深入浅出理解ViT(Vision Transformer)网络模型

IT菜鸟 6万+

Transformer 模型详解

本文介绍了Transformer模型的核心结构及其在计算机视觉中的应用。首先概述了Transformer的Encoder-Decoder架构,详细解析了Self-Attention机制和Multi-Head Attention的计算过程。文章重点阐述了编码器的组成(包括残差连接和层归一化)以及解码器的Masked操作特点,并对比了视觉领域中的ViT和DETR等成功应用案例。最后总结了Transformer的并行训练优势、位置编码的作用,以及其突破RNN限制的核心创新点。

人无远虑,必有近忧 3万+

深度学习:transformer模型

Google于2017年6月发布在arxiv上的一篇文章《Attention is all you need》,提出解决sequence to sequence问题的transformer模型,用全attention的结构代替了lstm,抛弃了之前传统的encoder-decoder模型必须结合cnn或者rnn的固有模式,只用attention,可谓大道至简。文章的主要目的是在减少...

皮皮blog 6万+
上一篇: leecode445 两数相加II
下一篇: leecode162 寻找峰值
TranquilGlow
博客等级 码龄5年 132粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值