


Selection Algorithms(选择算法)
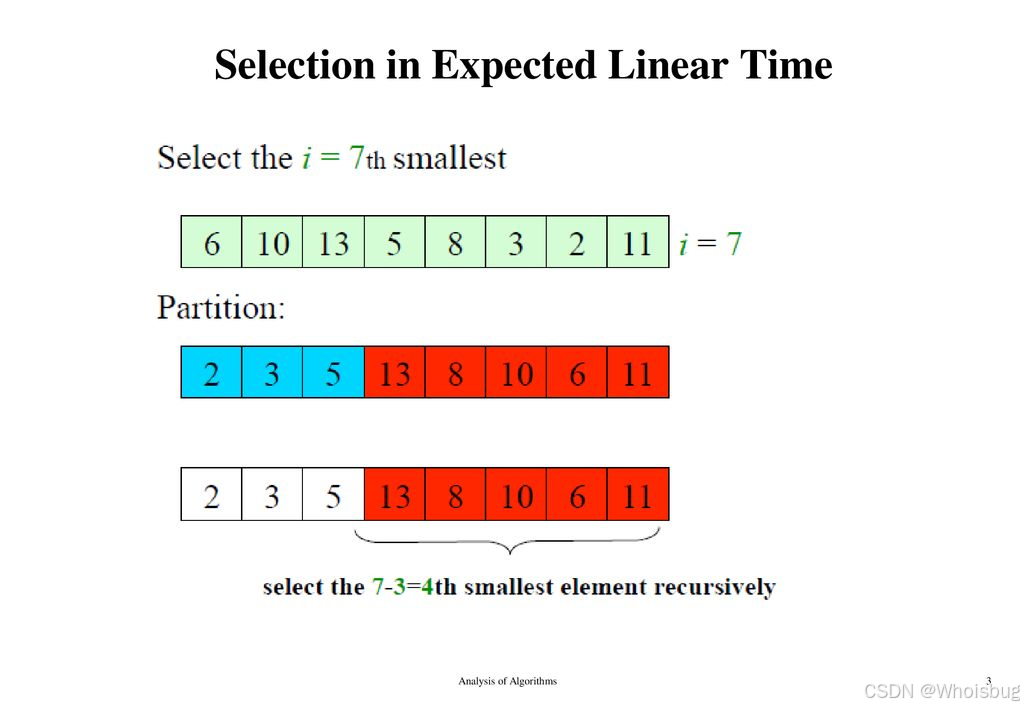
在计算机科学中,选择算法用于在数据结构中找到第 k 小的元素。这些算法在数据处理、统计分析以及各种优化问题中都有广泛的应用。本章将详细介绍几种不同的选择算法,包括通过排序选择、基于划分的选择算法以及线性选择算法。
什么是选择算法?
选择算法的目标是在未排序的列表中找到第 k 小的元素。当 k 等于列表长度的一半时,这个问题就变成了寻找中位数的问题。选择算法在数据处理、统计分析以及各种优化问题中都有广泛的应用。
为什么需要选择算法?
选择算法在许多应用场景中都非常有用,例如在数据库中查找记录、在文件系统中查找文件、在网页中查找特定内容等。高效的搜索算法可以显著提高系统的性能和用户体验。
选择算法的类型
通过排序选择
最直接的方法是先对数组进行排序,然后直接选择第 k 个元素。这种方法简单易懂,但效率不是最优的,因为它需要 O(nlogn) 的时间复杂度。
示例代码
def select_by_sorting(arr, k):
    # 使用内置的排序函数
    sorted_arr = sorted(arr)
    # 返回第 k 个元素
    return sorted_arr[k - 1]

# 示例输入
arr = [3, 2, 1, 5, 6, 4]
k = 3

# 示例输出
print(select_by_sorting(arr, k))  # 输出: 3
基于划分的选择算法
基于划分的选择算法是一种更高效的方法,它利用了快速排序中的划分思想。这种方法的时间复杂度为 O(n) ,在平均情况下表现良好。
示例代码
def partition(arr, low, high):
    pivot = arr[high]
    i = low - 1
    for j in range(low, high):
        if arr[j] < pivot:
            i += 1
            arr[i], arr[j] = arr[j], arr[i]
    arr[i + 1], arr[high] = arr[high], arr[i + 1]
    return i + 1

def select_by_partition(arr, low, high, k):
    if low == high:
        return arr[low]
    pivot_index = partition(arr, low, high)
    if k == pivot_index:
        return arr[k]
    elif k < pivot_index:
        return select_by_partition(arr, low, pivot_index - 1, k)
    else:
        return select_by_partition(arr, pivot_index + 1, high, k)

# 示例输入
arr = [3, 2, 1, 5, 6, 4]
k = 2

# 示例输出
print(select_by_partition(arr, 0, len(arr) - 1, k - 1))  # 输出: 2
线性选择算法 - 中位数算法
线性选择算法是一种更高级的选择算法,它通过选择一个更好的枢轴来保证线性时间复杂度。这种方法在最坏情况下也能保证 O(n) 的时间复杂度。
示例代码
def median_of_medians(arr, i):
    sublists = [arr[j:j+5] for j in range(0, len(arr), 5)]
    medians = [sorted(sublist)[len(sublist) // 2] for sublist in sublists]
    if len(medians) <= 5:
        pivot = sorted(medians)[len(medians) // 2]
    else:
        pivot = median_of_medians(medians, len(medians) // 2)
    low = [j for j in arr if j < pivot]
    high = [j for j in arr if j > pivot]
    k = len(low)
    if i < k:
        return median_of_medians(low, i)
    elif i > k:
        return median_of_medians(high, i - k - 1)
    else:
        return pivot

# 示例输入
arr = [3, 2, 1, 5, 6, 4]
k = 3

# 示例输出
print(median_of_medians(arr, k - 1))  # 输出: 3
选择算法:问题与解答
问题1: 找到数组中的最大元素
问题:在大小为 n 的数组 A 中找到最大元素。
解决方案:扫描整个数组并返回最大元素。
示例代码:
def find_max_element(arr):
    max_element = arr[0]
    for element in arr:
        if element > max_element:
            max_element = element
    return max_element

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
# 示例输出
print(find_max_element(arr))  # 输出: 9
性能分析:
-
最坏情况性能:O(n)
-
最好情况性能:O(n)
-
最坏情况空间复杂度:O(1)
备注:任何确定性算法通过比较键值来找到 n 个键中的最大值,至少需要 n - 1 次比较。
问题2: 找到数组中的最小和最大元素
问题:在大小为 n 的数组 A 中找到最小和最大元素。
解决方案:扫描整个数组,同时记录最小和最大元素。
示例代码:
Python复制
def find_min_max_elements(arr):
    min_element = max_element = arr[0]
    for element in arr:
        if element < min_element:
            min_element = element
        elif element > max_element:
            max_element = element
    return min_element, max_element

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
# 示例输出
print(find_min_max_elements(arr))  # 输出: (1, 9)
性能分析:
-
时间复杂度:O(n)
-
空间复杂度:O(1)
-
最坏情况比较次数:2(n - 1)
问题3: 优化前两个算法
问题:能否优化前两个算法?
解决方案:通过成对比较来减少比较次数。
示例代码:
def find_min_max_elements_optimized(arr):
    if len(arr) % 2 == 0:
        min_element = max_element = min(arr[0], arr[1])
    else:
        min_element = max_element = arr[0]

    i = 2 if len(arr) % 2 == 0 else 1
    while i < len(arr) - 1:
        if arr[i] < arr[i + 1]:
            min_element = min(min_element, arr[i])
            max_element = max(max_element, arr[i + 1])
        else:
            min_element = min(min_element, arr[i + 1])
            max_element = max(max_element, arr[i])
        i += 2
    return min_element, max_element

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
# 示例输出
print(find_min_max_elements_optimized(arr))  # 输出: (1, 9)
性能分析:
-
时间复杂度:O(n)
-
空间复杂度:O(1)
-
比较次数:
-
直接比较:2(n - 1)
-
仅在最大值比较失败时比较最小值:n - 1(最好情况:递增顺序)
-
最坏情况:2(n - 1)(递减顺序)
-
平均情况:3n/2 - 1
-
备注:对于分治技术,可以参考分治章节。
问题4: 找到给定列表中的第二大元素
问题:在给定的元素列表中找到第二大元素。
解决方案:暴力方法。首先找到最大元素(需要 n - 1 次比较),删除(丢弃)最大元素,再次找到最大元素(需要 n - 2 次比较)。
示例代码:
def find_second_largest_element(arr):
    max_element = second_largest = float('-inf')
    for element in arr:
        if element > max_element:
            second_largest = max_element
            max_element = element
        elif element > second_largest and element != max_element:
            second_largest = element
    return second_largest

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
# 示例输出
print(find_second_largest_element(arr))  # 输出: 6
性能分析:
-
总比较次数:n - 1 + n - 2 = 2n - 3
问题5: 减少 问题4 解决方案中的比较次数
问题:能否减少 问题4 解决方案中的比较次数?
解决方案:锦标赛方法。针对 n 是 2 的幂和不是 2 的幂的情况分别讨论,涉及构建二叉树等。
示例代码:
def tournament_method(arr):
    if len(arr) == 1:
        return arr[0], float('-inf')
    mid = len(arr) // 2
    left_max, left_second = tournament_method(arr[:mid])
    right_max, right_second = tournament_method(arr[mid:])
    if left_max > right_max:
        return left_max, max(left_second, right_max)
    else:
        return right_max, max(right_second, left_max)

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
# 示例输出
print(tournament_method(arr))  # 输出: (9, 6)
性能分析:
-
当 n 是 2 的幂时:
-
构建完全二叉树找到最大元素需 n - 1 次比较
-
在与最大元素比较输的元素中找第二大元素需 logn - 1 次比较
-
总共 n + logn - 2 次比较
-
问题6: 使用分区方法找到数组中第 k 小的元素
问题:使用分区方法在大小为 n 的数组 S 中找到第 k 小的元素。
解决方案:暴力方法。类似于冒泡排序和选择排序的扫描方法,遍历 k 次。
示例代码:
def find_k_smallest_elements_brute_force(arr, k):
    for _ in range(k):
        min_index = 0
        for j in range(1, len(arr)):
            if arr[j] < arr[min_index]:
                min_index = j
        arr[min_index], arr[0] = arr[0], arr[min_index]
        arr = arr[1:]
    return arr

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
k = 3
# 示例输出
print(find_k_smallest_elements_brute_force(arr, k))  # 输出: [1, 1, 2]
性能分析:
-
复杂度:O(n × k)
问题7: 使用排序技术解决 问题6
问题:能否使用排序技术解决 问题6?
解决方案:是的。排序并取前 k 个元素。
示例代码:
def find_k_smallest_elements_sorting(arr, k):
    arr.sort()
    return arr[:k]

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
k = 3
# 示例输出
print(find_k_smallest_elements_sorting(arr, k))  # 输出: [1, 1, 2]
性能分析:
-
排序 n 个数字:O(nlogn)
-
选择 k 个元素:O(k)
-
总复杂度:O(nlogn + k) = O(nlogn)
问题8: 使用树排序技术解决 问题6
问题:能否使用树排序技术解决 问题6?
解决方案:是的。将所有元素插入到二叉搜索树中。进行中序遍历并打印 k 个元素,这些将是最小的元素。
示例代码:
class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right

def insert_into_bst(root, val):
    if not root:
        return TreeNode(val)
    if val < root.val:
        root.left = insert_into_bst(root.left, val)
    else:
        root.right = insert_into_bst(root.right, val)
    return root

def inorder_traversal(node, k, result):
    if node and len(result) < k:
        inorder_traversal(node.left, k, result)
        result.append(node.val)
        inorder_traversal(node.right, k, result)

def find_k_smallest_elements_tree_sort(arr, k):
    root = None
    for val in arr:
        root = insert_into_bst(root, val)
    result = []
    inorder_traversal(root, k, result)
    return result

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
k = 3
# 示例输出
print(find_k_smallest_elements_tree_sort(arr, k))  # 输出: [1, 1, 2]
性能分析:
-
创建包含 n 个元素的二叉搜索树的成本:O(nlogn)
-
遍历前 k 个元素:O(k)
-
总复杂度:O(nlogn + k) = O(nlogn)
缺点:当数字按降序排列时,树会向左倾斜,构建树的成本变为 O(n²),可通过保持树平衡解决。
问题9: 优化树排序技术解决 问题6
问题:能否优化树排序技术解决 问题6?
解决方案:是的。使用较小的树来得到相同的结果。先取前 k 个元素创建 k 个节点的平衡树,对剩下元素根据与树中最大元素比较结果决定是否替换。
示例代码:
import heapq

def find_k_smallest_elements_optimized_tree_sort(arr, k):
    if k >= len(arr):
        return arr
    min_heap = arr[:k]
    heapq.heapify(min_heap)
    for val in arr[k:]:
        if val < min_heap[0]:
            heapq.heappop(min_heap)
            heapq.heappush(min_heap, val)
    return min_heap

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
k = 3
# 示例输出
print(find_k_smallest_elements_optimized_tree_sort(arr, k))  # 输出: [1, 1, 2]
性能分析:
-
前 k 个元素的成本:klogk
-
剩下 n - k 个元素的复杂度:O(logk)
-
总代价:klogk + (n - k) logk = nlogk,即 O(nlogk)
问题10: 使用分区技术解决 问题6
问题:能否使用分区技术解决 问题6?
解决方案:是的。算法:选择数组的一个枢轴,分区,根据 k 与枢轴位置关系进行递归操作。
示例代码:
def partition(arr, low, high):
    pivot = arr[high]
    i = low - 1
    for j in range(low, high):
        if arr[j] < pivot:
            i += 1
            arr[i], arr[j] = arr[j], arr[i]
    arr[i + 1], arr[high] = arr[high], arr[i + 1]
    return i + 1

def quickselect(arr, low, high, k):
    if low == high:
        return arr[low]
    pivot_index = partition(arr, low, high)
    if k == pivot_index:
        return arr[k]
    elif k < pivot_index:
        return quickselect(arr, low, pivot_index - 1, k)
    else:
        return quickselect(arr, pivot_index + 1, high, k)

def find_kth_smallest_element(arr, k):
    return quickselect(arr, 0, len(arr) - 1, k - 1)

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
k = 3
# 示例输出
print(find_kth_smallest_element(arr, k))  # 输出: 2
性能分析:
-
时间复杂度:最坏情况 O(n²),类似于快速排序。但平均情况为 O(nlogk)。
问题11: 以最佳方式找到数组中第 k 小的元素
问题:以最佳方式找到大小为 n 的数组 S 中第 k 小的元素。
解决方案:这个问题类似于 问题6,可以使用中位数的中位数算法。详细描述了算法 Selection(A, k) 的步骤。
示例代码:
def median_of_medians(arr, i):
    sublists = [arr[j:j+5] for j in range(0, len(arr), 5)]
    medians = [sorted(sublist)[len(sublist)//2] for sublist in sublists]
    if len(medians) <= 5:
        pivot = sorted(medians)[len(medians)//2]
    else:
        pivot = median_of_medians(medians, len(medians)//2)
    low = [j for j in arr if j < pivot]
    high = [j for j in arr if j > pivot]
    k = len(low)
    if i < k:
        return median_of_medians(low, i)
    elif i > k:
        return median_of_medians(high, i - k - 1)
    else:
        return pivot

def find_kth_smallest_element_optimized(arr, k):
    return median_of_medians(arr, k - 1)

# 示例输入
arr = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]
k = 3
# 示例输出
print(find_kth_smallest_element_optimized(arr, k))  # 输出: 2
性能分析:
-
递归关系:推导了递归关系,分析了不同情况下的元素划分和时间复杂度。
问题12: 使用 3 作为分组大小是否能在线性时间内工作
问题:在 问题11 中,我们将输入数组分成 5 个元素的组。常数 5 在分析中起重要作用。能否使用 3 作为分组大小并在线性时间内工作?
解决方案:分析表明使用 3 作为分组大小时,该算法将花费超过线性的时间。
性能分析:
-
最坏情况下的元素划分和时间递归关系:最终得出是 O(nlogn),因此不能用 3 作为分组大小。
问题13: 使用 7 作为分组大小
问题:与 问题12 类似,能否使用 7 作为分组大小?
解决方案:使用 7 作为分组大小的分析,根据元素划分得出时间递归关系,在满足一定条件下可以使用 7 作为分组大小。
问题14: 给定两个包含 n 个排序元素的数组,给出一个 O(logn) 时间的算法来找到所有 2n 个元素的中位数
问题:给定两个包含 n 个排序元素的数组,给出一个 O(logn) 时间的算法来找到所有 2n 个元素的中位数。
解决方案:给出了简单的合并排序取中间元素平均值的方法(复杂度为 Θ(n) 不满足),以及基于中位数比较递归寻找的方法。
示例代码:
def find_median_sorted_arrays(nums1, nums2):
    if len(nums1) > len(nums2):
        nums1, nums2 = nums2, nums1
    m, n = len(nums1), len(nums2)
    imin, imax, half_len = 0, m, (m + n + 1) // 2
    while imin <= imax:
        i = (imin + imax) // 2
        j = half_len - i
        if i < m and nums2[j-1] > nums1[i]:
            imin = i + 1
        elif i > 0 and nums1[i-1] > nums2[j]:
            imax = i - 1
        else:
            if i == 0: max_of_left = nums2[j-1]
            elif j == 0: max_of_left = nums1[i-1]
            else: max_of_left = max(nums1[i-1], nums2[j-1])
            if (m + n) % 2 == 1:
                return max_of_left
            if i == m: min_of_right = nums2[j]
            elif j == n: min_of_right = nums1[i]
            else: min_of_right = min(nums1[i], nums2[j])
            return (max_of_left + min_of_right) / 2.0

# 示例输入
nums1 = [1, 3]
nums2 = [2]
# 示例输出
print(find_median_sorted_arrays(nums1, nums2))  # 输出: 2.0
性能分析:
-
时间复杂度:O(log(min(m, n)))
-
空间复杂度:O(1)
总结
通过上述分析和示例代码,我们可以看到选择算法在不同场景下的应用和优化方法。这些算法在实际数据处理中非常有用,能够帮助我们高效地找到所需的元素。

 296


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


