手把手教你用Python实现决策树模型

Python-机器学习之决策树 决策树学习的目标: 根据给定的训练数据集构建一个决策树模型,使它能够对实例进行正确的分类。以【周志华 机器学习】这本书的介绍,学习相关的内容。具体内容这里不做过多介绍,具体计算见书。决策树生成的伪代码:(以字典类型保存Tree) 阅读详情

本文始发于个人公众号:TechFlow,原创不易,求个关注


今天是机器学习专题的第21篇文章,我们一起来看一个新的模型——决策树。


决策树的定义


决策树是我本人非常喜欢的机器学习模型,非常直观容易理解,并且和数据结构的结合很紧密。我们学习的门槛也很低,相比于那些动辄一堆公式的模型来说,实在是简单得多。

其实我们生活当中经常在用决策树,只是我们自己没有发现。决策树的本质就是一堆if-else的组合,举个经典的例子,比如我们去小摊子上买西瓜。水果摊的小贩都是怎么做的?拿起西瓜翻滚一圈,看一眼,然后伸手一拍,就知道西瓜甜不甜。我们把这些动作相关的因素去除,把核心本质提取出来,基本上是这么三条:

  1. 西瓜表面的颜色,颜色鲜艳的往往比较甜
  2. 西瓜拍打的声音,声音清脆的往往比较甜
  3. 西瓜是否有瓜藤,有藤的往往比较甜

这三条显然不是平等的,因为拍打的声音是最重要的,可能其次表面颜色,最后是瓜藤。所以我们挑选的时候,肯定也是先听声音,然后看瓜藤,最后看颜色。我们把其中的逻辑抽象出来然后整理一下,变成一棵树结构,于是这就成了决策树。
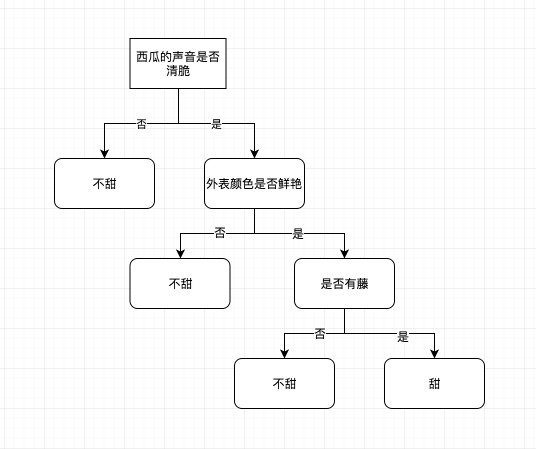
这个决策树本质上做的还是分类的工作,将西瓜分成了甜的和不甜的。也就是说决策树是一个树形的分类器,这个也是决策树的基本定义。另外从图中我们还有一个启示,在这个问题当中,决策树的特征都是离散值,而不是连续值。也就是说决策树可以接受像是类别、标识这样非数值型的特征,而逻辑回归这些模型则不太行。

如果你对这些细节还理解不深刻也没有关系,我们可以先放一放,至少我们明白了决策树的大概结构以及工作原理。

对于每一条数据来说,它分类的过程其实就是在决策树上遍历的过程。每到一个中间节点都会面临一次判断,根据判断的结果选择下一个子树。而树上的叶子节点代表一种分类,当数据到了叶子节点,这个叶子节点的值就代表它的分类结果。


决策树的训练


明白了决策树的结构和工作原理之后,下面就是训练的过程了。

在理清楚原理之前,我们先来看下数据。我们根据上面决策树的结构,很容易发现,训练数据应该是这样的表格:

分类 声音是否清脆 是否有瓜藤 是否有光泽
甜 是 是 是
甜 是 是 否
不甜 否 否 是
不甜 否 否 否

那么最后我们想要实现什么效果呢?当然是得到的准确率越高越好,而根据决策树的原理,树上的每一个叶子节点代表一个分类。那么我们显然希望最后到达叶子节点的数据尽可能纯粹,举个例子,如果一个叶子节点代表甜,那么我们肯定希望根据树结构被划归到这里的数据尽可能都是甜的,不甜的比例尽可能低。

那么我们怎么实现这一点呢?这就需要我们在越顶层提取规则的时候,越选择一些区分度大的特征作为切分的依据。所谓区分度大的特征,也就是能够将数据很好分开的特征。这是明显的贪心做法,使用这样的方法,我们只可以保证在尽可能高层取得尽可能好的分类结果,但是并不能保证这样得到的模型是最优的。生成最优的决策树本质上也是一个NP问题,我们当前的做法可以保证在尽量短的时间内获得一个足够优秀的解,但是没办法保证是最优解。

回到问题本身,我们想要用区分度大的特征来进行数据划分。要做到这一点的前提就是首先定义区分度这个概念,将它量化,这样我们才好进行选择。否则总不能凭感觉去衡量区分度,好在这个区分度还是很好解决的,我们只需要再一次引入信息熵的概念就可以了。


信息熵与信息增益


信息熵这个词很令人费解,它英文原文是information entropy,其实一样难以理解。因为entropy本身是物理学和热力学当中的概念,用来衡量物体分散的不均匀程度。也就是说熵越大,说明物体分散得程度越大,可以简单理解成越散乱。比如我们把房间里一盒整理好的乒乓球打翻,那么里面的乒乓球显然会散乱到房间的各个地方,这个散乱的过程可以理解成熵增大的过程。

信息熵也是一样的含义,用来衡量一份信息的散乱程度。熵越大,说明信息越杂乱无章,否则说明信息越有调理。信息熵出自大名鼎鼎的信息学巨著《信息论》,它的作者就是赫赫有名的香农。但是这个词并不是香农原创,据说是计算机之父冯诺依曼取的,他去这个名字的含义也很简单,因为大家都不明白这个词究竟是什么意思。

之前我们曾经在介绍交叉熵的时候详细解释过这个概念,我们来简单回顾一下。对于一个事件X来说,假设它发生的概率是P(X),那么这个事件本身的信息量就是:

I(X)=−log2P(X)I(X) = -log_2P(X)I(X)=−log2​P(X)

比如说世界杯中国队夺冠的概率是1/128,那么我们需要用8个比特才能表示,说明它信息量很大。假如巴西队夺冠的概率是1/4,那么只要2个比特就足够了,说明它的信息量就很小。同样一件事情,根据发生的概率不同,它的信息量也是不同的。

那么信息熵的含义其实就是信息量的期望,也就是用信息量乘上它的概率:

H(X)=−P(X)log2P(X)H(X) = -P(X)log_2P(X)H(X)=−P(X)log2​P(X)

同样,假设我们有一份数据集合,其中一共有K类样本,每一类样本所占的比例是P(K)P(K)P(

Python实现决策树(Decision Tree) 决策树,是机器学习的魔法般工具!它可以帮助我们进行分类和回归,无论是二元还是多元,连续还是离散,统统搞定!决策树的构建过程就像在寻宝一样,我们递归地挑选最优特征,然后根据这些特征将数据分割,直到发现宝藏——满足某种条件为止,这时,一颗美丽的决策树就呈现在我们面前! 阅读详情

相关推荐

从零构建决策树:手把手教你用Python实现ID3算法(含熵计算详解)

本文详细介绍了如何从零开始用Python实现ID3决策树算法。通过深入浅出地讲解信息熵和信息增益的计算原理,并手把手编写核心代码,帮助读者透彻理解机器学习中这一经典分类模型的构建过程与内在逻辑,而不仅仅是调用现成的库。

weixin_33660045的博客 699

决策树模型及案例(Python)

目录 1 决策树模型简介 2 Gini系数(CART决策树) 3信息熵、信息增益 4决策树模型代码实现 4.1分类决策树模型(DecisionTreeClassifier) 4.2回归决策树模型(DecisionTreeRegressor) 5案例:员工离职预测模型 5.1模型搭建 5.1.1数据读取与预处理 5.1.2提取特征变量和目标变量 5.1.3划分训练集与测试集 5.1.4模型搭建及训练 5.1.5代码汇总 5.2模型预测及评估 5.2.1直...

qq_42433311的博客 9万+

机器学习——决策树模型:Python实现

机器学习——决策树模型:Python实现欢迎使用Markdown编辑器新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 欢迎使用Markdown编辑器 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你

qq_34357269的博客 8770

详解决策树、python实现决策树

决策树模型 定义 决策过程 决策树学习 特征选择 信息增益 计算方法 ID3算法 python实现 验证 决策树模型 定义 分类决策树模型是一种描述对实例进行分类的树形结构。决策树由节点(Node)和有向边(directed edge)组成。节点有两种类型:内部节点(internal node)和叶节点(left node)。内部节点表示一个特征或一个属性,叶节

仍歌杨柳春风 4万+

如何在Python中实现一个决策树算法?

在机器学习领域,决策树(decision tree)是一种常用的模式分类算法。它能够将输入数据划分成不同类别或不同输出值,并据此做出预测。而对于复杂的数据分析任务来说,用决策树这种经典算法进行分析就显得十分合适了。本文将通过对决策树算法的基本原理和具体实现过程,带领读者一步步了解其工作原理。本文假定读者具备相关机器学习基础知识,比如机器学习的相关理论、算法、模型等。

AI天才研究院 2152

手把手教你用Python从零实现决策树分类器

手把手教你用Python从零实现决策树分类器 作者:禅与计算机程序设计艺术 1. 背景介绍 1.1 什么是决策树 决策树是一种常用的机器学习算法,它可以用于解决分类和回归问题。其核心思想是通过一系列的判断或决策来对数

AI天才研究院 517

基于BQ24610的24V电池充电板

转自我的博客 本文的主要目的在于传播基本的阅读datasheet的能力,以及PCB设计需要注意的基本问题。 本次需要设计的是24V动力锂电池充电电路。 原理图设计 参考官方参考电路 为了快速设计电路,自然是参考官方参考电路,选择Typical Application。 做细微的参数调整 由于我们的需求是给24V的电池充电,所以需要稍微修改一下原理图,接下来需...

greedyhao的博客 1万+

实战指南:在UE5中高效集成Entt(ECS)框架

本文提供了一份在虚幻引擎5中高效集成Entt ECS框架的实战指南。针对UE5项目在处理大规模动态实体时的性能瓶颈,详细讲解了如何通过数据驱动的ECS架构进行优化。内容包括前期环境准备、核心构建步骤、创建首个ECS子系统以及与UE原生系统的数据同步技巧,旨在帮助开发者快速掌握集成方法,提升游戏逻辑的执行效率。

weixin_29002209的博客 158

大华事件检测智能服务器,大华股份:高速公路智能事件检测 解决方案

1方案背景随着我国基础设施建设的飞速发展,公路尤其是高速公路的总里程数年年攀升。交通运输部统计数据显示,截止2017年底全国公路总里程477.35万公里,其中高速公路13.65万公里,位居世界第一。高速公路的运营和管理作为全国交通管理的重要组成部分日益受到严峻挑战,交通拥堵和事故频发已成为高速公路上非常突出的问题。抛洒物、行人、车辆不规则行驶等事件是导致以上结果的重要原因。基于视频分析的高速公路智...

weixin_39523887的博客 1822

EDA与机器学习融合:智能优化芯片设计流程的工程实践

机器学习作为数据驱动的核心技术,通过从历史数据中学习复杂模式,实现对系统行为的预测与优化。其原理在于构建模型,将输入特征映射到目标变量,从而揭示数据背后的内在规律。在工程领域,这项技术的核心价值在于能够将专家经验转化为可量化、可复用的智能模型,显著提升自动化水平与决策效率。电子设计自动化(EDA)是芯片设计的关键支撑,传统流程高度依赖人工试错,面临参数空间巨大、优化周期长等挑战。将机器学习应用于EDA,能够构建预测模型来预估设计性能(PPA),或通过代理模型加速设计空间探索,实现智能化的设计辅助与优化。本文

weixin_30411239的博客 684

RTX 5090配Ubuntu 24.04踩坑记:手把手搞定OpenVLA-OFT环境(附版本避坑清单)

本文详细记录了在RTX 5090显卡和Ubuntu 24.04系统上部署OpenVLA-OFT环境的完整过程,包括驱动安装、CUDA配置、PyTorch版本选择等关键步骤。提供了经过验证的版本组合清单和常见错误解决方案,帮助开发者高效搭建AI开发环境。

weixin_30342209的博客 465

开源ISP介绍(1)——开源ISP的Vivado框架搭建

ZYNQ视频图像处理系统,ISP图像处理硬件实现

路漫漫其修远兮,吾将上下而求索 3282

【软件测试】- 公有云、私有云、混合云简介以及如何在公有云与私有云上分别搭建测试环境

公有云、私有云以及混合云是目前云计算领域的三种主要模式。它们之间的区别主要在于部署方式、数据访问和管理控制的不同。在阿里云或腾讯云上使用 Kubernetes 和 Docker 搭建测试环境可以提供高度的可伸缩性和灵活性。这样的环境非常适合于需要在多种配置和条件下进行测试的复杂应用。通过云服务提供的工具和服务,可以轻松管理和监控整个测试过程。在云服务上搭建测试环境涉及选择合适的云提供商、配置云资源、安装和设置所需软件等步骤。### 1. 选择云服务提供商。

weixin_46453070的博客 2338

Cadence OrCAD Capture软件启动过程卡死且无法恢复的解决方法

如下图所示Cadence OrCAD Capture软件在启动后出现卡死的现象,且等待后无法自动恢复,需要强行关闭,再次启动依然卡死。

fydar的博客 4042

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

上一篇: Python一切皆是对象,但这和内存管理有什么关系?
下一篇: 优先队列的核心,面试的常客,带你深入了解堆
TechFlow
博客等级 码龄7年 347粉丝 276原创
评论 8
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
