【PyTorch】detach:从计算图中切断梯度的原理与实践

【Python】torch中的.detach()函数详解和示例 在PyTorch中,.detach()是一个用于张量的方法,主要用于创建该张量的一个“离断”版本。这个方法在很多情况下都非常有用,例如在缓存释放、模型评估和简化计算图等场景中。 阅读详情

在这里插入图片描述

一、Detaching Computation:分离计算图中的梯度传播

​ 在使用自动微分进行模型训练时,我们有时希望将部分计算从计算图中“摘除”,使其在反向传播阶段不再参与梯度计算。

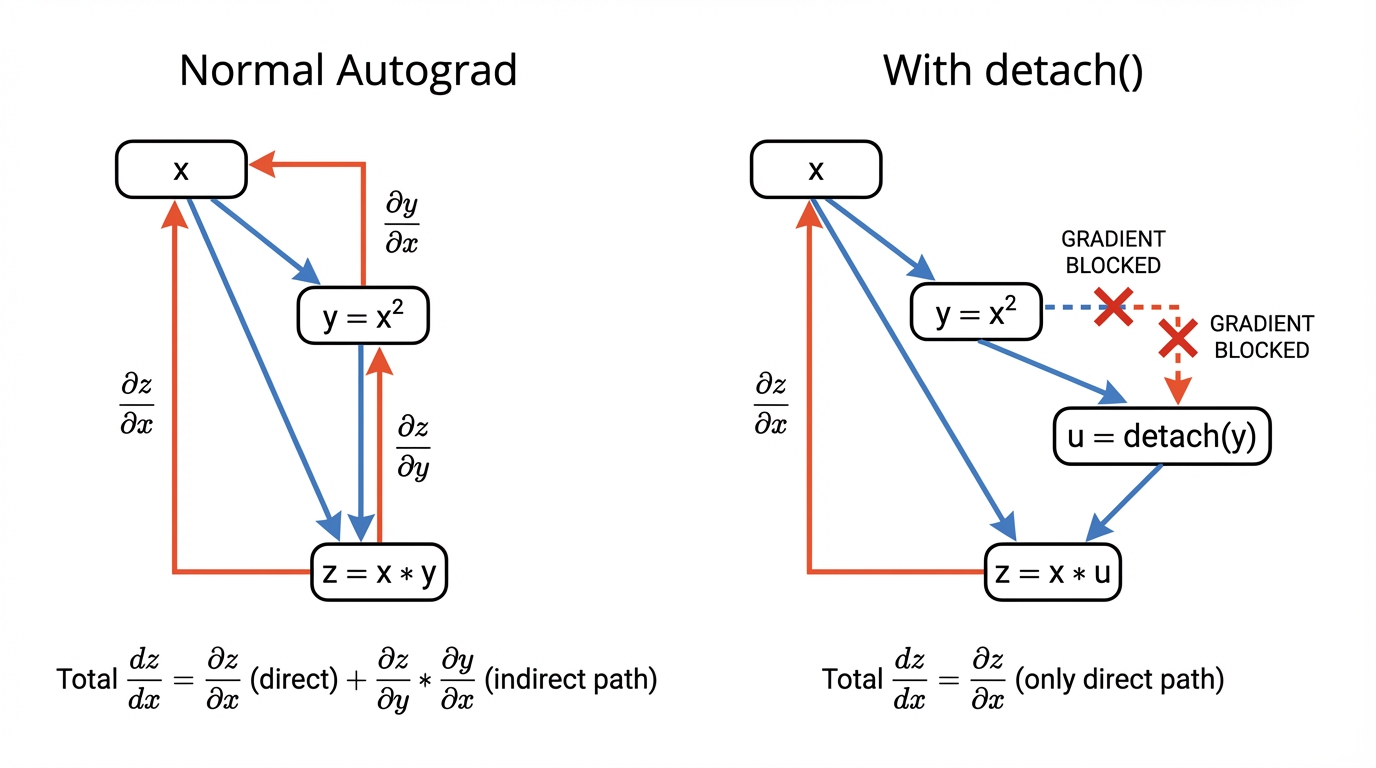
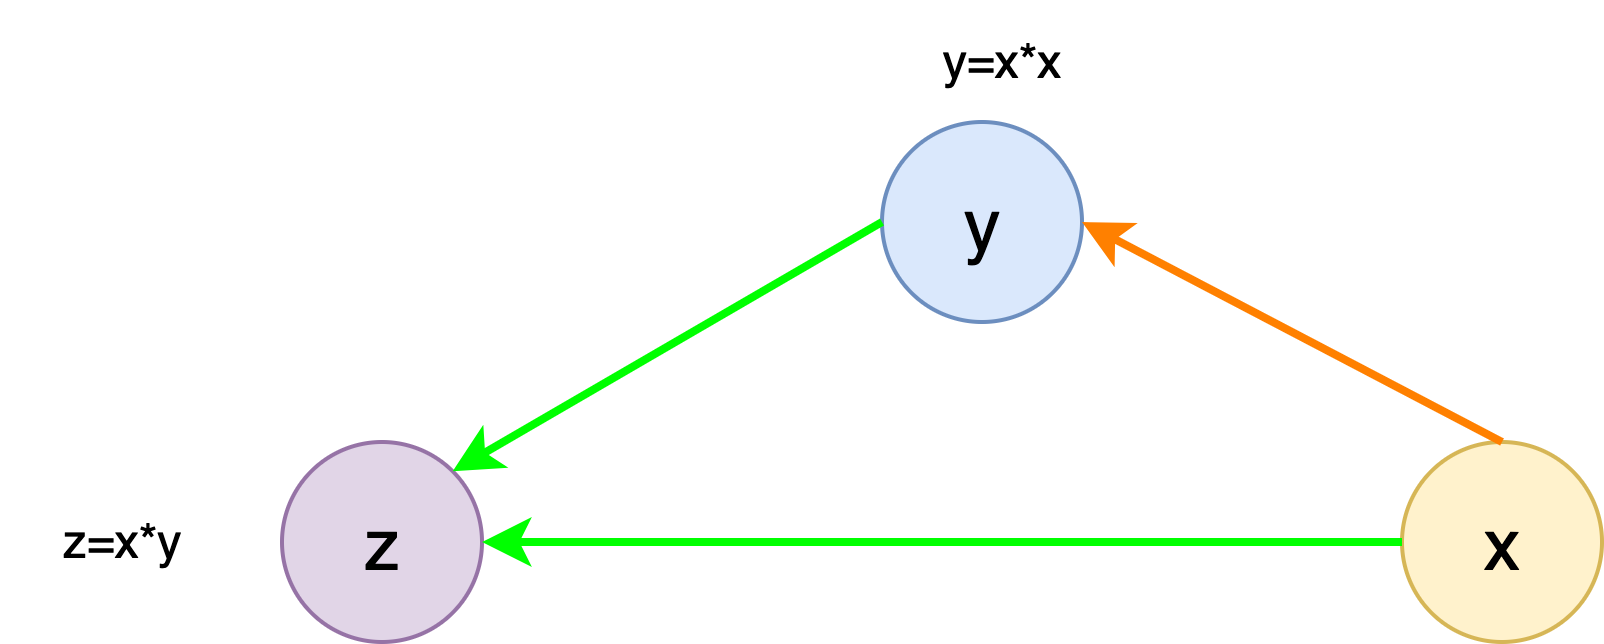
​ 例如,设 yyy 是 xxx 的函数,zzz 又同时依赖于 xxx 和 yyy。
y=f(x),z=g(x,y) y = f(x),z = g(x,y) y=f(x),z=g(x,y)
​ zzz同时显式依赖 xxx,又通过yyy隐式依赖 xxx。

​ 在标准的链式法则下,zzz 关于 xxx 的梯度为:
dzdx=∂g(x,y)∂x+∂g(x,y)∂y⋅dydx \frac{dz}{dx} = \frac{\partial g(x, y)}{\partial x} + \frac{\partial g(x, y)}{\partial y} \cdot \frac{dy}{dx} dxdz​=∂x∂g(x,y)​+∂y∂g(x,y)​⋅dxdy​
但在某些场景下,我们希望将 yyy 视为常数,只关注 xxx 对 zzz 的“直接影响”,即人为令:dydx=0\frac{d y}{d x} = 0dxdy​=0

​ 这正是 detach() 的核心思想:主动切断计算图中的梯度路径。

1. 一个直观的示例
在这里插入图片描述

​ 设:y=x2,z=x⋅yy = x^2, z=x \cdot yy=x2,z=x⋅y。如果按照完整的计算图进行反向传播,则有:
z=x⋅y=x3dzdx=3x2 z = x \cdot y = x^3 \\ \frac{d z}{d x} = 3x^2 z=x⋅y=x3dxdz​=3x2

  • 但现在我们希望在计算 zzz 的梯度时,不通过 yyy 反向传播到 xxx。此时,可以构造一个新的变量 uuu:

    • uuu 的数值与 yyy 相同
    • 但 uuu 不再携带 yyy 的计算图信息
      在这里插入图片描述
  • 在 PyTorch 中,这可以通过 detach() 实现。

    >>> x.grad.zero_()
    tensor([0., 0., 0., 0.])
    >>> y = x * x
    >>> u = y.detach()
    >>> z = u * x
    >>> z.sum().backward()
    >>> x.grad == u
    tensor([True, True, True, True])
    

    此时:
    z=u⋅x,∂z∂x=u z = u \cdot x, \frac{\partial z}{\partial x} = u z=u⋅x,∂x∂z​=u
    ​ 可以看到,梯度结果为 uuu,而不是 3x23x^23x2。

  • 这是因为,调用 detach() 后,PyTorch 会返回一个新的 Tensor:

    • 与原 Tensor 共享底层数据
    • 但其 grad_fn 被置为 None
    • requires_grad=False,不再参与反向传播

2. detach 不会破坏原有计算图

​ 需要强调的是:detach() 只会影响从它开始的新分支,并不会破坏原始 Tensor 的计算图。因此,仍然可以对 yyy 本身进行反向传播:

>>> x.grad.zero_()
tensor([0., 0., 0., 0.])
>>> y.sum().backward()
>>> x.grad == 2 * x
tensor([True, True, True, True])

​ 这是因为:

  • y = x * x 的计算图仍然完整存在
  • u = y.detach() 只是创建了一个不再向后传播梯度的新视图

3. Python 控制流下的自动微分

​ 需要注意的是,detach() 只会切断显式指定的梯度路径。在其他情况下,PyTorch 的自动微分系统依然可以在复杂的 Python 控制流下正常工作。

​ 例如:

def f(a):
    b = a * 2
    while b.norm() < 1000:
    		b = b * 2
    		
    if b.sum() > 0:
    		c = b
    else:
    		c = 100 * b
    		
    return c
  • 沿着这条实际执行的路径,f中的所有操作都是线性的(乘常数):

    • 初始化:b0=2ab_0 = 2ab0​=2a
    • 多次循环:bi=2i×b0(i=1,2,⋯ ,n)b_i = 2^i \times b_0 (i = 1,2,\cdots, n)bi​=2i×b0​(i=1,2,⋯,n)
    • 条件分支:c=bc = bc=b或c=100bc = 100bc=100b
  • 该函数在数学上是分段线性的:对任意输入 aaa,都存在某个常数 kkk,使得 f(a)=k⋅af(a) = k \cdot af(a)=k⋅a。

    其中,常数kkk由运行时控制流决定:
    k={2n+1 if bn.sum()>0100×2n+1 if bn.sum()≤0 k = \begin{cases} 2^{n+1} & \text{ if } b_{n}.sum()>0 \\ 100 \times 2^{n+1} & \text{ if } b_{n}.sum() \le 0 \end{cases} k={2n+1100×2n+1​ if bn​.sum()>0 if bn​.sum()≤0​

>>> a = torch.randn(size=(), requires_grad=True)
>>> d = f(a)
>>> d.backward()
>>> a.grad
tensor(4096.)
>>> d / a
tensor(4096., grad_fn=<DivBackward0>)

​ 这说明:即使计算图的构建依赖于 while、if 等 Python 控制流,PyTorch 仍然可以正确地记录运算并计算梯度。

二、从计算图角度理解detach

1. 从计算图中"摘取"一个Tensor

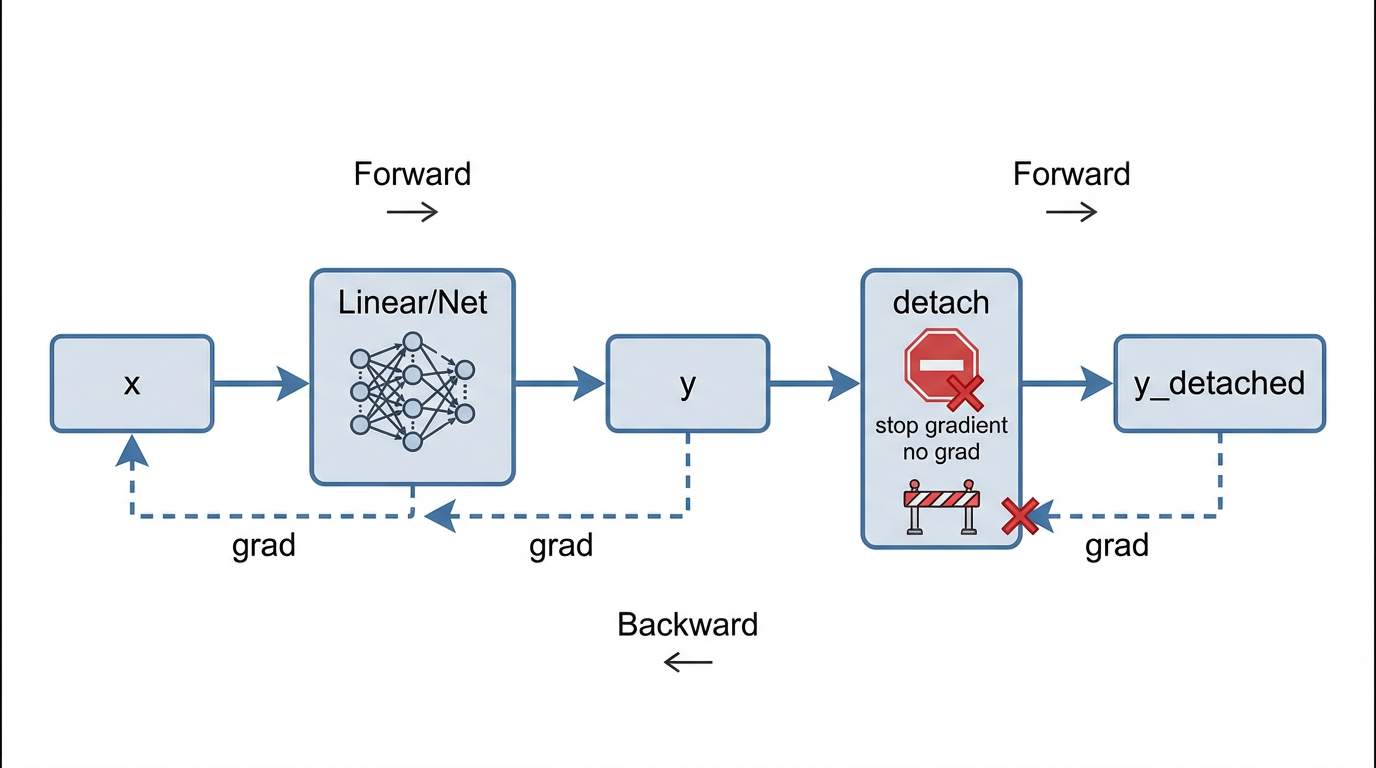
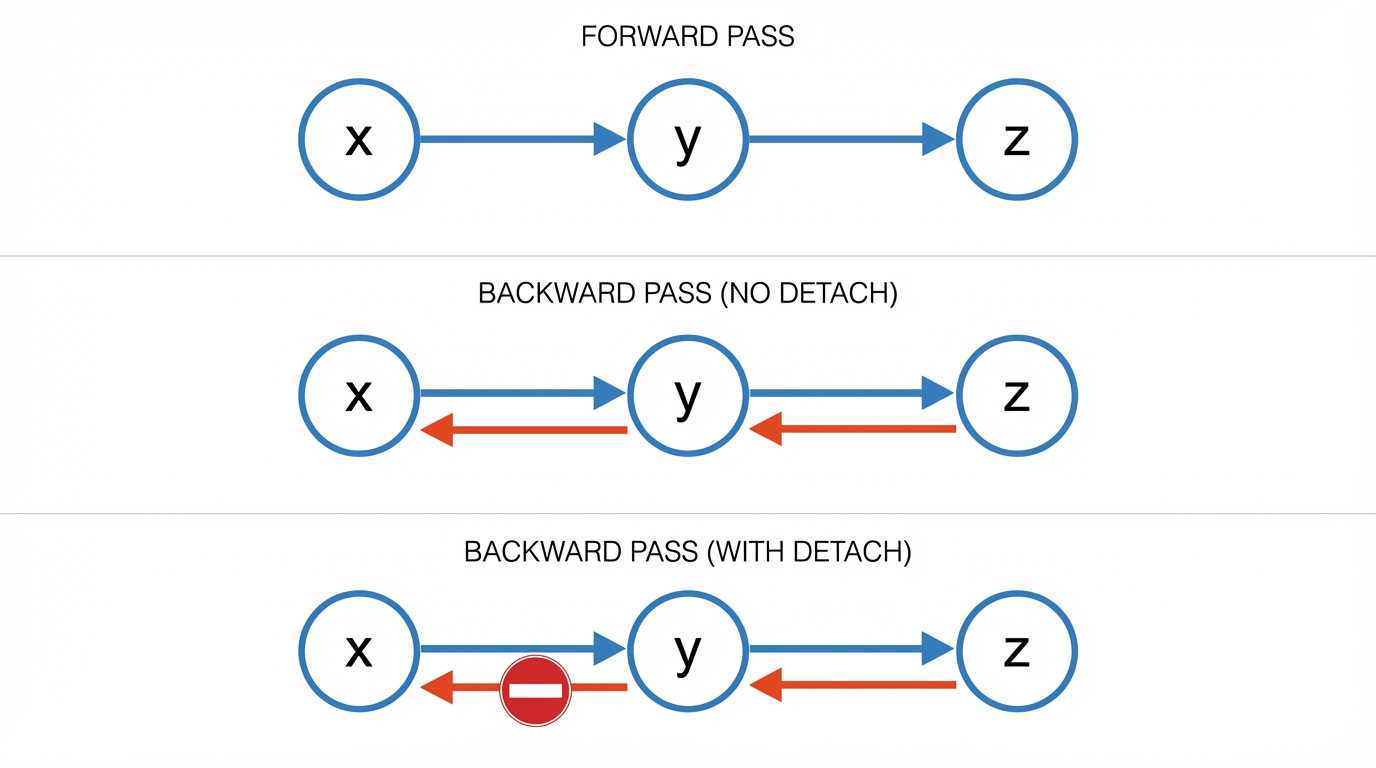
​ detach():把一个 Tensor 从计算图中“摘下来”,使其后续操作不再参与反向传播。

  • detach() 之后的 tensor
    • 不再有 grad_fn
    • 不会影响模型参数的梯度计算

2. 计算图对比

在这里插入图片描述

(1) 正常前向传播(训练阶段)
y = net(x)

​ 对应的计算图为:

x ──▶ net ──▶ y
          ▲
       计算图
  • y 录了完整的计算历史
  • loss.backward() 时,梯度会沿图反向传播
(2) 使用 detach()

​ y_detached = y.detach()。

​ 计算图变为:

x ──▶ net ──▶ y    y_detached
          ▲         ❌ 无计算图

  • y_detached 是一个新的 Tensor
  • 与 y 共享数据,但不共享计算图
  • 对 y_detached 的任何操作,都不会反向影响 net

三、Detach的典型应用场景

1. 推理 / 预测阶段:阻止梯度传播

pred = net(x)
pred_np = pred.detach().numpy()
  • numpy() 只能作用于不需要梯度的 Tensor

  • 若 Tensor 仍在计算图中,会触发运行时错误

    RuntimeError: Can't call numpy() on Tensor that requires grad
    
  • 因此,.detach().numpy() 成为常见的标准写法。

在使用 torch.no_grad() 的情况下,detach() 往往是冗余的,但保留它可以提高代码的鲁棒性。

2. 冻结部分网络结构

​ 在一些模型中,我们希望只训练网络的某一部分,例如:

h = encoder(x)
h = h.detach()   # 冻结 encoder
out = decoder(h)

​ 此时:

  • decoder 的参数会被更新

  • encoder 的参数梯度不会被计算

    这是 detach() 在模型设计中非常经典且重要的用途。

3. detach、no_grad 与 eval 的区别(对比)

方法作用范围是否构建计算图
detach()单个 Tensor后续不参与
torch.no_grad()代码块整段不构建
model.eval()模型行为与梯度无关

四、小结

​ detach() 并不是“关闭梯度计算”,而是在计算图中人为切断某些梯度路径。它允许我们在保持数值一致的前提下,精确控制哪些计算参与反向传播、哪些被视为常数。

​ 这一机制在冻结子网络、构造辅助损失、以及推理阶段的数据处理等场景中都至关重要。

⚠️ 注意:由于 detach() 返回的 Tensor 与原 Tensor 共享底层存储,对其进行 in-place 操作 可能会影响原 Tensor 的值,应谨慎使用。

诚之和:pytorch_detach 切断网络反传方式 pytorch中切断网络反向传递的方式最常见的方法就是使用detach来进行的,今天小编就带领小伙伴们来学习一下这种切断网络反传方式吧。 detach 官方文档中,对这个方法是这么介绍的。 detach = _add_docstr(_C._TensorBase.detach, r""" Returns a new Tensor, detached from the current graph. The result will never require gradient. 阅读详情

相关推荐

PyTorch中detach()的深度解析:从计算图原理到内存泄漏排查

在深度学习框架中,自动微分(Autograd)是实现模型训练的核心机制,它通过构建动态计算图来追踪张量操作并实现梯度反向传播。理解计算图的构建与释放原理,是进行高效内存管理和性能优化的基础。在PyTorch等动态图框架中,中间变量的生命周期管理尤为关键,不当的操作容易导致内存泄漏,尤其是在长时间训练或处理大规模数据时。detach()方法正是精准控制计算图、管理张量生命周期的关键接口,其核心价值在于能显式切断梯度流,释放不必要的计算图缓存,从而优化显存使用。这一技术在模型推理、评估指标计算、强化学习策略梯度

weixin_42524499的博客 217

PyTorch中detach与detach_的区别:内存泄漏与梯度计算详解

在深度学习框架中,计算图是自动微分和梯度反向传播的核心机制。PyTorch通过动态计算图记录张量间的运算关系,实现高效的梯度计算。然而,在某些场景下,我们需要将张量从计算图中分离,以优化内存使用或控制梯度流向。分离操作的技术价值在于平衡计算效率与内存管理,常见于模型推理、强化学习、GAN训练等应用场景。本文聚焦于PyTorch中的两种分离方法:detach()与detach_(),深入探讨其底层原理。通过分析内存泄漏和梯度计算中断等典型问题,揭示detach()作为安全克隆式分离的优势,以及detach_(

670

PyTorch张量复制操作实战指南:clone()、detach()、copy_()与data()的深度解析

本文深度解析PyTorch中clone()、detach()、copy_()与data()四种张量复制操作的核心区别与应用场景。通过对比内存共享、梯度传播与计算图管理机制,帮助开发者理解如何根据数据独立性与梯度回溯需求选择正确方法,避免训练中的常见陷阱,提升模型代码的健壮性与效率。

weixin_29055137的博客 334

pytorch:.detach()、.detach_()的作用和区别

返回一个新的tensor,从当前计算图中分离下来的,但是仍指向原变量的存放位置,不同之处只是requires_grad为false,得到的这个。其实detach()和detach_()很像,两个的区别就是detach_()是对本身的更改,detach()则是生成了一个新的tensor。由于x是直接创建的,所以它没有grad_fn,而y是通过一个加法操作创建的,所以y有grad_fn。将m的grad_fn的值设置为None,这样m就不会再与前一个节点x观点,这里的关系就会变成。

julac的博客 1万+

PyTorch动态计算图实战:从自动求导到梯度累积的深度解析

本文深入解析PyTorch动态计算图的核心机制与实战应用,涵盖自动求导、梯度累积等关键技术。通过具体代码示例展示动态图的调试优势与内存管理技巧,帮助开发者高效处理大型模型训练中的显存限制和梯度控制问题。

weixin_30374009的博客 327

PyTorch动态计算图生命周期管理:解决RuntimeError: Trying to backward through the graph a second time

在深度学习框架中,自动微分是实现神经网络训练的核心机制,它通过构建计算图来追踪张量间的运算依赖关系。PyTorch采用动态计算图,每次前向传播都会实时构建一个记录所有中间变量和运算的有向无环图。反向传播时,框架会沿着该图执行链式法则,计算参数的梯度。默认情况下,为高效利用内存,计算图在完成一次反向传播后会被立即销毁。这一机制在标准训练循环中表现优异,但在多任务学习、GAN训练等需要单次迭代内多次计算梯度的复杂场景下,若未妥善处理计算图生命周期,便会触发“RuntimeError: Trying to bac

weixin_33816946的博客 404

Pytorch-detach()用法

目的: 神经网络的训练有时候可能希望保持一部分的网络参数不变,只对其中一部分的参数进行调整。或者训练部分分支网络,并不让其梯度对主网络的梯度造成影响.这时候我们就需要使用detach()函数来切断一些分支的反向传播. 1 tensor.detach() 返回一个新的tensor,从当前计算图中分离下来。但是仍指向原变量的存放位置,不同之处只是requirse_grad为false.得到的这个tensir永远不需要计算器梯度,不具有grad. 即使之后重新将它的requires_grad置为true,

qq_31244453的博客 4万+

PyTorch自动微分与计算图原理深度解析

计算图是深度学习框架的核心抽象,它将神经网络的前向传播建模为有向无环图(DAG),并依托自动微分(Automatic Differentiation)实现高效梯度计算。其底层原理并非符号微分或数值微分,而是基于链式法则的反向传播在运行时动态构建的梯度流拓扑结构。这一机制赋予PyTorch动态图灵活性,支撑条件分支、动态网络结构等工程需求,同时带来内存管理、梯度生命周期等独特调试挑战。在GPU训练、模型部署及梯度优化等实际场景中,理解Autograd引擎如何协同Tensor、Function与Engine组件

weixin_34130389的博客 552

pytorch的函数 .detach()

参考: http://www.bnikolic.co.uk/blog/pytorch-detach.html

群星闪耀的博客 1万+

【Pytorch实战教程】Pytorch中.detach()的详细介绍

detach()方法返回一个新的张量,从当前计算图中分离出来,即返回的张量不会参与梯度计算。这在某些情况下非常有用,例如,当我们希望在不影响梯度计算的情况下使用张量的值时。detach()是 PyTorch 中一个强大的工具,允许我们在计算图中灵活控制梯度传播。通过将张量从计算图中分离出来,我们可以在不影响原始计算图的情况下使用张量的值。这在许多场景中(如生成对抗网络、复杂计算图和内存管理)都非常有用。

若北辰 3254

Dofbot机械臂从零部署笔记(1)——ROS之创建URDF模型、配置Moveit和MotionPlanning

Dofbot机械臂从零部署笔记(1)——ROS之创建URDF模型、配置Moveit和MotionPlanning

takedachia的博客 8698

PyTorch中detach函数的作用与最佳实践

自动微分是现代深度学习框架的核心技术,PyTorch通过动态计算图实现高效的梯度计算。在模型开发过程中,经常需要将张量转换为NumPy数组进行可视化或与其他库交互,这时就需要理解detach函数的关键作用。detach通过创建共享存储但剥离梯度信息的新张量,既保证了内存效率,又实现了计算隔离。该技术广泛应用于模型中间结果可视化、自定义损失函数实现以及推理性能优化等场景。与no_grad上下文管理器和clone方法相比,detach在特定场景下展现出独特的优势。合理使用detach可以避免常见的梯度计算中断问

weixin_32830601的博客 308

Redmi K30 5G刷 LineageOS17.1

前言 买手机前就观望了Xdr论坛,看Redmi K30 5G有LineageOS17.1的Rom并且还挺热,应该还不错,就入手了。晚上就刷机了。买了小米就是为了折腾,为发烧而生。 在开始前还请先安装adb工具,因为我自己是做Android开发的,自带adb,不会安装的可以百度“Android安装adb工具”。还有下载刷机文件:百度云 密码:2a0f 刷机的系统是刚买来的低版本,没有升级过Rom,如果高版本慎刷。 还有这个Rom是5G版本的,4G版本的不要刷。 建议没有刷过机器的最好不要尝试,变砖后果自负。

u010436867的博客 1万+

detach与no_grad:PyTorch梯度控制的艺术与陷阱

本文深入探讨了PyTorch中`detach()`与`no_grad()`的梯度控制技术,解析了它们在模型训练中的核心作用与潜在陷阱。通过实际代码示例展示了如何有效冻结网络参数、优化计算效率,并提供了性能对比与最佳实践建议,帮助开发者避免常见错误并提升深度学习项目的效率。

e6f7g8h9i的博客 625

开源CMDB与资产管理平台对比报告

本文对比分析了9款主流开源CMDB平台,从集成能力、功能完整性和多语言支持三个维度进行评测。重点介绍了VeCMDB、蓝鲸CMDB、WeCMDB和OpsAny等国产平台的特色:VeCMDB以动态模型和自动发现见长;蓝鲸CMDB适合超大规模企业级应用;WeCMDB专注金融级高并发场景;OpsAny提供一体化运维解决方案。针对不同规模企业给出选型建议:中小团队推荐Snipe-IT等轻量工具;大型企业建议蓝鲸或WeCMDB;需国产化适配的可选VeCMDB或OpsAny。文章还特别指出iTop、GLPI等适合ITIL

huang0612123的博客 1081

从0到1,快速理清 | DeepSeek Harness

DeepSeek推出自研Harness开发平台,主打"一切皆插件"理念,将AI执行能力模块化为可自由组合的插件体系。带你从0到1,快速了解开发链路。

IT学习博客 685

PyTorch detach()原理与应用:解决内存泄漏与梯度控制

在深度学习框架中,自动微分是实现模型训练的核心机制,它通过构建动态计算图来追踪张量操作并计算梯度。PyTorch作为主流框架,其动态图特性在提供灵活性的同时,也带来了内存管理与梯度控制的技术挑战。理解计算图的构建与生命周期管理,对于编写高效、稳定的训练代码至关重要。detach()方法正是解决这些问题的关键技术之一,它通过创建与原张量共享数据但剥离计算历史的副本,实现对梯度传播路径的精确控制。这一机制在模型微调、强化学习策略梯度、训练监控等场景中具有重要价值,能有效避免因保留不必要计算图而导致的内存泄漏问题

weixin_27013291的博客 296

Benchmark系列——基本概念和分类

本文主要介绍了Benchmark的基本概念和分类情况。

Bluetangos的博客 8439

PyTorch中clone()与detach()的联合使用:安全复制与梯度控制的实战解析

本文深入解析了PyTorch中clone()与detach()的联合使用,旨在实现张量的安全复制与精确梯度控制。通过对比两者独立特性,阐明detach().clone()组合在数据独立与计算图隔离上的优势,并结合模型状态保存、权重裁剪等实战场景,提供了避免内存共享与梯度干扰的最佳实践方案。

weixin_29085151的博客 318

YOLO系列算法改进 | C3k2改进篇 | 融合DFRL双融合注意力接收层 | 轻量化与全局感受野双突破,适应高分辨率航拍与密集小目标检测场景 | CVPR 2026

YOLO系列算法改进 | C3k2改进篇 | 融合DFRL双融合注意力接收层 | 轻量化与全局感受野双突破,适应高分辨率航拍与密集小目标检测场景 | CVPR 2026 (以YOLO26最新目标检测模型为基础,利用C3k2_DFRL创新模块进行改进)

2502_91881744的博客 233

yolov5运行detect.py之后卡住了?没后续,没结果,没报错,怎么办?如何解决?

🏆 本文收录于《全栈Bug调优(实战版)》专栏,致力于分享我在项目实战过程中遇到的各类Bug及其原因,并提供切实有效的解决方案。无论你是初学者还是经验丰富的开发者,本文将为你指引出一条更高效的Bug修复之路,助你早日登顶,迈向财富自由的梦想🚀!同时,欢迎大家关注、收藏、订阅本专栏,更多精彩内容正在持续更新中。让我们一起进步,Up!Up!Up!    备注: 部分问题/难题源自互联网,经过精心筛选和整理,结合数位十多年大厂实战经验资深大佬经验总结所得,数条可行方案供所需之人参考。

**My Coding Family** 1105

pytorch小记(八):pytorch中有关于.detach()的浅显见解

pytorch小记(八):pytorch中有关于.detach()的浅显见解

xzs1210652636的博客 1318

Sigrity System SI Parallel Bus Analysis模式进行DDR3仿真分析操作指导-单个颗粒

Default Strobe Offset:DQS默认偏移时间,自动填充为0.5ns,即DQS默认偏移1/2UI,DQS滞后于DQ 1/2UI,让建立保持时间均分。WLO:写平衡偏移的数值,DataL是0ps,DataU是500ps,是根据WLOSkew自动定义的,可以认为是WLOSkew取整,也可以根据需要手动调整数值。注意AddCmd的UI=T,这里的Data Rate仍然是DQ的速率,并不是地址线的速率,地址线的速率=1/UI=1/2ns=0.5Gbps。

weixin_54787054的博客 366

PyTorch RuntimeError: 解决“第二次反向传播”报错与计算图管理

在深度学习框架中,自动微分(Autograd)是实现神经网络训练的核心机制,它通过构建动态计算图来跟踪张量操作并自动计算梯度。其工作原理是在前向传播时记录操作序列,形成有向无环图,并在反向传播时利用链式法则计算参数梯度。这一机制的技术价值在于极大简化了梯度计算,使研究人员能专注于模型设计。然而,计算图在默认情况下会在首次反向传播后被释放以节省内存,若试图对同一计算图进行第二次反向传播,便会触发经典的 RuntimeError。该问题常见于多任务学习、梯度累积、RNN训练等应用场景,尤其在使用自定义损失函数或

weixin_33766805的博客 326

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

PyTorch训练中detach()的3个真实使用场景:从GAN训练到梯度截断

本文深入探讨了PyTorch中detach()函数的3个关键应用场景,包括GAN训练中的梯度隔离、RNN训练中的梯度截断以及内存优化与自定义损失函数。通过实际代码示例和性能对比,展示了如何有效使用detach()解决训练难题,提升模型稳定性和效率。

weixin_30566111的博客 344

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

PyTorch RuntimeError: 解决二次反向传播的计算图生命周期管理

在深度学习框架中,自动微分是实现神经网络训练的核心机制,它通过构建动态计算图来追踪张量操作并自动计算梯度。其原理是在前向传播过程中记录所有运算,形成有向无环图,以便在反向传播时应用链式法则。这一机制的技术价值在于极大简化了梯度计算,使开发者能专注于模型设计。然而,若管理不当,例如在梯度累积、GAN交替训练等应用场景中多次调用backward(),就会因计算图被默认释放而触发“RuntimeError: Trying to backward through the graph a second time”错误

weixin_33912453的博客 434

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

上一篇: 【动手学深度学习】Autogressive Model Demo
下一篇: 【LLM基础教程】语言模型基础
未收敛
博客等级 码龄11年 3317粉丝 163原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

未收敛

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值