Transformer架构:输出部分代码实现(基于PyTorch)

使用Pytorch从零实现Transformer模型 2017年Google在论文《Attention is All You Need》中提出了Transformer模型,并成功应用到NLP领域。该模型完全基于自注意力机制Attention mechanism实现,弥补了传统的RNN模型的不足。本文笔者将详解使用Pytorch从零开始逐步实现Transformer模型。 阅读详情


相关文章

Transformer架构:结构介绍:网页链接
Transformer架构:输入部分代码实现(基于PyTorch):网页链接
Transformer架构:核心模块代码实现(基于PyTorch):网页链接
Transformer架构:编码器部分代码实现(基于PyTorch):网页链接
Transformer架构:解码器部分代码实现(基于PyTorch):网页链接
Transformer架构:整体实现代码(基于PyTorch):网页链接


一、输出部分的核心作用

在Transformer架构中,输出部分(Generator)是连接模型特征与任务目标的“最后一公里”,负责将解码器输出的高维特征转化为可直接用于预测的词表概率分布。其核心功能体现在:

  1. 特征映射:将解码器输出的[batch_size, seq_len, embedding_dim]特征张量,通过线性变换映射到词表维度(vocab_size),实现“特征→词表”的维度转换。
  2. 概率归一化:使用log_softmax对输出进行归一化,既保证概率总和为1,又通过对数形式提升数值稳定性,便于后续计算负对数似然损失(NLLLoss)。
  3. 生成决策:为序列生成任务(如机器翻译、文本生成)提供每个位置的预测词概率,支持贪婪搜索、束搜索等解码策略。

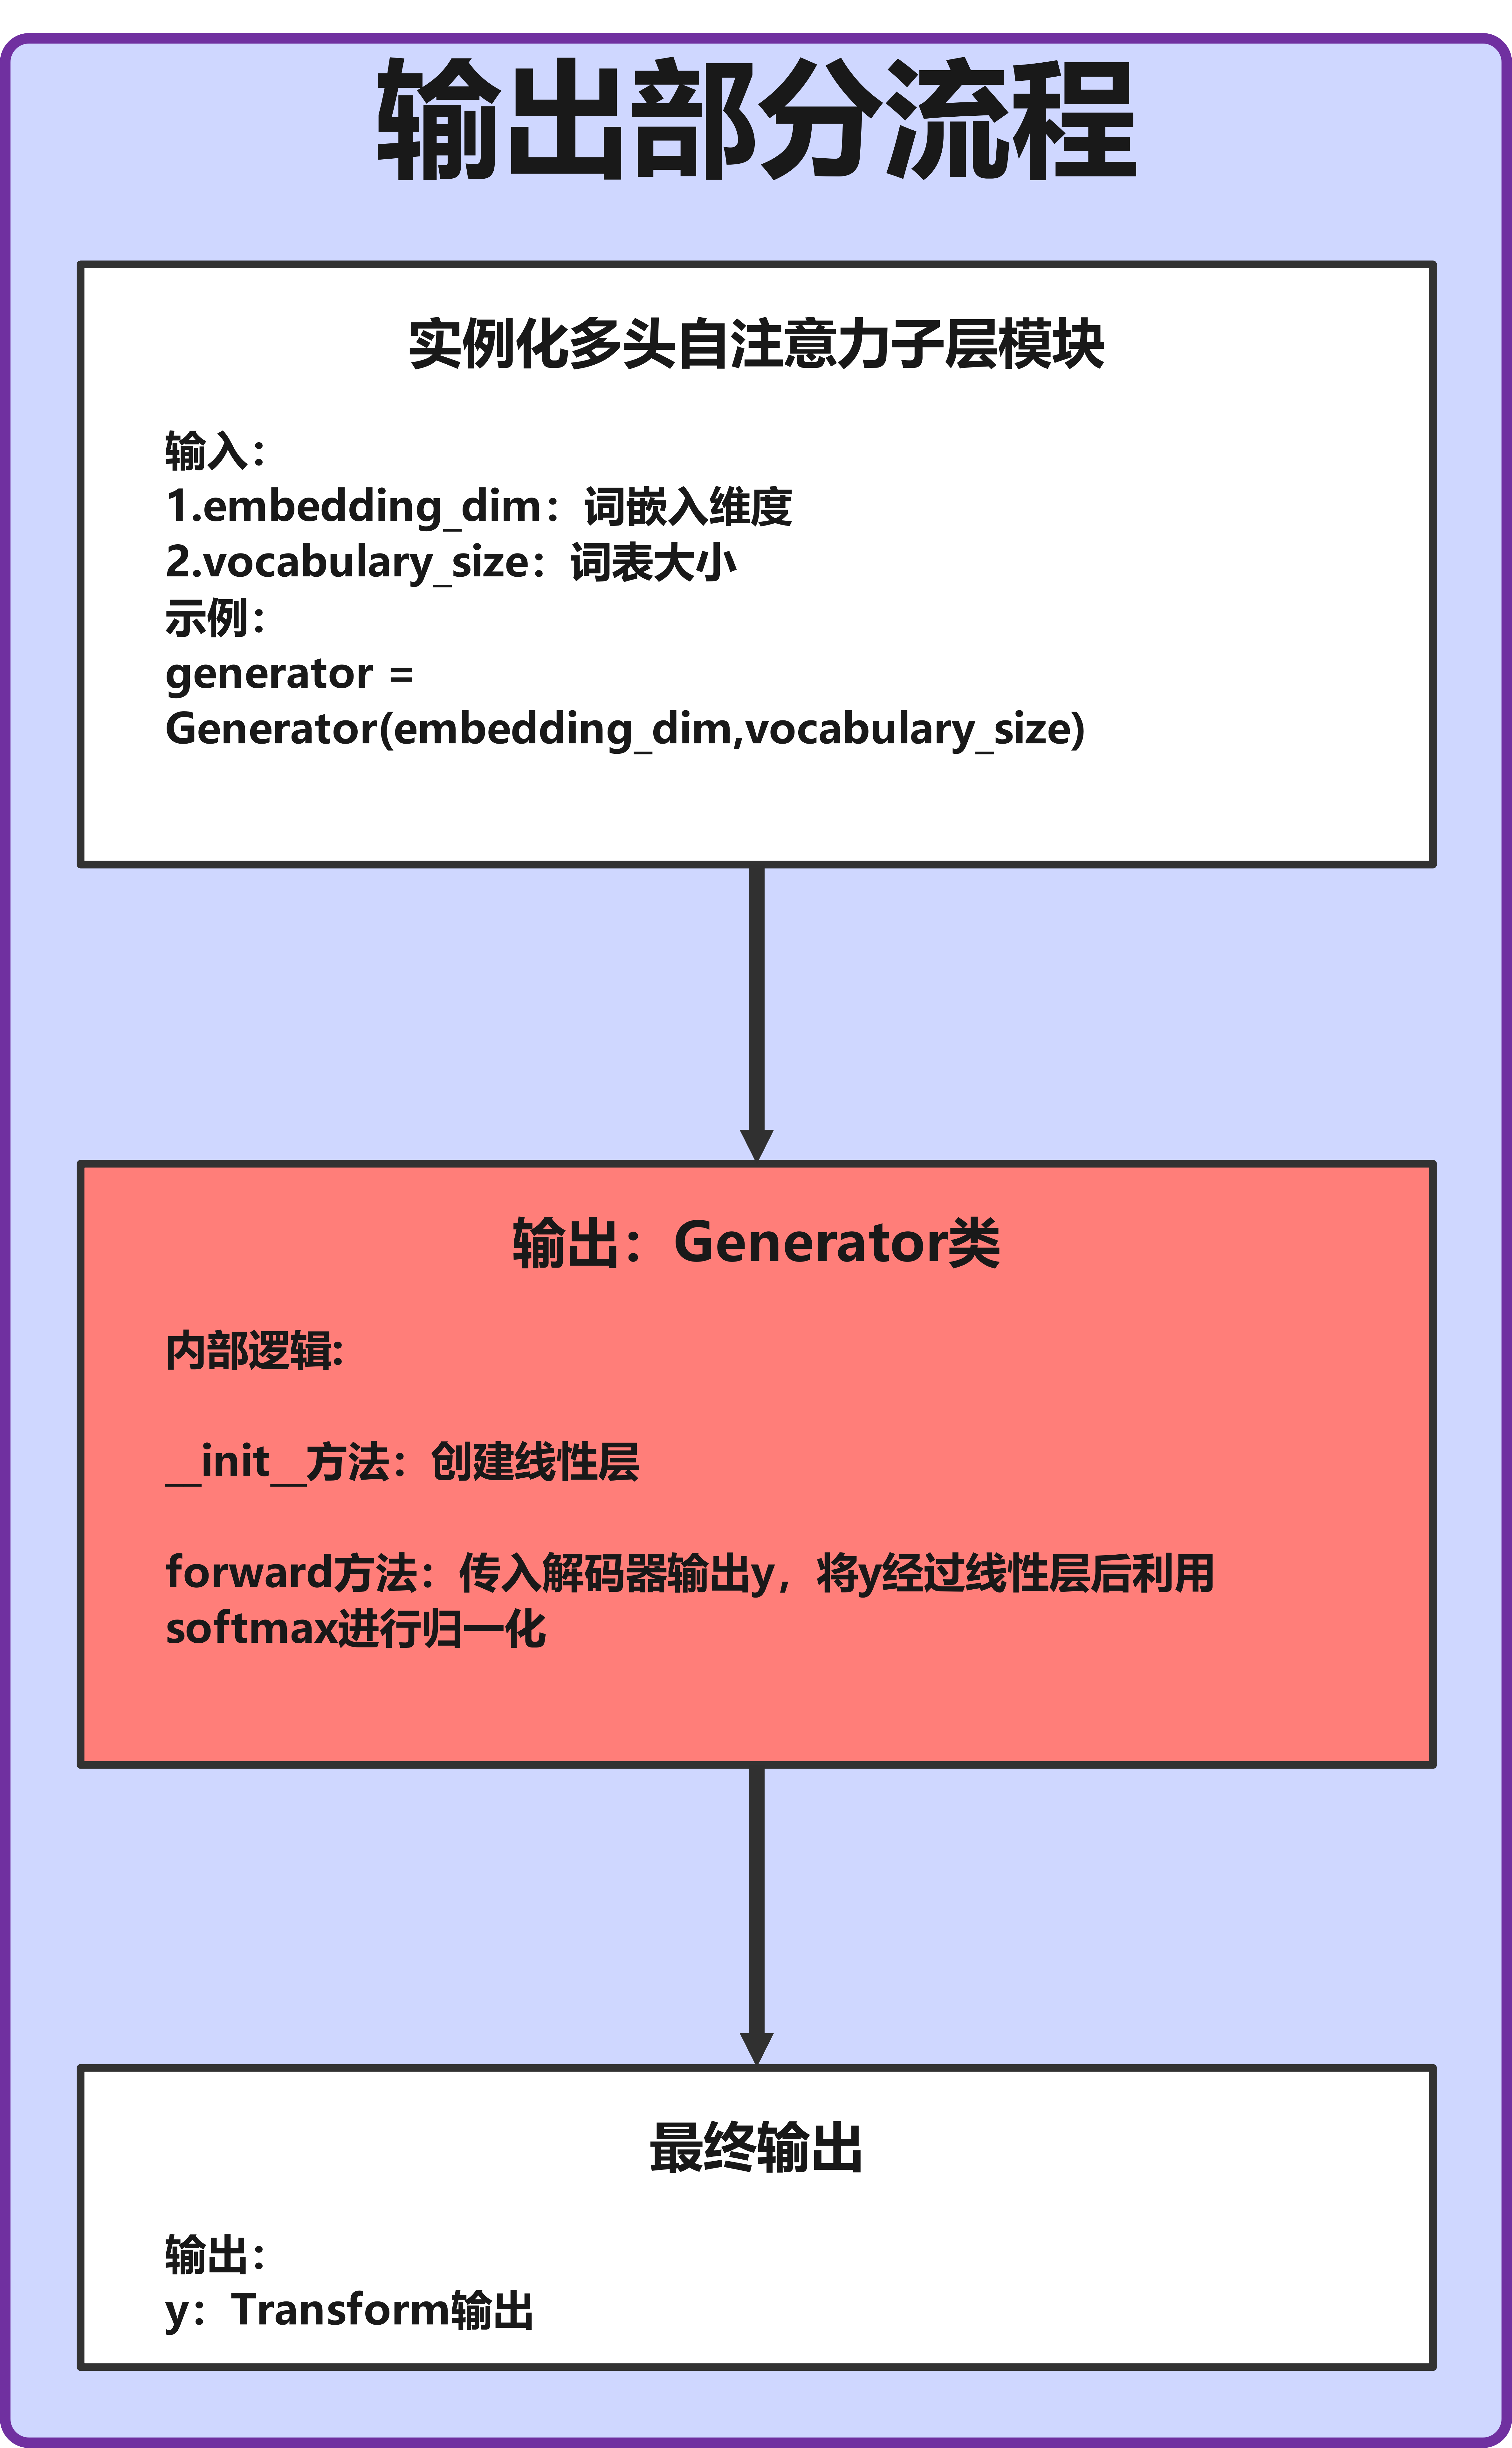
二、输出部分工作流程图
在这里插入图片描述

流程说明:

  1. 输入:解码器输出的特征张量(形状:[batch_size, tgt_seq_len, embedding_dim])。
  2. 线性层:将embedding_dim维度的特征映射到vocab_size维度(形状:[batch_size, tgt_seq_len, vocab_size])。
  3. Log-Softmax:对最后一个维度进行归一化,输出每个token的对数概率(形状不变)。
  4. 输出:可直接用于计算损失(训练阶段)或生成预测结果(推理阶段)。

三、输出部分核心代码实现与解析

Transformer输出部分的核心是Generator类,其代码简洁但作用关键,下面详细解析:

3.1 Generator类代码实现

import torch
import torch.nn as nn
import torch.nn.functional as F

class Generator(nn.Module):
    """将解码器输出映射到词表概率分布的模块"""
    def __init__(self, embedding_dim, vocab_size):
        super().__init__()
        # 线性层:将解码器输出的高维特征映射到词表大小
        self.project = nn.Linear(embedding_dim, vocab_size)

    def forward(self, x):
        """
        参数:
            x: 解码器输出的特征张量,形状为[batch_size, seq_len, embedding_dim]
        返回:
            log_probs: 对数概率分布,形状为[batch_size, seq_len, vocab_size]
        """
        # 先通过线性层映射到词表维度,再应用log_softmax归一化
        return F.log_softmax(self.project(x), dim=-1)

3.2 代码细节解析

  1. 初始化方法(init):

    • embedding_dim:解码器输出的特征维度(需与Transformer整体维度一致,如512)。
    • vocab_size:目标任务的词表大小(如机器翻译中的目标语言词表大小)。
    • self.project:线性层(nn.Linear)是核心组件,权重矩阵形状为[embedding_dim, vocab_size],负责将高维特征压缩到词表维度。
  2. 前向传播(forward):

    • 输入x是解码器的输出特征,形状为[batch_size, seq_len, embedding_dim]。
    • 第一步通过self.project(x)将特征映射到词表维度,输出形状为[batch_size, seq_len, vocab_size]。
    • 第二步应用F.log_softmax(..., dim=-1):
      • 对最后一个维度(词表维度)进行归一化,确保每个位置的概率和为1。
      • 使用log_softmax而非softmax的原因:一是避免数值下溢(softmax在高维时易出现极小数),二是与PyTorch的NLLLoss损失函数直接兼容(NLLLoss需输入log概率)。

3.3 张量形状变化示例

假设Transformer的embedding_dim=512,目标语言词表vocab_size=10000,输入解码器输出的特征形状为[2, 6, 512](2条样本,每条6个token):

  • 经过self.project(x)后,形状变为[2, 6, 10000](映射到词表维度)。
  • 经过log_softmax后,形状保持[2, 6, 10000],但每个[6, 10000]矩阵的最后一个维度满足概率和为1(对数空间)。

四、输出部分与损失函数的配合

在训练阶段,Generator的输出需与损失函数配合计算模型误差。以机器翻译为例,常用NLLLoss(负对数似然损失),其计算流程如下:

# 示例:Generator输出与损失计算
def test_loss():
    # 模拟解码器输出:[batch_size=2, seq_len=6, embedding_dim=512]
    decoder_output = torch.randn(2, 6, 512)
    # 初始化生成器(词表大小10000)
    generator = Generator(embedding_dim=512, vocab_size=10000)
    # 生成对数概率分布
    log_probs = generator(decoder_output)  # 形状:[2, 6, 10000]
    
    # 模拟目标标签(每个位置的真实token索引):[batch_size=2, seq_len=6]
    target_labels = torch.randint(0, 10000, (2, 6), dtype=torch.long)
    
    # 计算损失(NLLLoss需将log_probs展平为[batch*seq_len, vocab_size],标签展平为[batch*seq_len])
    criterion = nn.NLLLoss()
    loss = criterion(log_probs.reshape(-1, 10000), target_labels.reshape(-1))
    print(f"损失值:{loss.item()}")  # 输出一个标量损失

test_loss()

关键说明:

  • NLLLoss会自动取出每个位置真实标签对应的对数概率,并计算平均值的相反数,实现“最大化正确标签概率”的训练目标。
  • 若使用CrossEntropyLoss,则无需log_softmax,但Transformer中通常保留log_softmax以提升数值稳定性。

五、生成阶段的预测逻辑(推理阶段)

在推理阶段(如生成译文),Generator的输出需通过解码策略转化为具体token序列。以贪婪搜索为例:

def greedy_decode(generator, decoder_output):
    """贪婪搜索:每个位置选择概率最高的token"""
    log_probs = generator(decoder_output)  # [batch_size, seq_len, vocab_size]
    # 取最后一个维度的最大值索引(即预测的token)
    predicted_tokens = torch.argmax(log_probs, dim=-1)  # [batch_size, seq_len]
    return predicted_tokens

# 测试贪婪搜索
decoder_output = torch.randn(2, 6, 512)  # 模拟解码器输出
generator = Generator(512, 10000)
preds = greedy_decode(generator, decoder_output)
print(f"预测的token序列:{preds}")
print(f"预测形状:{preds.shape}")  # 预期:[2, 6]

扩展说明:

  • 实际应用中,贪婪搜索可能生成重复或不合理的序列,因此常使用束搜索(Beam Search)等更优策略,但核心都是基于Generator输出的概率分布。

六、输出部分的设计思想

  1. 极简主义设计:
    输出部分仅包含一个线性层和log_softmax,与复杂的编码器、解码器形成对比。这种设计的原因是:特征提取和语义建模已由前面的层完成,输出部分只需专注于“特征→词表”的映射,避免引入冗余参数。

  2. 与整体架构的兼容性:

    • embedding_dim必须与解码器输出维度一致,确保张量形状匹配。
    • vocab_size需与目标任务的词表对应(如翻译任务中与目标语言词表大小一致)。
  3. 数值稳定性优先:
    使用log_softmax而非softmax,解决了高维空间中概率值过小导致的下溢问题,同时兼容PyTorch的损失函数接口,简化训练流程。


七、完整代码与测试验证

7.1 完整代码

import torch
import torch.nn as nn
import torch.nn.functional as F

# 假设从解码器模块导入测试函数
from Transformer_decoder import test_decoder

class Generator(nn.Module):
    """Transformer输出部分:将解码器特征映射到词表概率分布"""
    def __init__(self, embedding_dim, vocab_size):
        super().__init__()
        self.project = nn.Linear(embedding_dim, vocab_size)

    def forward(self, x):
        return F.log_softmax(self.project(x), dim=-1)

# 测试输出部分与解码器的配合
def test_generator():
    # 获取解码器输出(来自解码器测试函数)
    decoder_result = test_decoder()  # 形状:[2, 6, 512]
    # 初始化生成器(假设词表大小为10000)
    generator = Generator(embedding_dim=512, vocab_size=10000)
    # 生成对数概率
    generator_result = generator(decoder_result)
    # 验证输出形状
    print(f'{"*"*30}生成器输出{"*"*30}')
    print(f'生成器输出形状:{generator_result.shape}')  # 预期:[2, 6, 10000]
    # 验证log_softmax的归一性(最后一个维度的指数和应为1)
    probs = torch.exp(generator_result)  # 转换为概率
    sum_probs = torch.sum(probs, dim=-1)  # 每个位置的概率和
    print(f'概率和(应接近1.0):{sum_probs}')
    return generator_result

if __name__ == '__main__':
    test_generator()

7.2 测试输出说明

  • 形状验证:生成器输出形状为[2, 6, 10000],与解码器输出的[2, 6, 512]兼容,确保序列长度和批次大小不变。
  • 归一性验证:torch.sum(probs, dim=-1)的结果接近1.0,证明log_softmax正确实现了概率归一化。

Transformer代码(Pytorch实现和详解)!!! 这个是第一版,有些代码如果不对,欢迎在评论指正,后续会慢慢改,我也是刚接触transformer,若有些地方理解不对还请指正。 阅读详情

相关推荐

第TR3周:Pytorch复现Transformer

Transformer可以看作是seq2seq模型的一种,因此,先从seq2seq的角度对Transformer进行宏观结构的学习。下图1先便是Transformer整体结构图,与seq2seq模型类似,Transformer模型结构中的左半部分为编码器,右半部分为解码器,下面我们来一步步拆解Transformer。在某种程度上,可以将Transformer看作是Seq2Seq的一种演变,Transformer可以执行Seq2Seq任务,并且相对于传统的Seq2Seq模型具有更好的性能和可扩展性。

lihuhelihu的博客 3022

NLP:Transformer输出部分

前言:前文讲解了Transformer的解码器,本篇文章讲解Transformer的输出部分。

sulin123123的博客 466

springcloud教程 -- 1.快速搭建入门级demo,看这一篇就够了

废话不多讲,跟紧我,开启你的SpringCloud初体验 首先回顾微服务的基本组成: [图片 here] 生产者:提供服务 消费者:消费服务 服务注册/发现中心:服务注册,发现,监控 所以,首先明白springcloud微服务的架构基础:生产者(client),消费者(client),服务注册/发现中心(server)

叶巨岩的博客 8万+

Transfomer原理输入部分,输出部分,

首先,将输入的文本序列通过词嵌入层转换为词嵌入向量,然后加上位置编码,得到每个词的位置嵌入向量。在自注意力机制中,每个词语都可以与其他词语进行交互,通过计算注意力权重来确定不同位置之间的重要性,并将这些权重应用于输入向量上,从而得到考虑了全局依赖关系的表示。在Transformer模型中,通过Softmax层可以将解码器的输出向量映射为各个词的概率分布,从而得到最终的输出结果。在Transformer模型中,词嵌入层将输入的词语映射为词嵌入向量,这些向量将作为模型的输入。在解码器的第一个注意力模块使用。

互联网知识分享 667

用matlab编程求矩阵的极大无关组,向量组极大无关组表示问题

已知向量组T:Eqn11.gif (3.16 KB, 下载次数: 1)2013-10-21 19:19 上传.(1) 求向量组T的秩,并判断向量组T的相关性;(2) 求T的极大线性无关组;(3) 将其余的向量用所求的极大线性无关组线性表示。程序:>> A=[1 1 3 2;-1 1 -1 3;5-2 8 9;-1 3 1 7]>> r=rank(A)>> A1=...

weixin_35094083的博客 7385

STM32 IIC温湿度传感器(STH45)实验

精度 ΔRH = ±1.0 %RH, ΔT = ±0.1 °C• 平均电流:0.4 μA,空闲电流:80 nA• I2C FM、CRC 校验和、乘法。I2C 地址。• 专利保护选项 [1]、PTFE 膜和可拆卸保护盖• 工作范围:0 …100 %相对湿度,−40…125 摄氏度• 在冷凝环境中功能齐全• 动力加热器,真正的NIST可追溯性• JEDEC JESD47 认证 • 符合 ISO 17025 : 2017 的传感器专用校准证书,3 点温度校准。

baidu_34971492的博客 3072

Transformer解码器部分实现

解码器部分实现

weixin_46556352的博客 971

H3C BGP联盟实验

bgp,bgp联盟,bgp公认团体属性,

一只懒羊羊 970

transformer架构解析{输出部分}(含代码)-7

前一节我们学习了解码器层的各个组成部分(3个子层结构:多头自注意力机制+规范化层+残差连接;多头注意力机制+规范化层+残差连接;前馈神经网络+规范化层+残差连接),解码器以及它们的实现代码。

JamesSwifte的博客 239

OceanBase全局索引深度解析:分布式环境下的高效索引设计与实战优化指南

全局索引(Global Index)是OceanBase数据库在分布式环境中提供的一种跨分区、跨服务器的索引结构,它允许用户创建跨越多个分区的索引,为分布式查询提供高效的数据访问路径。与局部索引(Local Index)不同,全局索引不是与表分区一一对应的,而是作为一个独立的逻辑结构存在。 在分布式数据库系统中,全局索引解决了以下几个关键问题: 跨分区查询性能:当查询条件不包含分区键时,全局索引可以避免全表扫描 唯一性约束维护:全局索引能够保证索引键在全局范围内的唯一性 分布式事务支持:全局索引与主表数

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 717

【AI for Medecine】吴恩达医学图像AI专项课程(诊断、预测、治疗)

近期需要简单了解AI4Science上的一些应用,看到吴恩达大佬的专项课程,于是开始来个“全面”的了解--医学人工智能(诊断、预测、治疗)。

图挖掘领域,新晋砖家 ☞ 未来可期,欢迎和静静一起学习交流吖 772

从零开始读懂Transformer:架构解析与PyTorch实现

本文深入解析了Transformer架构及其PyTorch实现,主要内容包括: 背景介绍:Transformer作为现代NLP基础架构,彻底改变了序列建模方式,成为BERT、GPT等大模型的核心 架构总览:详细图解了Transformer的四大组成部分: 输入部分(词嵌入+位置编码) 编码器(多头注意力+前馈网络) 解码器(自注意力+编码器-解码器注意力) 输出部分(线性层+softmax) 关键实现: 词嵌入层将离散token转为连续向量 位置编码通过正弦/余弦函数显式加入顺序信息 提供了PyTorch代

yun_kumo1028的博客 1483

SerDes电路的PCB仿真设计规则及策略

SerDes的PCB设计中,重点工作是使用3D 电磁 (EM) 场求解器,进行过孔结构优化,包括 BGA的扇入和扇出区域以及布线的过孔区域,并且,利用连接器供应商提供加密的 3D 模型,进行连接器和 PCB 的级联仿真,最终获取系统级的通道性能参数,如插入损耗、回波损耗、串扰和模式转换、阻抗曲线等,如果发现任何缺陷,再进行进一步优化,这一过程中,推荐进行拆分仿真,以提高设计效率。

一只豌豆象的博客 2192

Transformer

Positional Encoding位置编码,通常通过为每个位置生成一个唯一的向量,并将这个向量加到对应位置的词嵌入向量上,来实现。Transformer模型中使用的是一种固定的、基于正弦和余弦函数的编码方案,该方案允许模型捕获单词间的相对和绝对位置关系。每个编码器层由两个子层连接结构组成。第一个子层连接结构包括一个。和规范化层以及一个残差连接。第二个子层连接结构包括一个。和规范化层以及一个残差连接。和规范化层以及一个残差连接。和规范化层以及一个残差连接。和规范化层以及一个残差连接。

mvnmvn的专栏 338

大模型新闻摘要生成质量评估工具

大模型新闻摘要生成质量评估工具 关键词:大模型、新闻摘要、质量评估、自然语言处理、算法 摘要:本文将探讨大模型新闻摘要生成质量评估工具的设计与应用。首先介绍大模型新闻摘要生成的背景和问题,然后深入分析质量评估的难点和重要性,接着介绍大模型的

AI天才研究院 828

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

Transformer架构:输入部分代码实现(基于PyTorch)

Transformer输入部分将离散文本转换为连续向量,包含两大核心组件:词嵌入(Embedding)将词索引映射为512维向量并进行缩放处理,使语义相似的词向量距离更近;位置编码(Positional Encoding)通过正弦余弦函数为每个位置生成独特编码,叠加在词向量上以保留序列顺序信息。代码实现展示了PyTorch中Embedding层和自定义位置编码类的使用,包括矩阵生成、缩放操作和Dropout应用。最终输出为融合语义和位置信息的张量,形状为[batch_size, seq_len, embed

Springfield3006的博客 1192

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Transformer的PyTorch实现

本文由罗周杨原创,转载请注明作者和出处。未经授权,不得用于商业用途 Google 2017年的论文 Attention is all you need 阐释了什么叫做大道至简!该论文提出了Transformer模型,完全基于Attention mechanism,抛弃了传统的RNN和CNN。 我们根据论文的结构图,一步一步使用 PyTorch 实现这个Transformer模型。 Transf...

stupid_3的博客 4万+

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

【AI大模型】深入Transformer架构:输入和输出部分的实现与解析

因为在Transformer的编码器结构中, 并没有针对词汇位置信息的处理,因此需要在Embedding层后加入位置编码器,将词汇位置不同可能会产生不同语义的信息加入到词嵌入张量中, 以弥补位置信息的缺失.

2301_76820214的博客 6557

Transformer架构:整体实现代码(基于PyTorch)

Transformer架构解析 Transformer是一种基于自注意力机制的序列转换模型,采用编码器-解码器结构实现端到端序列建模。其核心优势在于并行计算能力、长距离依赖捕捉和跨模态对齐。模型由六大组件构成:输入处理模块(词嵌入+位置编码)、编码器(处理源序列)、解码器(生成目标序列)、多头注意力机制、前馈网络和输出层。工作流程包括源序列向量化、编码器特征提取、解码器序列生成和词汇概率输出。通过多头自注意力和位置编码等机制,Transformer有效解决了传统RNN模型在长序列处理上的局限性,广泛应用于机

Springfield3006的博客 1559

Transformer架构:解码器部分代码实现(基于PyTorch)

本文详细解析了Transformer架构中解码器(Decoder)的工作原理与PyTorch实现。解码器是序列生成任务的核心模块,通过自注意力机制捕捉目标序列内部依赖,同时利用编码器-解码器注意力实现跨序列对齐。文章从单层解码器到多层堆叠的完整结构展开,重点分析了掩码机制、残差连接等关键技术,并提供了模块化代码实现与测试验证流程,帮助理解解码器如何逐步优化生成序列的语义一致性和语法正确性。

Springfield3006的博客 1276

【手撕Transformer】Transformer输入输出细节以及代码实现(pytorch)

文章目录举例讲解transformer的输入输出细节encoderpaddingPadding MaskPositional EmbeddingattentionFeedForwardadd/Normencoder输入输出decoderSequence Mask测试Transformer pytorch代码实现数据预处理Positional EncodingPad MaskSubsequence MaskScaledDotProductAttentionMultiHeadAttentionFeedFor.

顾道长生的科研笔记 3万+

Transformer架构:编码器部分代码实现(基于PyTorch)

本文详细解析了Transformer架构中编码器(Encoder)的核心作用与实现细节。编码器通过多层堆叠的编码器层(EncoderLayer)实现特征提取,每个编码器层包含自注意力子层和前馈网络子层,采用残差连接和规范化确保训练稳定性。文章提供了基于PyTorch的代码实现,分析了编码器层的模块化设计(多头注意力、前馈网络)和整体编码器的多层堆叠逻辑。关键设计思想包括:模块化堆叠实现深度特征提取、自注意力机制捕获长距离依赖,以及与输入模块的衔接方式。完整代码展示了编码器层和整体编码器的实现,为理解Tran

Springfield3006的博客 1211

PyTorch从零开始实现Transformer

使用Pytorch实现Attention is all you need

阿正的梦工坊 4万+

Transformer的PyTorch实现(超详细)

文本主要介绍一下如何使用 PyTorch 复现 Transformer,实现简单的机器翻译任务。请先花上 15 分钟阅读我的这篇文章 Transformer详解,再来看文本,方能达到醍醐灌顶,事半功倍的效果 数据预处理 这里我并没有用什么大型的数据集,而是手动输入了两对德语→英语的句子,还有每个字的索引也是我手动硬编码上去的,主要是为了降低代码阅读难度,我希望读者能更关注模型实现的部分 # S: Symbol that shows starting of decoding input # E: Symbol

mathor的博客 6万+

transformer在图像分类上的应用以及pytorch代码实现

文章目录1.对transformers的简单介绍1.1序列数据的介绍(seq2seq)1.2self-Attention1.3 transformer的完整结构2.transformers在图像分类上的pytorch代码2.1加载cifar10数据集2.2构建transformers模型2.2.1构建图像编码模块 Embeddings2.2.3构建前向传播神经网络模块2.2.4构建编码器的可重复利用Block模块2.2.5构建Encoder模块2.2.6 构建完整的transformers2.2.7构建Vi

qq_37937847的博客 5万+

Transformer架构:核心模块代码实现(基于PyTorch)

本文解析Transformer架构四大核心模块:多头注意力机制通过多子空间并行计算捕捉多维度语义关联;前馈全连接层经非线性变换增强特征表达;规范化层稳定训练分布;子层连接结构结合残差连接与规范化保障深层网络训练。模块协同形成“关联捕捉-特征增强-稳定训练-网络深化”闭环,解析了各模块原理、实现及作用,展示其如何支撑Transformer在序列建模任务中的高效表现。

Springfield3006的博客 1438
上一篇: 人工智能概念之十:人工神经网络(ANN)
下一篇: 人工智能概念之十一:常见的激活函数与参数初始化
.30-06Springfield
博客等级 码龄7年 321粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值