Transformer架构:解码器部分代码实现(基于PyTorch)

Transformer编码器-解码器(Encoder-Decoder)架构介绍+代码实现 Transformer的编码器-解码器是基于自注意力的模块叠加而成的,源序列(Input)和目标序列(Target)的嵌入(Embedding)表示将加上位置编码(Positional encoding),再分别输入到编码器和解码器中。从宏观角度来看,Transformer的编码器是由多个相同的层叠加而 成的,每个层都有两个子层(子层表示为sublayer第一个子层是多头自注意力(汇聚;第二个子层是基于位置的前馈网络(具体来说,在计算编码器 的自注意力时,查询、键和值都来自前一个编码器层的输出, 阅读详情


相关文章

Transformer架构:结构介绍:网页链接
Transformer架构:输入部分代码实现(基于PyTorch):网页链接
Transformer架构:核心模块代码实现(基于PyTorch):网页链接
Transformer架构:编码器部分代码实现(基于PyTorch):网页链接
Transformer架构:输出部分代码实现(基于PyTorch):网页链接
Transformer架构:整体实现代码(基于PyTorch):网页链接


一、解码器的核心作用

在Transformer架构中,解码器(Decoder)是序列生成的核心模块,负责基于编码器输出的上下文特征和自身历史输出,生成符合任务需求的目标序列(如机器翻译中的译文、文本摘要中的摘要句)。其核心能力体现在:

  1. autoregressive 生成:通过掩码自注意力机制确保生成时仅依赖已生成的token,避免未来信息泄露。
  2. 跨模态对齐:通过编码器-解码器注意力机制,动态关联目标序列与源序列的上下文信息(如翻译时将“苹果”关联到“Apple”)。
  3. 特征精细化加工:通过多层堆叠的解码器层,逐步优化生成序列的语义一致性和语法正确性。

二、解码器整体工作流程图
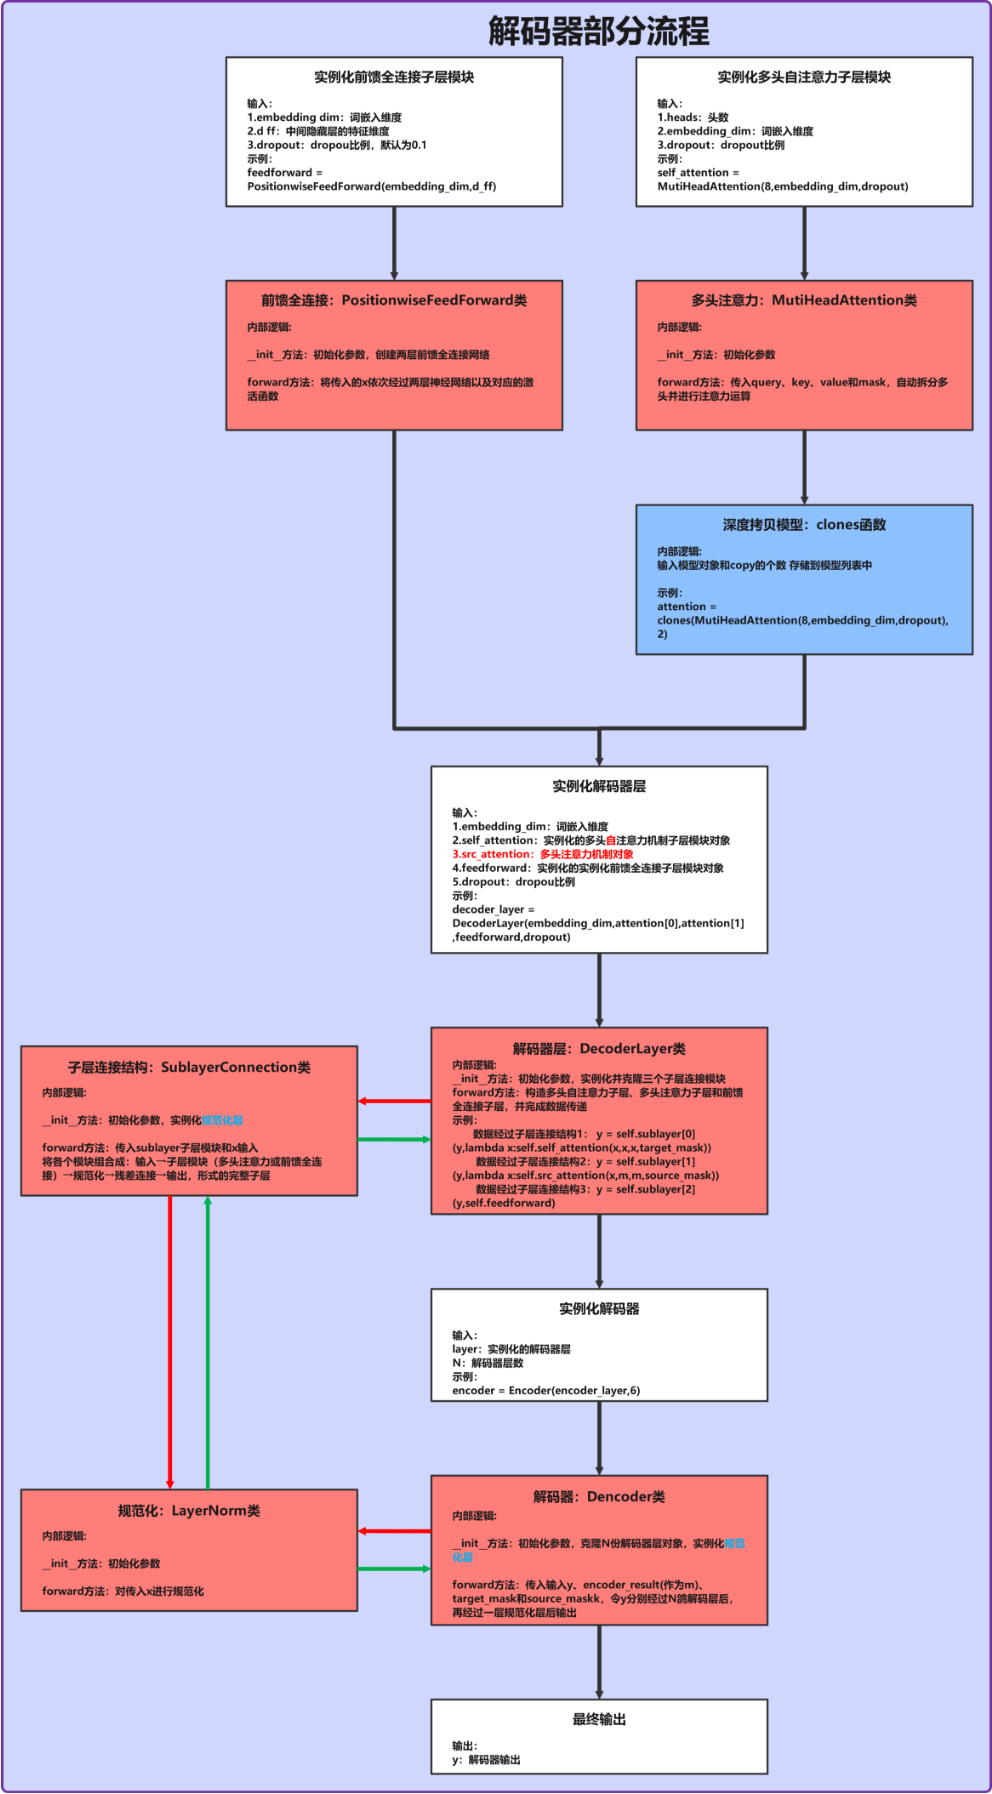
在这里插入图片描述


三、解码器层(DecoderLayer):单一层级的序列生成逻辑

解码器层是构成解码器的基本单元,每个层包含“自注意力子层”“编码器-解码器注意力子层”和“前馈网络子层”,通过子层连接结构实现特征的逐步优化。

3.1 代码实现与结构解析

class DecoderLayer(nn.Module):
    def __init__(self, embedding_dim, self_attention, src_attention, feedforward, dropout):
        super().__init__()
        self.embedding_dim = embedding_dim  # 词嵌入维度(如512)
        self.self_attention = self_attention  # 目标序列自注意力模块(带掩码)
        self.src_attention = src_attention    # 编码器-解码器注意力模块
        self.feedforward = feedforward        # 前馈全连接模块
        # 克隆3个子层连接结构(分别对应三个子层)
        self.sublayer = clones(SublayerConnection(embedding_dim, dropout), 3)

    def forward(self, y, encoder_result, target_mask, source_mask):
        m = encoder_result  # 编码器输出的源序列特征
        # 第一个子层:目标序列自注意力 + 残差连接 + 规范化
        y = self.sublayer[0](y, lambda x: self.self_attention(x, x, x, target_mask))
        # 第二个子层:编码器-解码器注意力 + 残差连接 + 规范化
        y = self.sublayer[1](y, lambda x: self.src_attention(x, m, m, source_mask))
        # 第三个子层:前馈网络 + 残差连接 + 规范化
        y = self.sublayer[2](y, self.feedforward)
        return y

3.2 关键细节解析

  1. 模块依赖:

    • self_attention:多头注意力实例(如8头),用于目标序列的自注意力计算(query=key=value=y)。
    • src_attention:多头注意力实例,用于关联目标序列与源序列(query=y, key=value=encoder_result)。
    • sublayer:通过clones函数复制的3个子层连接结构,封装“残差连接+LayerNorm+Dropout”逻辑,确保深层网络训练稳定。
  2. 前向传播流程:

    • 自注意力子层:输入目标序列y通过自注意力捕捉内部依赖,target_mask屏蔽未来token(如生成第i个词时,仅允许关注1~i个词)。
    • 编码器-解码器注意力子层:使用目标序列作为查询(query),编码器输出作为键值对(key=value),实现“目标序列→源序列”的信息对齐(如翻译时将“我”关联到源文中的“我”)。
    • 前馈网络子层:对注意力输出进行线性变换和ReLU激活,增强模型的非线性拟合能力。
  3. 张量形状变化:
    输入y的形状为[batch_size, tgt_seq_len, embedding_dim],经过三层子处理后形状保持不变,确保多层堆叠时的兼容性。


四、解码器(Decoder):多层堆叠的序列生成优化

解码器由N个相同的解码器层堆叠而成,通过多层迭代处理,逐步优化目标序列的生成质量,最终输出可直接用于预测的特征表示。

4.1 代码实现与结构解析

class Decoder(nn.Module):
    def __init__(self, layer, N):
        super().__init__()
        # 克隆N个解码器层(如N=6,与编码器对称)
        self.layers = clones(layer, N)
        # 最终规范化层(输出前的特征分布调整)
        self.norm = LayerNorm(embedding_dim)

    def forward(self, y, encoder_result, target_mask, source_mask):
        # 依次通过N个解码器层
        for layer in self.layers:
            y = layer(y, encoder_result, target_mask, source_mask)
        # 最终规范化,确保输出特征分布稳定
        return self.norm(y)

4.2 关键细节解析

  1. 多层堆叠逻辑:
    通过clones(layer, N)复制N个解码器层(Transformer原论文中N=6),形成深度生成网络。每层的输出作为下一层的输入,实现“粗→细”的序列特征优化(如从“词级语义”到“句子级连贯性”的提升)。

  2. 掩码的传递与作用:

    • target_mask:贯穿所有解码器层,始终屏蔽目标序列中的未来token和填充token(PAD),确保生成过程的 autoregressive 特性。
    • source_mask:用于屏蔽源序列中的填充token,避免编码器-解码器注意力关注无效信息。
  3. 与编码器的协同:
    编码器输出encoder_result在所有解码器层中被复用,作为key和value提供源序列的上下文信息,而目标序列y则通过query动态查询相关信息,实现“源→目标”的精准对齐。


五、核心设计思想

  1. 双注意力机制的分工:
    自注意力聚焦于目标序列内部的连贯性(如语法正确),编码器-解码器注意力聚焦于跨序列的语义对齐(如语义一致),两者结合确保生成序列“既通顺又准确”。

  2. 掩码机制的必要性:
    在自注意力中,target_mask通过下三角矩阵屏蔽未来token(如下表),强制模型仅依赖已生成信息,这是序列生成任务的核心约束。

    # target_mask示例(3个token的序列)
    [[1, 0, 0],
     [1, 1, 0],
     [1, 1, 1]]
    
  3. 模块化设计的扩展性:
    解码器层的三个子层通过统一的SublayerConnection接口封装,便于替换子层实现(如将自注意力替换为稀疏注意力以提升效率)。


六、解码器测试与验证

通过test_decoder函数验证解码器的功能,观察输入输出的形状一致性和特征变换效果:

def test_decoder():
    # 模拟目标序列输入(2条样本,每条6个token)
    y = torch.tensor([[10, 20, 30, 40, 50, 60], [70, 80, 90, 100, 110, 120]])
    y = untest_input(y)  # 转换为嵌入向量(形状:[2, 6, 512])
    
    # 获取编码器输出(模拟源序列特征)
    encoder_result = test_encoder()  # 形状:[2, 4, 512]
    
    # 初始化注意力和前馈网络
    attention = clones(MutiHeadAttention(8, embedding_dim, dropout), 2)  # 2个多头注意力实例
    feedforward = PositionwiseFeedForward(embedding_dim, d_ff)  # 前馈网络
    
    # 构建解码器
    decoder_layer = DecoderLayer(embedding_dim, attention[0], attention[1], feedforward, dropout)
    decoder = Decoder(decoder_layer, 6)  # 6层解码器
    
    # 初始化掩码(模拟填充和未来信息屏蔽)
    target_mask = torch.zeros(heads, 6, 6)  # 目标序列掩码(6个token)
    source_mask = torch.zeros(heads, 6, 4)  # 源序列掩码(6个目标token→4个源token)
    
    # 解码器前向传播
    decoder_result = decoder(y, encoder_result, target_mask, source_mask)
    
    # 输出验证
    print(f'{"*"*30}解码器输出{"*"*30}')
    print(decoder_result)
    print(f'解码器输出形状:{decoder_result.shape}')  # 预期:[2, 6, 512]
    return decoder_result

if __name__ == '__main__':
    test_decoder()

测试输出说明:

  • 解码器输出形状与输入目标序列一致([2, 6, 512]),确保后续可直接接入线性层预测下一个token。
  • 特征值经过多层处理后发生非线性变换,体现了解码器对序列特征的优化能力。

七、完整代码

from Transformer_encoder import *
from Transformer_moduls import *

# 解码器层类 DecoderLayer 实现
class DecoderLayer(nn.Module):
    def __init__(self, embedding_dim, self_attention, src_attention, feedforward, dropout):
        super().__init__()
        self.embedding_dim = embedding_dim
        self.self_attention = self_attention  # 目标序列自注意力(q=k=v)
        self.src_attention = src_attention    # 编码器-解码器注意力(q≠k=v)
        self.feedforward = feedforward
        self.sublayer = clones(SublayerConnection(embedding_dim, dropout), 3)  # 3个子层连接

    def forward(self, y, encoder_result, target_mask, source_mask):
        m = encoder_result
        # 自注意力子层(带目标掩码)
        y = self.sublayer[0](y, lambda x: self.self_attention(x, x, x, target_mask))
        # 编码器-解码器注意力子层(带源掩码)
        y = self.sublayer[1](y, lambda x: self.src_attention(x, m, m, source_mask))
        # 前馈网络子层
        y = self.sublayer[2](y, self.feedforward)
        return y

# 解码器类 Decoder 实现
class Decoder(nn.Module):
    def __init__(self, layer, N):
        super().__init__()
        self.layers = clones(layer, N)  # 堆叠N个解码器层
        self.norm = LayerNorm(embedding_dim)  # 最终规范化

    def forward(self, y, encoder_result, target_mask, source_mask):
        for layer in self.layers:
            y = layer(y, encoder_result, target_mask, source_mask)
        return self.norm(y)

# 解码器测试函数
def test_decoder():
    y = torch.tensor([[10,20,30,40,50,60],[70,80,90,100,110,120]])
    y = untest_input(y)  # 转换为嵌入向量
    encoder_result = test_encoder()  # 获取编码器输出
    
    # 初始化组件
    attention = clones(MutiHeadAttention(8, embedding_dim, dropout), 2)
    feedforward = PositionwiseFeedForward(embedding_dim, d_ff)
    decoder_layer = DecoderLayer(embedding_dim, attention[0], attention[1], feedforward, dropout)
    decoder = Decoder(decoder_layer, 6)  # 6层解码器
    
    # 掩码设置
    target_mask = torch.zeros(heads, 6, 6)
    source_mask = torch.zeros(heads, 6, 4)
    
    # 前向传播
    decoder_result = decoder(y, encoder_result, target_mask, source_mask)
    print(f'{"*"*30}解码器输出{"*"*30}')
    print(decoder_result)
    print(f'解码器输出形状:{decoder_result.shape}')
    return decoder_result

if __name__ == '__main__':
    test_decoder()

第TR3周:Pytorch复现Transformer Transformer可以看作是seq2seq模型的一种,因此,先从seq2seq的角度对Transformer进行宏观结构的学习。下图1先便是Transformer整体结构图,与seq2seq模型类似,Transformer模型结构中的左半部分为编码器,右半部分为解码器,下面我们来一步步拆解Transformer。在某种程度上,可以将Transformer看作是Seq2Seq的一种演变,Transformer可以执行Seq2Seq任务,并且相对于传统的Seq2Seq模型具有更好的性能和可扩展性。 阅读详情

相关推荐

下水管道损坏检测数据集总结

下水管道损坏检测数据集包含 6708 张图像,为下水管道损坏情况的检测提供了丰富的数据基础。该数据集提供了 YOLO 和 VOC 两种常见的标注方式,方便不同需求的使用者进行模型训练和研究。

crz1336768325的博客 868

Transformer pytorch 代码解读(3)Decoder

目录 0.总览整个Decoder 1.词编码和位置编码 2.各种atten矩阵 3.进入DecoderLayer层 0.总览整个Decoder decoder需要用到的参数是 1.dec_inputs(2,6) 2.enc_inputs(2,5) 3.enc_outputs(2,5,512) decoder也有词编码和位置编码,这里的词编码和位置编码是复用的encoder的所以重点应该是放在decoder层的特有的东西。 1.词编码和位置编码 红色部分执行的...

weixin_45193103的博客 2418

携程登录风控逆向踩坑实录:从滑块到点选验证码,我是如何一步步拿到phantom-token的

本文详细解析了携程登录风控系统的逆向过程,从滑块验证码到点选验证码的破解,再到设备指纹生成和加密协议逆向,最终成功获取phantom-token。文章提供了关键代码示例和实战技巧,帮助开发者理解并绕过复杂的风控机制。

weixin_28049429的博客 970

一文搞懂Transformer-decoder

每个步骤的输出都会在下一个时间步骤中被传递给底层解码器,解码器们会像编码器一样层层传递解码结果,并且,就像我们对编码器输入所做的那样,我们对这些解码器输入进行嵌入和添加位置编码,以指示每个单词的位置。在这里,引入了两个新的token,分别是<|im_start|>和<|im_end|>,此外,解码器一次只能接受一个token作为输入,也就是说,<|im_start|>会被作为一个输入,而"太”就是下一个预测token。根据我们的计算,解码器预测的单词是"太",它的Token是8192和103。

lbr15660656263的博客 4695

BambuStudio学习笔记:GCode 类

关键成员解析 核心配置组件 状态跟踪系统 功能模块集成 核心方法剖析 主输出管道 实现多阶段处理: 分层处理流程: 实现智能路径规划: 关键特性: 实现模板故障检测: 采用三级流水线: 支持扩展类型: 实现多通道输出: 采用: 实现: 支持: 支持模块化编译: 典型流程: 实现功能:

zzzkk2009的专栏 927

slew dreate,slew threshold与transition计算

​只看rise情况下,from pin取slew threshold10%-90%的区间,slew derate为1,计算得到transition为1.002e-10,to pin的slew threshold 为30%-70%,slew derate 0.5,从波形列表上取相近的值3.75e-10和8.75e-10,计算得到transition为(8.75e-10-3.75e-10)/0.5=1e-9,考虑精度和取值区间问题,基本符合工具计算的值,如下:​。如下示例,在.lib库中有定义以下内容。

m0_61544122的博客 793

深入解析 Transformer 解码器:核心模块和代码实现详解

通过实现和逐步分析 Transformer 解码器模块,我们可以看到它是如何结合编码器输出,在生成目标序列时保持语义和上下文一致的。希望本文能帮助你理解解码器的实现过程。后续内容可以深入研究完整的 Transformer 模型搭建,包括编码器与解码器的组合。

weixin_52582573的博客 1887

Open3D (C++) KD tree的使用【2025最新版】

Open3D (C++) KD tree的使用,博客长期更新,本文最近更新时间为:2025年1月6日。

点云侠的博客 1566

【深度学习】(4) Transformer 中的 Decoder 机制,附Pytorch完整代码

大家好,今天和各位分享一下 Transformer 中的 Decoder 部分涉及到的知识点:计算 self-attention 时用到的两种 mask。本文是对前两篇文章的补充,强烈建议大家先看一下:1.《Transformer代码复现》:https://blog.youkuaiyun.com/dgvv4/article/details/1254916932.《Transformer中的Encoder机制》:https://blog.youkuaiyun.com/dgvv4/article/details/125507206本节

博观而约取,厚积而薄发 4925

《民机适航入门指南:从法规学习到项目实践的全面解析》

适航(Airworthiness)是指航空器、其发动机、螺旋桨和其他部件在规定条件下,能够安全飞行并满足有关航空法规规定的条件。简而言之,适航代表了航空器在任何时候都能安全运营的状态。适航在民用航空领域尤为关键,因为飞机必须经过严格的适航认证才能投入商用。这些认证的目标是确保飞机能够在广泛的运行条件下保持飞行安全,从而保护乘客、机组和地面人员的生命财产安全。适航法规覆盖了飞机的整个生命周期,包括设计、制造、测试、运营、维护和报废。

qq_41854911的博客 992

华为OD机试新系统真题 【简单表达式计算】

华为OD机试 新系统真题【简单表达式计算】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题【简单表达式计算】题解

qq_45776114的博客 675

从零开始读懂Transformer:架构解析与PyTorch实现

本文深入解析了Transformer架构及其PyTorch实现,主要内容包括: 背景介绍:Transformer作为现代NLP基础架构,彻底改变了序列建模方式,成为BERT、GPT等大模型的核心 架构总览:详细图解了Transformer的四大组成部分: 输入部分(词嵌入+位置编码) 编码器(多头注意力+前馈网络) 解码器(自注意力+编码器-解码器注意力) 输出部分(线性层+softmax) 关键实现: 词嵌入层将离散token转为连续向量 位置编码通过正弦/余弦函数显式加入顺序信息 提供了PyTorch代

yun_kumo1028的博客 1483

新手也能写复杂爬虫!AI+Python自动分析京东商品,提取数据不用F12

不用F12:AI自动分析京东页面,生成选择器;不用懂JS:Playwright自动渲染动态数据;不用改代码:只需配置3个参数,复制运行就能出结果。这套方案不仅适用于京东,修改提示词后还能爬取淘宝、拼多多、亚马逊等电商网站,新手只需掌握“配置参数→运行代码→查看CSV”3步,就能轻松获取任意网站的结构化数据。未来,AI会让爬虫彻底进入“零代码、零门槛”时代,新手也能轻松搞定复杂数据爬取需求。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1341

大语言模型底层架构丨带你认识Transformer

本文主要介绍Transformer 结构。

华为云官方博客 2688

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Transformer

Positional Encoding位置编码,通常通过为每个位置生成一个唯一的向量,并将这个向量加到对应位置的词嵌入向量上,来实现。Transformer模型中使用的是一种固定的、基于正弦和余弦函数的编码方案,该方案允许模型捕获单词间的相对和绝对位置关系。每个编码器层由两个子层连接结构组成。第一个子层连接结构包括一个。和规范化层以及一个残差连接。第二个子层连接结构包括一个。和规范化层以及一个残差连接。和规范化层以及一个残差连接。和规范化层以及一个残差连接。和规范化层以及一个残差连接。

mvnmvn的专栏 338

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

PyTorch从零开始实现Transformer

使用Pytorch实现Attention is all you need

阿正的梦工坊 4万+

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

【Transformer系列(5)】Transformer代码超详细解读(Pytorch)

手把手教你用pytorch代码实现transformer模型

路人贾的博客 1万+

Transformer架构:输入部分代码实现(基于PyTorch)

Transformer输入部分将离散文本转换为连续向量,包含两大核心组件:词嵌入(Embedding)将词索引映射为512维向量并进行缩放处理,使语义相似的词向量距离更近;位置编码(Positional Encoding)通过正弦余弦函数为每个位置生成独特编码,叠加在词向量上以保留序列顺序信息。代码实现展示了PyTorch中Embedding层和自定义位置编码类的使用,包括矩阵生成、缩放操作和Dropout应用。最终输出为融合语义和位置信息的张量,形状为[batch_size, seq_len, embed

Springfield3006的博客 1192

Transformer架构:输出部分代码实现(基于PyTorch)

本文介绍了Transformer架构中输出部分(Generator)的实现与作用。Generator通过线性层将解码器输出的高维特征映射到词表维度,再使用log_softmax归一化,生成每个位置的概率分布。其核心功能包括特征映射、概率归一化和生成决策支持。文章详细解析了Generator类的代码实现,展示了张量形状变化,并说明其与NLLLoss损失函数的配合方式。此外,还介绍了推理阶段的贪婪搜索预测逻辑,以及输出部分极简主义的设计思想。输出部分作为连接模型与任务目标的最后一环,对Transformer的整

Springfield3006的博客 1038

Transformer架构:整体实现代码(基于PyTorch)

Transformer架构解析 Transformer是一种基于自注意力机制的序列转换模型,采用编码器-解码器结构实现端到端序列建模。其核心优势在于并行计算能力、长距离依赖捕捉和跨模态对齐。模型由六大组件构成:输入处理模块(词嵌入+位置编码)、编码器(处理源序列)、解码器(生成目标序列)、多头注意力机制、前馈网络和输出层。工作流程包括源序列向量化、编码器特征提取、解码器序列生成和词汇概率输出。通过多头自注意力和位置编码等机制,Transformer有效解决了传统RNN模型在长序列处理上的局限性,广泛应用于机

Springfield3006的博客 1559

Transformer(三)--论文实现:transformer pytorch 代码实现

文章目录1. transformer的基本结构2. 模块详解2.1 模块1:Positional Embedding2.2 模块2:Multi-Head Attention2.2.1 Scaled Dot-Product Attention2.2.2 Multi-Head2.3 模块3:ADD2.4 模块4:Layer Normalization2.5 模块5:Feed Forward NetWork2.6 模块6:Masked Multi-Head Attention2.7 模块7: Multi-Head

8177

仅仅使用pytorch来手撕transformer架构(4):解码器和解码器模块类的实现和向前传播

仅仅使用pytorch来手撕transformer架构(1):位置编码的类的实现和向前传播最适合小白入门的Transformer介绍仅仅使用pytorch来手撕transformer架构(2):多头注意力MultiHeadAttention类的实现和向前传播仅仅使用pytorch来手撕transformer架构(3):编码器模块和编码器类的实现和向前传播 话不多说,直接上代码 一. 的结构 1. 的结构 Transformer 解码器中的一个基本模块——。每个 包含两个主要部分:掩码多头自注意力(Ma

2302_80236633的博客 1227

Transformer编码器的理解与PyTorch实现

Transformer编码器的理解与Pytorch实现Transformer的整体结构 Transformer的整体结构 论文:Attention is All You Need Transformer模型是2017年Google公司在论文《Attention is All You Need》中提出的。自提出伊始,该模型便在NLP和CV界大杀四方,多次达到SOTA效果。2018年,Google公司再次发布论文《Pre-training of Deep Bidirectional Transformers f

一直特立独行的猫 7905

Transformer架构:编码器部分代码实现(基于PyTorch)

本文详细解析了Transformer架构中编码器(Encoder)的核心作用与实现细节。编码器通过多层堆叠的编码器层(EncoderLayer)实现特征提取,每个编码器层包含自注意力子层和前馈网络子层,采用残差连接和规范化确保训练稳定性。文章提供了基于PyTorch的代码实现,分析了编码器层的模块化设计(多头注意力、前馈网络)和整体编码器的多层堆叠逻辑。关键设计思想包括:模块化堆叠实现深度特征提取、自注意力机制捕获长距离依赖,以及与输入模块的衔接方式。完整代码展示了编码器层和整体编码器的实现,为理解Tran

Springfield3006的博客 1211

Transformer 详解(下) — 解码器【附pytorch代码实现】

Transformer 详解(下)解码器文本嵌入层位置编码层多头自注意力机制多头注意力机制规范化层前馈全连接层输出层代码实现Transformer 论文: Attention is All You Need 在上一篇博客,笔者简述了编码器部分的理论并用pytorch实现了编码器部分的代码。 此篇博客便是承接上文,继续讲述Transformer模型中解码器的代码实现。 其实编码器和解码器模型的部分层都是相同的,例如规范化层,多头注意力机制,前馈全连接层等。 只是解码器比编码器子层连接结构中多了一个多头自注意力

南风无休的博客 9434

transformer的一些理解以及逐层架构剖析与pytorch代码实现

文章目录前言一、transformer的架构二、transformer需要用到的三级部件1.词嵌入层(Embedding)2.位置编码器(PositionalEncoding)3.掩码张量生成器(subsequent_mask)4.注意力机制层(Attention)5.多头注意力机制层(MultiHeadedAttention)6.前馈全连接层(PositionwiseFeedForward)7.规范化层(LayerNorm)8.子层连接结构(SublayerConnection)三、transforme.

学习笔记 3870
上一篇: 人工智能概念:常用的模型压缩技术(剪枝、量化、知识蒸馏)
下一篇: 人工智能概念之十:人工神经网络(ANN)
.30-06Springfield
博客等级 码龄7年 321粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值