LazyLLM 黑科技 | 一个模型名搞定一切:LazyLLM 如何自动识别模型类型?

论文翻译 | LazyLLM: DYNAMIC TOKEN PRUNING FOR EFFICIENT LONG CONTEXT LLM INFERENCE 基于transformer的大型语言模型的推理包括两个顺序阶段:1)预填充阶段,用于计算提示的KV缓存并生成第一个令牌;2)解码阶段,用于生成后续令牌。对于长提示,在预填充阶段必须计算所有令牌的KV缓存,这可能会显著增加生成第一个令牌所需的时间。因此,预填充阶段可能成为生成过程中的瓶颈。一个悬而未决的问题是,是否所有提示令牌对于生成第一个令牌都是必要的。为了回答这个问题,我们引入了一种新颖的方法——LazyLLM,它在预填充和解码阶段选择性地为对下一个令牌预测重要的令牌计算KV。 阅读详情

本文将深入探讨在多模型工程落地中,一个看似不起眼却极度影响开发体验的问题——模型入口的统一与类型识别,并详细解析 LazyLLM 是如何通过优雅的机制解决它的。

1. 背景与问题:模型入口为何"四分五裂"?

在多模型工程里,最先让人头疼的,往往不是模型效果,而是入口不统一。

明明业务逻辑都是“用一个模型处理数据”,但在写代码前,开发者却被迫要先做一堆“选择题”:

  • 这是在线 API,还是本地部署部署的模型?
  • 这是文本对话(Chat),还是向量化(Embedding),抑或是语音生成(TTS)、多模态(VLM)?
  • 不同的能力,对应着不同的类名、不同的参数列表。

更现实的痛点在于工程演进:同一个模型,研发初期为了快,往往在线调用(API);到了生产期为了成本和安全,可能得切成本地私有化部署。 模型没变,业务逻辑没变,但因为底层入口不同,却不得不大改业务代码:改引用的类名、调参数配置、甚至重构调用链。

当模型入口不统一时,这些推断逻辑就会被迫“前置”到业务代码里。这就导致:

  1. 代码冗长且脆弱:业务代码里充斥着 if isinstance(model, XX) 或根据模型名字硬编码的分支。
  2. 切换成本极高:牵一发而动全身,换个模型供应商,业务层跟着抖动。
  3. 系统心智负担重:随着模型种类(图、文、音)和数量激增,入口层越复杂,系统越难维护。

2. 业界难点:为何统一入口这么难?

为什么大家不早点把入口统一呢?因为要做好这一层抽象,面临着天然的阻力:

  1. 形态的割裂:在线模型本质是网络请求(HTTP/RPC),本地模型本质是权重加载+推理框架(vLLM/TensorRT-LLM)。两者的生命周期、资源管理、并发模型完全不同,强行揉在一起容易出现“抽象泄漏”。
  2. 模态的碎片化:大语言模型(LLM)输入输出是文本;VLM 包含图像;TTS 输入文本输出音频流。不同模态的输入校验、后处理格式千差万别,用一个基类去 cover 所有,很容易变成一个臃肿的“上帝类”。
  3. 命名规则的无序:开源社区(如 HuggingFace、ModelScope)的模型命名天马行空,没有强约束的标准。如何仅凭一段字符串,就精准猜出它是个什么模态的模型?

3. LazyLLM 的解决方案:两层自动推断,化繁为简

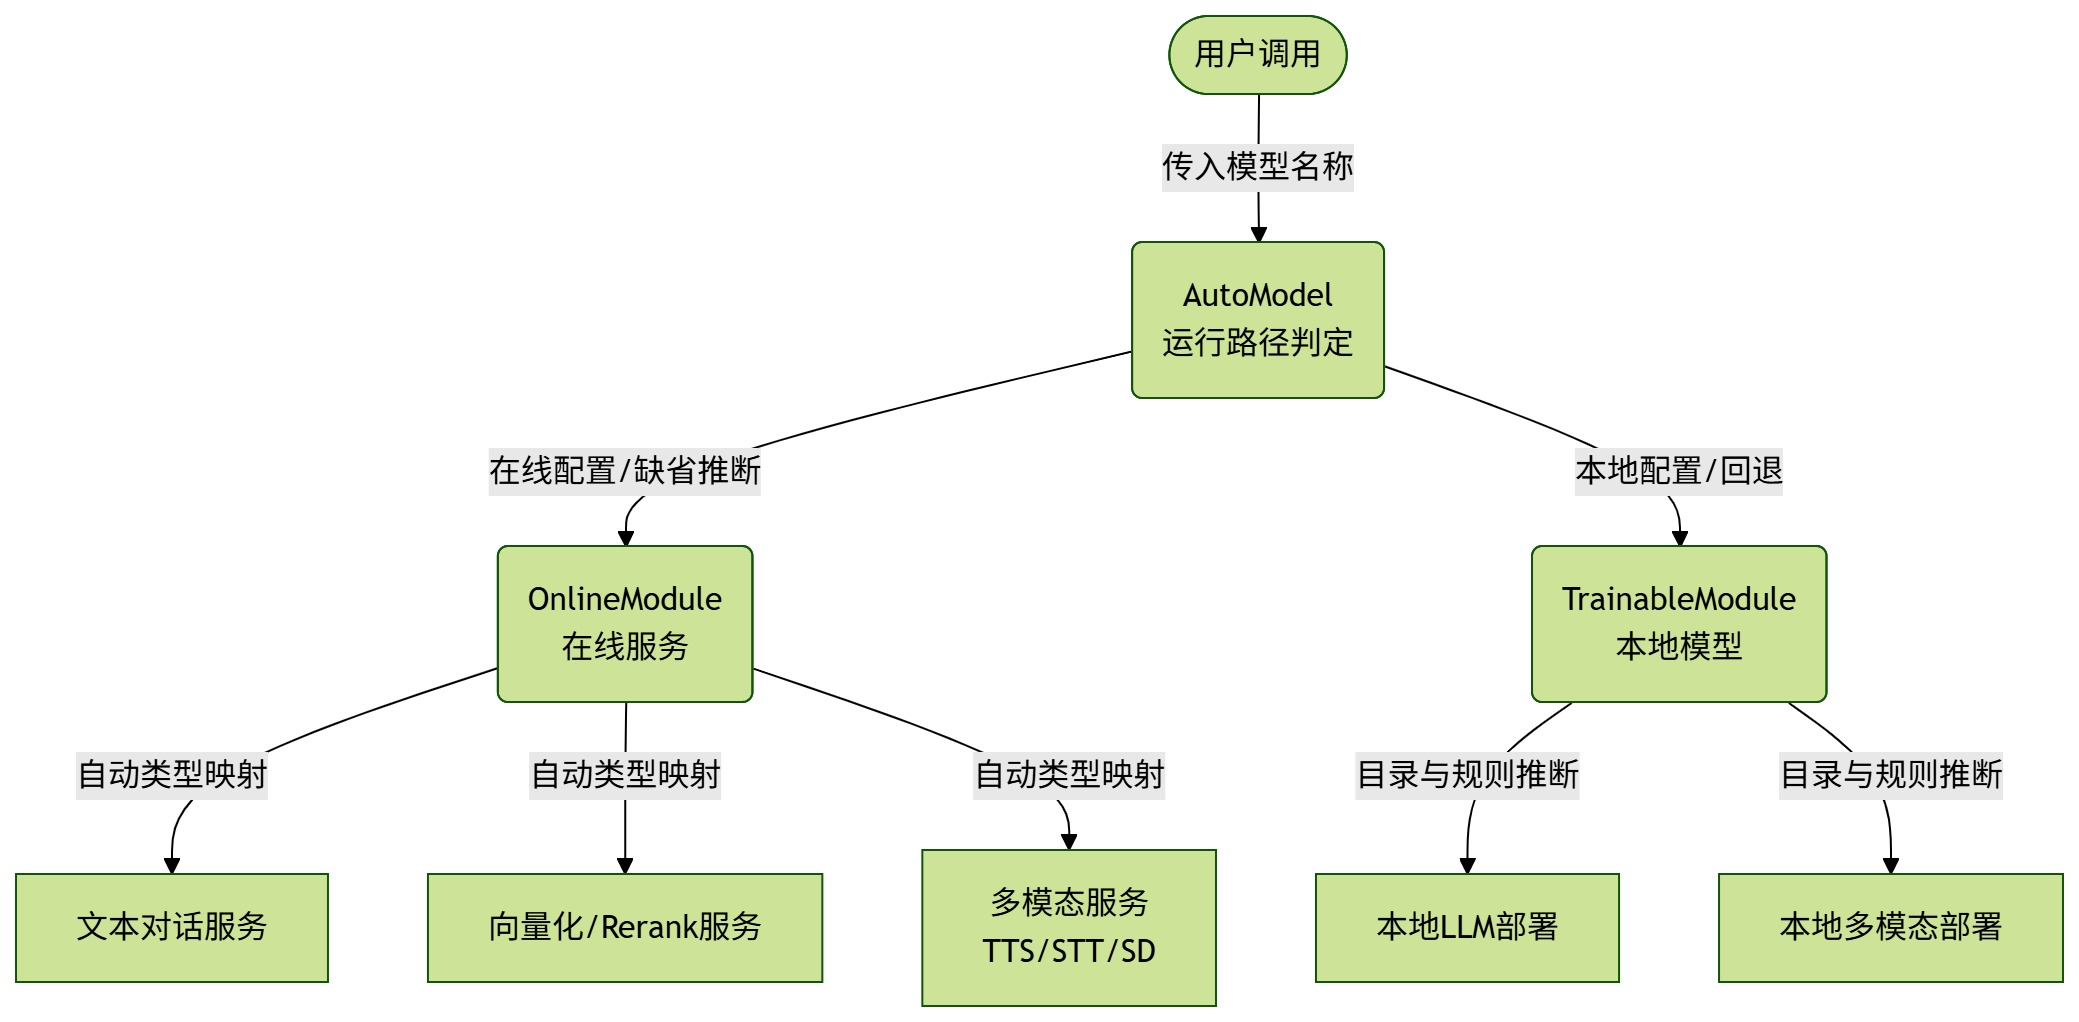
面对上述难题,LazyLLM 的解法是:在模型入口层引入“两层自动推断机制”,将运行方式、能力类型和模型类别的判断全部收敛截留在框架内部。

对用户来说,核心理念只有一句话:你只管给模型名字,其余(本地还是在线?什么模态?怎么跑)全交给框架。

架构设计上,我们将核心入口收敛为 AutoModel,并派生出两条路径:
4. 极致的用户体验:自动推断下的代码示例

在这个设计下,开发者的使用变得极其简单,几乎是真正的“零切换成本”。

示例 1:纯无感调用 你只需传入模型名,它是 API 还是本地,是 LLM 还是 TTS,框架自己懂。

import lazyllm

# 框架推断:这是一个在线大语言模型
model = lazyllm.AutoModel(model="gpt-4o")
print(model("Summarize this paper."))

# 框架推断:这是一个在线文本转语音多模态模型
tts = lazyllm.AutoModel(model="qwen3-tts-flash")
audio_output = tts("你好,世界") 

# 框架推断:这是一个向量化模型
embed = lazyllm.AutoModel(model="nova-embedding-stable")
vector = embed("这是一段文本")


示例 2:在线与本地的无缝切换 如果有一天,你想把 GPT-4o 换成自己本地部署的开源模型。

# 昨天:调用在线的 Qwen 
chat = lazyllm.AutoModel(model="qwen-plus") 

# 今天:老板说要私有化,换成本地部署的 Qwen 权重
# 只要改名字(如果本地配置了映射),或者显式声明来源
chat = lazyllm.AutoModel(model="qwen2.5-7b-instruct", source="local")

# 业务调用代码完全不变!
chat("hello")


5. 技术剖析:我们是如何做到的?

底层看似神奇的“魔法”,源于我们精心设计的匹配规则与责任链模式。让我们结合 LazyLLM 的源码来看看。

5.1 第一层:AutoModel 运行路径判定 (环境与配置感知)

AutoModel 的首要任务是决定走 TrainableModule(本地)还是 OnlineModule(在线)。 在 lazyllm/module/llms/automodel.py 中,我们的判断并不是粗暴的 if-else,而是一套基于配置和环境感知的优先级推断:
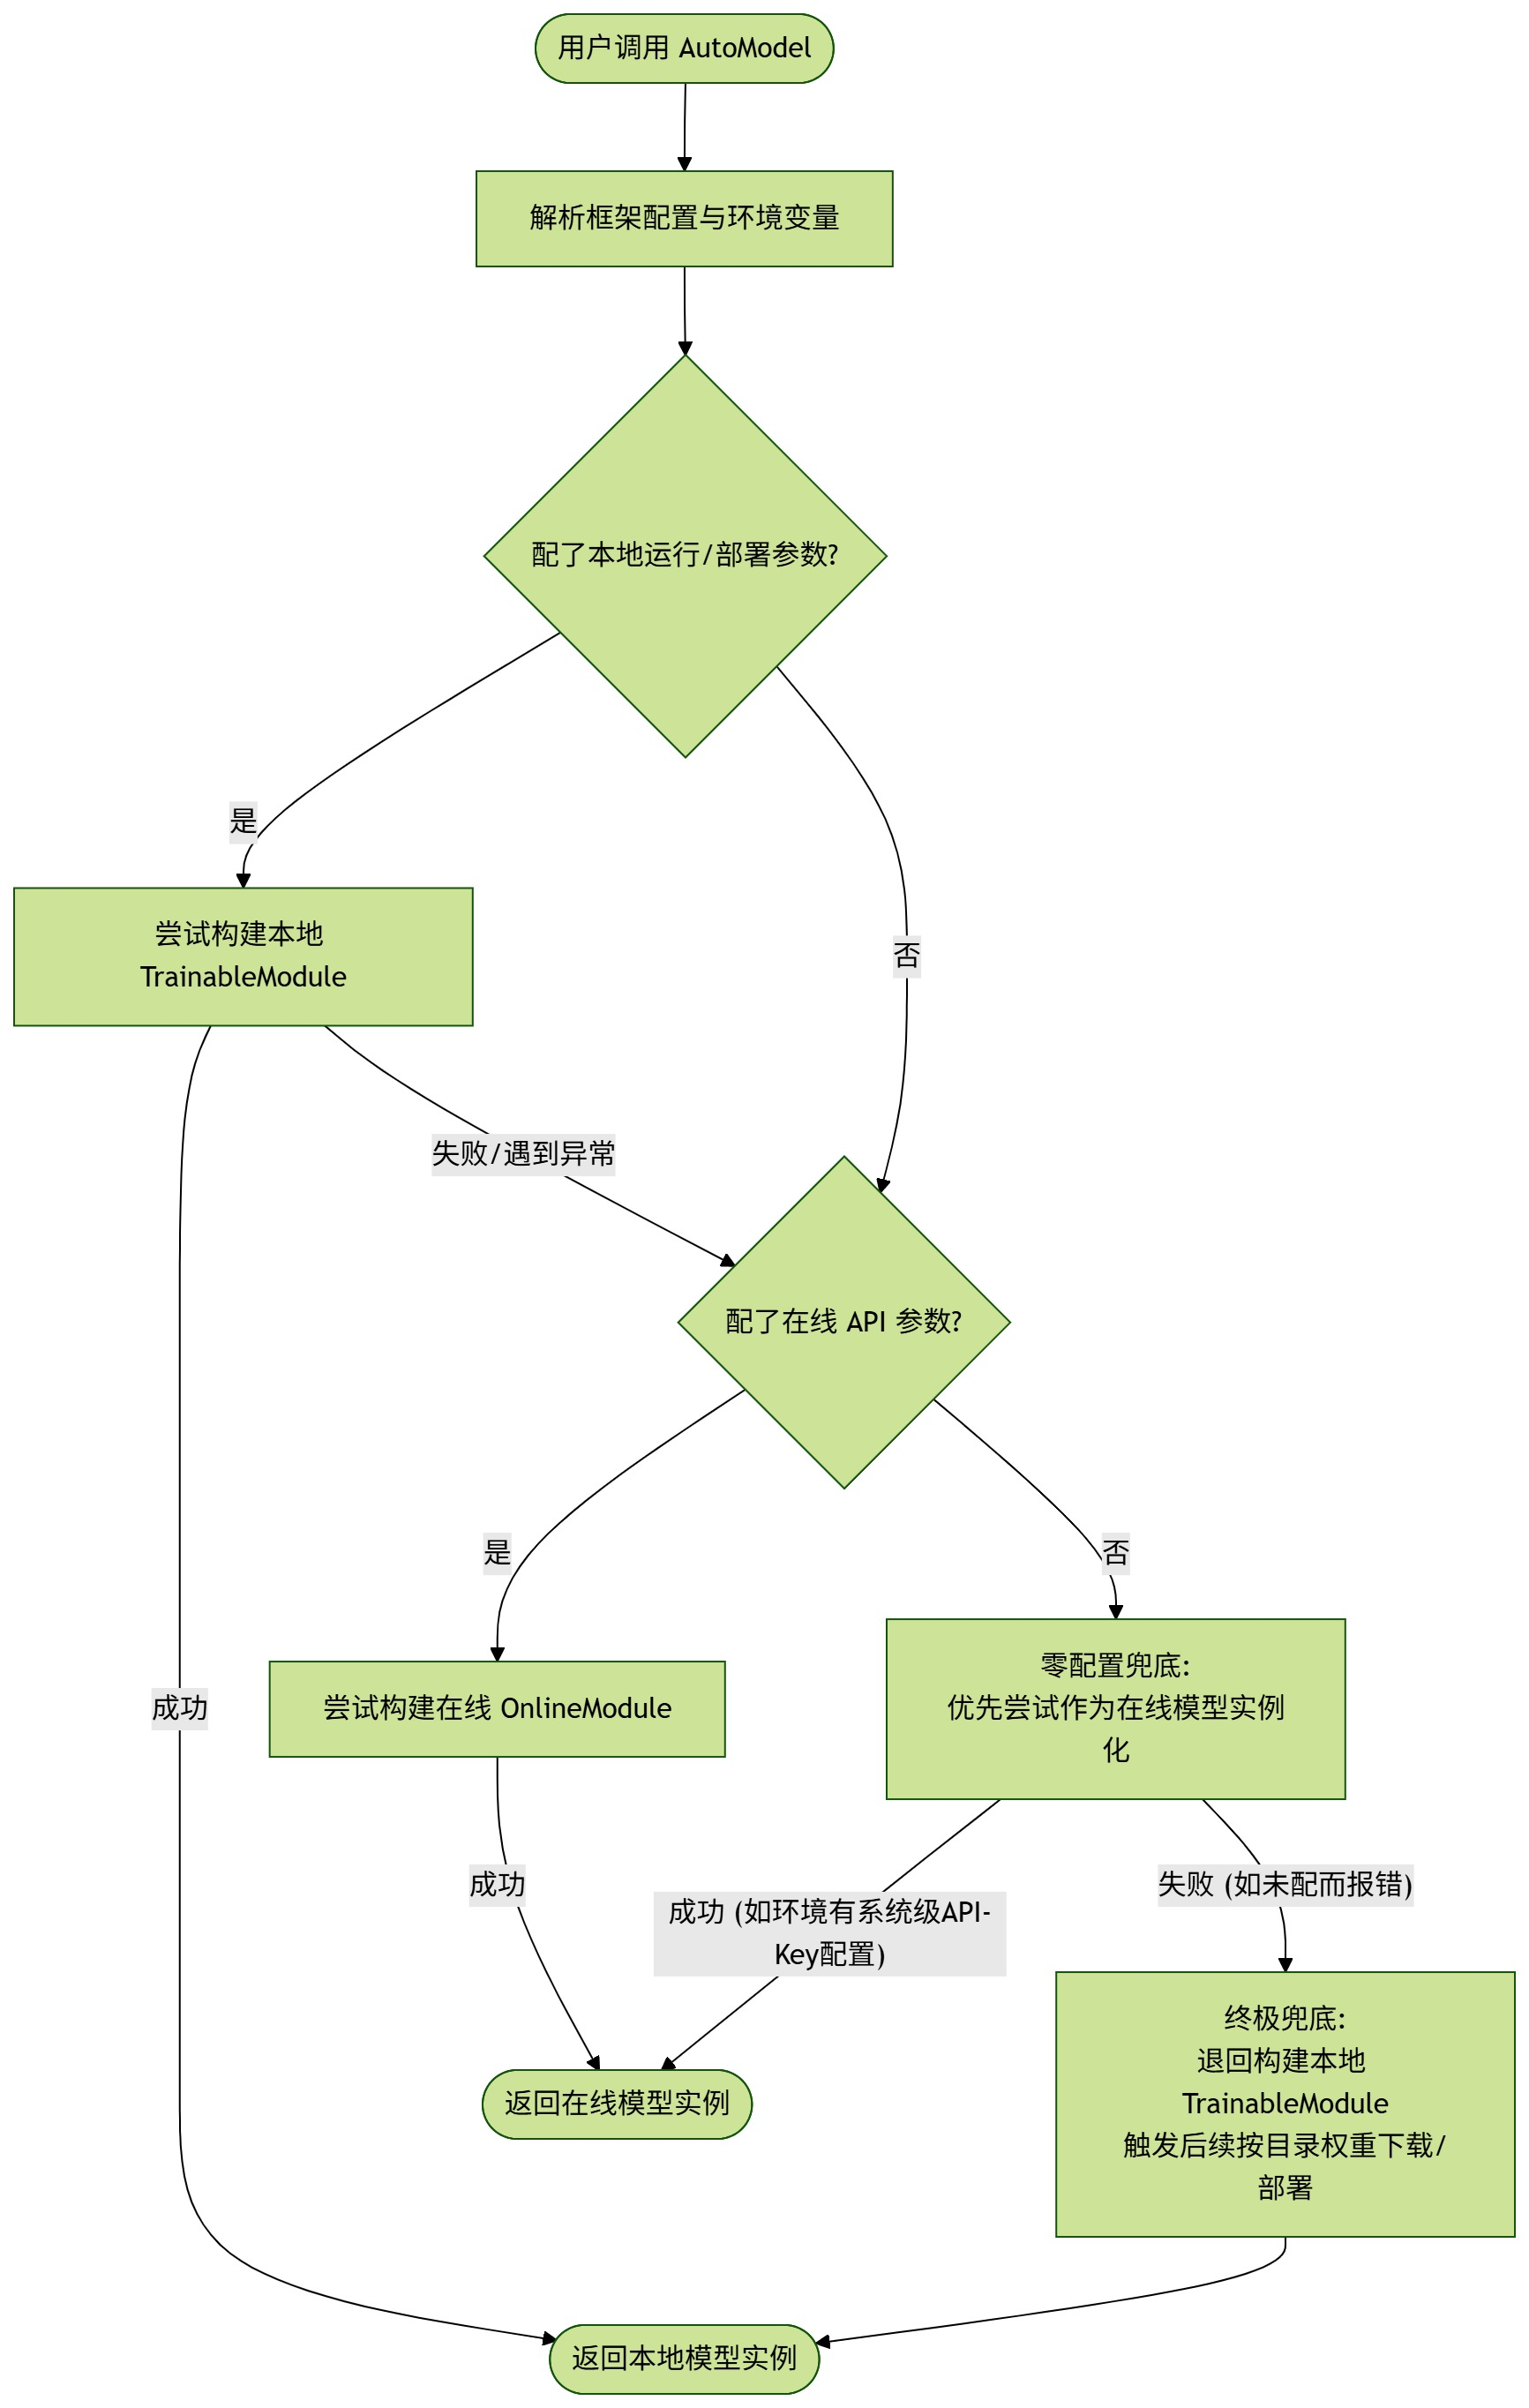
  1. 配置优先尝试本地:去检查环境里有没有该模型的本地运行部署配置(framework、deploy_config 等),如果有,尝试构建 TrainableModule。
  2. 在线配置兜底:如果在本地配置没找到或者失败了,尝试去匹配在线的 API 配置,构建 OnlineModule。
  3. 无配置回退:如果用户啥都没配,我们优先尝试作为在线模型去实例化(因为成本最低),如果报错(比如没配 Token),则最终回退到本地模型进行自动下载和部署。

这种设计确保了开发者配置的明确意图最高,同时在零配置下具备较强的容错生存能力。

5.2 第二层左路:OnlineModule 的在线能力映射

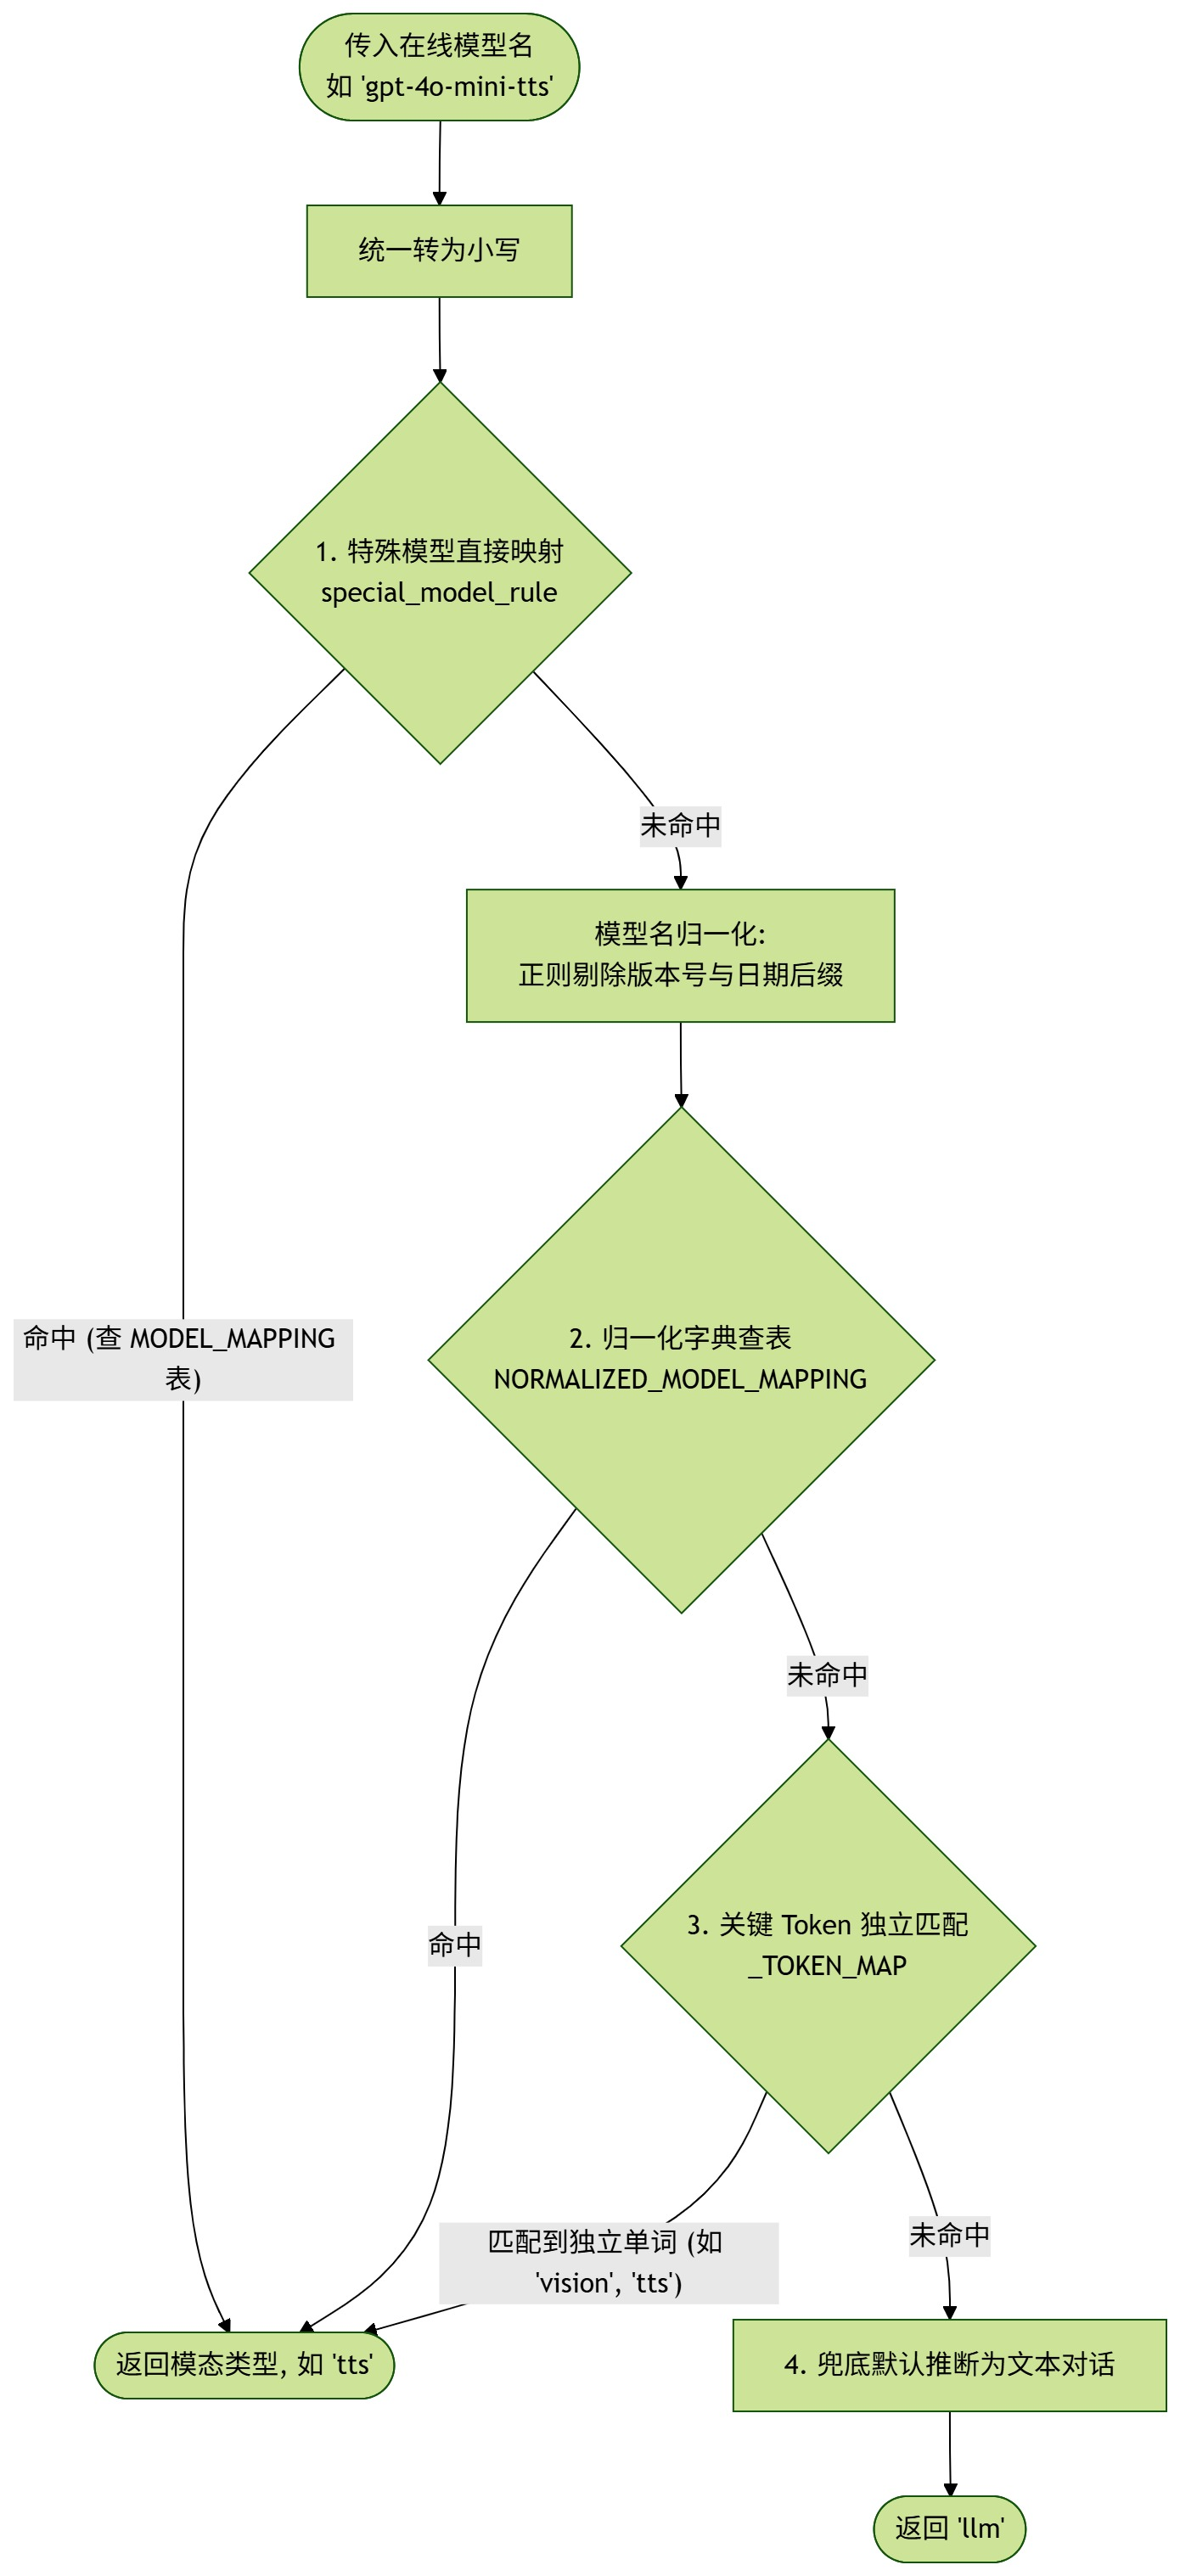
判定为在线模型后,进入 OnlineModule (lazyllm/module/llms/online_module.py)。它需要知道怎么组装 HTTP 请求,这就需要知道模型到底是什么类型(Type)。

如果用户没指明 type,引擎会调用 get_model_type(model)。在 map_model_type.py 中,我们维护了一个精密的映射与降级机制:
源码亮点:

为了应对厂商频繁发版(比如加时间戳),我们做了归一化处理 (_normalize_key),利用正则 (?:|[-_.]\d{4}(?:-\d{2}-\d{2})?|[-_.]v?\d+[a-z0-9\-]*)+$ 自动剥离模型名后缀的版本号和日期,大幅提高了基于关键词(如 vision, asr, tts)的命中率。

5.3 第二层右路:TrainableModule 的本地模型类型推测

如果是本地模型(需要下载、加载权重),它的推断在 lazyllm/components/utils/downloader/model_directory.py 中的 infer_model_type 函数完成。

由于开源社区模型浩如烟海,我们设计了严格的三级分层嗅探规则:
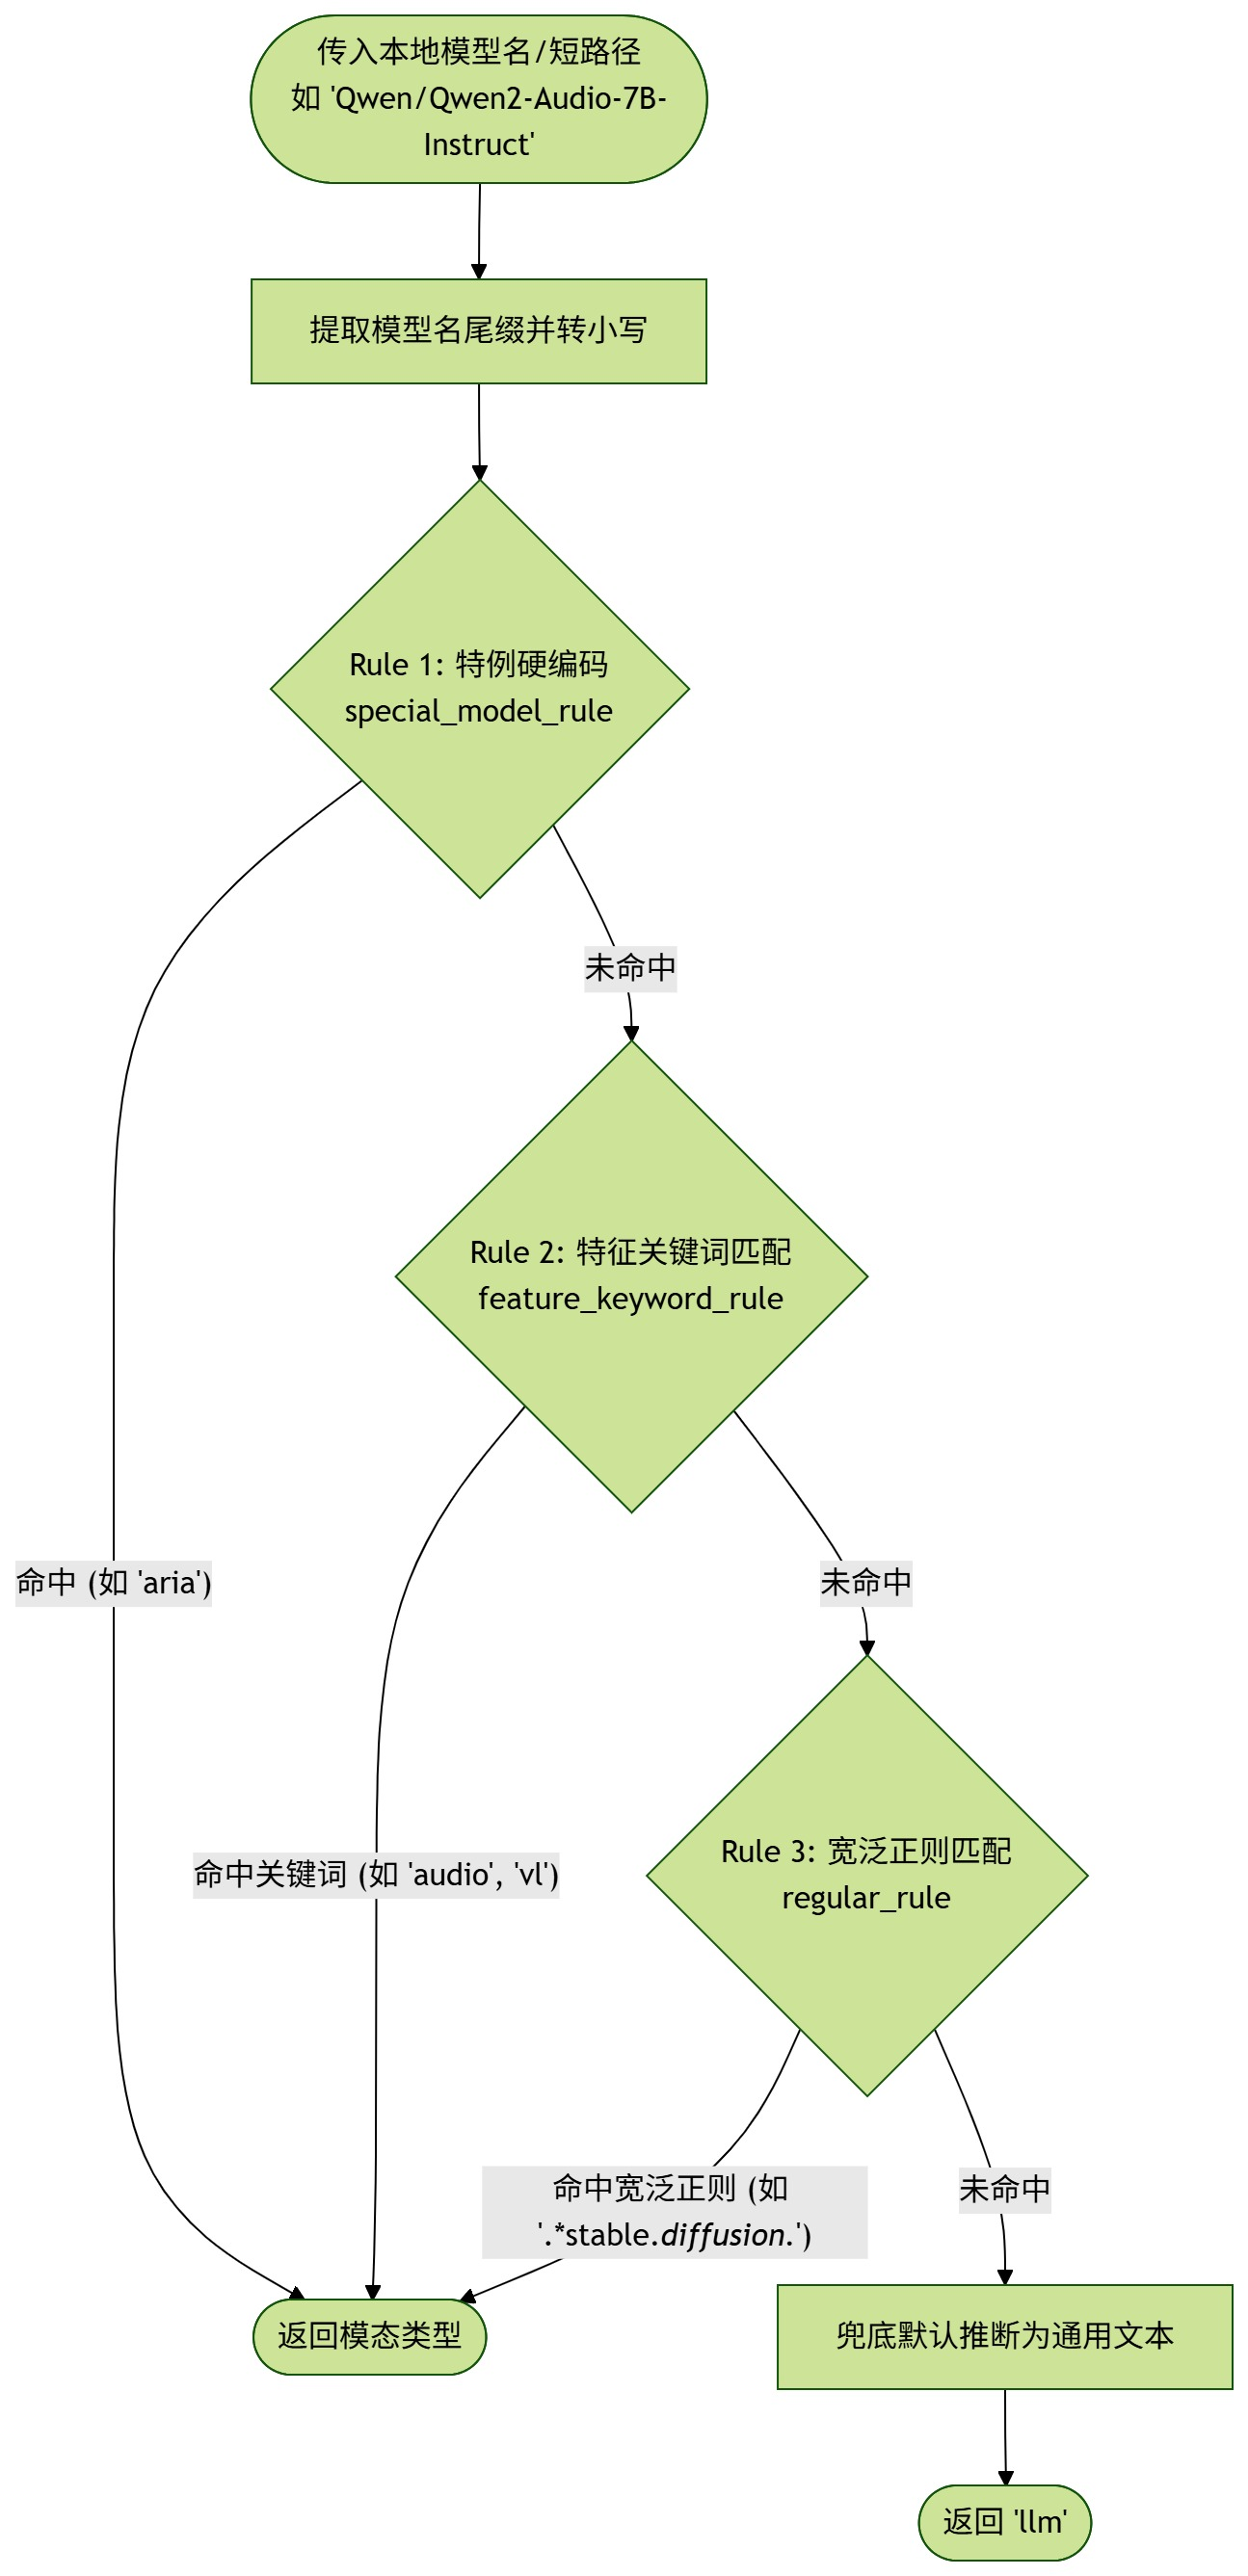
  1. Rule 1 - special_model_rule (特例硬编码):有一些模型名字非常个性,不包含任何模态特征(如 minicpm-2b-dpo-bf16, aria)。我们用硬编码集合优先拦截。
  2. Rule 2 -feature_keyword_rule (特征关键词匹配):通过检索模型名切片后的关键字。比如包含 vl, pixtral, cogagent 归类为 VLM(视觉语言),包含 music 归类为 TTS。 (细节:我们会按关键词长度降序排序再匹配,防止大词被小词截胡)
  3. Rule 3 - regular_rule (宽泛正则匹配):使用正则表达式兜底。例如 r'.*stable.*diffusion.*' 识别 SD 模型,r'.*clip.*' 识别跨模态嵌入模型。
# 摘自 lazyllm/components/utils/downloader/model_directory.py
def infer_model_type(model_name: str) -> str:
    # 责任链模式,依次尝试三种规则
    for rule in [special_model_rule, feature_keyword_rule, regular_rule]:
        try:
            result = rule(model_name)
            if result is not None:
                LOG.info(f'Model: {model_name} classified as type: {result} by rule: {rule.__name__}')
                return result
        except Exception as e:
            continue
    # 终极兜底
    LOG.warning(f'Cannot classify model type for: {model_name}. Defaulting to "llm" instead.')
    return 'llm'


拿到准确的 Type 后,后续的权重下载分发、TrainableModule 对本地推理引擎(如 vLLM 对 LLM,或特定 Pipeline 对多模态)的选择,也就水到渠成了。

结语

简单的一句 lazyllm.AutoModel("model_name") 背后,包含了 LazyLLM 对多模型生态乱象的深入思考与抽象。 通过环境感知、精确映射、正则嗅探与责任链机制,我们替开发者扛下了所有恶心的脏活累活。这就让 LazyLLM 的应用具有了极强的重构能力与生命力。

把复杂留给框架,把简单还给业务,这就是 LazyLLM 构建 AI 应用的哲学。

欢迎升级体验 LazyLLM 最新版本,请大家去 github 上点一个免费的 star,支持一下~

LazyLLM 项目仓库链接🔗:

https://github.com/LazyAGI/LazyLLM

https://github.com/LazyAGI/LazyLLM/releases/tag/v0.7.1

LazyLLM:长上下文场景下提高LLM推理效率 文章提出了LazyLLM技术,这是一种针对长上下文场景下提高大型语言模型(LLM)推理效率的方法,它通过动态选择性计算关键token来加速预填充阶段,同时保持推理性能,无需额外的模型微调。并且,LazyLLM可以无缝集成到现有的基于Transformer的LLM中,提高推理速度。 阅读详情

相关推荐

当知识图谱遇见多模态:突破文本界限的智能认知革命

本文探讨了知识图谱与多模态技术的融合,揭示了其在医疗诊断、文化保护等领域的革命性应用。通过图神经网络、对比学习框架和跨模态注意力机制等技术,实现了文本、图像和音频数据的智能关联与认知。文章还分享了在Neo4j等图数据库中的实践案例和优化策略,为构建下一代智能认知系统提供了技术参考。

weixin_29197835的博客 461

简化大模型工具LazyLLM

LazyLLM 是一个专注于简化大模型(如 GPT、LLaMA 等)应用开发的工具或框架,其核心理念是通过自动化或半自动化的方式降低大模型的使用门槛,提升开发效率。它可能涉及模型部署、推理优化、API封装等功能,适合快速构建基于大模型的应用程序。

find_element_by_id的博客 954

【AMD显卡在WIndow10/11部署带GPU支持的深度学习环境(Pytorch-DirectML篇)】

这篇是之前Tensorflow-DirectML的姊妹篇,如果对TF感兴趣的可以搜索我的博文。 首先我们丢一个官网地址,但是官网那个会误导新人如果你按那个操作的话。 https://docs.microsoft.com/en-us/windows/ai/directml/gpu-pytorch-windows 这里用我的方法操作: 首先声明一下,因为我的显卡是AMD RX6600,不带XT(性能和RTX3060 12G版本半斤八两),所以目前没有最新的WSL2驱动,如果有了的话欢迎告知我,所以我这里就.

weixin_44029053的博客 2万+

LazyLLM测评 | 基于LazyLLM Agent大模型搭建聊天机器人

LazyLLM是一款低代码多Agent大模型应用框架,通过模块化设计和数据流驱动范式简化AI开发流程。其三层架构(基础层/控制层/应用层)支持主流模型接入、任务灵活编排和预置组件调用,具备动态Token剪枝、多Agent协同等核心技术。实测显示,仅需3行代码即可搭建Web聊天机器人,进阶功能如代码注释Agent可自动生成规范文档,大幅提升开发效率。相比传统框架,LazyLLM显著降低了多模型协同与部署复杂度,为大模型落地提供高效解决方案。

Nicky's blog 1347

ARM CMSIS DAP源码分析(二)

今天分析的是RDDI_DAP_GetARMRegs(DWORD *regs, DWORD *rfpu, ULONG64 mask)和RDDI_DAP_SetARMRegs(DWORD *regs, DWORD *rfpu, ULONG64 mask)这两个函数。 以RDDI_DAP_GetARMRegs(DWORD *regs, DWORD *rfpu, ULONG64 mask)为例,代码如下:

pengxiao618的专栏 7976

机器学习的学习准则(期望风险最小化、经验风险最小化、结构风险最小化)

要评价模型f(x, θ)的好坏,可通过期望风险R(θ)来衡量:求期望损失R(θ)不仅需要知道损失函数还需要知道真实分布,损失函数可以通过一定的准则计算得到,但是样本空间的真实分布是未知的。所以不能直接求R(θ)。期望风险R(θ)无法计算,给定一个训练集D =,我们可以计算经验风险,经验风险就是在训练集上的平均损失:为了解决过拟合问题,引入了参数正则化来限制模型的能力。使其不要过度的最小化经验风险。这种准则就是结构风险最小化准则

... 2222

万字干货分享最新AI指南:用LazyLLM把Deep Research做成赛博屠龙刀!

Deep Research是OpenAI在2025.2月发布的一种新型的代理(Agent)能力,其被集成在ChatGPT中,能够通过大模型的推理能力和工具调用能力,自主从网络检索、整合信息,同时支持读取用户提供的文件,并通过编写和执行 Python 代码来分析数据,通过深度分析数据,对用户的问题进行深度解答,最终输出专业的长篇报告。

SenseCore的博客 1568

【转录调控网络】代谢组学与其他组学的联合分析经典模式简介

多组学联合分析经典模式转录组学&代谢组学联合分析 转录组学&代谢组学联合分析 转录组是获得生物体内基因表达的重要方法,代谢组是生物体表型的基础和直接体现者。 转录组测序可以得到大量差异表达基因和调控代谢通路,但由于基因与表型之间很难之间关联,导致关键的信号通路难以确定,因此往往达不到预期的研究目的。代谢产物是生物体在内外调控下基因转录的最终结果,是生物体表型的物质基础。 在系统生物学研究时代,生物过程复杂多变,基因调控网络复杂。针对特定的生理、病理等表型进行研究,利用转录组的数据获得大量差异

小哲的博客 6192

LazyLLM 第一讲:一文搞定 10 分钟拿下 Agent 快速部署

10 分钟部署 Agent,看到最后有福利

优快云高校俱乐部官方博客 3119

Windows 11 安装 JDK 11:下载、安装、配置环境变量、验证

本文详细介绍了在 Windows 11 系统中安装 JDK 11 的完整流程,包括从 Oracle 官网下载压缩包、解压到自定义目录、配置 JAVA_HOME 与 Path 环境变量,并验证安装是否成功。文章还包含一个专为 JDK 11 新特性设计的测试程序,涵盖 Lambda 表达式 var 语法、HTTP 客户端 API、字符串增强方法等,帮助读者确认安装版本正确无误,适合初学者和需要多版本 JDK 共存的开发者参考。

寒水馨 · 轻量级技术文档 · hanshuixin.org 2776

银河麒麟硬盘健康检测:smartctl/badblocks实战与坏盘预判

xfs_repair检查。S.M.A.R.T检测。

信创运维工程师 · 银河麒麟 & 容器实战 | 金融生产环境迁移·等保加固 | 142篇原创·17万+阅读 859

基于LazyLLM多Agent大模型应用的开发框架,搭建本地大模型AI工具,你贴身的写作、论文小助手

在搭建本地大模型作为写作、论文小助手时,开发者常面临诸多技术难题:模型部署需研究复杂 API 服务,微调模型要应对框架选择与模型切换的困扰,工具落地还需掌握 Web 开发技能,这让初级开发者望而却步,资深专家也需为适配需求、集成新工具耗费大量精力。而 LazyLLM 多 Agent 大模型应用开发框架可有效解决这些问题,它打包了应用搭建、数据准备、模型部署、微调、评测等全环节工具。初级开发者借助预置组件即可打造有生产价值的 AI 工具,资深专家能依托其模块化设计集成自有算法与前沿工具……

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 59万+

ENVI_基于无人机数据的果树提取与相对健康监测

一、数据处理 1.计算植被指数VDVI或GDVI:Band Math / Spectral Indices 2.制作掩膜:ROI——Threshold——Subset 二、单地块果树提取 1.绘制感兴趣区shp 2.确定果树提取参数:Count Crops 3.输出果树矢量文件:Convert Crops To Shapefile 4.果树相对健康程度分析:Calculate Crop Me...

提供技术服务、资源分享 429690771 1398

拆解 LazyLLM:10 个你可能忽略的工程黑科技

如果你一路看到这里,说明你大概率已经在真实工程里和大模型打过交道了。后续文章里,我们会继续拆解更底层的东西:为什么要这样设计、当时有哪些取舍、哪些地方其实还在不断演进。如果你对这些工程细节感兴趣,欢迎持续关注。Lazy 的黑科技,等你来一起揭秘~欢迎升级体验 LazyLLM最新版本,请大家去github上点一个免费的star,支持一下~

SenseCore的博客 709

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

【LazyLLM × MinerU】你的私人学术特工已上线!PDF拆解黑科技来了,让RAG更懂你的文章!

以上就是基于LazyLLM融合MinerU实现PDF解析与RAG的应用与进阶,让PDF解析从 “机械拆分” 迈向 “智能重构”,更多高级玩法有待探索。(以上代码请参考项目 👉https://github.com/jisyST/LazyRAG-Mineru#)更多信息请移步“LazyLLM”gzh!

SenseCore的博客 1190

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

告别 Excel 熬夜:LazyLLM 框架教你轻松构建自动化财报分析 Agent

财务报告分析是企业运营管理、投资决策制定及风险评估的核心环节。然而,传统财务分析流程普遍存在效率瓶颈:分析师需要从PDF年报、Excel表格等多样化数据源中手动提取、清洗和整合数据,这个过程既耗时又容易出错。

鸽芷咕的博客 2万+

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

我用LazyLLM做了一个打工人述职Agent,朋友直呼打工人的福利,太完美了

《AI助手一键生成打工人述职报告》摘要:本文介绍如何利用LazyLLM框架构建;打工人述职Agent;,实现自动将OKR及工作内容转化为规范的周报/季报。该方案通过两个核心提示词:大纲生成器(toc_prompt)自动区分周报/季报格式,内容生成器(completion_prompt)确保专业量化表达,最终拼接成完整报告。测试显示生成效果良好,朋友试用后可直接用于实际工作。LazyLLM作为商汤研发的低代码框架,支持模块化组装、一键部署和模型微调,显著降低大模型应用门槛。

LucianaiB的博客 4万+

LazyLLM 多 Agent 应用全流程实践:从源码部署到可视化 Web 调试的低代码方案

LazyLLM 多 Agent 应用全流程实践:从源码部署到可视化 Web 调试的低代码方案

wei_shuo的博客 1万+

用 Agent 智能体框架 LazyLLM 搞定个人文档RAG

本项目基于商汤科技开发的LazyLLM框架构建。LazyLLM是一个一站式AI应用开发工具,为应用开发过程中的全部环节提供了大量工具,协助开发者用极低的成本构建AI应用,并可以持续地迭代优化效果h=web#webLazyLLM和SenseNova都是商汤团队开发的产品,它们之间有很好的兼容性=Document:用于文档加载和处理Retriever:实现RAG检索功能:连接在线大语言模型:包装自定义处理函数WebModule:创建Web界面# 检查查询是否涉及最近一周的文档。

umeikou的博客 870

用 LazyLLM 搭建一个代码注释 / 文档 Agent 的实测体验

整个体验过程下来,我主要做了以下尝试:先在本地搭好虚拟环境,安装并配置 LazyLLM,然后用它跑了一个简单的对话机器人,验证模型可以正常工作。然后我试着用 Web 界面快速和模型交互,感觉直观又方便。最核心的实验是让它扫描 Python 文件,自动生成函数注释和 API 文档,不管是单个文件还是整个目录,都能自动生成清晰的函数用途、参数说明和返回值文档,几秒钟就完成了以前需要手动写很久的工作。

努力是为了站在万人之中,成为别人的光 1万+

LazyLLM教程 | 第3讲:大模型怎么玩:用LazyLLM带你理解调用逻辑与Prompt魔法!

LazyLLM是一款以数据流(Data Flow)为核心的多Agent大模型应用开发框架,所以 LazyLLM 中定义了大量的数据流组件,配合 LazyLLM 中提供的工具和组件,可以让您像搭积木一样搭建复杂的大模型应用。数据流的核心设计思路是无需您手动对数据流动进行指定,而是通过数据流内部将上一阶段的数据直接分发给对应的下游接收组件。LazyLLM支持Pipeline、Parallel、Switch、If、Loop、Diverter、Warp、Graph等数据流。

SenseCore的博客 982

【大模型】基于LazyLLM的日志助手开发

LazyLLM是一个简化大型语言模型应用开发的开源工具,支持模型部署、微调、推理优化和API封装。本文以智谱GLM为例,介绍API key申请和环境变量设置步骤,并展示如何基于LazyLLM开发日志分析助手。该助手能分类解析日志文件(ERROR/WARNING/INFO),通过GLM模型响应用户查询,提供日志统计和详情。示例代码包含日志解析、分类统计和交互查询功能,适用于快速构建私有化LLM应用。项目代码已开源,支持多种主流LLM平台接入。

qq_40734883的博客 737

LazyLLM黑科技|Claude写完代码上线就崩?那是缺了状态治理

AI 助手能帮你写出工整的逻辑,却无法凭空变出稳固的底层架构。LazyLLM 给“会聊天”的 AI 助手喂了一套“会干活”的工业级规约。从此,你负责业务创意,LazyLLM 负责帮你守住并发与隔离的底线。你在用 AI 助手写 Agent 时,被哪些“玄学 Bug”坑过?欢迎在评论区分享你的“惨痛经历”。想深度拆解这套“自动隔离”背后的底层魔法?观看下方内容——硬核分享:LazyLLM状态管理源码剖析。

SenseCore的博客 748

【LazyLLM】00 LazyLLM简介

商汤科技推出开源框架LazyLLM,旨在降低AI应用开发门槛。该框架支持低代码开发(最少10行代码),提供标准化工作流组件,实现多Agent协同、RAG检索等功能。特性包括跨平台部署、多模型支持、自动参数优化等,适用于从初学者到专业开发者的各类场景。核心模块涵盖文档处理、向量生成、智能体交互等,典型应用包括天气查询、知识库问答等复杂场景。通过模块化设计,LazyLLM简化了AI应用开发流程,提升迭代效率。

生命不息,折腾不止。 972

LazyLLM - ML 助手:基于 LazyLLM 与硅基流动免费模型的机器学习问答利器

在机器学习与强化学习领域,开发者常常面临模型选择、环境搭建、代码调试等诸多繁琐且重复的工作。尤其是对于新手而言,从众多模型中挑选合适的,再配置复杂的运行环境,会耗费大量时间和精力,阻碍了他们快速开展实际的学习与研究工作。同时,一些优秀的免费模型资源,由于缺乏便捷的集成工具,也难以被充分利用。为了解决这些痛点,我们开发了 LazyLLM - ML 助手 项目,旨在为开发者提供一个简单易用、能快速调用基于 LazyLLM 框架和硅基流动免费模型的机器学习 / 强化学习问答工具

2301_80892175的博客 839

LazyLLM 学习

本文介绍了基于LazyLLM框架构建PDF知识问答系统的实现过程。

lsswear的专栏 1135
上一篇: LazyLLM黑科技|Claude写完代码上线就崩?那是缺了状态治理
下一篇: LazyLLM 黑科技 | 给RAG装上C++涡轮:不改接口,性能直接起飞
商汤万象开发者
博客等级 码龄2年 174粉丝 67原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值