【深度学习】Hidden vs Latent:神经网络与概率模型中两个“隐”的本质区别

深度学习中的潜在空间 Latent Space 潜在空间:Latent ,这个词的语义是“隐藏”的意思。“Latent Space 潜在空间”也可以理解为“隐藏的空间”。Latent Space 这一概念是十分重要的,它在“深度学习”领域中处于核心地位,即它是用来学习数据的潜在特征,以及学习如何简化这些数据特征的表达,以便发现某种规律模式,最终来识别、归类、处理这些数据。 阅读详情

为什么在学习神经网络与概率模型时,hidden 和 latent 总是被混用?
因为它们都翻译成“隐”,却来自完全不同的建模范式。
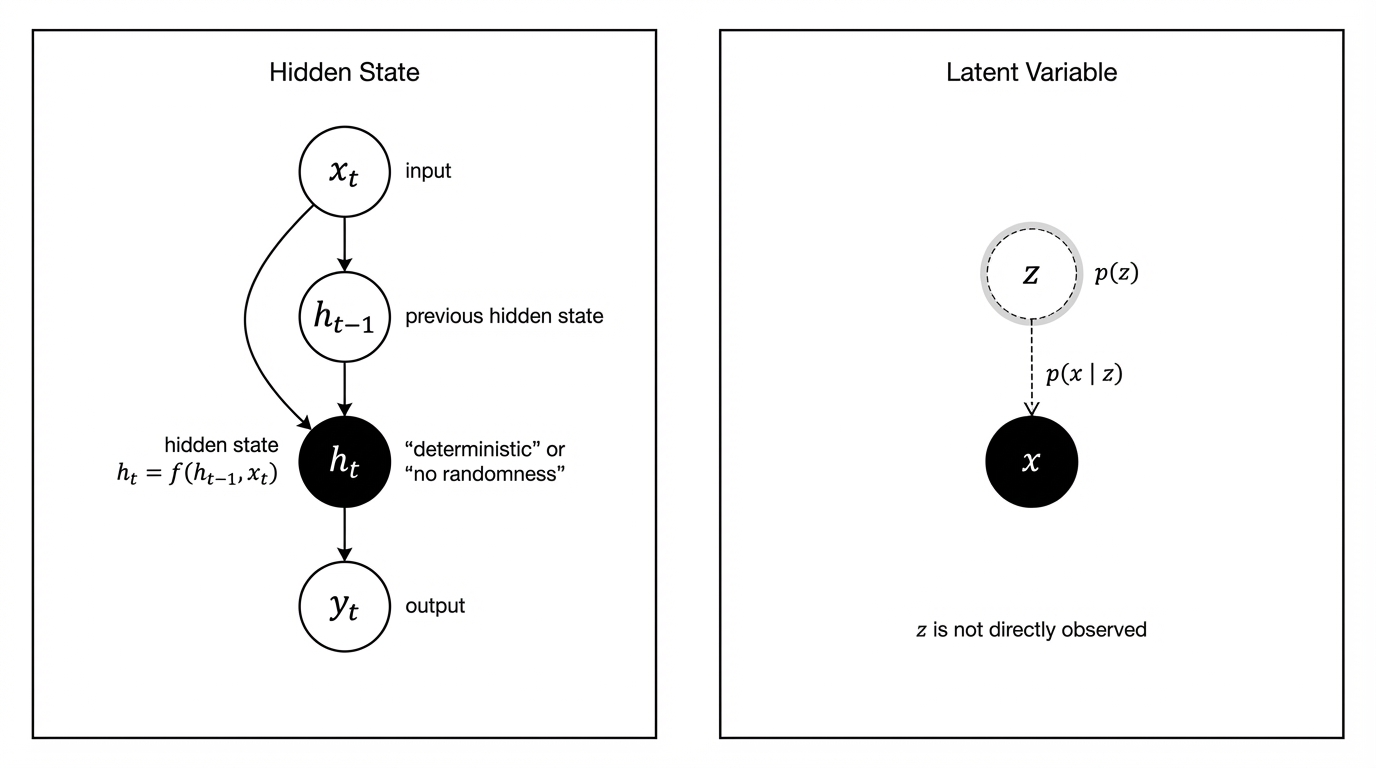
在这里插入图片描述

一、引言

1. 先说结论

  • Hidden:
    • 神经网络里的中间表示
    • 确定性、可直接计算
    • 每一次前向传播都“真实存在”
  • Latent:
    • 概率模型里的未观测随机变量
    • 不确定、需要推断
    • 只通过后验分布被“估计”

Hidden 是计算出来的;Latent 是推断出来的。

2. 概念对照表(避免混淆)

维度HiddenLatent
所属范式神经网络概率模型
是否随机❌ 否(确定性)✅ 是(随机变量)
是否可直接求值✅ 前向传播即可❌ 需做推断
是否显式建模分布❌ 不需要✅ 必须
典型例子RNN 的 hth_tht​、Transformer 的中间层VAE 的 zzz、HMM 的隐状态
直觉比喻盒子里真实存在的物品潜在性格/动机等因素

二、Hidden:网络结构中的隐藏状态

盒子里真实存在的一个物品,只是你没打开看到。

1. 词源直觉

  • hidden 来自古英语 hide:遮住、藏起
  • 含义强调:
    • 东西已经存在
    • 只是对观察者不可见

这与神经网络中的 hidden state / hidden layer 非常贴合。

2. 数学本质

​ Hidden 是确定性计算图上的节点:
ht=f(ht−1,xt;θ) \mathbf{h}_t = f(\mathbf{h}_{t-1}, \mathbf{x}_t; \theta) ht​=f(ht−1​,xt​;θ)

  • 给定参数 θ\thetaθ 和输入 xt\mathbf{x}_txt​
  • ht\mathbf{h}_tht​ 的值是唯一确定的
  • 不涉及概率、不涉及采样

3. 关键特征总结

  • 是模型内部真实存在的数据
  • 每一步 forward 都会产生
  • 反向传播可直接计算梯度
  • 本质是 feature / representation

Hidden ≈ 网络在“此刻学到了什么表征”

三、Latent:概率模型中的隐变量

“这个人可能有某种性格特质”,但你没有观测,只能推断。

1. 词源直觉

  • latent 来自拉丁语 latēre:潜伏、尚未显露
  • 不是“被挡住”,而是:
    • 可能存在
    • 不可直接接触

强调的是:潜在因素(underlying factors)

2. 数学本质

​ Latent 是随机变量:
z∼p(z)x∼p(x∣z) z \sim p(z) \\ x \sim p(x|z) z∼p(z)x∼p(x∣z)

  • zzz 本身不可观测
  • 我们只能通过:p(z∣x)p(z|x)p(z∣x)来推断它的分布

3. 关键特征总结

  • 不直接可见
  • 不是一个确定数值
  • 通常需要:
    • EM
    • 变分推断(VAE)
    • MCMC

Latent ≈ “是什么潜在原因生成了这些观测?”

四、为什么它们经常被混用?

1. 语言层面的原因

  • 中文都翻译为“隐”
  • 英文都带有 hidden / latent

2. 模型层面的交叉

一些模型同时出现两者:

  • VAE:
    • Encoder 输出是 hidden representation
    • 但它参数化的是 latent 的分布
  • Deep State Space Model:
    • hidden network
    • latent stochastic state

表面都在“中间层”,但数学地位完全不同。

五、判断口诀(非常实用)

1. 能不能前向一步直接算出来?

这是区分 计算节点 和 推断变量 的最快方法。

  • 能 → Hidden

    hidden 属于计算图中的节点,给定输入与参数,一次 forward 即可得到唯一确定的数值,本质是模型在计算过程中形成的中间特征表示。

  • 不能,必须算 posterior → Latent

    latent 属于概率模型中的随机变量,不是函数输出,必须通过条件分布(posterior)进行推断。

2.是不是显式写了 p(⋅)p(\cdot)p(⋅)?

这是一个形式层面的硬判断,不看直觉,只看模型在数学建模阶段写了什么。

​ 显式的意思是数学建模阶段是否为某个变量定义了概率分布。

  • 是 → Latent

    ​ latent 变量以随机变量的形式出现,并被显式建模分布,例如:z∼p(z),x∼p(x∣z)z\sim p(z), x\sim p(x|z)z∼p(z),x∼p(x∣z),其中zzz不是通过计算得到的,而是被假设存在、需要通过观测进行推断的潜在因素。

  • 否 → Hidden

    ​ hidden 是确定性的中间表示,仅以函数形式出现:h=f(x;θ)h = f(x;\theta)h=f(x;θ),给定输入和参数,hhh的值唯一确定,不涉及概率建模。

  • 只要你为一个变量建模了分布,它就不再是 hidden,而是 latent。

  • Hidden 用函数表示;Latent 用概率分布表示。

六、总结

  • Hidden 是网络结构中的确定性中间表示
  • Latent 是概率模型中用于解释数据生成过程的随机变量

它们的“隐”,一个是“被遮住的已知”,一个是“尚未显露的未知”。

《深度学习推荐系统》笔记(1) 《深度学习推荐系统》第0~2章笔记 阅读详情

相关推荐

机器学习中的隐变量和隐变量模型

开篇 这篇博客算我自己给自己挖的一个坑,主要想讲讲机器学习中的隐变量,今天在推导EM算法,李航在统计学习方法中的EM引入中提到了隐变量的概念(latent variable),他提到了如果我们的概率模型的变量都是观测到的变量,那么给定数据,我们就可以使用极大似然估计法,或者其他估计法去估计参数,但是当模型有隐变量的时候,就该我们的EM算法闪亮登场了。这边我先介绍一下什么是隐变量。后续关于隐变量模...

Ding_xiaofei的博客 2万+

快速理解深度学习中的latent code潜在编码

latent code,laten space,latent represtentation

xiufan1的博客 9638

Globus数据下载全攻略:从零配置到批量下载大文件(附常见问题解决)

本文详细介绍了Globus数据下载的全流程,从零配置到批量下载大文件的实用技巧,包括环境准备、高级传输策略、性能优化及常见问题解决方案。Globus作为科研数据的高效传输工具,通过并行流传输和自动校验技术,显著提升大规模数据传输的效率和可靠性。

u9v0w的博客 662

动手学习深度学习学习-循环神经网络

动手学习深度学习-循环神经网络笔记

hehehehejiejie的博客 771

手把手教你用AirSim生成无人机训练数据集:RGB/深度图/分割图全攻略

本文详细介绍了如何使用AirSim仿真插件在UE4环境中生成无人机训练数据集,涵盖RGB、深度图和分割图等多种模态数据的采集与处理。通过实战指南,读者可以掌握环境配置、多模态数据采集、自动化流程设计及数据后处理等关键技术,为无人机视觉算法开发提供高质量训练数据。

weixin_29008805的博客 448

2025年从零开始:构建你的首个ComfyUI工作流-ComfyUI入门教程

然而,由于它拥有众多的插件节点,以及较为复杂的操作流程,学习起来相对困难。以前面搭建的文生图工作流为例,首先点击功能区的【保存】,然后你的浏览器会出来一个弹窗,你可以进行文件命名,点击确定后浏览器会下载该文件,也就是带“json”后缀的文件,这样我们的工作流就打包成一份文件了。思考一下前面说的,节点是不是需要下载安装才能使用,而我们复用别人的工作流,他用的节点你不一定下载了,因为目前有600多个节点,你不可能全部下载了吧,所以我们日后使用别人的工作流,你会经常出现这样的问题。

weixin_59486588的博客 1454

机器学习中的隐变量/潜变量和隐藏空间/潜在空间

机器学习中的隐变量/潜变量和隐藏空间/潜在空间

嗨 2万+

告别繁琐同步:Zotero与Obsidian双向联动新方案(基于Better BibTeX与MarkDBConnect)

本文详细介绍了一套基于Better BibTeX、Bibnotes Formatter和MarkDBConnect插件的Zotero与Obsidian双向联动方案。该方案通过建立智能数据通道,实现文献信息的自动同步与笔记的增量更新,解决了手动同步的繁琐问题,并支持在两大工具间无缝跳转,极大提升了科研和知识管理的工作效率。

weixin_29213827的博客 641

随机过程在神经网络中的表现

1.背景介绍 随机过程(stochastic process)在神经网络中的应用非常广泛,它们在许多方面为神经网络提供了更强大的表达能力和更高的性能。随机过程在神经网络中的应用主要包括随机神经网络、递归神经网络、马尔可夫随机场等。随机过程在神经网络中的应用主要体现在以下几个方面: 模型表示:随机过程可以用来表示神经网络中的隐变量、观测过程和条件依赖关系,这有助于建模复杂的数据生成过程。 学习...

AI天才研究院 951

旅行青蛙破解汉化教程——蹭个热度

汉化破解版资源(无尽三叶草与点券): https://github.com/wisdombyzf/lxqw/blob/master/lxqw_zf.apk 截图: 破解方法: 工具: 1,APKIDE https://www.pd521.com/thread-818-1-2.html 2,dnspy https://down.52pojie.

github_38838414的博客 3783

ESP-IDF的安装及其在VScode中编译环境的搭建

从安装目录的\Espressif\frameworks\esp-idf-v5.3.2\examples路径中拷贝一个工程到项目中,比如拷贝\get-started下的hello_world文件夹。安装时可能会遇到如下问题,提示:"e:\ssc\software\ESP-IDF\v5.3.2\Espressif\tools\idf-python\3.11.2\python.exe -m pip" is not valid. (ERROR_INVALID_PIP)接着等待安装完成即可,其他步骤同方式1。

Freddy_Ssc的博客 4359

51c深度学习~合集8

方法的完整数学描述略显复杂,如果只是想了解主要思想,可以只看上面 PatchMix的流程图即可(其实只是公式多,每个公式也不复杂,后续有机会做个演示动画,帮助大家理解。这个方法也可以用简单的 Mask 方法实现,但是本方法在大规模图像处理上效率是最高的),对该工作感兴趣的同行可以看一下,我尽量写得清楚一些。结合 PatMix 的流程图,主要过程如下:由于混合图像和混合图像之间,重叠比例的不同,mix-to-mix label 中每一项的权重分数是不同的,根据上图,可以得到权重系数可以表示为。

whaosoft~aiotの开发板商城 2955

华为自研 ERP、Oracle EBS 与 SAP 上线时系统配置思路设计差异深度分析

本文对比分析了华为自研ERP、Oracle EBS和SAP S/4HANA三大ERP系统在上线配置思路上的核心差异。从架构设计看,华为采用分布式微服务架构,SAP采用分层服务架构,Oracle采用集中式一体化架构;在模块配置上,华为以业务场景为导向,SAP基于行业模板,Oracle强调模块独立性;数据迁移方面,华为侧重业务规则清洗,SAP注重数据质量监控,Oracle依赖标准化工具;流程适配上,华为系统随流程调整,SAP在框架内优化,Oracle需定制开发;定制开发模式差异明显,华为采用插件化扩展,SAP使

金牌架构师 1449

深度学习核心要素:从感知机到Transformer的算法推导与PyTorch实现(20段代码+12张架构图)

机器学习看似深奥,其实。本文 10000 字 + 20 段代码 + 16 张对比表 + 11 个 Mermaid 图表,从李航《统计学习方法》的经典框架出发,把监督学习、无监督学习、强化学习、半监督学习一网打尽。让你彻底搞懂「为什么回归用 MSE、分类用交叉熵」「批量梯度下降和小批量梯度下降的本质区别」「为什么 Adam 比 SGD 收敛快」。fill:#333;important;important;fill:none;color:#333;color:#333;important;fill:none。

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 230

Silvaco TCAD 半导体器件仿真全攻略:从入门到精通

本文介绍了Silvaco TCAD半导体器件仿真平台的核心功能与应用方法。主要内容包括: Silvaco TCAD的核心模块组成(ATHENA工艺仿真和ATLAS器件仿真)及其在半导体研发中的重要作用,能够通过数值仿真预测器件电学特性,显著降低研发成本。 环境配置要点,包括内存分配、文件目录管理和许可证验证,为仿真工作提供基础保障。 仿真核心概念:详细讲解了网格划分策略和物理模型选择原则,强调基于物理直觉的自适应加密网格方法。 以PN结二极管为例,提供了完整的仿真代码示例,涵盖从网格定义、掺杂设置到结果分析

huanghm88的专栏 198

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

Python机器学习:从零基础到项目实战

当您翻开此书,您正踏入一场数据与智慧的修行。机器学习,并非冰冷的符码,而是机器模拟人类洞察世界的法门。本书将带您,以Python为舟,泛游于算法之海。我们不只传授“术”,更探求其后的“道”——从数据的生灭流转中观照规律,于模型的迭代演进里体悟得失。愿您合上书卷时,收获的不仅是驾驭数据的技能,更有一双洞悉复杂、化繁为简的“智慧之眼”。现在,让我们一同启程。

YunWisdom 963

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

机器学习三要素完全手册:模型 + 策略 + 算法(李航统计学习方法框架·万字长文·20段代码·12张图表)

机器学习三要素核心解析(摘要) 本文系统性地解构了机器学习的三大核心要素:模型、策略与算法。通过10000字深度解析、20段Python代码示例、16张对比表格和11张Mermaid图表,全面覆盖监督学习、无监督学习、强化学习和半监督学习四大范式。 模型要素:详细剖析了线性模型、树模型、神经网络、概率模型等监督学习五大模型族,以及聚类、降维、密度估计和生成模型四大无监督学习模型族,包含参数复杂度对比和实际应用场景。 策略要素:深入解析损失函数选择(如MSE与交叉熵的本质区别)、风险最小化原则以及正则化技术,

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 269

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

隐变量(Latent Variable)定义-ChatGPT4o作答

隐变量是指在模型中无法直接观测,但对观测数据有重要影响的潜在因素。它通过数学模型或算法(如 EM 算法、MCMC 采样)进行推断和估计,广泛应用于聚类分析、主题建模、时间序列、神经网络等领域。在含隐变量的问题中,我们的目标通常是通过观测数据 ( X ) 估计隐变量 ( Z ) 的分布或模型参数 (\theta)。(Latent Variable)是指在模型中未被直接观测到,但会影响观测数据的隐藏变量或潜在因素。隐变量的引入使得复杂的数据生成过程变得可描述和可解释,帮助我们揭示数据背后的潜在结构。

qq_46215223的博客 1378

深度学习 | 基本循环神经网络

当前系统的状态,可能依赖很长时间之前系统状态。

"You are worthy! You can do it!" 2071

深度学习三巨头共同发文,聊聊深度学习的过去、现在与未来

作者|Yoshua Bengio,Yann LeCun,Geoffrey Hinton译者|香槟超新星出品|AI科技大本营(ID:rgznai100)人工神经网络领域的研究是基于对人类智能...

AI科技大本营 718

神经网络 隐藏层 hidden layer名字的意思

As mentioned earlier, the leftmost layer in this network is called the input layer, and the neurons within the layer are called input neurons. The rightmost or output layer contains the output neu

qq_20488317的博客 6028

神经网络中的隐藏层

问题 神经网络中隐层有确切的含义吗? 还是说神经网络的内部结构只能是黑盒,我们无从得知自己训练的每一个隐层节点权重的确切含义呢。 一层隐层网络就是一层特征层次,每一个神经元可以类似看作一个特征属性。 先解释一层隐层网络就是一层特征层次这一点,有一点拗口。这在传统的神经网络中还不是很明显,在CNN中尤为明显。要明白这一点,首先得理解感受野。感受野是指CNN卷积核在卷积过程中关注的区域,比如第一层5×...

nine_mink的博客 1万+

神经网络中隐层数和隐层节点数问题的讨论

神经网络中隐层数和隐层节点数问题的讨论<br />一隐层数<br />        一般认为,增加隐层数可以降低网络误差(也有文献认为不一定能有效降低),提高精度,但也使网络复杂化,从而增加了网络的训练时间和出现“过拟合”的倾向。一般来讲应设计神经网络应优先考虑3层网络(即有1个隐层)。一般地,靠增加隐层节点数来获得较低的误差,其训练效果要比增加隐层数更容易实现。对于没有隐层的神经网络模型,实际上就是一个线性或非线性(取决于输出层采用线性或非线性转换函数型式)回归模型。因此,一般认为,应将不含隐层的网络模

lqlong19922008的专栏 1万+

隐变量模型(latent variable model)

连续隐变量模型(continuous latent model)也常常被称为降维(dimensionality reduction) PCA Factor Analysis ICA 连续的情形比离散的情况更有效在信息表示上; 转载于:https://www.cnblogs.com/mtcnn/p/9422511.html...

weixin_30745641的博客 3140

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 180

AlexNet技术剖析:2012年那场ImageNet比赛如何引爆深度学习

2012年,AlexNet在ImageNet竞赛中将图像识别错误率从26.2%降至15.3%,开启深度学习革命。其成功源于三大创新:ReLU激活函数缓解梯度消失、Dropout防止过拟合、GPU并行加速训练。结合大规模标注数据(ImageNet)与数据增强策略,AlexNet突破传统特征工程瓶颈,推动计算机视觉进入“

大雾的小屋的博客 349
上一篇: 【LLM基础教程】LLM训练数据集是如何构造的:从文档到Token Block
下一篇: 【LLM评价指标】从概率到直觉:理解语言模型的困惑度
未收敛
博客等级 码龄11年 3304粉丝 163原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

未收敛

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值