别再让你的AI“一本正经地胡说八道“!RAG技术让你模型知识更新快人一步,小白也能秒懂!

OpenViking上下文数据库Golang集成实践 技术创新文件系统范式:将AI Agent的上下文管理从扁平向量存储提升为结构化文件系统分层检索策略:L0/L1/L2三层加载机制,减少62.1%的Token消耗记忆自迭代:会话提交触发Agent经验沉淀,实现越用越智能工程实践完整Golang实现:提供生产级可用的OpenViking客户端库企业级集成方案:涵盖文档摄入、检索、会话管理等全流程性能优化成果:检索准确率提升24.1%,响应时间减少53.3%可观测性提升可视化检索轨迹:实现检索过程的白盒化,调试效率提升77.1%全面监控指标。 阅读详情

一、RAG

1.1 简介

RAG (Retrieval-Augmented Generation),即“检索增强生成”,是目前大模型(LLM)落地应用中最主流的技术方案。它解决了大模型知识更新慢、容易产生“幻觉”以及无法掌握私有数据的问题。

大模型虽然聪明,但它的知识停留在他训练的那一刻。如果问它昨天的新闻或公司的内部文件,它就会胡编乱造。RAG 的做法是:在模型回答之前,先去外部知识库里“翻书”查阅资料,把查到的内容喂给模型,让它参考这些资料来写答案。
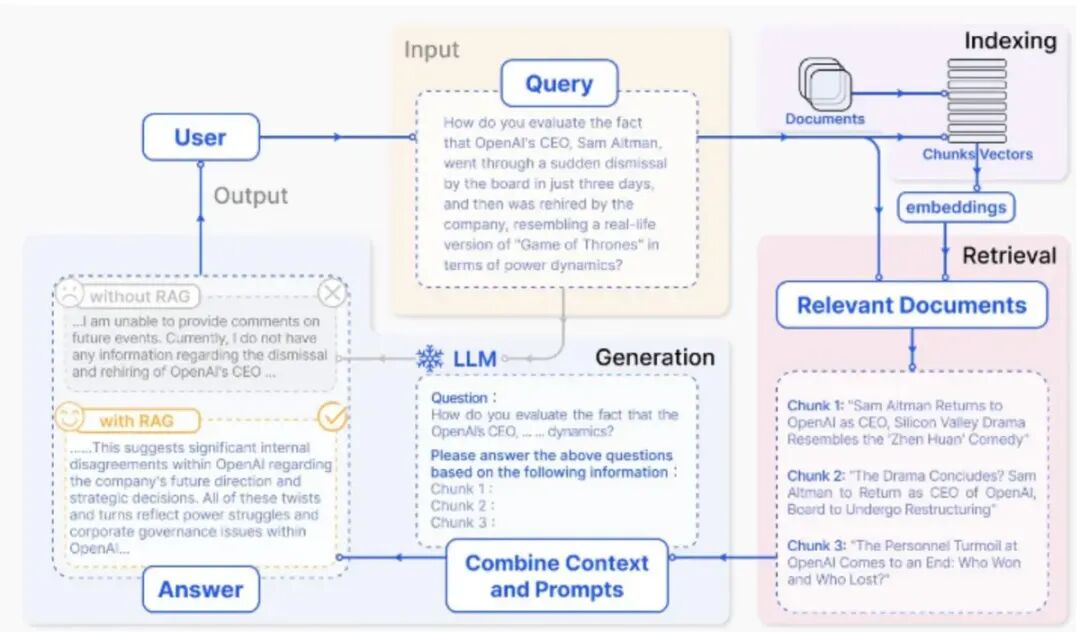
image.png

参考文档:https://datawhalechina.github.io/all-in-rag/#/

1.2 核心思想

RAG 的核心思想可以理解为:“开卷考试”。

  • 传统生成: 闭卷考试,全凭记忆,记错或没学过就乱写。
  • RAG: 开卷考试,遇到问题先在资料堆里找相关段落,然后根据这些段落组织语言回答。

1.3 实现原理

实现 RAG 通常分为两个阶段:数据准备(离线) 和 检索生成(在线)。

A. 数据准备阶段(把书存进库里)

  1. 文本分割 (Chunking): 把长文档切成一小段一小段(比如每段 500 字)。
  2. 向量化 (Embedding): 利用向量模型把这些文本片段向量化。
  3. 存入向量数据库: 把这些向量存到向量数据库,方便以后进行快速的相似度搜索。

B. 检索生成阶段(查书并回答)

  1. 问题向量化: 把用户的提问使用相同的向量模型转换成向量。
  2. 检索 (Retrieve): 在数向量据库里检索和问题向量相似的文本片段(欧氏距离或余弦距离)。
  3. 增强 (Augment): 把找出来的片段和原始问题拼接在一起,组成一个提示词(Prompt)。
  4. 生成 (Generate): 把这个提示词发给 LLM,模型根据参考资料输出最终答案。

1.4 优势

  • 准确性高: 所有的回答都有据可查,显著降低幻觉。
  • 实时性强: 只要更新数据库,模型就能掌握最新信息,无需重新训练模型。
  • 成本低: 相比于微调(Fine-tuning)模型,RAG 的部署和维护成本极低。
  • 隐私保护: 敏感数据可以留在本地数据库,只在需要时提供给模型参考。

1.5 挑战

虽然原理简单,但在实际应用中仍面临难题:

  • 检索不到: 数据库里有,但没搜出来。
  • 检索不准: 搜出来很多无关信息。
  • 整合能力差: 模型拿到了资料,但没理解好,或者忽略了关键信息。

二、高级RAG

当前RAG所存在的问题,成为很多企业或开发者的痛点,为了解决这些痛点,于是出现了多种方式来优化RAG。在优化的阶段,主要包括:预检索阶段、检索阶段、后检索阶段。

  1. 预检索优化(Pre-Retrieval)

预检索优化是指在检索之前的环节进行优化,在预检索优化中存在如下方法:

1.1 摘要索引

  • 简介:

    摘要索引 (Summary Index) 是 RAG 架构中一种旨在优化检索效率和准确性的索引策略。它不直接检索原始文本块,而是通过对文档内容进行预处理,生成“摘要”并以此为核心进行检索。

    在标准 RAG 中,如果文档非常长且细节繁琐,直接检索原始切片(Chunks)容易导致信息支离破碎或检索不到位。

    摘要索引的做法是:先为每个文档(或文档的大段落)生成一段精炼的摘要,并为摘要建立索引。检索时,系统先匹配摘要,确定相关文档后,再深入该文档获取细节。
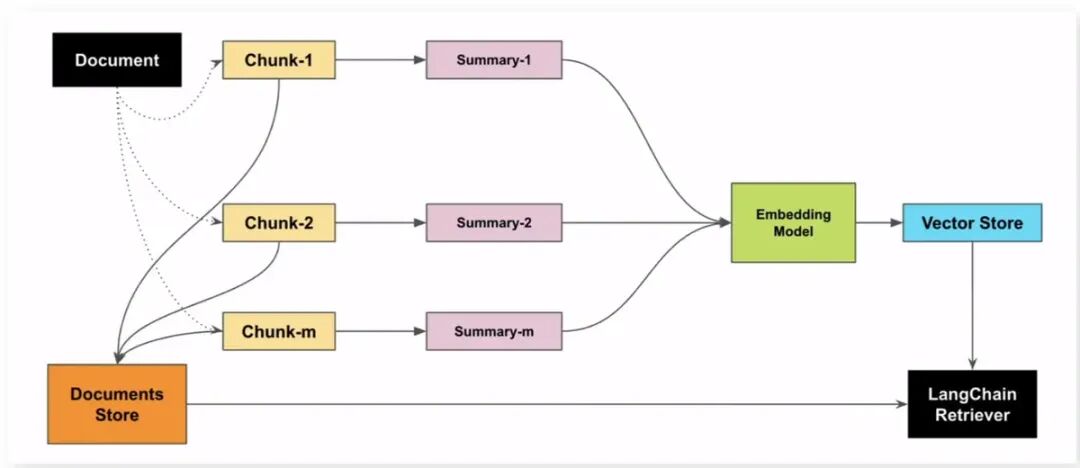
image.png

  • 核心思想:

    摘要索引的核心思想是 “由简入繁,层级定位”:

  • 语义提炼: 原始文本可能包含大量噪音,摘要保留了核心语义,降低了向量检索的干扰。
  • 全局映射: 摘要作为一个“锚点”,代表了背后一整块或一整篇文档的含义,解决了“只见树木不见森林”的问题。
  • 多层级检索: 通过建立“摘要 -> 原始文本”的映射关系,实现从宏观意图到微观细节的精准导航。
  • 实现原理:

    实现摘要索引通常分为以下几个步骤:

    A. 文档拆分与总结 (Summarization)

    B. 构建索引 (Indexing)

    C. 检索流程 (Retrieval)

    D. 答案生成 (Generation)

    LLM 结合这些经过筛选的、高度相关的原始文本片段生成答案。

  1. 第一阶段(摘要检索): 用户提问后,系统在“摘要库”中寻找最匹配的摘要。

  2. 第二阶段(上下文提取): 一旦命中某个摘要,系统会自动提取出该摘要关联的所有原始文本片段(或更细小的切片)。

  3. 向量化摘要: 仅对生成的“摘要文本”进行 Embedding(向量化)并存入向量数据库。

  4. 建立链接: 在数据库中建立父子关系,即:摘要 ID -> 原始文本块 IDs。

  5. 将长文档拆分为较大的语义单元(如章节、页面组)。

  6. 利用 LLM 为每个语义单元生成一段简短的摘要。

  7. 关键点: 摘要中通常会保留文档中的核心关键词、实体和主要观点。

  • 优势:

    摘要索引是构建层级化 RAG 的基础。它像是一本书的“详细目录”,让 AI 能够先看目录确定位置,再翻到具体页面读细节,从而大大提升了处理长文档时的检索成功率,而且信噪比极高。

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

用AI学习graphify Graphify是一个AI驱动的知识图谱构建工具,能够将代码、文档、论文、图像和视频等多模态数据转换为结构化知识图谱。其核心技术特点包括: 多模态处理能力: 支持25+编程语言的AST解析 处理PDF、Markdown等文档 集成Whisper进行音视频转录 高效知识提取: 采用确定性AST解析与LLM语义提取结合 相比直接读取源文件,查询token消耗最多减少71.5倍 增量更新机制仅处理变更文件 智能分析功能: 自动识别高中心性的"上帝节点" 发现跨领域的"意外连接&quo 阅读详情

相关推荐

到底什么是Harness工程?一篇文章从入门到企业落地全解析

随着OpenClaw爆火,Harness Engineering(驾驭工程)成为AI编程时代的热门概念,很多小白对其感到陌生。本文用通俗类比和真实案例,避开复杂术语,从基础定义入手,讲清Harness Engineering的核心逻辑——人类工程师设计“约束系统”(马具),让AI模型(烈马)安全高效地完成代码工作,同时拆解其核心组件、企业落地场景和实战成果,帮小白快速入门,读懂这项能解放人力、提升效率的新技术,轻松掌握它的核心价值和落地思路。

program哲学 3289

基于RAG的企业智能客服项目,已拿70万offer!

基于 RAG 构建一套企业智能客服系统📖。

m0_59164520的博客 1449

新能源场站必看:一次调频与AGC/AVC的协同控制逻辑解析(含典型拓扑图)

本文深度解析了新能源场站中一次调频与AGC/AVC的协同控制逻辑。针对电网频率与电压稳定需求,详细阐述了三者在响应时序、控制目标上的分工与配合,并重点剖析了以RCL-0923装置为核心的指令融合架构与典型拓扑,为场站实现高效、稳定的协同运行提供了清晰的实践指导。

brown的博客 1068

从Vibe Coding到可控生产力:Harness Engineering的实践启示

摘要:OpenAI提出的Harness Engineering(工程化治理)理念为AI Agent时代的软件工程提供了关键方法论,旨在解决代码高产出下的质量闭环、上下文管理等核心矛盾。其三大目标包括重构工程师角色、将AI纳入可控体系、实现低成本纠错,通过六大举措(如角色重构、机械化约束、反熵机制等)重构工程流程。该理念与vibe coding高度互补,既保留灵感驱动的敏捷性,又通过工程化体系保障稳定性,最终推动工程师从"代码生产者"升级为"工程体系设计者"。

小程故事多的博客 4401

YOLOv11改进 | 检测头篇 | 利用AFPN辅助YOLOv11检测头进行特征融合识别(全网独家创新)

本文给大家带来的最新改进机制是利用AFPN(渐近特征金字塔网络)来优化检测头,AFPN的核心思想是通过引入一种渐近的特征融合策略,将底层、高层和顶层的特征逐渐整合到目标检测过程中。这种渐近融合方式有助于减小不同层次特征之间的语义差距,提高特征融合效果,使得检测模型能更好地适应不同层次的语义信息。本文在AFPN的结构基础上,为了适配YOLOv11改进AFPN结构,同时将AFPN融合到YOLOv11中(因为AFPN需要四个检测头,我们只有三个,下一篇文章我会出YOLOv11适配AFPN增加小目标检测头)

Snu77的博客 3751

生成模型实战 | 基于Transformer生成音乐

本文介绍了基于Transformer架构的音乐生成方法,将音乐视为一系列事件序列进行处理。与将音乐表示为多维图像的MuseGAN不同,该方法使用类似GPT的仅解码器模型,基于先前事件预测下一个音乐事件。模型使用MIDI格式的钢琴音乐数据,通过分词处理将音符转换为note-on、note-off、time-shift和velocity四种事件类型,共388个独特词元,映射为索引序列后输入网络。训练完成后,可通过调整温度参数控制生成音乐的新颖性,从而创作出风格类似训练数据且连贯逼真的音乐作品。

盼小辉丶的博客 5899

别再让AI“一本正经地胡说八道”!三步驯服大模型,让它成为你的效率神器!

正确高效运用AI大模型,应遵循三步走的操作流程:即选对工具、向量思维、组合创作。

老皮的博客 1001

Mamba SSM 实战:IMDb 文本分类 + Mamba-ssm 全流程

Mamba SSM 文本分类链路:IMDb 二分类 → MambaLMHeadModel (d_model=256, n_layer=8, d_state=16, exp2=2) → 末 token 分类头。5 epoch 达 89.2% 准确率 (与 BERT-base 持平), 但显存降低 44% (3.5GB vs 6.2GB)。建议序列长度 ≥ 1024 再选 Mamba, 短序列 (< 512) 用 BERT 更高效。扩展时注意d_state。

m0_71589036的博客 58

【AI入门知识点】RAG 是什么?为什么它能让 AI 不再胡说八道?

RAG 是让 AI 学会“先查资料,再回答”的技术。RAG 是通过向量检索动态注入外部知识,再结合 LLM 生成答案的增强架构。如果你刚开始学习 AI。Token↓Embedding↓Attention↓↓LLM↓Prompt↓RAG↓AgentLLM 决定 AI 会不会说。RAG 决定 AI 说得准不准。理解 RAG。企业级 AI 应用开发的大门。

创世宇图 宏图天下 947

基于Python的彭博社新闻高效爬取实战:最新技术与完整代码解析

本文将详细介绍如何使用Python最新技术构建一个高效的彭博社(Bloomberg)新闻爬虫系统。我们将从爬虫基础概念讲起,逐步深入到高级反反爬技术、异步抓取、数据解析与存储等核心环节。文章包含完整的代码实现,采用最新的aiohttp、Playwright等技术栈,并特别关注法律合规性和数据质量保障。通过本文,读者将掌握一个完整的商业新闻爬虫开发流程,并能够根据实际需求进行定制化开发。关键词:Python爬虫、彭博社、Bloomberg、新闻采集、aiohttp、Playwright、反反爬技术。

2201_76125261的博客 1503

卫星轨道坐标转换:轨道六根数到经纬高(经STK验证)

a:半长轴(km)e:偏心率i:轨道倾角(度)Ω:升交点赤经(度)ω:近地点幅角(度)ν:真近点角(度)

weixin_52370774的博客 171

【收藏学习】一文搞懂RAG技术:大模型检索增强生成的原理与实战

RAG技术通过检索外部知识增强大模型回答能力,解决知识时效性、私有数据访问和可解释性问题。其构建流程包括文档分片、向量索引、语义检索、结果重排和答案生成。文章提供完整代码示例和行业案例,对比RAG与微调的适用场景,帮助开发者构建更准确、可靠的大模型应用,是AI从业者必学技术。

Android_XG的博客 1240

结构函数分析与 JESD51-14 标准详解

结构函数(Structure Function)是将器件瞬态热响应曲线(冷却曲线)通过数学变换,转换为热阻(Rth)与热容(Cth)沿热流路径一维分布的图形化分析方法。它能“看到”热量从结(Junction)到壳(Case)或环境的过程中,经过每一层结构时的热学特性。

专注于前沿技术的探索与实践,热衷于从代码逻辑、架构设计到行业应用等多维度深挖技术本质。期待在技术之路上与你共同成长~ 58

从零开始构建RAG系统:大模型检索增强生成实战指南

RAG技术:大模型的知识增强利器 RAG(检索增强生成)技术通过连接外部知识库,有效解决大模型知识时效性有限、无法访问私有数据、可解释性差等问题。文章详细解析了RAG的核心原理、应用场景和构建流程: 核心优势:相比传统大模型的"闭卷考试",RAG实现"开卷作答",通过实时检索增强回答准确性,支持知识更新和来源追溯。 适用场景:特别适合智能客服、金融合规、医疗辅助等对准确性要求高的领域,已成功应用于摩根士丹利等企业的知识管理系统。 构建方法:完整流程包括文档分片、向量索

2401_84495872的博客 1014

一文快速教你如何下载国自然模版

5. 成功进入“相关文件查看”页面后,点击左侧的“项目申请文件“,如果你此次申请的是“面上项目”,选择对应的下拉框,找到对应的模版下载即可。6. 🫑们发现,在当前页面点击“青年科学基金项目”,左侧出现的是“原国家杰出青年科学基金项目”。7. 进入下一页后,点击“青年科学基金项目”,便可以在右侧找到🫑们要找的模版啦。2. 成功登陆后,点击1处的“首页”,在首页界面,再点击2处的“项目批准”。8. 点击上图3处的“文件详情”,就可以找到可以下载的模版啦(如下图)。3. 从“项目批准”进入后,点击“管理”。

薰珞婷紫小亭子的博客 2405

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

深入浅出 RAG:原理、流程与代码实战

深入浅出 RAG:原理、流程与代码实战

嗨,欢迎来到我的 优快云 博客小天地!一名深耕多年的技术发烧友。在这里,我将把日常工作中积累的宝贵经验,从复杂架构设计的精妙之处,到代码优化的实战技巧,毫无保留地分享给大家。 8554

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

大模型工程师带你用5W1H彻底拆解RAG!What/Why/How全讲透(附大模型学习路线+资源)

RAG(检索增强生成)技术通过连接外部知识库,让AI系统"边查资料边回答",有效解决大模型知识时效性差、无法访问私有数据、缺乏可解释性和成本高等痛点。文章详细介绍了RAG的工作原理、应用场景、与微调技术的选择依据,以及从文档分片到答案生成的完整构建流程。RAG技术已在智能客服、企业知识管理、金融合规等领域展现巨大价值,为构建可信、可用、可控的AI系统提供了关键技术支撑。

2401_85375186的博客 1191

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

RAG是什么?企业为什么需要自己的知识库?

023年ChatGPT火了之后,大语言模型(Large Language Model,简称LLM)给人的感觉就是"无所不知的老师"。但实际上,你往企业场景一用,马上暴露两个硬伤

爱片闲串,爱钓鱼,爱中医,爱分享 223

大模型工程师带你用5W1H彻底拆解RAG!What/Why/How全讲透

大模型工程师带你用5W1H彻底拆解RAG!What/Why/How全讲透

瓦罗兰特顶级C位的博客 1046

大模型落地实操:RAG与微调到底怎么选?一文讲透“补课”与“开卷考试”

当工程师问“3101工作面现在的压力是多少”时,模型通过微调学到的专业能力理解问题意图,再通过RAG实时检索最新数据,最后给出精准、专业的回答。第一步用微调“定调子”:从历史文献、操作规程中提取知识,用 LoRA 技术对大模型进行专业培训,只微调不到1%的参数,让模型立刻掌握煤矿领域的专业术语和逻辑体系,从“通才”变成“煤矿专家”。微调的做法,是在一个已经训练好的通用大模型基础上,拿自家整理好的领域数据,再给它做一轮小规模的“加训”。你可以这么理解:模型还是那个模型,知识全在外挂库里,两者完全分离。

2601_96693776的博客 374

一文理清提示工程RAG、CAG、微调:大模型落地选型

大部分AI项目失败,不是模型不行,是架构选错了。

m0_59162248的博客 350

RAG入门指南:让大模型“边查资料边回答”,小白也能轻松掌握(收藏版)

本文用大白话解释了RAG(检索增强生成)技术如何让大模型像开卷考试一样,通过检索外部知识库来回答问题,从而解决传统大模型的三大短板:知识时效性有限、无法访问私有数据、缺乏可解释性。文章还介绍了个人和小团队如何利用成熟的开源框架(如LangChain、LlamaIndex)搭建轻量级RAG系统,并提供了选择RAG还是微调的决策指南。最后,通过智能客服、企业知识管理等真实案例,展示了RAG在各个领域的应用价值。

嘴巴吃糖了 434

RAG还是微调?同事吵了三天没结果,我拿出一张对比表,全员沉默后疯狂点赞!

摘要: 本文探讨AI开发中RAG(检索增强生成)与Fine-tuning(微调模型)的选择策略。RAG通过外挂知识库动态补充模型知识,适合实时性要求高、成本敏感的场景;Fine-tuning通过训练使模型掌握特定领域技能,适合风格/格式要求严格的场景。两者可组合使用(如法律文书生成案例中,RAG解决知识更新问题,Fine-tuning优化输出专业性)。决策时需权衡成本、时效性、领域需求等因素,最终实现1+1>2的效果。 (字数:149)

【javatoai17819112191】→Java && python && AI Agent工程师 573

RAG检索增强生成技术全解析:从原理到落地的完整指南

你好! 这是你第一次使用# RAG检索增强生成技术全解析:从原理到落地的完整指南在大模型应用落地过程中,RAG(Retrieval-Augmented Generation,检索增强生成)已经成为最刚需的技术,没有之一。原因很简单:大模型虽然知识广博,但存在两个天然短板——一是知识有截止日期,无法覆盖最新信息;二是面对私有领域知识(企业内部文档、专业资料)时,模型要么不知道,要么会"一本正经地胡说八道"。这两个短板,恰恰是企业在真实业务场景中最无法接受的。RAG 通过"先检索、后生成"的方式,把外部知识注入

yonggeit的博客 293

RAG(Retrieval-Augmented Generation)全面解析:从原理到实战,一文彻底搞懂大模型知识库

一句话解释:先查资料,再让大模型回答。用户│▼LLM│▼回答用户│▼知识检索│找到相关文档│▼LLM│结合知识生成答案▼最终回答所以:检索 + 生成RAG 已经成为当前大语言模型落地应用中最重要的技术之一。它通过“检索 + 增强 + 生成”的方式,让模型能够利用最新、最专业的外部知识回答问题,而无需重新训练模型。如果把大语言模型比作一个经验丰富但记忆固定的专家,那么 RAG 就像为这位专家配备了一个能够实时查阅资料的智能图书馆。

weixin_48914879的博客 243

一文理清提示工程 / RAG/CAG/ 微调:大模型落地选型全攻略

不少人折腾仨月给模型做微调,最后发现一个写得好的提示词,一周就能搞定问题;还有人非要搭全套RAG向量数据库,可那些文档其实一开始就能塞进上下文窗口;也有人总在抠提示词的细节,却没发现真正需要的是给模型做领域重训。

m0_59235945的博客 394
上一篇: 震惊!Meta豪掷140亿收购AI Agent,扎克伯格亲自操盘!小白程序员必学的前沿黑科技,从0到1掌握下一代编程范式
下一篇: 内卷不如内建!7天实战:从零开始构建大模型Agent,小白也能成为AI编程高手
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值