


2025年12月30日,传来一个震动科技圈的消息:Meta宣布完成对AI初创公司Manus的收购。这场由CEO扎克伯格亲自操盘的谈判仅用十余天敲定,交易对价超过20亿美元(约合人民币140亿元),花费仅次于 WhatsApp 和 Scale AI。(目前这个收购在审查中)
Manus的核心产品是一款能自主执行研究、编码等复杂任务的AI智能体(Agent)。自今年3月发布以来,Manus在不到10个月的时间里迅速崛起,于12月17日宣布其年度经常性收入(ARR)已突破1亿美元,成为AI应用领域的“现象级”产品。
AI Agent通过多模态感知理解环境和任务,利用其推理能力制定一个动态的行动计划,在执行过程中,它能根据环境的反馈实时调整策略,直至最终完成任务。这种自主性和适应性,使得Agent能够胜任远比传统AI更复杂的任务。
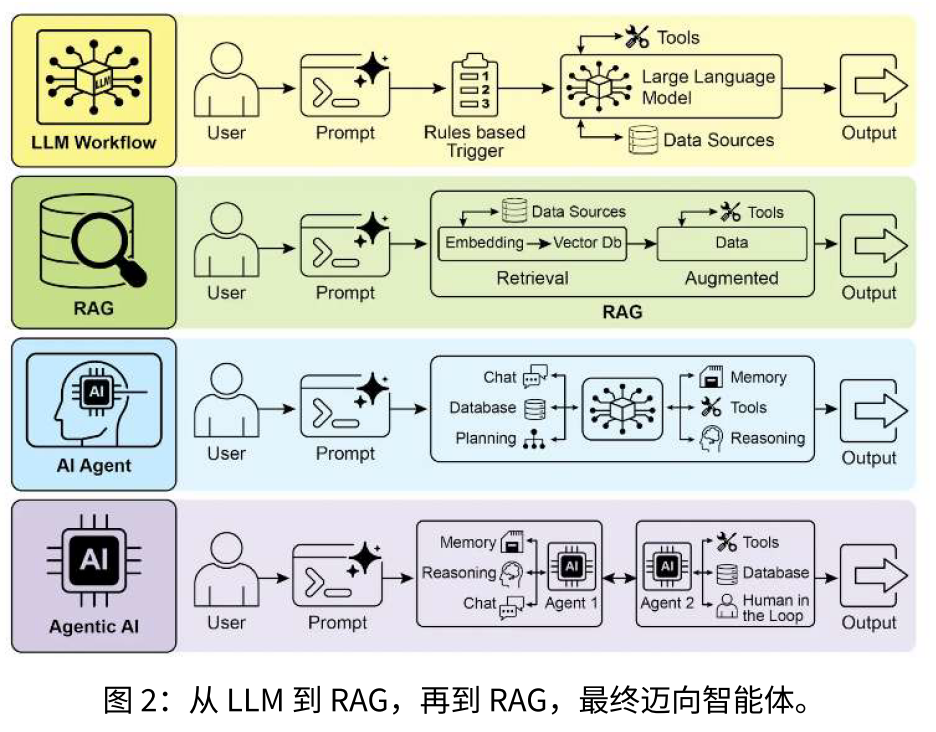
图片来源:Antonio Gulli《智能体设计模式》
AI Agent能够完成从感知、规划、决策到执行的完整闭环,被认为是继大型语言模型之后的下一个技术范式。
从技术上,AI Agent突破大模型静态局限,实现自主规划、工具协同与多模态交互,推动向通用智能演进。在产业中,AI Agent重构生产力范式,降本增效并降低 AI 应用门槛,赋能千行百业智能化升级。在社会层面,AI Agent将重塑人机协作关系,让人类聚焦高阶任务,推动技术普惠,为 AGI 奠定关键基础。
本文引用Maarten Grootendorst的《A Visual Guide to LLM Agents》,介绍一下Agent的基本概念。这篇文章制作了大量精美的图片,简明扼要的介绍了Agent工作原理,原文链接见文末。
01
什么是 LLM Agent?
Russell & Norvig在《人工智能:一种现代方法》(2016)一书中,对Agent的定义是:
一个 agent 是任何可以被视为通过传感器感知环境,并通过执行器作用于该环境的实体。
Agent通常包括3个重要组件:
- **传感器:**用于观察环境
- **执行器:**用于与环境交互的工具
- **效应器:**决定如何从观察转化为行动的"大脑"或规则
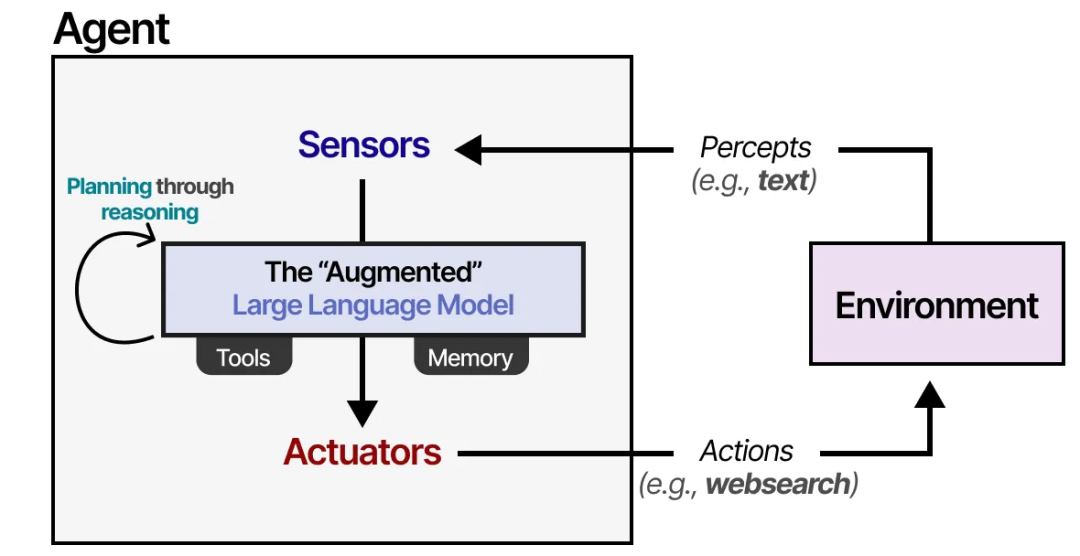
Agent 可以观察环境(例如:通过文本),并通过使用工具(例如:网络搜索)执行特定操作。
为了确定选择采取哪些行动,Agent需要具备一个关键技能:规划能力。这意味着 LLM 需要能够通过思维链等方法,进行"推理"与"思考"。
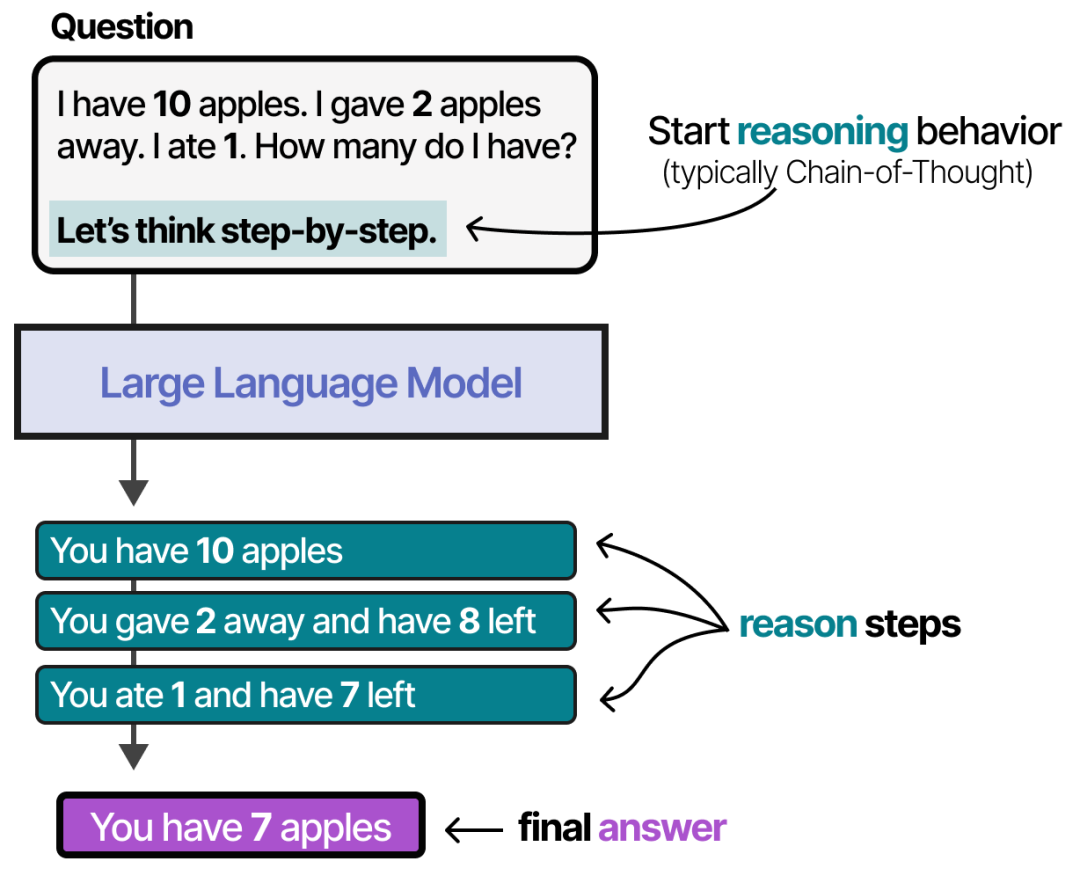
利用这种推理行为,Agent 将规划出必要的行动步骤,例如:
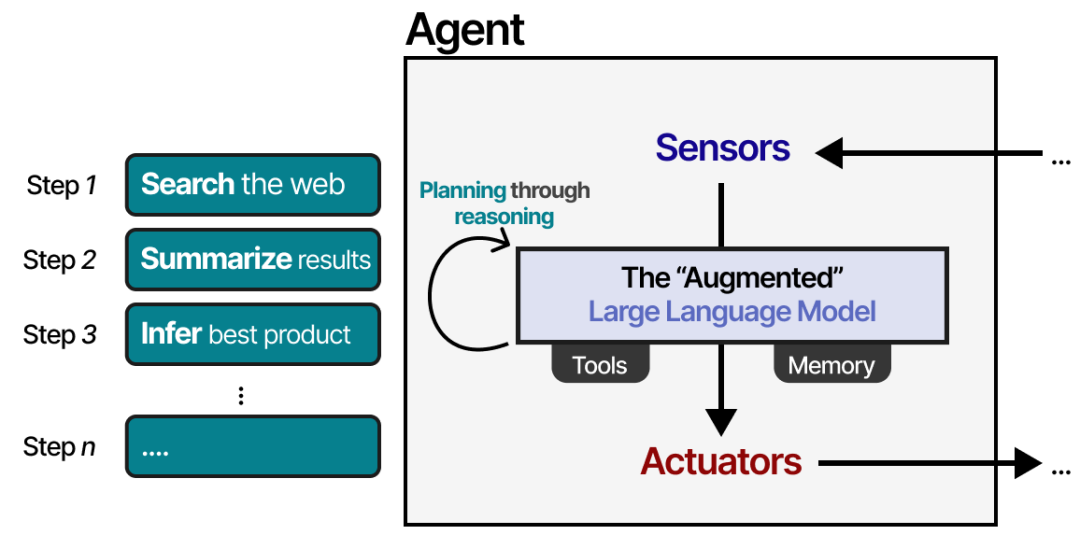
这种规划行为,使 Agent 能够理解情况、规划下一步,并采取行动。
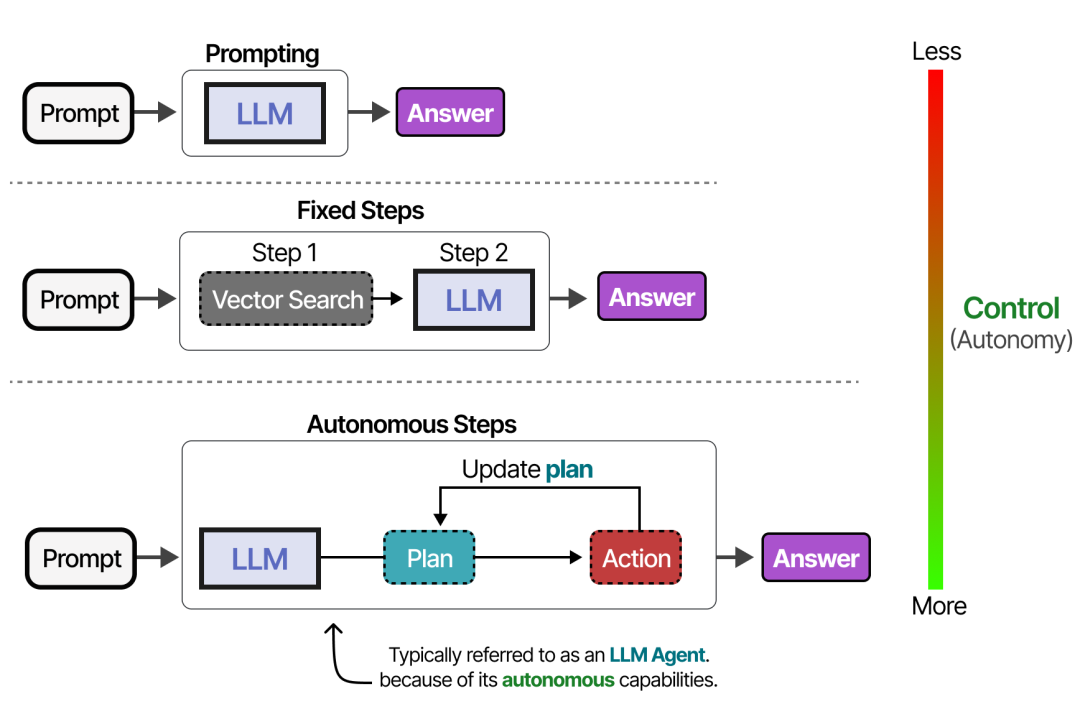
根据系统自主程度的不同,有不同类型的Agent。
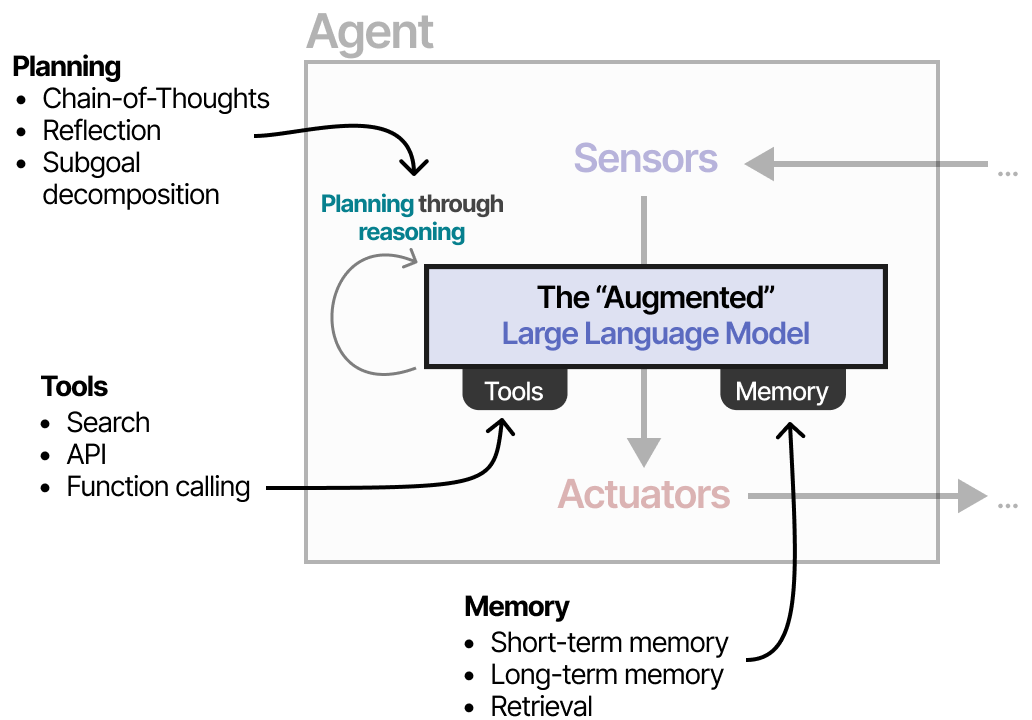
下面我们介绍 LLM Agent 的三个主要组件:记忆、工具和规划。
02
记忆-Memory
和LLM交互时,LLM通常不具有任何记忆功能。例如:
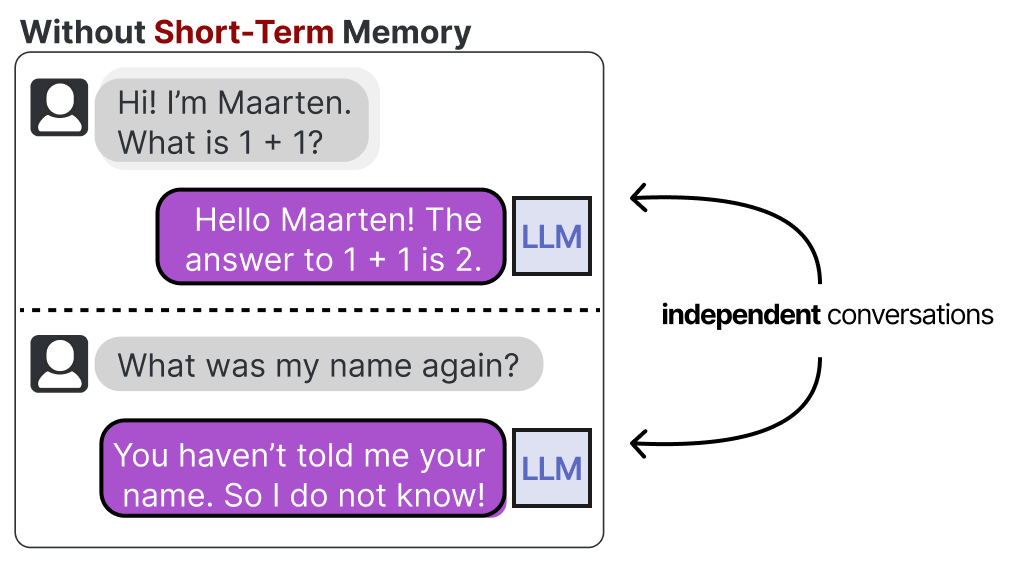
我们通常将此称为短期记忆,也称为工作记忆。
另外,Agent一般还需要跟踪可能数十个至数百个步骤,而不仅仅是最近的行动,这被称为长期记忆:
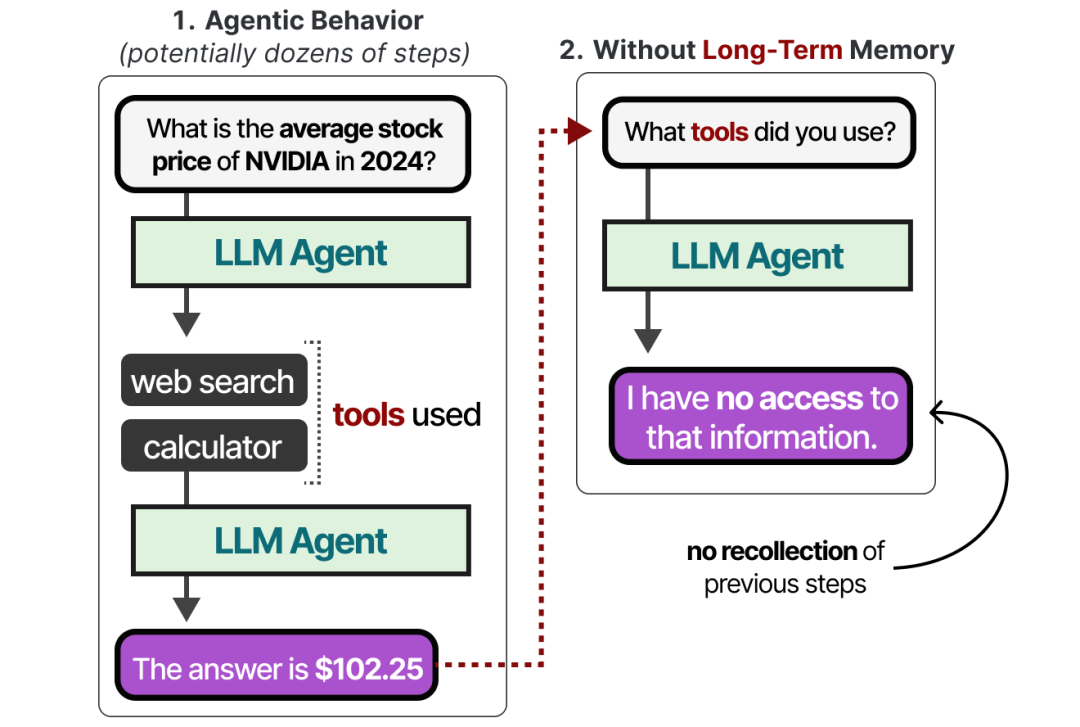
短期记忆和长期记忆的对比:
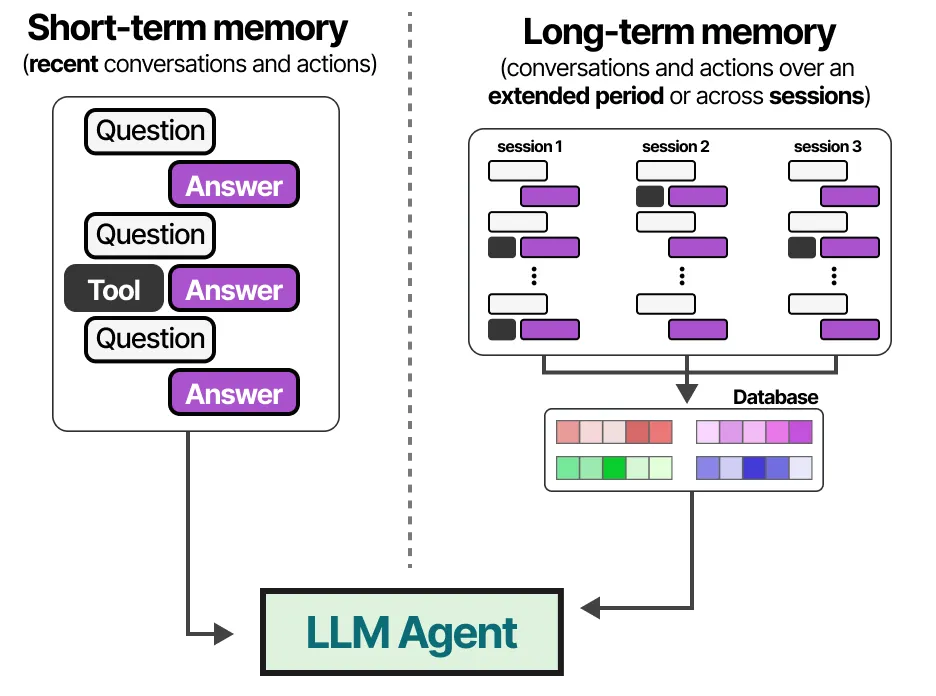
- 短期记忆
实现短期记忆的最直接方法是使用模型的上下文窗口,即 LLM 可以处理的 token 数量。
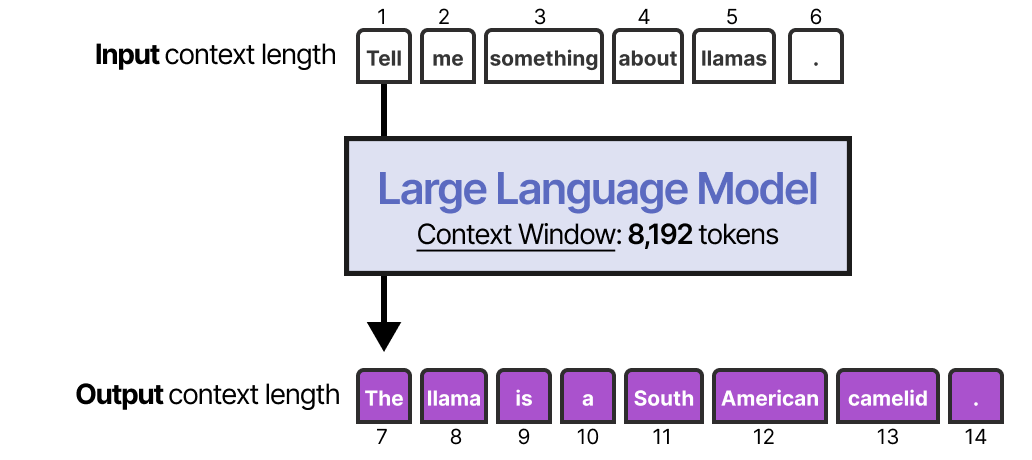
上下文窗口通常至少为 8192 个token,有时甚至可以扩展到数十万个 token。
大型上下文窗口,可用于将完整的对话历史作为输入 prompt 的一部分进行跟踪。
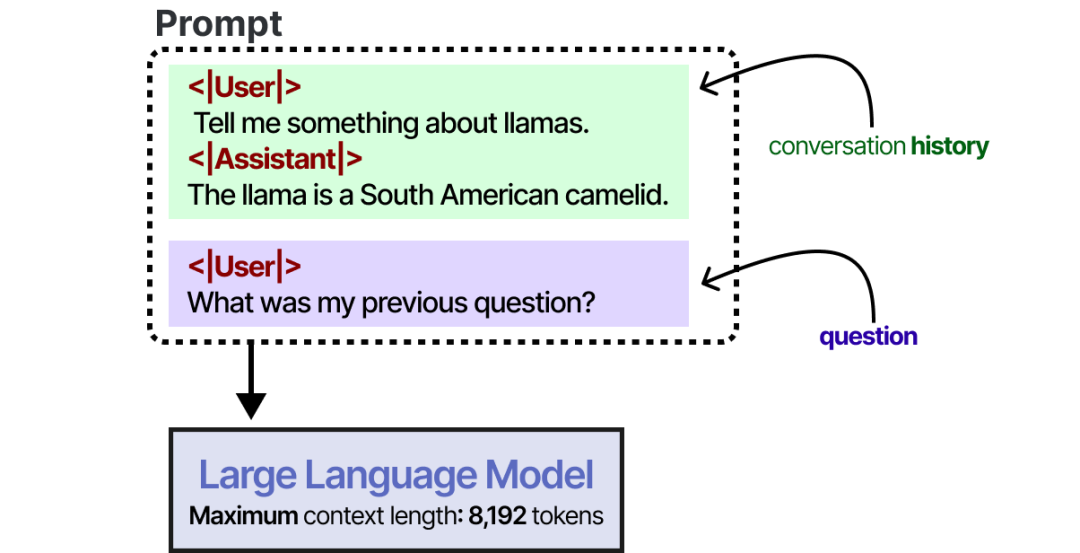
只要对话历史适合 LLM 的上下文窗口,这种方法就能有效模拟记忆。
但是,这并非真正记住对话,而只是在"告诉"LLM这个对话是什么。
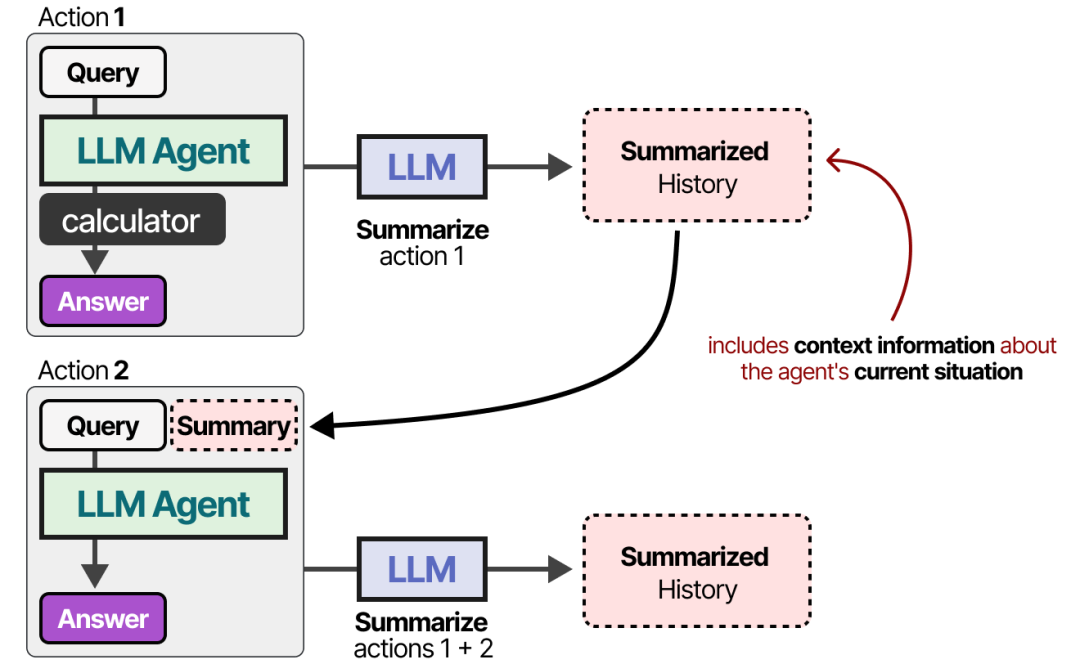
对于上下文窗口较小的模型,或者当对话历史较大时,我们可以使用另一个LLM来总结迄今为止发生的对话。
通过持续总结对话,我们可以保持较小的对话规模。这将减少 token 数量,同时只跟踪最重要的信息。
- 长期记忆
LLM Agent 的长期记忆包括需要长期保留的 Agent 过去的行动空间(即Agent 过去所有的操作、决策和互动记录,而不仅仅是静态的数据或信息)。
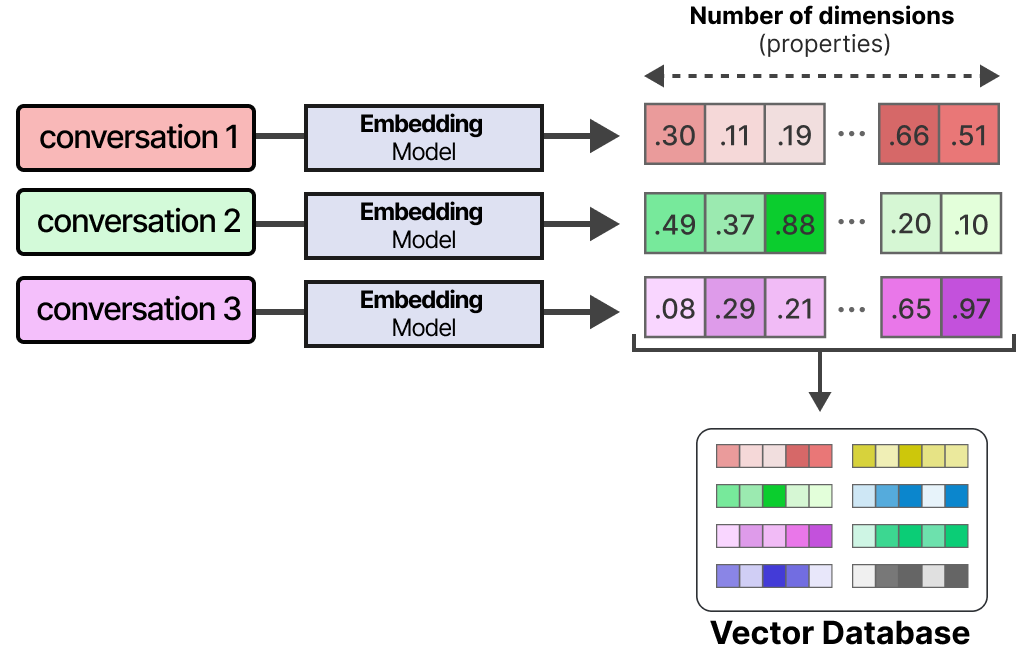
实现长期记忆的常见技术,是将所有先前的交互、行动和对话存储在外部向量数据库中。
要构建这样的数据库,首先将对话嵌入到能够捕捉其含义的数值表示中。
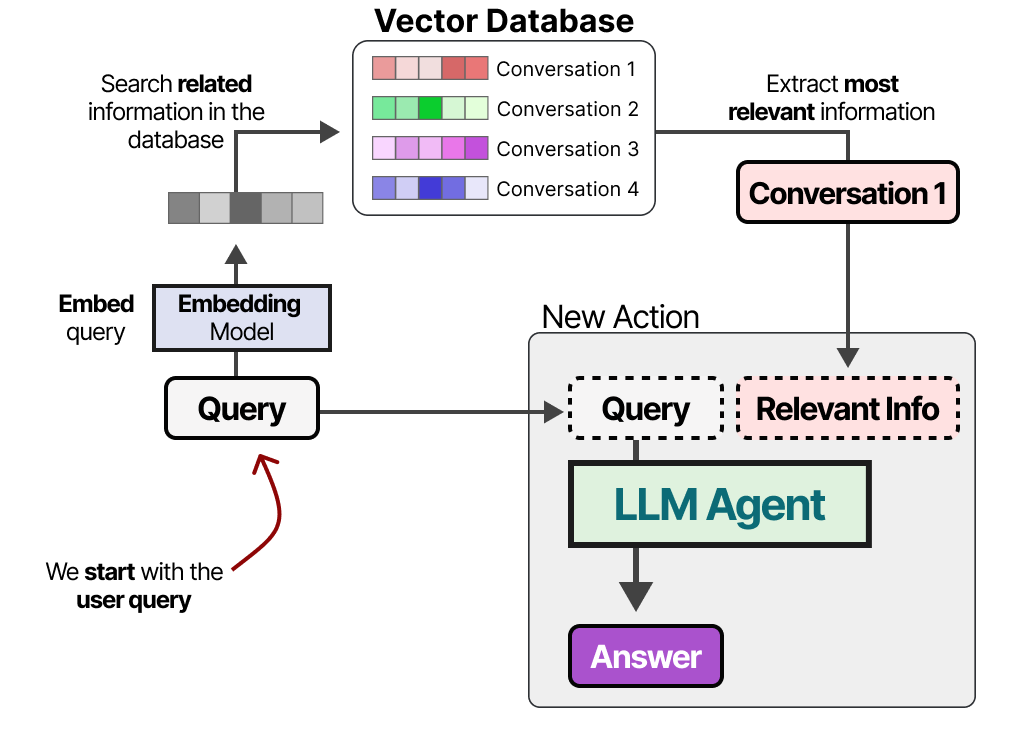
构建数据库后,我们可以嵌入任何给定的提示,并通过比较提示嵌入与数据库嵌入来找到向量数据库中最相关的信息。这种方法就是检索增强生成(Retrieval-Augmented Generation,RAG)。
长期记忆还可以涉及保留来自不同会话的信息。例如,你可能希望 LLM Agent 记住它在以前会话中所做的任何研究。
不同类型的信息也可以与不同类型的存储记忆相关联。在心理学中,有许多类型的记忆可以区分,在《Cognitive Architectures for Language Agents》论文中,将其中四种与LLM Agent 相关联。
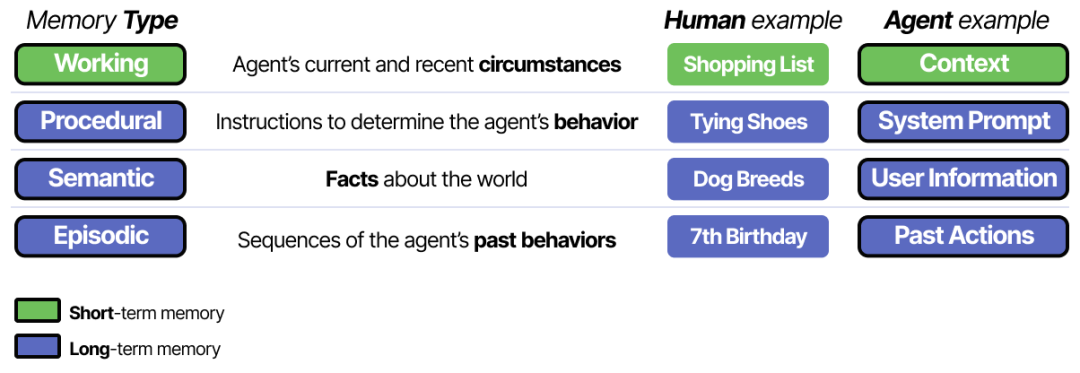
- Working Memory(工作记忆)
- 人类示例:购物清单。人类大脑用工作记忆来暂时存放、操作当前需要使用的信息,比如你在逛超市时,脑海里记着要买的东西。
- Agent示例:Context(上下文)。在LLM Agent中,工作记忆可以理解为模型在一次对话或推理过程中,需要临时“装载”的上下文信息,用于实时生成回复或执行操作。
- Procedural Memory(程序性记忆)
- 人类示例:系鞋带。人类的程序性记忆是对“如何做一件事”的技能或步骤的记忆,例如骑自行车、打字等,这些行为一旦学会,就可以相对自动地执行。
- Agent示例:System Prompt(系统提示)。对于LLM Agent而言,“程序性记忆”可以视作模型在执行任务时所依据的固定指令或规则。它规定了模型在面对某些输入时,需要如何去执行、遵循哪些步骤或约束。
- Semantic Memory(语义记忆)
- 人类示例:狗的品种。语义记忆是关于世界的通用知识、事实和概念,不依赖个人的具体经历,比如知道“巴黎是法国的首都”。
- Agent示例:User Information(用户信息)。对于LLM Agent来说,语义记忆中可以包括用户的偏好、历史对话中的关键信息、外部知识库中的事实等。这些事实类信息是与特定事件无关的通用知识。
- Episodic Memory(情景记忆)
- 人类示例:7岁生日。情景记忆是对个人经历的记忆,包含时间、地点、人物等具体情境。
- Agent示例:Past Actions(过去行为)。在LLM Agent中,这部分对应Agent在与用户或环境交互中所做出的具体操作或决策的历史记录,帮助Agent回溯和利用过去的经历来影响当前或未来的决策。
这种区分有助于构建Agent框架。语义记忆(关于世界的事实)可能存储在与工作记忆(当前和最近情况)不同的数据库中。
03
工具-Tools
工具允许LLM与外部环境(如数据库)交互,或使用外部应用程序(如运行自定义代码)。
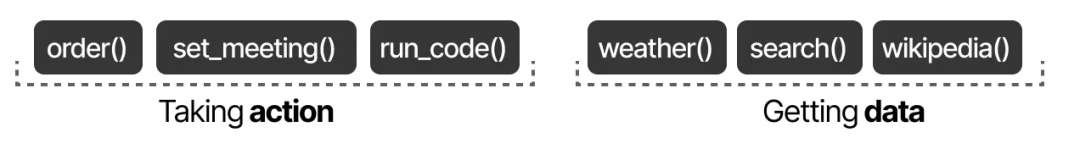
工具通常有两种用途:
-
**获取数据,**以检索最新信息;
-
采取行动,如设定会议或订购食物。
-
工具的使用方法
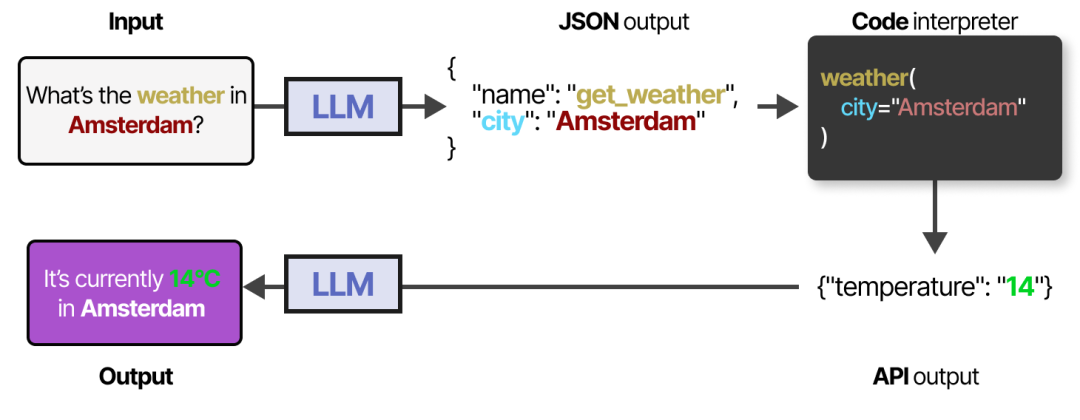
要实际使用工具,LLM 必须生成符合给定工具 API 的文本。我们通常期望生成可以格式化为 JSON 的字符串,以便它能够轻松地输到代码解释器中。
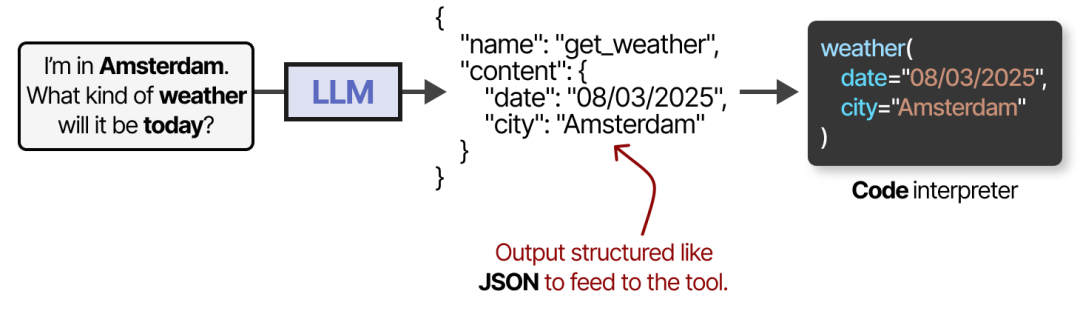
你还可以生成 LLM 能直接使用的自定义函数,比如基本的乘法函数。这通常被称为函数调用- function calling。
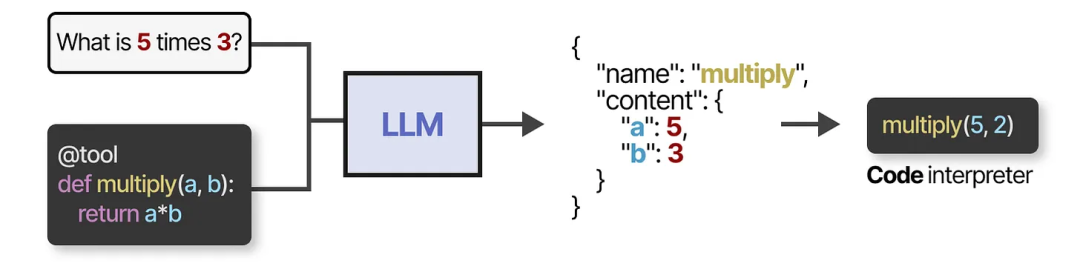
如果提示词足够准确,一些 LLM 可以使用任何工具。工具使用是大多数当前 LLM 都具备的能力。
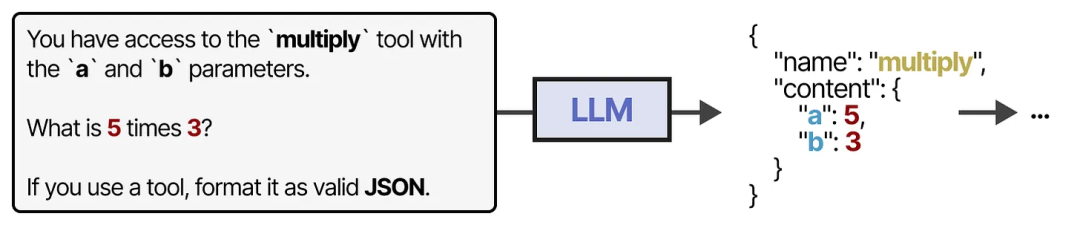
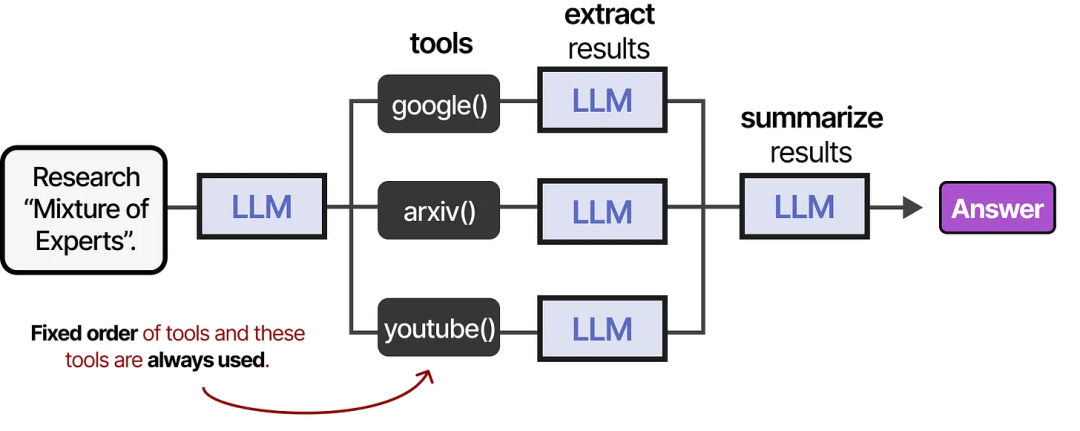
如果Agent框架是固定的,工具可以按照特定顺序使用;
或者 LLM 可以自主选择使用哪种工具以及何时使用。
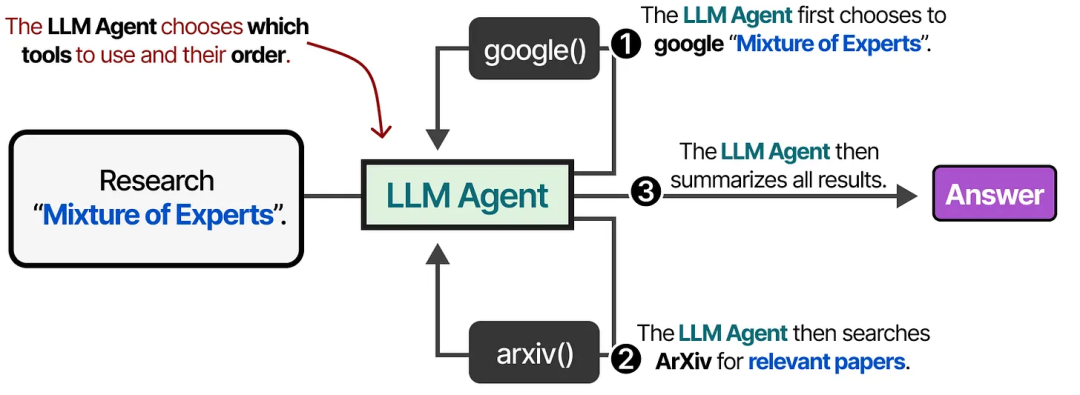
LLM 调用序列的中间步骤,会被反馈回 LLM 以继续处理。
可以认为,LLM Agent,本质上是 LLM 调用的序列(但具有自主选择行动/工具等的能力)。
- 模型上下文协议(MCP)
工具是Agent框架的重要组成部分,使 LLMs 能够与世界交互并扩展其能力。
然而,当存在多种不同API时,启用工具使用变得麻烦,因为任何工具都需要:
- 手动跟踪并输入到LLM中
- 手动描述(包括其预期的JSON schema)
- 每当API发生变化时,手动更新
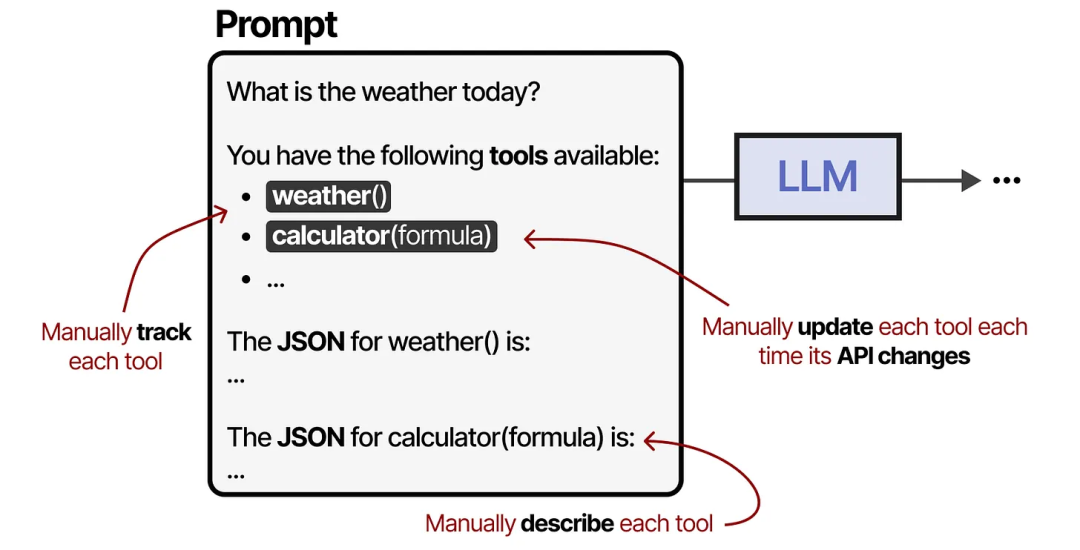
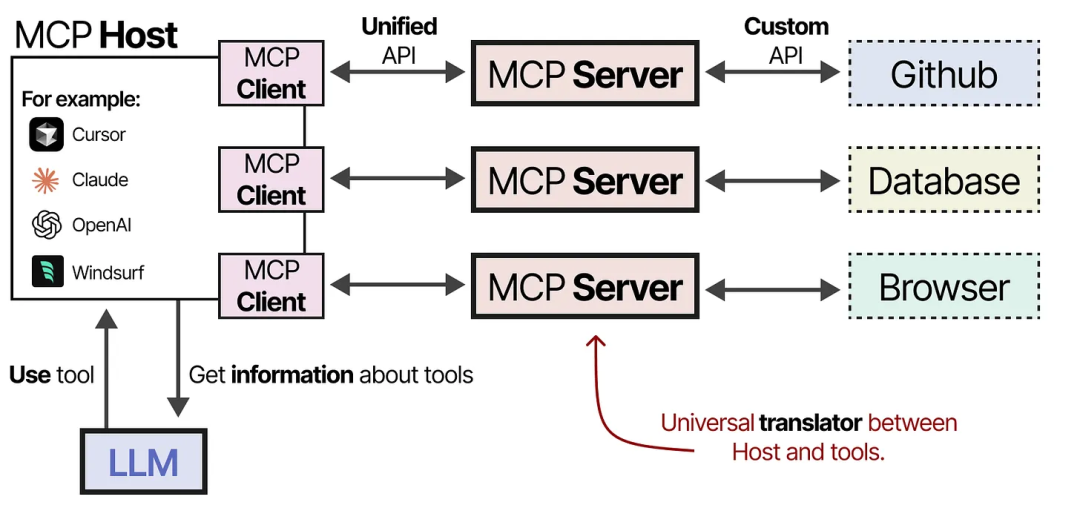
为了使工具在任何Agent框架中更容易实现,Anthropic 开发了 Model Context Protocol (MCP)。
MCP为天气应用和 GitHub 等服务标准化了 API 访问。
它由三个组件组成:
- MCP Host(宿主) — LLM 应用程序(如 Cursor)负责管理连接;
- MCP Client(客户端) — 维护与 MCP 服务器的 1:1 连接;
- MCP Server(服务器) — 向 LLMs 提供上下文、工具和功能;
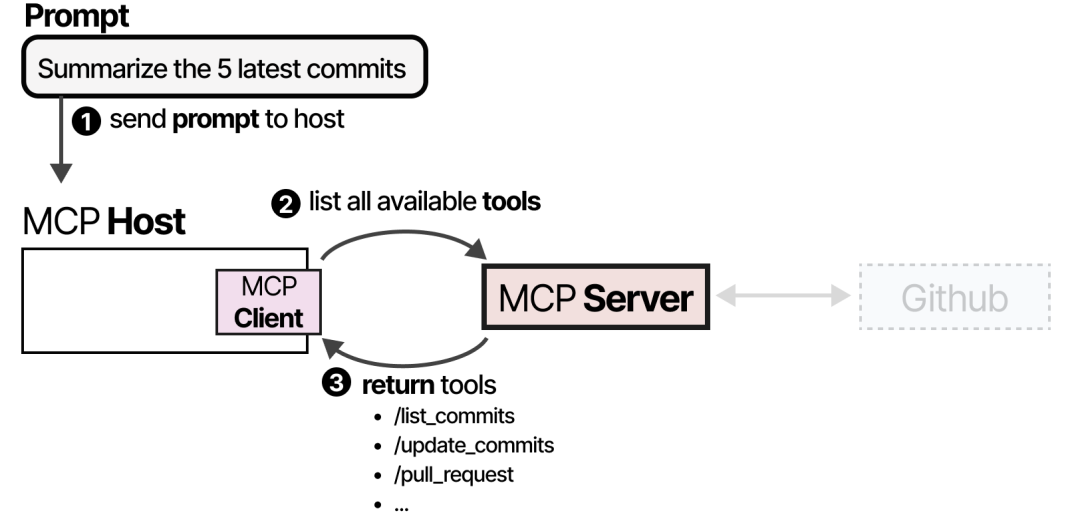
例如,假设你希望某个 LLM 应用程序总结你的代码仓库中最新的5个提交,MCP Host(与 MCP Client一起)会首先调用 MCP Server 询问哪些工具可用。
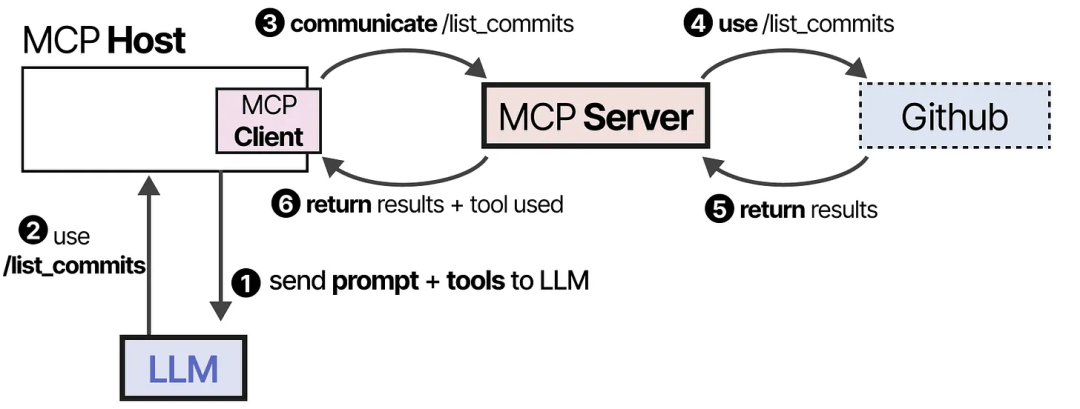
LLM 接收这些信息后,可能会选择使用某个工具。它通过 Host 向 MCP Server发送请求,然后接收结果,包括所使用的工具。
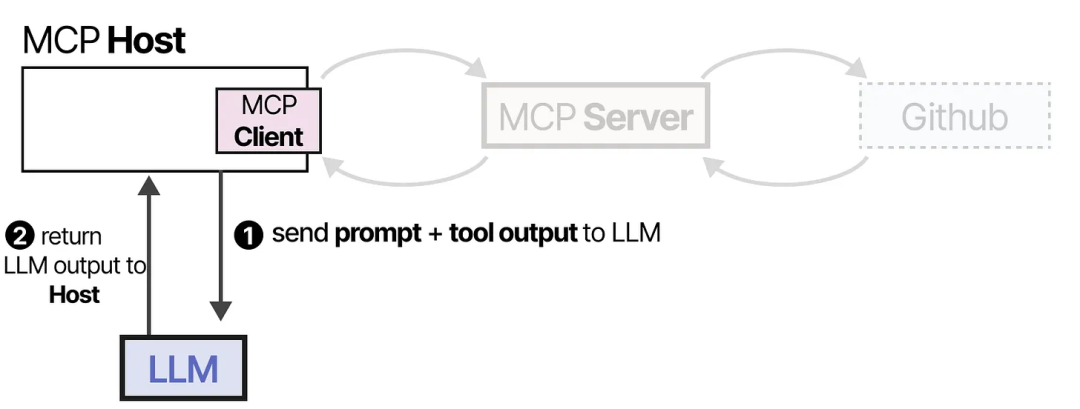
最后,LLM 接收结果并能够解析出回答给用户。
这个框架通过连接到任何 LLM 应用程序都可以使用的 MCP Servers,使创建工具变得更加简单。因此,当你创建一个与 Github 交互的 MCP Server时,任何支持 MCP 的LLM 应用程序都可以使用它。
04
规划-Planning
在Agent系统中,LLM 如何决定使用哪个工具以及何时使用呢?
这就是规划(planning)。
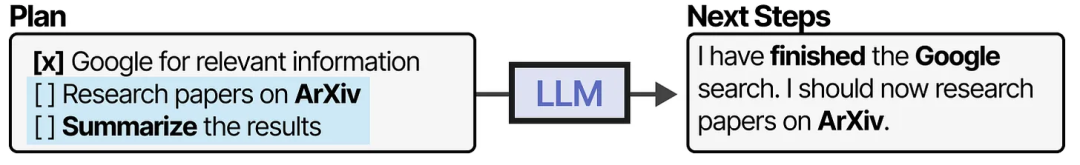
LLM Agents 中的规划涉及将给定任务分解为可执行的步骤。
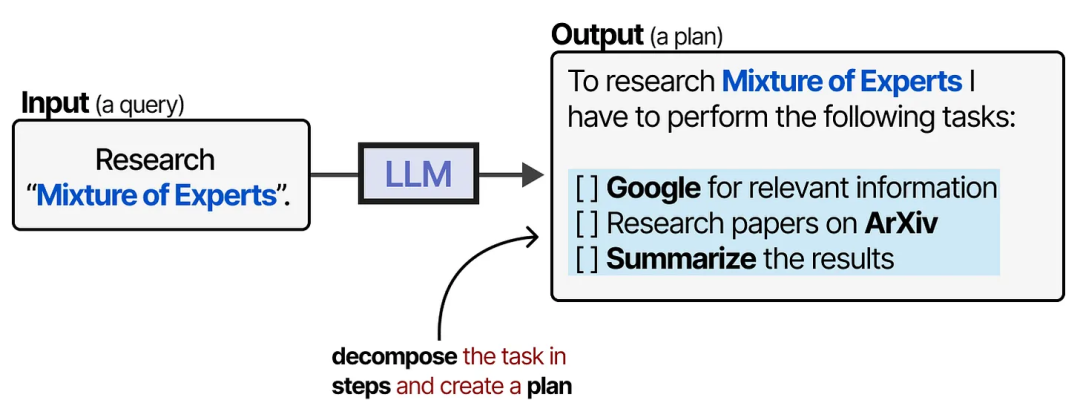
这种规划使模型能够迭代地反思过去的行为,并在必要时更新当前计划。
要在LLM Agent中实现计划能力,让我们首先看看这种技术的基础,即:推理能力。
- 推理(Reasoning)
规划可执行步骤需要复杂的推理行为。因此,LLM 必须能够展示这种行为,然后才能进行任务规划的下一步。
"推理型"LLM是那些倾向于在回答问题前先"思考"的模型。
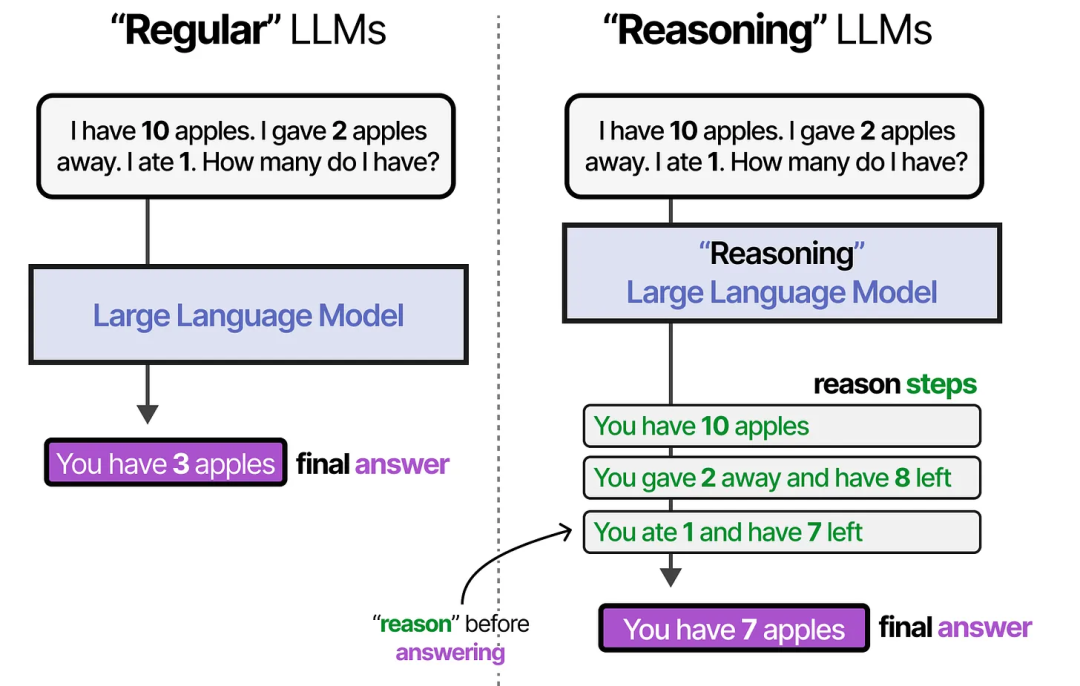
这种推理行为大致可以通过两种选择来实现:特定的提示工程(prompt engineering)或者微调LLM。
通过提示工程,我们可以创建 LLM 应遵循的推理过程示例。提供示例(也称为少样本提示,few-shot prompting)是引导 LLM 行为的一种优秀方法。
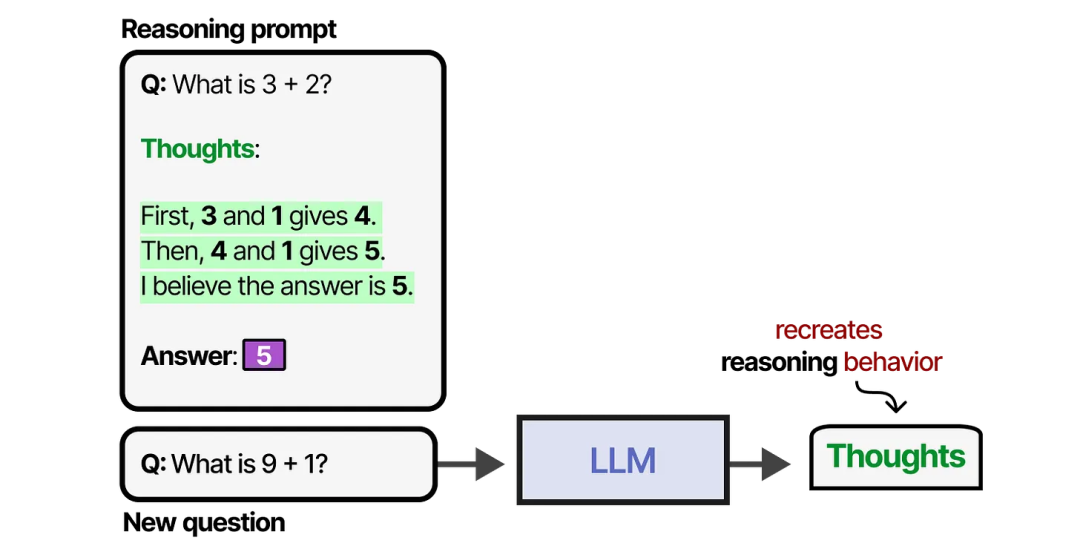
这种提供思考过程示例的方法被称为思维链(Chain-of-Thought),它能够实现更复杂的推理行为。
思维链也可以在没有任何示例(零样本提示,zero-shot prompting)的情况下实现,只需简单地说明"让我们一步步思考"。
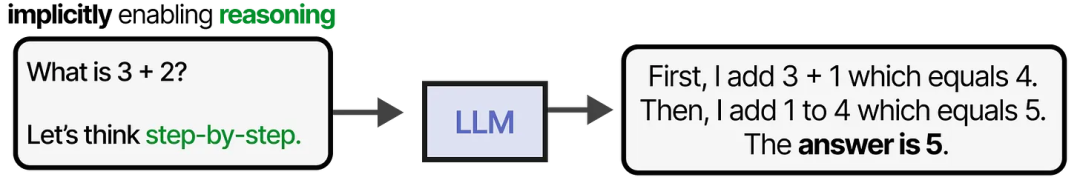
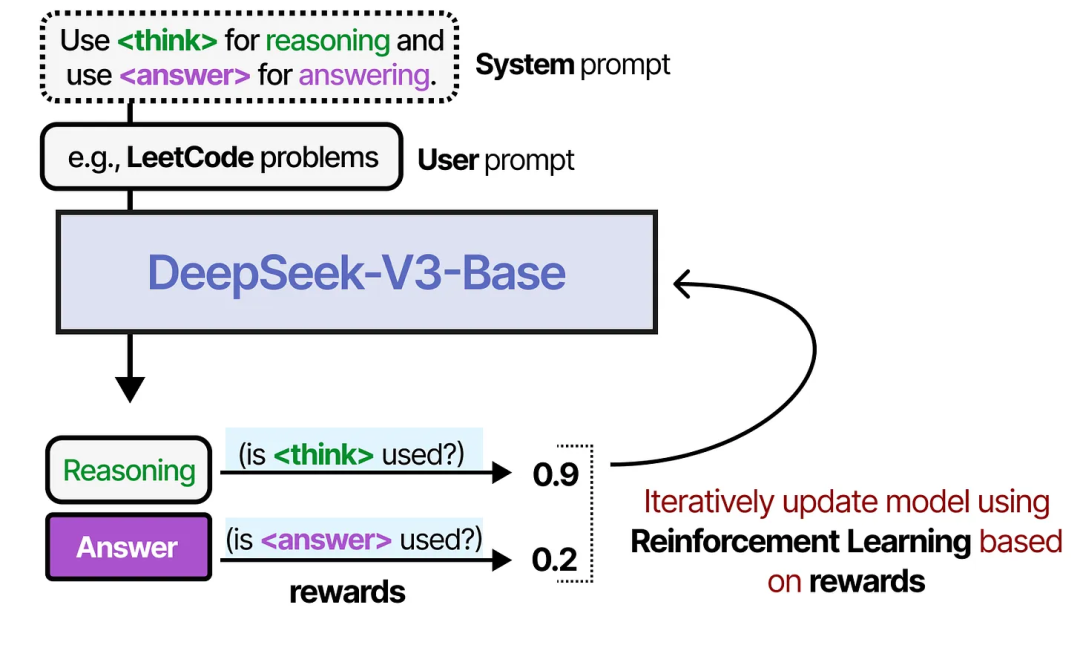
在训练 LLM 时,我们可以给它提供足够数量包含思考类示例的数据集,或者 LLM 可以发现自己的思考过程,比如使用强化学习。
DeepSeek-R1是一个很好的例子,它使用奖励机制来引导思考过程的使用。
- ReAct(Reason and Act)
推理形成思维链(Chain-of-Thought),使用工具实现与环境交互。
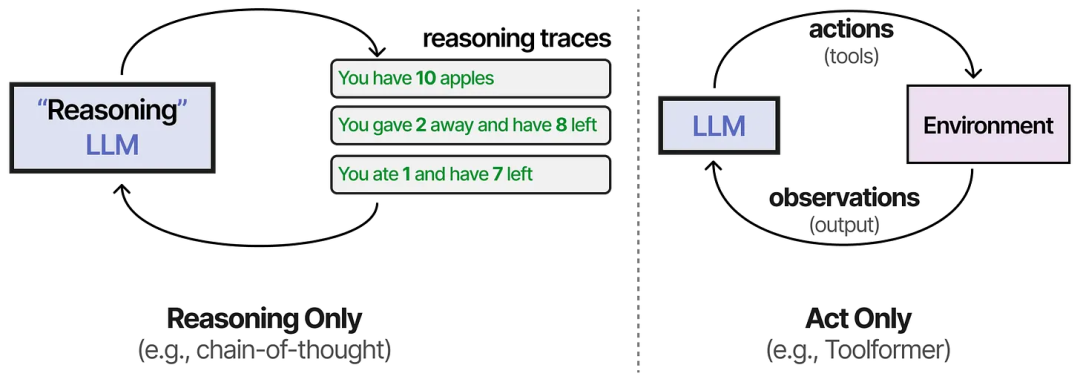
将这两个过程结合起来的技术之一,被称为 ReAct(Reason and Act)。
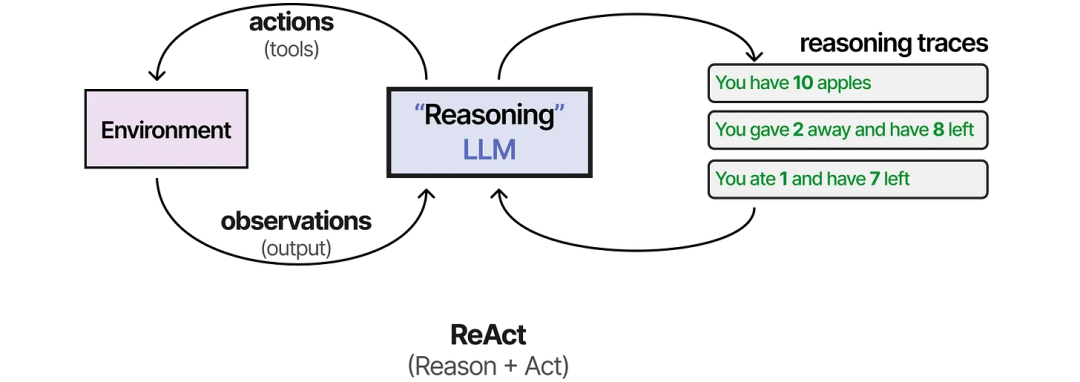
ReAct通过精心设计的提示工程来实现这一点。ReAct提示描述了三个步骤:
- 思考(Thought) - 关于当前情况的推理步骤
- 行动(Action) - 要执行的一系列行动(例如,使用工具)
- 观察(Observation) - 关于行动结果的推理步骤
提示本身相当直接:
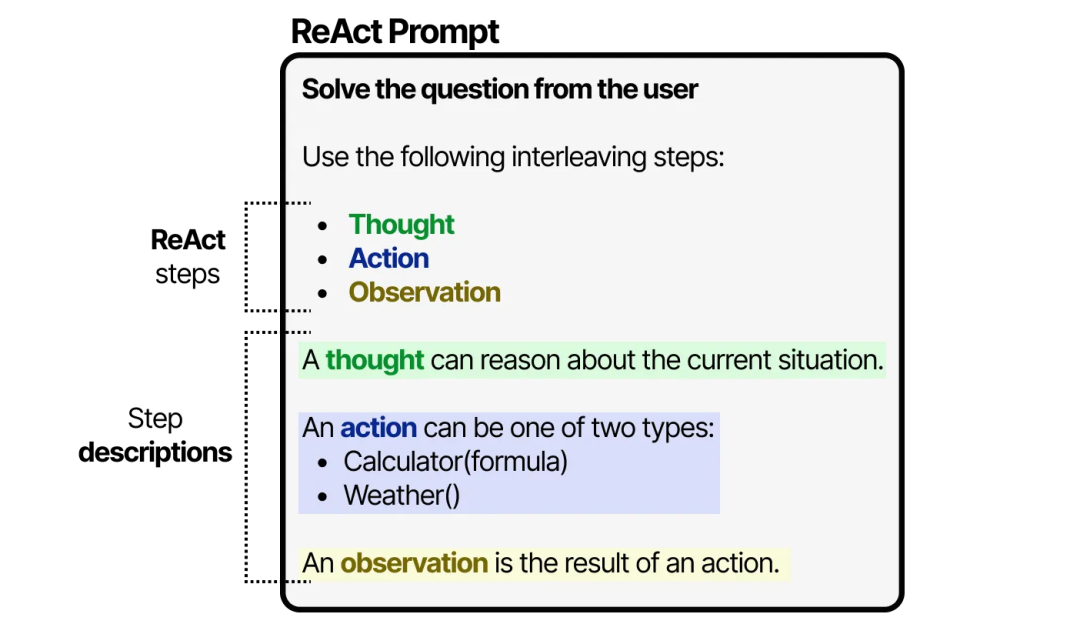
LLM使用这个提示(可作为系统提示使用)来引导其行为,在思考、行动和观察的循环中工作。
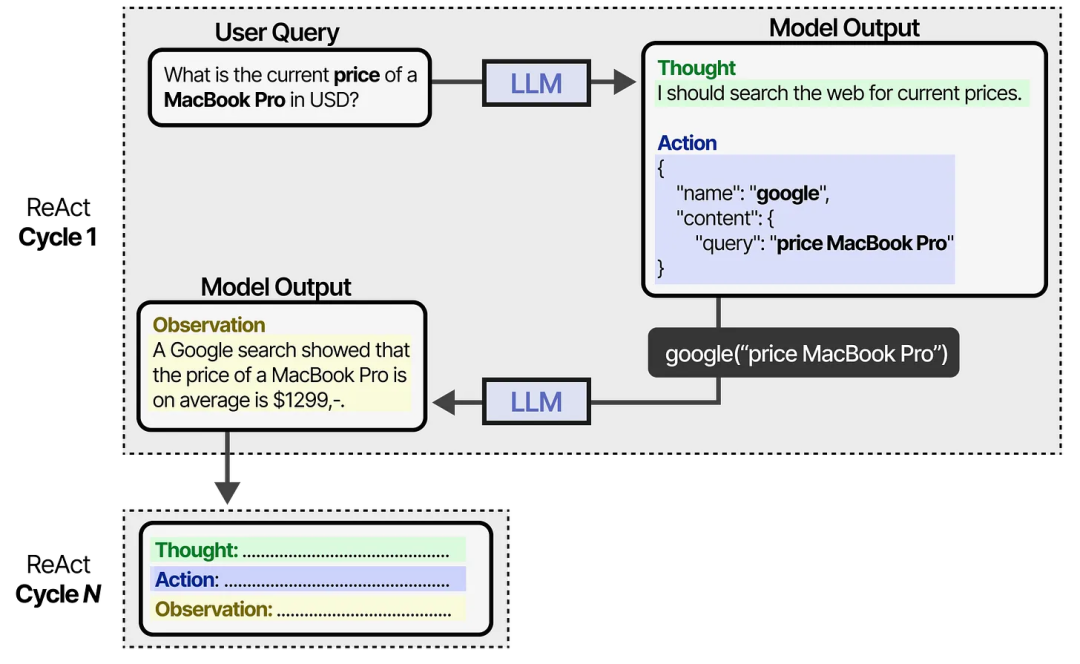
它会一直保持这种行为,直到某个行动指示返回结果。通过对思考和观察的迭代,LLM 可以规划行动,观察其输出,并相应地进行调整。
因此,与那些预定义固定步骤的Agent相比,这个框架使 LLMs 能够展示更加自主的Agent行为。
- 反思(Reflecting)
采用 ReAct 的LLM也可能会失败,此时可以采用反思(Reflexion)技术,这是一种使用语言强化来帮助Agent从先前失败中学习的技术。
该方法假设三个LLM角色:
- 执行者(Actor) — 根据状态观察选择并执行行动。我们可以使用思维链或ReAct等方法。
- 评估者(Evaluator) — 对执行者产生的输出进行评分。
- 自我反思(Self-reflection) — 反思执行者采取的行动和评估者生成的评分。
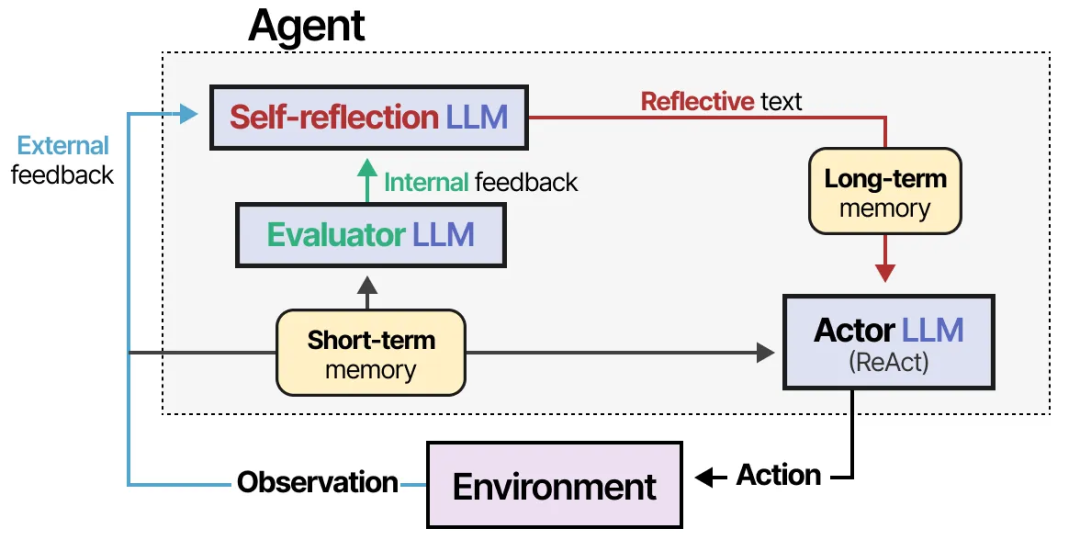
添加了内存模块来跟踪行动(短期)和自我反思(长期),帮助 Agent 从错误中学习并识别改进的行动。
一种类似但更优雅的技术被称为Self-Refine,其中反复执行精炼输出和生成反馈的行动。
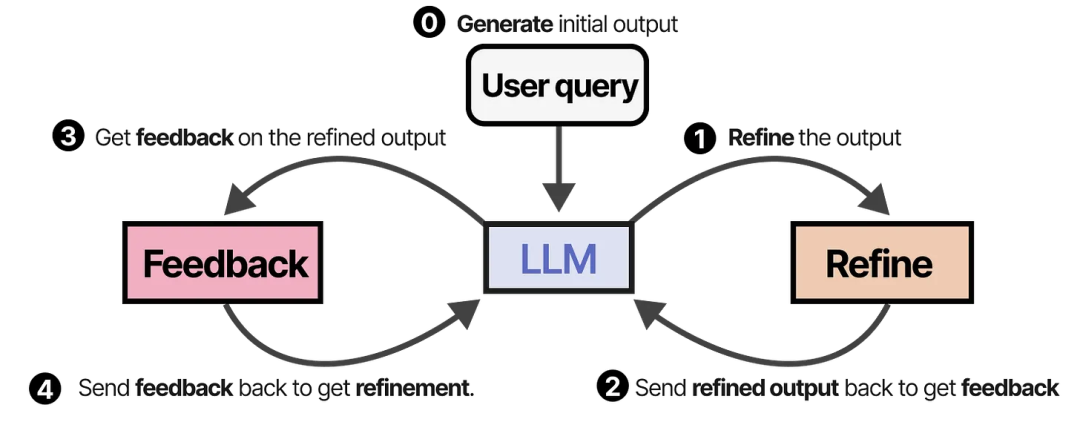
同一个LLM负责生成初始输出、精炼后的输出和反馈。
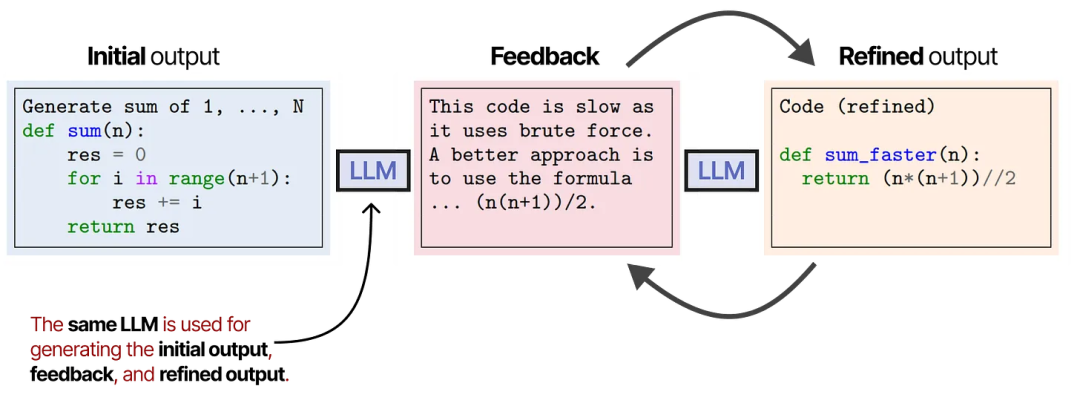
有趣的是,这种自我反思行为,无论是Reflexion还是Self-Refine,都与强化学习非常相似(强化学习中,基于输出质量给予奖励)。
05
多智能体协同
本文前面提到的单一Agent存在一些问题:工具太多可能导致选择困难,上下文变得过于复杂,并且某些任务可能需要更专业化的处理。
因此,我们可以考虑使用多智能体(Multi-Agent)框架,这类框架由多个 Agent 组成,每个 Agent 都有自己的工具、记忆与规划能力,它们之间能够相互交互,并与环境产生互动。
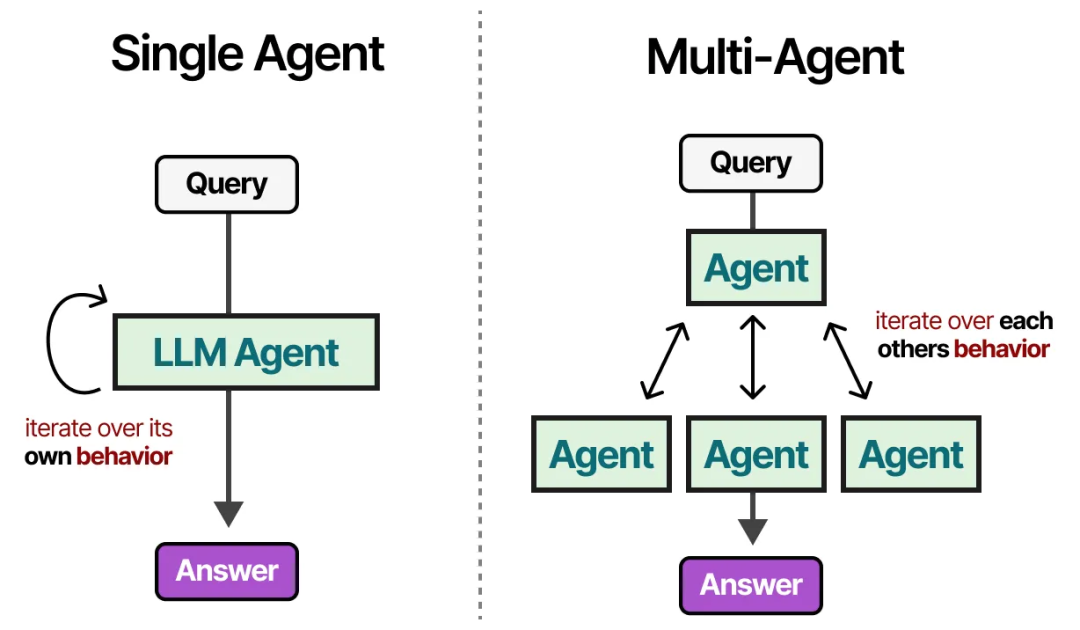
这些多智能体系统通常由专门的智能体组成,每个智能体拥有自己的工具集,并由一个主管(Supervisor)来进行管理。主管负责协调智能体之间的通信,并将特定任务分配给专业化的智能体。
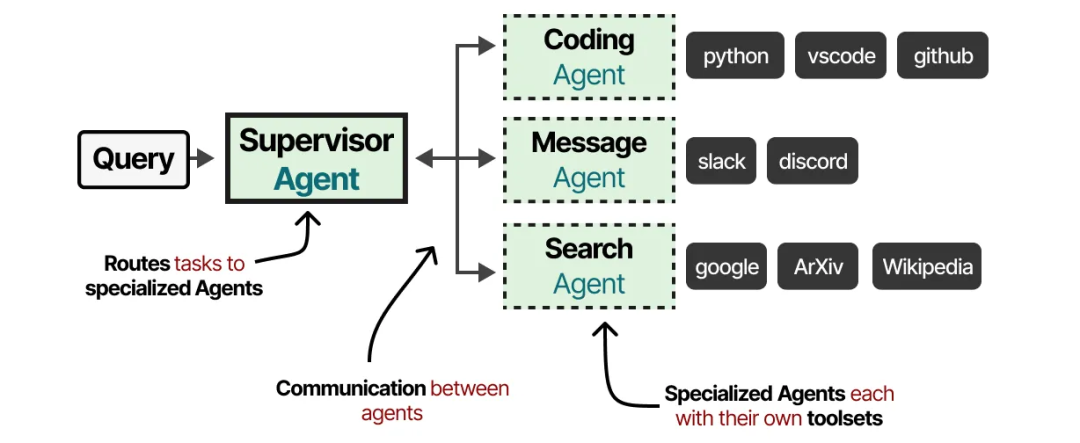
每个 Agent 可能配备不同类型的工具,并可能拥有不同的记忆系统。
实际上,已有数十种多智能体架构,它们的核心通常包括以下两个组件:
- 智能体初始化(Agent Initialization)—— 如何创建个体(专门的)智能体?
- 智能体编排(Agent Orchestration)—— 如何协调所有智能体?
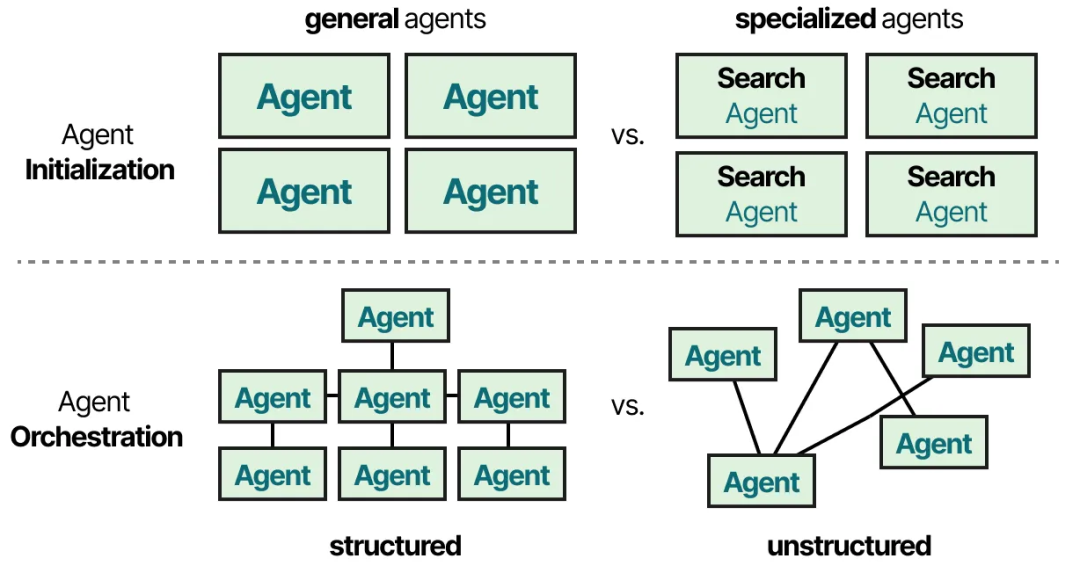
无论你选择哪种框架创建多智能体系统,这些框架通常由多个要素组成,包括智能体的配置文件、对环境的感知、记忆、规划以及可用的行动。
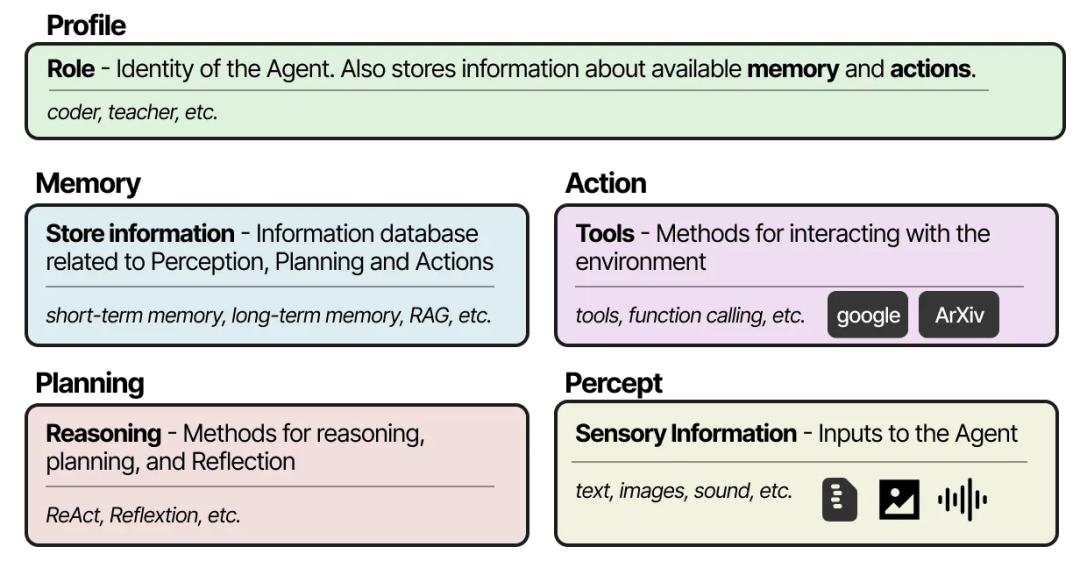
用于实现这些组件的热门框架包括 AutoGen、MetaGPT 和 CAMEL。然而,每个框架处理智能体间通信的方式略有不同。
例如,在 CAMEL 中,用户首先提出问题,并定义 AI 用户(AI User)和 AI 助理(AI Assistant)的角色。AI 用户角色代表人类用户,并引导整个过程。
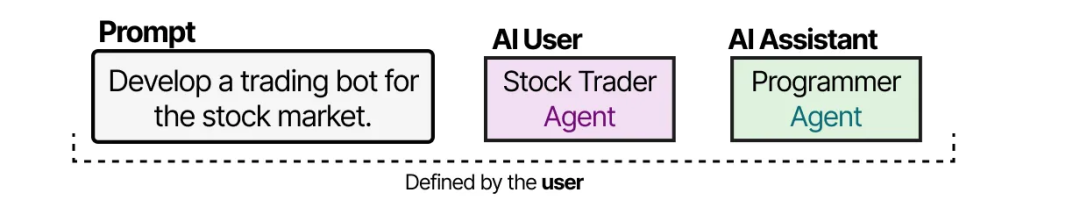
随后,AI 用户与 AI 助理相互协作,通过交互来解决问题。
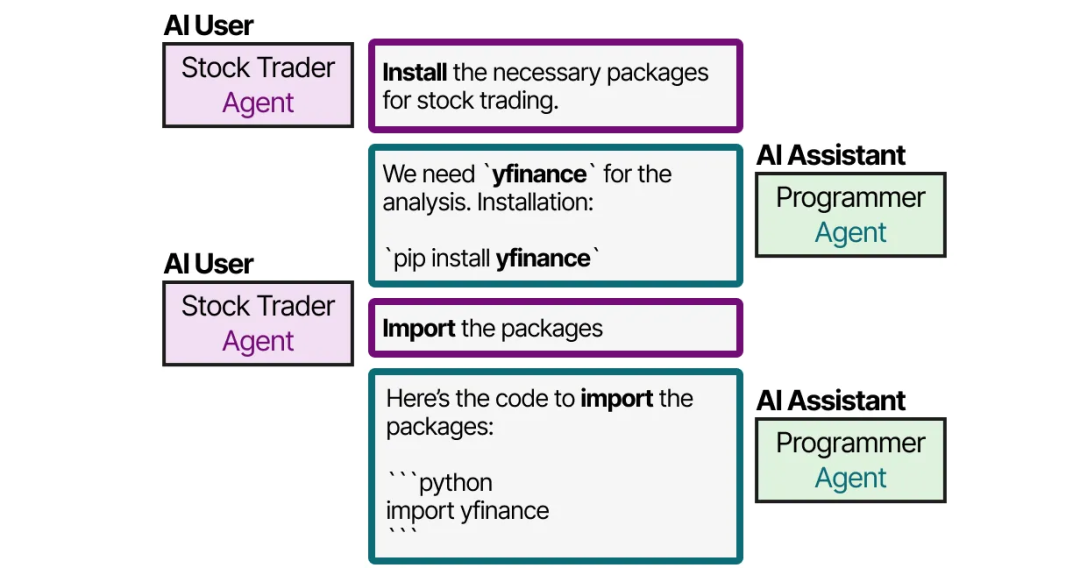
这种角色扮演的方法实现了智能体之间的协作交流。
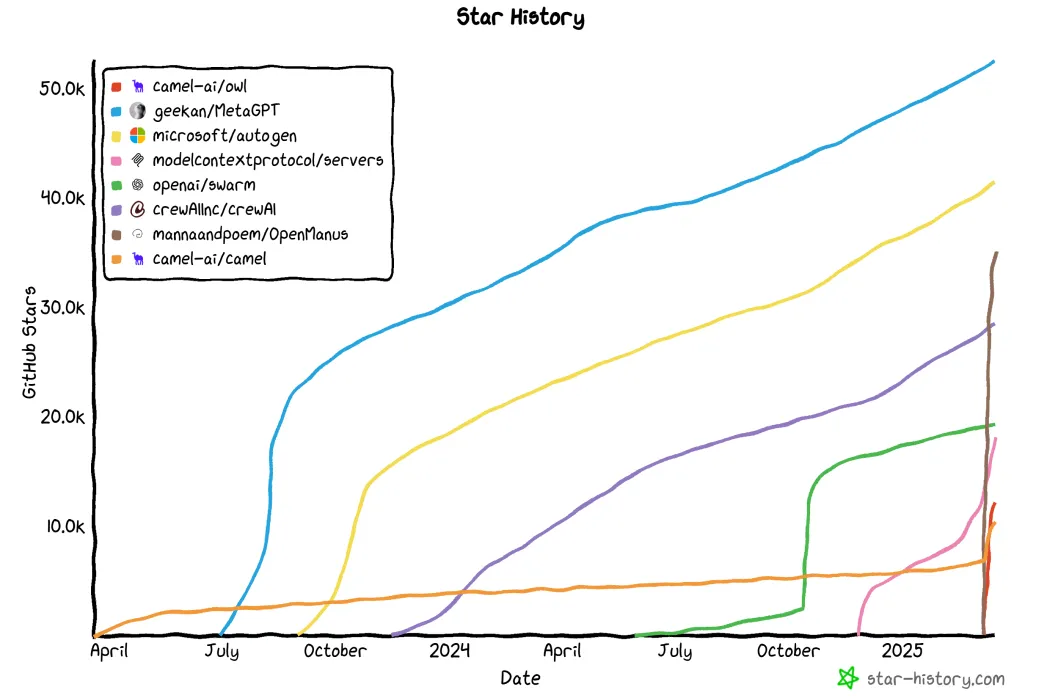
AutoGen 和 MetaGPT 的通信方法虽然有所不同,但本质上都是基于这种协作性质的通信。智能体可以相互交流,以更新自身状态、目标以及下一步行动。
过去一年,这些框架呈现出爆发式的增长。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 1209


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


