刚刚!Meta官宣!两篇Agent Learning论文,给AI智能体指明了新方向!

从零构建AI智能体:OpenRouter Ori Prime Agent实战指南 在AI应用开发中,大语言模型API调用与智能体(Agent)架构是核心技术概念。API调用提供了基础的文本生成能力,而智能体则通过规划、工具使用和记忆等机制,实现了更复杂的任务自动化与推理能力。其技术价值在于将大模型从单纯的文本生成器升级为可执行多步骤工作流的自主系统,广泛应用于客服自动化、数据分析、代码生成等场景。本文聚焦于OpenRouter平台及其Ori Prime Agent功能,通过实战演示如何利用统一网关管理多模型调用,并构建具备工具调用能力的智能体。内容涵盖从基础API连通性测试到完整智能体循 阅读详情

今天分享Meta SuperLabs最新发表的2篇关于Agent Learning的论文:

  • 2025.11 《Scaling Agent Learning via Experience Synthesis》
  • 2025.10 《Agent Learning via Early Experience》

两篇文章从“如何低成本获得高质量经验”出发,形成一条完整技术链:
离线专家数据 → 早期经验增广 → 合成环境狂飙 → Sim-to-Real 微调,为语言智能体进入“规模化 RL 时代”提供可复现的路线图。

一、Agent RL 的三座大山

  1. rollout 太贵
    WebArena 一次完整交互≈30 s,812 任务全跑一遍≈6.8 小时,训练 GRPO 动辄 80 k transitions。
  2. 奖励稀疏甚至缺失
    网页场景无 ground-truth 奖励;form 提交成功≠字段全对。
  3. 任务多样性不足
    手工写 800 条指令已是天花板,难以支持课程化训练。

二、Early Experience:把“专家演示”变成“经验海洋”

2.1 思想一句话

与其等环境给奖励,不如让 agent 自己“试一脚”——用产生的未来状态当监督信号。

2.2 两大技术路线

路线输入输出目标
Implicit World Modeling (IWM)(s, a’)s’学会“预测下一步世界”
Self-Reflection (SR)(s, a_expert, a’, s’)自然语言反思 c学会“为什么专家更好”

图 1:从人类数据时代 → 早期经验时代 → 完全经验时代

2.3 数据飞轮

  1. 从专家轨迹 Dexpert 中采样状态 si
  2. 用初始策略 πθ 生成 K 个替代动作 aji
  3. 在真实环境执行,收集 (si, aji, sji) 构成 Drollout
  4. 用 Drollout 做 IWM 或 SR 的增广训练
  5. 微调后的 πθ 继续产生更多 Drollout → 正向循环

2.4 结果速览

Table2 8个benchmarks结果

OOD结果

结论:仅需 1/8 专家数据即可打平 IL 全量效果,且 OOD 泛化增益更大。

三、DreamGym:再往前一步,把“真实交互”直接省掉

3.1 核心洞察

Agent 训练不需要完美仿真,只需要“足够多样、因果一致、可解释”的经验。

于是作者用一个 LLM 扮演 Experience Model,直接“推理”出下一状态与奖励,形成“零真实 rollout”的 RL 训练场。

Fig-2 DreamGym 框架

图 2:Experience Model 交替与 Agent 交互,Replay Buffer 持续更新,Task Generator 动态产出高熵任务

3.2 三大组件

组件作用关键技巧
Reasoning Experience Model给定 (s, a, τ, 历史, 相似轨迹) → (s’, r) + CoT 解释抽象文本状态空间,过滤 HTML 噪声
Experience Replay Buffer离线种子 + 在线新生成,top-k 相似检索防幻觉持续与策略共进化
Curriculum Task Generator选“成功率≈50%”的高熵任务 → 产生变体保证信息增益最大

3.3 实验亮点

DreamGym不同agnet训练算法结果

DreamGym 零真实交互即可打平甚至超越传统 RL;再叠加 5 k 真实 rollout(DreamGym-S2R)直接 +8~10% 绝对增益。

case分析

四、技术对比:Early Experience vs DreamGym

维度Early ExperienceDreamGym
是否触碰真实环境✅ 需要执行替代动作❌ 完全合成
奖励信号无需奖励,用 s’ 监督自产奖励 r∈{0,1}
数据效率10× 专家数据压缩2 k-10 k 过渡即可训练
与 RL 衔接提供热启动,后续接 GRPO直接内置 PPO/GRPO
最大瓶颈仍需真实 rollout 采集依赖 LLM 推理能力,存在幻觉风险

体验即数据,推理即环境

从 Early Experience 到 DreamGym,两条工作共同指向一个核心趋势——

“经验”不再是昂贵采集的稀缺品,而是可以靠大模型按需合成的数据原材料。

当“体验”可以被无限生成、“奖励”可以被即时推理,语言智能体才真正迈入**“ scalable RL ”的飞轮时代。对于工业界而言,这意味着“小样本专家轨迹 + 大模型合成”**将成为新的标准范式,而“真实环境”只用在最后 5% 的关头做校准——轻量、低成本、可扩展,下一轮 agent 爆发或许就此开启。

https://arxiv.org/pdf/2510.08558https://arxiv.org/pdf/2511.03773

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

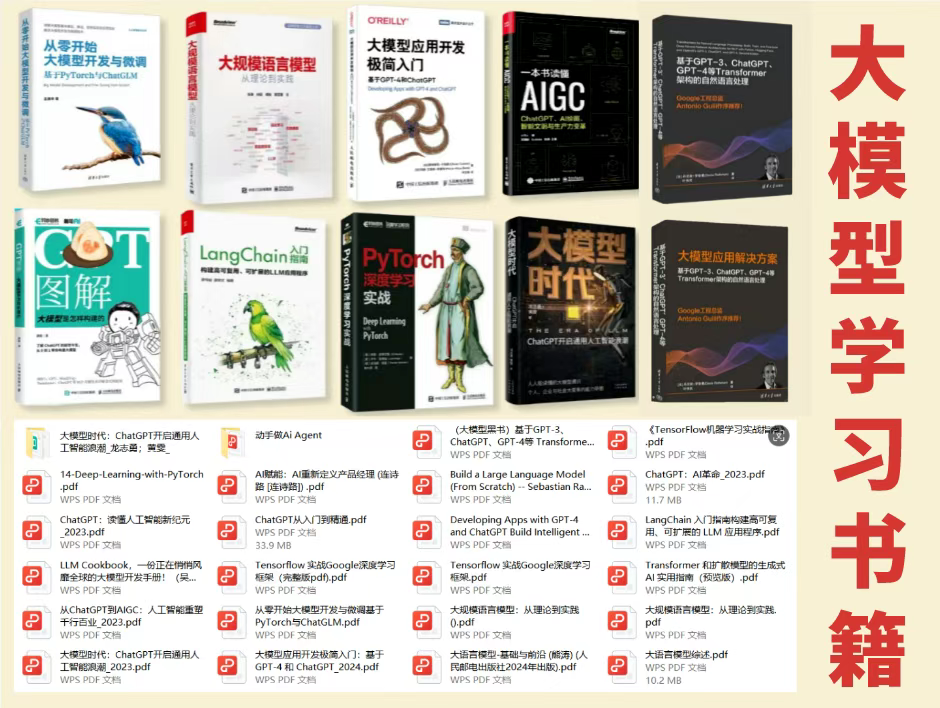
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

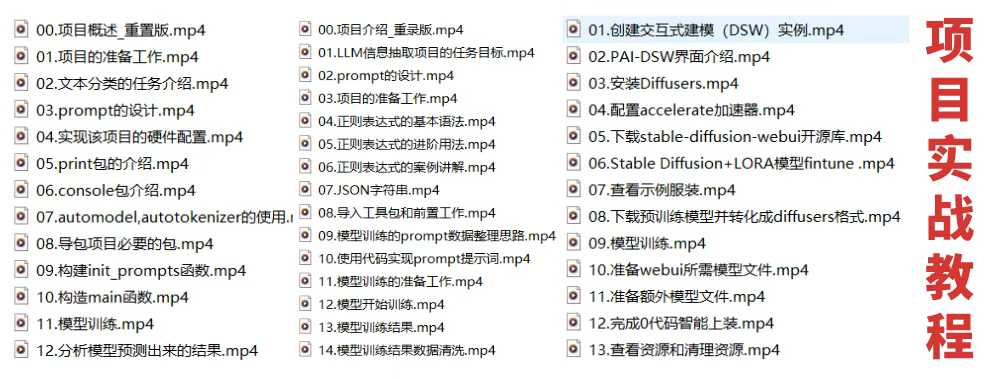
配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

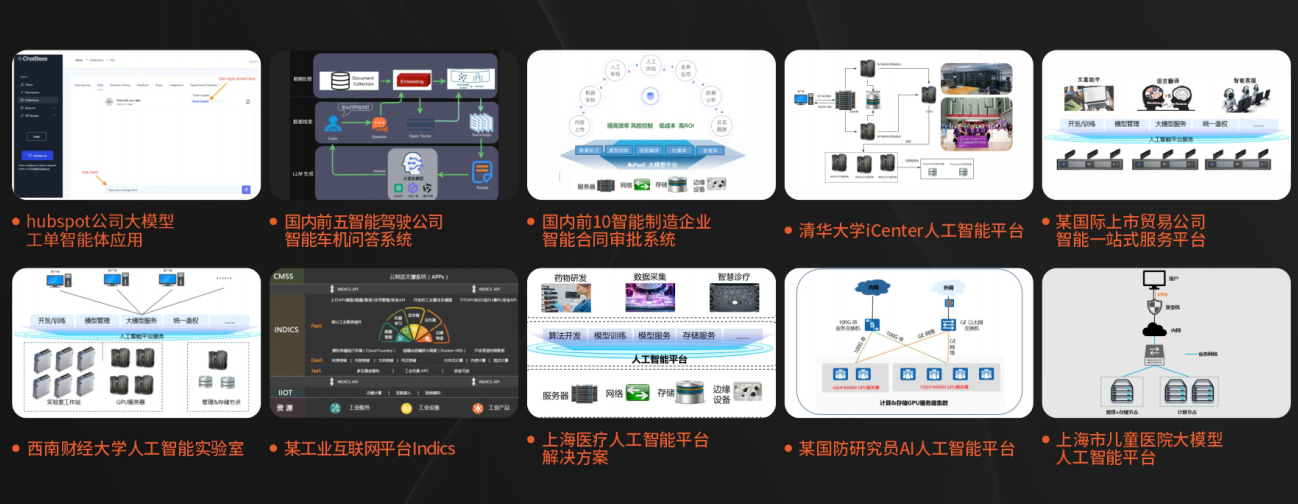
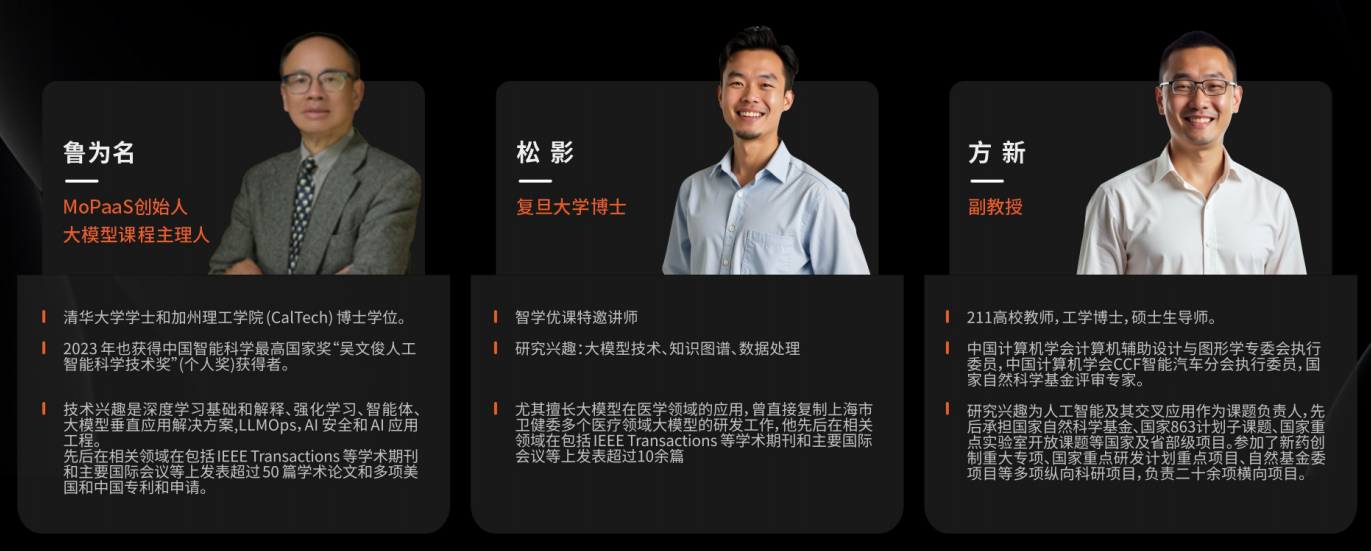
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

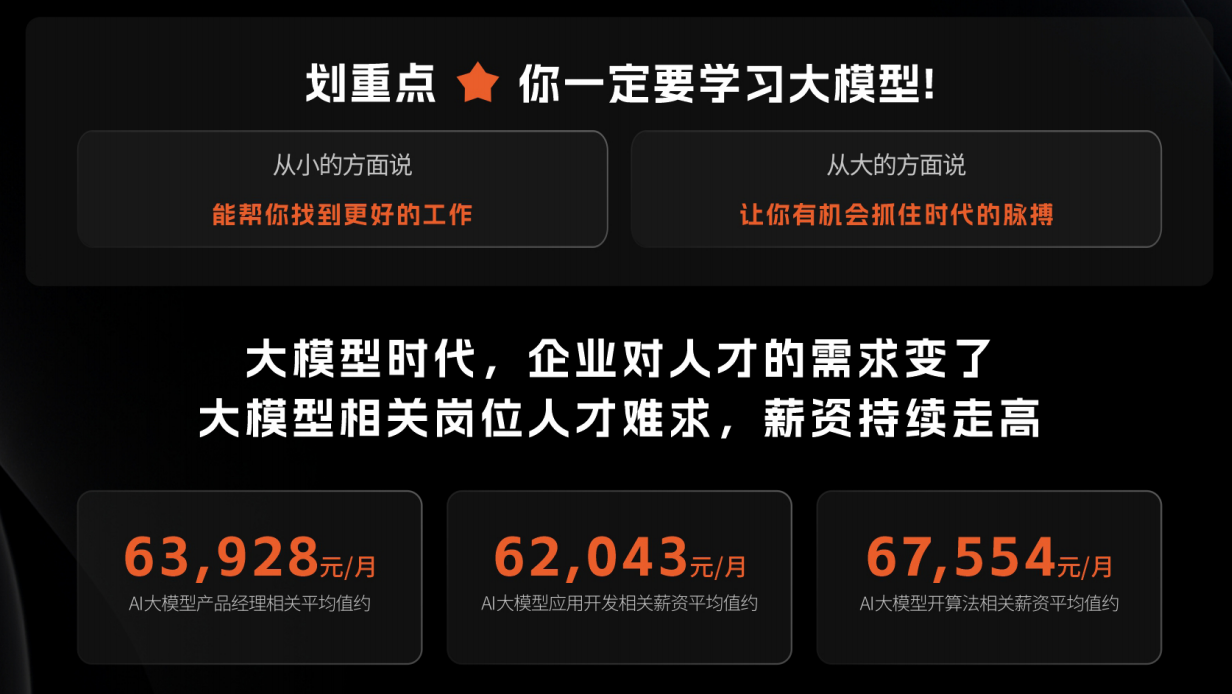
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

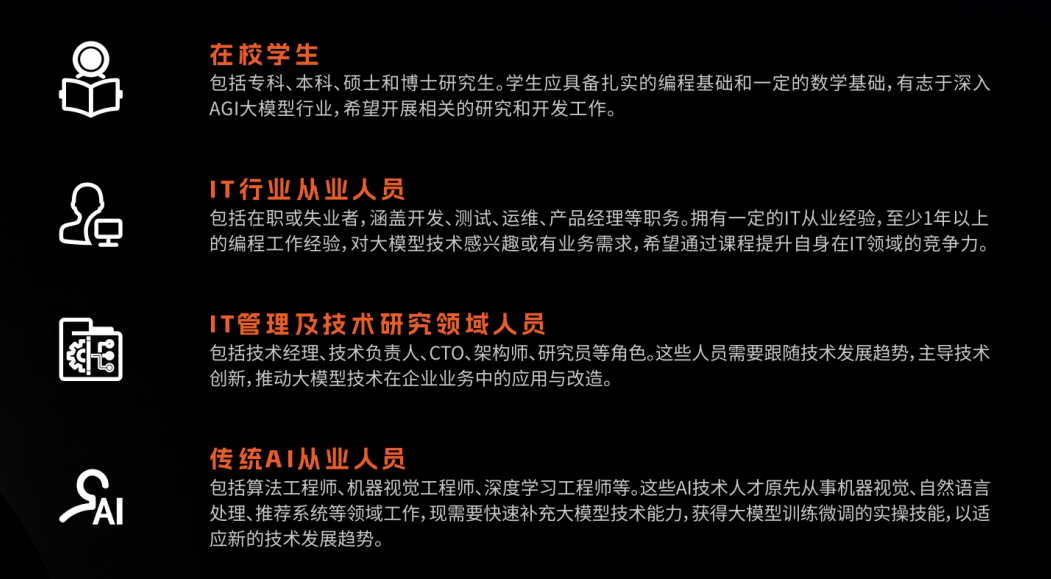
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。
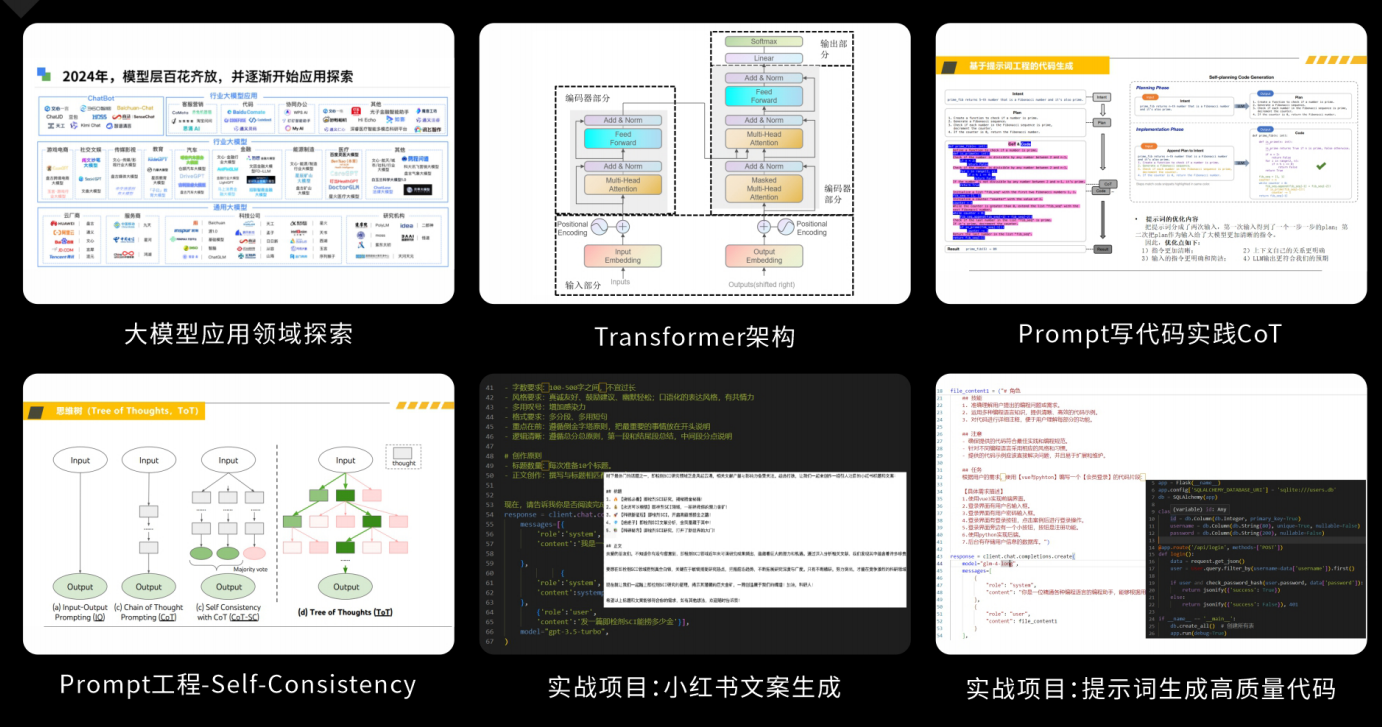
在这里插入图片描述
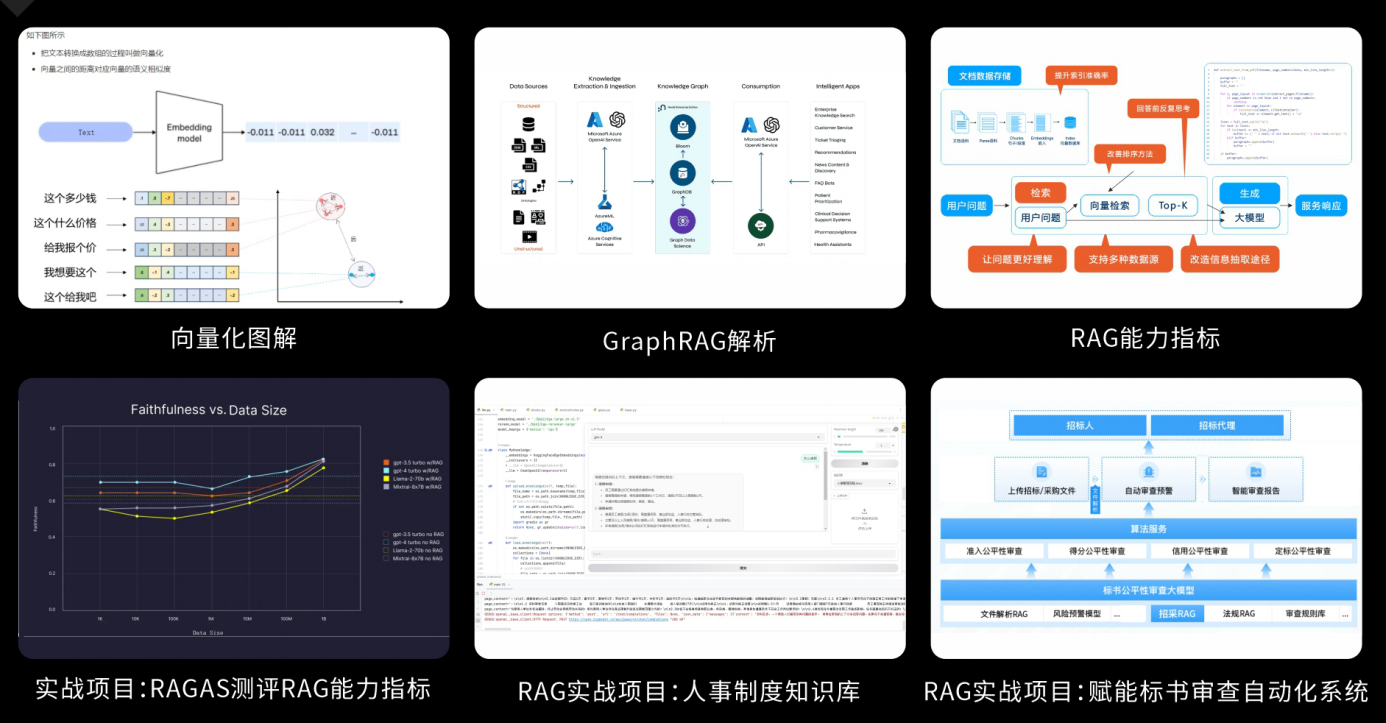
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
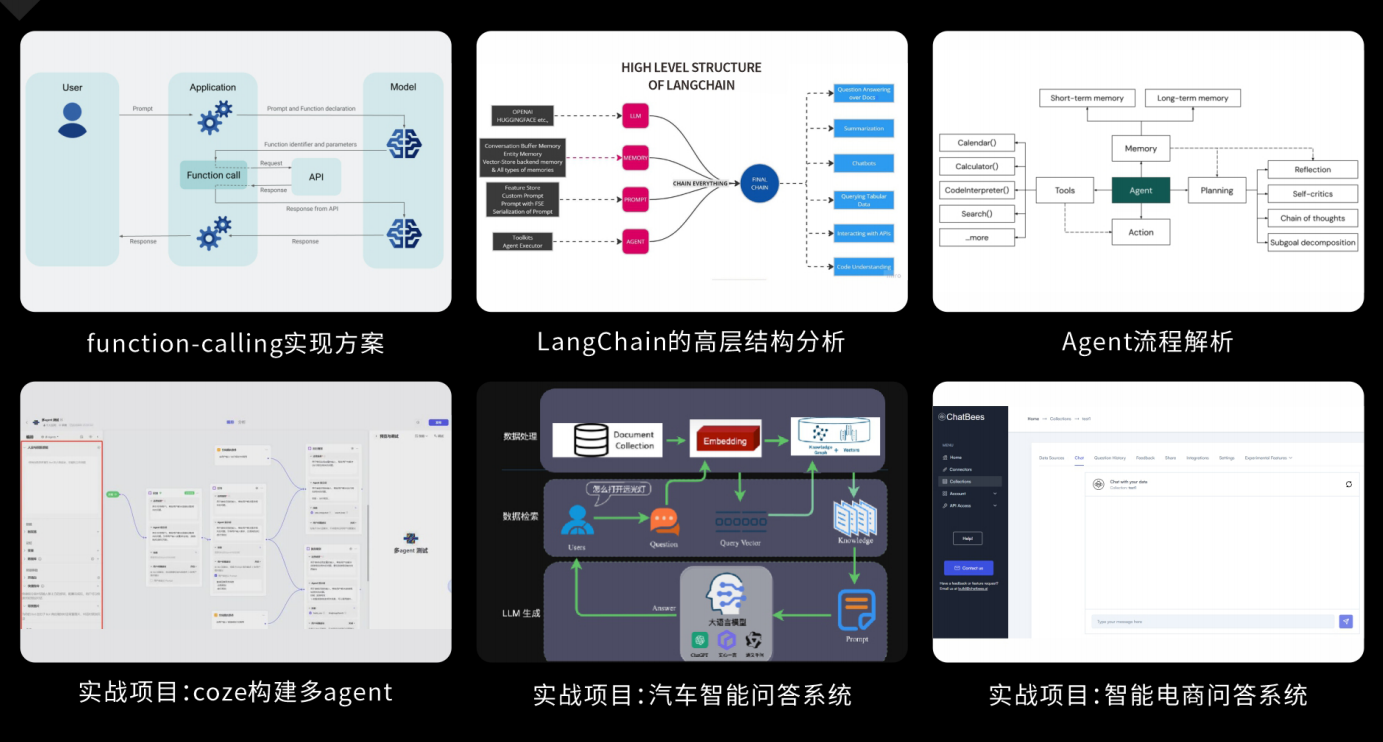
在这里插入图片描述

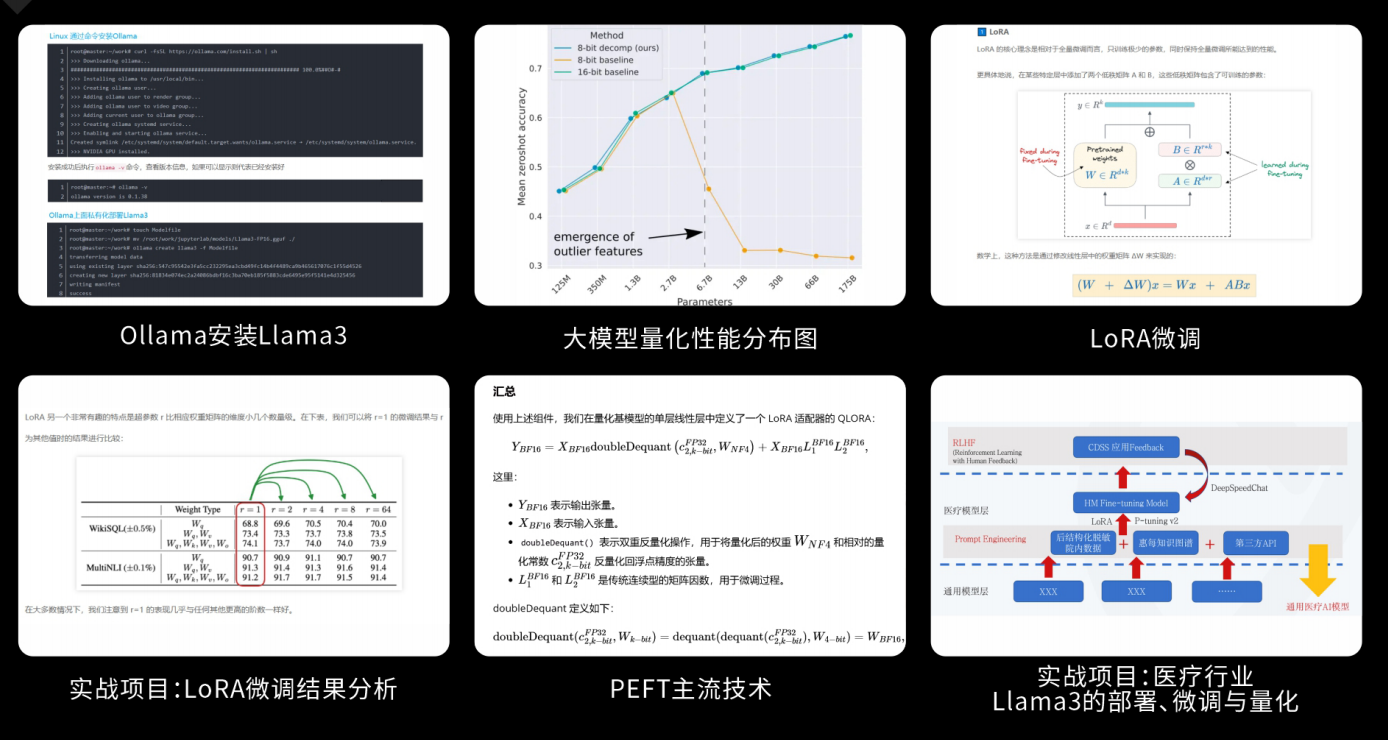
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

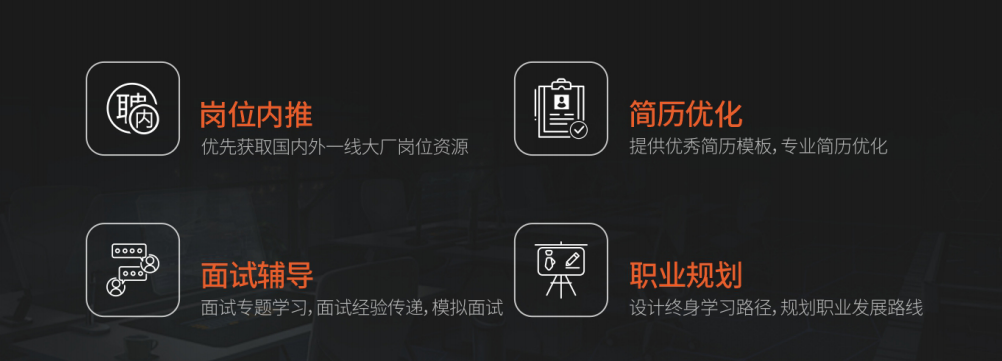
一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训
以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调 在这里插入图片描述
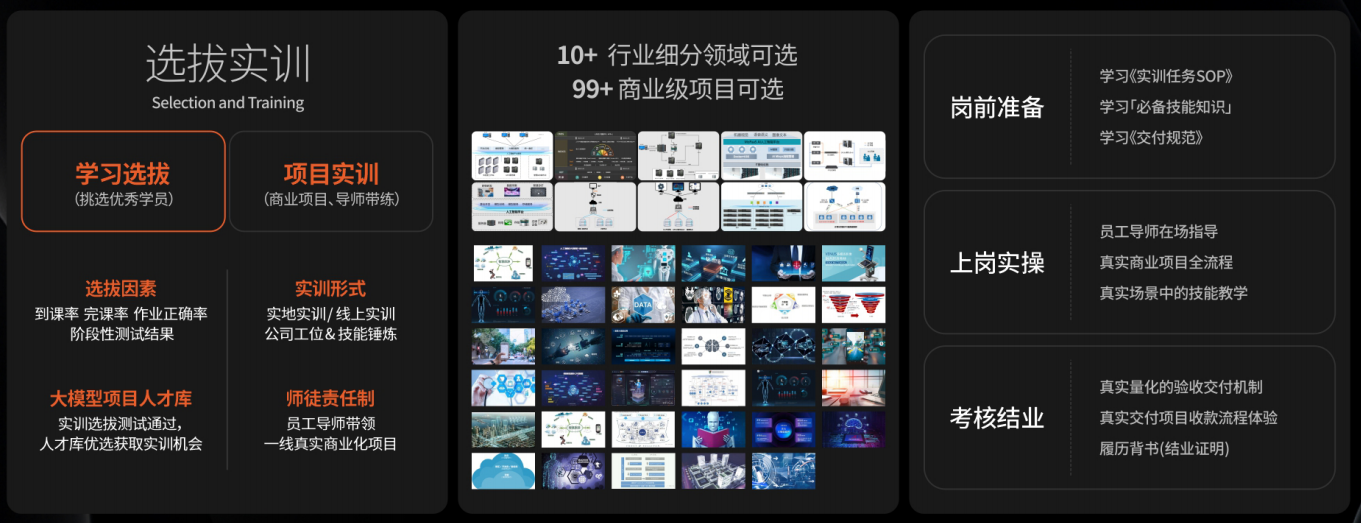
大厂绿色直通车,冲击行业高薪岗位

在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

智能体(Agent)技术入门:从原理到实践应用 智能体(Agent)作为人工智能领域的重要概念,是一种能够感知环境并自主决策的计算实体。其核心技术原理包括感知-决策-执行的闭环架构,以及强化学习等机器学习方法。在实际工程中,开发者常用Python搭配PyTorch/TensorFlow等框架实现智能体系统,并借助经验回放、分布式训练等技术优化性能。这类技术已广泛应用于游戏AI开发、智能对话系统等场景,特别是在自动化流程和决策优化领域展现出独特价值。通过14天的系统学习,可以掌握从基础反射型智能体到具备学习能力的进阶实现方法,为后续探索分层强化学习、多智能 阅读详情

相关推荐

【AI前沿】ICML 2026首尔开幕:清华斩获杰出论文、LLM记忆仅3.6bit/参数、AI智能体进入业务协同深水区_the flexibility trap-优快云博客

趋势维度关键信号影响学术研究ICML 2026告别暴力Scaling研究重心转向效率优化和理论理解模型能力LLM记忆仅3.6 bit/参数RAG/外挂记忆成为刚需对齐安全AI对齐可能被滥用为审查工具需要正视双重用途风险智能体从工具走向业务协同2026下半年企业数字化转型的基础设施产业大会WAIC 2026超300款新品首发AI终端化、场景化落地加速。

求知若渴、虚心若愚 518

收藏这一篇就够了!万字长文深度解析“无奖励学习”,从入门到精通,带你掌握Agent的“天生”智慧!

近年来,语言智能体(Language Agents)已成为人工智能领域的热点,它们能够通过自然语言与复杂环境交互,完成网页导航、工具使用、科学实验等任务。然而,如何高效训练这些智能体仍是一个巨大挑战。当前主流方法有两种:一是模仿学习(Imitation Learning),通过模仿专家示范数据来训练,但这种方式依赖高质量数据,且智能体无法从自身错误中学习;二是强化学习(Reinforcement Learning),通过环境奖励信号优化行为,但许多真实环境缺乏明确奖励,或任务周期过长导致训练低效。

m0_59164520的博客 769

大模型训练(1):流水线并行

Gpipe的方法是,在训练时计算和运用的是micro-batch里的均值和方差,但同时持续追踪全部mini-batch的移动平均和方差,以便在测试阶段进行使用。流水线并行的核心思想是:在模型并行的基础上,进一步引入数据并行的办法,即把原先的数据再划分成若干个更小的batch,分批送入GPU进行训练,算一部分就让下一个GPU动起来。从实验结果可知,在关掉NVlinks的情况下,Gpipe一样也能实现随着GPU数量的增加,训练速度也增加的效果。前文说过,随着模型的增加,每块GPU中存储的中间结果也会越大。

呆呆象呆呆的博客 1974

当智能体开始“编造自己的经验”:Scaling Agent Learning via Experience Synthesis 解读

DreamGym 通过使强化学习在大语言模型(LLM)代理的先前难以处理的领域中实现有效训练,同时大幅减少可行领域的数据和计算需求,从而解决了强化学习中的基本可伸缩性挑战。该方法表明,关注与学习相关的信号而非环境保真度可以带来更高效、更有效的代理训练。该框架能够在“非强化学习就绪”环境中实现强化学习,同时在传统强化学习设置中提供显著的效率提升,这使其成为扩展自主代理开发的实用解决方案。

yanqianglifei的专栏 1046

ROS开发者的福音:用Anaconda虚拟环境解决Python包冲突(附完整配置流程)

本文为ROS开发者提供了使用Anaconda虚拟环境解决Python包冲突的完整方案。通过分析冲突根源,详细介绍了Miniconda安装、专用环境创建以及核心桥梁包的配置流程,并阐述了“混合环境运行”与“纯虚拟环境构建”两种实战工作流,帮助开发者实现ROS核心与特定Python库的和谐共存,从而提升开发效率和项目可维护性。

weixin_28835789的博客 339

C语言新手必练:10个实战小项目带你快速上手(附完整代码)

本文为C语言初学者精选10个实战项目,从基础的温度转换器到高级的迷宫求解算法,涵盖输入输出、条件判断、循环控制、数组操作等核心知识点。每个项目配有完整代码和详细解析,帮助新手通过实践掌握编程思维,特别适合刚学完语法但缺乏实战经验的学习者。

weixin_29208077的博客 750

Agent Learning via Early Experience——通过早期经验实现智能体学习

Agent Learning via Early Experience——通过早期经验实现智能体学习

Together_CZ的博客 1192

3款 433MHz 收发模块对比:SYN480R vs RXB6 vs DL-TX19,实测卷帘门遥控距离

本文深度评测了3款433MHz收发模块SYN480R、RXB6与DL-TX19在卷帘门遥控距离、穿透性能和抗干扰能力等方面的表现。通过实测数据对比,分析了超外差、超再生和PLL锁相环技术的优劣,为智能家居和工业控制领域的无线遥控方案选型提供专业参考。

weixin_30700977的博客 395

《早期经验:语言智能体学习的中间道路》Agent Learning via Early Experience论文深度解读

论文提出"早期经验"作为模仿学习和强化学习之间的桥梁,解决了当前AI智能体训练的两难困境:既不依赖昂贵的专家数据,也不需要难以获取的奖励信号。 2. 双路径方法 隐式世界建模:让智能体预测自己动作的后果 自我反思:让智能体理解为什么某些动作更好

开源AI 专属 UI——papyrai-ui。《千界明彻录》(故事形式构建元思维)——胡说小说。更多思辨内容在公众号。 1094

告别理论!用AXI-Stream实战摄像头数据流采集(附Verilog关键代码片段)

本文详细解析了如何通过AXI-Stream接口实现工业级可靠性的摄像头数据流采集系统,重点介绍了Verilog实战代码、AXI-Stream握手机制及数据反压处理方案。通过三级缓冲架构和带宽优化,有效解决了OV5640等摄像头在高速场景下的帧丢失问题,为FPGA图像处理项目提供了实用解决方案。

weixin_42563415的博客 157

微信小程序 - 最新将页面可分享到朋友圈功能,小程序实现分享到朋友圈功能,开启分享给好友及分享朋友圈功能(微信小程序怎么分享到朋友圈?详细流程及示例代码教程)

没有设置过分享朋友圈功能的小程序,分享朋友圈按钮是灰色且无法点击。小程序 vue2 | vue3 版本语法都能使用,跟着教程复制代码运行即可。如下图所示,将页面开启分享后便可由用户转发出去。

🏆 前端领域优质创作者 2418

DreamGym:通过经验合成实现代理学习的可扩展化

基于论文《Scaling Agent Learning via Experience Synthesis》

阿正的梦工坊 1140

机器学习笔记——30种常见机器学习算法简要汇总

本笔记介绍机器学习中常见的30种机器学习算法。

haopinglianlian的博客 3200

aos-ce Meta-Harness 实战指南:用 capsule-forge 主动扩展 Agent 的用户空间世界

Unicity AOS 被定位为"Agent 的操作系统",而 `capsule-forge` 中内置的 `meta_harness_quickstart` 工具文档([meta_harness_quickstart.md](https://link.gitcode.com/i/29414f6e5cb381634553e65adca4d112))定义了其中的核心理念——Meta-Harness(元

gitblog_00915的博客 704

基于VSCode+clangd插件打造高效C++开发环境之四:clangd配置

本文介绍如何配置VSCode+clangd插件进行高效C++开发。重点内容包括:1)生成compile_commands.json文件,通过ninja工具提取编译命令并使用gen_compdb脚本转换;2)配置clangd命令行参数,如设置后台索引、并行度等;3)编写.clangd配置文件,调整编译标志和诊断选项;4)添加.clang-format文件定义代码风格;5)在VSCode中添加远程服务器工作目录。配置完成后需重启clangd服务使更改生效。文章还提供了MTK/QCOM等不同平台生成compile

5074

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

2025最新AI智能体记忆论文TOP10:Agent-Memory-Paper-List精选解读

Agent-Memory-Paper-List是一个专注于AI智能体记忆研究的论文列表项目,旨在为研究者和开发者提供全面的智能体记忆领域学术资源。该项目通过统一的分类框架,系统梳理了智能体记忆的存储形式、功能作用和动态演化等关键方向的最新研究成果。 ## 🧠 为什么AI智能体记忆如此重要? 记忆是基于基础模型的智能体的核心支柱,支撑着它们进行长期推理、持续适应和与复杂环境有效交互的能力。随着

gitblog_00438的博客 988

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

ruflo 实战:用 AgentDB Learning Plugins 为 Agent 接入 9 种强化学习算法并训练自学习智能体

AgentDB Learning Plugins 是 ruflo 生态中「让 Agent 通过经验自我改进」的核心技能:它以 AgentDB 的插件系统为载体,对外提供 9 种强化学习(RL)算法的创建、训练与部署能力,覆盖离线 RL(Decision Transformer)、基于值的学习(Q-Learning / SARSA)、策略梯度(Actor-Critic)与多种高级训练范式。阅读本文后

gitblog_00452的博客 991

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

如何5分钟上手Ruflo:一条npx命令从零搭建你的第一个AI Agent编排环境

**Ruflo** 是一个开源的 AI Agent 编排框架(agent meta-harness):一条 `npx ruflo init` 命令,就能给 Claude Code / Codex 装上"神经系统"——100+ 专业智能体、多智能体群组(Swarm)协同、自学习记忆、MCP 工具服务,全部开箱即用。本文带你 5 分钟从零搭好第一个 Ruflo AI Agent 编排环境。 [![R

gitblog_00930的博客 631

Meta推出Agent Learning via Early Experience,推动语言代理自主学习新范式

很显然 \(f(q)\) 是个很没用而且碍眼并且值又固定的东西,那么预处理算出 \(f(q)\),然后问题转化成求长度为 \(k\) 值域为 \(1 \sim n\) 的序列中单调不降的序列个数,那么仔细思考,对于从 \(n\) 中任选 \(k\) 个,重排一遍一定可以,所以说就是 \(C_n^k\),答案为 \(C_n^k f(q)\)。我们先给每组分配一个物品,只剩 \(n-1\) 个物品,我们要在这 \(n-1\) 个物品中选择 \(k-1\) 个隔板,所以是 \(C_{n-1}^{k-1}\)。

dsvsrgasaga的博客 881

ruflo Agent Meta-Harness 中的 GitHub CI/CD Pipeline Engineer:专用 cicd-engineer 智能体定义与落地实践

本篇技术指南以仓库内的智能体定义文件 [ops-cicd-github.md](https://link.gitcode.com/i/d9d8353077db9313cb539b82533139ac) 为核心骨架,讲解如何在 ruflo 的 Agent Meta-Harness 体系中定义、使用并加固一个专注 GitHub Actions 流水线的 `cicd-engineer` 专家智能体。读完

gitblog_00503的博客 835

Meta风雨飘摇中发了篇重量级论文,作者几乎全是华人

作者在文中复现了STaR风格的数据生成,发现模型为专家动作生成的推理链中,只有极少比例能匹配专家决策,筛选后几乎没剩下多少有用数据,而且这些推理因为从未真正与环境交互,往往是假想的、不可靠的。针对需要长链推理的任务,简单地让模型生成更长的思考链(例如调优提示词或控制思考步数)只能带来有限的改善,而早期经验中的自我反思相当于让模型亲身实践再反思,其对于复杂推理任务的提升要显著得多。

数据派THU 151

【论文合集】大模型代理论文 agent paper list

本文汇总了多篇关于多智能体强化学习的创新研究。核心论文提出基于图驱动的协作式特征转换优化方法(Collaborative Multi-Agent RL with Graph Optimization),另有研究涉及医疗合规AI系统(HIPAA Compliant Agentic AI)、通用智能体适配框架(ADAPTER-RL)、持续学习交互代理(Online Continual Learning)等。特别关注大语言模型在文本强化学习中的应用(STARLING),以及多智能体反思优化(MIRROR)和自动化

934

通过Multi-Agent强化学习的LLM Meta-Thinking「元思维」综述

这篇论文描绘了AI进化的下一站:通过多智能体协作和强化学习,让语言模型从「快问快答」转向「深思熟虑」。未来,这种具备元思维的AI将在医疗、法律等高风险领域大显身手——毕竟,谁也不希望诊断AI因为「脑补」而开错药方。」这种「一本正经地胡说八道」现象,就是LLM的「幻觉」(Hallucination)就像我们写完作文会检查错别字,AI也需要「自我审查机制」,在输出答案前先问自己:「我的推理有漏洞吗?:给AI添加「记忆抽屉」(存储成功经验)和「焦虑开关」(遇到不确定时主动求助),让它们更像人类思考。

zenRRan的博客 1226

Meta EvoHarness-RL:基于强化学习的AI智能体工具编排实践指南

在人工智能领域,强化学习(RL)是一种让智能体通过与环境交互试错来学习决策策略的核心方法。其核心原理在于通过奖励信号引导智能体优化行为序列,最终实现特定目标。这项技术的核心价值在于能够解决传统规则系统难以处理的复杂、动态决策问题,尤其在自动化流程和智能体控制等场景中展现出巨大潜力。具体到AI智能体的工具使用场景,传统的硬编码调用方式缺乏灵活性和适应性。而结合进化算法,智能体能够自主探索和优化工具组合策略,形成动态的“工具编排”能力。这正是Meta EvoHarness-RL框架所聚焦的方向,它通过强化学习与

weixin_33744854的博客 402

基于 tf-agents 的多智能体 PPO 训练框架:social_rl multiagent_tfagents 源码级解析

本文聚焦 Google Research 开源仓库 `social_rl/multiagent_tfagents` 这一多智能体强化学习训练模块:它以 tf-agents 为基础,通过一个"集中式元智能体(meta-agent)"统一管理多个独立 PPO 子智能体,实现字典式聚合观测的拆分、多动作的聚合输出以及向量奖励的独立学习。读完本文,你将掌握该框架的整体架构、核心源码调用链、完整训练命令与

gitblog_00601的博客 541

大模型论文 | 学生党福音!AMD 推出论文 Agent ,“Agent Laboratory” 助你轻松写论文

从历史上看,科学发现一直是一个漫长且耗费巨大的过程,从最初的构思到最终得出结果,需要投入大量的时间与资源。为了加速科学发现进程、降低研究成本并提高研究质量,我们推出了 “智能体实验室”(Agent Laboratory),这是一个基于大语言模型的自主框架,能够完成整个研究流程。该框架接收人类提供的研究思路,并历经三个阶段 —— 文献综述、实验以及报告撰写,从而生成全面的研究成果,包括代码库和研究报告,同时还能让用户在每个阶段提供反馈与指导。

Androiddddd的博客 1001
上一篇: 收藏这篇就够了!LangGraph+RAG+MCP 终极实战,从零构建能自动操控 Jira 的 AI 智能体!
下一篇: RAG效果提升终极指南:“小块检索,大块生成”从入门到精通,看这一篇就够!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值