RAG效果提升终极指南:“小块检索,大块生成”从入门到精通,看这一篇就够!

终极指南:大模型检索增强生成(RAG)全面综述,优快云最详尽解析,一篇文章掌握RAG精髓! 是什么:RAG 是一种通过检索外部知识库来获得额外语料,并使用 ICL(In-Context-Learning,上下文学习)来改进 LLM 生成效果的范式。为什么:LLM 受训练语料的限制,无法感知最新的内容,比如 LLM 训练后的新闻;此外,LLM 也容易产生幻觉,生成不正确的内容。如何做:当用户发起一个生成请求时,首先基于用户的 prompt 来检索相关信息,然后这些信息会被组合到 prompt 中,为生成过程提供额外的上下文,最后将组合后的 prompt 输入 LLM 生成结果。 阅读详情

“ 小块召回,大块生成的策略的作用是提升文档的召回率,并保证文档上下文的连贯性。”

在RAG技术的真实实践过程中,我们经常会遇到的一个问题就是——模型回答的质量不好;当然导致回答质量不好的原因有很多,而我们今天就来讨论一种RAG问答的优化策略——小块召回,大块生成。

从本质上来说其实就是解决了两个问题,小块解决召回问题,大块解决生成问题。

小块召回,大块生成

可能很多人都不明白什么叫做小块召回,大块生成?

小块召回,大块生成的原理很简单;用更小的文档块做召回,解决召回率和准确率问题;用更大的块做生成,解决上下文连贯性问题,提升生成质量。

当然这样说可能很多人都不太理解,其实这个是与具体的技术细节有关。

首先我们要明白一个问题,向量数据库存储数据的原理和传统数据库并没有本质上的区别;都是用一个一个的字段来存储数据,只不过向量数据库有一个比较特殊的点是支持向量计算,而不是基于传统的字符匹配。

其次,可能有人会认为,相似度查询是把文档向量化之后,通过相似度计算的方式检索出相关数据,然后再问答时再把这段数据转换成文本文档。

但在RAG的流程中,在把文档切片之后,虽然会把切片后的文档进行向量化,但同时会保存原文档;我们只是用向量化的数据做相似度计算,而不是用来做生成。

举例来说,向量字段就类似于传统数据库中的ID或某个字段,然后还会有一个原始文档的字段;当根据相似度计算检索到某条记录之后,会把原始文档里的内容传给模型做生成。

所以,向量数据库也是一条记录一条记录的保存数据,而向量是其中的一个字段类型,专门用来做向量检索使用。

而什么是小块检索,大块生成呢?

在文档切片之后,特别是在低质量的切片之后,很多人为了简单方便会直接把切片后的数据进行向量化,这种文档可能存在大量的无关内容或噪音。

比如说word/pdf等类型的文档会存在页眉,页脚,分割符等等;但这些内容对我们来说是没有意义的,只会降低文档的质量。

所以,我们可以选择一种方式,就是对这段文档进行总结或关键字提取;之后再进行向量化,这样就可以大大降低文档的噪音,提升相似度计算的质量;同时,我们继续保存文档原始内容,当召回之后我们并不是把总结之后的文档丢给模型,而是把原始文档丢给模型,这样既能提升文档召回率,也不会影响到参考文档质量。

而以上这个过程就叫做小块召回,大块生成;用更小更准确的文档块做数据召回,用更大更全的文档做增强生成;这样既能保证文档的召回效果,又能保证上下文的连贯性。

总之,RAG系统的优化过程是一个非常复杂且繁琐的过程,我们需要在各个环节对系统做优化和测试,才能真正达到生产级别的需要。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

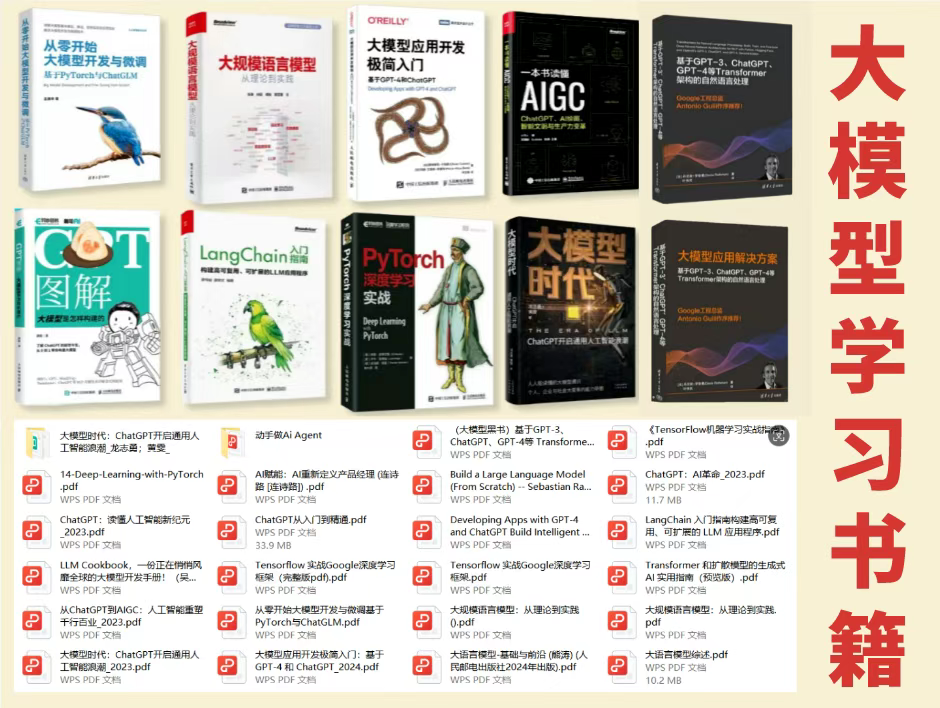
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

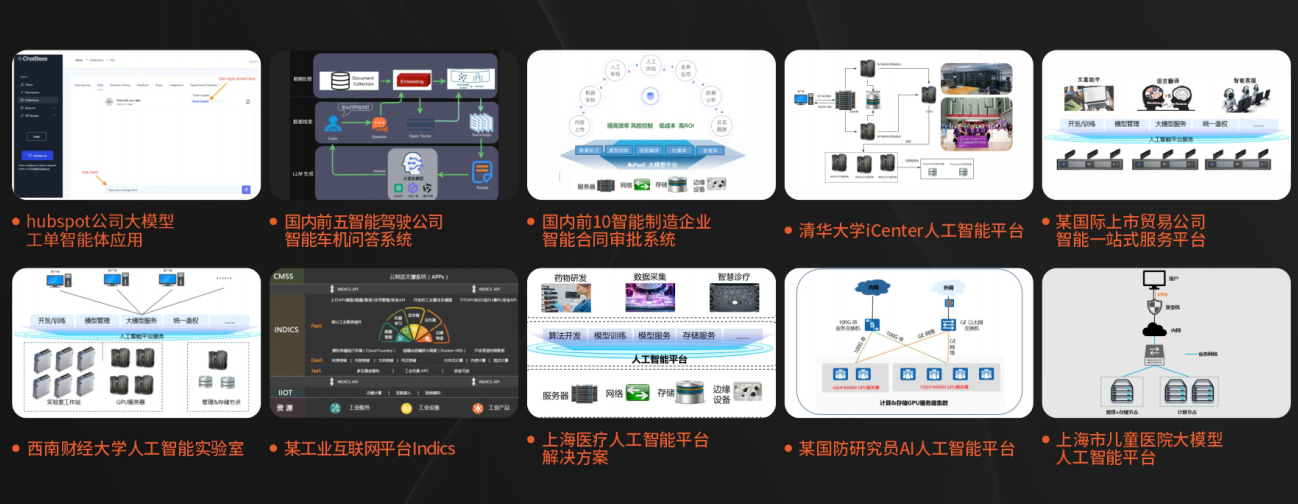
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

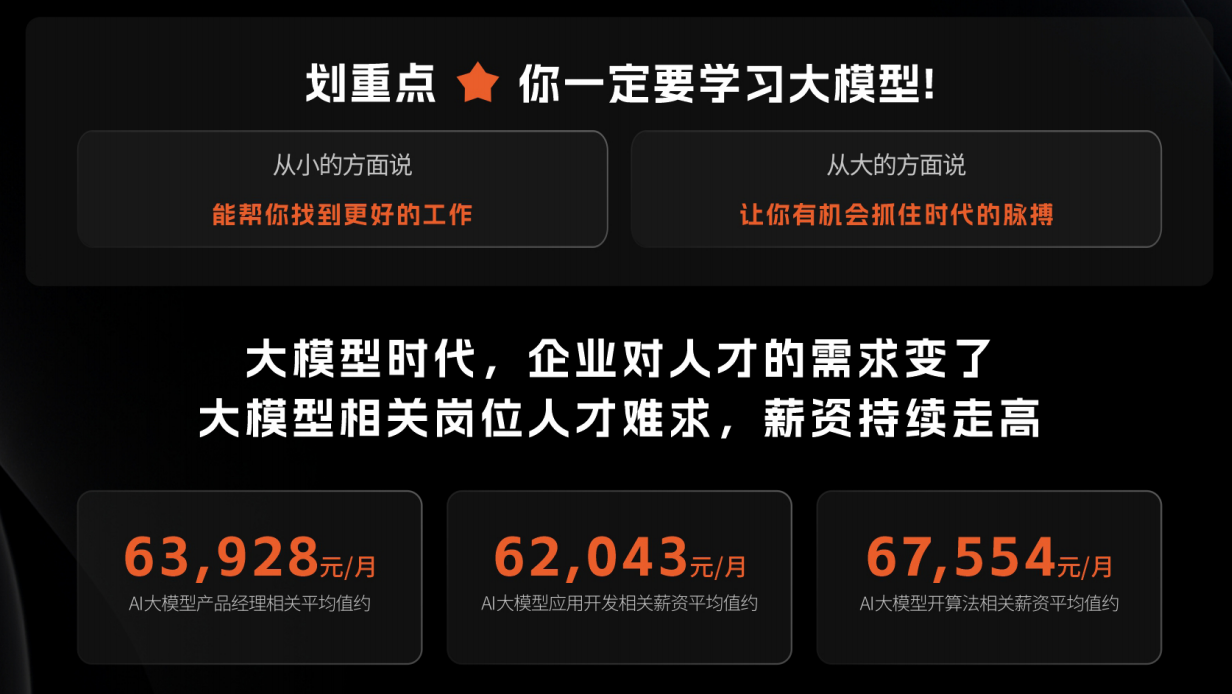
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

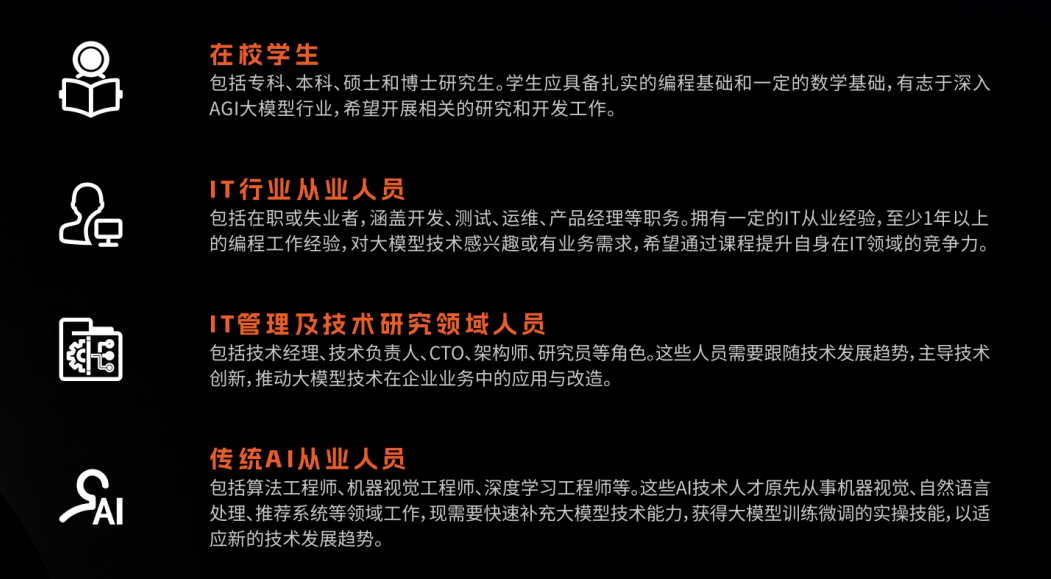
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

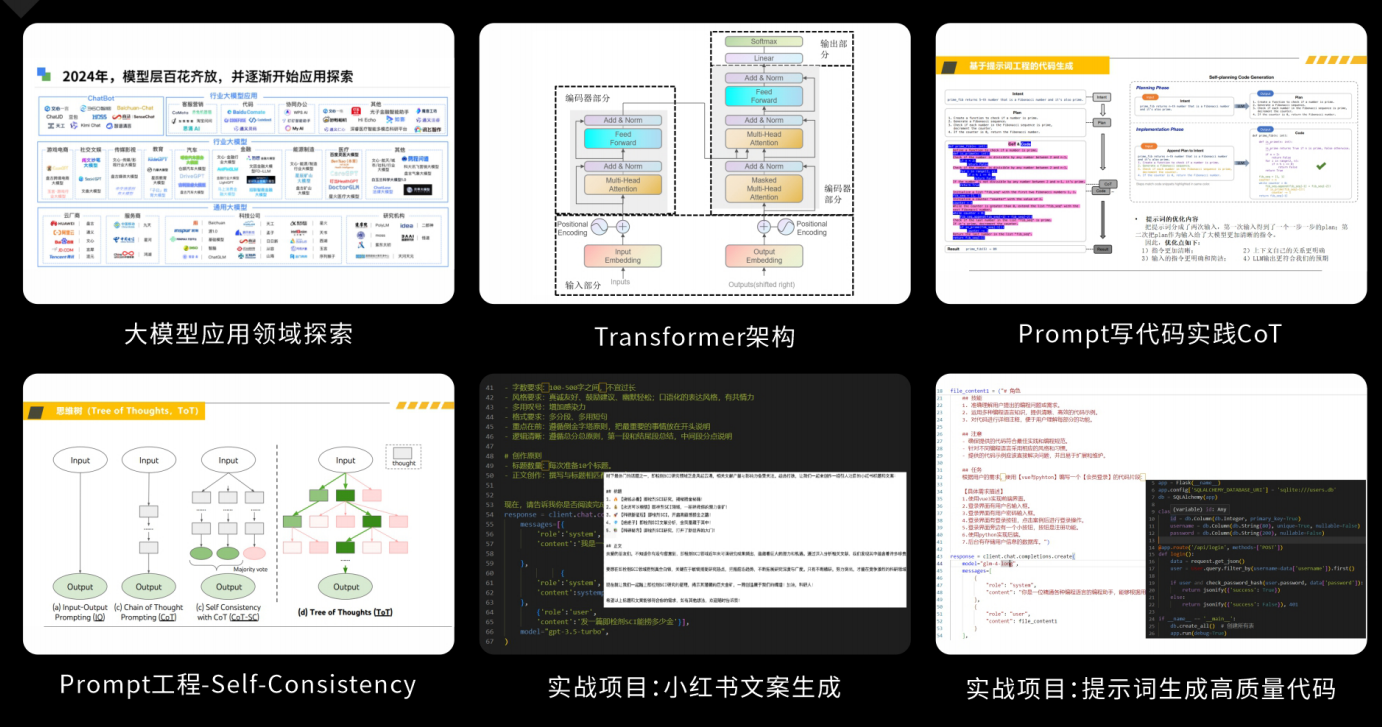
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。
在这里插入图片描述
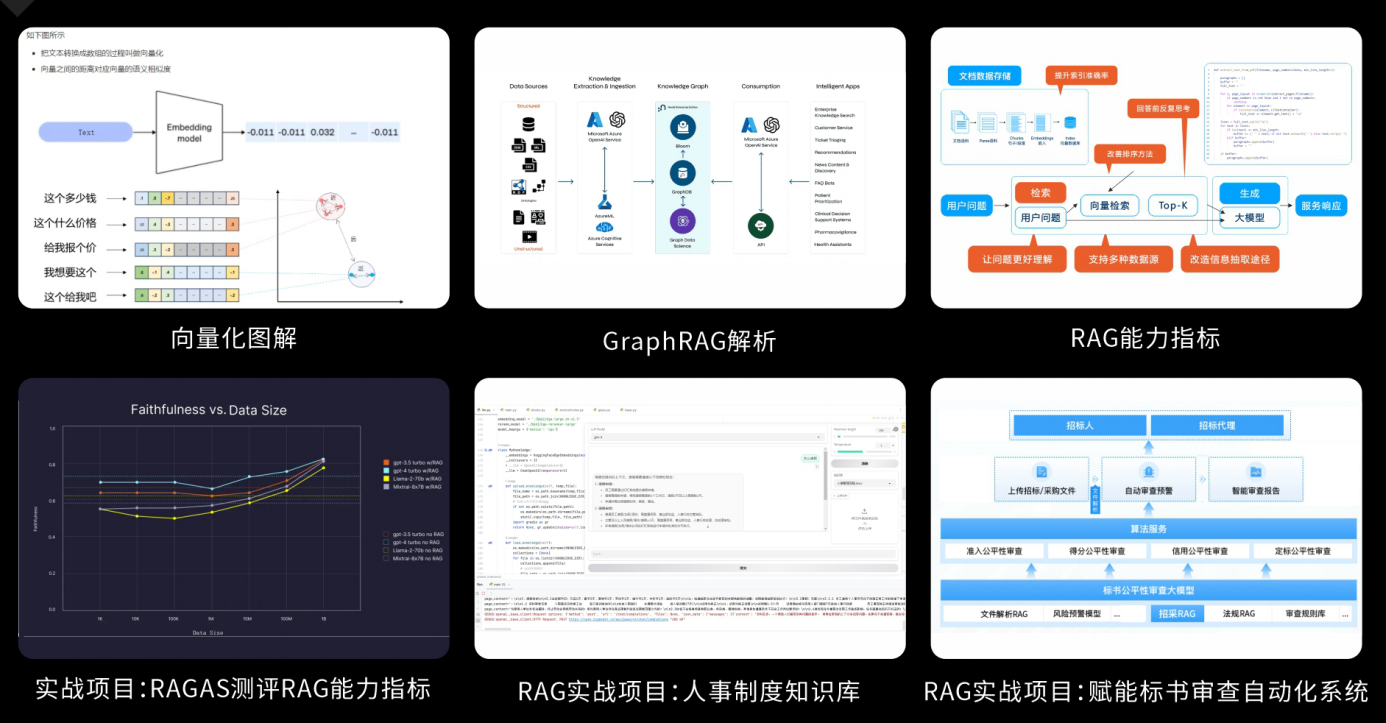
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述
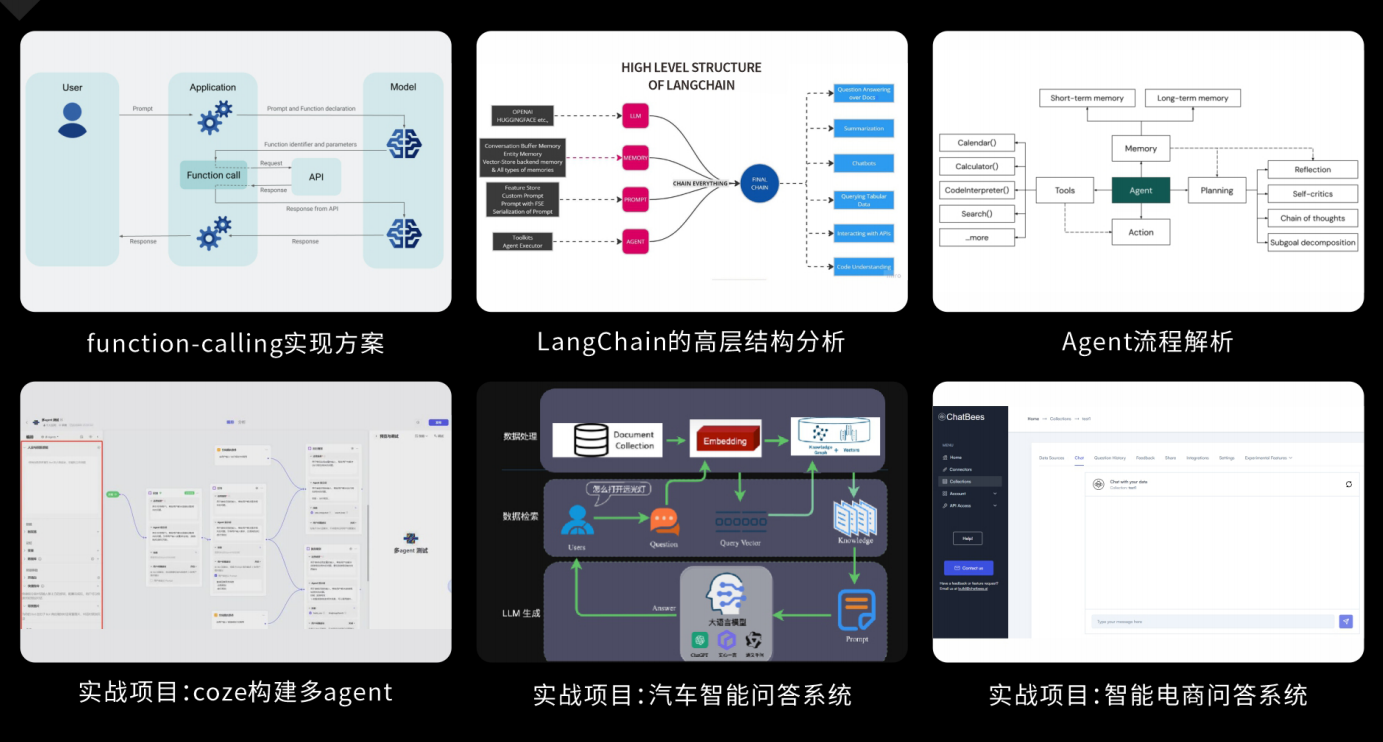
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

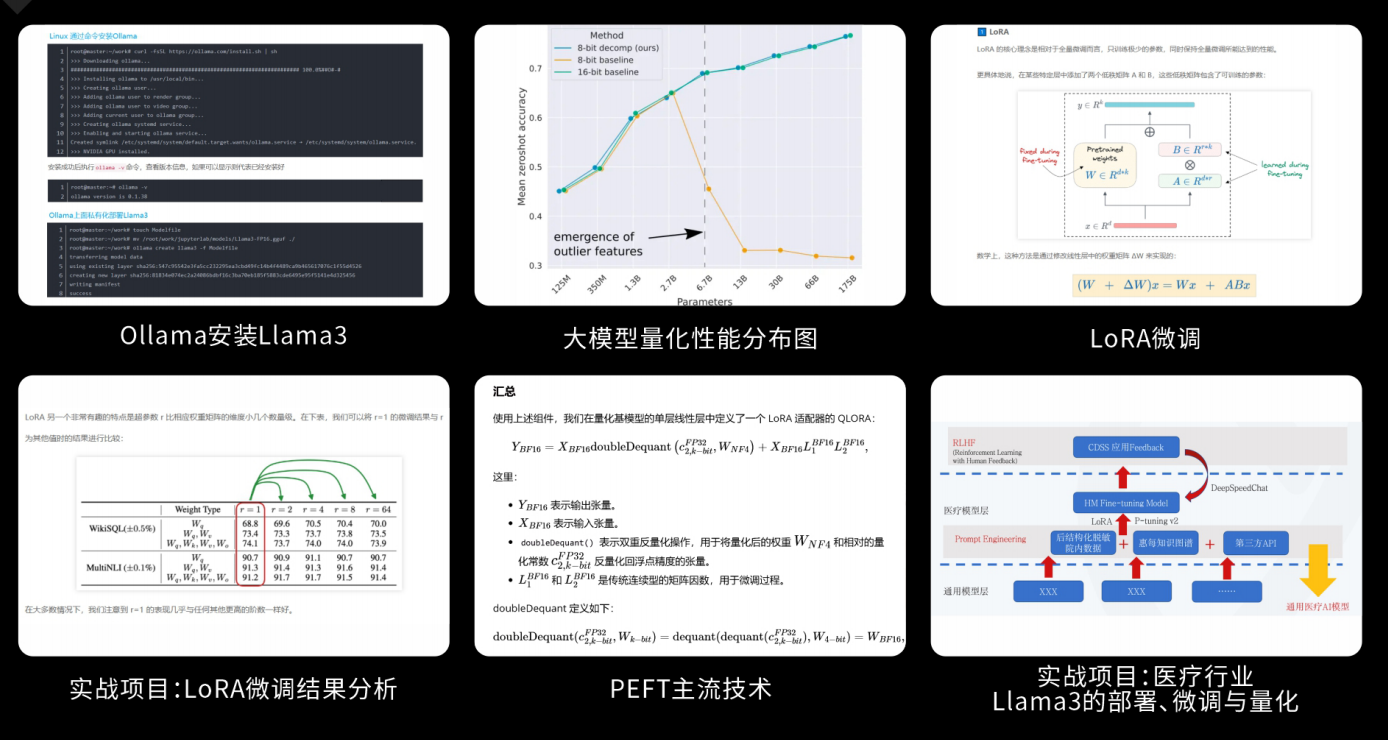
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训
以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调 在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位

在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

一文读懂「RAG,Retrieval-Augmented Generation」检索增强生成 检索增强生成(RetrievalAugmentedGeneration),简称RAG,已经成为当前最火热的LLM应用方案。它是一个为大模型提供外部知识源的概念,这使它们能够生成准确且符合上下文的答案,同时能够减少模型幻觉。知识的局限性:模型自身的知识完全源于它的训练数据,而现有的主流大模型(ChatGPT、文心一言、通义千问…)的训练集基本都是构建于网络公开的数据,对于一些实时性的、非公开的或离线的数据是无法获取到的,这部分知识也就无从具备。幻觉问题。 阅读详情

相关推荐

招标文件智能解析系统开发文档

本系统是一个基于OCR与大语言模型的招标文件智能解析平台,专门用于处理和分析招标文件,自动提取关键信息并进行结构化展示。

警世龙的技术博客 1928

AI入门系列之 RAG高效召回新技巧:索引扩展策略详解

在RAG(检索增强生成)系统中,索引结构是连接“用户查询”与“知识库”的核心枢纽。传统索引(如均匀分块向量索引)往往面临“召回精度与上下文完整性”的权衡——小块检索精准但上下文不足,大块检索上下文丰富但噪声过大。索引扩展策略通过优化索引的颗粒度分层语义关联与动态适配,解决了这一矛盾,显著提升了召回的准确性与实用性。索引扩展策略通过优化索引的颗粒度融合多模态信息构建层次化结构,解决了传统RAG系统“召回精度与上下文完整性”的矛盾。

沛哥儿的专栏 1686

Adversarial Texture for Fooling Person Detectors in the Physical World

本文提出了对抗纹理的想法(AdvTexture),与基本补丁攻击不同对抗纹理可以生成任意大小,可以覆盖任意大小的不了,并且纹理的任何局部都有对抗性的效果。当衣服被对抗纹理覆盖是,摄像头捕捉到的每一个局部区域都可以攻击探测器,这成功解决了片段缺失的问题。提出了一种两阶段生成方法:基于环形收割的可扩展生成攻击(TC-EGA)来制作广告纹理。第一阶段,训练一个全卷积网络FCN作为生成器,通过采样随机潜变量作为输入来产生纹理(不同于GAN中传统的生成器架构,每一层都使用卷积运算)......

weixin_49171105的博客 1067

AI入门系列之RAG高效召回新技巧:Small-to-Big(由小到大检索)

在RAG(检索增强生成)系统中,**召回效果**直接决定了生成内容的准确性与可靠性。传统检索(如均匀分块向量检索)常因**短查询语义不足**(如“修电脑”)或**长文档上下文割裂**(如技术文档中的分散知识点)导致召回率低下。**Small-to-Big**作为RAG高效召回的经典策略,通过**小块精准检索+大块上下文补充** 的双向优化,完美解决了“召回精度与上下文完整性”的矛盾,成为工业界与学术界的主流选择。Small-to-Big是一种分层索引+渐进检索的优化策略,核心逻辑是通过两种颗粒度的文本块。

沛哥儿的专栏 1816

计算机模拟爆破过程,基于LSDYNA岩石爆破模拟建模分析

原标题:基于LSDYNA岩石爆破模拟建模分析 Ls Dyna岩石爆破模拟仿真作者:dyna_focus擅长领域:dyna/abaqus/hypermesh一、 数值模型的建立1.1 单元及算法的选择岩石,炸药,空气都采用solid164实体单元。岩石采用常应力实体单元,该种单元属于纯粹的lagrange算法,该种算法单元网格附着在材料上,随着材料的流动而产生单元网格的变形,但是在结构变形巨大时,有...

weixin_29494379的博客 7317

基于扩展卡尔曼滤波(EKF)结合到达时间(TDOA)、到达频率(FDOA)实现多无人机无源定位,MATLAB代码

该程序实现了一种结合到达时间差(TDOA)和到达频率差(FDOA)技术的多无人机定位方法,利用扩展卡尔曼滤波(EKF)对单一目标进行定位。程序通过模拟多无人机的运动及其与目标的相对位置,估计目标的状态(位置和速度)。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 1267

提升RAG召回和生成效果策略之——小块检索,大块生成

摘要: "小块召回,大块生成"是优化RAG问答系统的有效策略。通过将文档切分为小块进行向量化检索,提升召回准确率;召回后使用更大原始文档块生成回答,保证上下文连贯性。该方法通过向量数据库存储结构实现:小块用于相似度计算(降低噪音干扰),原文档保留完整信息供生成阶段使用。这种双阶段处理既解决了检索精度问题,又维持了生成质量,是RAG系统优化的关键环节之一。

AI_today的博客 950

西门子S7-1200控制伺服/步进电机方法与接线(全)

西门子S7-1200控制伺服/步进电机方法与接线(全) 伺服/步进电机在非标自动化控制中十分常用,但作者发现在各类开源网站上很少有人做西门子1200PLC控制伺服/步进电机的教程,于是今天想着跟大家分享一下。 本文共分为一下几个四个内容。 文章目录西门子S7-1200控制伺服/步进电机方法与接线(全)前言一、准备二、接线1.PLC接线:2.伺服接线:3. 步进电机的接线:三、代码组态代码四、可能出现的问题 前言 工程控制常用到三项异步电机、直流电机等,但他们都无法准确的控制电机角度;于是有了步进电机、

weixin_46060068的博客 7万+

【收藏】RAG问答质量提升策略:小块召回,大块生成的原理与实现

"小块召回,大块生成"是优化RAG系统的有效策略:通过总结或提取关键信息生成小文档块进行向量化检索,提升召回准确率;在生成阶段则使用原始完整文档,确保上下文连贯性。这种方法既解决了文档噪音导致的召回质量问题,又保持了生成内容的完整性,是提升RAG系统性能的重要技术路径。

优快云_224022的博客 976

AD24-层次原理图的设计

4)在原理图关联对话框中双击需要放置方块图的子图,即激活方块图的放置,单击母图的空白处进行放置。3)设计-Create Sheet From Sheet,进入原理图关联对话框。4)放置-添加图纸入口,放置方块图的内部I/O端口并进行名称更改。2)放置-页面符,放置页面符,并执行Table完成属性设置。5)执行Ctrl+W,端口和内部I/O端口对应连接。1)创建一个工程并完成子图的每页原理图的设计。1)新建项目,创建Main原理图页。3)放置-的端口,放置方块图的端口。以上,就是层次原理图页的设计。

qq_52761962的博客 4937

Xilinx FPGA资源解析与使用系列——Transceiver(六)关键时钟梳理之TXOUTCLK和RXOUTCLK

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 Xilinx FPGA资源解析与使用系列——Transceiver(六)transceiver内部关键时钟梳理之TXOUTCLK和RXOUTCLK前言TXOUTCLKRXOUTCLK 前言 前面我们已经研读了 transceiver的参考时钟 和复位的相关内容。 但是随着内容的深入,越来越多的信号出现在我的面前。 例如 TXOUTCLK、TXUSERCLK、TXUSERCLK2 RXOUTCLK、RXUSERCLK、RXUSERCLK2

gzy0506的博客 8090

RAG技术优化:小块召回大块生成,提升大模型问答质量!

文章介绍了RAG技术的一种优化策略——"小块召回,大块生成"。该方法通过将文档进行总结或关键字提取后向量化,以提升召回率和准确性;同时保留原始文档内容,用于生成阶段。这种策略使用小块文档进行高效召回,用大块文档保证上下文连贯性,有效解决了RAG系统中常见的文档召回率和生成质量问题,是优化大模型问答性能的重要方法。

2401_84495872的博客 904

4D毫米波雷达:高度信息与微多普勒效应

4D毫米波雷达:高度信息与微多普勒效应​ ,人工智能,计算机视觉,大模型,AI,本文深入解析4D毫米波雷达的高度信息获取与微多普勒效应。4D毫米波雷达通过MIMO技术、垂直天线布局及相位差计算等获取高度信息,相较传统雷达更精准。微多普勒效应由目标微运动引发,可用于目标识别、分类和运动监测。文中结合自动驾驶、安防监控案例,分析技术挑战与未来趋势,如信号干扰、数据处理复杂,未来将向高精度、与其他传感器融合发展,展现出在多领域的巨大应用潜力。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 9万+

收藏必备!大模型RAG优化指南:详解“小块召回大块生成“策略,提升文档检索质量

"小块召回,大块生成"是RAG系统的核心优化策略,通过使用较小、准确的文档块进行向量检索提高召回率,同时保留完整原始文档用于生成,确保上下文连贯性。具体做法是对文档进行总结或关键字提取以降低噪音,提升相似度计算质量,但在生成时仍使用原始文档内容。这种方法有效平衡了文档召回效果和生成质量,是解决RAG问答系统性能问题的重要手段。

2401_85375186的博客 591

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

RAG终极指南:融合检索与重排序核心技术!从入门到精通,看这篇就够了!

我们之前介绍了什么是 RAG、它在大型语言模型 (LLM) 中的重要性,以及 RAG 的经典检索器、生成器系统是什么样的,本系列的第三篇文章探讨了一种构建 RAG 系统的升级方法:融合检索。 在深入探讨之前,值得简要回顾一下我们在本系列第二部分中探讨过的基本 RAG 方案。

Python_cocola的博客 1787

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

15种高级RAG技术终极指南:从预检索到生成,一篇讲透效果提升秘籍!

本文探讨了15种提升检索增强生成(RAG)系统性能的高级技术。针对传统RAG系统常见的信息密度低、检索不准确、响应质量差等问题,文章提出从预检索、检索过程、检索后处理和生成四个阶段进行优化。重点介绍了预检索阶段的5种方法:使用LLM提高信息密度、分层索引检索、创建假设问答对、信息去重和最优分块策略测试,并通过实验验证了不同分块方式的效果。这些技术可显著提升RAG系统的语义搜索能力、响应准确性和整体效率,为构建高性能生成式AI系统提供了实用解决方案。

weixin_58753619的博客 1527

RAG效果提升终极指南:RRF融合排序,从入门到精通,看这一篇就够了!

在检索增强生成(RAG)系统中,检索质量直接决定了最终生成结果的准确性和相关性。然而,单一的检索方式往往难以全面捕获用户意图。当我们使用多个检索系统(如BM25关键词搜索和向量语义搜索)时,如何有效融合这些不同来源的结果就成为了关键问题。

m0_59163425的博客 1498

2024最新最全:15种高级RAG技术,从预检索到生成全面提升RAG效果,收藏这一篇就够了

随着检索增强生成(RAG)系统的快速发展,它为增强对话式 AI 和其他生成式 AI 应用提供了许多机会。本文的实验和研究突显了先进的 RAG 技术在以下方面的潜力:信息密度检索准确性用户响应质量如果正确实施,这些技术可以为企业带来更高的成本效益,并改善客户体验。但为了跟上快速涌现的最佳实践,软件工程师和数据科学家需要及时、可信赖的资源作为参考。

wholeliubei的博客 2709

15种高级RAG技术:从预检索到生成全面提升RAG效果,收藏这一篇就够了

随着检索增强生成(RAG)系统的快速发展,它为增强对话式 AI 和其他生成式 AI 应用提供了许多机会。本文的实验和研究突显了先进的 RAG 技术在以下方面的潜力:信息密度检索准确性用户响应质量如果正确实施,这些技术可以为企业带来更高的成本效益,并改善客户体验。但为了跟上快速涌现的最佳实践,软件工程师和数据科学家需要及时、可信赖的资源作为参考。

Python_0011的博客 1355

RAG效果提升入门到精通,这15种高级技术,一篇就够了!

检索增强生成 (RAG) 是一种强大的技术,它将信息检索与生成式 AI 相结合,以产生更准确、上下文更丰富的响应。本文将探讨 15 种高级 RAG 技术,以提高生成式 AI 系统的输出质量和整体性能的鲁棒性。这样做使本文能够测试和识别从预检索到生成的适当优化,本文所提到的优化点大多数基于下图的流程。

m0_59163425的博客 1020

RAG优化实战:小块召回大块生成策略,提升文档召回率与上下文连贯性(必收藏)

摘要:RAG系统采用"小块召回,大块生成"策略优化性能,通过将文档切片后对小块进行总结或关键字提取并向量化,提高召回准确率;同时保留原始大块文档用于生成阶段,确保上下文连贯性。该方法既解决了文档召回中的噪音问题,又保证了生成质量。文中还介绍了大模型学习资源,包括成长路线图、书籍、视频教程等,帮助掌握AI技术把握未来机遇。

优快云_430422的博客 703

AI工程师私藏的RAG神技:小块召回大块生成,小白也能让AI回答质量原地封神!

"小块召回,大块生成"是RAG技术的核心优化策略。通过高质量文档切片提取关键信息向量化,提升召回准确率;同时保留完整原始文档用于生成,确保上下文连贯性。这一策略解决了传统RAG中召回率低和生成质量差的问题,是构建高效RAG系统的重要技术手段。

老皮的博客 804

RAG入门指南:检索增强生成全解析

RAG(检索增强生成)是一种让大模型在回答问题前先检索相关资料的技术,解决模型对私有资料、新知识和专业内容无法准确回答的问题。其流程包括:文档切块(Chunk)→文本向量化(Embedding)→存储到向量库→用户提问向量化→检索相似内容→结合上下文生成答案。关键点在于合理切分文档(大小适中、语义完整)、使用向量库进行语义检索,以及让模型基于检索内容而非记忆作答。该技术通过"开卷考试"模式显著提升回答准确性,降低幻觉风险。实践时需注重文档预处理、检索质量和提示词设计,而非单纯依赖模型能力

weixin_52611737的博客 1万+

15种高级RAG技术:从预检索到生成全面提升RAG效果

随着检索增强生成(RAG)系统的快速发展,它为增强对话式 AI 和其他生成式 AI 应用提供了许多机会。本文的实验和研究突显了先进的 RAG 技术在以下方面的潜力:信息密度检索准确性用户响应质量如果正确实施,这些技术可以为企业带来更高的成本效益,并改善客户体验。但为了跟上快速涌现的最佳实践,软件工程师和数据科学家需要及时、可信赖的资源作为参考。

Python_cocola的博客 1857

RAG检索优化四板斧(一):索引层,小块检索、大块阅读

所以在 RAG 系统里,检索优化是投入产出比最高的环节,而索引层又是这一切的地基——知识怎么"存",直接决定了后面能不能被"找到"。因为文档原文有时候表述很散,同一个意思散落在多个句子里,而摘要是对核心意思的提炼,语义更聚焦,在向量空间里和用户问题会更接近,命中率自然更高。这就引出下一板斧要解决的问题——查询层,如何"先问对问题,再让知识库回答"。父子分块、摘要索引、多粒度分层索引,本质上都是 Small-to-Big 思想的三种落地形态,区别只在于"怎么从精准的小块,回到完整的大块"。

一个coder的博客 4332
上一篇: 刚刚!Meta官宣!两篇Agent Learning论文,给AI智能体指明了新方向!
下一篇: AI产品经理终极手册!Agent从“能跑”到“落地”全流程解析(非常详细),看这篇就够!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值