


阿里的Qwen3系列模型正式发布了。短短12小时,GitHub星标数就突破17k,Hugging Face下载量峰值达2.3万次/小时。
更刺激的是,此次Qwen3系列一共发布了八款,全是混合推理模型(同时支持快思考与慢思考),在推理、指令遵循、工具调用、多语言能力等方面大幅增强外,还创下所有国产模型及全球开源模型的性能新高。
要素虽然有点多,但别担心,Zilliz已经第一时间安排多位工程师上手,帮大家上手评测,并给出手把手RAG教程,码住等于学会,五一不再加班。
另外,我们Zilliz的开源项目DeepSearcher(GitHub 超5K star,主打深度检索与报告生成)已经第一时间支持Qwen3模型,助力用户找到性能与成本的黄金点。
参考链接https://github.com/zilliztech/deep-searcher?tab=readme-ov-file#configuration-details
01
Qwen 3系列解读:更强,更多选择,更低门槛,更适合企业落地
总结 Qwen 3 系列模型,可以记住这四组关键词:
(1)全部是推理与非推理结合的混合模型;搞定老板又要成本又要性能的变态要求;
(2)两款MoE模型+六款Dense(稠密)模型;前者适合云端,后者本地表现更佳;
(3)基于小尺寸的能力升级;4张H20就能部署满血Qwen 3;
(4)接入MCP与多语言能力;开发成本更低。
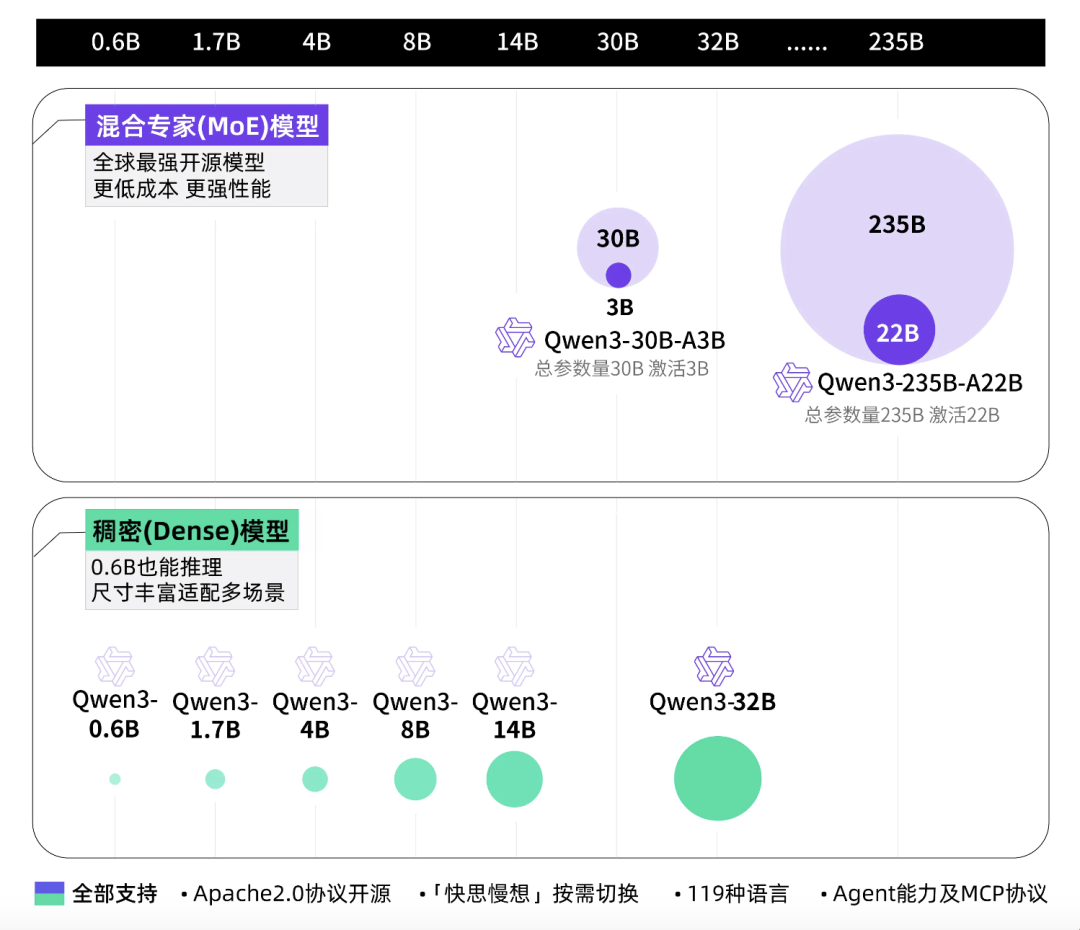
先说第一组关键词——混合推理模型。
此次Qwen3 系列全部是混合推理模型,即同时具备推理(慢思考)与非推理(快思考)能力。
原因很简单,推理模式能够让模型更聪明,但是也显著增加算力消耗,以及相应的等候时间。而采用推理与非推理能力混合,用户就能根据实际需求自由选择深度思考复杂问题还是快速回答简单问题,最大化的平衡算力成本与输出效果。
另外,比较有意思的是,围绕着token输出量,除了推理与非推理模式之外,Qwen3 API还可按需设置“思考预算”(即预期最大深度思考的tokens数量),进行不同程度的思考,灵活满足AI应用和不同场景对性能和成本的多样需求。
接下来看看第二组关键词:两款MoE模型+六款Dense(稠密)模型。
此次开源包括两款MoE模型:Qwen3-235B-A22B(2350多亿总参数、 220多亿激活参数),以及Qwen3-30B-A3B(300亿总参数、30亿激活参数)。每个token处理的激活专家数默认设置为8,总专家池规模扩展至128个。
以及六个Dense(稠密)模型:Qwen3-32B、Qwen3-14B、Qwen3-8B、Qwen3-4B、Qwen3-1.7B和Qwen3-0.6B。
(背景科普:Dense模型指的是所有参数和计算单元在每次推理或训练时全部参与计算,因此模型越大、训练与推理成本越高。代表例子:GPT-3、BERT、ResNet等传统大模型。MoE模型则引入了“专家Expert”的概念:模型内部包含多个子网络——专家网络,每次推理时只激活其中一部分专家。)
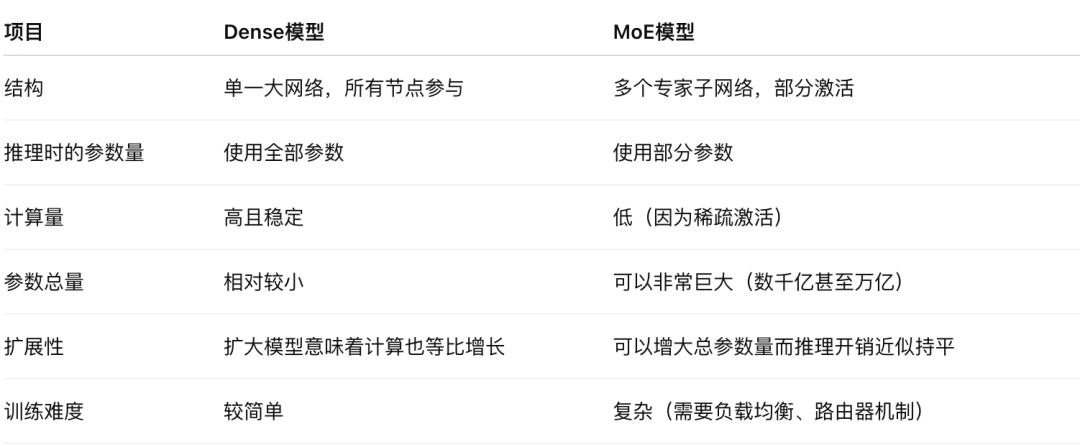
第三组关键词是基于小尺寸的能力升级。
此次,Qwen3 系列训练数据量达36T tokens,较Qwen2.5翻倍。
在此背景下,发布的八款模型发布中,尺寸最大的是MoE模型Qwen3-235B-A22B,共计有2350多亿总参数、 220多亿激活参数。在而此之前,通义千问(Qwen)系列中参数规模最大的模型是 Qwen1.5-110B,相比之下,参数量增加一倍。
不过,横向对比671B参数的DeepSeek-R1等模型可以发现,通义并没有走绝对的大参数路线。相应的,Qwen3的部署成本并不算高,通过支持FP4到INT8的动态量化**,**仅需4张H20即可部署千问3满血版。
第四组关键词是MCP与多语言。
Qwen3 系列模型在agent支持以及全球化落地上做了非常多的工程支持。
一方面,Qwen3 模型支持接入MCP,让外部的数据库、工具等产品可以更好的与大模型形成交互。此外,Qwen3 模型配套了一个 Qwen-Agent 项目,可以使用 API 进行工具调用,或结合现有的工具链进行扩展。
另一方面,Qwen3 模型支持 119 种语言和方言,可以更好的服务全球的开发者与上层应用,并方便企业拓展全球业务。
基于以上能力,可以发现,Qwen3 系列模型非常适合在企业场景中落地,帮助开发者快速构建性能与成本全面可控的产品。
接下来,我们会以RAG为例,结合Milvus与Qwen3 带来手把手搭建教程与推理、非推理模式下的结果与成本对比。
02
RAG搭建教程
环境准备
! pip install --upgrade pymilvus openai requests tqdm
首先,我们需要到阿里云DashScope模型服务灵积的官网获取api keyDASHSCOPE_API_KEY,并添加到环境变量中
import osos.environ["DASHSCOPE_API_KEY"] = "sk-***********"
数据准备
我们可以使用Milvus文档2.4. x中的FAQ页面作为RAG中的私有知识,这是构建一个基础RAG的良好数据源。
下载zip文件并将文档解压缩到文件夹milvus_docs
! wget https://github.com/milvus-io/milvus-docs/releases/download/v2.4.6-preview/milvus_docs_2.4.x_en.zip! unzip -q milvus_docs_2.4.x_en.zip -d milvus_docs
我们从文件夹milvus_docs/en/faq中加载所有markdown文件,对于每个文档,我们只需用“#”来分隔文件中的内容,就可以大致分隔markdown文件各个主要部分的内容。
from glob import globtext_lines = []for file_path in glob("milvus_docs/en/faq/*.md", recursive=True): with open(file_path, "r") as file: file_text = file.read() text_lines += file_text.split("# ")
准备 LLM 和Embedding模型
DashScope支持OpenAI风格的API, 我们可以初始化OpenAI 客户端来来调用LLM。
from openai import OpenAIopenai_client = OpenAI( base_url="https://dashscope.aliyuncs.com/compatible-mode/v1", api_key=os.getenv("DASHSCOPE_API_KEY"))
我们定义一个embedding模型,使用 milvus_model来生成text embedding,并使用DefaultEmbeddingFunction模型作为示例,它是一个预训练的轻量级嵌入模型。
from pymilvus import model as milvus_modelembedding_model = milvus_model.DefaultEmbeddingFunction()
生成一个测试embedding并打印它的维度和前几个元素。
test_embedding = embedding_model.encode_queries(["This is a test"])[0]embedding_dim = len(test_embedding)print(embedding_dim)print(test_embedding[:10])
768[-0.04836066  0.07163023 -0.01130064 -0.03789345 -0.03320649 -0.01318448 -0.03041712 -0.02269499 -0.02317863 -0.00426028]
将数据加载到Milvus,并创建集合
from pymilvus import MilvusClientmilvus_client = MilvusClient(uri="./milvus_demo.db")collection_name = "my_rag_collection"
关于MilvusClient的参数设置:
- 将URI设置为本地文件(例如./milvus.db)是最便捷的方法,因为它会自动使用Milvus Lite将所有数据存储在该文件中。
- 如果你有大规模数据,可以在Docker或Kubernetes上搭建性能更强的Milvus服务器。在这种情况下,请使用服务器的URI(例如http://localhost:19530)作为你的URI。
- 如果你想使用Zilliz Cloud(Milvus的全托管云服务),请调整URI和令牌,它们分别对应Zilliz Cloud中的公共端点(Public Endpoint)和API密钥(Api key)。
检查集合是否已经存在,如果存在则将其删除。
if milvus_client.has_collection(collection_name): milvus_client.drop_collection(collection_name)
创建一个具有指定参数的新集合。
如果未指定任何字段信息,Milvus将自动创建一个默认的ID字段作为主键,以及一个向量字段用于存储向量数据。一个预留的JSON字段用于存储未在schema中定义的字段及其值。
milvus_client.create_collection( collection_name=collection_name, dimension=embedding_dim, metric_type="IP", # Inner product distance consistency_level="Strong", # Strong consistency level)
插入集合
逐行遍历文本,创建嵌入向量,然后将数据插入Milvus。
下面是一个新的字段text,它是集合中的一个未定义的字段。 它将自动创建一个对应的text字段(实际上它底层是由保留的JSON动态字段实现的 ,你不用关心其底层实现。)
from tqdm import tqdmdata = []doc_embeddings = embedding_model.encode_documents(text_lines)for i, line in enumerate(tqdm(text_lines, desc="Creating embeddings")):  data.append({"id": i, "vector": doc_embeddings[i], "text": line})milvus_client.insert(collection_name=collection_name, data=data)
Creating embeddings: 100%|██████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 72/72 [00:00<00:00, 381300.36it/s]{'insert_count': 72, 'ids': [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71], 'cost': 0}
构建RAG,检索数据
我们来指定一个关于Milvus的常见问题。
question = "How is data stored in milvus?"
在集合中搜索该问题,并检索语义上最匹配的前3个结果。
search_res = milvus_client.search( collection_name=collection_name, data=embedding_model.encode_queries( [question] ), # Convert the question to an embedding vector limit=3, # Return top 3 results search_params={"metric_type": "IP", "params": {}}, # Inner product distance output_fields=["text"], # Return the text field)
我们来看看这个查询的搜索结果。
import jsonretrieved_lines_with_distances = [  (res["entity"]["text"], res["distance"]) for res in search_res[0]]print(json.dumps(retrieved_lines_with_distances, indent=4))
[  [    " Where does Milvus store data?\n\nMilvus deals with two types of data, inserted data and metadata. \n\nInserted data, including vector data, scalar data, and collection-specific schema, are stored in persistent storage as incremental log. Milvus supports multiple object storage backends, including [MinIO](https://min.io/), [AWS S3](https://aws.amazon.com/s3/?nc1=h_ls), [Google Cloud Storage](https://cloud.google.com/storage?hl=en#object-storage-for-companies-of-all-sizes) (GCS), [Azure Blob Storage](https://azure.microsoft.com/en-us/products/storage/blobs), [Alibaba Cloud OSS](https://www.alibabacloud.com/product/object-storage-service), and [Tencent Cloud Object Storage](https://www.tencentcloud.com/products/cos) (COS).\n\nMetadata are generated within Milvus. Each Milvus module has its own metadata that are stored in etcd.\n\n###",    0.6572665572166443  ],  [    "How does Milvus flush data?\n\nMilvus returns success when inserted data are loaded to the message queue. However, the data are not yet flushed to the disk. Then Milvus' data node writes the data in the message queue to persistent storage as incremental logs. If `flush()` is called, the data node is forced to write all data in the message queue to persistent storage immediately.\n\n###",    0.6312146186828613  ],  [    "How does Milvus handle vector data types and precision?\n\nMilvus supports Binary, Float32, Float16, and BFloat16 vector types.\n\n- Binary vectors: Store binary data as sequences of 0s and 1s, used in image processing and information retrieval.\n- Float32 vectors: Default storage with a precision of about 7 decimal digits. Even Float64 values are stored with Float32 precision, leading to potential precision loss upon retrieval.\n- Float16 and BFloat16 vectors: Offer reduced precision and memory usage. Float16 is suitable for applications with limited bandwidth and storage, while BFloat16 balances range and efficiency, commonly used in deep learning to reduce computational requirements without significantly impacting accuracy.\n\n###",    0.6115777492523193  ]]
使用大型语言模型(LLM)构建检索增强生成(RAG)响应
将检索到的文档转换为字符串格式。
context = "\n".join( [line_with_distance[0] for line_with_distance in retrieved_lines_with_distances])
为大语言模型提供系统提示(system prompt)和用户提示(user prompt)。这个提示是通过从Milvus检索到的文档生成的。
SYSTEM_PROMPT = """Human: You are an AI assistant. You are able to find answers to the questions from the contextual passage snippets provided."""USER_PROMPT = f"""Use the following pieces of information enclosed in tags to provide an answer to the question enclosed in tags.{context}{question}"""
使用通义千问最新的模型,根据提示生成响应。
completion = openai_client.chat.completions.create( # 模型列表:https://help.aliyun.com/zh/model-studio/getting-started/models model="qwen-plus-2025-04-28", messages=[ {"role": "system", "content": SYSTEM_PROMPT}, {"role": "user", "content": USER_PROMPT}, ], # Qwen3模型通过enable_thinking参数控制思考过程(开源版默认True,商业版默认False) extra_body={"enable_thinking": False},)print(completion.choices[0].message.content)
输出结果展示
In Milvus, data is stored in two main categories: **inserted data** and **metadata**.- **Inserted Data**: This includes vector data (like Binary, Float32, Float16, and BFloat16 types), scalar data, and collection-specific schema. These are stored in persistent storage as **incremental logs**. Milvus supports various object storage backends for this purpose, including: - [MinIO](https://min.io/) - [AWS S3](https://aws.amazon.com/s3/?nc1=h_ls) - [Google Cloud Storage (GCS)](https://cloud.google.com/storage?hl=en#object-storage-for-companies-of-all-sizes) - [Azure Blob Storage](https://azure.microsoft.com/en-us/products/storage/blobs) - [Alibaba Cloud OSS](https://www.alibabacloud.com/product/object-storage-service) - [Tencent Cloud Object Storage (COS)](https://www.tencentcloud.com/products/cos)- **Metadata**: Metadata generated within Milvus is stored separately. Each Milvus module maintains its own metadata, which is stored in [etcd](https://etcd.io/), a distributed key-value store.When data is inserted into Milvus, it is first loaded into a message queue. It is not immediately written to disk. A `flush()` operation ensures that all data in the queue is written to persistent storage immediately.
03
推理模式和非推理模式对比
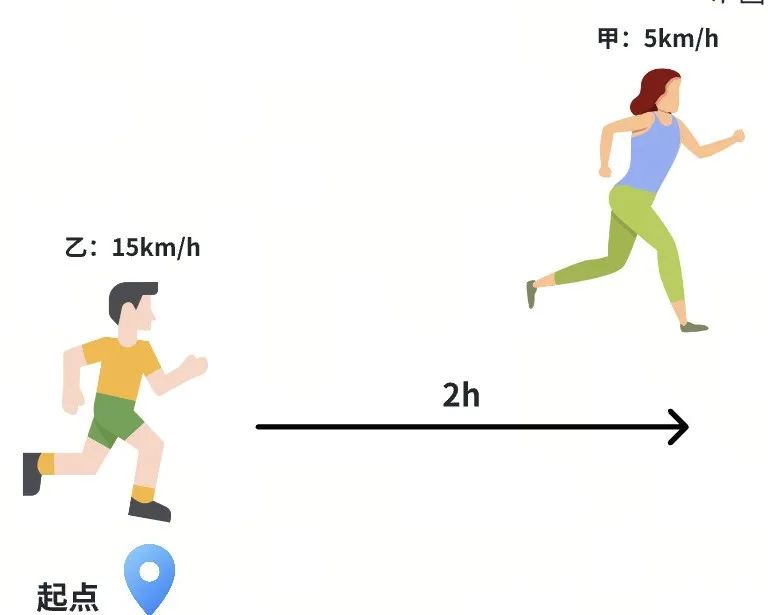
基础数学问题:甲和乙从同一地点出发,甲先走2小时,速度5km/h,乙以15km/h追赶,多久追上?
推理模式
参考代码:
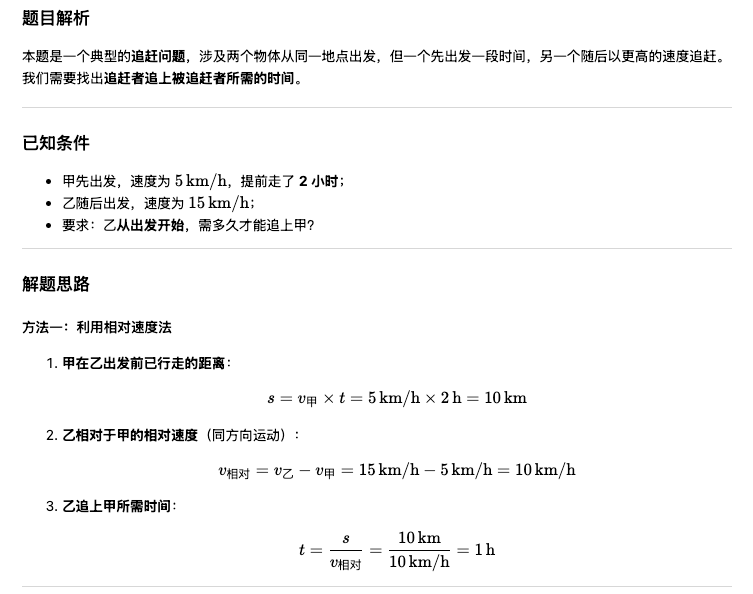
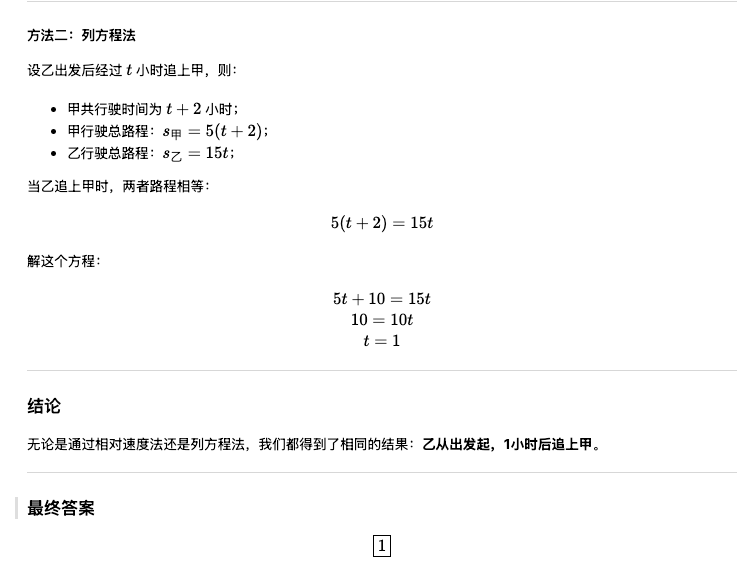
import osimport timefrom openai import OpenAIos.environ["DASHSCOPE_API_KEY"] = "sk-*************************"client = OpenAI( api_key=os.getenv("DASHSCOPE_API_KEY"), base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",)############################################# Think# 记录开始时间start_time = time.time()stream = client.chat.completions.create( # 模型列表:https://help.aliyun.com/zh/model-studio/getting-started/models model="qwen3-235b-a22b", messages=[ {"role": "system", "content": "You are a helpful assistant."}, {"role": "user", "content": "甲和乙从同一地点出发,甲先走2小时,速度5km/h,乙以15km/h追赶,多久追上?"}, ], # Qwen3模型通过enable_thinking参数控制思考过程(开源版默认True,商业版默认False) extra_body={"enable_thinking": True}, stream=True,)answer_content = ""for chunk in stream: delta = chunk.choices[0].delta if delta.content is not None: answer_content += delta.contentprint(answer_content)# 记录结束时间并计算总耗时end_time = time.time()print(f"\n\n总耗时:{end_time - start_time:.2f}秒")从回答的结果来看,推理模式能够通过解析题目知道这是一道追赶问题,然后分析已知条件,并给出两种解题思路和正确答案,说明模型在这个问题上进行了足够的思考。特别是它最终给出的Markdown格式的文档,其中的公式表达非常完美。
整个代码耗时:35.73秒
(下图是我们将大模型回答的markdown结果可视化后的截图,为了方便读者阅读)
非推理模式
在代码中,只需要设置"enable_thinking":False
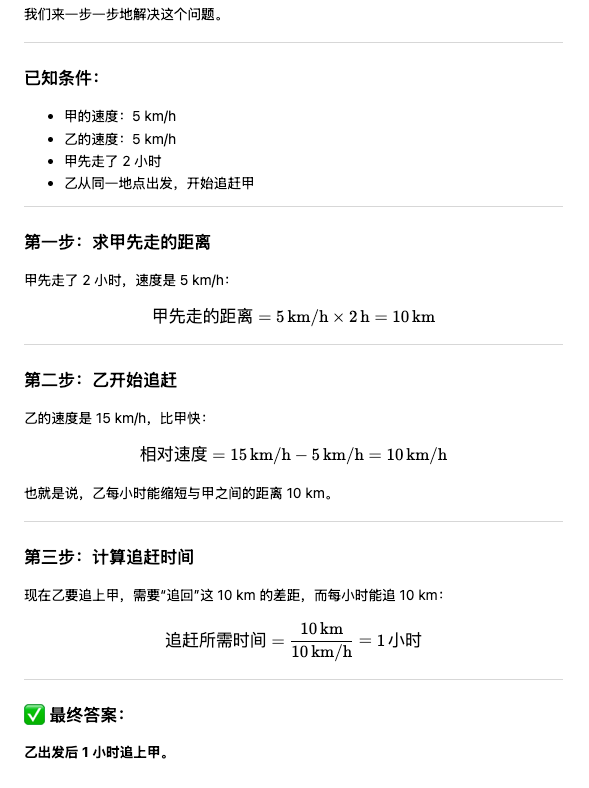
让我们再来看看非推理模式在这个问题的表现:
非推理模式通过一步步求解来解决这个问题,用的是常见的相对速度法,并且很快得出正确答案。
其总耗时在:6.89秒,时间是推理模式的1/5左右。可以看到推理模式相较于非推理会产生更多的思考。
这种更多的思考容易让回答更加丰富,更有逻辑性。但非推理模型相对来说回答更快,这两种模式在处理不同的问题上各有千秋。因此用户可以根据自身的情况进行选择***。***
尾声
整体来说,此次Qwen3系列模型发布除了在各个细分方向实现SOTA之外,更多指向了工程化落地,为RAG或者agent的搭建,在成本与性能的权衡上,做了一个很好的落地打样。
如相比DeepSeek有更小的参数,降低部署成本;如更多语言支持增加全球开发者使用成本;如MCP支持增加生态链接;再比如混合推理模型设计,让用户自由选择是否推理达到输出成本的精准调控。
在不久前开源的DeepSearcher项目(Zilliz开源的深度检索、报告生成项目)中,我们曾收到大量用户反馈——用推理模型做DeepSearcher,不仅等待时间较长,成本也不可控;但只用非推理模型,又会导致检索的轮次、智能程度大大降低,无法达到agentic rag的预期效果。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 3493


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


