【2025版】QwQ-32B,性能比肩全球最强开源推理模型,(非常详细)从零基础到精通,精通收藏这篇就够了!

QwQ - 32B 与 GPT - O1 的全面对比分析 在人工智能领域,大语言模型的发展日新月异,它们在理解和生成能力上不断突破界限。QwQ - 32B 和 GPT - O1 作为其中的代表模型,各自展现出独特的特性和优势。本文将从多个维度对 QwQ - 32B 和 GPT - O1 进行深入对比,包括训练方法、模型架构、实际应用表现等方面,以帮助读者更好地理解这两款模型的差异和适用场景。 阅读详情

近期的研究表明,强化学习可以显著提高模型的推理能力。例如,DeepSeek-R1 通过整合冷启动数据和多阶段训练,实现了最先进的性能,使其能够进行深度思考和复杂推理。

这一次,我们探讨了大规模强化学习(RL)对大语言模型的智能的提升作用,同时推出我们最新的推理模型 QwQ-32B。这是一款拥有 320 亿参数的模型,其性能可与具备 6710 亿参数(其中 370 亿被激活)的 DeepSeek-R1 媲美。

这一成果突显了将强化学习应用于经过大规模预训练的强大基础模型的有效性。此外,我们还在推理模型中集成了与 Agent 相关的能力,使其能够在使用工具的同时进行批判性思考,并根据环境反馈调整推理过程。

我们希望我们的一点努力能够证明强大的基础模型叠加大规模强化学习也许是一条通往通用人工智能的可行之路。

QwQ-32B 模型效果

QwQ-32B 在一系列基准测试中进行了评估,测试了数学推理、编程能力和通用能力。以下结果展示了 QwQ-32B 与其他领先模型的性能对比,包括 DeepSeek-R1-Distilled-Qwen-32B、DeepSeek-R1-Distilled-Llama-70B、o1-mini 以及原始的 DeepSeek-R1。
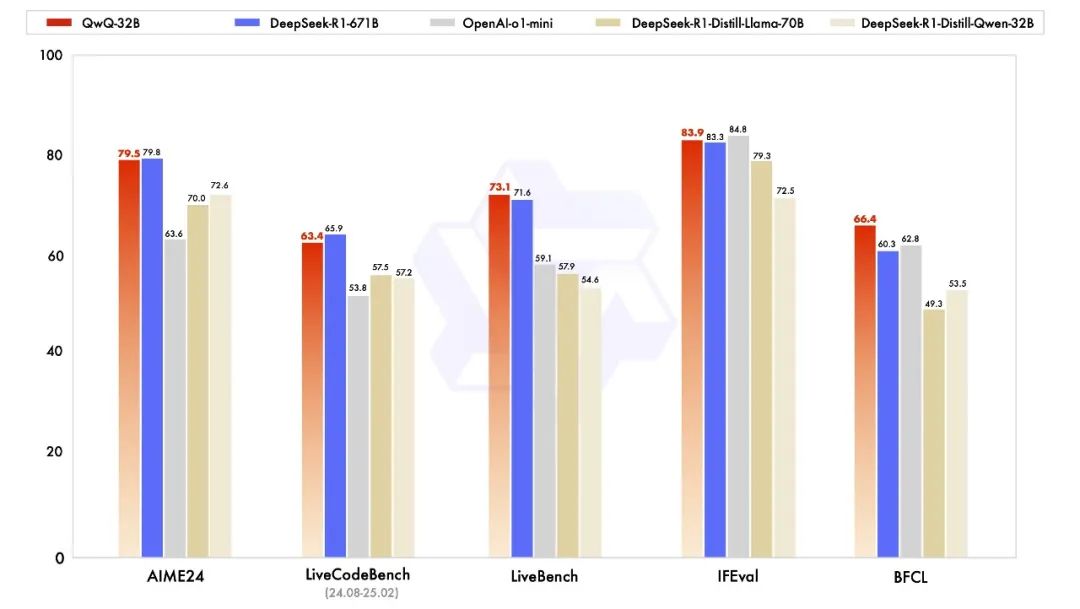
图片

在测试数学能力的 AIME24 评测集上,以及评估代码能力的 LiveCodeBench 中,千问 QwQ-32B 表现与DeepSeek-R1相当,远胜于 o1-mini 及相同尺寸的R1 蒸馏模型;在由Meta首席科学家杨立昆领衔的“最难LLMs评测榜” LiveBench、谷歌等提出的指令遵循能力IFEval评测集、由加州大学伯克利分校等提出的评估准确调用函数或工具方面的BFCL测试中,千问 QwQ-32B 的得分均超越了 DeepSeek- R1。

大规模强化学习

我们在冷启动的基础上开展了大规模强化学习。在初始阶段,特别针对数学和编程任务进行了 RL 训练。与依赖传统的奖励模型(reward model)不同,我们通过校验生成答案的正确性来为数学问题提供反馈,并通过代码执行服务器评估生成的代码是否成功通过测试用例来提供代码的反馈。

我们发现在 RL 扩展过程中,随着训练轮次的推进,这两个领域中的性能均表现出持续的提升。

在第一阶段的 RL 过后,我们增加了另一个针对通用能力的 RL。此阶段使用通用奖励模型和一些基于规则的验证器进行训练。我们发现,通过少量步骤的通用 RL,可以提升其他通用能力,同时在数学和编程任务上的性能没有显著下降。

通过API使用QwQ-32B

以下我们展示了一段简短的示例代码,说明如何通过 API 使用 QwQ-32B。

from openai import OpenAI``import os``   ``# Initialize OpenAI client``client = OpenAI(`    `# If the environment variable is not configured, replace with your API Key: api_key="sk-xxx"`    `# How to get an API Key:https://help.aliyun.com/zh/model-studio/developer-reference/get-api-key`    `api_key=os.getenv("DASHSCOPE_API_KEY"),`    `base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"``)``   ``reasoning_content = ""``content = ""``   ``is_answering = False``   ``completion = client.chat.completions.create(`    `model="qwq-32b",`    `messages=[`        `{"role": "user", "content": "Which is larger, 9.9 or 9.11?"}`    `],`    `stream=True,`    `# Uncomment the following line to return token usage in the last chunk`    `# stream_options={`    `#     "include_usage": True`    `# }``)``   ``print("\n" + "=" * 20 + "reasoning content" + "=" * 20 + "\n")``   ``for chunk in completion:`    `# If chunk.choices is empty, print usage`    `if not chunk.choices:`        `print("\nUsage:")`        `print(chunk.usage)`    `else:`        `delta = chunk.choices[0].delta`        `# Print reasoning content`        `if hasattr(delta, 'reasoning_content') and delta.reasoning_content is not None:`            `print(delta.reasoning_content, end='', flush=True)`            `reasoning_content += delta.reasoning_content`        `else:`            `if delta.content != "" and is_answering is False:`                `print("\n" + "=" * 20 + "content" + "=" * 20 + "\n")`                `is_answering = True`            `# Print content`            `print(delta.content, end='', flush=True)`            `content += delta.content

未来

这是Qwen在大规模强化学习(RL)以增强推理能力方面的第一步。通过这一旅程,我们不仅见证了扩展RL的巨大潜力,还认识到预训练语言模型中尚未开发的可能性。

在致力于开发下一代Qwen的过程中,我们相信将更强大的基础模型与依托规模化计算资源的RL相结合,将会使我们更接近实现人工通用智能(AGI)。此外,我们正在积极探索将智能体与RL集成,以实现长时推理,目标是通过推理时间扩展来释放更高的智能,敬请期待。

欢迎体验

目前,QwQ-32B 已在 Hugging Face (https://huggingface.co/Qwen/QwQ-32B) 和 ModelScope (https://modelscope.cn/models/Qwen/QwQ-32B) 开源,并采用了 Apache 2.0 开源协议。

也欢迎大家通过 Qwen Chat

(https://chat.qwen.ai/?models=Qwen2.5-Plus)直接进行体验!

## AI大模型学习福利

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

四、AI大模型商业化落地方案

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

华为2019秋招笔试Java实现(2) 华为2019秋招笔试Java实现(2) 笔试日期2019年8月14日 第二题(200分) 题目描述 某程序员小A,有一种表格数据需要存储在文件中。表格中的每一行,由若干个字段组成,每个字段可以是整数或字符串(字符串只包含数字、字母以及特殊字符!@#%^&*()",)。小A设计了一种存储格式,采用文本的方式对表格数据进行存储。文本文件中的每一行,代表了表格数据中的一行数据。具体格式描述如下: 1、采用逗号分隔不同的字段(逗号前后无空格); 2、数字直接采用10进制的文本存储; 3、字符串的存储规则如下 阅读详情

相关推荐

浮点数运算的陷阱与启示:FP16加法器/乘法器开发中的常见误区

本文深入探讨FP16加法器和乘法器开发中的常见误区,包括FP16格式解析、阶码对齐陷阱、尾数运算风险及规格化处理。通过Verilog实战代码展示防御性编程技巧,帮助开发者避免边界条件处理和异常状态管理中的错误,提升硬件设计的可靠性和效率。

dell8的博客 250

通义千问:QwQ-32B 模型超越 OpenAI o1

思考、质疑、理解,是人类探索未知的永恒追求。在这条探索之路上,QwQ犹如一位怀抱无尽好奇的学徒,以思考和疑问照亮前路。QwQ体现了古老的哲学精神:它深知自己一无所知,而这种认知正是其好奇心的源泉。在探寻答案的过程中,它始终保持自省,以理性之光审视每一个假设,在不同的思维维度中穿行,追寻更深层的真理。然而,正如所有智慧的追求者一样,

aolan123的博客 2337

峰值电流模式CCM BUCK的传递函数推导

电流内环闭环传递函数: Gci(s)=i^L(s)v^comp(s)=FmGid(s)1+KRiHe(s)FmGid(s)=1Ri11+s[mcL+(0.5VIN−Vo)RiVINRifSW]+s21(πfSW)2 G_{ci}(s)=\frac{\hat i_{L}(s)}{\hat v_{comp}(s)}=\frac {F_mG_{id}(s)}{1+KR_iH_e(s)F_mG_{id}(s)}=\frac{1}{R_i}\frac{1}{1+s[\frac{m_cL+(0.5V_{IN}-V_o)

c007106333的博客 2357

QWQ-32B概述与本地部署使用

2025年3月5日,阿里巴巴千问QwQ-32B,即DeepSeek之后,中国AI大模型有一次震惊世界。QwQ-32B 的运行成本显著低于 DeepSeek-R1 等模型,性能更优,成本仅为 1/10,体现了我国在被外国技术封锁的情况下进行进行自主创新的能力。QwQ 是 Qwen 系列的大模型之一,专注于 推理能力(reasoning)。

寸先生的AI道路 4134

PostgreSQL中idle in transaction状态的5个隐藏危害及实战解决方案

本文深入剖析了PostgreSQL中`idle in transaction`连接状态的五大隐藏危害,包括内存与锁泄漏、VACUUM受阻导致表膨胀、事务ID加速消耗、连接池资源耗尽以及增加故障排查复杂度。文章提供了基于`pg_stat_activity`视图的监控方法、识别高危事务的SQL脚本,并给出了从数据库参数调优(如设置`idle_in_transaction_session_timeout`)到应用层编码规范与连接池配置的完整实战解决方案。

zzz56的博客 234

UE5.3与Colosseum配置实战:从编译到问题解决的全流程指南

本文提供了在Windows系统下配置UE5.3与Colosseum仿真环境的全流程实战指南。详细介绍了从软件版本选择、源代码获取、编译脚本执行到解决常见编译错误和引擎崩溃问题的具体步骤,旨在帮助开发者高效搭建无人机、机器人等仿真平台,并顺利运行外部API控制。

weixin_29002595的博客 557

QwQ-32B 测评和使用教程来了!

昨天凌晨,阿里开源了全新的推理模型:QwQ-32B。据官方发布消息,该模型性能比肩满血版 DeepSeek-R1(671B)!可以看到在官方放出的评测图中, QwQ-32B 与满血版 DeepSeek R1(671B)在五项基准测试的得分不相上下,更是远超同尺寸 R1 蒸馏模型。看到了这些消息后,我就开始上手深度测试。QwQ-32B开源链接:魔搭开源链接:https://modelscope.cn/models/Qwen/QwQ-32B。

z551646的博客 3734

RK3588 C-PHY摄像头驱动升级踩坑记:从‘Only CSI2 supported’报错到成功取流

本文详细记录了在RK3588平台上调试C-PHY摄像头驱动的全过程,从‘Only CSI2 supported’报错分析到成功取流。内容涵盖C-PHY与CSI-2协议差异、SDK版本对比、V4L2框架下的bus-type解析机制,以及硬件排查与寄存器调优实战经验,为嵌入式Camera驱动工程师提供宝贵参考。

weixin_42522374的博客 124

千问推理模型QwQ-32B测评

1. QWQ-32B满血版本和deepSeekR1 满血版本,在语言对话上已经明显好于o1-mini 和gpt4o, 特别是一些和中文相关的问题, 但由于o1-mini和gpt4o还有多模态的能力 QWQ-32B满血版本和deepSeekR1 满血版本还不支持 还无法在多模态能力上进行比较,但相信应该快了。

2401_84495872的博客 3062

YOLOv11 模型轻量化全流程:从剪枝到量化,打造移动端“极速检测利器”

将浮点模型量化为INT8模型,减少内存占用并加速推理。# 加载剪枝后的模型# 转换为TorchScript# 静态量化# 保存量化模型量化后模型推理速度可再提升20%,而mAP损失小于1%。

m0_64661770的博客 465

1.4 你绝对不能错过的天气查询工具:MCP 标准化接入实战

本文介绍了如何构建一个符合MCP标准的天气查询服务。通过FastMCP框架集成OpenWeatherMap API,实现实时天气、天气预报和历史天气查询功能。文章详细展示了从环境准备、插件设计到控制器实现的完整流程,包括如何定义工具函数、配置路由和中间件。同时讲解了如何将MCP服务封装为LangChain工具并与DeepSeek等大模型集成,还涵盖了缓存、限流等高级特性。该示例演示了如何将任意API标准化为MCP服务,为Agent应用提供统一接口。

yonggeit的博客 3047

【2025版】QwQ-32B,性能比肩全球最强开源推理模型,从零基础到精通,精通收藏这篇就够了!

近期的研究表明,强化学习可以显著提高模型的推理能力。例如,DeepSeek-R1 通过整合冷启动数据和多阶段训练,实现了最先进的性能,使其能够进行深度思考和复杂推理。这一次,我们探讨了大规模强化学习(RL)对大语言模型的智能的提升作用,同时推出我们。这是一款拥有 320 亿参数的模型,其性能可与具备 6710 亿参数(其中 370 亿被激活)的 DeepSeek-R1 媲美。这一成果突显了将强化学习应用于经过大规模预训练的强大基础模型的有效性。此外,我们还在推理模型中。

leah126的博客 987

微信小程序 “net::ERR_CONNECTION_REFUSED” 报错大揭秘与破解之道

在微信小程序开发与运行过程中,“net::ERR_CONNECTION_REFUSED” 报错是开发者常遇难题。该错误意味着小程序与服务器连接建立失败,会导致功能无法使用、数据加载异常等问题,严重影响用户体验和业务运转。本文系统剖析此错误,从网络环境不佳、服务器异常、小程序配置有误等常见触发场景入手,提供网络、服务器、配置、代码等多维度排查步骤,给出针对性解决策略,如修复网络、处理服务器故障、修正配置与代码错误,还提出开发与运维阶段的预防措施,助力开发者高效解决该报错问题。

邓邓子的博客 6134

【2025版】QwQ-32B,性能比肩全球最强开源推理模型, (非常详细)从零基础入门到精通,收藏这篇就够了

近期的研究表明,强化学习可以显著提高模型的推理能力。例如,DeepSeek-R1 通过整合冷启动数据和多阶段训练,实现了最先进的性能,使其能够进行深度思考和复杂推理。这一次,我们探讨了大规模强化学习(RL)对大语言模型的智能的提升作用,同时推出我们。这是一款拥有 320 亿参数的模型,其性能可与具备 6710 亿参数(其中 370 亿被激活)的 DeepSeek-R1 媲美。这一成果突显了将强化学习应用于经过大规模预训练的强大基础模型的有效性。此外,我们还在推理模型中。

Javachichi的博客 943

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

阿里深夜开源推理模型QwQ-32B,性能比肩R1满血版

尤其是对于那些致力于打造专业级AI解决方案的小型企业或是初创团队而言,Qwen-32B无疑提供了一个极具吸引力的选择——它既具备强大的逻辑推理、数学处理以及编程能力,又保持了良好的可访问性和灵活性。我把这段代码粘贴到了Leetcode平台上,直接提交,没想到这段代码竟然完美的通过了全部测试用例吗,而且执行用时才127ms,击败了93%的在这个算法题库做尝试的人。最后的原因还是落在了Qwen团队的强化学习上。说实话,这个结果让我挺惊讶的,毕竟127ms的用时,看平均的用时基本都在1691ms左右。

weixin_43102784的博客 1091

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

【AI大模型前沿】阿里 QwQ-32B:320 亿参数推理大模型,性能比肩 DeepSeek-R1,免费开源

在人工智能领域,大模型的发展一直是技术前沿的热点话题。2025 年 3 月 6 日,阿里巴巴 Qwen 团队正式开源了其最新研发的推理大模型QwQ-32B,这无疑为全球开发者带来了一股强劲的创新动力。这款拥有 320 亿参数的模型,在数学推理、代码生成和逻辑分析等关键领域展现出了卓越的性能,迅速吸引了众多目光。令人惊叹的是,其性能不仅能够与参数规模高达 6710 亿的 DeepSeek-R1 相媲美,更凭借开源免费、轻量化部署的特性,极大地降低了技术门槛,成为了中小团队和学术研究的理想选择。

寻道AI,探索AI无限可能! 2134

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

国产AI卷疯了,QwQ-32B登顶全球最强开源模型!

最新一期的 LiveBench 国际权威榜单放出来,阿里通义千问 QwQ-32B 一举冲进全球前五,并且直接坐稳最强开源模型的宝座! 过去几年,聊起开源大模型,大家第一反应肯定是 Meta(Llama)、Mistral 这些欧美厂牌,基本是他们说了算。而如今,我们的DQ(DeepSeek & Qwen)以压倒性优势登顶 LiveBench,标志着中国 AI 开源模型正式进入全球第一梯队!

2401_85325397的博客 1044

阿里QwQ-32B震撼发布:小模型如何挑战DeepSeek-R1霸主地位?

国产AI的又一次突破!2025年3月6日凌晨,阿里云通义千问团队抛出一枚重磅炸弹——全新开源推理模型 QwQ-32B 正式亮相!这款仅有 320亿参数 的“小个子”,竟然在性能上直逼拥有 6710亿参数 的国产霸主 DeepSeek-R1 满血版。更令人惊讶的是,它还能在消费级显卡甚至苹果笔记本上跑起来!这不仅是一次技术的飞跃,更是国产AI从“大力出奇迹”向“精巧出智慧”转型的标志。QwQ-32B:小身材,大智慧QwQ-32B 是阿里通义千问团队的最新力作。

z551646的博客 1096

免费领各大模型API及使用教程:通义千问QwQ-32B DeepSeek 百川智能 零一万物 元语智能 智谱AI BELLE BiLLa Black Forest Labs 腾讯混元 等

QwQ-32B是阿里巴巴于2025年3月6日开源的推理模型,其核心定位是以极简参数规模实现顶级性能,参数量仅320亿(32B),但通过强化学习与架构优化,性能可媲美6710亿参数的DeepSeek-R1,甚至在部分评测中超越后者。这一突破标志着大模型从“参数竞赛”向“效率与场景精度”范式的转变。三大技术突破参数效率革命通过动态稀疏激活技术。

jijinduoduo的博客 3105

昇思MindSpore支持QwQ-32B并上线魔乐社区

昇思MindSpore原生支持Qwen2.5-32B, 在此基础上0Day完成QwQ-32B的支持,并且完成性能测试。魔乐社区已第一时间上架该模型,欢迎广大开发者下载体验!此外,MindSpore将于近期支持vLLM推理框架部署,敬请期待! 🔗 模型链接:https://modelers.cn/models/MindSpore-Lab/QwQ-32B

2401_87243659的博客 1320

Manus横空出世,阿里开源QwQ-32B,豆包深度思考,字节发布Trae国内版!| AI Weekly 3.3-3.9

Manus横空出世,阿里开源QwQ-32B,豆包深度思考,字节发布Trae国内版!| AI Weekly 3.3-3.9

hunteritself的博客 1731

国产AI卷疯了!Manus横空出世,阿里开源QwQ-32B!

大家好,我是玄姐。AI 界的动态不断,昨夜,两项重大的 AI 进展引起了广泛关注:Manus:宣称是全球首个通用 AI Agent 的 Manus 惊艳亮相,其特色在于能自主执行复杂任务,如数据整理、行程规划等。这是否意味着 AI 助手正向智能代理大步迈进?QwQ-32B:阿里巴巴开源的32B参数模型,在多项基准测试中与 DeepSeek-R1 不相上下,但其参数量仅为后者的1/20。小型模型如何...

musicml的博客 1147

最强国产大模型QwQ-32B,一键本地运行!

2025年开年,AI领域迎来重磅转折——国际权威机构MLCommons最新报告显示,全球大模型推理成本同比下降68%,其中中国企业贡献了超过40%的技术突破。在这场效率革命中,阿里巴巴Qwen团队3月6日开源的QwQ-32B模型,其参数仅为 DeepSeek R1 的 1/21,成本仅 1/10,极致性价比,让普通消费级显卡实现了超越专业AI服务器的能力!当OpenAI还在为GPT-5的万亿参数争论时,阿里工程师用"数学老师"思维破解了算力困局。摒弃传统奖励模型,直接通过验证答案正确性构建反馈系统。

m0_63171455的博客 1159

大模型时代的“双子星”:阿里QwQ-32B与Manus为何引爆科技圈?

年前随着Deepseek的爆火,AI天都塌了,各大厂商企业纷纷接入Deepseek。本以为这一波可以安稳几天,谁曾想短短几个月QwQ-32B与Manus的问世,更是让技术人疯狂、让厂商应接不暇。AI技术的发展简直太迅速了,反应慢了连汤都喝不上。

static_coder的博客 1299

AI开源竞赛与硬件革命:2025年3月科技热点全景解读——阿里、腾讯领跑开源,英特尔、台积电重塑算力格局

阿里以QwQ-32B证明“算法密度>参数规模”的新范式,开辟国产AI技术的话语权路径;台积电通过千亿美元投资,将芯片制造霸权与地缘政治深度绑定;英特尔与腾讯则分别从硬件普惠与内容生成切入,拓宽AI应用的边界。这场竞赛不仅是技术的角力,更是全球智能化进程中“开放生态”与“硬件霸权”的博弈缩影。未来,算法创新、算力基建与伦理规范的平衡,将成为决定AI社会价值的关键11112。延伸阅读(基于搜索结果补充):量子计算突破:中国“祖冲之三号”实现超导量子优越性,速度超经典计算机千万亿倍4。

sveewg的博客 6947
上一篇: 年薪30万+这些网络安全岗位你了解多少?(非常详细)从零基础到精通,收藏这篇就够了!
下一篇: 序列化和反序列化漏洞的简单理解,(非常详细)从零基础到精通,收藏这篇就够了!
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值