


C++学习-入门到精通-【4】函数与递归入门
函数与递归入门
一、 数学库函数
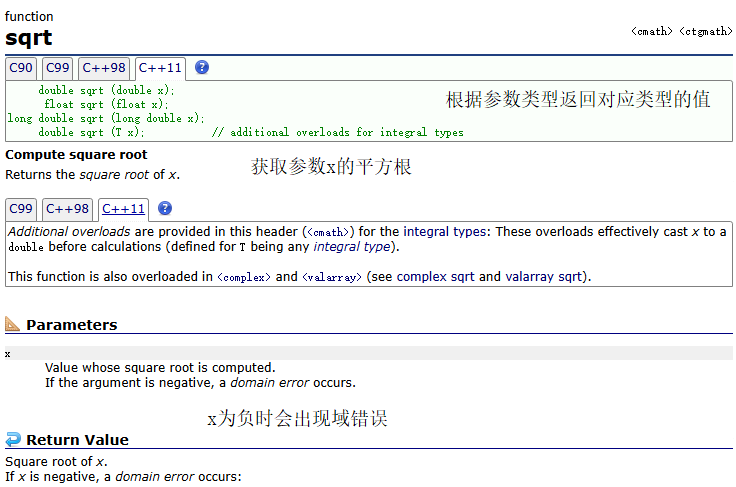
头文件向用户提供了一系列的数学函数。
sqrt()
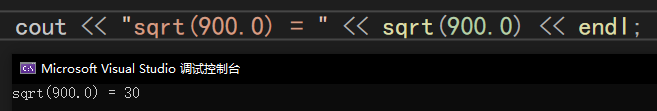
示例:
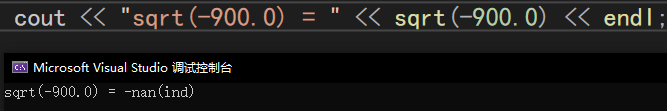
使用负数作为sqrt的参数时
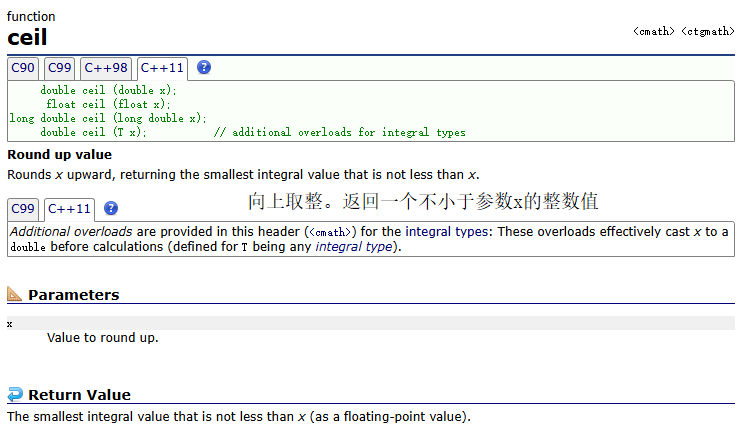
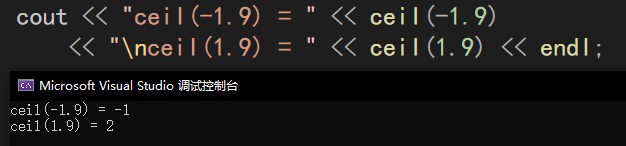
ceil()
示例:
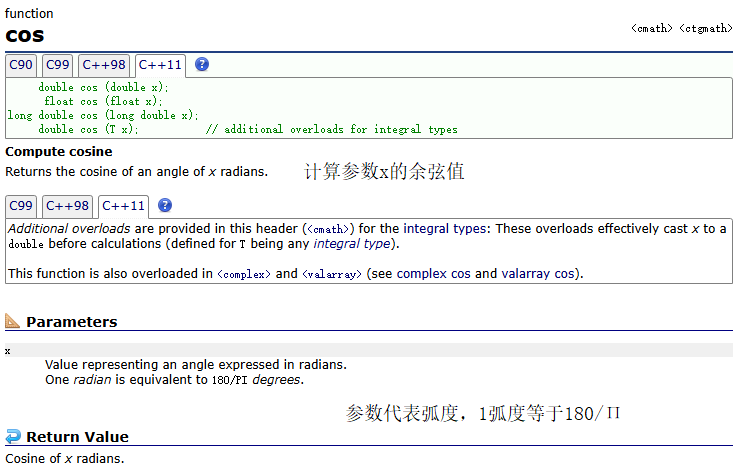
cos()
示例:
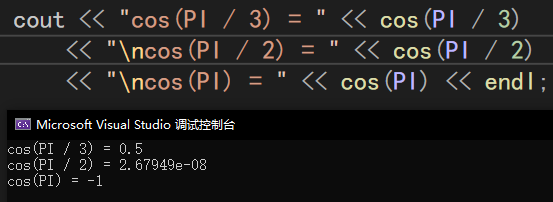
因为设置的PI的数值是一个近似值,所以cos(PI/2)得到的是一个0的近似值。
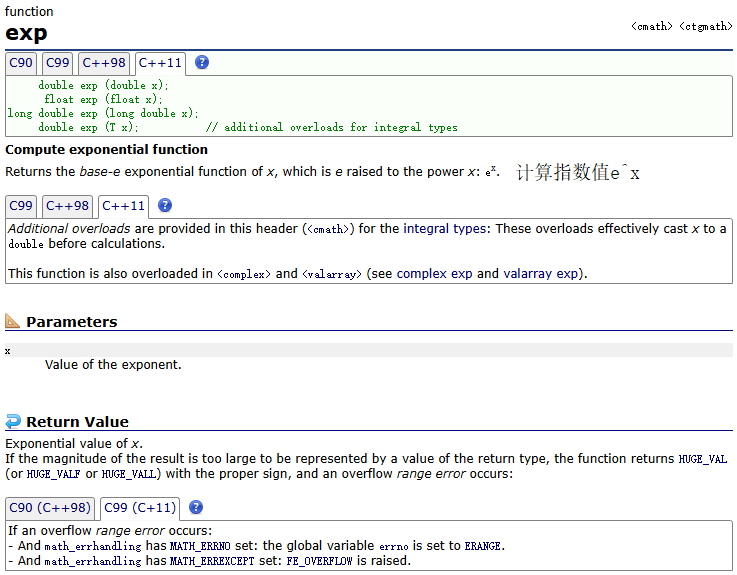
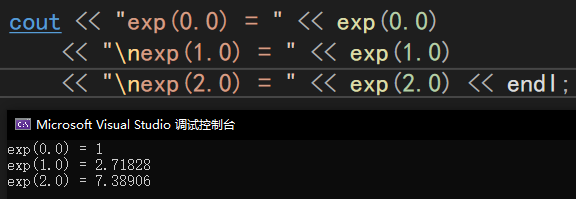
exp()
示例:
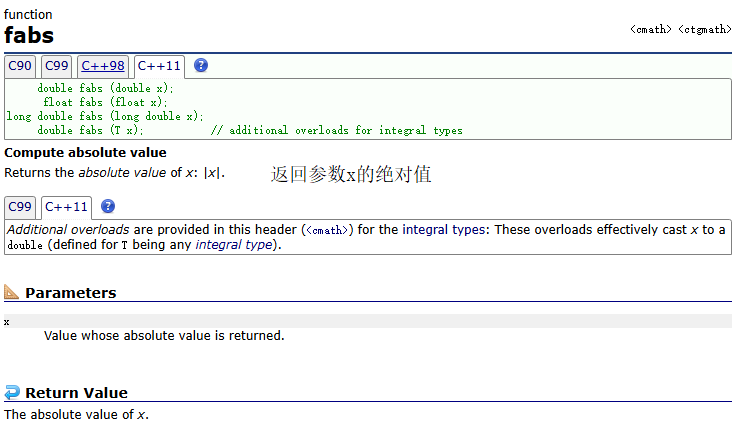
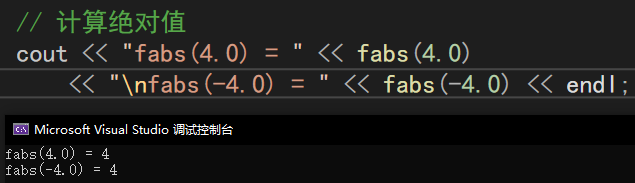
fabs()
示例:
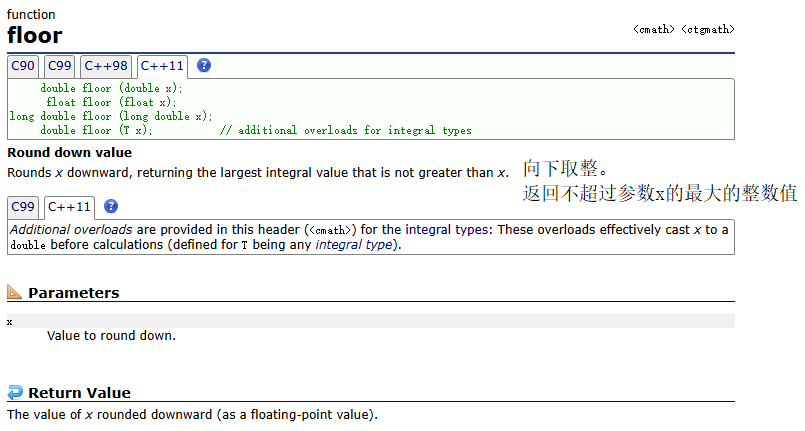
floor()
示例:
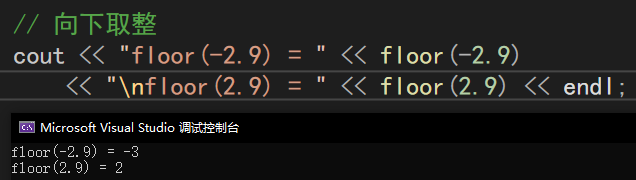
fmod()
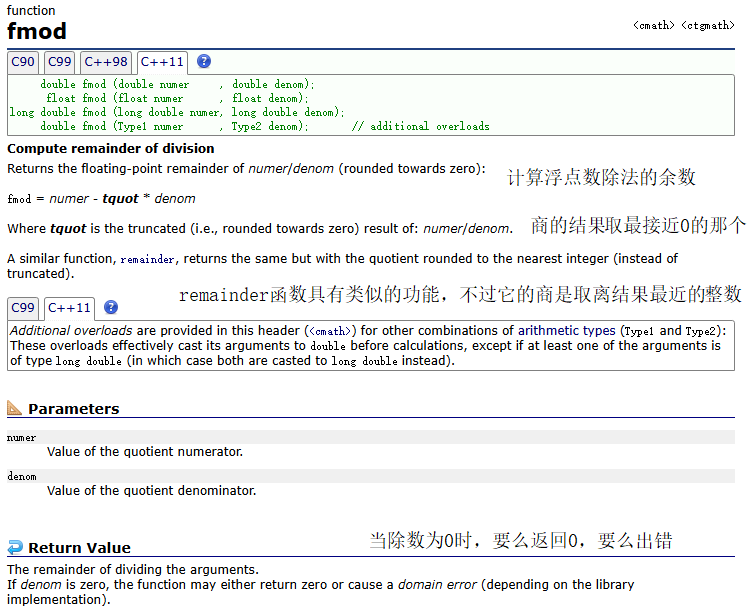
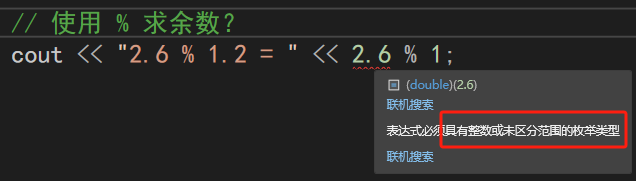
大家可能会存在这样的疑问,求余数为什么不使用取模操作符
%呢?
接下来就介绍为什么:
可以看到操作符%的两边操作数是不接受浮点数的,只接收整形类型的表达式。
函数使用示例:
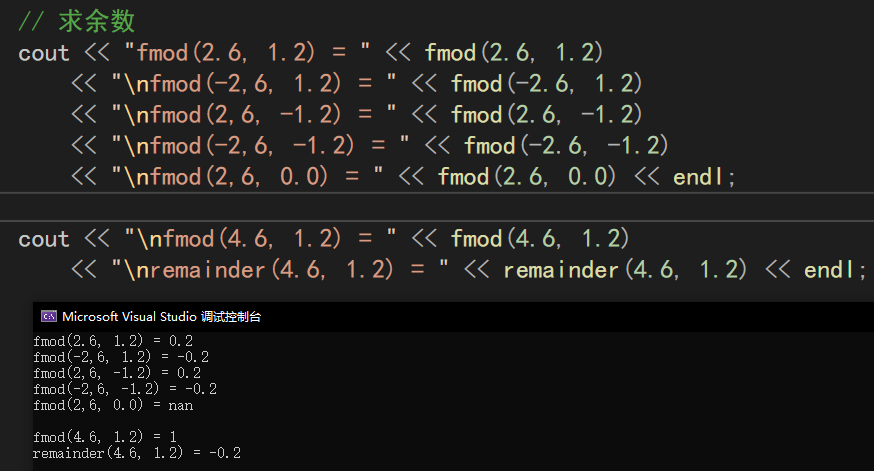
在上面的结果中可以得到,2.6 / 1.2 可以取两个结果——2和3,2更接近0,所以商取2,得到的余数为0.2;-2.6 / 1.2可以取两个结果——-2和-3,-2更接近0,所以商取-2,得到的余数为-0.2;
而remainder函数取的商的原则是使得除法的结果更接近0,所以在4.6 / 1.2的两个结果——3和4之间选择了4,因为4.8比3.6更接近4.6。
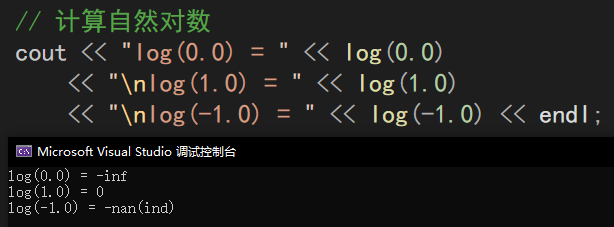
log()
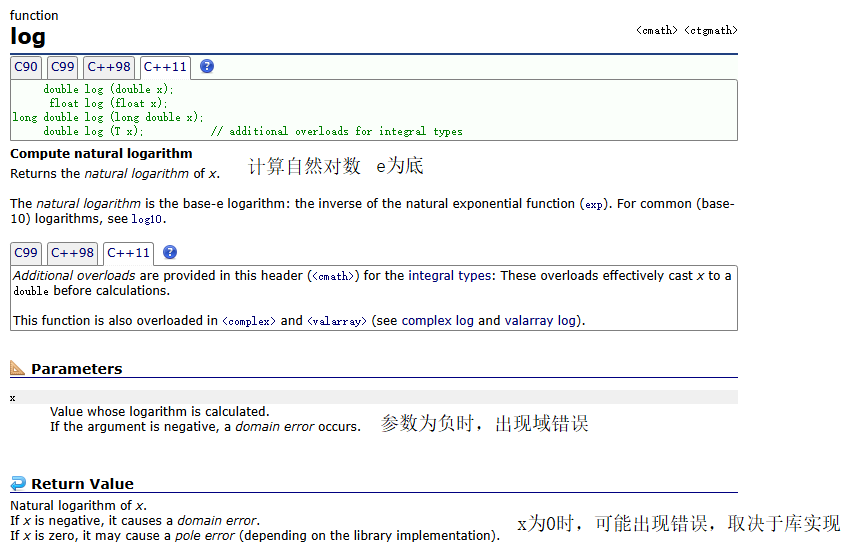
示例:
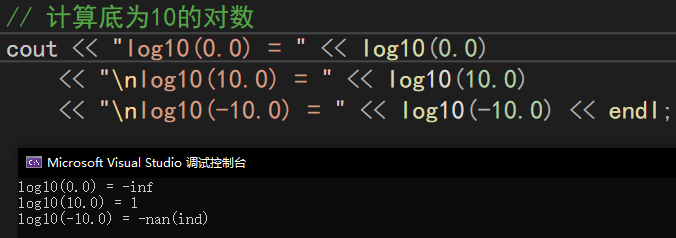
log10()
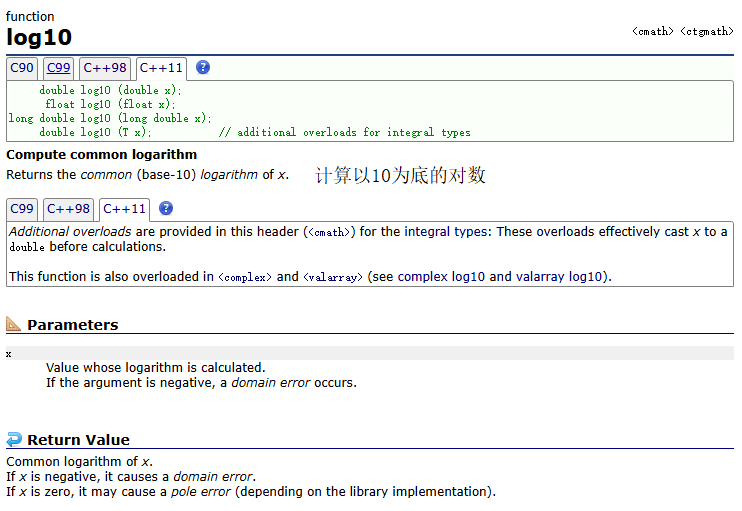
示例:
pow()
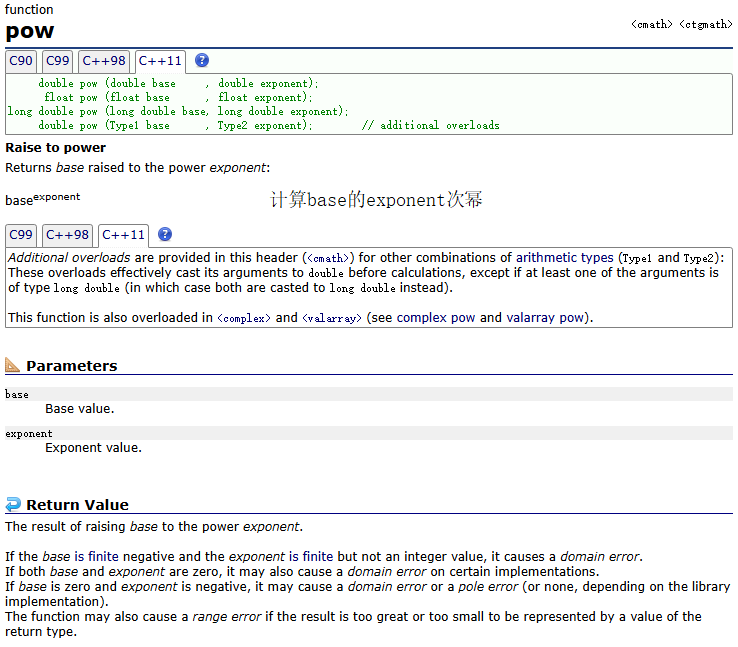
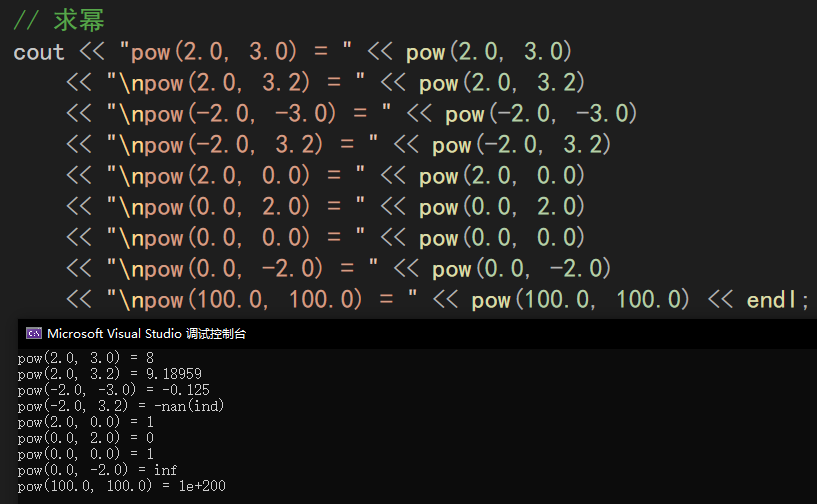
示例:
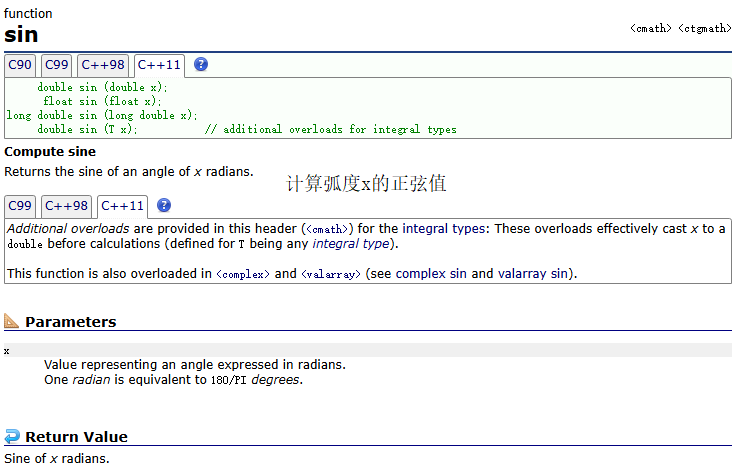
sin()
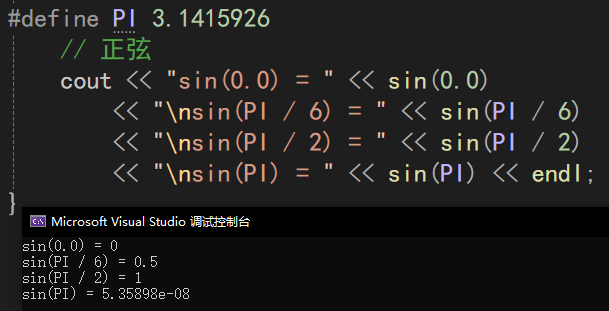
示例:
tan()
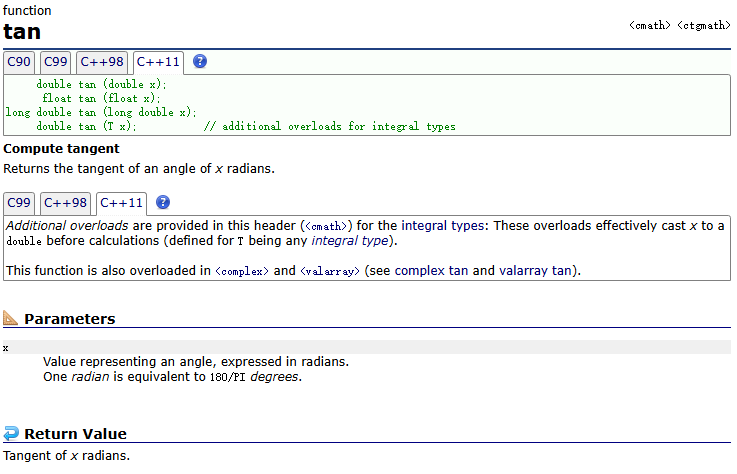
示例:
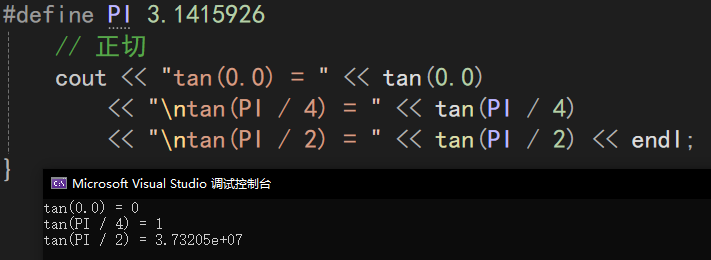
总结
| 函数 | 描述 | 示例 |
|---|---|---|
| sqrt(x) | 计算x的平方根 | sqrt(9.0) = 3.0 |
| pow(x, y) | 计算x的y次幂 | pow(2.0, 3.0) = 8.0 |
| ceil(x) | 向上取整 | ceil(6,6) = 7.0 |
| floor(x) | 向下取整 | floor(6.6) = 6.0 |
| fabs(x) | 取x的绝对值 | fabs(-2.0) = 2.0 |
| fmod(x, y) | 求x/y的余数(商取更接近0的值) | fmod(2.6, 1.2) = 0.2 |
| exp(x) | 计算e的x次幂 | exp(1.0) = e,(e是自然常数) |
| log(x) | 计算以e为底x的对数 | log(e) = 1.0 |
| log10(x) | 计算以10为底x的对数 | log10(10.0) = 1.0 |
| cos(x) | 计算弧度x的余弦值 | cos(PI / 3) = 0.5 |
| sin(x) | 计算弧度x的正弦值 | sin(PI /6) = 0.5 |
| tan(x) | 计算弧度x的正切值 | tan(PI / 4) = 1 |
二、具有多个形参的函数定义
GradeBook.h
#include <string>

class GradeBook
{
public:
	explicit GradeBook(std::string);
	void setCourseName(std::string);
	std::string getCourseName() const;
	void displayMessage() const;
	void inputGrades();
	void displayGradeReport() const;
	int maximum(int, int, int) const;
private:
	std::string CourseName;
	int maximumGrade;
};
GradeBook.cpp
#include "GradeBook.h"
#include <iostream>

using namespace std;

// 构造函数
GradeBook::GradeBook(string name)
	:maximumGrade(0) // 使用列表初始化器将数据成员maximumGrade初始化为0
{
	setCourseName(name); // 使用set成员函数初始化数据成员CourseName
}

// set成员函数,设置数据成员CourseName的值
void GradeBook::setCourseName(string name)
{
	// 检查参数的有效性
	// 课程名不超过25个字符合法
	if (name.size() <= 25)
	{
		CourseName = name;
	}
	else // 异常处理
	{
		CourseName = name.substr(0, 25); // 截断处理,取name的前25个字符赋值给课程名
		// 输出错误信息
		cerr << "Name \"" << name << "\" is exceeds maximum length(25).\n"
			<< "Limitng CourseName to first 25 characters.\n" << endl;
	}
}

// get成员函数,获取数据成员CourseName
string GradeBook::getCourseName() const
{
	return CourseName;
}

// 打印欢迎信息
void GradeBook::displayMessage() const
{
	cout << "Welcome to the Grade Book of " << getCourseName() << "!" << endl;
}

// 输入三个成绩,并判断最大值
void GradeBook::inputGrades()
{
	int grade1{0}, grade2{0}, grade3{0};

	// 判断输入成绩的有效性
	do
	{
		cout << "Enter the first Grade:>";
		cin >> grade1;
		if (grade1 < 0)
		{
			cerr << "The Grade should be greater than 0." << endl;
		}
	} while(grade1 < 0);

	do
	{
		cout << "Enter the second Grade:>";
		cin >> grade2;
		if (grade2 < 0)
		{
			cerr << "The Grade should be greater than 0." << endl;
		}
	} while (grade2 < 0);

	do
	{
		cout << "Enter the third Grade:>";
		cin >> grade3;
		if (grade3 < 0)
		{
			cerr << "The Grade should be greater than 0." << endl;
		}
	} while (grade3 < 0);


	maximumGrade = maximum(grade1, grade2, grade3);
}

int GradeBook::maximum(int grade1, int grade2, int grade3) const
{
	int max = grade1;

	if (grade2 > max)
	{
		max = grade2;
	}

	if (grade3 > max)
	{
		max = grade3;
	}

	return max;
}

// 打印最大成绩
void GradeBook::displayGradeReport() const
{
	cout << "Maximum of Grades entered: " << maximumGrade << endl;
}
test.cpp
#include <iostream>
#include "GradeBook.h"

using namespace std;

int main()
{
	GradeBook myGradeBook("CS1201 C++ Programming");

	myGradeBook.displayMessage();
	myGradeBook.inputGrades();
	myGradeBook.displayGradeReport();
}
运行结果:
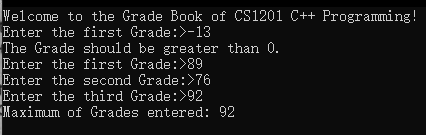
注意:函数参数列表中的,并不是逗号表达式的逗号。逗号表达式是运算顺序是从左到右,但是函数实参的求值顺序是由使用的编译器决定的,但是C++标准保证了被调用的函数在执行前,所有函数实参都已经赋值。
三、函数原型、函数签名和实参的强制类型转换
函数原型
函数原型(也称为函数声明)告诉编译器函数的名字、函数返回数据的类型、函数预期接收的参数的个数和顺序以及这些参数的类型。(不包含函数体)
在头文件中的就是GradeBook类中成员函数的原型。
函数定义也是一种函数原型,如果要在函数定义之前就使用这个函数,必须在此之前包含这个函数的原型。
函数签名
函数签名包括函数名和参数部分(比函数原型少了返回类型)。
在同一作用域中的函数必须有不同的函数签名。这使得C++中可以使用函数重载(后续章节介绍)。
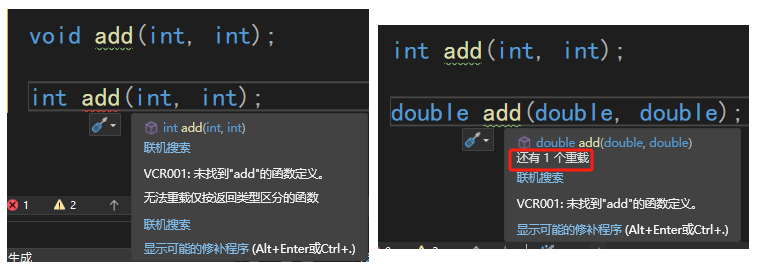
实参类型强制转换
在调用函数时,可能出现实参类型与形参不匹配的情况。程序在执行时会将实参类型强制转换为形参的类型。比如,一个形参类型的int类型的函数,在使用double类型的实参时,仍能正常工作。
在这种情况下发生的类型转换就是所谓的隐式类型转换。
C++中规定了基本数据类型之间可以进行隐式类型转换,升级规则是空间小的类型可以转换成占空间大的类型,比如,int类型转换为double类型;同样的大类型也可以转换为小类型,不过在这种情况下,会对大类型的值进行截断处理,这样才能将数据放入小类型的空间中。不过这种截断操作可能会对函数的执行结果产生影响。
四、C++标准库
C++标准库包含许多部分,每个部分都有自己的头文件。头文件中包含了形成标准库各个部分的相关函数的函数原型。头文件中还包含了各种各样的类类型和函数的定义,以及这些函数需要的变量。这些头文件负责预处理阶段的“接口”处理工作。
| C++标准库头 | 文件说明 |
|---|---|
| <iostream> | 包含C++标准输入和输出函数的函数原型 |
| <iomanip> | 包含格式化数据流的流操纵符的函数原型 |
| <cmath> | 包含数学库函数的函数原型 |
| <cstdlib> | 包含数转换为文本、文本转换为数、内存分配、随机数及其他各种工具函数的函数原型 |
| <ctime> | 包含处理时间和日期的函数原型和类型 |
| <array>,<vector>,<list>,<forward_list>,<deque>,<queue>,<stack>,<map>,<unordered_map>,<unordered_set>,<set>,<bitset> | 这些头文件包含了实现C++容器的类 |
| <cctype> | 包含测试字符特定属性(比如字符是否是数字字符或者标点符号)的函数原型和用于将小写字母转换成大写字母,将大写字母转换成小写字母的函数原型 |
| <cstring> | 包含C风格字符串处理函数的函数原型 |
| <typeinfo> | 包含运行时类型识别(在执行时确定数据类型)的类 |
| <exception>,<stdexcept> | 这两个头文件包含用于异常处理的类 |
| <memory> | 包含被C++标准库用来向C++标准库容器分配内存的类和函数 |
| <fstream> | 包含执行由磁盘文件输入和向磁盘文件输出的函数的函数原型 |
| <string> | 包含C++标准库的string类的定义 |
| <sstream> | 包含执行从内存字符串输出和向内存字符串输入的函数的函数原型 |
| <functional> | 包含C++标准库算法所用的类和函数 |
| <iterator> | 包含访问C++标准库容器中的数据的类 |
| <algorithm> | 包含操作C++标准库容器中数据的函数 |
| <cassert> | 包含为辅助程序调试而添加诊断的宏 |
| <cfloat> | 包含系统的浮点数长度限制 |
| <climits> | 包含系统的整数长度限制 |
| <cstdio> | 包含C风格标准输入和输出库函数的函数原型 |
| <locale> | 包含流处理通常所用的类和函数,用来处理不同语言自然形式的数据(例如,货币格式、排序字符串、字符表示,等等) |
| <limits> | 包含为各计算机平台定义数字数据类型限制的类 |
| <utility> | 包含被许多C++标准头文件所用的类和函数 |
五、实例研究:随机数生成
#include <iostream>
#include <cstdlib>
#include <iomanip>

using namespace std;

int main()
{
	int i{0};

	// 生成20个随机数
	for (i = 0; i < 20; i++)
	{
		// 设置输出格式,每次输出占10个字符宽,左对齐
		cout << setw(10) << left << ((rand() % 6) + 1);
	}


}
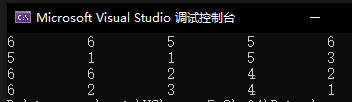
可以看到这里确实生成了20个随机数,但是当我们再次执行这个程序时会发现,生成的随机数是相同的。
所以rand函数生成的其实是伪随机数。
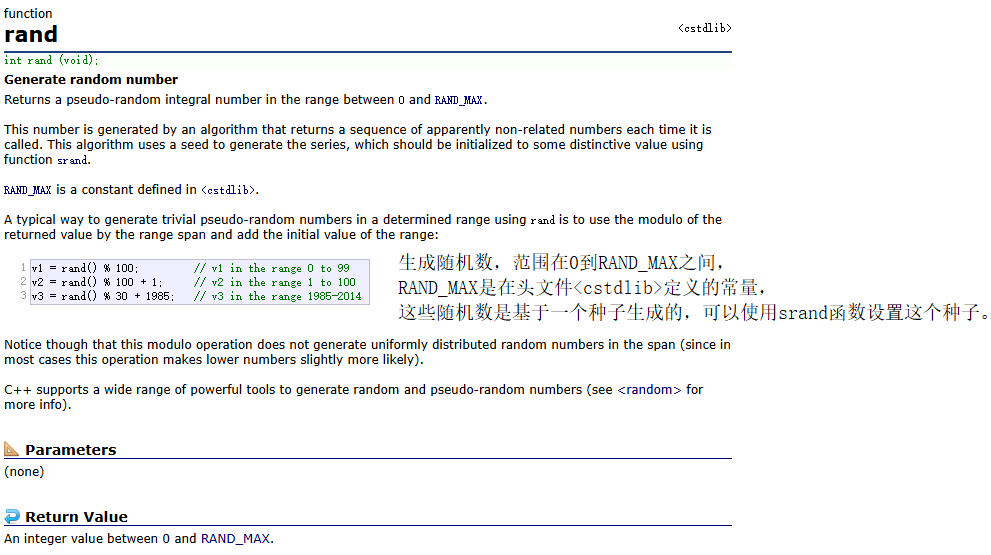
所以为了将上述的随机数生成器进行随机化,我们可以在每次程序执行时调用srand函数设置一个种子,每次调用使用的种子都应该不一样,也就是说这个种子其实也是一个“随机数”。那么这不是陷入了一个为了生成随机数而需要的一个随机数的死循环中了吗?
没错,所以我们并不是使用一个随机数来作为rand函数的种子,而是使用一个永远不可能相同的一个量——时间。
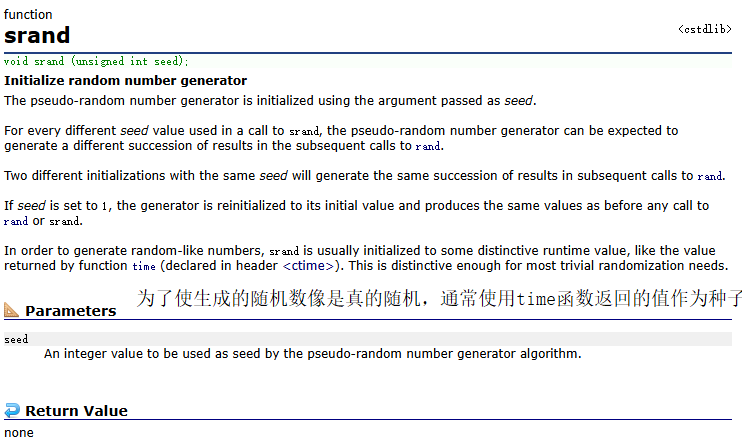
每次程序执行都由用户输入一个数作为随机数生成的种子
#include <iostream>
#include <cstdlib>
#include <iomanip>

using namespace std;

int main()
{
	int i{0};
	// 提示用户输入一个数作为此次程序生成随机数使用的种子
	unsigned int seed{0};
	cout << "Enter seed:>";
	cin >> seed;
	srand(seed);

	// 生成10个随机数
	for (i = 0; i < 10; i++)
	{
		// 设置输出格式,每次输出占10个字符宽,左对齐
		cout << setw(10) << left << ((rand() % 6) + 1);
	}

	cout << "\n";
}
使用头文件中的时间函数,获取当前时间,将该时间作为种子
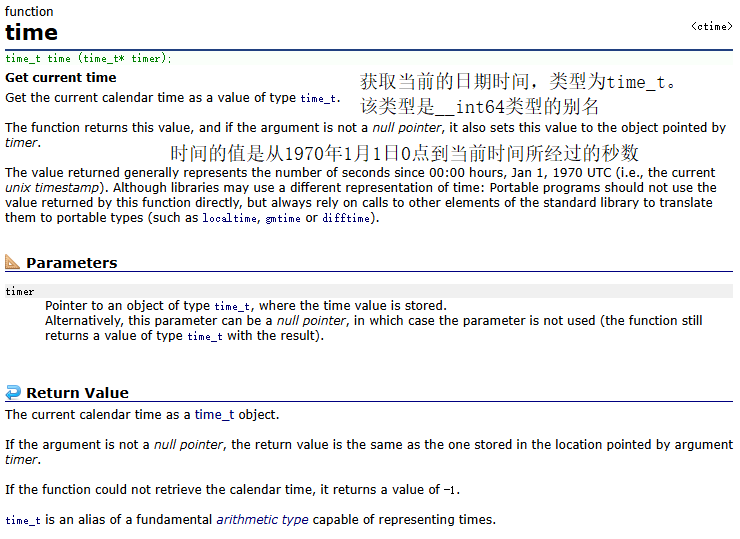
#include <iostream>
#include <cstdlib>
#include <iomanip>
#include <ctime>

using namespace std;

int main()
{
	srand(static_cast<unsigned int>(time(NULL)));

	for (int i = 0; i < 10; i++)
	{
		cout << setw(10) << left << (1 + rand() % 6);
	}

	cout << "\n";
}
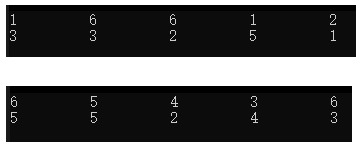
注意:使用生成随机数的种子在每次执行程序中只需要设置一次(一般在main函数中设置)。
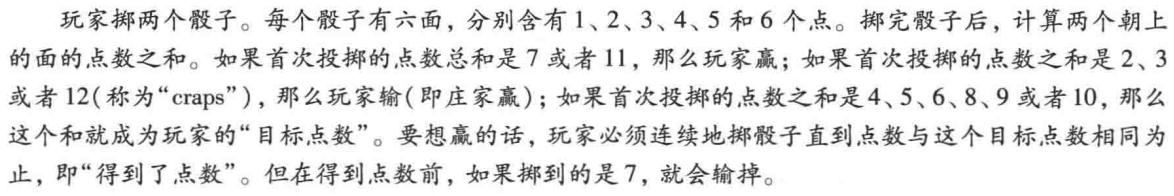
下面使用time函数作为种子,写一个使用随机数的程序——“掷双骰”的骰子游戏
规则如下:
#include <iostream>
#include <iomanip>
#include <cstdlib>
#include <ctime>

using namespace std;

// 给出掷两个骰子的函数原型
unsigned int rollDice();

int main()
{
	// 使用枚举类型来保存游戏的状态
	// 游戏有3种状态:
	// 1. 赢 - WON
	// 2. 输 - LOST
	// 3. 游戏继续 - CONTINUE
	enum Status { WON, LOST, CONTINUE};

	// 定义一个枚举类型的变量用来保存当前游戏的状态
	Status status{CONTINUE}; // 初始化为游戏继续状态

	// 设置随机数生成的种子 - 以当前时间作为种子
	srand(static_cast<unsigned int>(time(NULL)));

	// 定义一个变量保存掷骰子的结果
	int sumOfDice{0}; // 初始化为0
	// 定义一个变量保存玩家的目标点数
	int myPoint{0};

	// 第一次掷骰子
	sumOfDice = rollDice();

	// 进行游戏状态判定
	switch (sumOfDice)
	{
	// 玩家胜利
	case 7:
	case 11:
		status = WON; // 更改游戏状态
		break;
	// 玩家失败
	case 2:
	case 3:
	case 12:
		status = LOST; // 更改游戏状态
		break;
	// 游戏继续
	default:
		status = CONTINUE;
		myPoint = sumOfDice; // 设置玩家的目标点数
		cout << "Point is " << myPoint << "!\n"; // 打印玩家的目标点数
		break;
	}

	// 将一个非左值放在判断是否相等的左边有利于程序的健壮性
	// 判断游戏状态是否是继续
	while (CONTINUE == status)
	{
		// 掷骰子
		sumOfDice = rollDice();

		// 判断游戏状态
		if (sumOfDice == myPoint)
		{
			status = WON;
		}
		else if (7 == sumOfDice) // 点数为7,玩家输
		{
			status = LOST;
		}
	}

	if (WON == status)
	{
		cout << "Player wins" << endl;
	}
	else
	{
		cout << "Player loses" << endl;
	}
}

unsigned int rollDice()
{
	// 定义两个变量保存掷得的骰子数
	unsigned int die1{0};
	unsigned int die2{0};

	die1 = 1 + (rand() % 6); // 6面的骰子
	die2 = 1 + (rand() % 6);

	// 定义变量保存骰子数之和
	unsigned int sum = die1 + die2;

	// 打印掷骰子结果
	cout << "Player rolled: " << die1 << " + " << die2 << " = " << sum << endl;

	return sum;
}
运行结果:
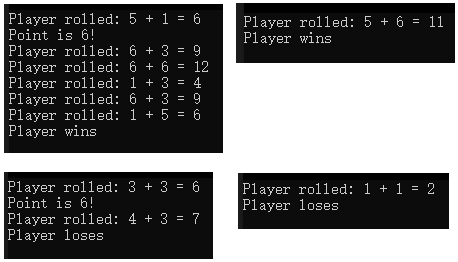
枚举常量的值是整型常量,但是给枚举类型变量赋值时不可以用等同于枚举常量的整数值替代,这样会出现编译错误。
因为不同枚举类型中枚举常量的标识符可能是相同的,在同一程序中使用这些枚举类型会导致命名冲突和逻辑错误。为了消除此类问题,C++11中引入了所谓的作用域限定的枚举类型,这种类型用关键字enum class或enum struct来声明。
例如:
enum class Statuc { WON, LOST, CONTINUE }; // or enum struct Status { WON, LOST, CONTINUE };
现在要引用一个作用域限定的枚举常量,就必须像Statuc::WON一样,用作用域限定的枚举类型名加上作用域分辨运算符::来限定该常量。
于是这样就能将不同枚举类型中相同的标识符区分开来。
默认情况下,枚举类型的枚举常量隐含的整数类型为int类型,不过C++11中允许程序员显式指定枚举类型所隐含的整数类型。方式是在枚举类型名后加一个冒号:再跟上指定的整数类型。
例如:
enum class Status : unsigned int { WON, LOST, CONTINUE };
六、C++11的随机数
根据CERT提供的信息,rand函数不具有“良好的统计特性”并且是可预测的,这使得使用rand函数的程序安全性较弱。C++11中提供了许多类来表示各种不同的随机数生成引擎和配置。
其中引擎实现一个产生伪随机数的随机数生成算法,而一个配置控制一个引擎产生的值的范围、这些值的类型和这些值的统计特性。
下面我们使用默认的引擎default_random_engine和默认的配置uniform_int_distribution来生成随机数,其中后者在指定的值的范围内均匀的生成伪随机数。
#include <iostream>
#include <iomanip>
#include <random>
#include <ctime>

using namespace std;

int main()
{
	unsigned int i = 0;

	default_random_engine engine(static_cast<unsigned int>(time(NULL)));
	uniform_int_distribution<unsigned int> randomInt(1, 6);

	for (i = 1; i <= 10; i++)
	{
		cout << setw(10) << left << randomInt(engine);

		if (i % 5 == 0)
		{
			cout << endl;
		}
	}
}
运行结果:
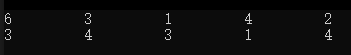
在上面中<unsigned int>表示uniform_int_distribution是一个类模板(只有类模板在声明一个变量时,才需要指定类型)。在这种情况下尖括号对<>中可以指定任何的整数类型。之后会详细介绍如何创建类模板,现在只需要模仿例子中的语法来使用这个类模板即可。
七、存储类别和存储期
到目前为止,我们所看到的程序中使用标识符作为变量名和函数名。变量的属性包括名字、类型、规模大小和值。实际上,程序中的标识符还有其他的属性,包括存储类别、作用域和链接。
C++中提供5种存储类型说明符:auto、register、extern、mutable和static,它们决定变量的存储期。
存储期
标识符的存储期决定了其在内存中存在的时间,换言之存储期就是这个标识符的生命周期。有些标识符存在的时间短,有些标识符可以重复创建和销毁,还有一些标识符在整个程序执行过程中一直存在。这一节先讨论两种存储期:静态的(static)和自动的(auto)。
作用域
标识符的作用域是指标识符在程序中可以被引用的范围。有些标识符在整个程序中都能被引用,有些只能在程序的某个部分引用。在本文的后面章节会详细介绍标识符的作用域。
链接
标识符的链接决定了标识符是只在声明它的源文件中可以被识别,还是在编译后链接在一起的多个文件可以识别。标识符的存储类型用于确定存储类型和链接。
存储期
存储类别说明符可以分为4种存储期:自动存储期、静态存储期、动态存储期、线程存储期。本节仅讨论前两种;
动态分配的变量才有动态存储期,C++允许程序在执行过程中为变量分配额外的空间,这被称为动态存储分配。线程存储期是在多线程中应用中使用。
局部变量和自动存储期
具有自动存储期的变量包括:
- 局部变量;
- 函数的形参;
- 用register声明的局部变量或函数形参;
这样的变量在程序执行到定义它们的语句块时被创建,它们只能在定义它们的语句块中使用,在程序离开该语句块之后,这些变量就会被销毁。这种具有自动存储期的变量可以简称为自动变量。自动变量只存在于其定义所在的函数体中离它最近的花括号对{}之内,当它是一个函数的形参时,它在整个函数的都存在。局部变量默认情况下都具有自动存储期。
寄存器变量
程序的机器语言版本中的数据一般都是加载到寄存器中处理的。因为在程序的执行过程中会将内存中的数据拿到寄存器中处理,将要处理的数据放入寄存器中,可以避免数据从内存加载到寄存器中的开销。当我们在声明一个变量时,认为它会经常被使用,就可以把它声明成一个寄存器变量,虽然编译器并不一定会将其设为寄存器变量。
下面是一个声明寄存器变量的例子:
register unsigned int counter = 1;
这个例子中,建议将一个unsigned int类型的变量counter放入计算机的一个寄存器中。
注意:关键字register只能和局部变量或函数形参一起使用
提示:现在的编译器是非常智能的,通常并不需要程序员显式的将一个变量声明成寄存器变量,编译器可以识别频繁使用的变量,并自行决定将它们放到寄存器中。
静态存储期
关键字extern和static为函数和具有静态存储期的变量的声明标识符。具有静态存储期的变量在程序开始执行起直到程序执行结束都一直存在于内存中。在遇到这种变量时就对它进行一次性初始化。对于函数而言,程序执行开始时函数名就已经存在。然而, 即使函数名和变量在程序一开始执行就存在,并不意味着这些标识符在整个程序中都可以使用。存储期和作用域(标识符可以使用的地方)是独立的问题。本文的后续部分会进行说明。
具有静态存储期的标识符
有两种具有静态存储期的标识符,一种是声明在外部的标识符(全局变量),另一种是用存储类别说明符static声明的局部变量。全局变量是通过把变量放在任何类或函数定义的外部来创建的。全局变量在整个程序中保存它们的值。全局变量和全局函数可以被源文件中任何位于其声明或定义之后的任何函数引用。
静态局部变量
使用关键字static声明的局部变量仅被其声明所在的函数所知。但是与自动变量不同的是,当函数退出调用时,这个静态局部变量并不会销毁,而是会继续存在于内存中,下次再调用这个函数,该静态局部变量的值与上次结束时的值相同。举个例子:
#include <iostream>

using namespace std;

void test();

int main()
{
	cout << "First test:";
	test();

	cout << "Second test:";
	test();
}

void test()
{
	static int i = 0;

	cout << i++ << endl;
}
运行结果:
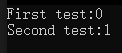
可以看到在第一次调用test之后局部变量i的值变成了1,第二次调用时,输出的结果也是1,并没有再对i进行初始化。
八、作用域规则
程序中可以使用标识符的范围就是该标识符的作用域。例如在一个语句块中声明了一个局部变量,这个局部变量只能在这个语句块中使用,这个语句块就是该局部变量的作用域。下面我们会讨论4个作用域:语句块作用域、函数作用域、全局命名空间作用域和函数原型作用域。在更之后的章节中还会介绍另两种作用域:类作用域、命名空间作用域。
语句块作用域
在一个语句块中声明的标识符具有语句块作用域。该标识符的作用域开始于标识符的声明处,结束于标识符声明所在语句块的结束右花括号处。局部变量具有语句块作用域,函数形参同样具有语句块作用域。任何语句块都能包含变量声明。当语句块是嵌套的,且内层语句块中一个标识符与外层语句块中的一个标识符有相同的名字时,在内层语句块中使用该名字引用的标识符是内层的标识符,外层语句块的标识符对它而言是隐藏的。
举个例子:
#include <iostream>

using namespace std;

int main()
{
	int a = 3;

	{
		int a = 6;
		cout << "a = " << a << endl;
	}
}
运行结果:

而声明为static的局部变量同样具有语句块作用域,虽然它具有静态存储期,从程序开始执行开始就一直存在,但是这影响它的作用域。(存储期不会影响标识符的作用域)。
提示:因为外层和内层语句块中存在同名的标识符时,在内层语句块中引用该标识符是引用的内层的标识符,当程序员想要引用外层的标识符时,就会产生逻辑错误,所以不要使用同名的标识符。
函数作用域
标签,也就是像start:之类的后跟一个冒号的标识符,或者是switch语句中的case标签,是唯一的具有函数作用域的标识符,标签可以用在它们出现的函数内的任何地方,但是不能在函数体之外引用。
全局命名空间作用域
声明在任何函数或者类之外的标识符都具有全局命名空间作用域。这种标识符对于从其声明处开始直到文件结尾处为止出现的所有函数都是已知的,即“可访问的”。位于函数之外的全局变量、函数定义和函数原型都具有全局命名空间作用域。
函数原型作用域
具有函数原型作用域的唯一标识符是那些用在函数原型形参列表中的标识符。通常函数原型是不需要形参名的,只需要它们的类型。函数原型的形参列表中出现的名字会被编译器忽略。所以用在函数原型中的标识符可以在程序的任何地方无歧义的利用。
九、函数调用堆栈和活动记录
函数调用堆栈
调用每个函数时,可能会依次调用其他函数,而且所调用的函数也可能调用其他函数,这一切都发生在任何函数返回之前。每个函数都必须将控制权返回给调用它的函数。因此,必须用某种方法记录每个函数把控制权返回给调用它的函数时所需要的返回地址。函数调用堆栈就是处理这些信息的理想数据结构。这种数据结构具有先进后出的特性非常符合函数调用的逻辑。每当一个函数调用另一个函数时,就会有一个数据项被压入堆栈中。这个数据项被称为一个堆栈结构或者一条活动记录,包含了被调用函数返回到调用函数所需的返回地址,还包含了一些附加信息。当一个函数调用结束返回到调用它的函数时,该函数的堆栈结构就会弹出,并将控制权转到该结构中的返回地址处。
自动变量和堆栈结构
大多数函数都会有自动变量——形参和声明在函数内部的局部变量。这些自动变量在函数执行时存在,在函数执行结束后被销毁。在调用时存在,返回时销毁,这和堆栈结构的特性相似,所以堆栈结构是一个保存这类信息的理想位置。
堆栈溢出
堆栈也是一种计算机资源,资源总是会存在上限,也就是说堆栈空间是会用完的。如果发生太多的函数调用,堆栈资源被使用完了,不能将相应的函数活动记录保存到堆栈中,这时就会发生堆栈溢出错误。
下面我们对一个例子进行分析:
#include <iostream>

using namespace std;

int square(int);

int main()
{
	int a = 10;

	cout << "a = " << a << endl;

	a = square(a);

	cout << "a = " << a << endl;
}

int square(int x)
{
	return x * x;
}
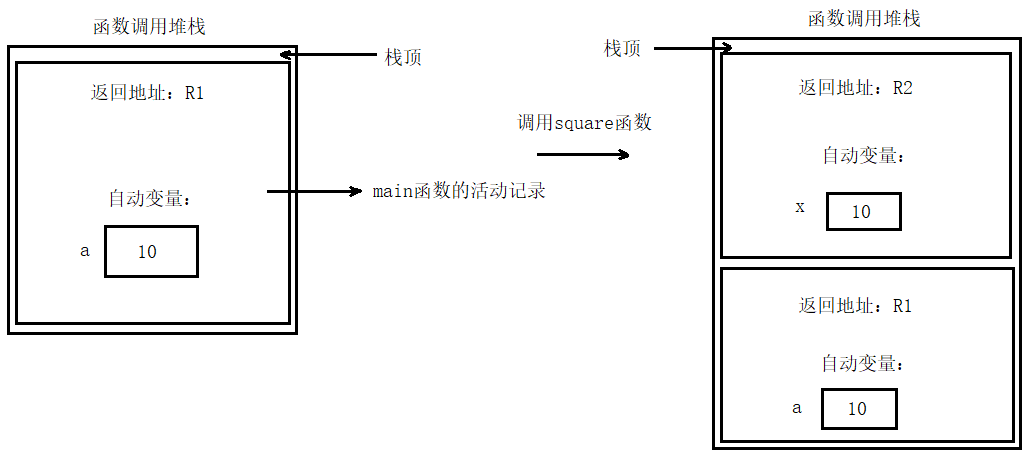
十、内联函数
从上面的函数调用堆栈中可以看到通过函数来实现它实现的功能是会带来额外的开销的——函数的调用及返回。当一些函数所实现的功能非常简单时,这些开销与实现功能消耗的开销就相差无几甚至更多,这里就可以使用内联函数。在函数定义中把限定符inline放在函数返回类型前面,可以建议编译器在合适的时候在函数被调用的地方生成函数体代码的副本——将函数代码复制过来,以避免函数的调用。这种行为会导致程序代码变得比较庞大。
提示:对内联函数进行修改之后,要求程序重新进行编译,才可以实装修改。注意,这与宏的替换是不同的,宏的替换是在预处理阶段进行的,而内联函数的替换是在编译阶段进行,它需要进行语法分析,确保类型安全,并且内联函数的替换并不一定会发生,编译器会自行决定是否进行替换,在函数声明时使用inline关键字只是“建议”将这个函数设成内联函数。
十一、引用和引用形参
在许多编程语言中都会有按值传递和按址传递(或称为按引用传递)这两种函数形参传递方式。其中,按值传递会先在函数调用堆栈中创建一个实参值的副本,然后将副本传递给被调用的函数。对于副本的修改并不会影响实参的值。
提示:当使用按值传递的方式传递一个很大的变量时,创建该变量的副本会产生较大的开销。
引用传参
在C++中有两种按引用传递的方式,第一种就是引用传参,另一种是使用指针实现的按引用传参。
引用形参是函数调用相应实参的别名。为了指明一个函数参数是按引用传递的需要在形参的类型后面跟上一个&;例如:int &a,这条语句可以读作,“a是对一个int类型对象的引用”。
注意与C语言进行区分,引用是C++中新引入的概念,在C语言中是使用指针来实现这种行为的,但是,由于指针存在空指针、野指针、悬空指针等问题,且使用时需要使用*,->等符号,所以在C++中引入了更简洁的引用操作。引用在底层可能也是使用指针实现的,不过在某些情况下,由编译器优化可能会更安全。
由于对实参的引用是可以对原来的值进行修改的,为了使用了引用形参的函数不会修改对应实参的值,可以使用const进行修饰,const放在类型的前面。
例如:const int& a;,这条语句表明a是一个int类型对象的引用,且无法通过别名a修改它对应的值。
注意1:
引用与指针不同的是,引用必须在它们的声明中完成初始化,且在初始化之后,引用绑定的对象无法再进行修改,要与指针进行区分。
注意2:
与指针相同,虽然函数可以返回引用,但是要注意不要返回一个函数的自动变量的引用,因为当函数返回之后,函数中定义的自动变量会被销毁,此时返回的引用就变成了一个“虚悬引用”。
十二、默认实参
当重复调用函数时对特定的形参一直采用相同的实参。在这种情况下就可以对这个形参指定默认实参,即传递给该形参一个默认值。当程序在调用函数时,对于有默认实参的形参省略了对应的实参时,编译器就会重写这个函数调用,并且插入那个实参的默认值。
默认实参必须是形参列表中最靠右边的实参。当调用具有2个及以上的默认实参的函数时,当省略的实参不是最右边的实参,那么它后面的实参也会使用默认实参代替。
默认形参必须在函数名第一次出现时指定,通常是在函数原型中,如果因为函数定义也作为了函数原型而省略了函数原型,那么应该在函数头部中指定默认实参。
默认值可以是任何表达式,包括常量、全局变量、或者函数调用。默认实参也可用于内联函数。
下面给出一个使用默认实参的例子:
#include <iostream>

using namespace std;

// 函数原型中可以省略形参名
//unsigned int boxVolume(unsigned int = 1, unsigned int = 1, unsigned int = 1);
// 为了增强可读性,在声明函数原型时,可以包含形参名
unsigned int boxVolume(unsigned int length = 1, unsigned int width = 1, unsigned int height = 1);

int main()
{
	// 第一次调用,全部使用默认实参
	cout << "The default box volume is " << boxVolume() << endl;

	// 第二次调用,高度和宽度使用默认实参
	cout << "\nThe volume of a box with length 10,\n"
		<< "width 1 and height 1 is " << boxVolume(10) << endl;

	// 第三次调用,高度使用默认实参
	cout << "\nThe volume of a box with length 10,\n"
		<< "width 5\nand height 1 is " << boxVolume(10, 5) << endl;

	// 第四次调用
	cout << "\nThe volume of a box with length 10,\n"
		<< "width 5\nand height 3 is " << boxVolume(10, 5, 3) << endl;
}

unsigned int boxVolume(unsigned int length, unsigned int width, unsigned int height)
{
	return length * width * height;
}
运行结果:
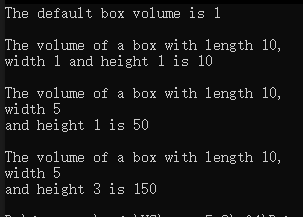
从下图中可以看出不存在中间参数使用默认实参,右边使用指定实参的情况。

十三、一元的作用域分辨运算符
前面我们提到了全局变量和局部变量是可能出现同名的情况的,在局部变量的作用域中使用这个标识符我们会访问到局部变量,全局变量对于这片作用域是被“隐藏”起来的。那么我们要如何在这个作用域中访问到这个全局变量呢?使用一元的作用域分辨运算符::。下面给出它的使用例子。
#include <iostream>

using namespace std;

// 全局变量
int a = 10;

int main()
{
	// 与全局变量同名的局部变量
	int a = 100;

	cout << "a = " << a << endl;
	cout << "::a = " << ::a << endl;
}
运行结果:

提示:
在引用全局变量时总是使用::可以使得程序更加容易理解,且更不容易出错。
十四、函数重载
前面我们提到了在同一作用域中函数的函数签名是不能相同的,所以在C++中我们可以定义多个名字相同的函数,只要它们的函数签名不相同即可。这种特性被称为函数重载。当调用一个重载函数时,编译器通过检查函数调用中的实参数目、类型和顺序来选择恰当的函数。
函数重载通常用于创建执行相似任务、但是作用于不同的数据类型的具有相同名字的多个函数。
下面是一个使用重载函数的例子:
#include <iostream>

using namespace std;

int square(int);
double square(double);

int main()
{
	cout << square(7) << endl;
	cout << square(7.5) << endl;
}

int square(int x)
{
	cout << "square of integer " << x <<  " is ";
	return x * x;
}

double square(double x)
{
	cout << "square of double " << x << " is ";
	return x * x;
}
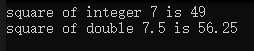
运行结果:
编译器如何区分重载的函数
重载的函数通过它们的签名来区分。签名由函数名和参数部分组成。编译器会对每个函数的标识符利用它的形参类型进行编码(有时也称为名字改编或名字装饰),以便能够实现类型安全的的链接。类型安全的链接保证调用正确的重载函数,并且保证实参类型和形参类型相符合。
下面给出一个Cpp代码经过GUN g++编译器编译的程序。
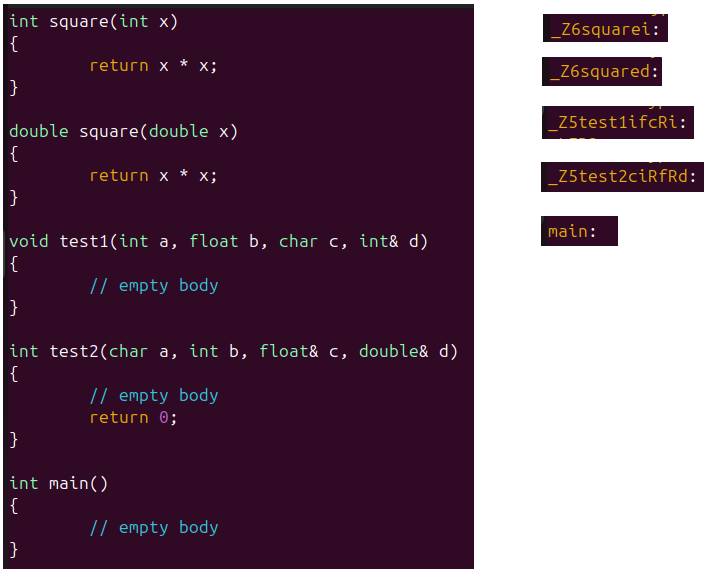
左边是Cpp程序代码,右边的经过编译后生成的汇编语言代码,它们是改编后的名字。
除main函数之外,每个改编之后的名字都是由一个下划线_开始,后跟字母Z、一个数字和函数名。字母Z后面的数字表示函数名的长度,函数square的长度是6所以前面两个重载的square函数的改编之后的Z字母后面是6。
在函数名之后跟着该函数的形参列表的编码。在test1中,i表示int类型,f表示float类型,c表示char类型,Ri表示int&类型(R表示引用)。
main函数是无法重载的。
提示:
调用一个具有默认实参的函数时省略实参,其形式可能与调用另一个重载的函数一样,这样会产生编译错误。比如,一个函数指定了没有参数,另一个重载的函数,给出了所有的默认实参。当试图在一次调用中不传入任何参数,此时就会导致编译错误,因为编译器无法区分使用的哪个版本的函数。
十五、函数模板
重载函数通常用于执行相似的操作,这些操作涉及作用于不同数据类型上的不同程序逻辑。如果对于每种数据类型程序逻辑和操作都是相同的,那么使用函数模板可以使重载执行起来更加紧凑和方便。程序员需要编写单个函数模板定义。只有在这个函数模板中提供了实参类型,C++就会自动生成独立的函数模板特化来恰当的处理每种类型的调用。如此,定义了一个函数模板其实相当于定义了一整套重载的函数。
所有的函数模板都是由template关键字开头,后面跟一对尖括号<>,这是函数模板的模板形参列表,数量可以大于1。模板形参列表中每个形参(通常称为形式类型形参)由关键字typename或class(它们是同义词)开头。
形式类型形参是基本类型或用户自定义类型的占位符。这些占位符用于指定函数形参的类型、指定函数的返回类型,以及在函数定义体内声明变量。函数模板的定义与其他函数的定义一样,只是使用形式类型形参作为实际数据类型的占位符。
下面给出一个定义函数模板的例子:
maximum.h
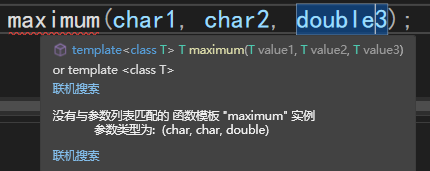
使用template关键字表明这是一个函数模板,形式类型形参列表中只有一个形式类型形参,所以整个函数中只可以使用一种类型(每个形式类型形参在一次特化中只能代表一种类型)。
函数模板中函数的返回值和三个参数的类型都用T来表示
template <typename T> // or template <class T>

T maximum(T value1, T value2, T value3)
{
	T maximumValue = value1;

	if (value2 > maximumValue)
	{
		maximumValue = value2;
	}

	if (value3 > maximumValue)
	{
		maximumValue = value3;
	}

	return maximumValue;
}
test.cpp
#include <iostream>
#include "maximum.h"

using namespace std;

int main()
{
	int int1{0}, int2{0}, int3{0};
	cout << "Enter three integer values:";
	cin >> int1 >> int2 >> int3;
	cout << "The maximum integer value is " << maximum(int1, int2, int3) << endl;

	double double1{ 0 }, double2{ 0 }, double3{ 0 };
	cout << "Enter three double values:";
	cin >> double1 >> double2 >> double3;
	cout << "The maximum double value is " << maximum(double1, double2, double3) << endl;

	char char1{ 0 }, char2{ 0 }, char3{ 0 };
	cout << "Enter three char values:";
	cin >> char1 >> char2 >> char3;
	cout << "The maximum char value is " << maximum(char1, char2, char3) << endl;
}
运行结果:
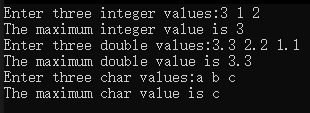
可以看到在上面的test.cpp中我们直接使用了maximum函数,并没有对不同类型进行特化,这就归功于在maximum.h中定义的函数模板。
十六、C++11——函数尾随返回值类型
C++11的一个新特性就是函数的尾随返回值类型。为了指定尾随返回值类型,需要将关键字auto放在函数名之前,并且在函数的形参列表之后加上->以及返回值类型。
这个新特性对于一些返回值类型比较复杂的情况很有帮助。例如:
int (*getFunction(char, int))(int, int);
这段代码如果大家是第一次见估计人肯定是懵懵的,这都是些什么鬼啊。
这是一个函数的函数原型。它有两个参数,类型分别是char和int,它的返回值是一个函数指针,这个函数指针指向一个有两个int类型的参数、返回值类型为int的函数。
先找到getFunction这个标识符,它左边与
*结合,右边与()结合,()的优先级比*更高,所以该标识符先与()结合形成一个函数。()中的内容是该函数的参数列表,这个函数有两个参数,第一个参数类型为char类型,第二个参数类型为int类型。
剩余部分都是该函数的返回值类型,函数签名首先与*结合,所以该该函数的返回值类型是一个指针类型。剩下的部分就是指针指向的类型;
int (int, int)是一个函数,返回值类型是int,有两个int类型的参数。
让我们使用尾随返回值类型来声明这个函数原型试试看:
auto getFunction(char, int) ->int (*)(int, int);
这样是不是就一目了然了。
该特性的更多用途还需要大家在编程中逐渐体会。
十七、递归
递归函数是直接或者间接地(通过另一个函数)调用自己的函数。注意C++标准文档中规定,main函数在一个程序中不应当被其他函数调用或递归调用自身。
调用递归函数实际上为了解决问题。这种函数只知道如何解决最简单的情况,或者基本情况。如果调用函数是为了解决基本情况,那么它就会简单的返回一个结果。如果调用函数是为了解决一个复杂的情况,那么它通常会将问题分成两个概念性的部分:一部分是函数知道如何去做的,另一部分是函数不知道如何处理的。为了使递归可以解决问题,后一部分必须和原来的问题相似,且规模更小或更简单一点。因此函数可以调用一个全新的副本去解决这个新的更小的问题——这就是递归调用,也称递归步骤。递归步骤通常包括关键字return,因为它的结果会与函数知道如何解决的一部分组合起来,从而得到可以返回给调用者的结果。
下面我们来看一个例子:
阶乘
迭代的阶乘:int factorial = 1; for(int count = n; count >= 1; count--) { factorial *= count; }递归的阶乘:
int Factorial(int n)
{
	if(1 == n || 0 == n)
	{
		return 1;
	}
	return n * Factorial(n - 1);
}
利用递归实现斐波那契数列
#include <iostream>

using namespace std;

int fibonacci(int n)
{
	if (1 == n || 0 == n)
	{
		return n;
	}

	return (fibonacci(n - 1) + fibonacci(n - 2));
}

int main()
{
	for (int i = 0; i <= 10; i++)
	{
		cout << "fibonacci(" << i << ") = " << fibonacci(i) << endl;
	}

	cout << "fibonacci(20) = " << fibonacci(20) << endl;
	cout << "fibonacci(30) = " << fibonacci(30) << endl;
	cout << "fibonacci(40) = " << fibonacci(40) << endl;
}
运行结果:
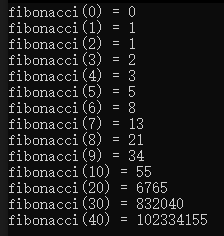
但是如果大家尝试执行了这段代码应该会发现,在执行fibonacci(40)时明显是隔了一段时间。这是因为递归实现的Fibonacci的函数,每级递归都会使函数的调用的次数加倍。所以在实现一些可以使用迭代实现的算法尽量不要使用递归实现。
十八、递归与迭代
现在对递归与迭代进行一些比较:
- 迭代和递归都是基于控制语句的:迭代使用循环结构,递归使用选择结构;
- 迭代和递归都涉及循环:迭代显式的使用循环结构,递归通过重复的函数调用实现循环;
- 迭代和递归均包括终止条件测试:迭代在循环继续条件不满足时停止,递归在达到基本情况时终止;
- 采用计数器控制的循环的迭代和递归都是逐步达到终止的:迭代修改计数器直到计算器的值使循环继续条件不满足,递归产生比原来的问题更简单的问题直到达到基本情况;
- 迭代和递归都可能无限进行:如果循环继续测试一直为真,则循环会一直进行下去。如果递归步骤不能通过递归归结到基本情况,就会导致无限递归;
递归的不足
递归存在许多不足之处。它需要进行多次函数调用,这势必会增加许多开销(调用函数)。这样不仅会消耗处理器的时间,还会消耗内存空间。每个递归调用都会创建函数变量的一份副本,这会占用相当量的内存空间。而迭代通常发生在一个函数内,因此没有重复的函数调用的开销和额外的内存分配。
那么为什么还要使用递归呢?

 320


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


