智谱GLM-4.6V开源,原生识图+工具调用,还能“手眼通天”

GLM-4.6V-Flash多模态模型部署与优化指南 多模态大模型通过结合视觉与语言处理能力,正在重塑人机交互范式。其核心技术在于注意力机制优化和量化压缩,前者通过稀疏计算降低复杂度,后者则显著减少显存占用。以GLM-4.6V-Flash为例,该9B参数模型采用Flash注意力技术实现O(nlogn)计算效率,配合INT4量化可将体积压缩76%。这类技术在智能客服、内容生成等场景展现价值,尤其适合需要实时响应的边缘计算场景。部署时需注意显存管理,1080Ti显卡上通过vLLM引擎可实现12 tokens/s的生成速度,而生产环境推荐采用Triton Infer 阅读详情

就在昨晚,智谱开源了GLM-4.6V 模型。

128k 超长上下文(约等于150 页文档)

最大的亮点:原生支持视觉工具调用(Function Call)

不仅能看,还能动手干活

两个版本,丰俭由人:

• GLM-4.6V(106B-A12B):这是满血版,性能强悍,对标云端业务,支持高性能集群

• GLM-4.6V-Flash(9B):这是轻量版,跑得快,适合本地部署

价格方面:
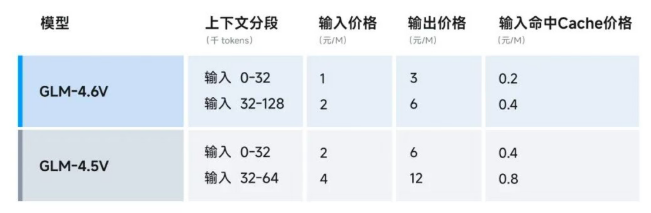
image.png

image.png

相比上一代,直接降价 50%

输入:1 元 / 百万 token

输出:3 元 / 百万 token

Flash 版本:免费

以及,这次更新,唯一的重点

GLM-4.6V,打通了“视觉”和“工具”

以前的多模态模型是:我看图 -> 转成文字 -> 调工具 -> 给你结果。中间转来转去,信息全丢了。

GLM-4.6V 是原生的:图像即参数,结果即上下文

直接把图扔给工具,工具返回的图表、网页,模型也能直接看懂

从“看懂”到“执行”,一条龙搞定

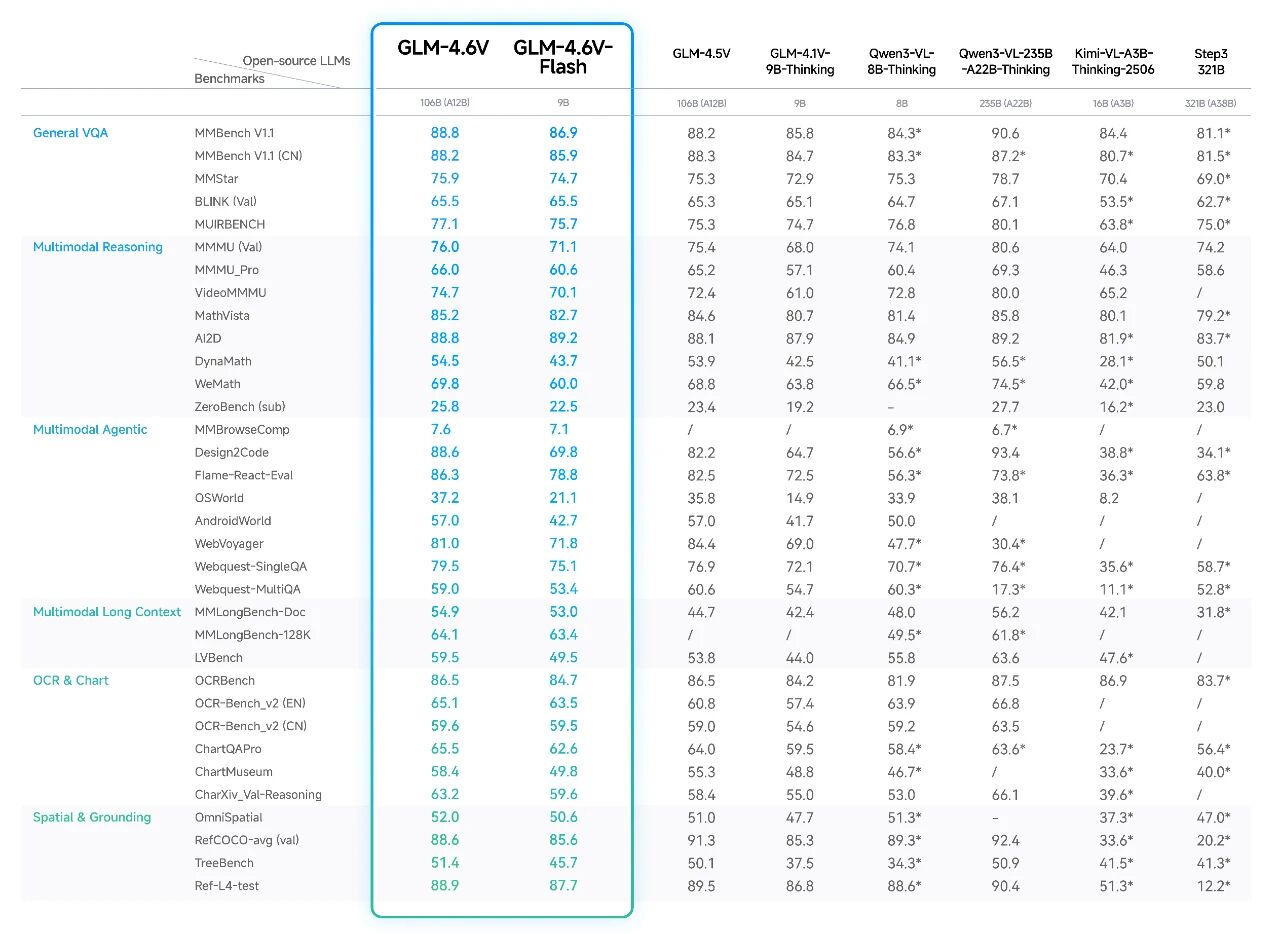
评测数据,简单总结就是“以小博大”
7ad5306a4ee92d3735d5cb0b4ecc4fdf.jpg

7ad5306a4ee92d3735d5cb0b4ecc4fdf.jpg

在 MMBench、MathVista 等 30+ 评测基准上验证:

• 9B Flash 版本:整体干翻 Qwen3-VL-8B

• 106B 版本:跟参数量是它 2 倍的 Qwen3-VL-235B 打得有来有回

官方场景案例:

1. 图文混排神器:内容创作的福音

扔给它一个主题,或者一篇干巴巴的论文、研报

它不是简单的配图,而是真正理解了内容

模型能自己调搜索工具找图,还自带“审美”做视觉审核

最后采用“草稿 -> 选图 -> 润色”的流程,吐出一篇结构清晰、图文并茂的公众号文章或 PPT 素材

2. 识图购物 Agent:比你更懂全网低价

你在街上拍个好看的衣服,模型直接识别你的“剁手”意图

自动规划任务,调起 image_search 工具

它能处理京东、拼多多等不同平台的脏数据,自动清洗、对齐

最后甩给你一张带购买链接、价格对比和缩略图的 Excel 表格

3. 前端复刻:程序员狂喜

直接上传一张设计稿或者网页截图,模型直接生成 HTML/CSS/JS 代码

它支持“视觉交互调试”

你可以在生成的图上圈一下,说:“把这个按钮左移一点,换成深蓝色”

模型利用视觉反馈循环,自动定位代码并修正,像素级还原

4. 财报/长视频分析:过目不忘

128k 上下文不是摆设,大概能塞进 150 页文档或 1 小时视频

一次扔进去 4 家上市公司的财报,它能跨文档提取核心指标,生成对比表

或者扔进一场足球比赛录像,它能精准定位进球时刻,生成集锦时间轴,关键信息一个不漏

这次智谱很敞亮,权重、代码全放出来了。

支持 vLLM、SGLang、Transformers 等主流框架,国产卡(NPU)也支持

GitHub👉https://github.com/zai-org/GLM-V

Hugging Face👉https://huggingface.co/collections/zai-org/glm-46v

魔搭 ModelScope👉https://modelscope.cn/collections/GLM-46V

在线体验👉z.ai (选 GLM-4.6V)或者智谱清言 APP

如果你也对AI感兴趣,想拥抱AI,不妨可以来看看我们的AI超级个体知识库👇 免费的!
二维码

AI超级个体知识库

https://hyperspace.feishu.cn/wiki/SpRGwQNKMiYk8UkzInBcQkzZnLh

VL53L0X测距不准?手把手教你做RefSPAD校准与环境补偿(附Arduino/STM32代码) 本文详细解析了VL53L0X激光测距传感器精度不足的原因,并提供了RefSPAD校准与环境补偿的完整解决方案。通过Arduino和STM32代码示例,手把手教你实现毫米级测距稳定性,适用于机器人避障、工业检测等场景。 阅读详情

相关推荐

在 STM32CubeIDE 中针对 STM32F407 移植 ThreadX

在 STM32CubeIDE 中针对 STM32F407 移植 ThreadX,不依赖盗版破解的Keil MDK、IAR等软件。

wangyuewu08的博客 3377

GLM-4.6V:从视觉理解到行动执行

智谱AI发布开源多模态大模型GLM-4.6V系列,其中GLM-4.6V-Flash(9B)轻量版免费商用并开放全量权重,实现多模态技术普惠化。

围炉漫谈间,一起深聊人工智能、大数据这类前沿科技领域的新动态,在这里为你拆解前沿技术百货的多样精彩。 2294

FOC实战笔记:RC吸收电路的设计考量与参数调优

本文深入探讨了FOC驱动器中RC吸收电路的设计与调优。针对MOS管开关过程中的电压尖峰问题,详细阐述了RC电路的钳位与能量吸收原理,并提供了从参数计算、实验调试到布局布线的完整实战指南,旨在帮助工程师有效提升系统可靠性与稳定性。

weixin_29219539的博客 277

小白友好型模型来了!GLM-4.6V-Flash-WEB免费开源可商用

本文介绍了如何在星图GPU平台上自动化部署GLM-4.6V-Flash-WEB镜像,快速启用开箱即用的视觉理解能力。用户上传图片并自然语言提问,即可获得精准图文解析,典型应用于商品图材质识别、教育涂鸦分析、Excel截图数据解读等场景,大幅降低多模态AI使用门槛。

weixin_35516273的博客 249

深入浅出横向联邦学习、纵向联邦学习、联邦迁移学习

深入浅出解析横向联邦学习(Horizontal Federated Learning)、纵向联邦学习(Vertical Federated Learning)和联邦迁移学习(Federated Transfer Learning)有多个机构(比如几家不同的银行,或者几家医院)都拥有一些数据,他们希望联合起来训练一个更强大的机器学习模型,但出于隐私保护或法规要求,他们不能直接把数据共享出来。联邦学习就是为了解决这个问题而提出的。它的核心思想是“数据不动模型动”,即数据保留在本地,参与方共同训练模型。

frostmelody 全网同名,大家多多关注呀~ 持续分享优质内容! 2472

DVWA靶场实战:从搭建到渗透测试的完整指南

本文详细介绍了DVWA靶场的搭建与渗透测试全流程,涵盖LAMP环境搭建、Docker部署及集成环境安装三种方式。通过SQL注入、文件上传漏洞等实战案例,帮助读者掌握Web安全测试技巧,并提供防御方案与进阶调优建议,是网络安全学习的实用指南。

weixin_28312391的博客 491

智谱GLM-4.6V深度解析

12月8日,智谱AI开源了GLM-4.6V系列多模态大模型。和。GLM-4.6V包含两个版本。GLM-4.6V主模型采用的MoE架构,面向云端和高性能集群部署。GLM-4.6V-Flash则是的轻量版本,针对本地部署和低延迟场景优化,免费提供使用。从技术角度看,GLM-4.6V的显著特性在于。模型可以直接处理图像、截图作为工具输入参数,无需先转换为文本描述。视觉输出(如图表、网页渲染结果)也能被模型直接解析并整合进推理链路。

OpenCSG的博客 1545

NSIS教程(8): 基于第三方界面库的安装包界面

前面的几篇文章介绍了NSIS的传统界面的安装包和现代界面的安装包的制作方法,也提到了NSIS支持自定义页面(即使用page custom)的特性,自定义页面需要用户自己创建对话框、控件、添加控件响应等等,虽然NSIS提供了nsDialogs.nsh来支持这些功能,但使用起来还是不太方便(需要专门了解这个插件诸多用法),而且不够灵活,所以本文介绍一种终极的自定义界面的安装包解决方案,即完全使用第三方

while(1) { smile(); } 9万+

告别复杂配置!GLM-4.6V-Flash-WEB开箱即用体验分享

本文介绍了基于星图GPU平台自动化部署GLM-4.6V-Flash-WEB镜像的完整实践,该镜像集成轻量化视觉语言模型,支持网页与API双模式推理。通过Docker一键启动,可快速构建图文分析、AI应用开发等多模态服务,显著降低部署门槛,提升中文场景下的开发效率。

weixin_42518874的博客 698

UG\NX二次开发 获取三平面交点

//如果返回值不为0 则此三个面没交点 int three_faces_point(tag_t tagFace1, tag_t tagFace2, tag_t tagFace3, double *dou_x, double *dou_y, double *dou_z)

王牌飞行员_里海的博客 677

代谢组数据分析(三):代谢组降维分析

本文详细介绍了代谢组学中常用的降维分析方法,包括PCA、PLS-DA和OPLS-DA。PCA通过线性变换降低数据维度,便于数据可视化和异常值检测;PLS-DA是一种有监督的模式识别方法,适用于分类和预测;OPLS-DA通过正交分解避免过拟合,更准确地筛选差异代谢物。降维分析在揭示样本间差异和发现生物标志物方面具有重要意义

专注生信领域 3792

GLM-4.6V-Flash-WEB 部署教程:如何在本地 GPU 运行智谱新模型

本文详细介绍了如何将GLM-4.6V-Flash多模态大模型部署到本地GPU并提供Web访问的完整流程。主要内容包括:硬件配置要求(建议24GB显存GPU)、环境搭建、模型下载、使用vLLM启动本地推理服务(支持OpenAI兼容API)、WebUI部署(推荐OpenWebUI或Gradio方案),以及性能优化建议和常见问题排查。该方案可实现模型服务的本地化部署,既支持API调用也提供可视化界面,适合团队协作使用。文章特别强调了从基础部署到生产环境的渐进式优化路径,包括量化、多卡并行等进阶方案。

qq_32278033的博客 639

一文看懂EMMC原理及工作过程

CMD:用于设备初始化和命令传输的双向通道, CMD信号有2种工作模式:1#:漏极开路--->用于初始化模式2#:推拉--->用于快速命令传输其中命令从eMMC主机控制器发送到eMMC设备,响应从设备发送到主机。DAT [7:0]:双向数据信号,模式包括:1(DAT0);默认情况下,通电或重置后,只有DAT0用于数据传输。DAT信号在推挽模式下工作,eMMC设备包括数据线DAT1-DAT7的内部上拉。进入4位模式后,设备立即断开线路DAT1、DAT2和DAT3的内部上拉;

Airer_00的博客 2043

亲测可用!GLM-4.6V-Flash-WEB单卡部署全流程复现

本文介绍了如何在星图GPU平台上自动化部署GLM-4.6V-Flash-WEB镜像,实现多模态视觉语言理解功能。用户可通过简单操作快速启动网页与API双通道服务,典型应用于图片内容识别与中文问答,如上传办公桌照片并准确解析物品、颜色及布局信息。

weixin_42600407的博客 336

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

手把手教你用GLM-4.6V-Flash-WEB:开箱即用的视觉大模型

本文介绍了如何在星图GPU平台上自动化部署GLM-4.6V-Flash-WEB镜像,快速搭建一个开箱即用的视觉大模型服务。该平台简化了部署流程,用户可通过一键脚本快速启动服务,并利用该模型实现图文对话、图片内容理解与描述等核心应用场景,显著降低多模态AI的应用门槛。

weixin_42584507的博客 58

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

GLM-4.6V-Flash-WEB避坑指南:这些配置问题千万别踩

本文介绍了基于星图GPU平台自动化部署GLM-4.6V-Flash-WEB镜像的实践方法,重点解析部署中的常见配置陷阱与优化策略。该镜像适用于多模态AI应用开发,如图文理解、视觉问答等场景,结合平台能力可实现高效、稳定的模型推理服务搭建。

weixin_42604188的博客 976

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

GLM-4.6V-Flash-WEB值不值得部署?综合评测报告

本文介绍了基于星图GPU平台自动化部署GLM-4.6V-Flash-WEB镜像的实践方案。该平台支持一键拉取镜像并快速启动容器,实现模型的高效部署。GLM-4.6V-Flash-WEB具备双通道推理能力,适用于中文文档理解、表格识别与UI截图分析等典型场景,尤其适合企业级图文信息处理与AI应用开发,显著提升多模态任务的落地效率。

weixin_33173126的博客 388

低成本高并发方案:用GLM-4.6V-Flash-WEB构建视觉AI服务

GLM-4.6V-Flash-WEB以极低显存占用和毫秒级响应,让消费级GPU也能承载视觉AI服务。通过8位量化、KV缓存优化与一键部署设计,大幅降低落地门槛,适用于内容审核、教育解析、医疗辅助等高频场景,真正实现中小型团队的高效集成与规模化应用。

weixin_31869917的博客 783

2026AI视觉落地趋势:GLM-4.6V-Flash-WEB弹性GPU部署

本文介绍了基于星图GPU平台自动化部署GLM-4.6V-Flash-WEB镜像的实践方案,结合弹性GPU资源实现高效、低成本的AI视觉应用落地。该模型支持网页端与API双模式推理,适用于图像理解、内容分析等场景,特别适合中小企业和开发者快速构建多模态AI应用,推动视觉大模型走向轻量化与普及化。

weixin_42513209的博客 657

GLM-4.6V-Flash-WEB免费部署:无需配置环境的一键启动方案

本文介绍了如何在星图GPU平台上自动化部署GLM-4.6V-Flash-WEB镜像,实现无需复杂环境配置的一键启动。该方案让用户能快速体验这一多模态大模型,其核心应用场景包括通过网页界面上传图片进行视觉问答、文档理解等智能交互,极大降低了AI视觉应用的入门门槛。

weixin_35734408的博客 688

GLM-4.7-Flash入门指南:Web界面操作、提示词技巧与温度参数调优建议

本文介绍了如何在星图GPU平台自动化部署GLM-4.7-Flash镜像,实现高效的中文文本生成与多轮对话。该镜像特别适用于内容创作场景,如自动生成营销文案、技术文档和创意写作,通过Web界面可快速调整参数优化生成效果,提升工作效率。

weixin_28487725的博客 487

GLM-4.6V开源:从看懂到完成

智谱AI开源GLM-4.6V多模态大模型,实现从"理解图片"到"完成任务"的突破。该系列包含高性能云端版(106B-A12B)和轻量本地版(9B),具备128k超长上下文处理能力和SOTA视觉精度。其核心创新在于原生多模态工具调用和视觉-行动闭环,支持直接处理图像并生成可执行行动,适用于图文创作、电商导购、前端开发等场景。模型已全面开源,提供本地部署、云端API等多种接入方式,价格优势明显。这一突破将推动国产AI生态发展,降低多模态技术应用门槛。

点亮创新之光,照亮科研梦想 1674

一键部署GLM-4.6V-Flash-WEB,单卡实现AI视觉推理超简单

本文介绍了如何在星图GPU平台上自动化部署GLM-4.6V-Flash-WEB镜像,实现单卡AI视觉推理。该镜像开箱即用,支持网页交互与API调用,典型应用于商品图智能问答、图文理解与多轮对话等场景,显著降低视觉大模型落地门槛。

weixin_26805451的博客 328

[实战评测]GLM Coding Plan + GLM-4.6V

GLM-4.6V系列大模型提供云端高性能和本地轻量级两种解决方案。106B参数的GLM-4.6V具备SOTA级多模态理解、128K超长上下文支持及原生函数调用能力,适合企业级复杂任务;9B参数的GLM-4.6V-Flash则针对个人开发者提供免费本地部署方案。通过实战演示了从UI设计到代码生成的完整流程,包括ui_to_artifact等工具的应用,展现了AI如何重构开发范式。文章强调开发者应转向更高价值的创造性工作,并赞赏国内厂商的技术开放与创新。

Just Linux! 3786

GLM-4.6V-Flash-WEB最新版部署:Web界面使用教程

本文介绍了基于星图GPU平台自动化部署GLM-4.6V-Flash-WEB镜像的完整流程。该平台支持一键式部署与高效运行,适用于视觉大模型的快速应用。通过Web界面或API调用,用户可轻松实现图像内容描述、OCR识别与语义理解等多模态AI任务,广泛应用于智能客服、教育辅助与内容分析等场景。

weixin_42389113的博客 291

2026年AI视觉模型部署趋势:GLM-4.6V-Flash-WEB实战分析

本文介绍了基于星图GPU平台自动化部署GLM-4.6V-Flash-WEB镜像的完整流程。该平台支持一键拉取镜像并启动多模态推理服务,适用于图像理解、智能客服等AI应用开发场景,显著降低部署门槛,提升开发效率。

weixin_42443533的博客 531
上一篇: 拿数据说话,《State of AI》100万亿Token深度分析出来的7个真相
下一篇: 01Agent惊艳亮相2025 XAIR大会,重塑内容生产,现场引爆签约热潮
MobiusStack
博客等级 码龄1年 1粉丝 50原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值