大模型新手必备AI基础有哪些?AI基础知识、Hugging Face 工具库等

中文大模型本地部署指南:魔塔社区 vs Hugging Face 保姆级对比 本文详细对比了魔塔社区与Hugging Face在中文大模型本地部署方面的表现,重点分析了平台定位、部署流程和中文优化特性。魔塔社区凭借对中文语境的深度优化和轻量级工具链,在中文文本处理、向量检索和LoRA微调等方面展现出明显优势,特别适合中文场景的快速部署和开发。 阅读详情

对于大模型领域的新手而言,扎实的 AI 基础是后续深入研究(如模型训练、微调、应用开发)的核心前提。这些基础可分为数学理论、机器学习核心、深度学习基础、编程与工具链四大模块,每个模块都有明确的核心知识点和学习重点,具体如下:
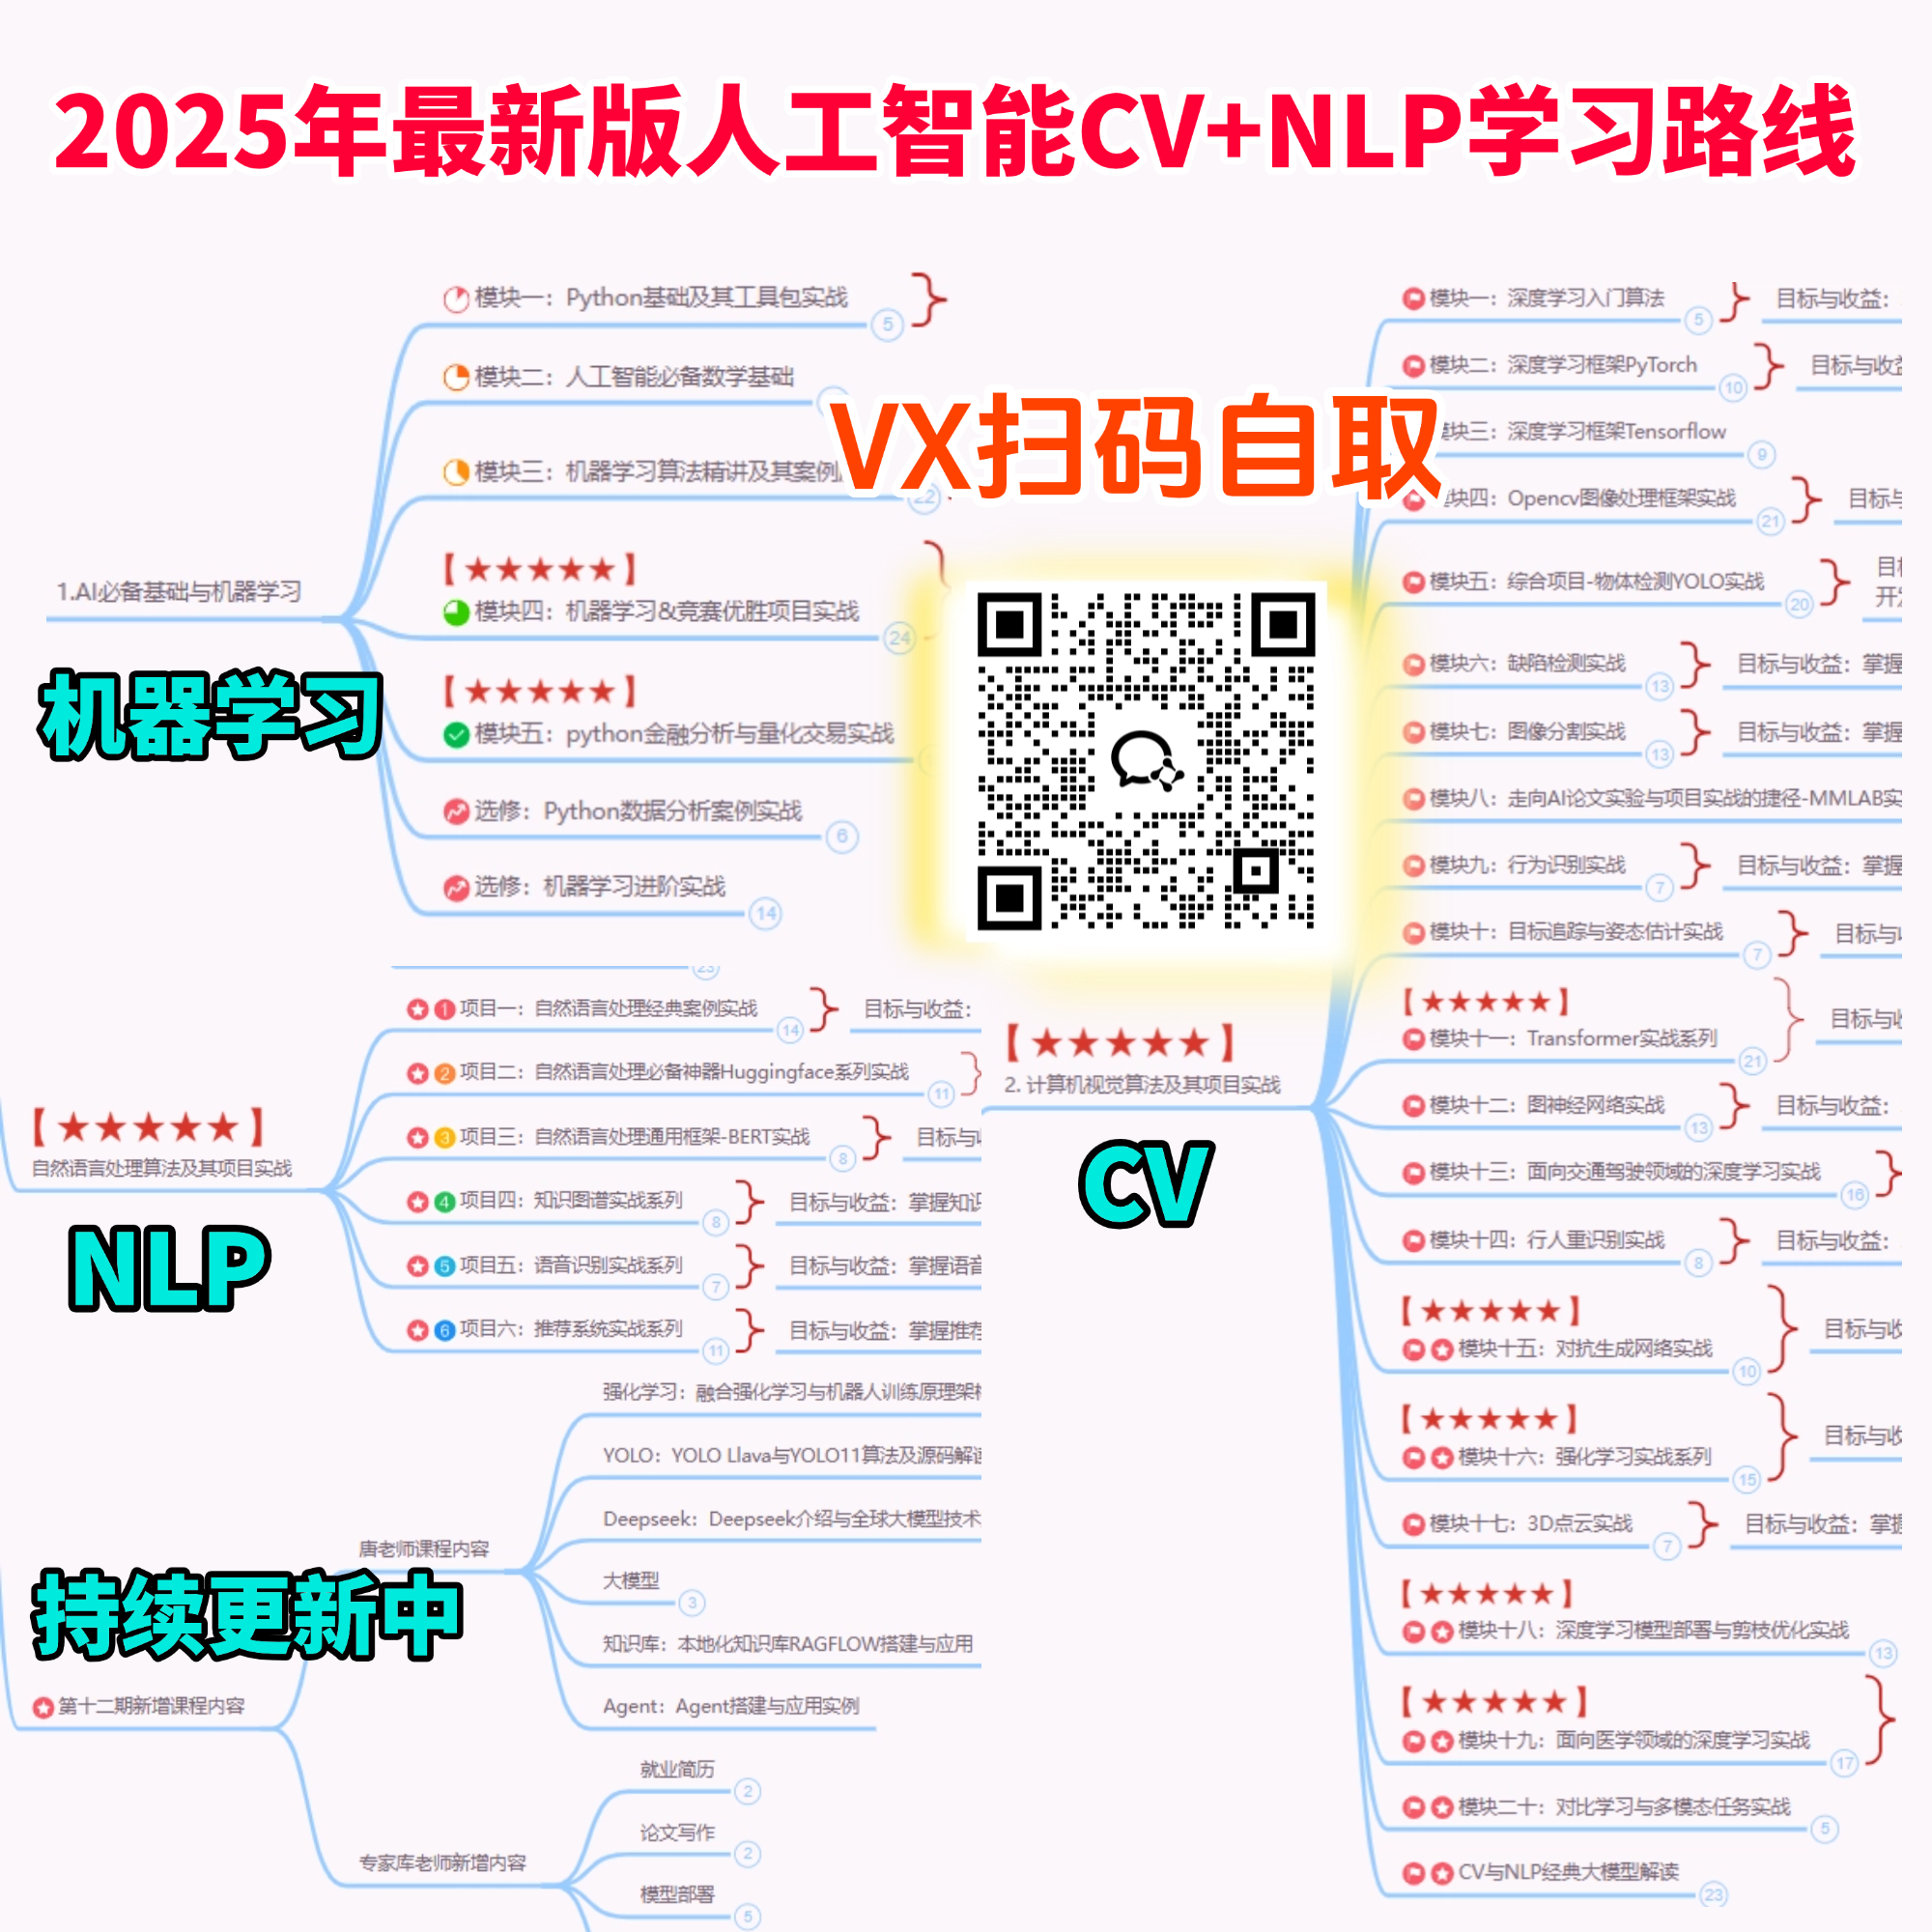
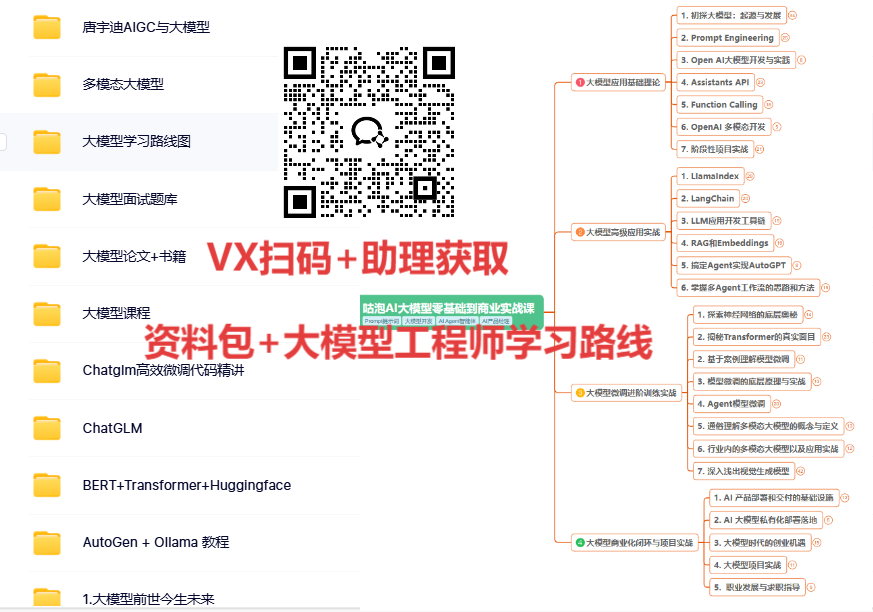
需要大模型全栈学习路线和人工智能入门到实战路线的扫码加助理不要米获取

想学AI,计算机视觉正确学习路线是什么?

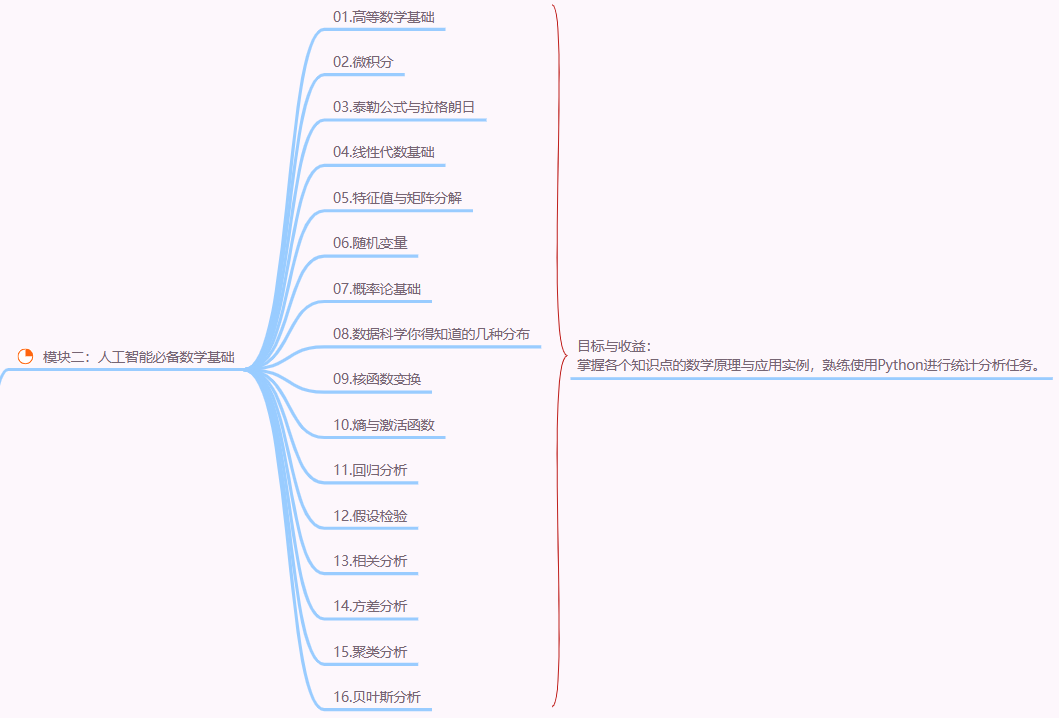
一、数学理论基础:大模型的 “底层逻辑语言”

数学是 AI 算法设计、模型优化、结果解释的底层支撑,无需追求纯数学的深度,但需掌握 “能用数学解决 AI 问题” 的能力,核心知识点如下:

  1. 线性代数

    • 核心内容:向量(如文本 / 图像的特征向量)、矩阵(如模型权重矩阵)、张量(大模型中多维度数据的存储形式,如[batch, seq_len, hidden_dim])、矩阵运算(乘法、转置、逆)、特征值与特征向量(PCA 降维、模型特征提取的理论基础)、奇异值分解(SVD,用于数据压缩和特征简化)。
    • 为什么重要:大模型的输入处理(如词嵌入向量)、层间计算(如注意力机制中的矩阵乘法)、参数更新(如权重矩阵优化)全依赖线性代数,不懂矩阵运算就无法理解 “模型如何处理数据”。
  2. 概率论与数理统计

    • 核心内容:概率分布(正态分布、伯努利分布,大模型中初始化参数、噪声处理的依据)、期望与方差(评估模型预测的稳定性)、极大似然估计(模型参数学习的核心思想,如逻辑回归的参数求解)、贝叶斯定理(小样本学习、不确定性量化的基础,如贝叶斯大模型)、熵与交叉熵(损失函数设计的核心,如大模型常用的交叉熵损失)。
    • 为什么重要:大模型的本质是 “基于概率的预测模型”(如预测下一个 token 的概率),统计思维能帮助理解 “模型为何会出错”“如何评估模型的置信度”。
  3. 最优化理论

    • 核心内容:梯度下降(大模型训练的核心优化算法,包括 SGD、Adam、AdamW 等变种)、梯度消失 / 爆炸(大模型层数加深后面临的核心问题,理解 BatchNorm、残差连接的设计动机)、凸优化基础(局部最优与全局最优,大模型非凸优化的简化分析)、正则化(L1/L2、Dropout,防止大模型过拟合的关键)。
    • 为什么重要:大模型训练的本质是 “最小化损失函数”,最优化理论直接决定 “如何高效、稳定地更新模型参数”,不懂梯度下降就无法理解 “微调大模型时学习率为何不能乱设”。
二、机器学习核心:大模型的 “前置方法论”

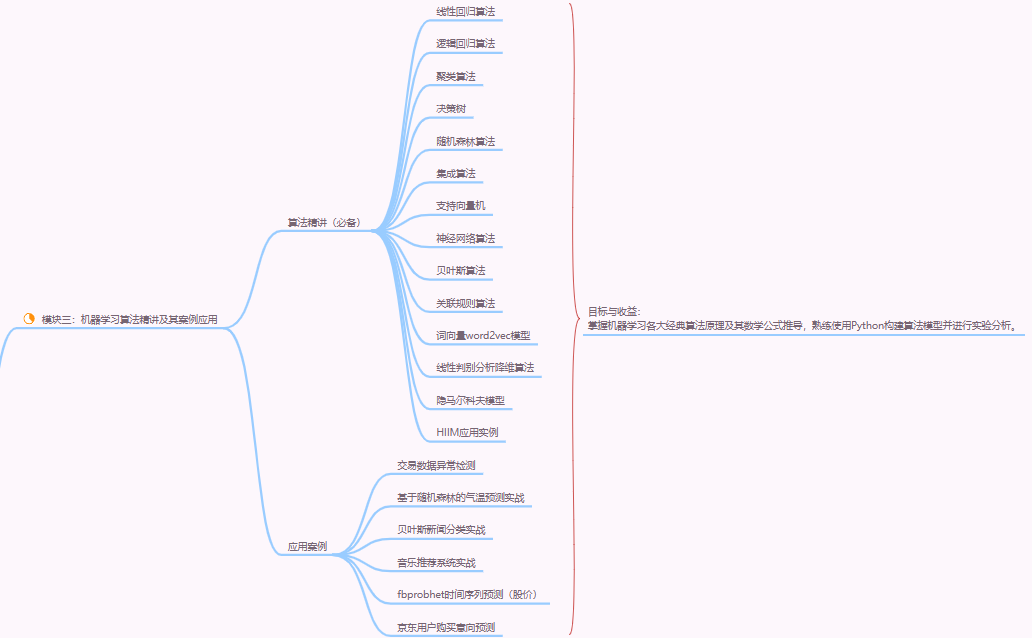
大模型是机器学习的 “进阶产物”,很多核心思想(如泛化性、过拟合、特征工程)均源自传统机器学习,需先掌握基础框架:

  1. 核心概念与流程

    • 数据划分:训练集、验证集、测试集的作用(避免过拟合,评估模型泛化性)、交叉验证(小样本场景的常用策略)。
    • 模型性能指标:分类任务(准确率、 precision、 recall、 F1-score、 AUC-ROC)、回归任务(MAE、 MSE、 RMSE)、大模型特有的指标(Perplexity 困惑度、BLEU、ROUGE,用于文本生成评估)。
    • 过拟合与欠拟合:成因(模型复杂度过高 / 过低、数据量不足)、解决方案(正则化、数据增强、早停 Early Stopping)。
  2. 经典算法思想

    • 无需深入实现,但需理解 “思想如何迁移到大模型”:
      • 决策树 / 随机森林:“特征选择” 思想→大模型中 “注意力权重分配”(关注重要特征);
      • 支持向量机(SVM):“最大化分类间隔”→大模型中 “Margin-based 学习”(如对比学习);
      • 聚类算法(K-Means):“相似性分组”→大模型中 “文本聚类、模态对齐”(如 CLIP 的图文对齐)。
三、深度学习基础:大模型的 “架构与组件”

大模型(如 Transformer、LLaMA、GPT)本质是 “复杂的深度学习网络”,需先掌握深度学习的核心组件和经典架构,再理解大模型的演进:

  1. 基础网络组件

    • 神经网络基本单元:神经元(激活函数的作用,如 ReLU 解决梯度消失、Sigmoid 用于二分类、Softmax 用于多分类)、全连接层(参数过多的问题,理解大模型为何用 “稀疏连接” 优化)。
    • 特征提取组件:卷积神经网络(CNN,图像领域的特征提取核心,理解 “局部感受野”→大模型中 “局部注意力”)、循环神经网络(RNN/LSTM/GRU,文本时序数据的早期处理方式,理解 “梯度消失” 问题→Transformer 的设计动机)。
  2. 大模型的核心架构:Transformer

    • 这是所有现代大模型(GPT、BERT、LLaMA、Diffusion)的基础,必须吃透:
      • 注意力机制(Attention):核心是 “计算 Query 与 Key 的相似度,为 Value 分配权重”,解决 RNN “长序列依赖” 问题;重点理解自注意力(Self-Attention)(同一序列内的特征交互,如文本中 “上下文关联”)和多头注意力(Multi-Head Attention)(从多个维度捕捉特征关联)。
      • Transformer Encoder/Decoder:Encoder(双向注意力,如 BERT 用于理解任务)、Decoder(单向注意力 + 掩码机制,如 GPT 用于生成任务),以及层归一化(LayerNorm)、残差连接(Residual Connection)的作用(稳定训练,解决深层网络梯度问题)。
      • 位置编码(Positional Encoding):Transformer 无时序信息,通过正弦 / 余弦编码或可学习编码,让模型感知序列顺序(如文本中 “词的先后关系”)。
  3. 经典预训练模型思想

    • 大模型的核心范式是 “预训练 - 微调(Pre-train & Fine-tune)”,需理解早期预训练模型的设计逻辑:
      • BERT(双向预训练):通过 “掩码语言模型(MLM)” 和 “下一句预测(NSP)” 学习通用语言表示,为后续大模型的预训练任务(如 GPT 的 “自回归语言建模”)奠定基础。
      • CLIP(跨模态预训练):通过 “图文对匹配” 学习跨模态特征对齐,是多模态大模型(如 DALL-E、GPT-4V)的核心思想。
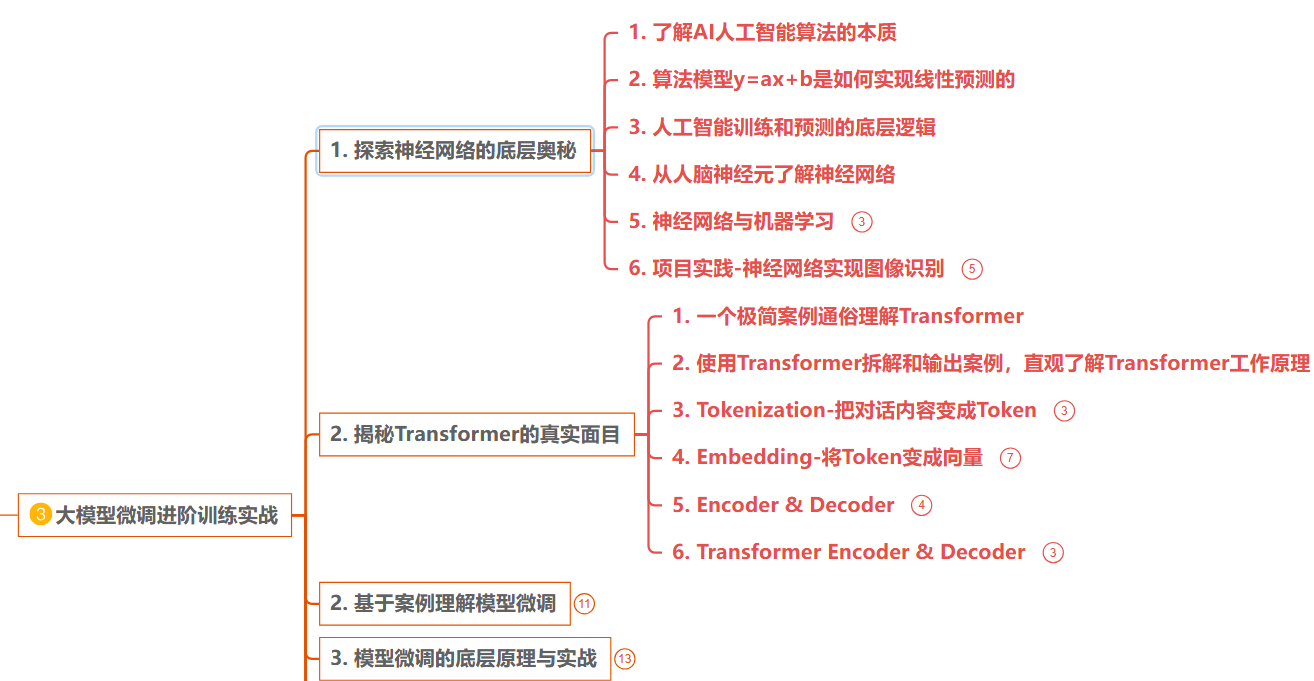
四、编程与工具链:大模型的 “实践工具”

理论需落地到代码,新手需掌握 “数据处理 - 模型调用 - 微调训练” 的核心工具,无需从底层造轮子,但需能熟练使用成熟框架:

  1. 编程语言

    • 核心:Python(AI 领域的通用语言,语法简洁,库生态完善)。
    • 重点掌握:数据结构(列表、字典、数组)、循环与条件判断、函数定义、类与面向对象(理解模型类的封装逻辑)。
  2. 数据处理工具

    • NumPy:数组运算(大模型输入数据的基础处理,如将文本向量转为 numpy 数组)。
    • Pandas:表格数据处理(如大模型训练数据的清洗、筛选、格式转换,如从 CSV 文件读取文本数据)。
    • 可视化工具(可选):Matplotlib/Seaborn(绘制模型损失曲线、准确率曲线,分析训练过程)。
  3. 深度学习框架

    • 二选一即可,重点是 “用框架调用 / 微调大模型”,而非底层实现:
      • PyTorch:动态计算图,调试友好,生态丰富(Hugging Face Transformers 库基于 PyTorch),是大模型研究的主流框架。
      • TensorFlow/Keras:静态计算图,适合工程部署,Google 系模型(如 T5)常用,新手可先学 PyTorch 入门。
  4. 大模型专用工具库

    • Hugging Face Transformers:最核心的库,提供预训练模型(GPT、BERT、LLaMA 等)的调用、微调接口,一行代码即可加载模型,新手必学。
    • Hugging Face Datasets:处理大模型训练数据的库,提供海量公开数据集(如 GLUE、C4),支持数据加载、预处理、格式转换。
    • 加速工具(可选):DeepSpeed/FairScale(解决大模型训练的显存不足问题,实现模型并行、数据并行)。
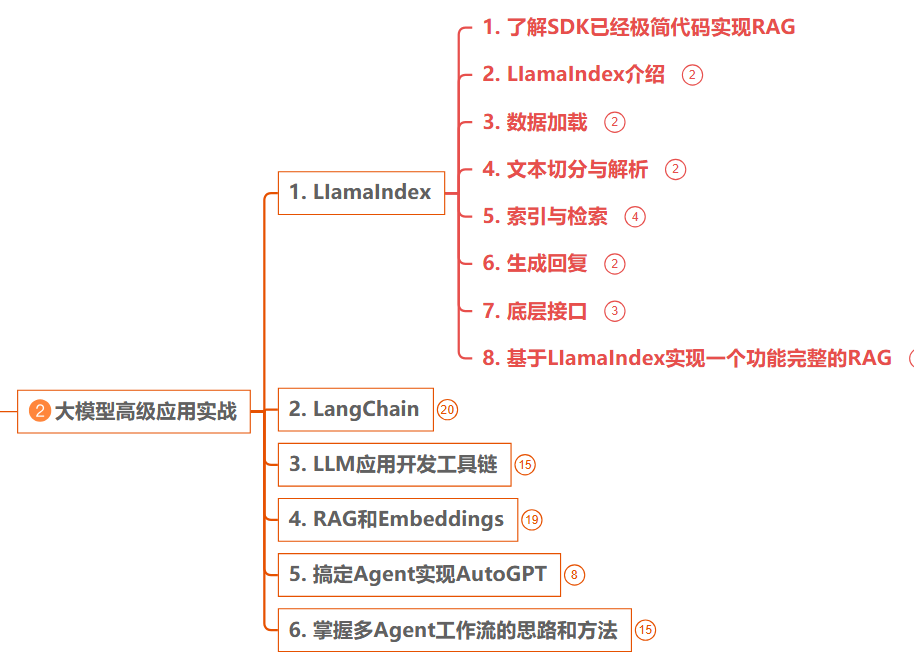
总结:新手的学习路径建议

  1. 先补数学:重点攻克 “线性代数(矩阵运算)+ 概率论(交叉熵)+ 最优化(梯度下降)”,无需啃纯数学教材,可结合 AI 应用场景学习(如《深度学习数学》)。
  2. 再学机器学习:理解 “数据划分、过拟合、性能指标”,用 Scikit-learn 库做简单实验(如训练一个逻辑回归模型),建立 “机器学习思维”。
  3. 深入深度学习:重点吃透 “Transformer 架构(注意力机制、Encoder/Decoder)”,用 PyTorch 实现简单的 Transformer 模块,理解大模型的核心组件。
  4. 动手实践:用 Hugging Face Transformers 调用预训练模型(如用 GPT-2 生成文本、用 BERT 做文本分类),再尝试微调小模型(如在自定义数据集上微调 BERT),积累实践经验。

通过以上基础的积累,新手能快速理解大模型的原理、训练逻辑和应用场景,为后续深入研究(如大模型优化、多模态大模型、大模型部署)打下坚实基础。

大模型全流程学习路径+60G学习干货包

论文指导+技术答疑+做项目

关zhuV.X服务号:大模型星球 发送:211C 自取

资料包:1、Agent多模态大模型视频及课件

2、ChatGLM、LLM、LangChain、llama3等教程,微调部署落地

3、Transformer、BERT、Huggingface三大基础模型

4、大模型前沿论文+书籍+路线图

5、最新大模型大厂面试题库、转型简历包装

6、李宏毅等名师视频合集
【AI大模型】新手工具包:Hugging Face注册与基础使用全解 摘要:本文为零基础用户提供HuggingFace(HF)平台完整使用指南,涵盖账号注册、密钥生成、模型调用与上传全流程。HF作为全球最大AI开源社区,托管数十万开源模型和数据集,是大模型开发的核心平台。教程详细讲解:1)注册账号并生成访问令牌;2)配置Python环境安装必要工具库;3)实战代码演示模型下载、本地推理和流水线应用;4)数据集加载与微调模型上传方法;5)网页端无代码使用技巧与常见问题解决方案。配套可直接运行的代码示例,帮助开发者快速掌握从模型调用到微调部署的全套技能,无缝衔接AI大模型开发生态 阅读详情

相关推荐

使用Matlab进行IEEE 33节点潮流计算的NR法实现详解及应用实例

IEEE 33节点系统是一个标准的配电系统模型,广泛用于学术研究和工程应用。该系统由33个节点和37条线路组成,结构复杂,具有代表性。其潮流计算结果可用于验证各种潮流计算方法的准确性和效率。NR法是一种基于迭代求解的潮流计算方法,通过不断迭代求解非线性方程组,直到达到预定的收敛条件。NR法具有收敛速度快、计算精度高的优点,适用于大规模复杂电力系统的潮流计算。

m0_57781768的博客 2070

从Hugging Face与ModelScope高效获取大模型与数据集的实战指南

本文提供了从Hugging Face与ModelScope高效获取大模型与数据集的实战指南,涵盖环境准备、基础下载命令、高级下载技巧及常见问题解决方案。通过优化下载速度、管理缓存和使用镜像源等技巧,帮助开发者快速获取所需资源,提升AI开发效率。

weixin_30505225的博客 633

告别Inspect!用微软官方推荐的Accessibility Insights搞定WinApp自动化测试元素定位

本文介绍了如何从传统的Inspect工具升级到微软官方推荐的Accessibility Insights for Windows,以提升Windows应用自动化测试中的元素定位效率。通过详细的功能对比、安装指南和实战技巧,帮助测试工程师掌握这款现代化工具的核心优势,包括实时元素检测、属性筛选和与WinAppDriver、Appium等测试框架的无缝集成。

weixin_26749245的博客 616

Hugging Face 推出免费 AI Agents 免费课程

今天给大家推荐的开源项目是来自于 Hugging Face 推出的免费 AI Agents 免费课程。这门课程从基础入门,到掌握如何使用和构建 AI 代理。

python1234567_的博客 788

产业大脑+未来工厂:揭秘浙江数字经济系统的5大核心场景搭建指南

本文深入解析了“产业大脑+未来工厂”这一浙江数字经济系统的核心范式,并提供了五大核心场景的实战搭建指南。文章详细阐述了从供应链协同、产能共享到产品创新、质量追溯及绿色低碳等关键场景的构建逻辑与技术架构,旨在帮助企业实现从技术驱动到场景驱动的价值落地,破解数据孤岛难题,提升产业链整体效能。

mac99的博客 665

LTE随机接入实战:如何通过PRACH前导码优化小区覆盖半径(附计算公式)

本文深入探讨了LTE网络中PRACH前导码格式对小区覆盖半径的关键影响。通过解析不同前导码格式(如Format 0-3)的物理参数与覆盖能力,提供了核心计算公式与实战Python脚本,指导网络工程师根据覆盖需求、环境多径和容量等因素,科学选择前导码格式以优化边缘用户接入成功率,实现精准的网络规划与优化。

qq_27496129的博客 572

Hugging Face 微调 + Tokenizer 机制新手教学(超详细)

Hugging Face入门指南:零基础玩转NLP模型 本文为NLP初学者提供了一份Hugging Face平台的详细入门教程。主要内容包括: Hugging Face核心功能: Transformers库(预训练模型) Datasets库(开源数据集) Tokenizers库(文本数字化工具) 关键概念解析: 预训练模型:如BERT、GPT等现成模型 微调:在预训练基础上进行针对性训练 Tokenizer:将文本转换为模型可读的数字格式 实战案例: 使用IMDB影评数据集进行情感分类 完整代码示例涵盖数据

qq_57758323的博客 1157

5步上手Quartz.NetUI:.NET Core定时任务的开箱即用解决方案

Quartz.NetUI是一个基于.NET Core + Quartz.NET + Vue + IView的开箱即用的定时任务UI解决方案。它结合了Quartz.NET的强大功能和Vue.js的易用性,提供了一个不依赖数据库、只需在界面进行简单配置即可使用的定时任务管理系统。通过上述步骤,你已经学会了如何使用Quartz.NetUI在.NET Core项目中实现定时任务。Quartz.NetUI不仅功能强大,而且使用简单,非常适合那些需要快速实现定时任务管理的开发者。

java专栏 2406

【万字长文】Hugging Face生态全面解析:程序员必备的大模型开发工具!

Hugging Face是提供开源AI工具和平台的公司,其生态系统由Hub和工具链组成。Hub用于托管分享模型、数据集和工具,工具链包括Datasets(数据处理)、Tokenizers(文本分词编码)和Transformers(模型加载使用)。文章详细介绍了如何使用AutoModel和AutoModelForXXX加载预训练模型,如何使用Tokenizer处理文本输入,以及如何使用Datasets库进行数据加载、预处理和保存,为开发者提供了完整的大模型开发解决方案。

Trb201013的博客 1006

调节桌面图标大小的方法(编程)

如果你对其他操作系统或编程语言有类似的需求,可以根据具体的情况进行相应的调整和搜索相关的库和方法。在编程中,我们可以使用各种桌面应用程序来调节桌面图标的大小。库提供的函数,我们获取了桌面图标的窗口句柄,并使用Windows消息发送方式设置图标的大小。你可以根据自己的需求修改代码中的图标大小值,并在运行代码后观察桌面图标的变化。函数并传入所需的图标大小,这里设置为48x48像素。首先,我们需要使用Python的第三现的方法。首先,我们需要使用Python的第三方库。首先,我们需要使用实现的方法。

CyberFlare的博客 437

使用Visual Studio 2022创建CUDA编程项目

本文介绍了在Visual Studio 2022中配置CUDA开发环境的完整流程。首先需要安装VS2022并勾选C++开发组件,然后安装CUDA Toolkit和兼容的NVIDIA驱动。创建项目时选择CUDA模板,VS会自动生成数组相加的示例代码。项目配置包含CUDA头文件依赖和链接器设置(cudart_static.lib)。文章详细说明了从环境搭建到代码编写、调试的完整步骤,帮助开发者快速上手CUDA编程。

新兴IT民工的专栏 1万+

Hugging Face 生态使用指南,大模型微调、预训练必备技能

Hugging Face 是一家提供开源 AI 工具和平台的公司,致力于简化预训练模型的使用,加速机器学习项目的开发与落地。

2401_82469710的博客 1470

初学者入门YOLO目标检测:从懵圈到上手,这篇文章讲透所有核心(附学习路径+避坑指南)

目标:比如训练一个“检测苹果和橘子”的模型,或者“检测人脸”的模型;任务:学会用LabelImg标注数据,制作YOLO格式的数据集,用命令行训练模型;关键:不用追求高精度,能训练出一个能检测出目标的模型就行。很多初学者卡在入门阶段,不是因为智商不够,而是因为“想太多,做太少”——总觉得要把所有原理搞懂才能动手,结果越想越怕,最后放弃。先动手,再动脑。先跑通一个案例,获得成就感;再制作自定义数据集,训练简单模型;最后再回头去理解原理,优化模型。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 688

Hugging Face 推出免费 AI Agents 免费课程,大模型入门到精通,收藏这篇就足够了!

今天给大家推荐的开源项目是来自于 Hugging Face 推出的免费 AI Agents 免费课程。这门课程从基础入门,到掌握如何使用和构建 AI 代理。

pythonhy的博客 638

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

Hugging Face官方出免费AI Agent教程!

2024年被称为是AI Agent的元年,经过了一年的酝酿,各类AI Agent的产品方案层出不穷,比如Dify、扣子等等。在未来,AI Agent无疑也会是AI的一块核心领域。

2301_81940605的博客 547

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Hugging Face生态全解析:大模型开发者的完整工具链教程

Hugging Face是AI开发的核心生态系统,包含Hub平台和工具链库。本文详解了Transformers库中的模型加载(AutoModel、AutoModelForXXX)、Tokenizer使用(文本处理与编码)以及Datasets库(数据加载、预处理与保存)。通过这些工具,开发者可高效实现从数据处理到模型训练的全流程,是入门大模型开发的必备知识。

2301_82275412的博客 1403

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

2026 Python+AI零基础入门天花板,本地大模型实战+代码直接抄,新手1个月逆袭

本文针对零基础新手提供Python+AI快速入门指南,聚焦2026最新技术趋势,摒弃传统晦涩理论,重点讲解轻量化AI应用开发。内容涵盖环境搭建、Python核心语法精简学习、AI全栈技术栈对比、本地大模型部署(Ollama)、LangChain应用开发等热门方向。提供完整学习路线图,从基础到实战项目(如房价预测),强调"应用优先"理念,15天即可完成AI项目开发。文章包含可直接运行的代码示例、技术对比表格和避坑指南,适合作为学习笔记、毕设或求职参考,帮助新手高效入门Python+AI开发

2602_94956987的博客 726

【收藏必备】一个月快速入门AI大模型:从零基础到实战项目的完整指南

本文提供为期一个月的AI大模型系统学习计划:第一周掌握Transformer架构与核心理论;第二周学习Hugging Face工具与模型应用;第三周深入模型微调与PEFT技术;第四周通过RAG系统、模型量化等项目实战应用所学知识。文章强调动手实践的重要性,提供学习心态建议,帮助读者从零开始系统掌握AI大模型技术,成为有能力的实践者。

2401_85154887的博客 1227

【收藏必备】大模型微调工具性能终极指南:Llama Factory、Unsloth和Hugging Face谁更胜一筹?

文章对比了Llama Factory、Unsloth和Hugging Face三大大模型微调工具的性能。实验显示,在单GPU环境下,Unsloth内存效率更高;在多GPU配置下,Llama Factory训练速度更快且扩展性更好。研究还发现序列长度对训练时间影响显著,主要源于注意力机制的二次复杂度。结论是:根据硬件配置选择合适的微调工具至关重要。

嘴巴吃糖了 1095

对标OpenAI Operator!Hugging Face推出免费AI智能体,虽有短板却暗藏潜力,大模型入门到精通,收藏这篇就足够了!

对标OpenAI Operator!Hugging Face推出免费AI智能体,虽有短板却暗藏潜力,大模型入门到精通,收藏这篇就足够了!

pythonhy的博客 1065

【收藏必备】Hugging Face生态解析:大模型开发者的全景指南与最佳实践

全面解析Hugging Face技术生态,涵盖Transformers、Datasets等核心组件及模型部署实践。文章详细介绍了统一架构接口、动态模型加载、高效注意力等关键技术,对比了不同推理方案的性能指标,并展示了大模型服务化架构。同时探讨了协作开发新模式,包括Spaces容器配置、AutoTrain工作流和模型卡片标准,最后介绍了Safetensors安全格式及模型可解释性工具链,为开发者提供完整的AI开发生态指南。

qq_46094651的博客 1022

AI大模型学习资源汇总:十大必备网站推荐

学习AI大模型不仅需要理论知识的积累,还需要通过实践来加深理解。上述十大网站提供了丰富的学习资源和社区支持,能够帮助你在AI大模型的学习之路上走得更远。希望你能充分利用这些资源,提升自己的技能,推动人工智能领域的发展。

m0_63171455的博客 5338

从零到精通:AI大模型学习全攻略,新手必备!AI大模型学习路线,零基础入门到精通

本文系统介绍了AI大模型的学习路线,从数学与编程基础(线性代数、微积分、Python等)开始,到机器学习入门(理论学习与Kaggle实践),再到深度学习进阶(Transformer架构、PyTorch框架)。接着探讨大模型应用(预训练模型微调、Hugging Face工具),并建议参与开源项目和行业应用。文章强调大模型时代催生了"技术+业务"复合型人才需求,推荐了提示词工程、RAG、模型微调等实用技术,提供了完整的学习资源包(104G)。最后指出2025年将是Agent技术元年,鼓励读者

m0_65555479的博客 881

Hugging Face入门

在 AI 的世界里,大模型的界定有着明确的标准,那就是参数量。一般来说,参数量达到 10 亿(10 亿 = 1B)以上的 AI 模型,我们称之为大模型,而参数量在 10 亿以下的则属于小模型。

2401_86968005的博客 801

【专辑】AI大模型应用开发入门-拥抱Hugging Face与Transformers生态 - Huggingface与Transformers简介

《AI大模型开发入门:HuggingFace与Transformers生态解析》 摘要: 本文系统介绍了HuggingFace及其核心产品Transformers库的开源生态。HuggingFace作为"AI界的GitHub",提供超200万预训练模型和60万数据集,通过Transformers库简化NLP/CV/语音等多模态开发流程。文章详解其核心功能:Pipeline推理、训练器微调、文本生成等,并对比阿里巴巴ModelScope平台的中文特色。课程涵盖从模型加载、微调到部署的全流程

java1234的博客 1826
上一篇: 人人都要学的AI大模型全栈学习路线
下一篇: 读完《大语言模型提示工程》,终于摸清 LLM 高效输出的 “密码”!
大模型星球
博客等级 码龄5年 1132粉丝 239原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

