NVIDIA提出STORM!Mamba 建模时间编码器!Token压缩实现高效长视频理解新SOTA!

MVBench:多模态大模型视频理解基准 MVBench多模态视频理解基准测试与VideoChat2模型设计研究 阅读详情

🌐 社群导航

🔗点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群

🔗点击加入➡️【2-3月CCF投稿】交流群

最新论文解读系列

图片

论文名:Token-Efficient Long Video Understanding for Multimodal LLMs

论文链接:https://arxiv.org/pdf/2503.04130

开源代码:https://research.nvidia.com/labs/lpr/storm
图片

导读

基于视频的多模态大语言模型(Video-LLM)的最新进展显著提升了人工智能系统理解和生成视频内容描述的能力。这些模型中常用的一种策略是将视频视为一系列单独的图像帧,使用图像编码器和视觉语言投影器独立处理每一帧。然后将得到的帧级表示输入到大语言模型(LLM)中,该模型进行时间推理以理解视频中所描绘的事件序列。

简介

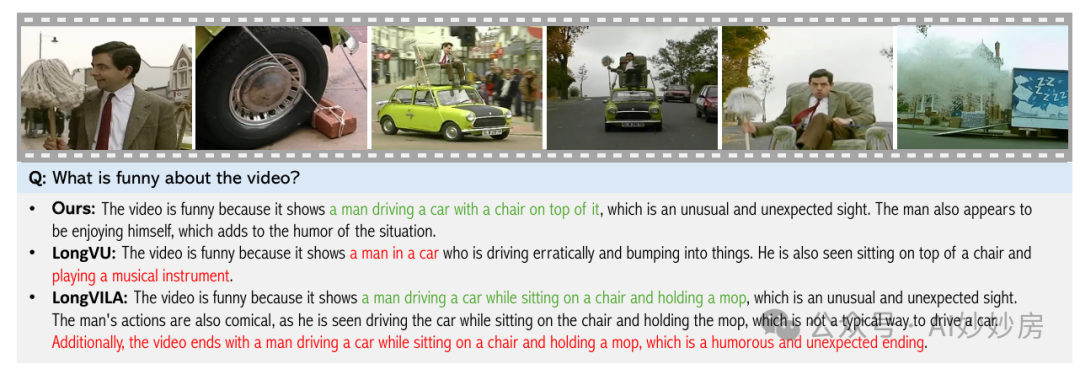
基于视频的多模态大语言模型(Video-LLMs)的最新进展,通过将视频处理为图像帧序列,显著提升了视频理解能力。然而,许多现有方法在视觉主干网络中独立处理帧,缺乏显式的时间建模,这限制了它们捕捉动态模式和有效处理长视频的能力。为解决这些局限性,我们引入了STORM(面向多模态大语言模型的时空令牌缩减,Spatiotemporal TOken Reduction for Multimodal LLMs),这是一种新颖的架构,在图像编码器和大语言模型之间融入了一个专门的时间编码器。我们的时间编码器利用曼巴状态空间模型(Mamba State Space Model)将时间信息整合到图像令牌中,生成丰富的表示,这些表示能保留整个视频序列中的帧间动态。这种丰富的编码不仅增强了视频推理能力,还能实现有效的令牌缩减策略,包括测试时采样以及基于训练的时间和空间池化,在不损失关键时间信息的情况下,大幅降低了大语言模型的计算需求。通过整合这些技术,我们的方法在提高性能的同时,还能同时减少训练和推理延迟,实现了在长时间上下文下高效且稳健的视频理解。大量评估表明,STORM在各种长视频理解基准测试中取得了最先进的成果(在MLVU和LongVideoBench上提升超过5%),同时对于固定数量的输入帧,计算成本最多降低,解码延迟降低。

方法与模型

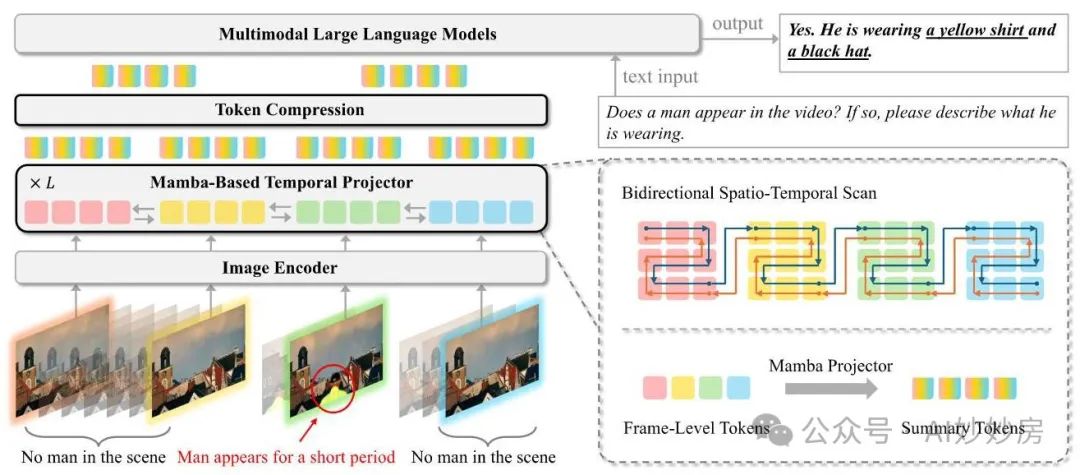
本节介绍基于曼巴(Mamba)的时间投影器架构,并引入几种用于高效长视频处理的令牌压缩技术。我们提出了两种令牌压缩方法:时间压缩和空间压缩。我们首先详细介绍我们的时间和空间池化策略,这些策略能在训练期间有效减少令牌数量。此外,我们提出了一种测试时的时间令牌采样方法,该方法无需额外的训练步骤即可保持模型性能。我们方法的概述如图2所示。
图片

图 2 | STORM 流程概述。我们在图像编码器和大语言模型(LLM)之间提出了一个基于曼巴(Mamba)的时间投影器。该投影器弥合了视觉表示和语言表示之间的差距,同时将时间信息注入到标记中。处理后的标记(在图中表示为摘要标记)自然地捕捉了时间历史,有效地总结了视频的时间动态。这种能力使我们能够在不损失关键信息的情况下,减少用于大语言模型处理的视觉标记数量。

1. 预备知识

状态空间模型(SSMs

MVBench多模态大模型视频理解能力基准 | CVPR Highlight 同时,基于对已有多模态模型的缺陷分析,提出了更强大的基线模型VideoChat2。近期的图像对话模型评测研究,倾向于从不同的感知和认知角度,考察模型多种能力,并基于不同的能力设计评测任务,再通过人工采集、标定数据。通过比较图像和视频任务的本质区别,联合团队确定了一种简单可扩展的方案,即首先总结基本的图像评测任务,再由这些任务出发,构建无法通过单帧有效解决的视频任务。提取取每个数据集中合适的视频长度,过短的视频往往动作幅度较小,而过长的视频包含过于复杂的上下文,问题过难会导致无法区分不同模型的能力; 阅读详情

相关推荐

ICCV 2025 | 视频生成迈入“多段一致”新时代!TokensGen用“压缩Token”玩转长视频生成

TokensGen提出创新两阶段框架解决长视频生成难题:1)To2V模型通过视频Tokenizer将短片段压缩为高语义密度Token,实现精细内容控制;2)T2To模型采用扩散Transformer一次性生成长视频Token序列,确保长期一致性。关键技术突破包括自适应FIFO-Diffusion对角去噪策略实现平滑过渡,以及基于PCA的轻量降维保持90%以上压缩率。实验表明,该方法在2分钟视频生成中显著优于主流基线,运动平滑度指标提升20%+,同时支持零拍摄长视频编辑。

AIGCer的博客 1756

VMamba:视觉语言模型中的高效状态空间架构

状态空间模型(State Space Model, SSM)作为一种序列建模技术,通过线性动力系统实现长序列的高效处理。其核心原理是将序列数据建模为状态转移过程,通过递归计算实现线性复杂度,同时保持对长程依赖的建模能力。在视觉语言模型(VLM)领域,SSM因其计算效率优势成为Transformer的有力替代。VMamba作为SSM在视觉任务中的代表架构,通过双向状态空间设计和动态参数化,显著提升了高分辨率图像处理的效率。实验表明,VMamba在512x512分辨率下显存占用比ViT减少42%,推理速度提升1

weixin_35755188的博客 207

w~多模态~合集1

可见GPT4无法处理模型优选任务,说明了该任务的重要性,以及我们方法的必要性,有效性。

whaosoft~aiotの开发板商城 1236

【Mamba】(202401)U-Mamba: Enhancing Long-range Dependency for Biomedical Image Segmentation

本文介绍了一种名为U-Mamba的通用生物医学图像分割网络,该网络旨在改进卷积神经网络(CNN)和Transformer在处理长距离依赖性方面的局限性。由于局部性和计算复杂性,CNN和Transformer在处理这类问题时能力有限。受状态空间序列模型(State Space Sequence Models, SSMs)的启发,我们设计了一个混合型CNN-SSM模块,它结合了卷积层强大的局部特征提取能力和SSMs捕捉长程依赖性的能力。

LetsonH的博客 6099

别再死记硬背GNN公式了!用PyTorch Geometric从零实现一个GraphSAGE(附完整代码)

本文通过PyTorch Geometric从零实现GraphSAGE模型,深入解析图神经网络的核心原理与实战应用。文章提供完整代码示例,涵盖环境配置、邻居采样、信息聚合等关键步骤,帮助开发者掌握图表示学习技术,避免陷入公式推导的困境。适合希望将GNN应用于实际项目的中级开发者和学生。

weixin_42530570的博客 348

【Android14 ShellTransitions】Transition就绪:双Transaction与SurfaceControl显示时机剖析

本文深入剖析了Android14 ShellTransitions框架中Transition就绪阶段的核心机制。重点解释了为何需要“双Transaction”来精确控制SurfaceControl的显示与隐藏时机,以确保Activity切换动画的流畅性。通过分析onTransactionReady流程、窗口绘制状态机及动画目标提升策略,揭示了系统如何协调WMCore与WMShell,实现从状态收集到动画播放的无缝衔接。

ooo22的博客 530

西门子200 SMART与博图WinCC通讯全攻略:从PC Access到S7-200协议避坑指南

本文详细解析了西门子S7-200 SMART PLC与博途WinCC上位机通讯的两种主流方案:基于PC Access SMART的OPC通讯和利用博途内置S7-200协议驱动直连。文章深入对比了两种架构的优缺点、配置步骤,并提供了从网络层到软件层的深度排错指南与性能优化建议,帮助工程师高效、稳定地实现系统集成。

gg901的博客 819

dbt+Snowflake实战:数据建模、权限隔离与性能优化全指南

dbt(data build tool)作为现代数据栈的核心建模工具,其与Snowflake的深度协同远不止于SQL编译执行——它本质是将软件工程实践(如版本控制、测试驱动、CI/CD)注入数据交付流程。理解dbt的声明式建模原理与Snowflake的虚拟仓库、Time Travel、TRANSIENT表、聚簇键等底层机制如何咬合,是实现可维护、可审计、低成本数据产品交付的关键。本文聚焦dbt在Snowflake环境中的真实落地挑战,涵盖schema与warehouse的物理映射设计、role级硬隔离策略、

weixin_34389926的博客 315

以太网PHY寄存器

并且,值得注意的是,由于目前很多百兆的PHY芯片其MAC接口主流的都是SMII/S3MII,8个端口的接口是相互关联的,一个端口设置Isolate可能会影响其他端口的正常使用,因此在使用中注意不要随意更改bit10的状态。Bit10和bit11的区别是,bit11的配置在强制情况下生效,PHY只能工做与bit11指定的工作模式,而bit10的配置在非强制配置情况下生效,仅仅控制PHY在AN时候的优先级,偏向于Maser或者Slave,但是最终的工作模式看协商的结果,不一定和优先级配置的结果一致。

mangofu的博客 293

electron:解决打包后报错Cannot find module ‘X‘ 运行报错各种模块缺失问题(解决electron build打包后运行应用报错启动失败或白屏,无论模块名称是什么都能解决!)

Electron app打包后启动报错:“Cannot find module 'X'”解决方案,electron-builder 打包出现 cannot find module,electron 打包后找不到module问题,electron打包运行白屏、Can not find modules ‘x‘,electron项目打包报错,electron打包后,点击生成的exe应用程序出现Cannot find module,解决electron-build打包后运行app报错:cannot find mod

✅ 精选推荐文章 4386

Allegro如何进行四层板板层设计

板层的设计

weixin_42499230的博客 3194

HBase学习二:RegionServer详解

RegionServer是HBase系统中最核心的组件,主要负责用户数据写入、读取等基础操作。RegionServer组件实际上是一个综合体系,包含多个各司其职的核心模块:HLog、MemStore、HFile以及BlockCache。一个RegionServer由一个(或多个)HLog、一个BlockCache以及多个Region组成。其中,HLog用来保证数据写入的可靠性;BlockCache可以将数据块缓存在内存中以提升数据读取性能;

qwerty1372431588的博客 750

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

上一篇: BuboGPT:首个可以定位的视觉、音频和语言多模态对话模型发布!
下一篇: 【NeurIPS 2024】南理工提出IMAGPose!用于Pose引导人物图像生成的统一条件框架!照片级真实感!
DataSourceAI
博客等级 码龄3年 470粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值