

快速理解binary cross entropy 二元交叉熵

深度学习损失函数详解 | Binary Cross Entropy(二元交叉熵)原理 + 数学推导 + Python实现 (简称 BCE)是用于二分类模型的损失函数,通常用于输出为概率(0~1)的问题,比如逻辑回归、神经网络的输出层等。它本质上是信息论中的交叉熵(Cross Entropy)在二分类场景下的特例。Binary Cross Entropy 是一个经典且强大的损失函数,适用于任何概率型的二分类输出模型。掌握其原理不仅有助于理解模型的优化过程,也能在实际建模中灵活应用与调试。 阅读详情
AI摘要

本文详细介绍了二元交叉熵作为损失函数在二分类问题中的应用。通过公式解释,展示了当标签为1和0时,如何根据预测概率计算损失。二元交叉熵能够有效地衡量模型预测的准确性,当预测与实际标签一致时损失最小,不一致时损失增大。通过对所有样本损失的平均,得到模型的整体损失。

Binary cross entropy 二元交叉熵是二分类问题中常用的一个Loss损失函数,在常见的机器学习模块中都有实现。本文就二元交叉熵这个损失函数的原理,简单地进行解释。

首先是二元交叉熵的公式 :
Loss=−1N∑i=1Nyi⋅log⁡(p(yi))+(1−yi)⋅log(1−p(yi)) Loss = - \frac{1}{N}\sum_{i=1}^{N}y_i \cdot \log(p(y_i)) + (1 - y_i) \cdot log(1-p(y_i)) Loss=−N1​i=1∑N​yi​⋅log(p(yi​))+(1−yi​)⋅log(1−p(yi​))

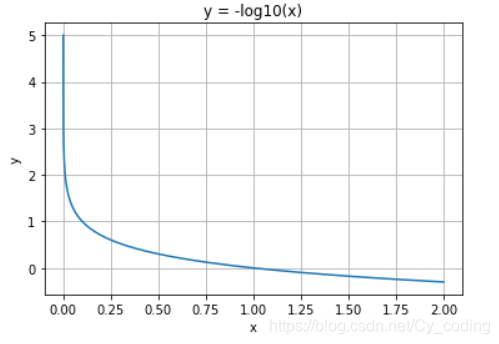
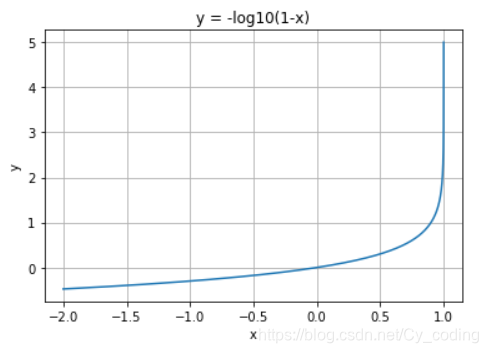
其中,yyy 是二元标签 0 或者 1, p(y)p(y)p(y) 是输出属于yyy 标签的概率。作为损失函数,二元交叉熵是用来评判一个二分类模型预测结果的好坏程度的,通俗的讲,即对于标签y为1的情况,如果预测值p(y)趋近于1,那么损失函数的值应当趋近于0。反之,如果此时预测值p(y)趋近于0,那么损失函数的值应当非常大,这非常符合log函数的性质。

下面以单个输出为例子,在标签为 y=1y=1y=1 的情况下Loss=−log⁡(p(y))Loss = -\log(p(y))Loss=−log(p(y)), 当预测值接近1时,Loss=0Loss = 0Loss=0, 反之 LossLossLoss 趋向于正无穷。
在这里插入图片描述

同样的单个输出为例,当标签 y=0y=0y=0时,损失函数 Loss=−log⁡(1−p(y))Loss = -\log(1-p(y))Loss=−log(1−p(y)),当预测值接近0时,Loss=0Loss = 0Loss=0,反之LossLossLoss 趋向于正无穷。
在这里插入图片描述
之后,再对所有计算出的单个输出损失求和求平均,就可以求出模型针对一组大小为N的输出的Loss了。

交叉熵损失和二元交叉熵损失 交叉熵损失和二元交叉熵损失的简单讨论 阅读详情

相关推荐

二元交叉熵损失函数(Binary Cross Entropy Loss,BCELoss)是交叉熵损失函数(CrossEntropyLoss)的特殊情况

一直以来看到还以为是很复杂的东西,原来其实是,也就是二元交叉熵损失函数其实就是交叉熵损失函数。

努力学习的DS 6885

损失函数:BCE Loss(二元交叉熵损失函数)、Dice Loss(Dice相似系数损失函数)

Python、PyTorch、人工智能、损失函数

FriendshipTang的博客 2万+

深入解析Binary Cross Entropy:从数学原理到PyTorch实战

本文深入解析Binary Cross Entropy(BCE)损失函数,从数学原理到PyTorch实战应用。详细介绍了BCE在二分类任务中的核心原理、PyTorch中的三种实现方式及数值稳定性处理技巧,并结合电商推荐系统和图像分割等实际案例,展示了BCE的多场景应用。文章还探讨了梯度行为、优化策略及高级变体,为深度学习开发者提供全面指导。

weixin_30379531的博客 192

详细介绍二元交叉熵损失函数,计算过程及优缺点

二元交叉熵损失函数是一种常用的机器学习损失函数,它可以用来衡量训练模型的预测准确性。它通过计算真实标签与预测标签之间的差异来衡量模型的预测准确性。为了计算二元交叉熵损失函数,我们需要先计算两个标签的概率,然后计算交叉熵损失函数:L = -(y*log(p) + (1-y)*log(1-p))。此外,二元交叉熵损失函数只能处理二元分类问题,而且它不能处理多分类问题。优点是,它可以衡量模型的预测准确性...

weixin_35755823的博客 2805

多标签分类实战指南:从概念误区到工业级落地

多标签分类(Multilabel Classification)是一种基础但常被误用的监督学习范式,其核心在于每个样本可同时归属多个独立二元标签,而非传统多分类的互斥单选。它源于对现实世界属性叠加性(如商品兼具‘学生适用’‘简约风格’‘棉质’)的建模需求,技术原理上依赖sigmoid激活、二元交叉熵损失与标签级评估体系。相比多分类,它在电商打标、新闻分类、医疗诊断等需细粒度语义刻画的场景中具备不可替代的技术价值。本文聚焦真实项目中的概念辨析、路线选型、特征融合与阈值校准等关键实践环节,尤其强调‘标签相关性’

aikenqiu5098的博客 337

从机械臂示教到厨房做饭:ACT模仿学习如何让机器人更“人性化”?

本文探讨了ACT(Action Chunking with Transformers)模仿学习技术如何让机器人更“人性化”,特别是在厨房等复杂场景中的应用。通过动作分块(Action Chunking)和时态融合(Temporal Ensemble)技术,机器人能够像人类一样记忆和执行复杂任务,如烹饪。文章还分析了ACT在家庭场景中的落地挑战及其在康复医疗、柔性制造等领域的跨领域应用潜力。

weixin_30613343的博客 255

Binary Cross Entropy

参考Understanding binary cross-entropy / log loss 此笔记有内容与机器学习逻辑回归算法原理、伪代码及实现效果展示 交叉熵(cross_entropy)重合 Introduction 训练一个二元分类器( binary classifier)的时候,往往会用到binary cross-entropy / log loss作为损失函数。下面详细介绍这个损失...

zhongzhh8的博客 2万+

Bentley ORD(openroads designer) 二次开发(BIM)第七节 在ORD SDK中调用MicroStation SDK

从课程刚开始的时候我们就通过学习,了解了ORD的开发是基于MicroStation的,ORD SDK的接口发布的时候也对MicroStation SDK也做了一次发布。这一章将以我们对ORD SDK知识的了解为基础,使用ORD SDK的接口读取道路几何信息、计算桩号,然后再使用MicroStation SDK 读取地形数据和计算投影点的位置,并创建一组方柱形状的Soild。计算方柱底部坐标要经过两大步骤,通过路线的桩号及偏移距离去定位方柱的平面位置,通过方柱的平面位置计算数字地面模型上的投影点的坐标。

chen286990651的博客 882

从零理解Binary Cross Entropy:数学原理到实际应用的全方位指南

本文全面解析Binary Cross Entropy(二元交叉熵)的数学原理与Python实现,深入探讨其在深度学习中的核心应用。从信息论基础到梯度特性分析,结合PyTorch/TensorFlow实战示例,揭示BCE在二分类、自编码器等场景中的优化技巧,帮助开发者掌握这一关键损失函数的工程实践与性能调优方法。

ff678的博客 302

电荷灵敏前置放大器噪声优化策略:从理论到实践

本文深入探讨了电荷灵敏前置放大器的噪声优化策略,从理论分析到实践应用。文章系统解析了并联电流噪声与串联电压噪声的来源,并引入噪声等效原理与“冷电容”模型作为统一分析工具。通过详解a、b、c三类噪声的频谱特性,为实战优化提供了清晰指导。核心策略包括选用高跨导、低漏电流FET,优化静态工作点,采用共源-共基结构,精心设计反馈网络,以及实施严格的PCB布局、屏蔽与接地,旨在全面提升微弱信号检测系统的信噪比。

weixin_29292431的博客 469

【学习K230-例程46】GT6700-UVC摄像头

UVC模块提供了USB摄像头的检测、配置和图像采集功能,支持单摄像头操作。本实验通过开发板上的USB接口连接摄像头,将摄像头捕获到的画面显示在显示设备上。print(f"模式{i}: {mode.width}x{mode.height} {mode.format}@{mode.fps}fps")print(f"摄像头检测: {‘已连接’ if plugin else ‘未连接’}, 设备信息: {devinfo}")检测系统是否连接了USB摄像头(当前仅支持单个摄像头检测)。获取摄像头支持的所有视频模式。

GilgameshJSS的博客 807

Binary Cross Entropy可视化指南:用Python绘制损失函数曲线,直观理解模型优化过程

本文通过Python和Matplotlib,以可视化方式深入解析二元交叉熵损失函数。通过绘制一维损失曲线、3D参数损失曲面以及梯度下降动画,直观展示了损失函数如何惩罚预测错误,并引导模型参数优化。文章帮助读者从图形化角度深刻理解模型训练过程,特别适合视觉学习型开发者。

solidity8miner的博客 439

Vivado时序违约小结

目录1. setup time违约1.1 逻辑级数太高1.2 Fanout太大2. hold time 违约2.1 异步信号处理导致hold time违约 1. setup time违约 建立时间是工程设计中最常遇到的问题了。一般说来,导致建立时间违例主要有两个原因:逻辑级数太大或者扇出太大,当然也可以尝试通过降频来解决建立时间违约。 1.1 逻辑级数太高 Levels指的是逻辑级数logic level,一个logic level的延迟对应的是一个LUT和一个Net的延迟,对于不同的器件,不同频率的设计能

mu_guang_的博客 7158

什么是交叉熵损失(Cross-Entropy Loss)?背后的数学原理

交叉熵”(Cross-Entropy)这个词来自信息论。我们把它拆开看:交叉熵 = 交叉 + 熵熵(entropy)衡量的是一个概率分布的不确定性。如果一枚硬币完全公平(50% 正面、50% 反面),熵就高,因为我们对结果非常不确定。如果一枚硬币总是落在正面(100% 正面、0% 反面),熵就是零,因为完全没有不确定性。"交叉"意味着我们在比较两个分布:真实分布(应该发生什么)和预测分布(模型认为会发生什么)。

Java开发,人工智能,边缘计算,致力于掌握前沿技术 142

深入理解 SAP HANA 上的查询处理机制:从 CDS 分层建模到执行计划落地

本文探讨了S/4HANA系统中CDS视图性能问题的本质及其优化策略。文章指出,性能问题往往源于数据模型、查询编译和执行计划的综合影响,尤其在多层CDS视图叠加时表现更为明显。通过分析SAP HANA查询处理链路的四个关键阶段(SQL Plan Cache、SQL Front End、SQL Optimizer和Execution Plan),揭示了CDS视图性能波动的根本原因。文章强调,优化CDS性能需要关注数据规模、谓词选择性和执行计划稳定性,建议使用参数化查询、合理分层视图结构,并利用PlanViz等工

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 4819

第十届MathorCup高校数学建模挑战赛-B题:养老服务床位需求预测与运营模式研究

当养老床位数增加时存在的商机,提出了相应的养老服务床位的运营商业模式。就业的可能性,建立多目标规划模型,尽可能同时满足三方面的要求。务床位的需求、制定合理的养老服务床位发展规划,是构建和谐社会、幸福社会。问题一的床位需求与市场类型的分类结果,查找关于国内养老院的相关数据,探。求,又能持续发展养老事业,同时还能促进社会就业的养老服务床位运营的商业。养老服务床位数的增加能够带来的就业方面因素的影响,并对这些因素进行一个。你们的模型及其结论为科学依据,对政府管理部门针对养老床位规划提出合理的。

getusushu的博客 1140

AI开发之基础快速入门深度学习

等最终扔进线上生产环境预测时,它就已经变成了一个越猜越准的模型了,最后谁是黑客,谁是正常用户,一抓一个准!知道差距在哪了后,咱们立刻启动微积分链式法则,抄家伙改这就是backward反向传播,把那些猜错的参数轻轻往正确的方向挪动,谁贡献了或者错误了就改谁。所以咱们还是像之前一样从零开始,不依赖任何深度学习框架PyTorch/TensorFlow/Keras,仅使用纯python和numpy来手写一个深度学习模型,是理解ai底层机制前向传播,反向传播,梯度下降方式。3.循环训练与最终预测:反复猜!

Strategic__qq3610256651的博客 241

【问题解决】Python 异步 asyncio 卡死、协程不执行、任务泄漏,保姆级排错

本文详细分析了Python异步编程中常见的卡死、协程不执行和任务泄漏问题。文章首先列举了这些问题的典型表现,如程序卡住、死锁、任务未启动等。然后深入剖析了各类问题的根源,包括同步阻塞操作、未正确await、资源未清理等。针对这些问题,文章提供了两套解决方案:一是异步编程最佳实践,包括安全协程执行、带超时的执行、任务清理等实用方法;二是死锁检测和预防机制,通过锁管理和等待图分析来避免死锁。文章还包含可直接使用的代码示例,帮助开发者快速定位和解决异步编程中的常见问题。

博客 450

RAG精排技术解析:从向量检索到Cross-Encoder的实战优化

在构建高质量检索增强生成(RAG)系统时,向量检索作为核心技术,通过将查询和文档映射到语义空间实现快速召回。然而,其依赖的语义相似度计算存在固有局限,如词汇不匹配和缺乏深度交互理解,可能导致检索结果与问题相关性不足。为解决这一问题,RAG精排技术应运而生,它通过在初步检索后引入智能排序层,显著提升信息精度。以Cross-Encoder为代表的深度交互模型,通过将查询与文档拼接并利用自注意力机制进行细粒度匹配,实现了更精准的相关性评估。这项技术的核心价值在于优化大模型输入质量,减少信息过载和幻觉现象,从而提升

weixin_30642869的博客 451

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

深入理解交叉熵:原理、实现与机器学习应用

交叉熵是信息论中的核心概念,用于衡量两个概率分布之间的差异。其数学本质可以分解为熵与KL散度的组合,在机器学习中常被用作分类任务的损失函数。从工程实践角度看,交叉熵具有梯度计算高效、收敛速度快等技术优势,特别适合处理图像分类、自然语言处理等场景。现代深度学习框架如PyTorch和TensorFlow都内置了交叉熵的优化实现,同时衍生出标签平滑、Focal Loss等改进变体,有效应对类别不平衡、模型过拟合等实际问题。理解交叉熵的工作原理,对于设计高效的机器学习模型至关重要。

weixin_34116110的博客 539

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

多类别分类与多标签分类的本质区别与工程实践

在机器学习分类任务中,多类别分类(Multi-Class)建模互斥的单选决策,输出归一化概率分布,适用于‘它是什么’的唯一归属判断;而多标签分类(Multi-Label)将每个标签视为独立二分类,输出非互斥置信度,本质是识别样本的多重属性。其技术价值在于支撑信息检索、内容打标、细粒度特征识别等真实业务场景。关键差异体现在输出层设计(Softmax vs Sigmoid/BCE)、损失函数(Cross-Entropy vs Binary Cross-Entropy)及评估逻辑(Accuracy/F1 vs H

weixin_30338497的博客 328

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

手写三层感知机:从XOR入门理解反向传播原理

多层感知机(MLP)是深度学习的基础模型,其核心在于前向传播与反向传播的协同机制。反向传播并非黑箱,而是基于链式法则的确定性梯度计算过程,用于高效求解损失函数对各层权重的偏导数。该技术赋予网络非线性拟合能力,在图像识别、自然语言处理等任务中构成模型可训练性的理论基石。本文以XOR逻辑门为教学载体,使用NumPy纯手写实现2-3-1结构的MLP,聚焦Backward Propagation的逐层误差传递与矩阵维度对齐,帮助初学者建立对梯度流动、激活函数导数及权重更新的直观工程认知。

314

用NumPy从零实现反向传播神经网络:代码逐行解析

神经网络的核心并不在于框架封装好的接口,而在于数据流动与梯度计算的底层逻辑。理解前向传播、反向传播、损失函数与梯度下降,是掌握一切深度学习模型的基础。本文从最小BP神经网络出发,仅依赖NumPy实现完整训练流程,涵盖矩阵运算、激活函数、链式法则与参数更新,并借助鸢尾花数据集验证结果。同时,将全连接网络的思想延伸至卷积神经网络(CNN)与循环神经网络(RNN),剖析权重共享与隐藏状态更新的本质。通过阅读代码而非API文档,建立从数学原理到工程实践的完整直觉,为调参、排错和迁移到其他网络结构打下扎实基础。

weixin_33860553的博客 329

PyTorch实战:从零实现变分自编码器(VAE)理解生成模型核心

自编码器是一种经典的无监督学习模型,通过编码器将高维数据压缩为低维表示,再由解码器重建,常用于数据降维和特征学习。然而,传统自编码器的隐空间往往不规则,难以从中采样生成高质量新数据。变分自编码器(VAE)通过引入概率图模型和变分推断,将隐变量建模为概率分布,并利用重参数化技巧实现可微分的随机采样,从而学习到一个连续、规整的隐空间。这一技术革新使得模型不仅能重建数据,更能学习数据背后的潜在分布,成为连接自编码器与深度生成模型的重要桥梁。在计算机视觉和AIGC领域,VAE为数据生成、隐变量建模提供了坚实的理论基

weixin_34060741的博客 406

PyTorch BCELoss使用陷阱与BCEWithLogitsLoss工程实践

二元交叉熵(BCE)是深度学习二分类任务的基础损失函数,其数学本质要求输入为(0,1)区间内的概率值、标签为float型0/1编码,并严格满足数值稳定性约束。在实际工程中,直接套用nn.BCELoss易因sigmoid激活缺失、数据类型不匹配、混合精度降级等问题导致NaN loss、梯度消失或AUC骤降。而nn.BCEWithLogitsLoss通过融合sigmoid与log-loss、内置log-sum-exp数值保护、原生支持pos_weight等机制,显著提升训练鲁棒性与收敛效率,已成为工业级二分类项

weixin_33966095的博客 430
上一篇: keras中mean square error均方误差理解
下一篇: python numpy 分离与合并复数矩阵实部虚部的方法
Cy_coding
博客等级 码龄7年 49粉丝 88原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值