


前言
Transformer是奠定现代人工智能(尤其是大语言模型,例如: CHATGPT,DeepSeek等)的基石架构,也是引爆这一轮AI技术革命的奇点。所以理解这个架构是非常必要的!
因为昨天有读者问关于Transformer架构,对这个还很模糊,所以这两天我把Transformer详细基础的写了出来,考虑到大家其实对解码器和架构的组成有一些不足,我在后面添加了专门的数据在结构之间的流动帮助大家理解
一、 核心思想:为什么需要 Transformer?
在 Transformer 出现之前,处理序列数据(比如句子)的主流模型是循环神经网络(RNN),特别是其变种 LSTM 和 GRU。
RNN 的工作方式像是一个人逐字阅读句子:
读第一个词。
记住它的信息,然后读第二个词。
结合第一个词的信息来理解第二个词,然后更新记忆,再读第三个词……
这种“依次处理”的模式有两个致命弱点:
无法并行计算:你必须处理完第 N 个词才能处理第 N+1 个词,这在处理长文本时效率极低,限制了模型在现代大规模硬件(如 GPU)上的训练速度。
长期依赖问题:虽然 LSTM 等模型有所缓解,但信息在长序列中传递时,仍然会逐渐丢失或扭曲。句子末尾的词很难“记住”句子开头的词的精确信息。
Transformer 的革命性思想是:彻底抛弃 循环 和 依次处理,采用一种能够一次性看到并处理整个序列中所有词的方法。
它的核心就是 “自注意力机制”(Self-Attention)。
我们在理解句子 “The animal didn’t cross the street because it was too tired.” 中的 “it”。为了搞清楚 “it” 指的是 “animal” 还是 “street”,你需要同时关注句子中的其他词。RNN 是慢慢地把信息传递过来,而 Transformer 则允许 “it” 直接与 “animal” 和 “street” 等所有词进行 “对视”,并根据相关性强度来判断 “it” 到底指谁,这个方法一听就很可行啊!
二、 整体架构:可以类比成一个翻译团队
首先借用大神的一张图了解大体结构:

Transformer 最初是为了机器翻译任务而设计的,其结构也像一个由“编码器(Encoder)”和“解码器(Decoder)”组成的团队。
编码器 (Encoder):负责“理解”输入。
它会接收源语言的整个句子(例如,“我是一只猫”)。
它的任务是处理这个句子,提炼出其中每个词的深层含义和上下文关系,并生成一系列富含信息的向量表示(Vector Representations)。你可以想象成编码器把源语言的句子“消化”并理解透彻了。
解码器 (Decoder):负责“生成”输出。
它接收编码器生成的向量表示,以及已经生成的目标语言部分(例如,已经翻译出 “I am”)。
它的任务是根据对源句子的理解和已生成的内容,预测下一个最可能的词(例如,预测出 “a”)。这个过程会一直持续,直到生成完整的句子。
编码器和解码器都不是单一的组件,而是由多个相同的层(论文中是6层)堆叠而成。我们接下来深入其内部,看看最关键的部件。
三、 核心组件深入解析
\1. 输入处理:嵌入与编码
计算机不认识文字,只认识数字。所以第一步是把词语转换成向量。
1.词嵌入 (Word Embedding):每个词会被映射到一个固定长度的向量。例如,“猫”可能被表示为 [0.1, -0.4, 0.8, …]。这些向量在训练开始时是随机的,模型会逐渐学习到让意思相近的词(如“猫”和“虎”)拥有更相似的向量。
2.位置编码 (Positional Encoding):由于 Transformer 抛弃了 RNN 的顺序结构,它本身无法感知词语的位置。没有位置信息,“我打你”和“你打我”在模型看来是一样的。为了解决这个问题,我们需要给每个词的向量中加入“位置信号”。
3.如何实现? 论文中使用了一组巧妙的 sin 和 cos 函数。对于每个位置,都会生成一个独特的向量,这个向量会被加到该位置的词嵌入向量上。

这里 pos 是词的位置
i 是向量的维度索引
d_model 是向量总维度。
这种设计的好处是,不同位置的编码是独特的,并且模型可以学习到它们之间的相对位置关系。
\2. 自注意力机制 (Self-Attention):
这是 Transformer 最核心的部分。它让模型在处理一个词时,能够同时考虑到句子中所有其他词对它的影响。
工作原理(三步走):
对于输入序列中的每一个词向量,我们都会根据它创建三个新的向量:
查询向量 (Query, Q):代表了当前词为了理解自己,要去“查询”或“提问”的向量。
键向量 (Key, K):代表了当前词可以被“索引”或“标识”的特征,用来响应其他词的查询。
值向量 (Value, V):代表了当前词的实际内容和含义。
这三个向量都是通过将原始词向量乘以一个在训练中学习到的权重矩阵(W_Q,W_K,W_V)得到的。
计算过程如下:
第一步:计算注意力分数 (Attention Score)
1.对于一个我们正在处理的词(比如 “it”),我们用它的 Q 向量去和句子中所有词的 K 向量进行点积(Dot Product)运算。
2.这个点积结果就代表了 “it” 与其他每个词之间的“相关性”或“关注度”。如果 “it” 的 Q 向量和 “animal” 的 K 向量方向更接近,它们的点积就会更大,表示关联度高。
第二步:缩放与归一化 (Scale & Softmax)
1.将上一步得到的所有分数除以一个缩放因子 sqrtd_k(d_k 是 K 向量的维度)。这一步是为了防止梯度在反向传播时变得过小,让训练更稳定。
2.然后,将缩放后的分数输入到 Softmax 函数中。Softmax 会将这些分数转换成一组总和为 1 的权重(概率分布)。现在,每个词都有一个权重,表示我们应该对它投入多少“注意力”。分数高的词,权重就大。
第三步:加权求和
1.将上一步得到的权重,分别乘以每个词对应的 V 向量。
2.最后,将所有加权后的 V 向量相加,得到的结果就是当前词(“it”)经过自注意力机制处理后,融合了全局上下文信息的新向量表示。这个新向量比原始向量更能理解它在句子中的角色。
公式总结:

3. 多头注意力 (Multi-Head Attention)
一次自注意力计算,像是只从一个角度去理解句子。但显然,词语之间的关系是多维度的。例如,“The cat sat on the mat” 中,“sat” 这个词既和主语 “cat” 有关(谁在坐),也和地点 “mat” 有关(坐在哪)。多头注意力就是让模型从多个不同的“角度”或“子空间”去理解上下文关系。
1.如何实现? 它不是只用一组 W_Q,W_K,W_V 矩阵,而是用多组(例如8组)。每一组都会独立地执行上述的自注意力计算,得到一个输出向量。这就好比有8个“注意力头”在同时工作,每个头关注点不同。
**2.整合信息:**得到8个输出向量后,将它们拼接(Concatenate)在一起,再乘以一个额外的权重矩阵 W_O,将其融合为一个最终的输出向量。
好处:它让模型能够同时捕捉到多种类型的关联,比如语法关系、语义关系等,极大地增强了模型的表达能力。
4. 残差连接 (Add) 和层归一化 (Norm)
在每个编码器和解码器的子层(如多头注意力和前馈网络)之后,都会有两个标准操作:
1.残差连接 (Residual Connection):将子层的输入 x 直接加到子层的输出 Sublayer(x) 上,即 x + Sublayer(x)。
2.层归一化 (Layer Normalization):对上一步的结果进行归一化处理。它能使模型训练过程更加稳定和快速,减少对参数初始化的敏感度。
所以每个子层的完整公式是 LayerNorm(x + Sublayer(x))。
5. 前馈神经网络 (Position-wise Feed-Forward Network)
在每个注意力层之后,编码器和解码器都会有一个简单的前馈神经网络。这个网络对每个位置的向量独立地进行一次非线性变换。它由两个线性层和一个ReLU激活函数组成,可以看作是对注意力机制提取出的信息进行进一步的加工和提炼,增加模型的非线性能力。
6. 解码器(深度讲解):
子层一:带掩码的多头自注意力 (Masked Multi-Head Self-Attention)
目的:“回顾已写内容”。在生成下一个词时,解码器需要知道自己前面已经写了什么,以保证句子的连贯性。例如,已经写了 “I am a”,下一个词很可能是 “cat”,而不是重复生成 “I”。
工作方式:它和编码器中的自注意力机制几乎完全一样,都是为了计算序列内部词与词之间的关系。
关键区别:“掩码 (Masking)”
为什么需要掩码? 在训练时,我们已经知道了完整的译文(例如 “I am a cat”)。如果没有掩码,当模型在预测 “am” 这个词时,它会“偷看”到后面的 “a” 和 “cat”,这显然是在作弊,模型学不到真正的预测能力。
如何实现掩码? 掩码是一个“上三角矩阵”,它在计算注意力分数后、进行 Softmax 之前起作用。它会强制将所有未来位置的注意力分数设置为一个极大的负数(例如 -1e9)。
效果:极大的负数经过 Softmax 函数后,其对应的权重会无限接近于0。这样一来,模型在计算任意位置的输出时,其注意力权重只能分布在当前位置和之前的位置上,从而保证了模型无法“看到未来”。
比喻:就像给模型戴上了“眼罩”,让它在写每个字时,只能回头看已经写好的部分,而不能偷看标准答案的后文。
子层二:编码器-解码器注意力 (Encoder-Decoder Attention / Cross-Attention)
目的:查看编码层后的结果。这是连接编码器和解码器的核心桥梁。它让解码器在生成译文的每一步,都能去关注原文中最相关的部分。
工作方式:这也是一个多头注意力层,但它的Q, K, V 来源不同:
**查询向量 (Query, Q):**来自解码器前一个子层(即带掩码的自注意力层)的输出。这个 Q 向量代表了“写作部”当前的需求,可以理解为:“根据我已经写出的内容(比如 ‘I am’),我现在需要什么信息来决定下一个词?”
键向量 (Key, K) 和 值向量 (Value, V):全部来自编码器栈的最终输出(即“理解部”的最终版精读笔记)。这两个向量代表了原文的完整信息,并且在解码的整个过程中是固定不变的。
比喻:解码器(作者)拿着自己的草稿(Q 向量)去问编码器(原文摘要):“我的草稿写到这了,请问你原文中哪部分内容跟我现在要写的最相关?” 编码器通过 K, V 向量回答它,解码器据此获得生成下一个词的关键线索。例如,当解码器生成到与 “猫” 对应的位置时,这一层的注意力会高度集中在编码器输出中代表 “猫” 的那个向量上。
子层三:前馈神经网络 (Position-wise Feed-Forward Network)
目的:“消化整合,深入思考”。
工作方式:这个子层与编码器中的前馈网络完全相同。它接收来自编码器-解码器注意力层的输出向量,并对其进行一次非线性变换。
比喻:在回顾了自己写的内容(Masked Self-Attention)并查阅了原文(Encoder-Decoder Attention)之后,解码器需要一个“独立思考”的过程,将这些信息进行整合、加工和提炼,最终形成一个准备用于预测下一个词的、信息高度浓缩的向量。这个“独立思考”的过程就是由前馈网络完成的。
最终输出层
当数据流经整个解码器栈(例如6层)后,我们会得到一个最终的输出向量。如何用这个向量来决定下一个词呢?
线性层 (Linear Layer):将解码器栈输出的高维向量(例如512维)通过一个线性变换,投影到一个维度非常高(等于词汇表大小,例如30000维)的向量上。这个向量被称为 “Logits”。
Softmax 层:将 Logits 向量中的每一个数值转换成一个概率。数值越大的,转换后的概率也越高。
选择词语:模型会选择概率最高的那个词作为当前时间步的输出。
这个 “输入 -> 解码器栈处理 -> 线性层 -> Softmax -> 选择词语” 的循环会一直进行下去,直到选出的词是特殊的句子结束符 为止。
详细讲解数据在其中的流动方式以及各部分之间的关系。
核心架构概览
从最高层面看,Transformer 的 Encoder-Decoder 架构可以表示为:
输入序列 (X) -> [编码器 (Encoder)] -> 上下文表示 (Z) -> [解码器 (Decoder)] -> 输出序列 (Y)
X: 源语言的词语序列,例如 (“我”, “是”, “一只”, “猫”)。
Z: 由编码器生成的、富含上下文信息的中间表示。它不是一个单一的向量,而是一组代表了输入序列中每个词的向量。这是连接编码器和解码器的桥梁。
Y: 目标语言的词语序列,例如 (“I”, “am”, “a”, “cat”)。
第一部分:编码器 (Encoder) - 理解原文
编码器的唯一目标是“读懂”输入序列 X,并将其转换成高质量的上下文表示 Z。
数据流动符号说明:
->: 表示“流向”或“作为输入”。
+: 表示向量相加(用于位置编码和残差连接)。
f(input): 表示 input 经过函数/层 f 的处理。
编码器的数据流动:
步骤 1:输入预处理
X -> 词嵌入 -> E_X
E_X + 位置编码 -> X_emb
数据首先从词语(X)变成数字向量(E_X),然后与位置信息向量相加,得到既包含语义又包含顺序的最终输入 X_emb。
步骤 2:进入编码器栈 (N层)
编码器由 N 个完全相同的 EncoderLayer 堆叠而成。数据逐层向上流动,每一层都会对信息进行提炼。
Input_L1 = X_emb
Output_L1 = EncoderLayer(Input_L1)
Input_L2 = Output_L1
Output_L2 = EncoderLayer(Input_L2) …
Input_LN = Output_L(N-1)
Z = EncoderLayer(Input_LN) // 最后一层输出就是最终的上下文表示 Z
编码器总结:数据 X 经过嵌入和位置编码后,穿过 N 层 EncoderLayer。在每一层,数据都通过自注意力捕捉全局依赖,再通过前馈网络进行深度加工。最终输出的 Z 是一个包含了输入序列中每个词的、经过深度上下文理解的向量集合。
第二部分:解码器 (Decoder) - 生成译文
解码器的目标是利用编码器提供的上下文 Z,并结合已经生成的部分译文,来预测下一个最可能的词。
解码器的数据流动(以生成第 t 个词为例)
步骤 1:输入预处理
解码器的输入是到目前为止已经生成的输出序列 Y_partial = (y_1, …, y_{t-1})
Y_partial -> 词嵌入 (Embedding) -> E_Y
E_Y + 位置编码 (Positional Encoding) -> Y_emb
步骤 2:进入解码器栈 (N层)
解码器也由 N 个相同的 DecoderLayer 堆叠而成。
Z 是从编码器传来的,在所有层中保持不变
D_Input_L1 = Y_emb
D_Output_L1 = DecoderLayer(D_Input_L1, Z)
D_Input_L2 = D_Output_L1
D_Output_L2 = DecoderLayer(D_Input_L2, Z) …
D_Input_LN = D_Output_L(N-1)
Decoder_final_output = DecoderLayer(D_Input_LN, Z)
单个 DecoderLayer 内部的数据流动:
假设该层的输入为 y_in,编码器的输出为 Z。
A[输入 y_in] --> B(带掩码的多头自注意力);
A --> D{Add & Norm};
B --> D;
B --> D 的意思是:第一个子模块 B(带掩码的多头自注意力)处理完数据后,把它的输出流向 D 模块。
A --> D 的意思是:这个解码器层最原始的输入 A 也有一条“快捷通道”直接流向 D 模块。
整体含义:这两行描述第一个残差连接 (Add & Norm)。在 D 模块内部,它会执行 LayerNorm(A + B的输出)。也就是把模块的输入和输出相加,然后进行归一化。这个结果我们暂时称之为 D_out。
D --> E(编码器-解码器注意力);
Z[编码器输出 Z] --> E;
D --> E 的意思是:上一步得到的归一化结果 D_out,现在作为输入流向了第二个核心模块 E(编码器-解码器注意力)。这个 D_out 将被用来生成该注意力层的 查询向量 (Query, Q)。
Z --> E 的意思是:从编码器传来的、代表原文完整信息的 Z,也作为输入流向了模块 E。这个 Z 将被用来生成该注意力层的 键向量 (Key, K) 和 值向量 (Value, V)。
整体含义:这是解码器最关键的一步。它用自己当前的理解 (Q from D) 去查询原文的完整信息 (K和V from Z),看看原文的哪一部分对生成下一个词最重要。
D --> G{Add & Norm};
E --> G;
E --> G 的意思是:E 模块(编码器-解码器注意力)处理完数据后,把它的输出流向 G 模块。
D --> G 的意思是:模块 E 的输入 D_out 也有一条“快捷通道”直接流向 G 模块。
整体含义:这描述了第二个残差连接 (Add & Norm)。在 G 模块内部,它会执行 LayerNorm(D_out + E的输出)。这个结果我们暂时称之为 G_out。
G --> H(前馈神经网络);
G --> J{Add & Norm};
H --> J;
J --> K[输出 y_out];
G --> H的意思是:上一步的结果 G_out 作为输入,流向第三个子模块 H(前馈神经网络),进行最后的非线性加工。
H --> J 和 G --> J 的意思是:模块 H 的输出和输入 G_out,共同流入最后一个 Add & Norm 模块 J,完成第三次也是最后一次残差连接和归一化。
J --> K 的意思是:J 模块处理后的最终结果,成为了整个解码器层 K 的最终输出 (y_out)。这个 y_out 将被传递给下一个解码器层,或者(如果是最后一层)传递给最终的预测层。
步骤 3:最终预测
Decoder_final_output -> 线性层 (Linear Layer) -> Logits
Logits -> Softmax函数 -> 概率分布 (Probabilities)
解码器栈的最终输出经过一个线性层和 Softmax 函数,转换成词汇表中每个词的概率,概率最高的词就是最终的预测结果 y_t。
通过这种精巧的结构,Transformer 实现了对原文的深刻理解和对译文的精准生成,并且整个过程高度可并行化,效率极高。
最后
感谢你们的阅读和喜欢,作为一位在一线互联网行业奋斗多年的老兵,我深知在这个瞬息万变的技术领域中,持续学习和进步的重要性。
为了帮助更多热爱技术、渴望成长的朋友,我特别整理了一份涵盖大模型领域的宝贵资料集。
这些资料不仅是我多年积累的心血结晶,也是我在行业一线实战经验的总结。
这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。如果你愿意花时间沉下心来学习,相信它们一定能为你提供实质性的帮助。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
AI大模型系统学习路线
在面对AI大模型开发领域的复杂与深入,精准学习显得尤为重要。一份系统的技术路线图,不仅能够帮助开发者清晰地了解从入门到精通所需掌握的知识点,还能提供一条高效、有序的学习路径。
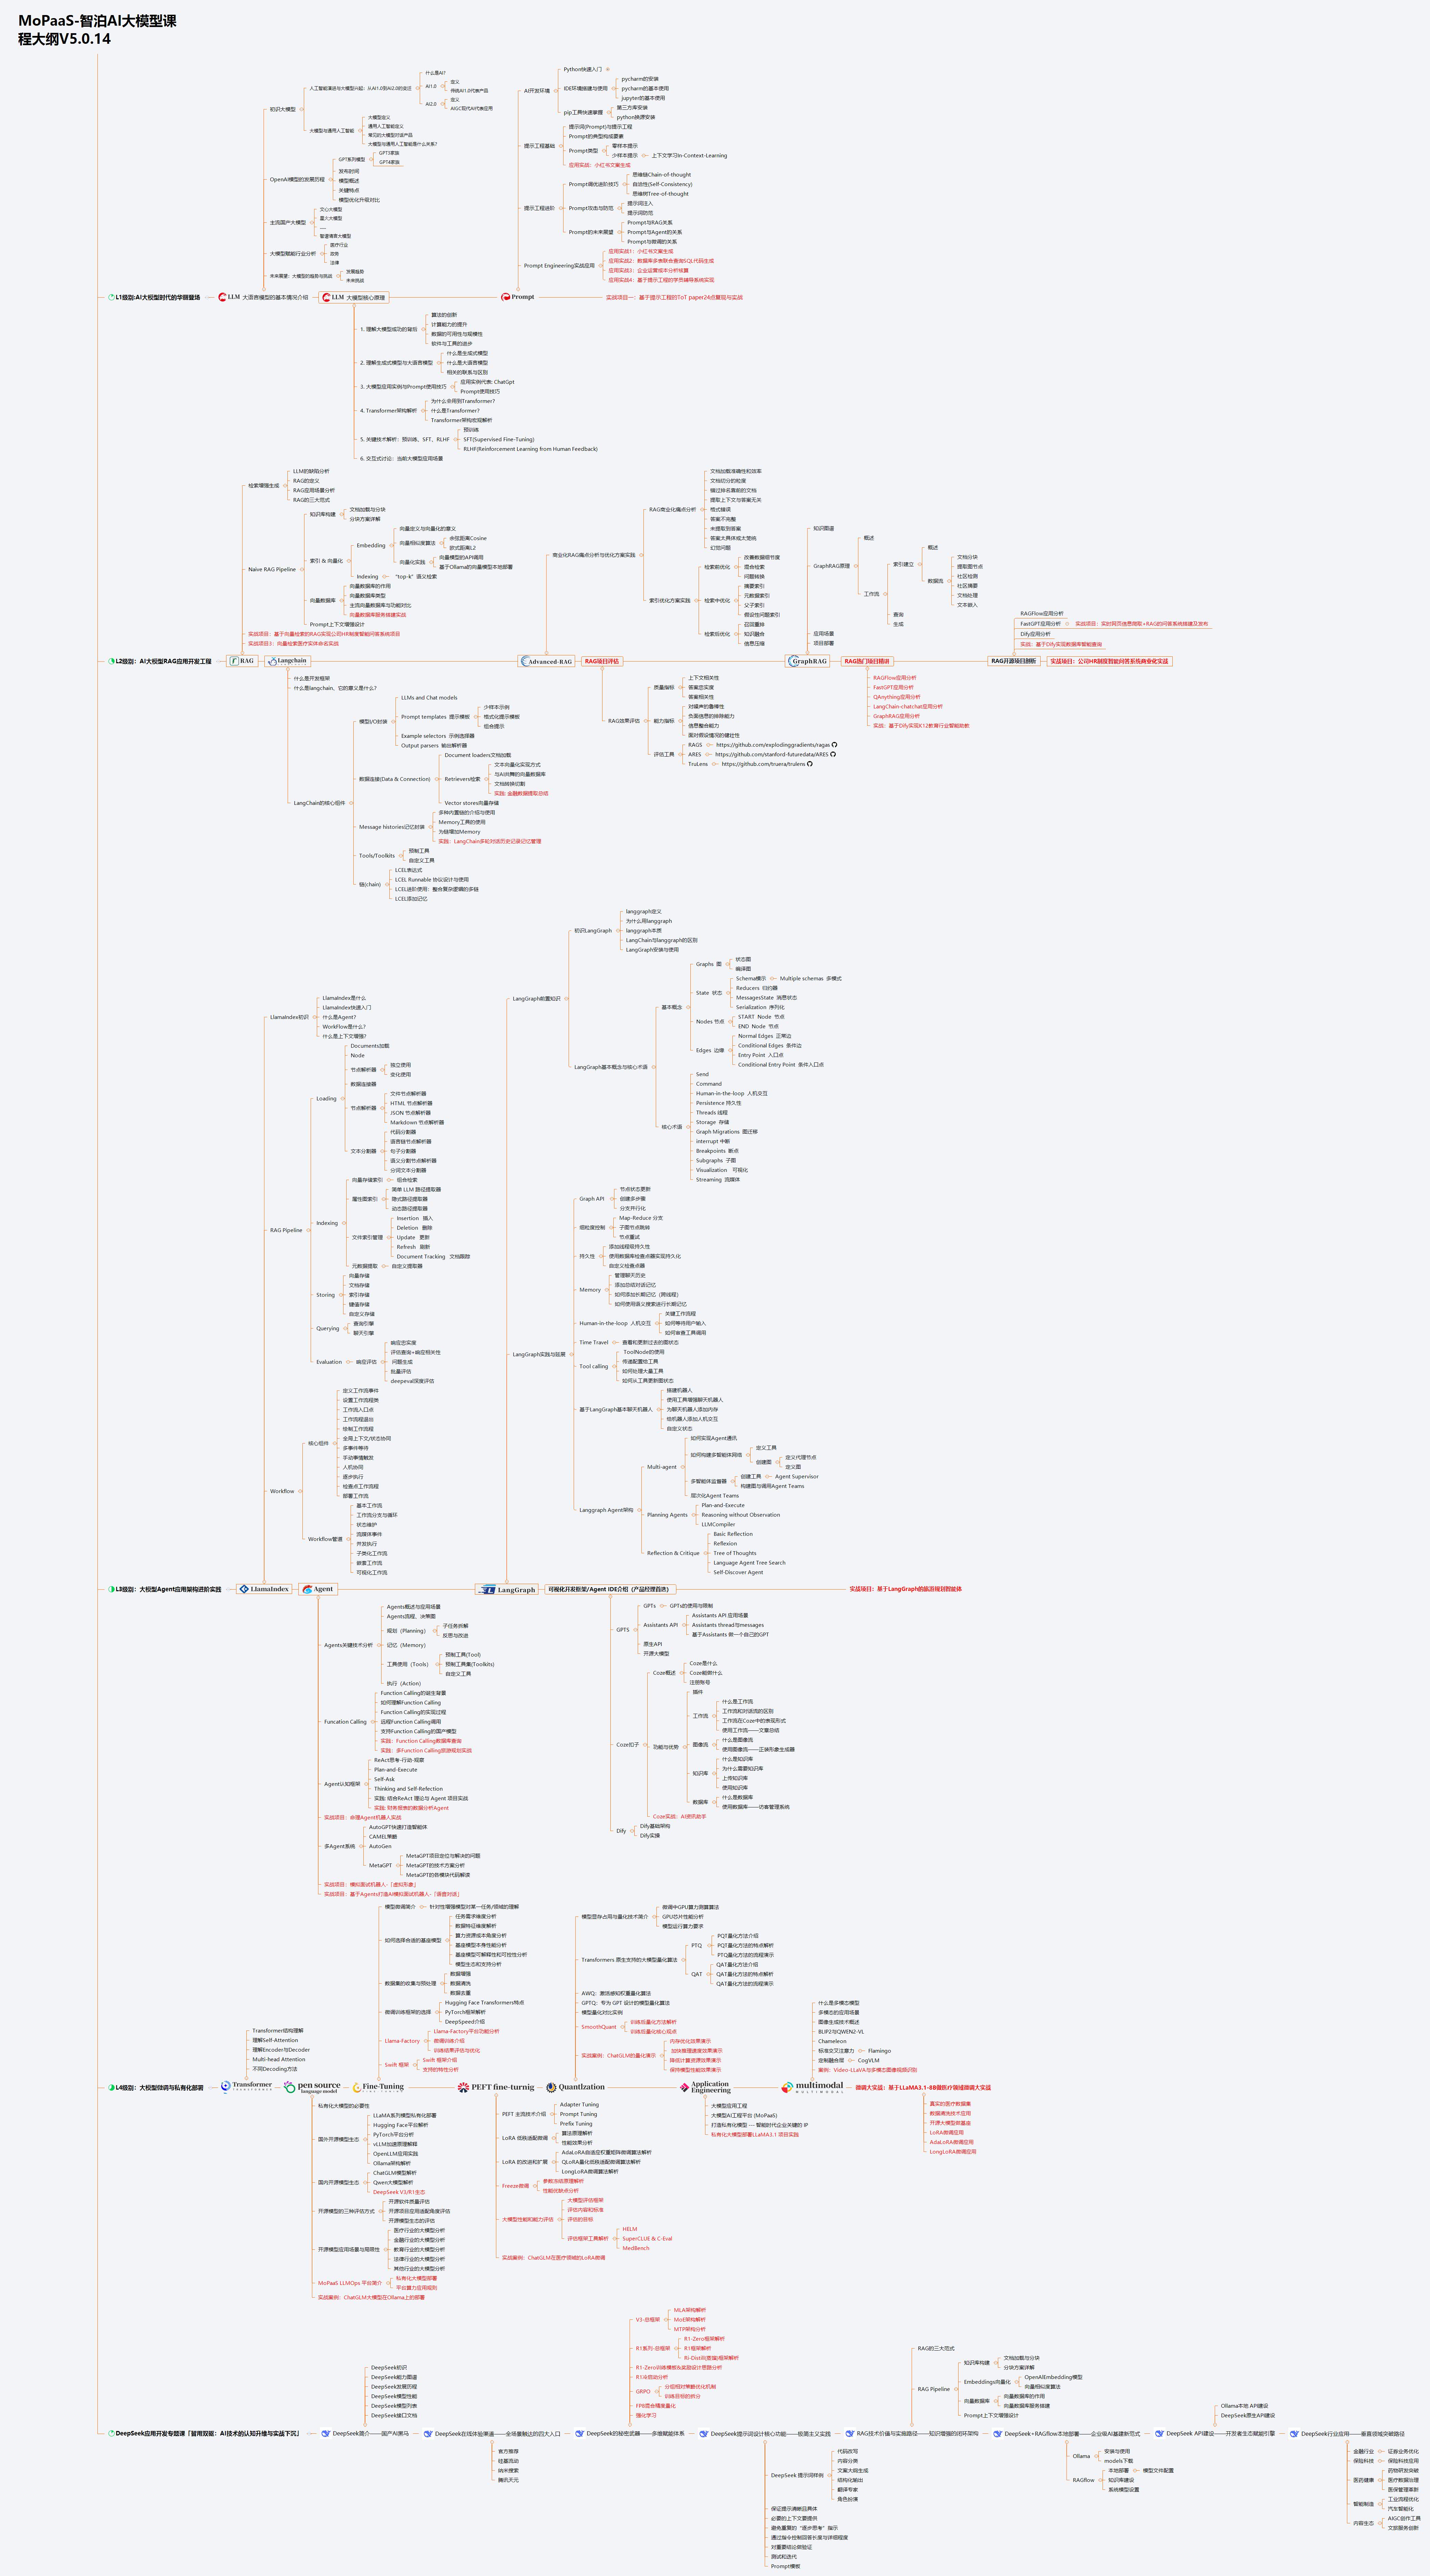
但知道是一回事,做又是另一回事,初学者最常遇到的问题主要是理论知识缺乏、资源和工具的限制、模型理解和调试的复杂性,在这基础上,找到高质量的学习资源,不浪费时间、不走弯路,又是重中之重。
AI大模型入门到实战的视频教程+项目包
看视频学习是一种高效、直观、灵活且富有吸引力的学习方式,可以更直观地展示过程,能有效提升学习兴趣和理解力,是现在获取知识的重要途径
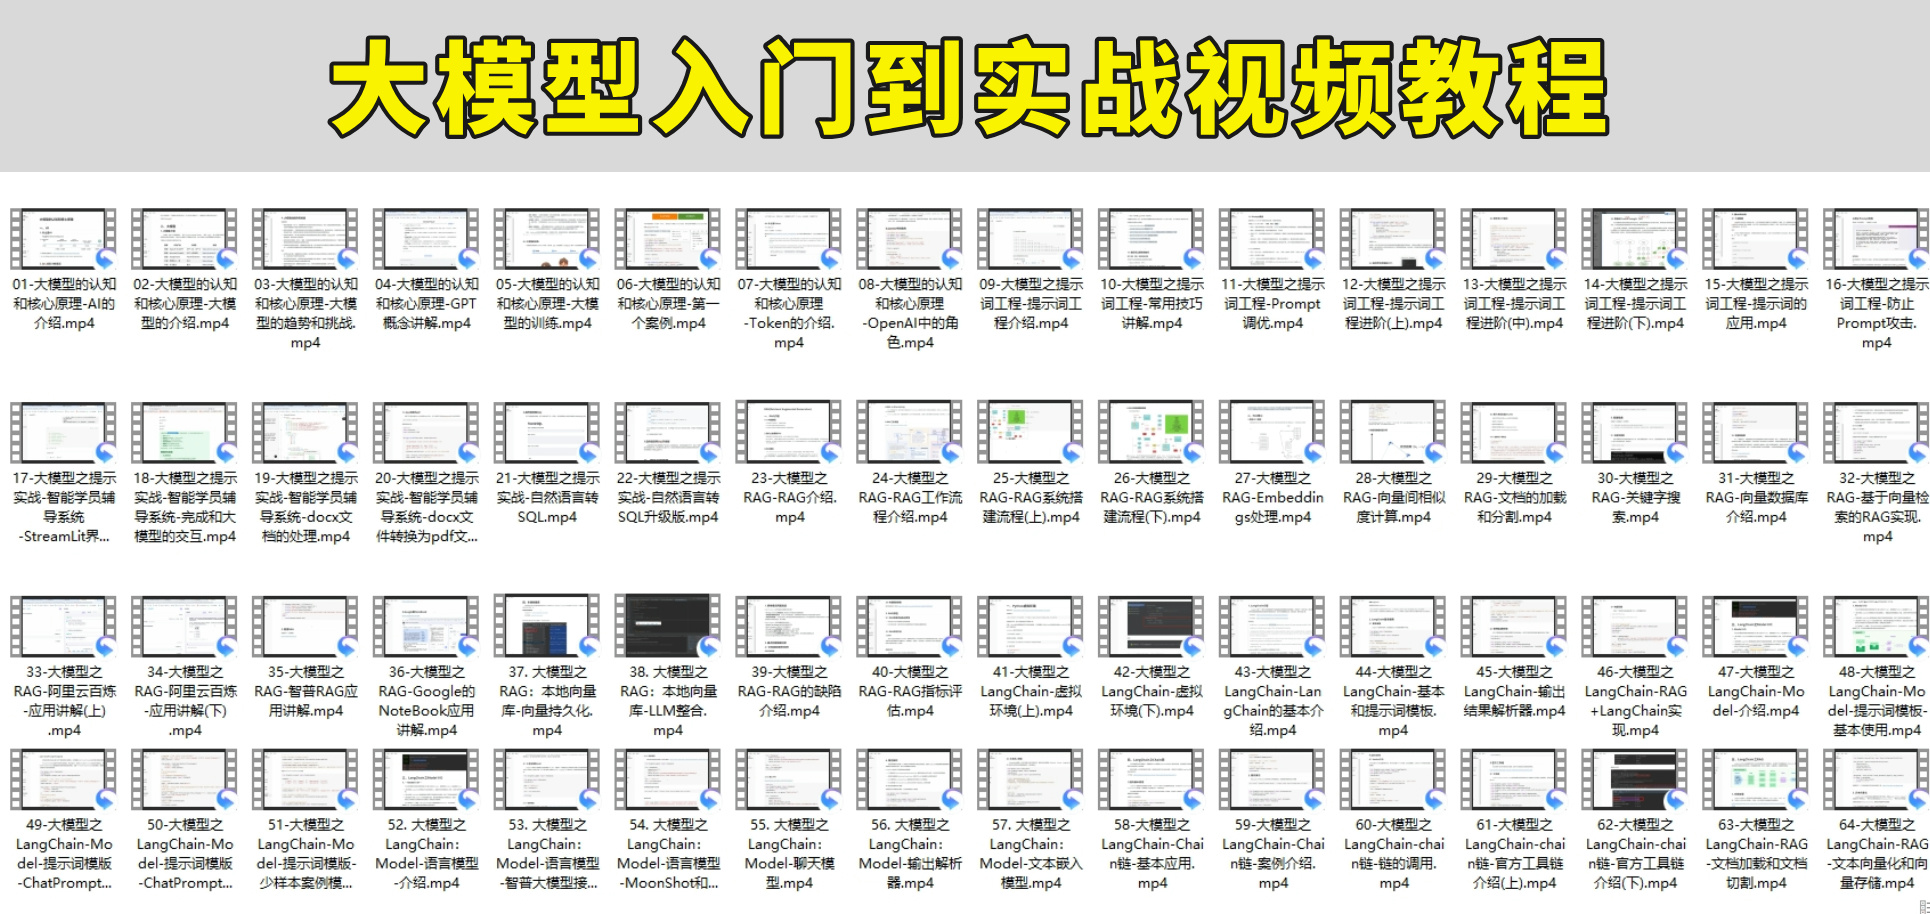
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
海量AI大模型必读的经典书籍(PDF)
阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。
600+AI大模型报告(实时更新)
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
AI大模型面试真题+答案解析
我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 9424


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


