大模型学习基础知识,(非常详细)零基础入门到精通,收藏这一篇就够了!!

LLM大模型基础知识【一】 大语言模型(LLM):是指在自然语言处理(Natural Language Processing,NLP)领域中的一类大模型,通常用于处理文本数据和理解自然语言。这类大模型的主要特点是它们在大规模语料库上进行了训练,以学习自然语言的各种语法、语义和语境规则。例如:GPT系列(OpenAI)、Bard(Google)、文心一言(百度)。视觉大模型:是指在计算机视觉(Computer Vision,CV)领域中使用的大模型,通常用于图像处理和分析。 阅读详情
AI摘要

本文详细介绍了大模型的定义、基本原理与核心特点,包括Transformer架构、预训练+微调范式、缩放定律及分布式训练技术。同时探讨了大模型的数据驱动通用性、涌现能力及其高算力依赖等问题,并对比了传统模型差异。文章还梳理了大模型的学习路径和使用流程,提供了一套完整的AI大模型学习资源。

1、大模型的定义

大模型(Large Model)是一类基于深度学习的机器学习模型,其核心特征在于超大规模的参数数量、海量的训练数据支撑以及极高的计算资源消耗。通过对复杂数据结构的深度学习,这类模型能够捕捉数据中抽象的内在规律,进而灵活应对翻译、推理、创作等多种跨领域复杂任务,是当前人工智能技术的重要载体。

2、大模型的基本原理与特点

作为人工智能领域的主流技术形态,大模型的核心逻辑是通过超大规模参数在海量数据上的训练,逐步逼近通用智能。以下从技术原理和核心特性两方面展开解析:

2.1、基本原理
2.1.1 架构基础:Transformer模型

Transformer是大模型的主流架构,其核心优势源于两大设计:

  • 自注意力机制(Self-Attention):
    让模型能动态聚焦输入序列中关联紧密的部分,解决了传统循环神经网络(RNN)难以处理长文本依赖的问题。例如在句子“莉莉给妈妈买了围巾,她很喜欢”中,模型能自动识别“她”指代“妈妈”。
  • 并行计算能力:
    不同于RNN按顺序处理输入的模式,Transformer可同时对所有输入片段进行计算,大幅提升了训练和推理效率,为模型规模的扩大提供了基础。
2.1.2 训练范式:预训练+微调

这是大模型实现“通用能力+任务适配”的核心路径:

  • 预训练(Pre-training):
    在无标注的海量数据(如全网文本、书籍、代码库等)上通过自监督学习训练模型。常见任务包括:
    • 预测下一个词(如GPT系列的“语言建模”任务);
    • 补全被随机遮盖的词(如BERT的“掩码语言模型”任务)。
      此阶段让模型掌握语言规律、常识知识等通用能力。
  • 微调(Fine-tuning):
    在特定任务(如法律文书分析、医学影像解读)的小规模标注数据上调整部分参数,使模型适配具体场景。例如用医疗问答数据微调的模型,能更精准地回答患者提问。
2.1.3 缩放定律(Scaling Laws)

模型性能与参数量、训练数据量、计算资源呈幂律关系:

  • 当数据充足时,参数量翻倍可按固定比例提升性能(如数学推理准确率提高15%);
  • 若数据不足,盲目增加参数会导致模型“学不透”,反而出现过拟合(如仅用10万条数据训练千亿参数模型,会记住数据而非学习规律)。
2.1.4 分布式训练技术

由于参数和数据规模过大,单设备无法承载训练,需依赖分布式技术:

  • 数据并行:将训练数据拆分到多个GPU,同时计算并汇总结果;
  • 模型并行:将模型参数拆分到不同设备(如谷歌TPU集群训练PaLM模型);
  • 混合精度训练:结合FP16(半精度)和FP32(单精度)计算,在减少显存占用的同时保证精度,加速训练过程。
  • 补充:近年还出现“混合并行”技术(如Megatron-LM),结合数据并行和模型并行的优势,进一步提升超大模型的训练效率。
2.2、核心特点
2.2.1 参数规模的突破性增长

“规模即能力”是大模型的显著特征:

  • 参数量从早期深度学习模型的百万级(如ResNet约600万参数)跃升至万亿级(如GPT-4预估1.8万亿参数);
  • 当参数超过百亿级后,模型会“涌现”出新能力,例如零样本完成任务(无需示例直接翻译小众语言)、复杂逻辑推理(解数学应用题)等。
  • 对比案例:GPT-2(15亿参数)仅能生成简单文本,而GPT-3(1750亿参数)可创作小说、编写代码,能力差距显著。
2.2.2 数据驱动的通用性

大模型无需针对不同任务重新设计架构,可通过数据学习跨场景能力:

  • 多模态融合:能同时处理文本、图像、音频等数据(如GPT-4V可分析图片内容并生成描述文本,PaLM-E能结合视觉和语言指令控制机器人);
  • 跨任务适配:同一模型可无缝切换翻译、摘要、问答等任务,例如用同一基座模型既能将中文合同翻译成英文,也能提取合同中的关键条款。
2.2.3 涌现能力(Emergent Abilities)

当模型规模突破临界值(通常1000亿参数以上),会突然具备未被专门训练的能力:

  • 零样本学习:无需示例即可执行新任务,如“用日语总结这段英文新闻”;
  • 思维链推理:分步骤解决问题,例如“先算小明有3个苹果,妈妈又给5个,总共8个,再分给2个朋友,每人4个”;
  • 工具使用:近年新涌现的能力,模型可调用计算器、搜索引擎、代码库等工具完成复杂任务(如“查2023年全球GDP数据并生成图表”)。
2.2.4 高算力依赖与成本

大模型的训练和运行对资源需求极高:

  • 训练成本:GPT-3训练消耗约1287兆瓦时电力(相当于120个美国家庭一年的用电量),单次训练成本超千万美元;同时,训练过程会产生大量碳排放(如GPT-3约产生550吨二氧化碳,相当于一辆汽车行驶120万公里)。
  • 推理成本:GPT-4生成1000个token(约750个汉字)的API调用成本约0.06美元,大规模商用需依赖GPU集群支撑实时响应。
2.2.5 模型即服务(MaaS)的应用模式

大模型多以服务形式落地,降低了使用门槛:

  • 云端API:企业或个人通过接口调用能力(如OpenAI API、文心一言接口),无需自建模型;
  • 垂直领域微调:基于通用基座模型(如LLaMA、通义千问),用行业数据微调得到私有模型(如法律领域的“北大法宝”大模型);
  • 轻量化部署:通过量化(如INT4/INT8压缩)、剪枝等技术,将模型部署在手机、边缘设备上(如手机端的语音助手大模型)。
2.3、与传统模型的对比
维度传统模型(如ResNet、LSTM)大模型(如GPT-4、PaLM)
参数量级百万~十亿级百亿~万亿级
训练数据以标注数据为主(如ImageNet图像标签)以无标注互联网级数据为主(如全网文本)
泛化能力单一任务专用(如ResNet仅用于图像分类)跨任务、跨领域通用(如文本+图像+推理)
计算需求单卡或小集群即可训练千卡级GPU/TPU集群才能支撑训练
应用模式端到端部署(如手机摄像头的人脸识别)云端API+轻量化边缘部署结合

3、大模型的核心优势

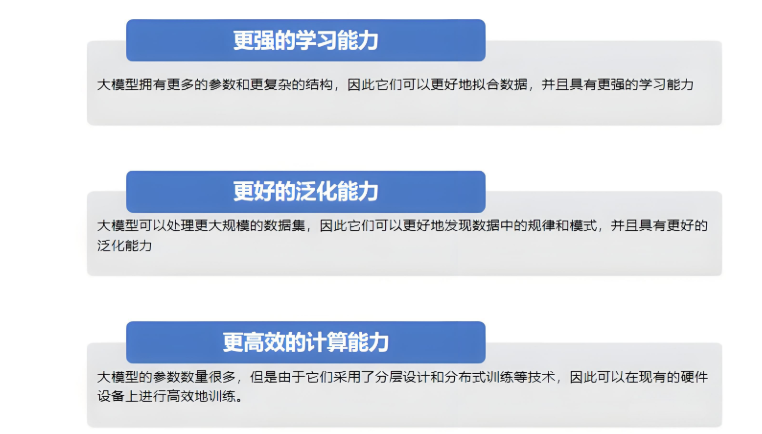
大模型之所以成为人工智能的核心方向,源于其独特价值:

  • 高效处理复杂任务:能同时整合多源信息解决问题(如自动生成包含数据、图表、分析结论的市场报告);
  • 降低技术门槛:中小企业无需自建AI团队,通过API即可快速接入先进能力(如电商用大模型自动生成商品文案);
  • 持续进化能力:通过在线学习(如实时吸收新数据)不断优化,适应动态需求(如新闻领域大模型实时学习热点事件);
  • 推动跨学科创新:在科研、医疗等领域辅助突破(如用大模型分析基因数据,加速疾病机理研究)。
在这里插入图片描述

4、大模型的使用与训练流程

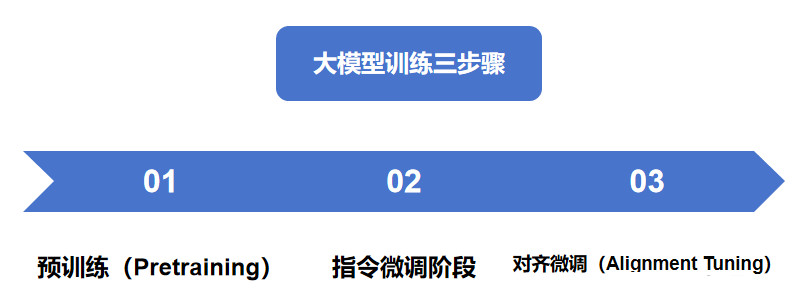
主流大模型的训练流程参考OpenAI的InstructGPT框架,分为三个核心阶段,近年也涌现出多种优化技术:
在这里插入图片描述

4.1、预训练(Pretraining)

这是模型“打基础”的阶段,核心是数据准备与训练:

  • 数据来源:涵盖互联网文本、书籍、论文、代码等,需经过严格清洗(去重、过滤违法/低俗内容、脱敏隐私信息)。例如GPT-4的训练数据包含多语言文本、图像描述、科学文献等。
  • 数据处理:用Tokenizer工具将文本拆分为token(如汉字、词片段),并进行格式标准化(如统一标点、去除乱码)。近年还出现数据去重技术(如MinHash算法),避免重复数据导致模型“偏见”。
  • 训练目标:通过自监督任务让模型学习语言规律,例如预测下一个词、补全句子等。
4.2、指令微调(Instruction Tuning)

通过人类指令激发模型能力,让模型“听懂需求”:

  • 核心逻辑:将任务转化为自然语言指令(如“总结这段文本”“翻译这句话到法语”),用这些指令数据微调模型,使其理解并遵循人类意图。
  • 高效微调技术:由于全量微调成本过高,Parameter-Efficient Fine-Tuning(PEFT)技术成为主流:
    • LoRA(Low-Rank Adaptation):将模型权重矩阵分解为两个低秩矩阵,仅微调这两个矩阵的参数(约为原模型的1%),即可达到与全量微调接近的效果;
    • IA³(Infused Adapter):通过调整模型内部激活值的缩放因子实现微调,参数更少,适配小样本场景;
    • Prefix Tuning:在输入前添加可训练的“前缀”向量,引导模型生成符合任务的输出,适合生成类任务。
4.3、对齐微调(Alignment Tuning)

让模型的输出符合人类价值观和偏好,核心技术是“对齐”:

  • 传统方法:RLHF(基于人类反馈的强化学习):

    1. 用高质量人工标注数据微调预训练模型(SFT阶段);
    2. 让模型对同一问题生成多个回答,由人类评估排序,训练“奖励模型”;
    3. 用PPO(邻近策略优化)算法,基于奖励模型反馈微调SFT模型。
      但PPO存在效率低、稳定性差的问题(每轮更新需重新采样数据)。
  • 新兴替代技术:

    • DPO(直接偏好优化):跳过奖励模型,直接用人类偏好数据训练策略,将对齐问题转化为单阶段训练,效率更高且性能更优;
    • RAFT(Reward rAnked FineTuning):用排序后的偏好数据直接微调,无需强化学习,适合小数据场景;
    • RLAIF(基于AI反馈的强化学习):用AI模型替代人类评估,降低标注成本,同时保持对齐效果。
4.4、Prompt提示词技术

无需微调,通过输入提示词引导模型输出,是最便捷的使用方式:

  • 核心逻辑:用自然语言描述任务需求(如“写一封道歉信,语气诚恳”“分析这段代码的错误”),激发模型的内在能力。
  • 典型技巧:
    • 角色扮演(“假设你是历史老师,讲解唐朝的科举制度”);
    • 思维链提示(“解题步骤:1. 先算……2. 再推导……”);
    • 示例引导(给出1-2个示例,让模型模仿格式输出)。

通过上述流程,大模型从“学知识”到“懂需求”再到“合心意”,逐步实现从技术到实用价值的转化。

5、 AI大模型从0到精通全套学习大礼包

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

只要你是真心想学AI大模型,我这份资料就可以无偿共享给你学习。大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!

如果你也想通过学大模型技术去帮助就业和转行,可以扫描下方链接👇👇
大模型重磅福利:入门进阶全套104G学习资源包免费分享!
在这里插入图片描述

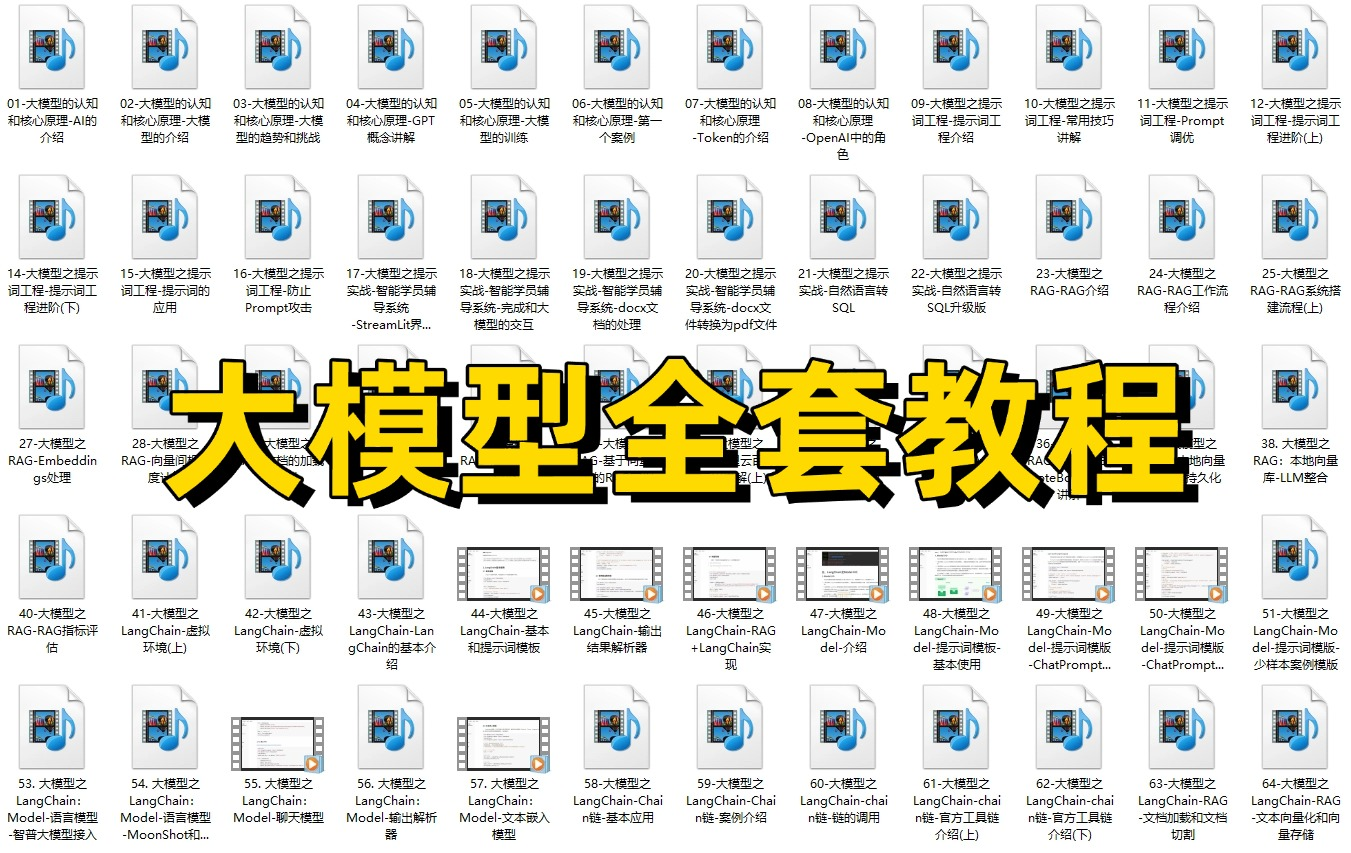
01.从入门到精通的全套视频教程

包含提示词工程、RAG、Agent等技术点
在这里插入图片描述
​

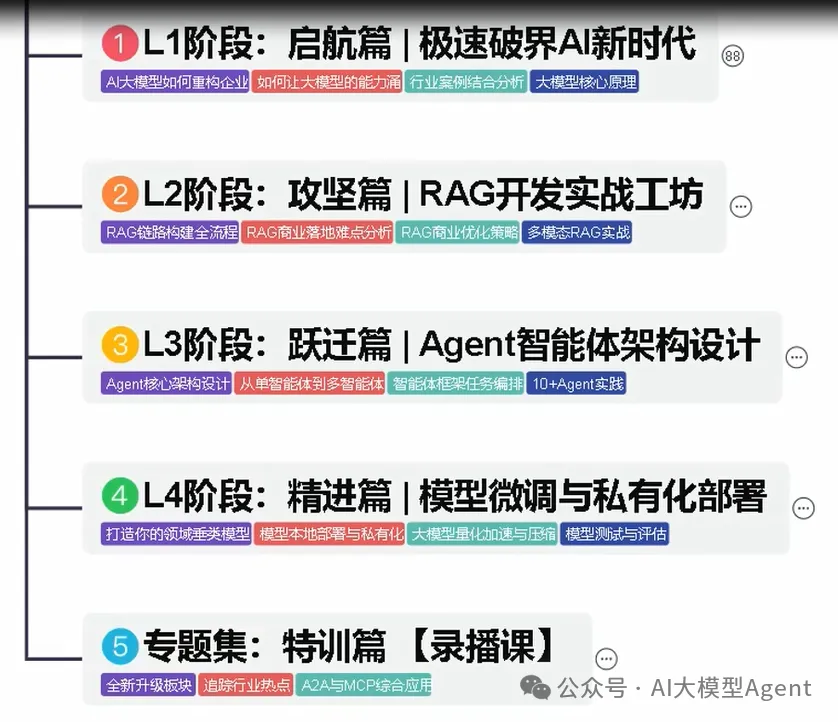
02.AI大模型学习路线图(还有视频解说)

全过程AI大模型学习路线

在这里插入图片描述
​在这里插入图片描述

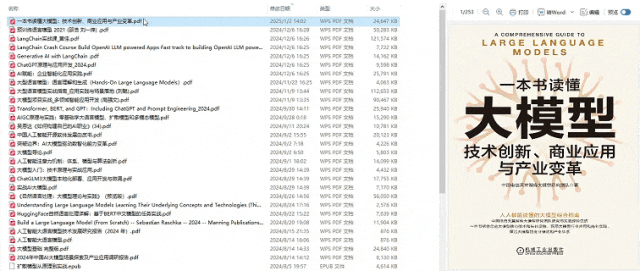
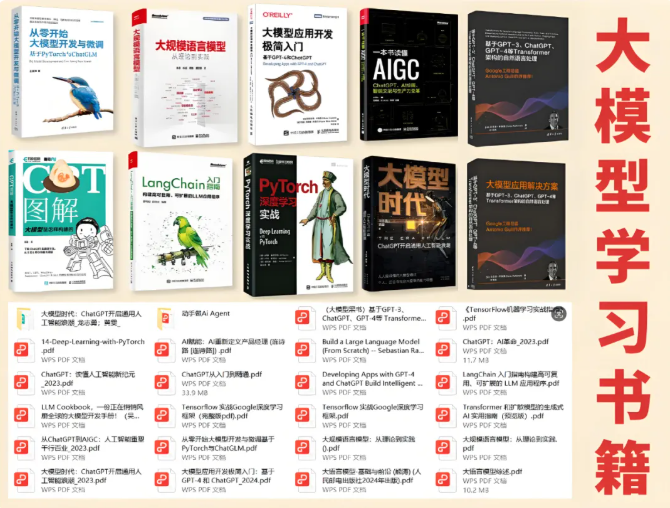
03.学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
在这里插入图片描述
在这里插入图片描述

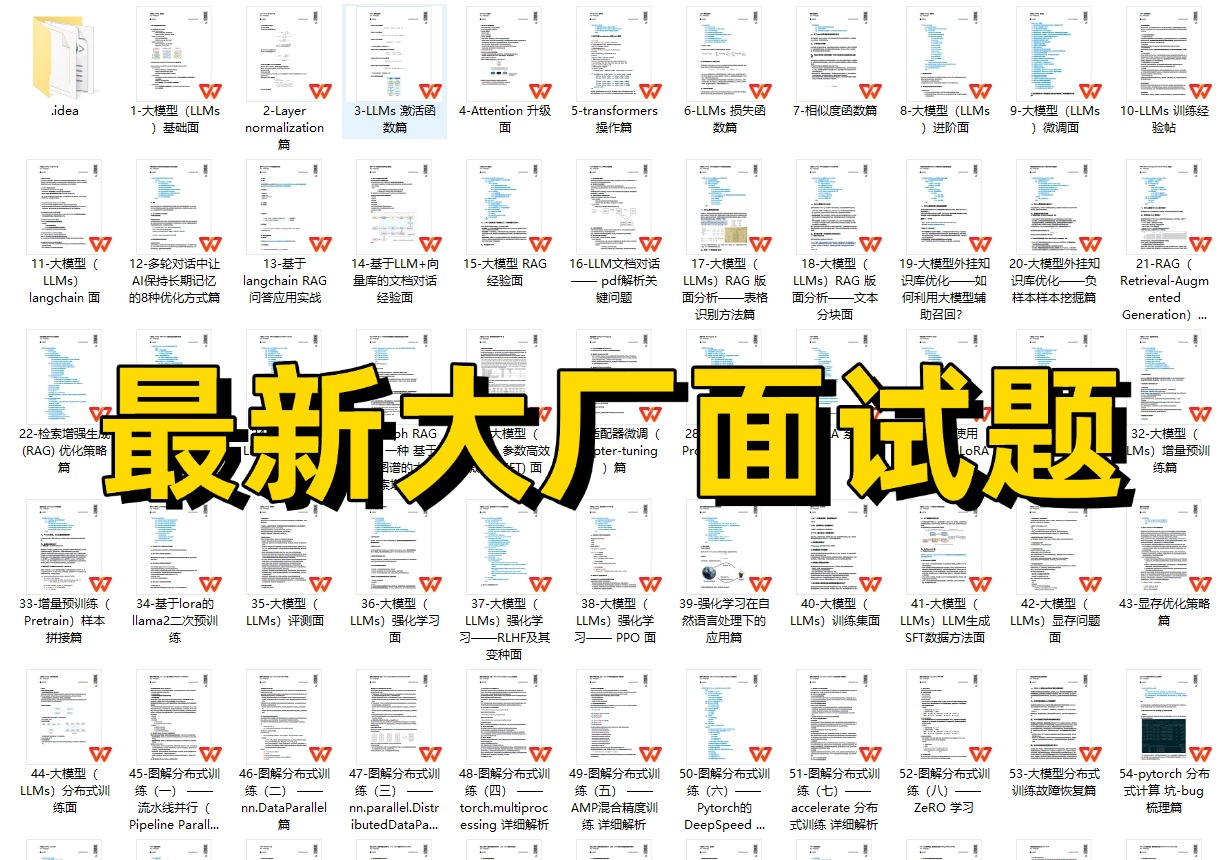
04.大模型面试题目详解

在这里插入图片描述

在这里插入图片描述

05.这些资料真的有用吗?

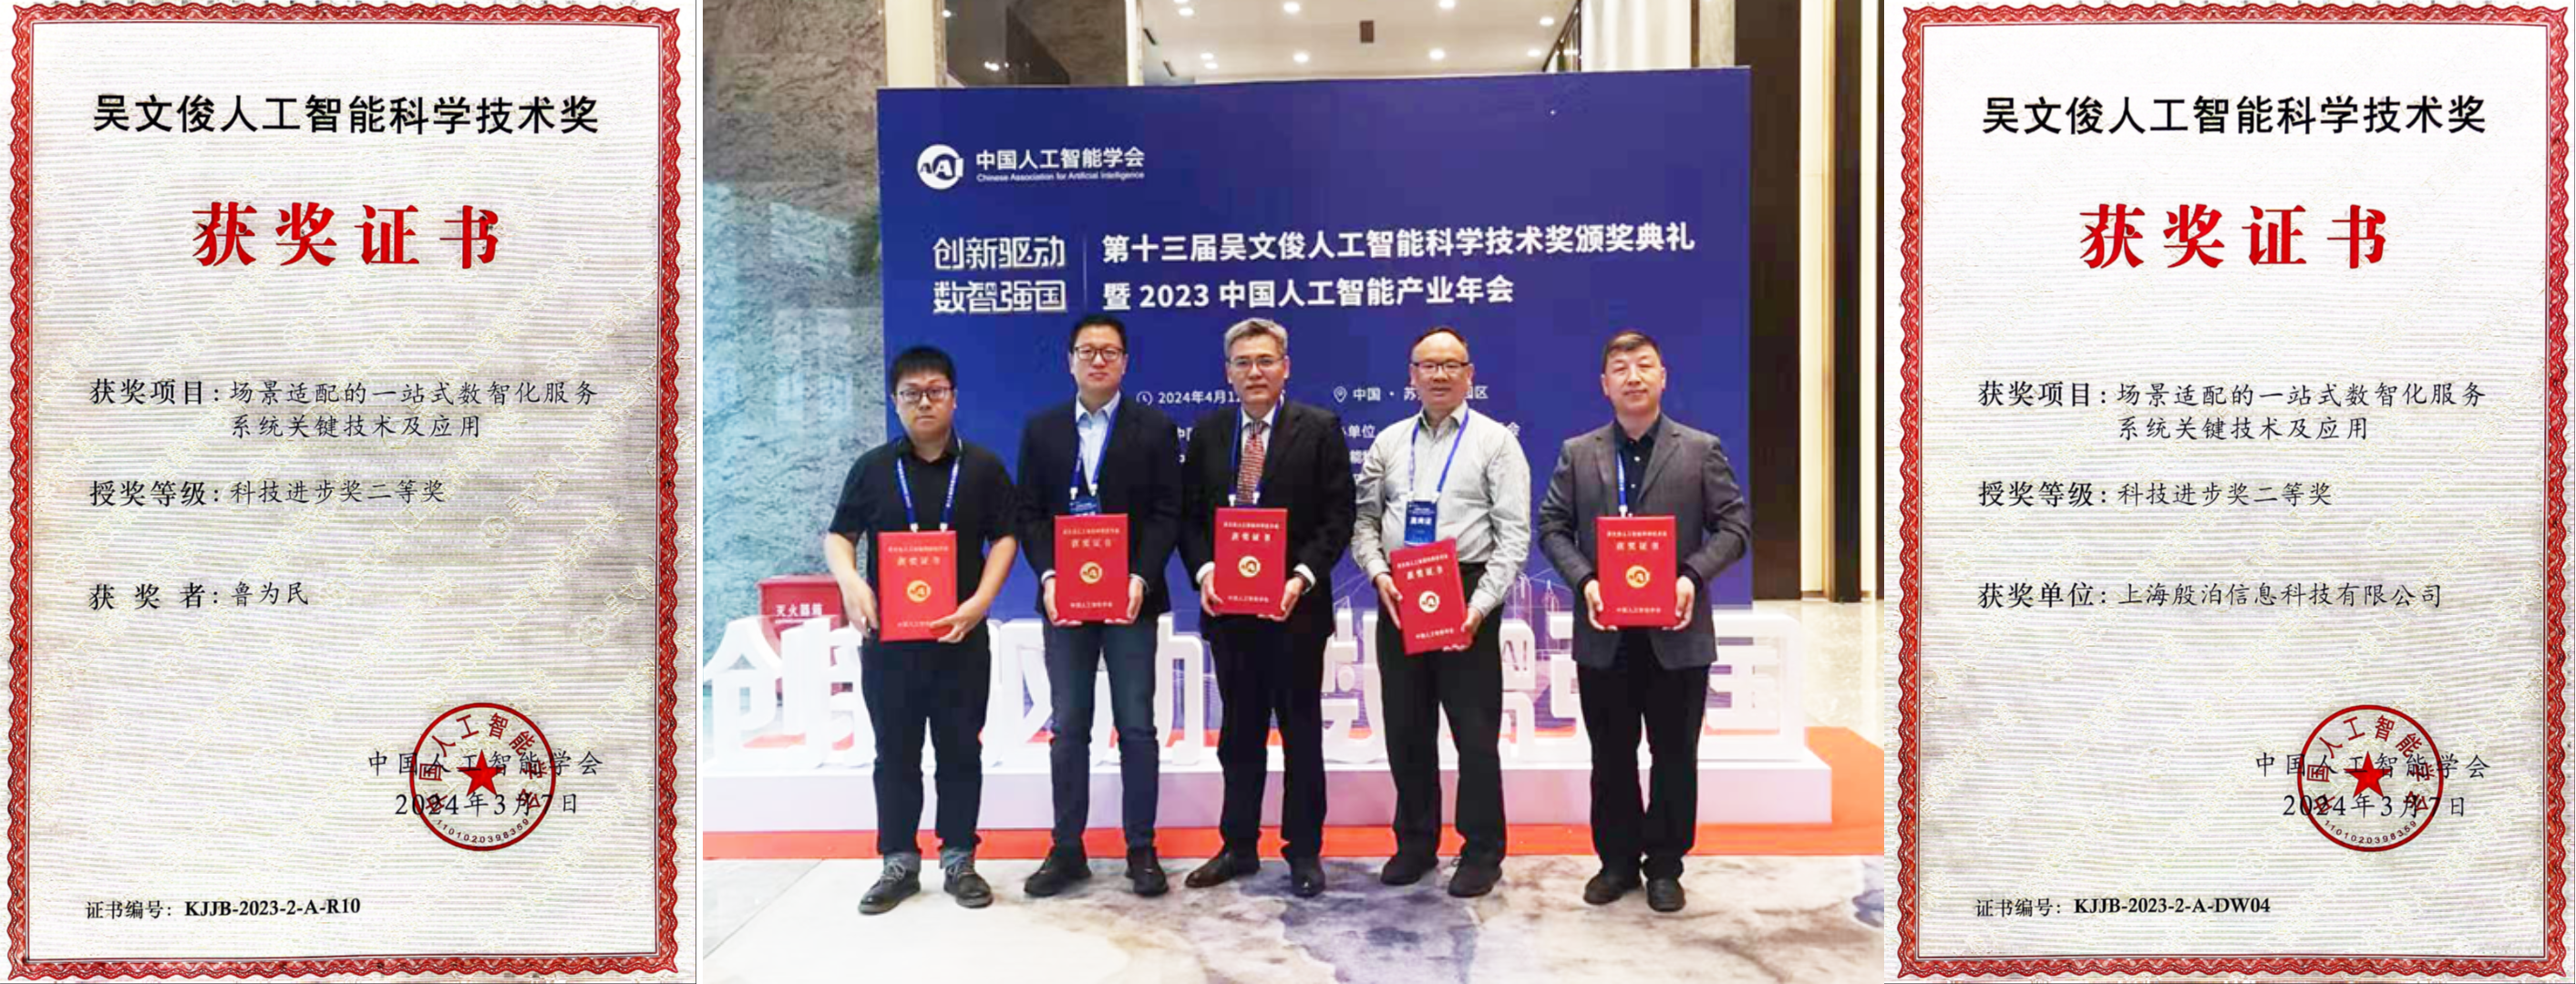
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。

所有的视频由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
在这里插入图片描述
在这里插入图片描述

智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念‌,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势‌,构建起"前沿课程+智能实训+精准就业"的高效培养体系。

课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

在这里插入图片描述
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!

应届毕业生‌:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能 ‌突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
在这里插入图片描述

删除。

大模型学习篇(一):初识大模型 初识大模型,了解什么是语言模型,以及大模型和小模型的区别。 阅读详情

相关推荐

大模型基础01:理论与技术的演进概述

大语言模型(英文:Large Language Model,缩写LLM) 是指参数规模极大的神经网络语言模型,大模型的基础理论主要包括深度学习理论、表示学习理论、迁移学习理论、模式识别理论、计算学习理论、分布式计算理论和统计语言模型理论,大模型集成了这些计算机科学核心理论的精华。通过大数据预训练加小数据微调,大大降低了使用门槛,将人工智能技术带入了一个新的阶段。

AaronZZH 的博客 4489

大模型入门知识点(非常详细)零基础入门到精通,收藏这一篇就够了

企业级大模型商业化产品通过构建包含前端界面、后端服务、模型服务等组件的应用架构,实现了用户与大模型的交互。用户在前端输入Prompt,前端发送请求至后端,后端调用模型服务与大模型进行Tokenization、模型推理、Decoding等操作,最后将结果返回给前端展示。整个过程涉及HTTP/HTTPS、RPC、消息队列等多种通信方式,以及前后端数据交换的JSON格式。具体的代码实现会根据选用的技术栈(如编程语言、框架、库等)有所不同。

leah126的博客 6271

GPT Researcher 的win docker安装攻略

github网址是:https://github.com/assafelovic/gpt-researcher/blob/master/README-zh_CN.md。使用 Docker 运行 AI-Researcher 项目的。因为docker安装方法不够清晰,因此写一个使用方法。打开设置——docker engine ,增加代码。如有其他问题,可提供错误截图或日志进一步排查!

weixin_43818488的博客 1124

初识大模型:大模型的基础知识与入门指南

对齐” 在这个上下文中指的是调整大型语言模型的输出,以使其符合人类的预期和特定需求。对齐是为了让大模型更加实用和安全。更好用符合用户预期当用户向大型语言模型提出问题或任务时,他们通常期望模型的回答或生成的文本与问题或任务的上下文相关。对齐的目标是确保模型的输出与用户的预期一致。例如,当用户询问中国的首都时,预期的答案是"北京",而不是其他无关的信息(模型可能会输出“美国的首都是哪里?德国的首都是哪里?…”,也可能输出“这是一个大家都知道的问题”。

2401_85373898的博客 2862

WinCC与PLC在西门子逻辑赛项中的通信配置避坑指南

本文针对西门子逻辑赛项中WinCC与PLC通信配置的常见问题,提供了一套实战避坑指南。重点解析了WinCC、PLC与EET仿真平台的三角通信架构,强调了IP地址规划、防火墙设置等关键环节的注意事项,并给出了系统化的故障诊断流程与排查技巧,帮助选手和技术人员快速定位并解决通信故障,确保监控系统稳定运行。

weixin_29165725的博客 107

PaddleOCR在医疗票据识别中的实战:从部署到业务字段提取

本文详细介绍了PaddleOCR在医疗票据识别中的实战应用,重点阐述了其离线部署方案与PP-OCRv3模型选型优势。针对医疗票据敏感数据不出本地的合规要求,文章提供了从环境搭建、模型配置到核心字段提取策略的完整流程,并分享了性能优化与系统集成的实践经验,有效解决了医疗票据自动化录入的难题。

weixin_29271053的博客 236

学习人工智能需要哪些基础知识?(非常详细),零基础入门到精通,看这一篇就够了

学习人工智能需要哪些基础知识?(非常详细),零基础入门到精通,看这一篇就够了

Python单行客的博客 1万+

从安装Eclipse 开始 开发第一个 CDS View

一篇超级简单快速的 创建CDS VIEW 入门步骤介绍文章。

IT小职员 4249

ai大模型应用开发:零基础入门到精通ai大模型应用开发,(非常详细)收藏我这一篇就够了!

随着大模型技术的飞速发展,我们正站在一个全新的技术前沿,探索着如何将这些强大的工具应用于实际问题的解决。如果你对AI大模型应用开发充满热情,那么你可以读一下这篇文章——一个系统全面的入门指南,专为渴望深入AI世界的你设计。先来总结下整个路径图:至今我们还没发现有其它博主如此系统和全面地写一套AI入门教程。

2401_85375298的博客 7624

鸿蒙【ArkTS】使用TS装饰器封装网络请求HTTP

在HarmonyOS应用开发中,通过HTTP访问网络,可以使用官方提供的@ohos.net.http模块。但是官方提供的直接使用不太好使用,需要封装下才好。这里采用TS的装饰器实现AOP效果 完成前后端接口风格的统一

weixin_60376559的博客 5610

CorelDraw插件开发-Cdr插件-CPG插件-GMS插件-安装位置

文章目录1.gms格式插件2.cpg格式插件3.作者答疑   CorelDraw软件是一款使用非常广泛的矢量图形软件,系统本身提供了非常便利的二次开发环境,制作插件的格式有两种,一种是gms格式的脚本插件,另外一种是cpg格式dll插件。 1.gms格式插件   gms格式插件是使用微软的 VBA 技术,编写和调试都比较方便,从9的版本开始支持。   安装:把gms文件复制到程序所安装的目录 gms 下,一般在C:\Program Files\Corel\CorelDRAW Graphics Suite 1

插件开发 2751

大模型入门教程:从零基础到精通,非常详细收藏我这一篇就够了

掌握大模型技术,可应对复杂的数据分析任务,提升研究与工作的解决能力。学习大模型具备处理复杂性、具有泛化能力与灵活性,对求职者有显著提升。本教程从基础概念出发,包括大模型的优势与应用、基础知识学习建议、入门基础教程,以及分布式训练、有监督微调与AGI学习包等内容。通过推荐的学习资源与实战项目资料,引导读者深入学习并实践大模型技术,开启AI大模型之旅。

m0_63171455的博客 3545

rk3568 点亮双LVDS 屏

承接文章《rk3568点亮LCD(lvds)》中仅仅只能使用亮单LVDS;经过厂商的努力,陆续发布新补丁。目前支持双lvds显示,缺憾是需要自己额外移植相关补丁。受限于通信频率和VOP编码能力,支持最大分辨仍然是1920x1080、60fps。

weixin_35723192的博客 3007

【大模型】初识大模型(非常详细)零基础入门到精通,收藏这一篇就够了

【大模型】初识大模型(非常详细)零基础入门到精通,收藏这一篇就够了

大模型教程的博客 6286

使用FSL对DTI数据进行预处理

在fsl官网我们可以看到是同时使用了AP和PA图像处理,采用的是最小二乘法将2个图像合并为1个图像。–inindex此处需要处理的是PA图像,在acq_param.txt中我们是把这个放在第一行的,此处为1,如果处理的是AP图像,则此处为2。为了校正磁场引起的畸变,对DTI的B0像分别采集了A>P和P>A的反向编码的两种B0像。即如果AP和PA只有1个B0像时,那么这里就是两行,如果各有3个B0像则这里应该是6行。假设转换后的图像为sub01_AP.nii.gz和sub01_PA.nii.gz。

weixin_52073820的博客 4839

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

大模型学习路径,(非常详细)从零基础入门到精通,收藏这篇就够了

在掌握机器学习之前,理解支撑这些算法的基本数学概念非常重要。:这是理解许多算法(特别是深度学习算法)的关键。主要概念包括向量、矩阵、行列式、特征值和特征向量、向量空间以及线性变换。:许多机器学习算法涉及到连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分以及梯度的概念也很重要。:这些知识对于理解模型如何从数据中学习并进行预测至关重要。主要概念包括概率理论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。有的时候临时抱佛脚也是可以的。

Python单行客的博客 1236

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

AI大模型入门到精通:零基础详细教程,非常详细收藏我这一篇就够了!

掌握大模型技术,可应对复杂的数据分析任务,提升研究与工作的解决能力。学习大模型具备处理复杂性、具有泛化能力与灵活性,对求职者有显著提升。本教程从基础概念出发,包括大模型的优势与应用、基础知识学习建议、入门基础教程,以及分布式训练、有监督微调与AGI学习包等内容。通过推荐的学习资源与实战项目资料,引导读者深入学习并实践大模型技术,开启AI大模型之旅。

2401_84495872的博客 1397

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

AI大模型学习路线,零基础入门到精通(非常详细)收藏这一篇就够了!

学习大模型需要打好数学和编程基础。数学方面需掌握线性代数、微积分和概率统计,推荐Khan Academy和MIT的公开课。编程以Python为主,需学习数据结构和算法,可通过Codecademy和Coursera课程入门。之后可进入机器学习领域,建议从经典算法入手逐步深入。整体学习路径强调理论与实践结合,通过系统学习掌握大模型核心技术。

2401_84495872的博客 1969

AI大模型学习路线图:零基础入门到精通,一篇掌握全部知识!非常详细收藏这一篇就够了!

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

2401_85390073的博客 1296

【2025最新最全】大模型学习路线规划:零基础入门到精通,非常详细收藏这一篇就够!

2025年大模型学习路线与行业趋势 随着AI技术快速发展,大模型领域人才需求激增,2025年相关岗位缺口达47万,初级工程师平均月薪28K。学习路径可分为五个阶段:1)基础准备(数学/Python/深度学习);2)核心技术(Transformer/预训练/NLP);3)实战项目(复现经典模型/领域应用);4)高级技能(API开发/模型微调/部署);5)持续学习(前沿技术/社区交流)。行业案例显示,经过系统学习后转行成功率显著提升,如某机械专业学员4个月学习后薪资翻3倍。学习资料包含提示词工程、RAG系统、

2401_85375151的博客 1493

神仙级AI大模型入门教程(非常详细),从零基础入门到精通,非常详细收藏我这一篇就够了!

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。学习路上没有捷径,只有坚持。虽然大模型在底层运算上可能不如一些特定的算法快速,但大模型清晰的结构和强大的能力能够解放开发者的大量时间,同时也能方便地与其他技术(如传统机器学习算法)结合使用。包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。

2401_84495872的博客 931

【零基础入门到精通】AI大模型超详细学习路线:看这篇就够了!

学习AI大模型从零基础入门到精通是一个循序渐进的过程,涉及到理论知识、编程技能和实践经验。下面是一份详细的指南,帮助你从头开始学习并逐步掌握AI大模型的构建与应用。

2401_84494441的博客 1823

大模型入门教程:非常详细,从零基础到精通,看完这一篇就够了!

大模型就像一座庞大的图书馆,里面有非常多的书籍。但与普通图书馆不同的是,这座图书馆中的每本书都是关于不同事物的描述和知识。而这些书籍中的每一页都代表了这个事物的一些特征或细节。现在,想象一下,你是一个研究员,你想了解各种各样的话题,比如天气、历史、科学等等。但是你没有时间和精力去阅读所有的书籍,而且有些书籍可能非常专业和深奥,你也未必能理解。这时,一位聪明的朋友建议你去一座巨大的图书馆,这个图书馆里面的每本书都已经被一个智能的读者阅读过,并且将书中的重要内容总结成了简单易懂的概要。

2401_85343303的博客 1395

大模型入门指南(非常详细)零基础入门到精通,收藏这一篇就够了

Part of speech: 词性标注Named entity recognition: 命名实体的识别Co-reference: 共指向性(代指)Basic dependencies: 依存句法–句法理论Sentiment Analysis: 情感分类Opinion Mining:意向挖掘。

Everly_的博客 1254
上一篇: 35 岁资深程序员的春天又来了?程序员学习、晋升之路!!
下一篇: ReAct模式:AI大模型的进化之路,实现思考、行动与观察的完美循环!
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值