机器学习8:集群

配置DataBricks Connect使用IntelliJ + sbt 连接 Azure Data Bricks Spark集群 配置DataBricks Connect使用IntelliJ + sbt 连接 Azure Data Bricks Spark集群 本文主要参考的是Azure官方文档:开发者工具:Databricks Connect 由于笔者使用的编程语言是Scala,涉及Python的配置部分跳过,但如果你使用Python,请仔细阅读上面连接中的官方文档,在Python版本方面,需要小心注意,仔细比照 databricks runtime 支持的 Python 版本和你的客户端安装的 Python 版本的差异,防止操作到 阅读详情

非监督学习

如下图所示,,非监督学习是把相距较近的点划分为K个簇
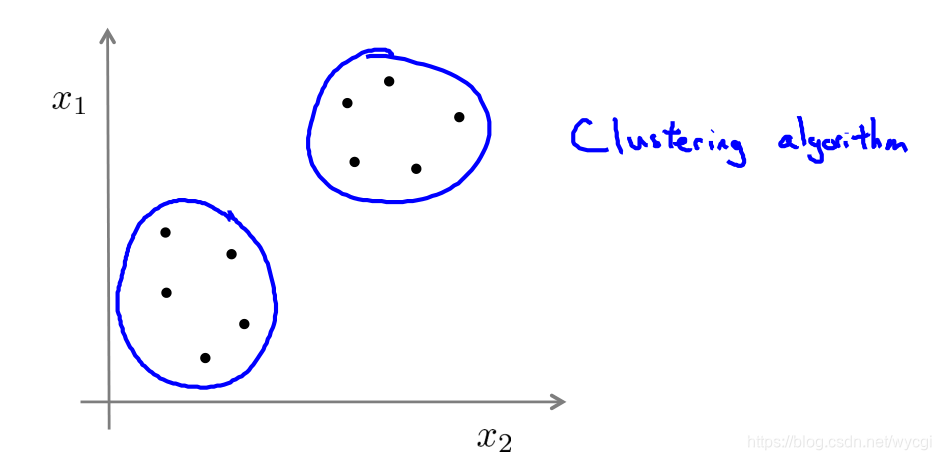
在这里插入图片描述

具体可以应用于市场分割、社交网络分析、组织计算集群和天文数据分析

K-均值算法

输入:需要划分的集群数量K,以及训练集 { x ( 1 ) , x ( 2 ) , … , x ( m ) } \{x^{(1)},x^{(2)},\dots,x^{(m)}\} {x(1),x(2),…,x(m)}。
其中, x ( i ) ∈ R n x^{(i)}\in R^n x(i)∈Rn(不需要 x 0 = 1 x_0=1 x0​=1)

算法过程:
随机初始化K个集群中心点 μ 1 , μ 2 , . . . , μ k ∈ R n \mu_1,\mu_2,...,\mu_k\in R^n μ1​,μ2​,...,μk​∈Rn(一般从样本中随机取K个)
Repeat
f o r i = 1 t o m c ( i ) = 距 离 x ( i ) 最 近 的 集 群 中 心 的 编 号 ( 相 当 于 将 样 本 分 配 到 各 集 群 中 心 点 ) f o r k = 1 t o m μ k : = 所 有 归 属 于 该 集 群 中 心 的 样 本 的 均 值 点 ( 移 动 集 群 中 心 到 均 值 上 ) for\quad i = 1\quad to\quad m \\ c^(i) = 距离x^{(i)}最近的集群中心的编号 (相当于将样本分配到各集群中心点) \\ for\quad k = 1\quad to\quad m \\ \mu_k := 所有归属于该集群中心的样本的均值点 (移动集群中心到均值上) fori=1tomc(i)=距离x(i)最近的集群中心的编号(相当于将样本分配到各集群中心点)fork=1tomμk​:=所有归属于该集群中心的样本的均值点(移动集群中心到均值上)

优化目标

代价函数:
J ( c ( 1 ) , … , c ( m ) , μ 1 , … , μ K ) = 1 m ∣ x ( i ) − μ c ( i ) ∣ 2 J(c^{(1)},\dots,c^{(m)},\mu_1,\dots,\mu_K)=\frac{1}{m}|x^{(i)}-\mu_{c^{(i)}}|^2 J(c(1),…,c(m),μ1​,…,μK​)=m1​∣x(i)−μc(i)​∣2
由上可知,先簇分配,改变 c ( 1 ) , … , c ( m ) c^{(1)},\dots,c^{(m)} c(1),…,c(m)值,使J降低,再通过移动簇中心,改变 μ 1 , … , μ K \mu_1,\dots,\mu_K μ1​,…,μK​,进一步使J降低
另外,目标函数就是使代价函数最小

随机初始化集群中心点

  • 集群中心点数量K应小于样本数量m
  • 从样本中随机取K个样本作为集群中心点

选取多组K个随机样本作为集群中心点,分别经过K均值算法进行迭代更新后,选取J值最小的那组集群中心点。

选取集群中心点数量K

  1. 肘部法则
    在这里插入图片描述
    如上面左图,使J值下降的转折处即为合适的K值;
    但是实际上并不好用,因为一般是像右图,很难找到转折点

  2. 按目标选择
    通过找到集群的目的,来选择K值,比如目标是增加分类多样化,那K值取大一些,如果目标是减少类别(减少产品类型,降低生产成本),那K值取小一些。

降维

数据压缩

将两维特征的样本 ( x 1 , x 2 ) (x_1,x_2) (x1​,x2​)压缩成一维 z 1 z_1 z1​:

在这里插入图片描述

将三维特征的样本 ( x 1 , x 2 , x 3 ) (x_1,x_2,x_3) (x1​,x2​,x3​)压缩成两维 ( z 1 , z 2 ) (z_1,z_2) (z1​,z2​):
在这里插入图片描述

数据可视化

这步主要是观察压缩后的数据是否有一定规律(一般不要指望能看出来规律。。)

以下是国家的各个特征数据,包括GDP、平均收入、平均年龄等
在这里插入图片描述

以上特征压缩成两维后:
在这里插入图片描述

将压缩后的特征可视化(如果将GDP相关数据压缩成一维,国家规模相关数据压缩成另一维,则可以看到如美国就国家规模和GDP都高,新加坡国家规模小而GDP高):
在这里插入图片描述

主成分分析(PCA)

PCA与线性回归的区别,如下图,线性回归是样本点到假设函数的y轴距离最短;而PCA是样本点到假设函数的距离最短
在这里插入图片描述

算法过程

  1. 样本集: x ( i ) x^{(i)} x(i)

  2. 均值归一化:
    x j ( i ) = x j ( i ) − μ j s j μ j = 1 m ∑ i = 1 m x j ( i ) x^{(i)}_j = \frac{x^{(i)}_j-\mu_j}{s_j} \\ \\ \mu_j=\frac{1}{m}\sum_{i=1}^mx^{(i)}_j xj(i)​=sj​xj(i)​−μj​​μj​=m1​i=1∑m​xj(i)​
    其中, s j s_j sj​的取值为令 x j ( i ) x^{(i)}_j xj(i)​在一个小范围内,请参照之前博客中提到的均值归一化步骤。

  3. 求协方差方程机器特征向量
    ∑ = 1 m ∑ i = 1 m ( x ( i ) ) ( x ( i ) ) T \sum=\frac{1}{m}\sum^m_{i=1}(x^{(i)})(x^{(i)})^T ∑=m1​i=1∑m​(x(i))(x(i))T
    在octave中:
    在这里插入图片描述

从上图可知,取由svd函数计算得到的n*n矩阵U的第1列到第k列为Ureduce,转置Ureduce后乘以样本 x ( i ) ( 列 向 量 ) x^{(i)}(列向量) x(i)(列向量),就得到降维后的样本 x ( i ) x^{(i)} x(i)

重建维度

将上面的 z = U r e d u c e ′ ∗ x z=Ureduce'*x z=Ureduce′∗x的算式反转,得到下式:
x a p p r o x ( i ) = U r e d u c e ∗ z ( i ) x^{(i)}_{approx} = Ureduce*z^{(i)} xapprox(i)​=Ureduce∗z(i)

选择要下降到的维度K

K值的选取,要在尽量小的情况下,保证数据压缩后的差异性不要太大,也就是说,需要衡量以下差异指标:

在这里插入图片描述
上面指标小于等于0.01,说明差异度小于等于1%,保留了99%方差

上面的差异指标在实际计算中,通过octave的svd函数返回的n*n的S矩阵([U,S,V]=svd(Sigma))来计算,如下式:
1 − ∑ i = 1 k S i i ∑ i = 1 n S i i ≤ 0.01 1-\frac{\sum_{i=1}^kS_{ii}}{\sum_{i=1}^nS_{ii}}\le0.01 1−∑i=1n​Sii​∑i=1k​Sii​​≤0.01
实际上计算:
∑ i = 1 k S i i ∑ i = 1 n S i i ≥ 0.99 \frac{\sum_{i=1}^kS_{ii}}{\sum_{i=1}^nS_{ii}}\ge0.99 ∑i=1n​Sii​∑i=1k​Sii​​≥0.99

PCA应用建议

  • 在监督学习中也可以用于压缩数据(比如逻辑回归和线性回归,将特征数目压缩)

  • PCA应用:

    • 压缩:减小存储量、加快机器学习算法运行
    • 数据可视化,压缩到维度k为2或3(维度太高无法可视化)
  • 不建议使用PCA来避免过拟合。且注意k值最好远小于n值,比如k为1000,n为10000

  • 在使用PCA前,先使用原始样本 x ( i ) x^{(i)} x(i)进行训练,若不行,再用PCA

PySpark ML分布式机器学习实战:从特征工程到模型部署 分布式机器学习是处理TB级结构化数据建模的核心能力,其本质在于将单机算法(如Scikit-learn)迁移至Spark DataFrame计算范式,依托Catalyst优化器与Tungsten执行引擎实现‘数据不动、计算动’。关键技术原理包括:StringIndexer的分布式字典构建、VectorAssembler的列序敏感向量化、StandardScaler的跨分区参数复用,以及PipelineModel的跨语言可部署设计。该技术显著提升信贷评分、用户流失预测、点击率预估等场景的可扩展性与工程鲁棒性,避 阅读详情

相关推荐

ML Enabled Applications:构建可运维的机器学习软件产品

机器学习应用(ML Application)本质上是软件工程与统计建模在生产环境中的深度融合。它超越了传统模型训练与部署的概念,强调可观测性、可回滚性、特征一致性与业务指标对齐等工程能力。核心挑战在于应对数据漂移、训练-推理不一致、模型版本与代码版本耦合等现实问题。技术价值体现在将机器学习转化为稳定、低延迟、高可用的服务使能器(Enabled),而非独立模块。典型应用场景包括智能推荐、实时风控、搜索排序等需与业务逻辑深度集成的系统。本文聚焦于ONNX模型交付、特征仓库设计、分层部署策略及三层监控体系等落地关

Hi, Sun 947

【译】使用 ML.NET 进行机器学习 - 集群完整指南

在之前的几篇文章中,我们探索了一些基本的机器学习算法。到目前为止,我们介绍了一些简单的回归算法,分类 算法。我们使用 ML.NET 实现和应用这些算法。到目前为止,我们探索了使用监督学习的算法。这意味着我们始终拥有用于训练机器学习模型的输入和预期输出数据。在这种类型的学习中,训练集包含输入和期望的输出。通过这种方式,算法可以检查其计算出的输出是否与所需输出相同,并据此采取适当的措施。

寒冰屋的专栏 699

cluster.py

使用python手写聚类实现。 逐步进行更新聚类中心点和分类归属,并在每次更新的过程中图像化显示。 代码清晰

云计算——常见集群策略

本章将会讲解云计算中常见的集群策略,了解什么是集群。

yj11290301的博客 6503

K-mean cluster算法 machine learning

K-mean cluster算法 在machine learning中的matlab程序

Optimus基于机器学习的集群管理

论文pdf版本。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。。

六台机器搭建RedisCluster分布式集群

一、RedisCluster结构二、redis Cluster集群搭建1、修改redis.conf中需要更改的配置bind 改成当前ipcluster-enabled yes  #允许redis集群cluster-config-file nodes-6379.conf  #集群配置文件cluster-node-timeout 15000   #集群中节点允许失联的最大时间15s注:安装redis集...

迟迟 优快云 1万+

HPM6E00:PWM V2使用指南

HPM6E00:PWM V2使用指南

xikangsoon的博客 1733

机器学习:系统设计与实现 分布式训练

机器学习:系统设计与实现 分布式训练

weixin_44966641的博客 3512

将外部电磁近场数据导入 ANSYS HFSS

本博客介绍了如何将电磁近场数据导入 ANSYS HFSS。用户可能需要导入字段,无论是通过分析计算、测量、由其他工具生成还是从提供商处接收的字段,并将其用作实际激励来执行不同类型的分析。以下是导入过程的简要概述,视频链接中提供了完整的演示。为了定义简单基元近场源,HFSS 使用两种外部数据文件。首先,实际位置/字段数据以 .nfd 格式存储。其次,Ansys Near field Descriptor 文件(.and 文件)存储 .nfd 数据的一般几何信息和路径。

jkh920184196的博客 2323

论文工具——写论文好用的绘图工具(甘特图+流程图+网络模型图+泳道图)

* 在写HiFi-GAN论文的代码阅读过程中,我发现仅仅通过文字来描述网络结构,不够详细,所以想绘制出网络结构图,更加具象化的描述出网络结构。想去花了,才发现之前都是通过在线绘图网站画的,费时费力,所以想找一些专门的网站化出比较规范并且高质量的图。一方面是为了方便讲解,提高论文的质量,另外一方面也是为了以后写论文打下良好的基础。 * 这篇文章会根据我以前的画图经验展开,以前是使用绘图软件,手动绘图。后来,看到了其他的方法,但是需要写一些代码,或者需要安装特定的软件,投入成本太大,就没有学。所以,本文分享的工

Blackoutdragon的博客 1万+

机器学习 聚类算法(clustering)

聚类算法 前言 与回归与分类不同,聚类是无监督学习算法,无监督指的是只需要数据,不需要标记结果,自己给自己分类。 在现实生活中,很少直接用聚类算法,因为聚类效果的好坏不容易衡量(因为没有标记,就没有标准答案),有时候会用做监督学习中稀疏特征的预处理,把混乱的数据先分分看,看看大类如何。 算法思想   聚类算法,顾名思义是将数据聚集起来的算法,所谓“物以类聚,人以群分”的道理。聚类算法的主要思想...

weixin_41544711的博客 2947

仿真学习系列(四十一):Sigrity仿真之PDN阻抗提取

电源分配网络(Power Distribution Network,简称PDN)是电子系统中至关重要的部分,主要用于将电源从电源输入端传输到各个组件。PDN的设计质量直接影响到系统的电源完整性和信号稳定性,尤其是在高速设计中,PDN的阻抗特性对电源噪声、地弹(ground bounce)和电源完整性(Power Integrity,简称PI)具有重要影响。

案例文章,高速信号 1133

es8中无法设置主节 出现unknown setting [node.master]

es8中无法设置主节 出现unknown setting [node.master] 设置node.master: true 改为:node.roles: [ master ] 其中节点的角色有多种选择 master data data_content data_hot data_warm data_cold data_frozen ingest ml remote_cluster_clien...

qq_36466946的博客 448

桌面运维工程师面试题汇总(高频完整版)

岗位,覆盖:电脑硬件、系统安装与故障、网络、办公软件、安全、AD域、打印机、日常排错、服务意识。

老韩的Linux云计算架构师进阶之路 915

CentOS7安装OpenSSL1.1.1s

CentOS7安装OpenSSL1.1.1s

Bertram的博客 733

从 0 到 1 跑通第一个 Flink ML 示例

本文介绍了如何在Flink上运行机器学习任务。首先说明了Flink ML作为Flink的机器学习库,具有数据就地训练和流式场景适配两大优势。接着详细讲解了环境准备步骤:安装Java、下载Flink、配置环境变量,并将Flink ML库添加到Flink中。然后指导读者启动本地Flink集群,并提交KMeans聚类示例作业运行。最后解析了示例输出结果,展示了Flink ML完成训练和预测的完整流程。文章还提供了常见问题排查建议,帮助用户快速上手Flink ML的基本使用。

hello.reader 1341

矢量网络分析仪校准:原理、方法与系统适配性

矢量网络分析仪(VNA)校准是射频测量的关键环节,通过误差建模(12项误差项)和标准件测量,可将系统不确定度从±5dB降至±0.1dB以下。主流校准方法包括SOLT(适用于同轴系统)和TRL(适用于波导系统),二者在标准件、误差重点及频率上限等方面存在显著差异。随着6G与量子通信的发展,动态实时校准将成为新趋势。工程师需根据传输结构、频率范围及精度需求选择合适方法,确保测量精度。

u014344410的博客 262

Photon-ML部署实战:从本地开发到YARN集群的完整流程

Photon-ML是LinkedIn开发的基于Apache Spark的机器学习库,专为大规模机器学习任务设计。本文将为您详细介绍如何将Photon-ML从本地开发环境部署到YARN集群的完整流程,帮助您快速掌握这个强大的机器学习工具的实际应用。 ## 🚀 快速入门:环境准备与项目构建 ### 系统要求与依赖安装 在开始部署Photon-ML之前,您需要确保系统满足以下基本要求: - *

gitblog_00360的博客 544

YOLOv11改进策略【Neck】| GSConv+Slim Neck:混合深度可分离卷积和标准卷积的轻量化网络设计

实时检测器架构的轻量级设计GsConv。

Limiiiing的博客 2311

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

用 Python 跑通第一个 Flink ML 项目KMeans 聚类从本地到集群实战

本文介绍了如何使用PyFlink ML的KMeans算法对二维向量进行聚类。主要内容包括:1)环境准备,需安装Java 8、Python 3.7/3.8和PyFlink ML SDK;2)代码实现步骤:创建执行环境和Table环境,构造训练数据表,配置KMeans模型参数并训练,使用模型进行预测;3)完整示例代码展示了如何将6个二维向量聚成2个簇,并输出每个向量所属的簇ID。该程序支持本地运行和集群部署两种方式。

hello.reader 2270

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

如何快速入门 Photon-ML:5步搭建你的第一个Spark机器学习项目

Photon-ML 是一个基于 Apache Spark 的可扩展机器学习库,由 LinkedIn 机器学习算法团队开发,支持训练多种广义线性模型(GLMs)和广义线性混合模型(GLMMs/GLMix),包括逻辑回归、线性回归和泊松回归等。本指南将帮助你通过5个简单步骤快速上手,搭建并运行你的第一个 Photon-ML 项目。 ## 1️⃣ 环境准备:安装必要依赖 在开始之前,确保你的系统已安

gitblog_00125的博客 405

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

Photon-ML 终极指南:LinkedIn开源的大规模机器学习库

Photon-ML 是由 LinkedIn 机器学习算法团队开发的基于 Apache Spark 的可扩展机器学习库,支持训练多种广义线性模型(GLMs)和广义线性混合模型(GLMMs/GLMix 模型),包括逻辑回归、线性回归和泊松回归,为大规模数据处理提供了强大的解决方案。 ## 🚀 核心功能亮点 ### 🌟 广义线性模型(GLMs) Photon-ML 支持三大基础模型,满足不同业务

gitblog_00503的博客 718

Python机器学习:适合新手的8个项目

再多的理论也不能代替动手实践。

weixin_72959097的博客 1606

【ML on Kubernetes】第 4 章:机器学习平台剖析

幸运的是,Kubernetes 有这个能力,我们的机器学习平台可以利用这个能力来限制团队的资源。您可以在前面的步骤中看到,除了编写代码之外,所有其他步骤都是声明性的。ML 平台的模型开发组件探索数据模式、构建和训练 ML 模型,并尝试多种配置以找到最佳配置和算法集,以实现模型的预期性能。数据工程师是构建软件的人,该软件收集和处理原始数据,为数据分析师和数据科学家生成干净且有意义的数据集。该平台的声明能力还将允许团队标准化整个组织的流程,这将减少定制工具链的使用,从而提高一致性并提高整个流程的安全性。

sikh_0529的博客 1084
上一篇: Python之列表
下一篇: 机器学习9:异常检测
SilentSlot
博客等级 码龄16年 44粉丝 68原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值