Win10系统安装FastGPT知识库集成使用本地大模型问答

人工智能 | Embedding 通过使用Embedding,我们可以将每个单词或句子表示为一个固定长度的向量,其中每个维度代表了某种语义特征。通过将文本转换为向量表示,我们可以在机器学习和深度学习模型中使用这些向量进行文本分类、情感分析、机器翻译等任务。近日,北京数元灵科技有限公司开源了语义向量(Embedding)模型:DMeta-Embedding,目前位列 MTEB 中文场景开源模型第一(总榜第一名百川只提供 API 服务,暂未开源模型),并在 Pair Classification Average 单项… 阅读详情
AI摘要

本文介绍在Win10系统安装FastGPT知识库并集成本地大模型进行问答的方法。先阐述FastGPT概念、部署架构和工作流程,接着说明安装FastGPT和OneAPI的步骤,还介绍大模型和向量模型的下载运行方式,最后讲解重新配置、修改文件及进行应用建立和问答测试的过程。

一、 什么是FastGPT?

FastGPT,是一个基于 LLM 大语言模型的知识库问答系统,提供开箱即用的数据处理、模型调用等能力。
同时可以通过 Flow 可视化进行工作流编排,从而实现复杂的问答场景!

二、 FastGPT知识库的部署架构和工作流程

首先当我们录入知识库时,FastGPT会用集成的向量模型对知识库中的文本进行分割,得到文本块。
利用embedding模型给出文本块的embedding,并利用向量数据库进行保存。
然后当用户给大模型输入问题后,问题输入与知识库通过大预言模型根据用户输入信息的embedding, 通过向量数据库检索得到最相关的文本片段,将提示词模板与用户提交问题及历史消息合并输入大语言模型。大语言模型进行结果组装返回给用户回答。
在这里插入图片描述
部署FastGPT需要部署的环境。

  1. Docker DeskTop
  2. OneAPI
  3. Ollama + LLM大模型以及 向量模型
    关于Docker DeskTop怎么部署参看Windows系统安装Docker容器博客

什么是OneApi?

One API 是一个 OpenAI 接口管理 & 分发系统,可以通过标准的 OpenAI API 格式访问所有的大模型,开箱即用。
默认情况下,FastGPT 只配置了 GPT 的模型,如果你需要接入其他模型,需要进行一些额外配置。FastGPT 可以通过接入 One API 来实现对不同大模型的支持。

OneApi中渠道和令牌的关系及OneApi及FastGPT的工作流程
**渠道:**
OneApi 中一个渠道对应一个 Api Key,这个 Api Key 可以是GPT、微软、ChatGLM、文心一言的。一个Api Key通常可以调用同一个厂商的多个模型。
One API 会根据请求传入的模型来决定使用哪一个Key,如果一个模型对应了多个Key,则会随机调用。
**令牌:** Api Key
访问 One API 所需的凭证,只需要这1个凭证即可访问One API上配置的模型。因此FastGPT中,只需要配置One API的baseurl和令牌即可。
**大致工作流程** Api Key
客户端请求 One API
根据请求中的 model 参数,匹配对应的渠道(根据渠道里的模型进行匹配,必须完全一致)。如果匹配到多个渠道,则随机选择一个(同优先级)。
One API 向真正的地址发出请求。
One API 将结果返回给客户端。

常用的中文向量模型

mofanke/acge_text_embedding
shaw/dmeta-embedding-zh
m3e
bge-m3

三、安装FastGPT和OneAPI

通过GitHub下载FastGPT的Docker-compose 文件https://github.com/labring/FastGPT/blob/main/files/docker/docker-compose/docker-compose
和OneAPI的Config.json文件
https://github.com/labring/FastGPT/blob/main/projects/app/data/config.json
将两个文件放置到相同目录下,然后在文件浏览器窗口该目录下输入cmd命令,执行

docker-compose up -d 

可以看到docker自动拉取镜像并安装执行,等到全部安装结束即可。
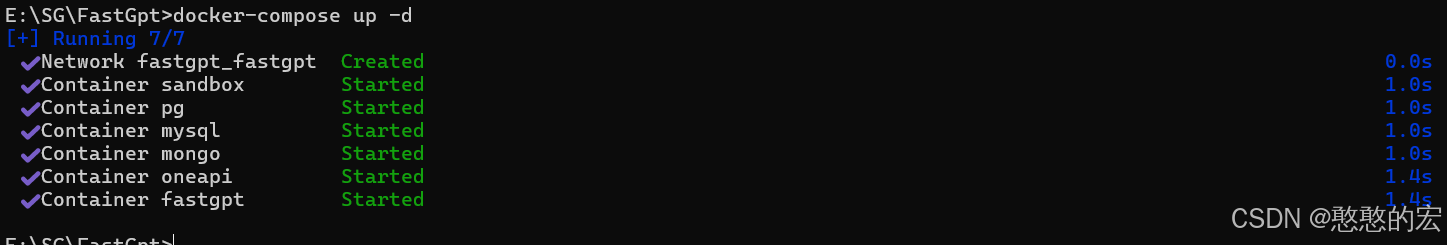
在这里插入图片描述
全部安装结束,我们即可打开本地http://ip:3001端口即是OneAPI的登录入口,默认用户名 root 密码123456。本地http://ip:3000即是FastGPT的登录入口,默认用户名root 密码1234。
在这里插入图片描述

四、下载并运行大模型和向量模型。

第一种方式:通过Ollama进行快速下载和运行:
登录ollama官网搜索下载大模型和向量模型,这步非常简单,直接命令行运行Ollama run+模型名称即可。ollama支撑常见的多种模型下载和运行。
譬如,大语言模型:llama3、qwen2、gema;
向量模型:mofanke/acge_text_embedding
shaw/dmeta-embedding-zh
bge-m3
以下是我已经下载并运行的模型。
在这里插入图片描述
第二种方式:通过其它方式进行下载和运行:
docker方式:
m3e

#GPU模式启动
docker run -d -p 6008:6008 --gpus all --name m3e --network fastgpt_fastgpt registry.cn-hangzhou.aliyuncs.com/fastgpt_docker/m3e-large-api
#CPU模式启动,并把m3e加载到fastgpt同一个网络
docker run -d -p 6008:6008 --name m3e --network fastgpt_fastgpt stawky/m3e-large-api

五、重新配置OneApi渠道以及修改Config.json文件并重启docker-compose。

config.json文件里面配置了示例的大模型名称和向量模型名称。我们根据本地的实际情况修改成自己的大模型名称和向量模型名称即可。
然后再相同的目录下Docker-compose down 将容器停止,再Docker-compose up -d 重启。
最后登录OneAPI平台配置渠道,若是ollama下载的大模型,则类型选择Ollama。
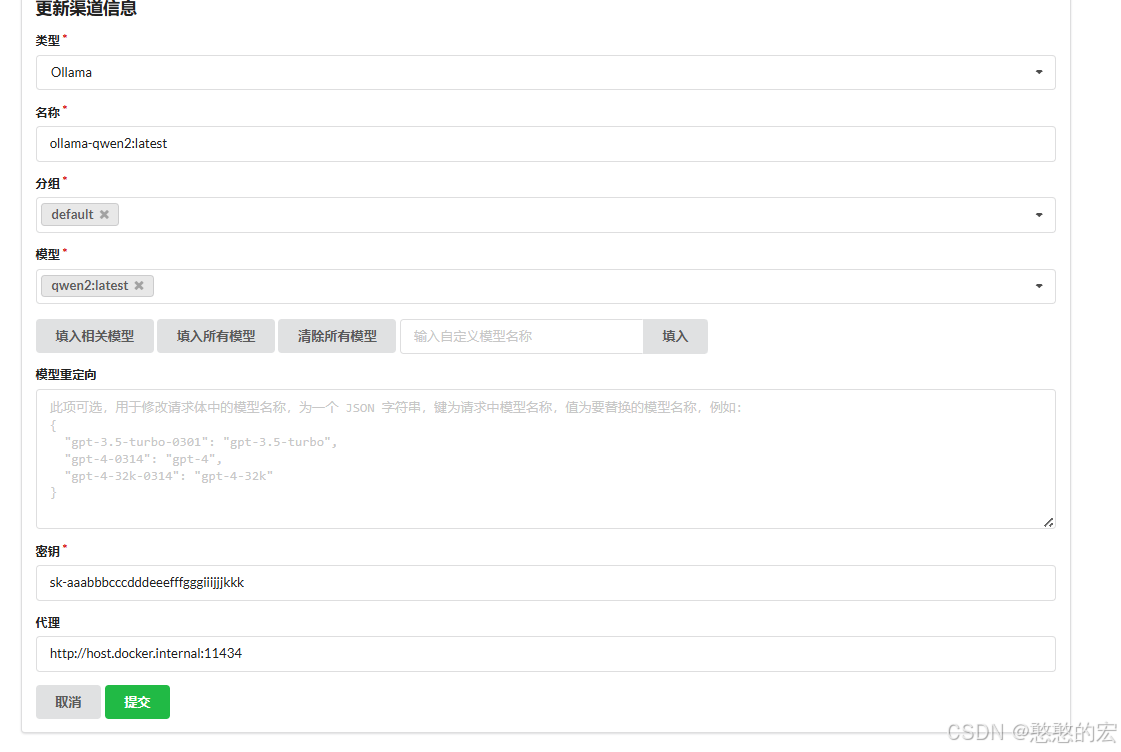
在这里插入图片描述
代理部分填入:http://host.docker.internal:11434

配置时的注意点:
1.注意最后代理填入Docker容器与本机Ollama通讯的地址。
2.向量模型在OneAPI渠道测试时会报400错误,直接略过即可。
3.config.json文件中配置的"model": 名称需要与OneAPI里面“模型”标签,以及ollama list里面的模型名称完全一致,并且不能有空格。

六、进行FastGPT应用建立和问答测试。

新建知识库,然后选中向量模型和LLM模型。点击测试对话即可开始对话。
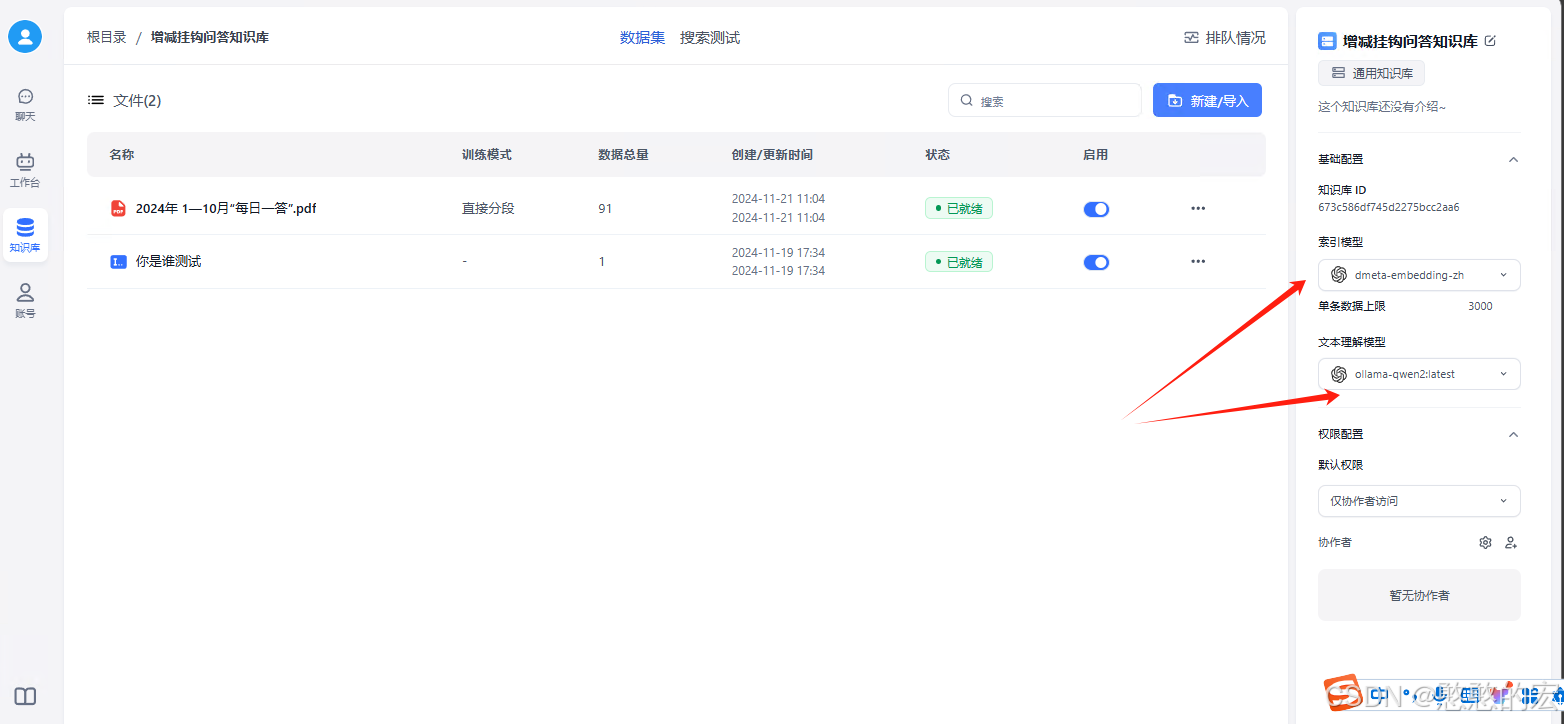
在这里插入图片描述

七、最后附上config.json和fastgpt的docker-compose文件

// 已使用 json5 进行解析,会自动去掉注释,无需手动去除
{
  "feConfigs": {
    "lafEnv": "https://laf.dev" // laf环境。 https://laf.run (杭州阿里云) ,或者私有化的laf环境。如果使用 Laf openapi 功能,需要最新版的 laf 。
  },
  "systemEnv": {
    "vectorMaxProcess": 15, // 向量处理线程数量
    "qaMaxProcess": 15, // 问答拆分线程数量
    "tokenWorkers": 50, // Token 计算线程保持数,会持续占用内存,不能设置太大。
    "pgHNSWEfSearch": 100 // 向量搜索参数。越大,搜索越精确,但是速度越慢。设置为100,有99%+精度。
  },
  "llmModels": [
    {
      "model": "llama3.1:8b", 
      "name": "ollama-llama3.1:8b",
      "avatar": "/imgs/model/openai.svg", 
      "maxContext": 125000, 
      "maxResponse": 16000, 
      "quoteMaxToken": 120000,
      "maxTemperature": 1.2,
      "charsPointsPrice": 0, 
      "censor": false, 
      "vision": false, 
      "datasetProcess": true, 
      "usedInClassify": true, 
      "usedInExtractFields": true,
      "usedInToolCall": true, 
      "usedInQueryExtension": true, 
      "toolChoice": true,
      "functionCall": true, 
      "customCQPrompt": "", 
      "customExtractPrompt": "", 
      "defaultSystemChatPrompt": "", 
      "defaultConfig": {}
    },
	{
      "model": "qwen2:latest",
      "name": "ollama-qwen2:latest",
      "maxContext": 32000,
      "avatar": "/imgs/model/openai.svg",
      "maxResponse": 8000,
      "quoteMaxToken": 20000,
      "maxTemperature": 1.0,
      "charsPointsPrice": 0,
      "censor": false,
      "vision": false,
      "datasetProcess": true,
      "usedInClassify": true,
      "usedInExtractFields": true,
      "usedInToolCall": true,
      "usedInQueryExtension": true,
      "toolChoice": true,
      "functionCall": true,
      "customCQPrompt": "",
      "customExtractPrompt": "",
      "defaultSystemChatPrompt": "",
      "defaultConfig": {}
    }
  ],
  "vectorModels": [
	 {
      "model": "shaw/dmeta-embedding-zh",
      "name": "dmeta-embedding-zh",
      "avatar": "/imgs/model/openai.svg",
      "charsPointsPrice": 0,
      "defaultToken": 512,
      "maxToken": 3000,
      "weight": 100,
      "dbConfig": {},
      "queryConfig": {}
    },
    {
      "model": "mofanke/acge_text_embedding:latest",
      "name": "mofanke/acge_text_embedding:latest",
      "avatar": "/imgs/model/openai.svg",
      "charsPointsPrice": 0,
      "defaultToken": 512,
      "maxToken": 3000,
      "weight": 100,
      "dbConfig": {},
      "queryConfig": {}
    },
    {
      "model": "bge-m3:latest",
      "name": "bge-m3:latest",
      "avatar": "/imgs/model/openai.svg",
      "charsPointsPrice": 0,
      "defaultToken": 512,
      "maxToken": 3000,
      "weight": 100,
      "dbConfig": {},
      "queryConfig": {}
    },
    {
      "model": "m3e",
      "name": "m3e",
      "avatar": "/imgs/model/openai.svg",
      "charsPointsPrice": 0,
      "defaultToken": 512,
      "maxToken": 3000,
      "weight": 100,
      "dbConfig": {},
      "queryConfig": {}
    }
  ],
  "reRankModels": [],
  "audioSpeechModels": [
    {
      "model": "tts-1",
      "name": "OpenAI TTS1",
      "charsPointsPrice": 0,
      "voices": [
        { "label": "Alloy", "value": "alloy", "bufferId": "openai-Alloy" },
        { "label": "Echo", "value": "echo", "bufferId": "openai-Echo" },
        { "label": "Fable", "value": "fable", "bufferId": "openai-Fable" },
        { "label": "Onyx", "value": "onyx", "bufferId": "openai-Onyx" },
        { "label": "Nova", "value": "nova", "bufferId": "openai-Nova" },
        { "label": "Shimmer", "value": "shimmer", "bufferId": "openai-Shimmer" }
      ]
    }
  ],
  "whisperModel": {
    "model": "whisper-1",
    "name": "Whisper1",
    "charsPointsPrice": 0
  }
}

docker-compose文件修改的地方:
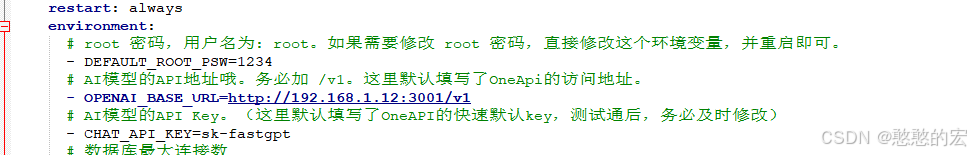
在这里插入图片描述

Ubuntu 22.04 搭建 FastGPT 完整教程 FastGPT 是一个基于大型语言模型(如GPT系列)构建的开源AI应用框架,支持知识库管理、AI对话和自动化流程。本教程将指导您通过Docker快速部署FastGPT服务。 阅读详情

相关推荐

大模型系列-fastgpt,ollama搭建本地知识库

大模型系列-fastgpt,ollama搭建本地知识库。

GeekPlusA的博客 3280

【LLM_05】使用fastgpt搭建本地离线大语言模型(Chatglm3)问答+知识库平台

1、大语言模型:ChatGLM3-6b【可替换成ChatGLM3-6b-32k】2、词向量模型:m3e、bge【有m3e_base、m3e_large、bge_large等等,可以自行选择性能最好的向量模型】3、监控和管理docker的工具:Portainer.io4、系统:ubuntu20(22也一样)5、配置docker、启动oneAPI、启动FaskGPT【具体步骤请看=》

1万+

Win10本地部署私有知识库:Ollama+DeepSeek+one-api+FastGPT全攻略

在数据隐私日益受重视的今天,私有化部署大模型应用成为企业内网智能化升级的重要方向。本文从基础概念讲起,梳理了大模型运行环境、推理模型、统一API网关与知识库应用框架的分工原理,并解释为什么解耦式架构比All-in-One方案更适合长期维护。通过将大型语言模型与向量检索技术结合,可以在完全离线的条件下实现文档问答与内部资料检索,保障数据不出内网。基于Windows 10平台的完整部署实践,详细说明了从硬件准备、Docker环境搭建、模型下载,到配置网关、创建知识库应用的全流程。无论你是技术人员还是开源爱好者,

weixin_28694169的博客 243

使用Ollama本地部署deepseek大模型(二)

不过在此之前,我们还需要下载一个名为“shaw/dmeta-embedding-zh:latest”的模型(此模型用来配置本地数据库)。这里我们需要用到cherry studio软件,下载官网:https://cherry-ai.com/模型地址:https://ollama.com/shaw/dmeta-embedding-zh。2、公共模型使用起来并不能达到我们的预期,我们希望将自己的数据导入到模型。1、使用命令行进行沟通非常的不方便。下载好后请自行安装。

杨村的博客 1454

Win10本地部署私有知识库:Ollama+DeepSeek+OneApi+FastGPT实战

大模型本地化部署正成为企业数据安全与成本控制的重要选择。其核心原理是通过容器化技术将模型运行环境、API网关和应用层分离:Ollama负责在本地运行开源模型,OneApi统一管理模型路由与密钥,FastGPT则提供文档切片、向量检索与可视化问答界面。这种架构让私有知识库无需上传云端即可获得智能问答能力,特别适合处理密文档、内部手册等敏感数据。在实际工程中,Win10环境可通过WSL2与Docker Desktop实现混合部署,配合DeepSeek等量化模型,在16GB内存的普通办公机上即可流畅运行。本文从环

weixin_30843121的博客 332

Win10本地知识库实战:Ollama+DeepSeek+one-api+FastGPT集成指南

大模型的实际价值往往体现在与私有数据的结合上,而本地知识库正是实现这一目标的典型形态。其核心原理是将文档切分后通过向量检索构建索引,再由对话模型基于检索结果生成答案。在这一过程中,Ollama作为轻量级模型运行时,能够高效部署DeepSeek等开源模型;one-api则提供统一的API网关,简化了多模型接入与令牌管理;FastGPT承担了知识库应用层的编排与交互。这一组合不仅适用于个人笔记管理、企业内部文档检索,也适合离线环境下的安全知识服务。基于Windows 10平台,可以完整梳理出一条从模型部署、网关

weixin_29054399的博客 243

使用docker-compose一键本地化部署fastgpt,并连接本地ollama部署的大模型

环境:win11+wsl2+docker,但主要操作在wsl中完成。

qq_47814951的博客 2791

Win10本地知识库搭建实战:Ollama+DeepSeek+One API+fastGPT全配置

RAG(检索增强生成)是当前企业级知识问答的主流架构,它通过将文档向量化、语义检索与生成模型结合,让AI基于私有文档给出准确回答。搭建一套本地知识库,既能解决文档分散、搜索效率低的问题,又能保障数据不出内网,避免云端API的token成本与隐私风险。本文从最基础的Ollama模型运行时入手,介绍如何在Windows 10上部署DeepSeek大模型,经由One API完成接口网关封装,再配合fastGPT实现文档拆分、向量检索与问答应用编排。适合有私有知识库搭建需求、希望利用RAG提升检索效率的个人或小团队

weixin_29070721的博客 256

基于Ollama安装deepseek-r1模型搭建本地知识库(Dify、MaxKb、Open-WebUi、AnythingLLM、RAGFlow、FastGPT)

大模型(LLM,Large Language Model)指的是 参数量巨大、基于深度学习训练的人工智能模型,用于 自然语言处理(NLP) 任务,如文本生成、对话、翻译、代码补全等。

DEVELOPERAA的博客 1771

零基础也能玩转AI知识库 | 用FastGPT打造专属本地知识库的完整指南

本文为零基础用户提供了使用FastGPT搭建本地私有化AI知识库的完整指南。文章详细阐述了本地部署在数据安全与成本控制方面的优势,并分步讲解了从Docker环境准备、FastGPT快速启动,到知识库创建、文档导入及智能应用构建的全过程,帮助读者轻松打造专属、安全的智能知识助手。

weixin_29306875的博客 268

Win10本地部署DeepSeek知识库:Ollama+One-API+FastGPT实战

在数据隐私与智能化需求并重的背景下,本地私有知识库成为企业内网文档问答的高效解法。其核心原理是通过大语言模型理解语义,配合检索增强生成(RAG)技术,让模型基于自有文档内容作答。技术架构上,Ollama负责模型运行时管理,DeepSeek提供推理能力,One-API统一接口调度,FastGPT完成文档切片与对话编排,四者协同实现从文档导入到精准问答的完整链路。该方案尤其适用于数据敏感、需离线运行或API成本受限的场景,如技术手册查询、内部规范检索等。在Windows环境下,利用Docker容器化部署可降低环

weixin_28733637的博客 146

Win10本地部署DeepSeek知识库:Ollama+One API+FastGPT实战指南

在数据合规和隐私安全要求日益严格的背景下,越来越多的团队希望将大模型能力私有化,构建内部可用的知识库问答系统。这涉及本地模型推理、接口网关统一管理、知识库检索增强生成(RAG)等多个技术环节。Ollama作为轻量级模型运行时,能简化模型的下载与调用;DeepSeek蒸馏模型在性能和参数量上取得平衡,适合本地CPU环境;One API则通过统一的OpenAI兼容接口,屏蔽底层模型差异,提升扩展性;FastGPT负责文档切片、向量化和问答流程编排,形成完整的业务闭环。这套方案不仅适用于Windows 10环境,

weixin_29063035的博客 49

如何本地部署开源AI知识库 FastGPT(新手教程)

Win10WSL2。

本博客,博文仅代表个人操作经验,不能完全解决你的问题,仅供参考,佛系回复。 3690

Win10本地知识库搭建实战:Ollama+DeepSeek+One API+FastGPT全流程

RAG(检索增强生成)正在成为企业私有知识管理的核心范式,它通过将文档向量化并接入大模型,让AI能够基于自有数据给出精准回答。本地部署RAG则是兼顾数据隐私与成本的最佳路径,无需依赖公有云API,也无需将敏感文档上传至外部服务器。借助Ollama作为本地模型运行时,DeepSeek负责推理,One API统一管理模型接口与令牌,FastGPT提供知识库检索与应用界面,一套完整的私有知识问答系统便能在普通Win10电脑上落地。这套方案不仅适用于文档多且注重数据安全的企业内部小组,也适合想低成本尝试RAG的个人

weixin_29054399的博客 159

深入瑞芯微SDK:手把手解析Uboot、Kernel到Rootfs的镜像生成与烧录

本文深入解析瑞芯微SDK中从Uboot、Kernel到Rootfs的镜像生成与烧录全流程,揭示编译背后的技术细节。通过详细分析SDK架构、镜像生成流水线、分区表定制、Rootfs构建及烧录科学,帮助开发者从会编译进阶到懂原理,掌握系统级开发的关键技术。

weixin_29193359的博客 270

告别纯代码:用Visual Studio为LabVIEW封装一个‘即插即用’的海康VisionMaster控件

本文介绍如何利用Visual Studio为LabVIEW封装一个‘即插即用’的海康VisionMaster控件,解决传统集成方式中的代码臃肿和维护困难问题。通过.NET控件封装核心功能,实现LabVIEW与VisionMaster的高效对接,显著提升工业自动化开发效率。

weixin_33744854的博客 505

Win10本地部署知识库:Ollama+DeepSeek+one-api+FastGPT实战指南

在数据隐私与成本控制日益重要的今天,本地知识库成为个人与小型团队的高效解决方案。其核心在于将文档管理、向量化检索与生成式回答相结合,通过语义相似度匹配为用户提供可溯源的智能问答能力。基于这一原理,Ollama作为轻量级模型运行工具,可高效加载DeepSeek等开源语言模型,实现完全离线的自然语言推理;而one-api则扮演接口网关角色,统一不同模型源的OpenAI兼容格式,简化上层应用接入流程。配合FastGPT这类知识库编排平台,能够快速实现文档切分、向量存储、检索测试与对话应用。在实际工程实践中,以Wi

weixin_29895109的博客 228

如何使你的直流电机闭环?(PID讲解)

看了看很多大佬写的PID讲解很全面也很复杂,实在是不适合很多萌新入坑,所以想按自己的理解写一篇通俗易懂的PID算法讲解

a2001444的博客 1万+

Win11部署FastGPT+ChatGLM3+m3e

Win11部署FastGPT+ChatGLM3+m3e

2301_80175612的博客 1615

NVIDIA DGX Spark实战指南:从开箱到AI模型高效部署

本文详细介绍了NVIDIA DGX Spark的开箱体验、硬件架构及AI模型高效部署实战指南。从1 PetaFLOP算力的迷你设备到Grace Blackwell超级芯片的深度解析,再到五分钟快速上手指南和大模型部署技巧,帮助开发者充分利用这款全球最小AI超级计算机的性能优势。

weixin_29239279的博客 1366

WinForm实战:如何用C#和PdfiumViewer打造一个功能齐全的PDF阅读器(含源码)

本文详细介绍了如何使用C#和PdfiumViewer库从零开始构建一个功能齐全的WinForm PDF阅读器。内容涵盖项目环境搭建、核心组件解析、基于命令模式的工具栏与UI架构设计,并深入讲解了智能缩放、页面导航、打印功能等核心交互的实现,以及内存管理和性能优化等高级话题,为开发者提供了一套完整的实战解决方案。

docker8compose的博客 503

WSL2+ChatGLM2+FastGPT+oneapi本地化部署

使用WSL2+docker+oneapi成功部署fastGPT

weixin_42118737的博客 4589

微信爬虫服务器,微信文章爬虫使用教程 - 八爪鱼采集器

对于某些用户来说,直接自定义规则可能有难度,所以在这种情况下,我们提供了网页简易模式,网页简易模式下存放了国内一些主流网站爬虫采集规则,在你需要采集相关网站时可以直接调用,节省了制作规则的时间以及精力。微信文章采集下来有很多作用,比如可以将自己行业中最近一个月之内发布的内容采集下来,然后分析文章标题和内容的一个方向与趋势。所以本次介绍八爪鱼简易采集模式下“搜狗公众号”的使用教程以及注意要点。步骤一...

weixin_26712065的博客 3256

Win10本地部署大模型问答:Ollama+DeepSeek+One API+FastGPT实战

本地私有化部署大模型正成为企业保障数据安全、降低云端依赖的热门选择。通过容器化与模型编排技术,将开源大模型能力嵌入自有系统,实现完全离线的智能问答体验。其核心原理在于分层协作:模型运行时负责底层推理,语言模型提供语义理解,网关完成接口适配与令牌管理,应用层则封装知识库与对话交互。这种架构既保留了ChatGPT式交互的便捷性,又确保内部资料不出本地,特别适合具有敏感数据的团队构建私域知识库。本文以Windows 10为运行环境,详解基于Ollama、DeepSeek、One API与FastGPT四件套的部署

weixin_31364787的博客 132

[24] cuda 应用之 nppi 实现图像颜色通道变换

[24] cuda 应用之 nppi 实现图像颜色通道变换

yohnyang的博客 343

Xilinx平台SRIO介绍(五)示例工程Example Design介绍

理解IP的使用,少不了Example Design的学习。

数字IC/FPGA杂货铺,找一找,或许有你想要的~ 1万+
上一篇: 命令行测试本地本地部署的大模型是否成功
下一篇: 安装claudecode并接入阿里云白炼免费大模型
憨憨的宏
博客等级 码龄14年 41粉丝 8原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值