HBase存储

在HBase中创建的一张表可以分布在多个Hregion,也就说一张表可以被拆分成多块,每一块称我们呼为一个Hregion。每个Hregion会保 存一个表里面某段连续的数据,用户创建的那个大表中的每个Hregion块是由Hregion服务器提供维护,访问Hregion块是要通过 Hregion服务器,而一个Hregion块对应一个Hregion服务器,一张完整的表可以保存在多个Hregion 上。HRegion Server 与Region的对应关系是一对多的关系。每一个HRegion在物理上会被分为三个部分:Hmemcache(缓存)、Hlog(日志)、HStore(持久层)。
上述这些关系在我脑海中的样子,如图所示:

1.HRegionServer、HRegion、Hmemcache、Hlog、HStore之间的关系,如图所示:

http://zcitrq.bay.livefilestore.com/y1pdt-uarMGAWh01NH_Avl_-f8n5ZUq7zHyGaPKPp1ApP2BkJOtQFDh0H6YXwzhW4odm6zA6htPQTZC-vIX0G1x3YYolWkXMCDF/HBase-RegionServer-Region.jpg?psid=1

2.HBase表中的数据与HRegionServer的分布关系,如图所示:

http://public.bay.livefilestore.com/y1pjunmpIABSxL-FrxrHUCCwXZ-eFxjSUI5xAiuUpWQRo5HKEJy_2iyVl7bkobp1U5pqa8jvJmMQgirR9PQcSZ6NA/HBase-RegionServer-Region2.jpg?psid=1


HBase读数据
HBase读取数据优先读取HMemcache中的内容,如果未取到再去读取Hstore中的数据,提高数据读取的性能。

HBase写数据
HBase写入数据会写到HMemcache和Hlog中,HMemcache建立缓存,Hlog同步Hmemcache和Hstore的事务日志,发起Flush Cache时,数据持久化到Hstore中,并清空HMemecache。

    客户端访问这些数据的时候通过Hmaster ,每个 Hregion 服务器都会和Hmaster 服务器保持一个长连接,Hmaster 是HBase分布式系统中的管理者,他的主要任务就是要告诉每个Hregion 服务器它要维护哪些Hregion。用户的这些都数据可以保存在Hadoop 分布式文件系统上。 如果主服务器Hmaster死机,那么整个系统都会无效。下面我会考虑如何解决Hmaster的SPFO的问题,这个问题有点类似Hadoop的SPFO 问题一样只有一个NameNode维护全局的DataNode,HDFS一旦死机全部挂了,也有人说采用Heartbeat来解决这个问题,但我总想找出 其他的解决方案,多点时间,总有办法的。

昨天在hadoop-0.21.0、hbase-0.20.6的环境中折腾了很久,一直报错,错误信息如下:
Exception in thread "main" java.io.IOException: Call to localhost/serv6:9000 failed on local exception: java.io.EOFException
10/11/10 15:34:34 ERROR master.HMaster: Can not start master
java.lang.reflect.InvocationTargetException
        at sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method)
        at sun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java:39)
        at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:27)
        at java.lang.reflect.Constructor.newInstance(Constructor.java:513)
        at org.apache.hadoop.hbase.master.HMaster.doMain(HMaster.java:1233)
        at org.apache.hadoop.hbase.master.HMaster.main(HMaster.java:1274)

死活连接不上HDFS,也无法连接HMaster,郁闷啊。
我想想啊,慢慢想,我眼前一亮  java.io.EOFException 这个异常,是不是有可能是RPC 协定格式不一致导致的?也就是说服务器端和客户端的版本不一致的问题?换了一个HDFS的服务器端以后,一切都好了,果然是版本的问题,最后采用 hadoop-0.20.2 搭配hbase-0.20.6 比较稳当。
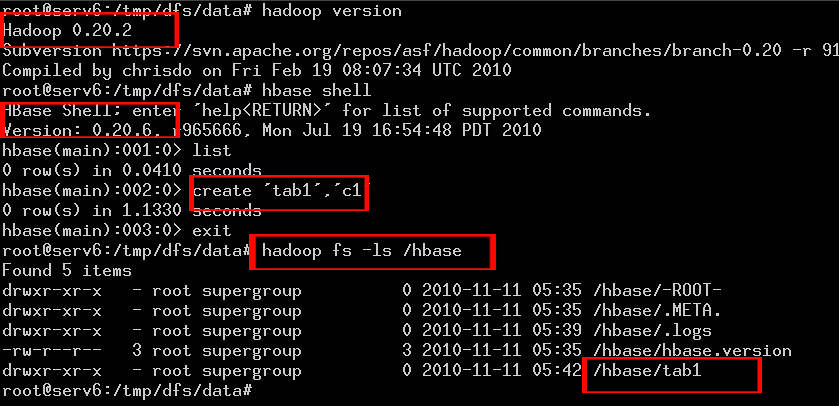
最后的效果如图所示:
http://farm5.static.flickr.com/4065/5165595387_d17a1bbbe4.jpg

查看大图请点击这里, 上图的一些文字说明:
   1.hadoop版本是0.20.2 ,
   2.hbase版本是0.20.6,
   3.在hbase中创建了一张表 tab1,退出hbase shell环境,
   4.用hadoop命令查看,文件系统中的文件果然多了一个刚刚创建的tab1目录,
以上这张图片说明HBase在分布式文件系统Apache HDFS中运行了。

TMS320F28388D 学习笔记2 高精度PWM (HRPWM) HRPWM的学习记录。 阅读详情

相关推荐

在Ultralytics YOLO中添加/更换模块详细指南

使用参数继承 my_module_args: &my_args [64, 3, 0.5] # 定义参数模板 backbone: - [-1, 1, MyModule, *my_args] # 引用参数。

MR_Colorful的博客 2584

HBase总复习

一、基础知识记忆 二、知识简答 1、HBase 的数据模型 2、HBase 分布式数据库与传统数据库的区别。 3、HBase 架构 4、HBase读数据流程 5、HBase写数据流程 三、知识分析解答 1、下面关系表在HBase中的物理模型和逻辑模型。 2、在HBase Shell交互界面中,可通过一系列Shell命令操作HBase,下面通过一张表列举操作HBase表常见的Shell命令。 3、写出下面HBase操作的shell命令 4、Java API 四、编写程序代码

昕昕子的博客 2705

Cadence Allegro通过手工绘制板框的方法

Cadence Allegro通过手工绘制板框的方法 Cadence Allegro绘制板框有三个方法: 1、通过手工绘制板框; 2、通过向导绘制板框; 3、通过导入DXF文件导绘制板框; 本章将教会大家如何通过手工的方法绘制100mm的矩形板框。 方法步骤如下: 一、通过放置绘图工具2D线绘制; 1、运行Cadence Allegro软件,打开File菜单栏,选择New。 2、这时软件会弹出Ne...

LGCPCB的博客 2万+

Spark大数据分与实践笔记(第五章 HBase分布式数据库-03)

HBase构建在Hadoop HDFS之上,Hadoop HDFS为HBase提供了高可靠的底层存储支持,Hadoop MapReduce为HBase提供高性能的计算能力,Zookeeper为HBase提供稳定服务和容错机制。

Lydia868的专栏 783

RK3568+XS9922B+Android11双模视频输入:CVBS与AHD兼容驱动开发实战

本文详细介绍了基于RK3568平台和XS9922B解码芯片,在Android11系统上开发支持CVBS与AHD双模视频输入的兼容驱动实战。内容涵盖硬件选型、内核驱动框架分析、双模信号自动识别与配置、视频通道切换实现及图像质量优化等关键技术点,为车载监控等需要兼容新旧摄像头的项目提供完整解决方案。

js777的博客 379

2026 最新实战教程:AI 重构开发全流程(从需求→上线→运维)

1)做什么系统2)技术栈3)功能模块4)部署要求plaintext我要做一个:待办事项(Todo)全栈应用技术栈:前端:React + TypeScript + Tailwind后端:Node.js + Express + MongoDB部署:Docker + 本地运行(后续可上云)功能:- 增删改查任务- 任务状态切换(完成/未完成)- 简单错误处理请按企业级标准生成:架构设计 + 全部代码 + 接口文档 + 启动命令。

qq_35779316的博客 1703

(Hadoop)HBase分布式数据库

简介 是一个高可靠性、高性能、面向列、可伸缩的分布式数据库。目标是储存并处理大型的数据。有一下特点 容量大:可以存储成千上万的行和列组成的数据 面向列:HBase是面向列的存储和权限控制。列存储,其数据在表中是按照每列存储的,根据数据动态怎能更加列,并且可以单独对列进行各种操作。 多版本:HBase中表的每一个列的数据存储都有多个版本Version。一般的每一列队形一条数据,但是有的数据会对应多...

Python1One的博客 834

PowerBI启动故障排查:环境变量与兼容性设置全指南

本文详细解析了PowerBI启动故障的常见问题,如空白界面和闪退,并提供了环境变量修改与兼容性设置的全方位解决方案。通过调整WEBVIEW2_ADDITIONAL_BROWSER_ARGUMENTS环境变量和设置兼容模式,有效解决PowerBI启动问题,提升软件运行稳定性。

weixin_29255731的博客 471

Hbase存储小资源java代码

System.out.println("\n---根据rowkey、列族、列删除数据---");System.out.println("\n---根据rowkey、列族删除数据---");System.out.println("\n---根据rowkey批量删除数据---");System.out.println("\n---根据rowkey查询数据---");System.out.println("\n---根据rowkey删除数据---");

SongJingzhou的博客 259

光栅衍射有入射角时_偏振光栅的衍射角度及衍射效率测量

偏振光栅是一种基于入射光的偏振态实现选择性分光的衍射光学元件,衍射角度取决于光栅线数。通过控制入射光的偏振态,偏振光栅能够调控正一阶和负一阶之间的能量分布。当入射光束偏振态不同时,偏振光栅具有不同的衍射特性。理想的偏振光栅:当入射光为右旋圆偏振光时,只有+1级衍射光,衍射光为左旋圆偏振光。当入射光为左旋圆偏振光时,只有-1级衍射光,衍射光为右旋圆偏振光。当入射光为非圆偏振光时,偏振光栅同...

weixin_39552768的博客 6005

PLSQL 14.0.6 下载使用教程

众所周知,PLSQL 只是一个oracle第三方开发测试工具,它依赖oracle 客户端搭配使用,但是oracle 客户端有2G,相当庞大,不建议安装。所以我们如果下载安装好PLSQL,再下载好轻量级的支持远程链接的oracle客户端,这样搭配使用可以的话就最好了,答案是可以的。 第一步: PLSQL 下载与安装 PLSQL 14.0.6 下载地址 : https://www.allroundautomations.com/registered-plsqldev/ 下载下来,除了安装路径更改一下,

qq976511508的博客 2135

HBase入门篇4–存储

作者: H.E. | 您可以转载, 但必须以超链接形式标明文章原始出处和作者信息及版权声明 网址: http://www.javabloger.com/article/apache-hbase-hadoop.html   前几篇文章讲述了 HBase的安装、Hbase命令和API的使用、HBase简单的优化技巧,《HBase入门篇4》这篇文章是讲述把HBase的数据放在HDFS上的点滴过程...

nodie的专栏 203

11.1华为OD机试真题 新系统 - 整理学生编号 (Java/Py/C/C++/Js/Go)

11.1华为OD机试真题 新系统 - 整理学生编号 (Java/Py/C/C++/Js/Go)

算法大师! 473

Hbase存储详解

转自:http://my.oschina.net/mkh/blog/349866 Hbase存储详解   started by chad walters and jim   2006.11 G release paper on BigTable   2007.2 inital Hbase prototype created as Hadoop contrib   2007.10 F...

似水流年 4175

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

HBase 数据存储结构

在HBase中, 从逻辑上来讲数据大概就长这样: 单从图中的逻辑模型来看, HBase 和 MySQL 的区别就是: 将不同的列归属与同一个列族下 支持多版本数据 这看着感觉也没有那么太大的区别呀, 它解决了 MySQL 的那些问题呢? 每一个新事物的出现, 都是为了解决原本存在的问题. 对写入友好, 支持异步大批量并发写入 可动态添加列 按列存储数据, 不存在的列不会落盘, 节省空间. 而 MySQL 中不存在的内容也要用 null 填充 支持海量数据分布式存储(BigTable 最开始就是 Go

烟草的香味的博客 862

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

HBase存储结构

一、 Hbase存储框架 图1 Hbase存储架构图 1、 结构 HBase中的每张表都通过行键按照一定的范围被分割成多个子表(HRegion),默认一个HRegion超过256M就要被分割成两个,由HRegionServer管理,管理哪些HRegion由HMaster分配。 HRegionServer存取一个子表时,会创建一个HRegion对象,然后对表的每个列...

meiye的专栏 2725

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Hbase--存储结构

存储结构1、存储概念特点特点概念`RowKey:类似于主键的概念``RegionServer:HBASE架构中的从节点``Region:RegionServer中的存储单元`思考:我有一张表,我有很多数据,我要写入这张表,我怎么让这张表变成分布式的?Hbase中:Store:Region中更小的存储单元memstore:Store中存储数据的内存区域StoreFile:每个Store中内存刷新出来的文件就是storefile2、逻辑结构3、物理结构4、存储架构 1、存储概念特点 特点 优先读写内存 写:

qq_46893497的博客 1406

hbase 异构存储

我整理的一些关于【异构】的项目学习资料(附讲解~~)和大家一起分享、学习一下:https://d.51cto.com/f2PFnNHBase 异构存储:探索大数据存储的未来 在大数据时代,Hadoop生态系统中的HBase因其非关系型数据库的特性而备受青睐。HBase使用列式存储,尤其适合大量数据的快速随机读写。然而,随...

weixin_40523931的博客 143

大数据海量存储揭秘,详解HBase存储结构

HBase是一个查询极其快速的非关系型数据库,它在实时读写和实时访问上有着巨大的优势,并且非常灵活。今天小鸟就从HBase的存储结构来向大家揭秘其强大之处。 之前小鸟已经介绍过HBase的系统架构了,没有看过的同学欢迎翻阅之前的文章:大数据Hadoop工具,HBase系统架构简介 下面正式进入今天的主题:HBase的存储结构 先来看下面这幅图: 这是一个HBase表的存储结构模型,其中...

似水流年 2390

Hbase的存储机制

Hbase的存储机制 Hbase在存储时各个组件的工作 HMaster Hmaster在启动时会将region分配到具体的Hregionserver上,当region因为不断的写入数据变得过大到达阈值时,Hmaster会分割Region为两个新的Region并重新分配regionserver上,以尽可能保障每个regionserver的负载均衡。因为读写数据与master没有关系所以master宕...

e3hhhh的博客 1161

Hbase-之HFile存储结构解析

Hbase-之HFile存储结构解析 StoreFile(HFile)是Hbase最终存储数据的介质,这里需要了解几个Hbase相关的名词 Block KeyValue 具体的HFile的结构图示如下: 1 Block HFile是底层存储Hbase数据的Block-based-index-File,而每个HFile又是由N个Blocks组成的,Block是基于ColumnFamily的,不同的ColumnFamily的数据存储在不同的Store下的不同的Hfile中的不同Block中; HFile

shufangreal的博客 1619

Hbase存储及元数据meta

Hbase的列族式存储 列族就是多个数据列的组合,列族式可以说是表的schema的一部分,而列不是。Hbase可以说是列簇数据库,在创建表的时候要指定列族,而不需要指定具体的列。 Hbase Table组成:Table = rowkey + family + column + timestamp + value 数据存储模式:(Table, rowkey , family , column , timestamp) -> Value Hbase数据存储原型 HBase 是一个稀疏的、分布式、

youngflyer的博客 6736

HBase数据库:分布式列式存储的王者之路

摘要:HBase数据库的分布式列式存储解析 HBase作为Apache Hadoop生态中的分布式列式数据库,以其卓越的海量数据处理能力解决了传统关系型数据库的扩展瓶颈。本文深入剖析了HBase的核心架构与数据模型: 分布式架构:基于HDFS构建的三组件架构(HMaster、RegionServer、Zookeeper)实现高可用与线性扩展,通过客户端连接示例展示服务发现机制 列式存储模型:采用行键+列族的多维存储结构,支持稀疏数据存储和单元格多版本控制,以用户行为分析案例演示数据操作逻辑 实践价值:通过倒

言不信者行不果,行不敏者言多滞. 3285

hbase java存储图片_如何使用HBase存储图片

温馨提示:要看高清无码套图,请使用手机打开并单击图片放大查看。Fayson的github:https://github.com/fayson/cdhproject提示:代码块部分可以左右滑动查看噢1.文档编写目的Fayson在前面的文章中介绍了《如何使用HBase存储文本文件》和《如何使用Lily HBase Indexer对HBase中的数据在Solr中建立索引》,实现了文本文件保存到HBase...

weixin_42296571的博客 1169

hbase 默认目录_[HBase] HBase数据存储目录解析

Hbase在hdfs上的存储位置,根目录是由配置项hbase.rootdir决定,默认就是"/hbase"/hbase/WALs在该目录下,对于每个RegionServer,都会对应1~n个子目录/hbase/oldWALs当/hbase/WALs中的HLog文件被持久化到存储文件时,它们就会被移动到/hbase/oldWALs/hbase/hbase.id集群的唯一ID/hbase/hbase....

weixin_39577422的博客 4972

Hbase的存储

Hbase在生态系统中的位置 Hbase存储的逻辑视图 Hbase的存储格式 Hbase写数据流程 Hbase快速响应数据 Hbase在生态系统中的位置   HBase位于结构化存储层,Hadoop HDFS为HBase提供了高可靠性的底层存储支持,Hadoop MapReduce为HBase提供了高性能的计算能力,Zookeeper为HBase提供了稳定服务和fail...

diaomu5377的博客 822
上一篇: php通过thrift操作hbase
下一篇: hadoop 添加删除datanode及tasktracker
weixir123
博客等级 码龄16年 1粉丝 207原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值