


RollRate:在当前催收水平下,不同逾期天数转换为坏账的概率。
Vintage:通过账龄分析评估放款的质量。其中,逾期率的计算有两种方式。
第一种:应收口径下,风险偏好偏保守。分子:已逾期的借款其所有已到期但未还本金和未到期本金,全部计入逾期未还本金中; 分母:贷款本金。具体公式
如下:
𝑜𝑑𝑢𝑒_𝑟𝑎𝑡𝑒=(𝑐𝑢𝑟𝑟𝑒𝑛𝑡_𝑜𝑑𝑢𝑒_𝑎𝑚𝑡+𝑛𝑜_𝑑𝑢𝑒_𝑎𝑚𝑡)𝑙𝑜𝑎𝑛_𝑎𝑚𝑡第二种:各借款已经到期的借款。分子:已逾期的借款其所有已到期但未还本金。分母:已到期各期本金总和。具体公式如下:
𝑜𝑑𝑢𝑒_𝑟𝑎𝑡𝑒=𝑐𝑢𝑟𝑟𝑒𝑛𝑡_𝑜𝑑𝑢𝑒_𝑎𝑚𝑡𝑑𝑢𝑒_𝑙𝑜𝑎𝑛_𝑎𝑚𝑡其中:MOB指放款后对应的第N个月月底。
对于Vintage的表现,建议关注以下几个方面:
放款后表现:观察每月审批通过后的客户第N个月的逾期比率,对比每月波动。通常波动与审批策略调整有关,
此波动在数据准备阶段的样本抽样过程需要关注。 逾期分布:
逾期分布集中在通过后的前三个月说明审批的策略有待改进,超过三个月之后才慢慢增加,说明贷中的管理 有待提高。
成熟期:确定逾期率在经历第N期趋于稳定。
标签界定多考虑,看完流转看账龄
mport pandas as pd
import numpy as np
from pandas import DataFrame, Series
import warnings

warnings.filterwarnings(action='ignore')
with open(r'F:\知识与学习\Python\Finance\Vintage\loan_detail.xlsx', 'rb') as f:
    loan = pd.read_excel(f)
loan.shape
(253059, 10)
loan.sample(5)
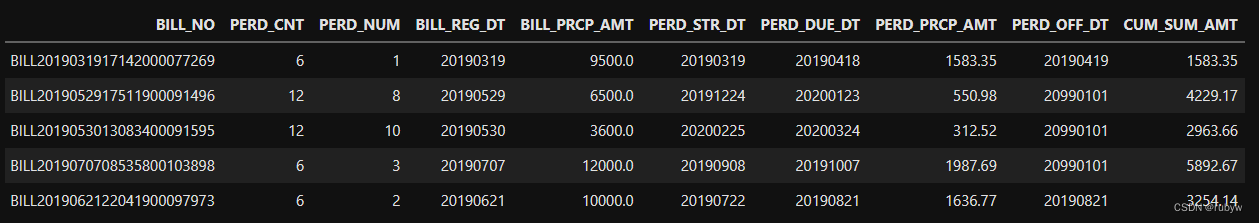
loan.columns = loan.columns.str.lower()
for col in ['bill_reg_dt', 'perd_str_dt', 'perd_due_dt']:
    loan[col] = loan[col].map(lambda x: datetime.strptime(str(x), '%Y%m%d'))
# 将结清日期转换为日期格式。将缺失值填充为2099-01-01。
loan['perd_off_dt'] = loan['perd_off_dt'].map(
    lambda x: datetime.strptime(str(int(x)), '%Y%m%d') if x > 0
    else datetime.strptime('20990101', '%Y%m%d'))
loan['MOB'] = loan['perd_num'].map(lambda x: 'MOB' + str(x))
loan.loc[loan['bill_no'] == 'BILL2019040217271500079112', :]

按照第一种方法(应收口径)计算Vintage
# 计算分子中的逾期应还本金。逾期应还本金包括:逾期应还而未还本金和未到期用户本金。
# 提取所有订单明细。
bill_nos = pd.unique(loan['bill_no'])
date = datetime(year=datetime.today().year, month=datetime.today().month, day=1) - timedelta(days=1)
date = datetime(year=date.year, month=date.month, day=25)
# 对于在当前日期尚未到期的用户同一清除。
loan = loan.loc[(date - loan['perd_due_dt']).map(lambda x: x.days) > 0, :]
loan.head()
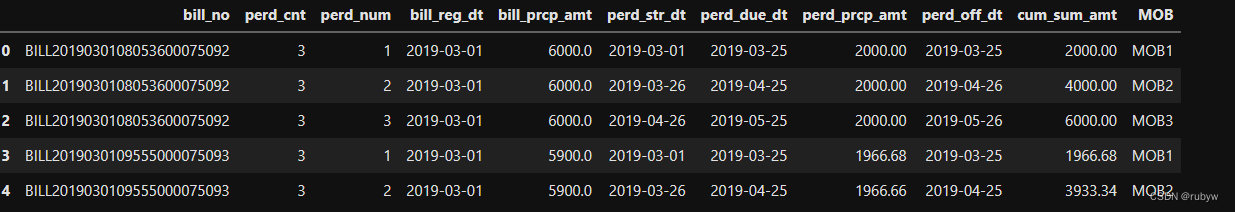
dct = dict()

for bill_no in bill_nos:
    part = loan.loc[loan['bill_no'] == bill_no, :]
    part = part.sort_values(['perd_num'])

    # 计算截至每一期期末应还本金的累计金额。
    part['cum_sum_amt'] = part['perd_prcp_amt'].cumsum()

    # 分期计算各期的还款情况。
    perds = pd.unique(part['perd_num'])

    for perd in perds:
        part_perd = part.loc[part['perd_num'] <= perd, :]

        # 计算每一期期末的日期,用于比较是否已经还款和历史最大逾期天数。
        due_date = max(part_perd['perd_due_dt'])
        due_amt = max(part_perd['cum_sum_amt'])

        # 计算与MOB期末的时间间隔。
        part_perd['delta_days'] = (due_date - part_perd['perd_due_dt']).map(lambda x: x.days)
        # 只要在MOB期末最后一天及以前显示还款(即还清时间小于MOB期末时间),则对应的期数不再纳入最大逾期天数的计算。
        part_perd['is_payoff'] = (due_date - part_perd['perd_off_dt']).map(lambda x: x.days)

        # 计算累计还款金额。
        payoff_amt_df = part_perd.loc[part_perd['is_payoff'] >= 0, 'perd_prcp_amt']
        # 如果用户未还清过1期,还清金额默认为0。
        if payoff_amt_df.shape[0] == 0:
            payoff_amt = 0
        else:
            payoff_amt = payoff_amt_df.sum()

        # 计算截至MOB期末的历史最大逾期天数。
        max_oduedays_df = part_perd.loc[part_perd['is_payoff'] < 0, 'delta_days']
        # 如果用户在统计时间点全部还清借款,则默认最大逾期天数为0。
        if max_oduedays_df.shape[0] == 0:
            max_oduedays = 0
        else:
            max_oduedays = max(max_oduedays_df)

        # 将最大逾期天数,已还清金额存入对应字典中。
        keys = bill_no + '_' + str(perd)
        values = [perd, due_amt, payoff_amt, max_oduedays]

        dct[keys] = values
final = DataFrame(Series(dct))
final = final.reset_index()
final.columns = ['bill_no_perd', 'values']
for i in range(4):
    final[i] = final['values'].map(lambda x: x[i])
final['bill_no'] = final['bill_no_perd'].map(lambda x: x.split('_')[0])
del final['values'], final['bill_no_perd']
final.columns = ['perd_num', 'due_amt', 'payoff_amt', 'max_oduedays', 'bill_no']
final.loc[final['max_oduedays'] >= 30, :].head()

alls = pd.merge(loan, final, left_on=['bill_no', 'perd_num'], right_on=['bill_no', 'perd_num'],
                how='left')
# 计算未到期的金额。
alls['no_due_amt'] = alls['bill_prcp_amt'] - alls['due_amt']
# 通过本金-已还清金额计算分子。
alls['bad_amt'] = alls['bill_prcp_amt'] - alls['payoff_amt']
# 计算放款月份。
alls['bill_month'] = alls['bill_reg_dt'].map(lambda x: str(x)[0 :7])
# 计算分子
numerator =  pd.pivot_table(alls.loc[alls['max_oduedays'] >= 30], index=['bill_month'],
                            columns=['MOB'], values=['bad_amt'], aggfunc=np.sum)
numerator = numerator['bad_amt']
denominator = pd.pivot_table(alls.loc[alls['perd_num'] == 1, :], index=['bill_month'],
                             values=['bill_prcp_amt'], aggfunc=np.sum)
denominator = denominator['bill_prcp_amt']
numerator

denominator

numerator = pd.merge(numerator, denominator, left_index=True, right_index=True, how='left')
for col in numerator.columns[: -1]:
    numerator[col] = round(numerator[col] / numerator['bill_prcp_amt'], 3)
numerator['MOB1'] = 0.000
numerator


绘制vintage图表
from pyecharts.globals import CurrentConfig, NotebookType
CurrentConfig.NOTEBOOK_TYPE = NotebookType.JUPYTER_LAB
from pyecharts.charts import Line
from pyecharts import options as opts
line = (
    Line(init_opts=opts.InitOpts(width='600px', height='400px', theme='dark', bg_color='#111111'))
    .add_xaxis(['MOB1', 'MOB2', 'MOB3', 'MOB4', 'MOB5'])
    .add_yaxis(numerator.index[0], numerator.iloc[0, 1:].tolist())
    .add_yaxis(numerator.index[1], numerator.iloc[1, 1:].tolist())
    .add_yaxis(numerator.index[2], numerator.iloc[2, 1:].tolist())
    .add_yaxis(numerator.index[3], numerator.iloc[3, 1:].tolist())
    .set_global_opts(title_opts=opts.TitleOpts(title='各期Vintage', subtitle='第一种计算方法'))
)
line = (
    Line(init_opts=opts.InitOpts(width='600px', height='400px', theme='white', bg_color='#F2F2F2'))
    .add_xaxis(['MOB1', 'MOB2', 'MOB3', 'MOB4', 'MOB5'])
    .add_yaxis(numerator.index[0], numerator.iloc[0, 1:].tolist())
    .add_yaxis(numerator.index[1], numerator.iloc[1, 1:].tolist())
    .add_yaxis(numerator.index[2], numerator.iloc[2, 1:].tolist())
    .add_yaxis(numerator.index[3], numerator.iloc[3, 1:].tolist())
    .set_global_opts(title_opts=opts.TitleOpts(title='各期Vintage', subtitle='第一种计算方法'))
)
line.render('vintage.html')
分析和计算Roll_Rate的过程20190901
Vintage可以用于分析客户表现的趋势、稳定的时间等,对于客户好坏程度的定义没有涉及, 而通过滚动率分析可以对客户好坏程度进行定义。
滚动率分析就是从某个观察点之前的一段时间(称为观察期)的最坏状态向观察点之后的一段时间(称为表现期)的最坏状态的发展 变化情况。
Y变量即为客户好坏标签变量。Y变量的界定要结合滚动率分析和Vintage分析来定义 滚动率分析用于对客户好坏程度进行定义,解决什么样程度的是好,什么样程度的是坏的问题 Vintage分析用于确定多长的表现期是比较合适的。
import PIL.Image as image

with open(r'F:\知识与学习\Python\Finance\Vintage\roll_rate.png', 'rb') as f:
    im = image.open(f, mode='r')
    im = im.resize(size=(600, 80))
im

import pandas as pd
import numpy as np
from pandas import DataFrame, Series
with open(r'F:\知识与学习\Python\Finance\Vintage\loan_detail.xlsx', 'rb') as f:
    data = pd.read_excel(f)
data.columns = data.columns.str.lower()
data.head()

# 将日期转换为日期格式。
for col in ['bill_reg_dt', 'perd_str_dt', 'perd_due_dt', 'perd_off_dt']:
    data[col] = data[col].map(lambda x: datetime.strptime(str(x)[:8], '%Y%m%d'))
# 计算放款的月份。
data['bill_month'] = data['bill_reg_dt'].map(lambda x: str(x)[ :7])
# 将未到期和表现期不充分的记录删除。
date = datetime(year=datetime.now().year, month=datetime.now().month, day=1) - timedelta(days=1)
date = datetime(year=date.year, month=date.month, day=25)
# 对于未过表现期的用户删除。同时只保留3、4月份放款的用户。
bool1 = data['bill_month'].isin(['2019-03', '2019-04'])
bool2 = data['perd_num'] <= 4
data = data.loc[(data['perd_due_dt'] <= date) & bool1 & bool2, :]
bill_nos = pd.unique(data['bill_no'])
# 计算用户在观察期的表现。
under_obs = dict()

for bill_no in bill_nos:
    part = data.loc[(data['bill_no'] == bill_no) & (data['perd_num'] <= 2), :]
    part = part.sort_values(['perd_num'])

    # 计算每一期期末的日期,用于比较是否已经还款和历史最大逾期天数。
    due_date = max(part['perd_due_dt'])

    # 计算与MOB期末的时间间隔。
    part['delta_days'] = (due_date - part['perd_due_dt']).map(lambda x: x.days)
    # 只要在MOB期末最后一天及以前显示还款(即还清时间小于MOB期末时间),则对应的期数不再纳入最大逾期天数的计算。
    part['is_payoff'] = (due_date - part['perd_off_dt']).map(lambda x: x.days)

    # 计算截至MOB期末的历史最大逾期天数。
    max_oduedays_df = part.loc[part['is_payoff'] < 0, 'delta_days']
    # 如果用户在统计时间点全部还清借款,则默认最大逾期天数为0。
    if max_oduedays_df.shape[0] == 0:
        max_oduedays = 0
    else:
        max_oduedays = max(max_oduedays_df)

    under_obs[bill_no] = max_oduedays
# 计算用户在表现期的最大历史逾期天数。
perform_obs = dict()

for bill_no in bill_nos:
    part = data.loc[(data['bill_no'] == bill_no), :]
    part = part.sort_values(['perd_num'])

    # 计算每一期期末的日期,用于比较是否已经还款和历史最大逾期天数。
    due_date = max(part['perd_due_dt'])

    # 计算与MOB期末的时间间隔。
    part['delta_days'] = (due_date - part['perd_due_dt']).map(lambda x: x.days)
    # 只要在MOB期末最后一天及以前显示还款(即还清时间小于MOB期末时间),则对应的期数不再纳入最大逾期天数的计算。
    part['is_payoff'] = (due_date - part['perd_off_dt']).map(lambda x: x.days)

    # 计算截至MOB期末的历史最大逾期天数。
    max_oduedays_df = part.loc[part['is_payoff'] < 0, 'delta_days']
    # 如果用户在统计时间点全部还清借款,则默认最大逾期天数为0。
    if max_oduedays_df.shape[0] == 0:
        max_oduedays = 0
    else:
        max_oduedays = max(max_oduedays_df)

    perform_obs[bill_no] = max_oduedays
under_obs = DataFrame(Series(under_obs))
under_obs.columns = ['under_obs']
perform_obs = DataFrame(Series(perform_obs))
perform_obs.columns = ['perform_obs']
all_obs = pd.merge(under_obs, perform_obs, left_index=True, right_index=True, how='left')
all_obs.loc[all_obs['under_obs'] > 0, 'under_obs_label'] = 'M1+'
all_obs.loc[all_obs['under_obs'] == 0, 'under_obs_label'] = '正常'
all_obs.loc[(all_obs['perform_obs'] > 0) & (all_obs['perform_obs'] <= 31), 'perform_obs_label'] = 'M1+'
all_obs.loc[(all_obs['perform_obs'] > 31), 'perform_obs_label'] = 'M2+'
all_obs.loc[(all_obs['perform_obs'] == 0), :] = '正常'
all_obs = all_obs.reset_index()
final = pd.pivot_table(all_obs, index=['under_obs_label'], columns=['perform_obs_label'], values=['index'],
                       aggfunc=len)
final = final['index']
final['sum'] = final.sum(axis=1)
final

for col in ['M1+', 'M2+', '正常']:
    final[col] = final[col] / final['sum']
final

迁移率分析
迁移率和滚动率分析比较像,都是分析客户从某个状态变为其他状态的发展变化情况。
所不同的是:滚动率侧重于分析客户逾期程度的变化,所以在做滚动率分析时,需要设置相对较长时间的观察期和表现期; 而迁移率侧重于分析客户状态的发展变化路径。
import pandas as pd
import numpy as np
from pandas import DataFrame, Series
from datetime import datetime
from datetime import timedelta
with open(r'F:\知识与学习\Python\Finance\Vintage\loan_detail.xlsx', 'rb') as f:
    data = pd.read_excel(f)
data.columns = data.columns.str.lower()
data.sample(5)

for col in ['bill_reg_dt', 'perd_str_dt', 'perd_due_dt', 'perd_off_dt']:
    data[col] = data[col].map(lambda x: datetime.strptime(str(x), '%Y%m%d'))
# 提取注册月份。
data['bill_month'] = data['bill_reg_dt'].map(lambda x: str(x)[: 7])
# 只选取3月份放款,保证有4期以上的表现期。
data = data.loc[data['bill_month'].isin(['2019-03']), :]
# 选择当前已经到期的用户。
date = datetime(year=datetime.now().year, month=datetime.now().month, day=1) - timedelta(days=1)
date = datetime(year=date.year, month=date.month, day=25)

data = data.loc[data['perd_due_dt'] <= date, :]
data.head(5)

bill_nos = pd.unique(data['bill_no'])
bill_nos.shape

 7165


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


