主流的RAG算法有哪些?

RAG 全流程核心技术深度解析:1-工作原理+切片+召回+排序 本文深入解析了检索增强生成(RAG)技术的核心原理与应用。RAG通过将信息检索与大语言模型生成能力结合,有效解决大模型的"幻觉"问题、知识时效性不足和领域专业壁垒等关键问题。文章详细介绍了RAG的工作流程,包括准备阶段的分片(Chunking)和索引(Indexing)技术,以及回答阶段的召回、重排和生成过程。特别针对分片技术,对比分析了固定长度切分、递归字符切分、语义切分、结构切分和LLM智能切分五种方法的优缺点及适用场景。最后,文章还探讨了向量化(Embedding)的核心算法和主流 阅读详情

RAG(Retrieval-Augmented Generation):检索增强生成,通过为大模型接入外部知识库,将传统生成式大模型与实时检索技术相结合,为大模型补充来自外部的相关数据和上下文,提升大模型问答准确率,解决大模型幻觉和实效性问题。
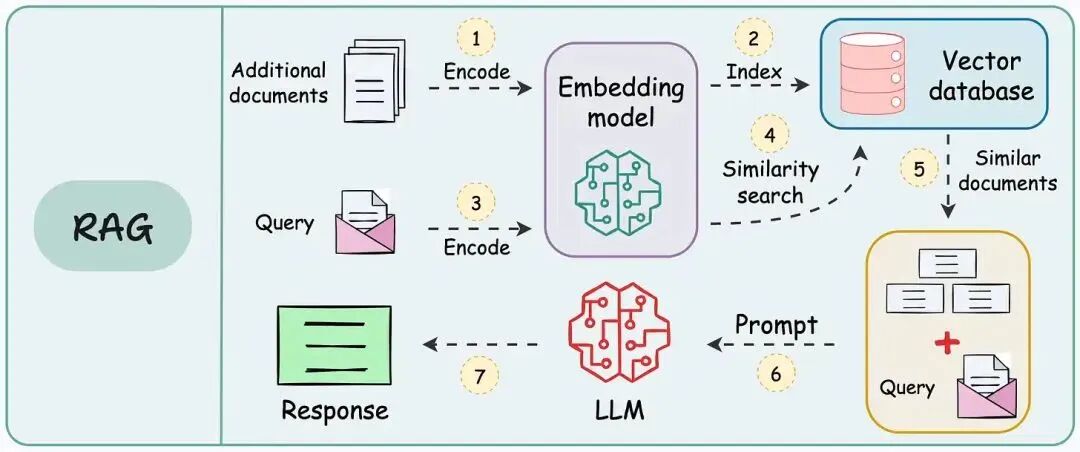
检索:根据用户的输入,从外部知识库中检索出相关的信息,这一步通常是把多模态数据表示成向量,通过向量检索得到最相关的信息。

增强:将用户的查询内容跟检索到的相关知识一起放到提示词模板里。

生成:将经过检索增强的提示词输入到大模型中,通过大模型推理,得到最终的输出结果。

RAG技术的本质是让大模型参加「开卷考试」,通过RAG查找知识库中相关资料,从而解决大模型没有学过的问题。

主流RAG算法

1、RAG Embedding

文档经过切分得到文本块,每一段文本通过Embedding模型进行特征提取,得到每个文本块的向量表达,最后将这些向量存储到知识库里,这个过程叫做RAG Embedding。

不仅文档可以转换成向量,图像、视频、语音等多模态数据也可以转换成向量。通过将不同模态的数据都映射到统一向量空间,以实现多模态知识的互联互通。
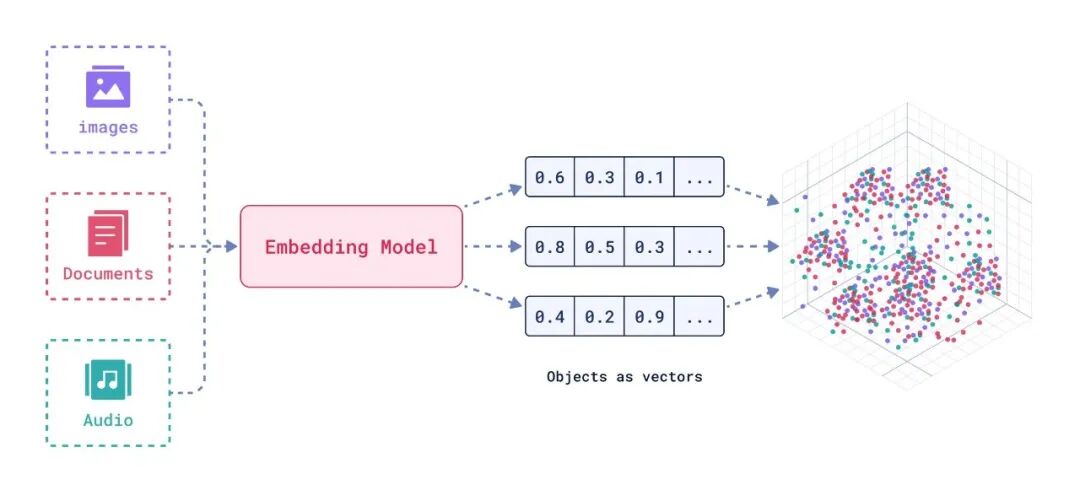
业界主流的Embedding模型包括BGE、Sentence-BERT、text2vec等。这些模型的共同特点是都由Transformer结构组成。

2、RAG Index

当接到用户的查询请求时,通过RAG Embedding将用户的查询请求转换成向量,然后将这个向量与知识库中的向量进行比对,从知识库中找到与查询向量最相似的一组向量。

然而,在实际业务中,知识库中有数千万甚至上亿条向量,如果将查询向量和知识库中的向量进行逐一比对,向量检索的计算量会非常大,无法满足时效性要求。

因此,业界的主流方案是在向量的底库上构建一个高性能的向量索引,检索时基于向量索引快速查询到对应的向量,从而大幅减少向量检索的计算开销,这个建立向量索引的过程叫RAG Index。

业界主流的向量索引包括HNSW图索引和IVFPQ索引。

HNSW(Hierarchical Navigable Small World)分层导航小世界图
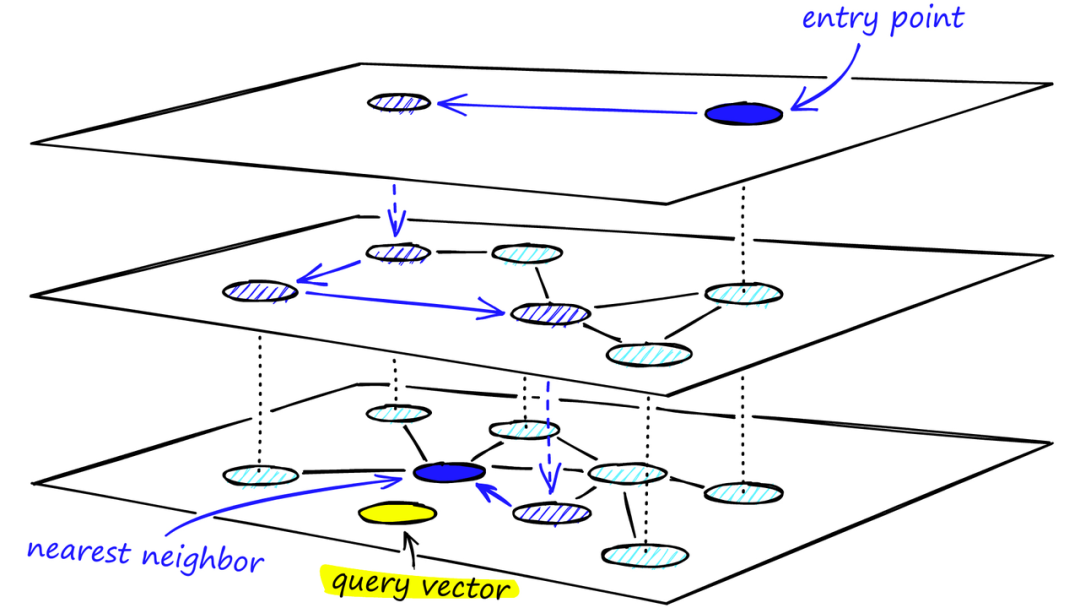
HNSW通过分层导航小世界图实现搜索优化。每一层的节点通过边连接,表示节点间的接近程度。上层图用于快速跳跃,底层图则进行精细搜索。搜索过程包括以下步骤:

  1. 从顶层的入口点开始,利用贪婪搜索找到与查询向量最近的节点。

  2. 达到局部最优后,跳转到下一层并重复搜索。

  3. 在最底层完成最终的精细搜索,返回最近邻结果。

IVF_PQ( Inverted File with Product Quantization)

IVF 就像在一本书中创建索引。 你不用扫描每一页(或者,在我们的情况下,每一个向量),而是在索引中查找特定的关键词(群组),从而快速找到相关的页面(向量)。
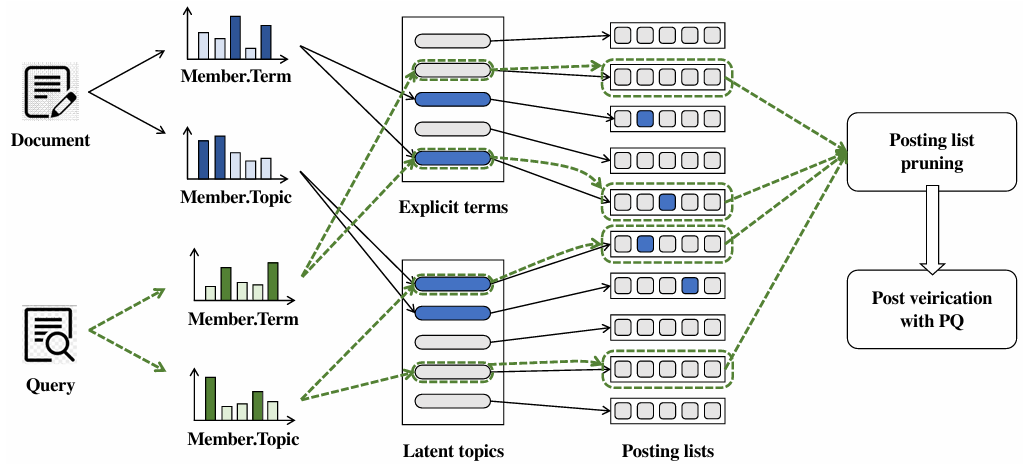
IVFPQ 中包含了两个关键概念:

倒排索引(Inverted File): 这是一种数据结构,用于加速搜索。对于每个特征向量,倒排索引存储了包含该特征向量的数据的列表,这使得在查询时可以快速定位包含相似特征的数据。

乘积量化(Product Quantization): 这是一种降维和量化的技术。在数据检索中,通常使用很高维度的特征向量来描述数据。乘积量化通过将这些高维向量分解成较小的子向量,并对每个子向量进行独立的量化,从而减少了存储和计算的复杂性。这有助于加快检索速度。

3、RAG Reranker

在向量检索完成后,RAG Reranker会对检索到的结果进行重排序。重排序分为逐点重排(Pointwise Reranking)和列表重排(Listwise Reranking)。逐点重排是“给每篇文章单独打分”,列表重排是“看完所有文章再直接排名次”。
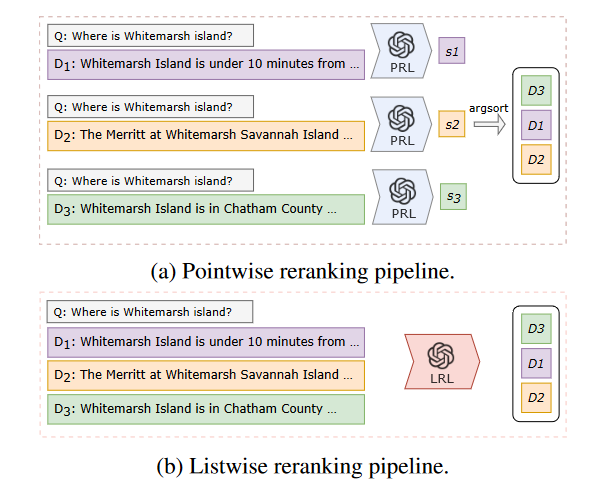
Pointwise是工业界RAG主流,追求高效稳定;Listwise是高精度检索进阶方案,追求排序质量,适合搜索与专业场景。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

智能问答进阶之路:RAG(大模型检索增强生成)框架详解与实战,融合检索与生成助力智能系统更上层楼 阅读详情

相关推荐

【DeepSeek R1构建本地RAG知识库】Reranker模型原理详解

随着生成式AI技术的迅猛发展,Retrieval-Augmented Generation(RAG)作为一种结合信息检索与文本生成的技术框架,正在变得越来越流行。它不仅提高了生成内容的相关性和精确度,还在许多实际应用场景中展现出了巨大的潜力。在本文中,我们将深入探讨如何使用DeepSeek R1来构建一个本地化的RAG知识库,并重点介绍其中的关键组件——Reranker模型的工作原理。Reranker模型的主要任务是对检索器初步筛选出来的结果进行重新排序,以确保最相关、最有用的信息能够被优先展示给用户。

少说,多做 1061

RAG核心算法

一文读懂RAG

AI从业者的专栏 2222

MIPI DPHY接口(基于Xilinx FPGA实现)案例分析

在Xilinx FPGA实现MIPI DPHY接口的案例(包括CIS协议层)。截止目前为止,Xilinx仅在Ultrascale+及其以上版本的FPGA IO可直接支持MIPI 电平输入,其他的,都需要转换成LVDS来接收。

ONEFPGA的博客 5635

一文了解RAG18种常见算法对比,看这一篇就够了!

在本文,将介绍一下RAG常用的18种算法

大模型研究中心 1454

MacOS下Mixly 2.0安装避坑指南:从Java环境到终端权限全解析

本文详细解析了在MacOS系统上安装Mixly 2.0时可能遇到的核心问题与解决方案。针对Java环境版本不兼容、MacOS Gatekeeper安全机制拦截以及终端权限不足三大常见障碍,提供了从检查并配置正确Java版本、安全设置绕过到彻底解决应用内部工具链权限的完整避坑指南,帮助用户顺利完成安装并正常使用。

weixin_29231725的博客 504

常用的集成TTL门电路

本篇主要分析了常用的逻辑门电路与非门,详细分析了电源原理。值得收藏。

ManagerUser的博客 5088

基于RAG与大模型的医疗问答知识库构建简介,大模型入门到精通,收藏这篇就足够了!

RAG,本质上是一种结合搜索技术和大型语言模型(LLMs)的技术。它通过从数据源中检索信息来辅助LLM生成答案。

瓦罗兰特顶级C位的博客 667

高效低功耗设计:PMOS电子开关在墨水屏与ADC采样电路中的创新应用

本文深入探讨了PMOS电子开关在低功耗设计中的创新应用,特别是在墨水屏和ADC采样电路中的关键作用。通过详细分析PMOS的导通机制和近乎零静态功耗特性,展示了其在待机低功耗场景下的显著优势,并提供了实用的电路设计技巧和元器件选型建议,帮助工程师实现极致的功耗优化。

weixin_29193359的博客 162

RAG实战:构建基于本地大模型的智能问答系统

检索(Retrieval)从知识库检索相关文档利用向量数据库进行高效存储和检索通过语义相似度找到最相关内容增强(Augmentation)将检索内容注入提示模板为模型提供准确的上下文确保回答基于可靠信息生成(Generation)利用大模型生成回答保证回答的准确性和可追溯性本文介绍的RAG问答系统结合了最新的AI技术,实现了一个既智能又可靠的问答系统。通过使用本地大模型和RAG技术,我们可以构建出适合特定领域的智能问答应用,为用户提供准确、可靠的答案。

大白菜代码的博客 1704

搞懂 ABAP 里的 Language Settings:登录语言、文本环境语言与 sy-langu 的真实含义

SAP系统中语言设置并非单一字段决定,而是由登录语言(logon language)和文本环境语言(text environment language)共同控制。登录语言在会话期间固定,而文本环境语言可通过SET LOCALE语句修改,影响文本处理、排序、异常显示等行为。开发中需区分两者:使用CL_ABAP_SYST方法获取登录语言,通过sy-langu或GET LOCALE获取当前文本环境语言。语言环境切换应谨慎处理并尽快恢复,避免影响会话中其他程序。在多语言场景下,正确处理语言设置对确保文本相关功能正常

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1307

主流的RAG算法有哪些?收藏这份RAG入门指南,轻松玩转大模型知识增强技术!

RAG(检索增强生成)技术通过结合外部知识库和实时检索,显著提升大模型问答的准确性和实效性。其核心流程包括检索(向量化查询与知识库匹配)、增强(将检索结果整合到提示词)和生成(模型推理输出)。主流算法涵盖RAG Embedding(多模态向量转换)、RAG Index(高效向量检索)和RAG Reranker(结果优化排序)。该技术让大模型实现"开卷考试"式知识调用,有效解决幻觉问题。文章还提供了大模型学习的系统路径和实用资源,助力开发者掌握这一前沿技术。

m0_65555479的博客 1012

图机器学习(1)——图论基础

图 (Graph) 是一种描述实体间关系的数学结构,几乎在各个领域都有应用。例如,社交网络就是图,其中用户之间的连接取决于一个用户是否“关注”另一个用户。图论,即对图的研究,一直以来广受关注,包含了大量算法、性质分析方法和数学模型,以解析复杂系统的行为特征。本节将介绍图数据结构的核心概念,通过理论阐述与实例演示相结合的方式,理解基础理论用以实践应用。重点介绍用于创建、操作和研究复杂网络结构与功能的 Python 库。

盼小辉丶的博客 9160

向量检索算法综述:KNN、近似KNN与主流ANN索引算法(PQ、NSW、HNSW)

本文系统介绍了向量索引技术及其在高效检索中的应用。首先解释了向量索引作为高维向量快速查找目录的核心功能,然后详细分析了RAG流程中的召回与排序两阶段:召回阶段追求高召回率,排序阶段则结合业务逻辑进行个性化重排序。文章重点剖析了多种ANN技术:倒排索引(IVF)的文本检索原理、KNN搜索及其时间复杂度问题、近似KNN的空间分块优化、Product Quantization(PQ)的向量压缩编码方法,以及NSW和HNSW图结构的高效搜索机制。

weixin_72563696的博客 1974

Yocto系列讲解[入门篇] 2 - 演示运行qemux86-64虚拟机

手把手教大家怎么编译Yocto,并运行一个qemux86虚拟机

fulinux的博客 1万+

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

一文读懂:从RAG到多模态RAG

Retrieval Augmented Generation,检索增强生成。是一种结合了信息检索技术和大型语言模型提示功能的框架。它通过从数据源检索信息来辅助LLM生成答案,提高了模型在知识密集型任务中的准确性和可信度。

python123456_的博客 1085

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

主流RAG框架TOP10及RAG小工具SODA :兼看RobustRAG防攻击污染框架思路

本文主要讲了2个问题,一个是回顾下主流RAG框架TOP10及一个有趣的soda RAG小工具,另一个为防止恶意检索污染攻击的RAG方案RobustRAG思路。其中关于主流框架方面,当前有很多,但不需要哪个都做,还是需要选一个就行。另外,RobustRAG在真实场景下用不太到,但单纯从思想上来看,是很有趣的。

具身机器人和通用AI 2527

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

【AI大模型】RAG 20多种常见算法对比,零基础小白收藏这一篇就够了!!

它的原理是通过智能地对查询进行分类并为每种问题类型选择最合适的检索策略,自适应 RAG 比其他方法表现出更好的性能。在事实、分析、观点和上下文策略之间动态切换的能力使其能够非常准确地处理不同的信息需求。

Android23333的博客 1053

RAG实战指南 Day 20:大规模向量索引优化技术

大规模向量索引面临内存、计算和精度三方面的挑战HNSW适合高精度需求,PQ适合内存敏感场景分布式架构是处理亿级向量的必由之路量化技术可显著降低内存占用,但会引入精度损失。

在未来等你的专栏 1517

RAG索引技术:智能导航知识库的核心

RAG索引技术通过向量化与高效检索算法,将非结构化数据转化为可快速查询的语义地图。核心流程包括: 向量生成:使用嵌入模型(如BGE)将文本转化为高维向量; 索引构建:采用IVF(聚类分桶)、HNSW(多层图导航)等算法加速检索,其中HNSW适合高精度实时场景,IVF平衡速度与内存; 检索优化:结合混合检索与重排序提升结果相关性。 实战示例:基于FAISS库构建电商商品索引,HNSW索引10万向量仅需20秒,实现毫秒级语义搜索。选型建议:中小团队优先HNSW,企业级

achenbusi的博客 1269

RAG实战指南 Day 11:文本分块策略与最佳实践

五大分块策略的实现原理与适用场景分块质量评估的量化指标体系多模态内容的分块与关联技术电商知识库案例的优化经验自适应分块选择算法先分析文档类型和特征再选择策略对混合内容采用多模态分块关键文档使用LLM辅助优化建立分块质量监控机制不同文档类型采用不同分块策略基于嵌入模型的动态分块主题连贯性分析算法跨文档上下文关联分块边界优化策略实时分块调整技术。

在未来等你的专栏 1270

RAG中的向量数据库:底层技术剖析、主流库对比与内容更新策略

向量数据库是RAG系统中实现高效检索的关键,其底层技术(如HNSW、IVF、PQ)决定了性能与扩展性。主流库如Pinecone、Milvus、Weaviate和Faiss各有侧重,选择需根据项目规模、实时性和运维能力权衡。内容更新方面,增量与批量策略的结合可满足不同场景需求。

爱好技术的小老头 4466

【RAG】检索增强生成中的重排序(Re-rank)技术

而重排序模型通过综合考虑更多的特征,如查询意图、词汇的多重语义、用户的历史行为和上下文信息等,重新计算上下文的相关性得分,使得真正相关的文档更容易被识别出来。例如,在传统的TF-IDF或BM25方法中,匹配主要依赖于词汇级别的相似度计算,而大型语言模型则可以理解句子和段落的上下文信息,从而更好地识别出真正相关的文档。总之,Cohere提供的在线重排序模型凭借其便捷的接入方式、卓越的性能以及广泛的适用性,成为众多企业和开发者进行RAG系统开发时的重要选择。然而,这类模型对计算资源的需求较高,部署成本较大。

酒酿小圆子呀~ 882

RAG 如何消除大模型幻觉,大模型入门到精通,收藏这篇就足够了!

假设我们有一个基于大型生成模型(如GPT-3)的问答系统,该系统用于回答药企内部知识库中的问题。我们向其提出一个问题:“阿司匹林的主要药理作用是什么?”

2301_81940605的博客 1003

一文读懂检索增强生成 RAG

检索增强生成(RAG)技术通过结合大型语言模型与外部知识库,有效解决LLM的幻觉问题、知识滞后等痛点。其核心流程分为检索、重排序、生成三阶段,关键技术包括:1)Embedding模型(将文本向量化存储);2)Reranker模型(对检索结果进行智能重排);3)Temperature参数(控制生成结果的严谨性与创造性)。其中,Embedding负责语义理解,Reranker充当"知识质检员",而Temperature则调节AI输出的风格。该技术通过混合检索策略(语义+关键词)显著提升召回率

m0_72652089的博客 1898

【LLM进阶-RAG】3.稠密向量检索算法

摘要:本文系统梳理了向量检索算法的发展历程与技术原理,重点剖析了ANN(近似最近邻)技术的演进路径。从早期的暴力检索、树结构算法,到局部敏感哈希、乘积量化,再到当前主流的图索引算法,文章详细解析了各类算法的数学原理与工程实现。特别深入分析了HNSW算法的分层导航机制及其核心参数设计,揭示了现代向量数据库实现高效检索的技术本质。文章通过严谨的数学公式和工程实践视角,为理解大语言模型中检索增强生成(RAG)技术的底层支撑提供了全面参考。

FDGFGFDGFD的博客 363
上一篇: 别让你的RAG停留在两年前:万字拆解2026大模型检索技术的真实落地现状
下一篇: 没人告诉你的真相:大模型应用开发靠的是经验,不是技术
Llama-Turbo
博客等级 码龄4年 9901粉丝 2024原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
